O lançamento do ChatGPT demonstrou o potencial dos grandes modelos de linguagem (LLMs) e da inteligência artificial generativa em diversas áreas, como redação de conteúdo, geração de imagens, otimização de código e busca de informações. Os LLMs tornaram-se ferramentas poderosas para indivíduos e empresas, evoluindo para superaplicativos e criando novos ecossistemas. Este tópico descreve como criar um chatbot dedicado usando o ApsaraDB RDS for PostgreSQL.
Contexto
Cada vez mais empresas e indivíduos desejam usar LLMs e IA generativa para desenvolver produtos com inteligência artificial voltados a seus domínios específicos. Embora os LLMs tenham bom desempenho em problemas gerais, eles apresentam limitações ao lidar com conhecimento especializado e informações em tempo real devido aos dados de treinamento e à forma como geram respostas. Na era da informação, as empresas atualizam frequentemente suas bases de conhecimento. Essas bases de conhecimento de domínios verticais, que incluem documentos, imagens e arquivos de áudio/vídeo, podem ser privadas ou confidenciais. Para desenvolver um produto de IA específico para um domínio com base em um LLM, a empresa precisa treinar continuamente o modelo com sua própria base de conhecimento.
Dois métodos comuns estão disponíveis:
Fine-tuning: forneça novos conjuntos de dados para ajustar os pesos de um modelo existente. Atualize continuamente a entrada para ajustar a saída e alcançar o resultado desejado. Essa abordagem é adequada para pequenos conjuntos de dados ou para treinamento em tipos de tarefas ou estilos específicos. No entanto, o custo de treinamento é elevado.
Prompt-tuning: ajuste os prompts de entrada em vez de modificar os pesos do modelo para alterar a saída. Em comparação com o fine-tuning, o prompt-tuning possui custos computacionais menores, exige menos recursos e tempo de treinamento, além de oferecer maior flexibilidade.
As vantagens de criar um chatbot no ApsaraDB RDS for PostgreSQL incluem:
O ApsaraDB RDS for PostgreSQL conta com o plugin pgvector, que permite converter conteúdo em tempo real ou conhecimento específico do domínio em embeddings vetoriais. Armazenar esses embeddings no ApsaraDB RDS for PostgreSQL acelera as buscas vetoriais e melhora a precisão das respostas para seus dados privados.
Como mecanismo avançado de processamento transacional (TP) open source, o ApsaraDB RDS for PostgreSQL lida simultaneamente com interações de usuários online e tarefas de armazenamento de dados. Por exemplo, ele gerencia histórico de conversas, registros de interação e carimbos de data/hora do chat. A versatilidade do ApsaraDB RDS for PostgreSQL simplifica a criação de serviços privados e torna a arquitetura mais leve.
O plugin pgvector é amplamente utilizado pela comunidade de desenvolvedores e em bancos de dados PostgreSQL open source. Ferramentas como o ChatGPT Retrieval Plugin também adicionaram rapidamente suporte ao PostgreSQL. Isso demonstra que o ApsaraDB RDS for PostgreSQL possui forte suporte do ecossistema e uma ampla base de aplicações para recuperação vetorial, oferecendo aos usuários diversas ferramentas e recursos.
Este tópico utiliza o plugin de índice vetorial open source para ApsaraDB RDS for PostgreSQL, pgvector, e os recursos de embedding da OpenAI para mostrar como criar um chatbot dedicado.
Pré-requisitos
-
Crie uma instância RDS PostgreSQL que atenda às seguintes condições:
A instância executa o PostgreSQL 14 ou posterior.
A versão secundária do mecanismo da instância é 20230430 ou posterior.
NotaPara mais informações, consulte Atualize a versão principal do mecanismo e Atualize a versão secundária do mecanismo.
O chatbot dedicado neste tópico baseia-se no plugin open source pgvector para ApsaraDB RDS for PostgreSQL. Certifique-se de compreender totalmente seu uso e conceitos básicos. Para mais informações, consulte pgvector user guide.
O chatbot dedicado neste tópico utiliza recursos da OpenAI. Verifique se você possui uma
Secret API Keye se seu ambiente de rede tem acesso à OpenAI. Os exemplos de código neste tópico são implantados em uma instância ECS na região Singapore.O código de exemplo neste tópico usa Python. Garanta que você tenha um ambiente de desenvolvimento Python configurado. Este exemplo utiliza Python
3.11.4e PyCharm2023.1.2.
Conceitos relacionados
Embedding
Embedding é o processo de mapeamento de dados de alta dimensão para uma representação de baixa dimensão. Em machine learning e processamento de linguagem natural (NLP), o embedding é frequentemente usado para representar símbolos ou objetos discretos como pontos em um espaço vetorial contínuo.
No contexto de NLP, o word embedding é uma técnica comum que mapeia palavras para vetores de números reais, permitindo que os computadores compreendam e processem texto de forma mais eficaz. Por meio do word embedding, as relações semânticas e gramaticais entre as palavras podem ser representadas no espaço vetorial.
A OpenAI oferece um recurso de Embeddings.
Princípios de implementação
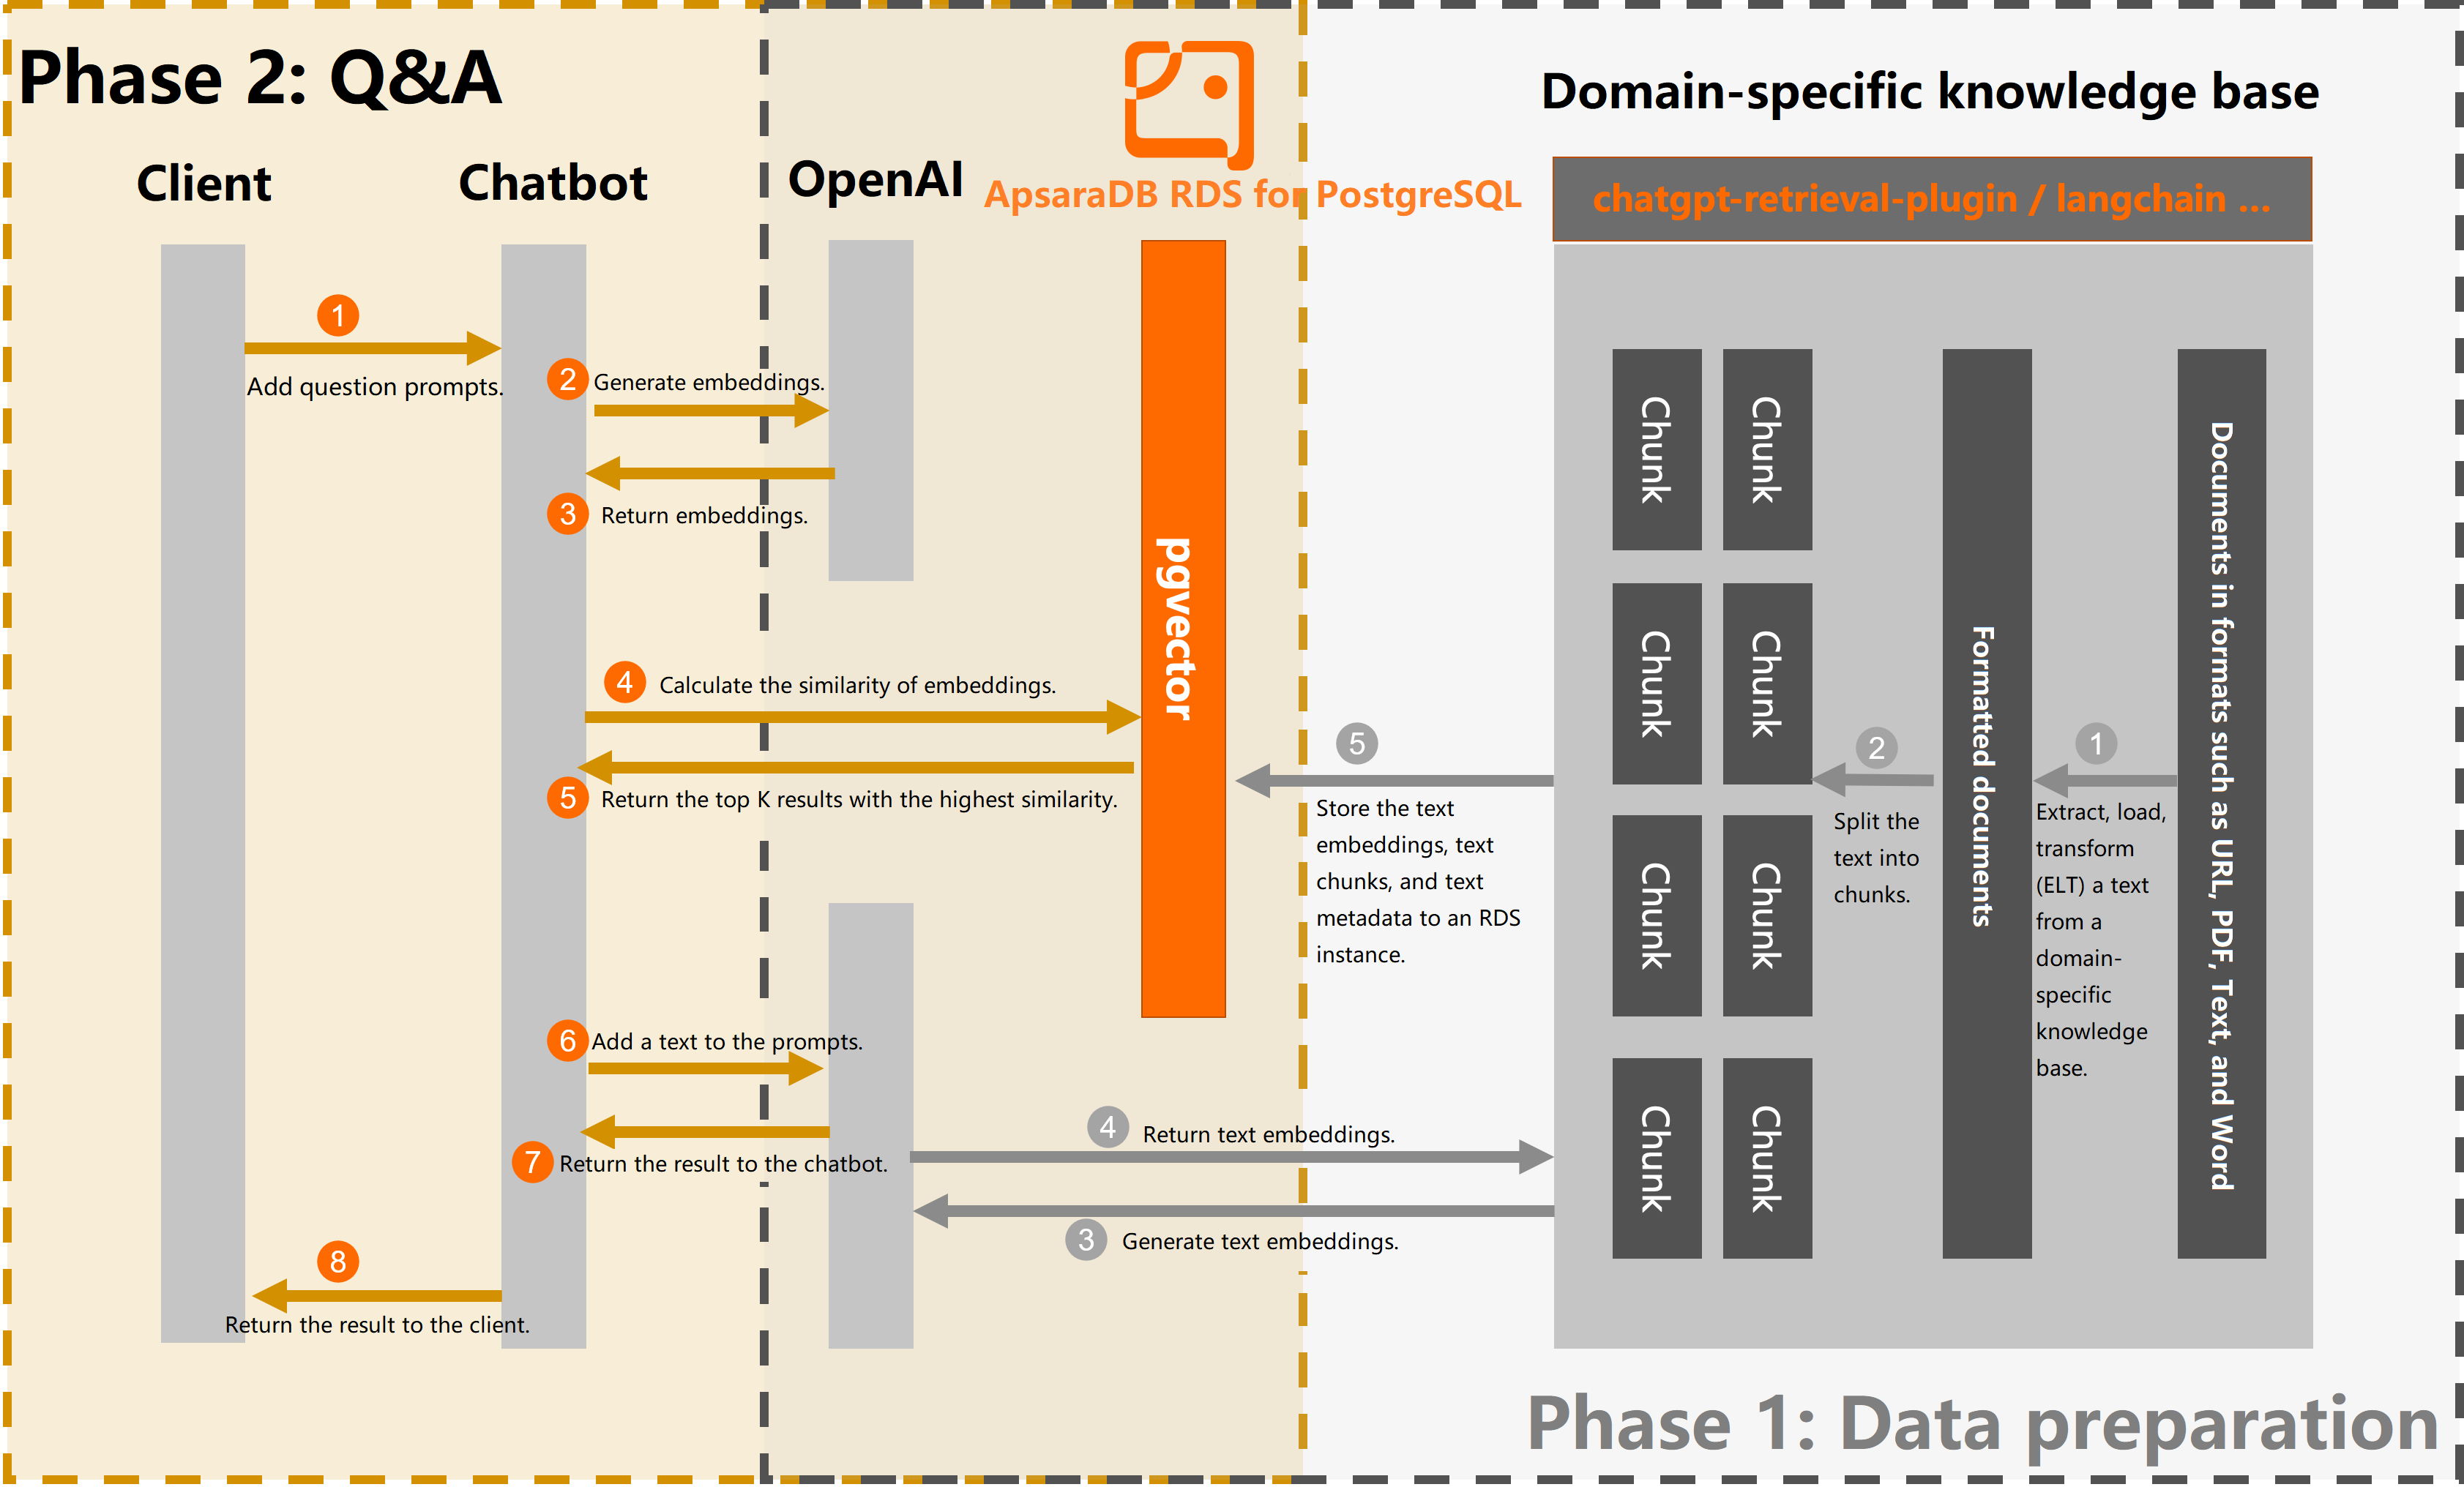
O processo de criação do chatbot dedicado consiste em duas fases:
Fase 1: Preparação de dados
Extraia e fragmente as informações da base de conhecimento: extraia o texto relevante da base de conhecimento do domínio e processe-o em fragmentos. Isso pode incluir a divisão de textos longos em parágrafos ou frases, ou a extração de palavras-chave ou entidades. Esse processo ajuda a organizar e gerenciar o conteúdo da base de conhecimento.
Chame uma interface de LLM para gerar embeddings: utilize uma interface fornecida por um LLM, como a OpenAI, para inserir os fragmentos de texto e gerar os embeddings correspondentes. Esses embeddings capturam as informações semânticas e contextuais do texto, servindo de base para buscas e correspondências posteriores.
Armazene as informações de embedding: salve os embeddings de texto gerados, os fragmentos de texto e os metadados associados no banco de dados ApsaraDB RDS for PostgreSQL.
Fase 2: Perguntas e respostas
Um usuário faz uma pergunta.
Crie um embedding para a pergunta usando a interface de embedding fornecida pela OpenAI.
Use o pgvector para filtrar fragmentos de documentos no banco de dados ApsaraDB RDS for PostgreSQL que tenham uma pontuação de similaridade acima de um determinado limiar e retorne os resultados.
O fluxograma a seguir ilustra o processo:
Procedimento
Fase 1: Preparação de dados
Este tópico usa o conteúdo de texto do documento Create an RDS for PostgreSQL instance como exemplo. O conteúdo é dividido e armazenado em um banco de dados ApsaraDB RDS for PostgreSQL. Prepare sua própria base de conhecimento específica do domínio.
O ponto central da fase de preparação de dados é converter o conhecimento específico do domínio em embeddings de texto, além de armazenar e corresponder essas informações de maneira eficaz. Ao aproveitar os poderosos recursos de compreensão semântica dos LLMs, você obtém respostas e sugestões de alta qualidade relacionadas ao seu domínio específico. Frameworks open source atuais, como LangChain e o ChatGPT Retrieval Plugin open source da OpenAI, permitem carregar e analisar facilmente arquivos de base de conhecimento em formatos como URL, Markdown, PDF e Word. Tanto o LangChain quanto o ChatGPT Retrieval Plugin já suportam PostgreSQL com a extensão pgvector como banco de dados vetorial de backend. Isso facilita a integração com sua instância ApsaraDB RDS for PostgreSQL. Com essa integração, conclua a preparação de dados para sua base de conhecimento de domínio na Fase 1. Além disso, aproveite totalmente os recursos de indexação vetorial e busca por similaridade do pgvector para consultas e correspondência de texto eficientes.
-
Crie um banco de dados de teste. Este exemplo utiliza
rds_pgvector_test.CREATE DATABASE rds_pgvector_test; -
Conecte-se ao banco de dados de teste e crie o plugin pgvector.
CREATE EXTENSION IF NOT EXISTS vector; -
Crie uma tabela de teste para armazenar o conteúdo da base de conhecimento. Este exemplo utiliza
rds_pg_help_docs.CREATE TABLE rds_pg_help_docs ( id bigserial PRIMARY KEY, title text, -- Document title description text, -- Description doc_chunk text, -- Document chunk token_size int, -- Token count of the document chunk embedding vector(1536)); -- Text embedding information -
Crie um índice na coluna de embedding para otimizar e acelerar as consultas.
CREATE INDEX ON rds_pg_help_docs USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);NotaPara mais informações sobre como criar um índice em uma coluna vetorial, consulte pgvector user guide.
-
No PyCharm, crie um projeto, abra o Terminal e execute o seguinte comando para instalar as dependências necessárias.
pip install openai psycopg2 tiktoken requests beautifulsoup4 numpy -
Crie um arquivo
.pypara dividir o documento da base de conhecimento e armazená-lo no banco de dados. Este exemplo utilizaknowledge_chunk_storage.py. O código de exemplo é o seguinte:NotaNo código de exemplo abaixo, o método de divisão personalizado divide o documento da base de conhecimento apenas por um número fixo de caracteres. Você pode usar métodos fornecidos por frameworks open source, como LangChain e o ChatGPT Retrieval Plugin open source da OpenAI, para realizar a divisão. A qualidade dos documentos na base de conhecimento e os resultados da fragmentação têm um impacto significativo na saída final.
import openai
import psycopg2
import tiktoken
import requests
from bs4 import BeautifulSoup

EMBEDDING_MODEL = "text-embedding-ada-002"
tokenizer = tiktoken.get_encoding("cl100k_base")

# Connect to the RDS for PostgreSQL database
conn = psycopg2.connect(database="<database_name>",
                        host="<instance_endpoint>",
                        user="<username>",
                        password="<password>",
                        port="<port>")
conn.autocommit = True

# OpenAI API key
openai.api_key = '<Secret API Key>'

# Custom splitting method (for example only)
  def get_text_chunks(text, max_chunk_size):
    chunks_ = []
    soup_ = BeautifulSoup(text, 'html.parser')

    content = ''.join(soup_.strings).strip()

    length = len(content)
    start = 0
    while start < length:
        end = start + max_chunk_size
        if end >= length:
            end = length

        chunk_ = content[start:end]
        chunks_.append(chunk_)

        start = end

    return chunks_

# Specify the web page to split
url = 'https://www.alibabacloud.com/help/document_detail/148038.html'

response = requests.get(url)
if response.status_code == 200:
    # Get the web page content
    web_html_data = response.text
    soup = BeautifulSoup(web_html_data, 'html.parser')
    # Get the title (H1 tag)
    title = soup.find('h1').text.strip()

    # Get the description (content of the p tag with class='shortdesc')
    description = soup.find('p', class_='shortdesc').text.strip()

    # Split and store
    chunks = get_text_chunks(web_html_data, 500)
    for chunk in chunks:
        doc_item = {
            'title': title,
            'description': description,
            'doc_chunk': chunk,
            'token_size': len(tokenizer.encode(chunk))
        }

        query_embedding_response = openai.Embedding.create(
            model=EMBEDDING_MODEL,
            input=chunk,
        )

        doc_item['embedding'] = query_embedding_response['data'][0]['embedding']

        cur = conn.cursor()
        insert_query = '''
        INSERT INTO rds_pg_help_docs
            (title, description, doc_chunk, token_size, embedding) VALUES (%s, %s, %s, %s, %s);
        '''

        cur.execute(insert_query, (
            doc_item['title'], doc_item['description'], doc_item['doc_chunk'], doc_item['token_size'],
            doc_item['embedding']))

        conn.commit()

else:
    print('Failed to fetch web page')
Execute o programa Python.
-
Faça login no banco de dados e execute o seguinte comando para verificar se o conteúdo da base de conhecimento foi dividido e armazenado como dados vetoriais.
SELECT * FROM rds_pg_help_docs;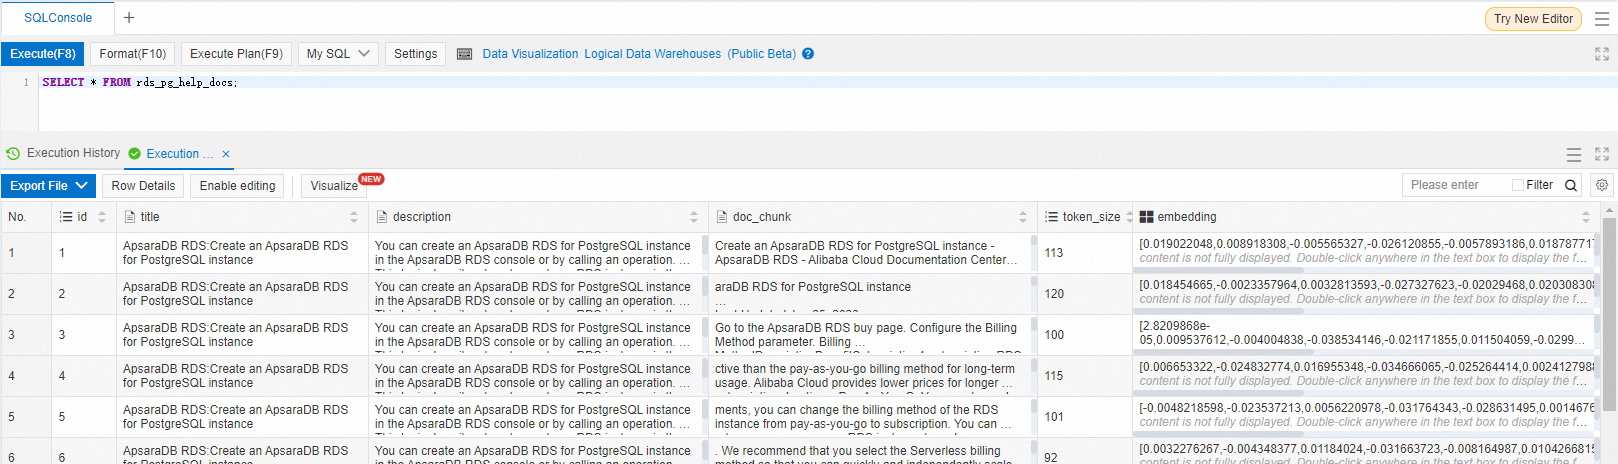
Fase 2: Perguntas e respostas
-
No projeto Python, crie um arquivo
.pypara formular uma pergunta, comparar sua similaridade com o conteúdo da base de conhecimento no banco de dados e retornar o resultado. Este exemplo utilizachatbot.py.import openai import psycopg2 from psycopg2.extras import DictCursor GPT_MODEL = "gpt-3.5-turbo" EMBEDDING_MODEL = "text-embedding-ada-002" GPT_COMPLETIONS_MODEL = "text-davinci-003" MAX_TOKENS = 1024 # OpenAI API key openai.api_key = '<Secret API Key>' prompt = 'How to create an RDS for PostgreSQL instance' prompt_response = openai.Embedding.create( model=EMBEDDING_MODEL, input=prompt, ) prompt_embedding = prompt_response['data'][0]['embedding'] # Connect to the RDS for PostgreSQL database conn = psycopg2.connect(database="<database_name>", host="<instance_endpoint>", user="<username>", password="<password>", port="<port>") conn.autocommit = True def answer(prompt_doc, prompt): improved_prompt = f""" Answer the following question based on the provided document and steps: (1) First, analyze the content of the document to see if it is relevant to the question. (2) Second, use only the content from the document for the reply. Be as detailed as possible and output in markdown format. (3) Finally, if the question is not related to RDS for PostgreSQL, reply with "I am not very knowledgeable about topics other than RDS for PostgreSQL." Document: \"\"\" {prompt_doc} \"\"\" Question: {prompt} """ response = openai.Completion.create( model=GPT_COMPLETIONS_MODEL, prompt=improved_prompt, temperature=0.2, max_tokens=MAX_TOKENS ) print(f"{response['choices'][0]['text']}\n") similarity_threshold = 0.78 max_matched_doc_counts = 8 # Filter out document chunks with a similarity greater than a certain threshold using pgvector similarity_search_sql = f''' SELECT doc_chunk, token_size, 1 - (embedding <=> '{prompt_embedding}') AS similarity FROM rds_pg_help_docs WHERE 1 - (embedding <=> '{prompt_embedding}') > {similarity_threshold} ORDER BY id LIMIT {max_matched_doc_counts}; ''' cur = conn.cursor(cursor_factory=DictCursor) cur.execute(similarity_search_sql) matched_docs = cur.fetchall() total_tokens = 0 prompt_doc = '' print('Answer: \n') for matched_doc in matched_docs: if total_tokens + matched_doc['token_size'] <= 1000: prompt_doc += f"\n---\n{matched_doc['doc_chunk']}" total_tokens += matched_doc['token_size'] continue answer(prompt_doc,prompt) total_tokens = 0 prompt_doc = '' answer(prompt_doc,prompt) -
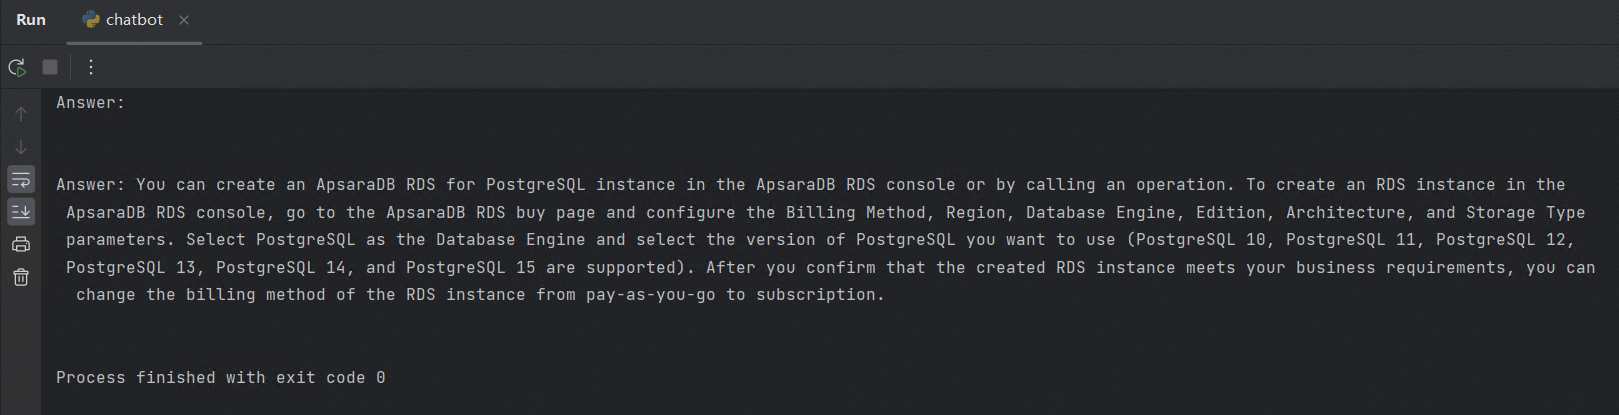
Após executar o programa Python, uma resposta correspondente aparecerá na janela de execução, semelhante ao seguinte:
NotaÉ possível otimizar o método de divisão e o prompt da pergunta para obter respostas mais precisas e completas. Este tópico fornece apenas um exemplo.
Resumo
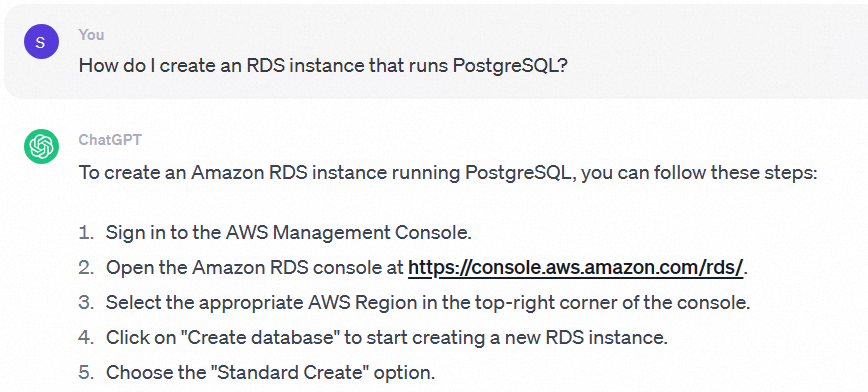
Sem uma base de conhecimento dedicada conectada, a resposta da OpenAI para a pergunta "Como crio uma instância RDS for PostgreSQL?" geralmente é irrelevante para a Alibaba Cloud. Por exemplo:
Após conectar-se à base de conhecimento dedicada armazenada no banco de dados ApsaraDB RDS for PostgreSQL, a resposta para a pergunta "Como crio uma instância RDS for PostgreSQL?" será específica para o ApsaraDB RDS for PostgreSQL da Alibaba Cloud.
Com base no exemplo anterior, fica claro que o ApsaraDB RDS for PostgreSQL é totalmente capaz de suportar a criação de uma base de conhecimento baseada em LLM para um domínio vertical.