Este documento apresenta resultados de benchmarks para índices IVFFlat no ApsaraDB RDS for PostgreSQL. Utilize esses dados para compreender como o volume de dados afeta o armazenamento e como os parâmetros lists e probes equilibram o throughput de consultas com a taxa de recall antes de ajustá-los para sua carga de trabalho.
Como funcionam os índices IVFFlat
O IVFFlat divide vetores em clusters durante a construção do índice. No momento da consulta, o banco de dados pesquisa apenas um subconjunto de clusters em vez de todos os vetores.
|
Parâmetro |
Função |
Efeito de um valor maior |
|
|
Quantidade de clusters criados durante a geração do índice |
Consultas mais rápidas (menos vetores por cluster), porém com recall menor quando os vetores de consulta estão próximos aos limites dos clusters |
|
|
Número de clusters pesquisados durante a execução da consulta |
Recall superior, mas consultas mais lentas |
Esses dois parâmetros exercem efeitos opostos sobre o recall e o throughput.
Ambiente de teste
A instância RDS e a instância ECS devem estar na mesma Virtual Private Cloud (VPC) e vSwitch para evitar variações relacionadas à rede nos resultados dos testes.
|
Componente |
Especificação |
|
Instância RDS |
PostgreSQL 16, ApsaraDB RDS High-availability Edition, instância dedicada pg.x8.2xlarge.2c (16 núcleos, 128 GB de memória) |
|
Versão do pgvector |
0.8.0 |
|
Instância ECS |
ecs.c6.xlarge (4 núcleos, 8 GiB de memória), Alibaba Cloud Linux 3 |
|
Cliente PostgreSQL |
15.1 |
|
Ferramenta de teste |
pgbench |
Pré-requisitos
Antes de começar, verifique se você possui:
Uma conta privilegiada chamada
testusere um banco de dados chamadotestdb. Consulte Crie um banco de dados e uma contaA extensão pgvector instalada no
testdb. O nome da extensão no sistema évector. Consulte Gerencie extensõesUma conexão com a instância RDS. Consulte Connect to an ApsaraDB RDS for PostgreSQL instance
Defina os dados de teste
-
Conecte-se ao
testdbe crie uma função auxiliar que gera vetores aleatórios com um determinado comprimento:CREATE OR REPLACE FUNCTION random_array(dim integer) RETURNS DOUBLE PRECISION[] AS $$ SELECT array_agg(random()) FROM generate_series(1, dim); $$ LANGUAGE SQL VOLATILE COST 1; -
Crie uma tabela para vetores de 1536 dimensões:
CREATE TABLE vtest(id BIGINT, v VECTOR(1536)); -
Insira 100.000 linhas de dados de teste:
INSERT INTO vtest SELECT i, random_array(1536)::VECTOR(1536) FROM generate_series(1, 100000) AS i; -
Crie um índice IVFFlat usando distância de cosseno com 100 listas:
CREATE INDEX ON vtest USING ivfflat(v vector_cosine_ops) WITH(lists = 100);
Execute o benchmark
Utilize o endpoint interno da instância RDS para eliminar a latência de rede como variável.
-
Crie um arquivo SQL chamado
test.sqlcom a seguinte consulta. Ela gera um vetor aleatório de 1536 dimensões e recupera os registros mais semelhantes devtestusando distância de cosseno:WITH tmp AS ( SELECT random_array(1536)::VECTOR(1536) AS vec ) SELECT id FROM vtest ORDER BY v <=> (SELECT vec FROM tmp) LIMIT FLOOR(RANDOM() * 50); -
Execute o pgbench na instância ECS. Certifique-se de que o cliente PostgreSQL esteja instalado. Consulte a documentação do pgbench para referência.
pgbench -f ./test.sql -c6 -T60 -P5 -U testuser -h pgm-bp****.pg.rds.aliyuncs.com -p 5432 -d testdbParâmetro
Descrição
-f ./test.sqlCaminho para o arquivo SQL de teste. Substitua pelo caminho real
-c6Quantidade de conexões simultâneas de clientes (6 neste teste)
-T60Duração do teste em segundos (60 segundos neste teste)
-P5Intervalo do relatório de progresso em segundos (a cada 5 segundos)
-U testuserNome de usuário do banco de dados. Substitua pelo seu nome de usuário
-h pgm-bp****.pg.rds.aliyuncs.comEndpoint interno da instância RDS
-p 5432Porta interna da instância RDS
-d testdbBanco de dados alvo
Resultados dos testes
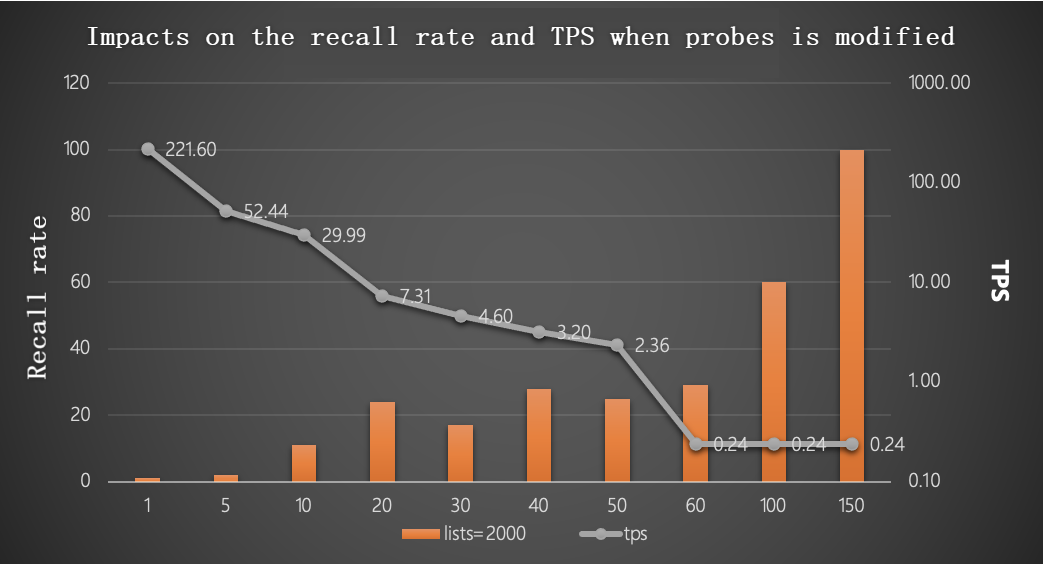
Com lists = 2000 e 1.000.000 de linhas: um valor maior de probes resulta em uma taxa de recall mais alta, mas reduz o TPS.
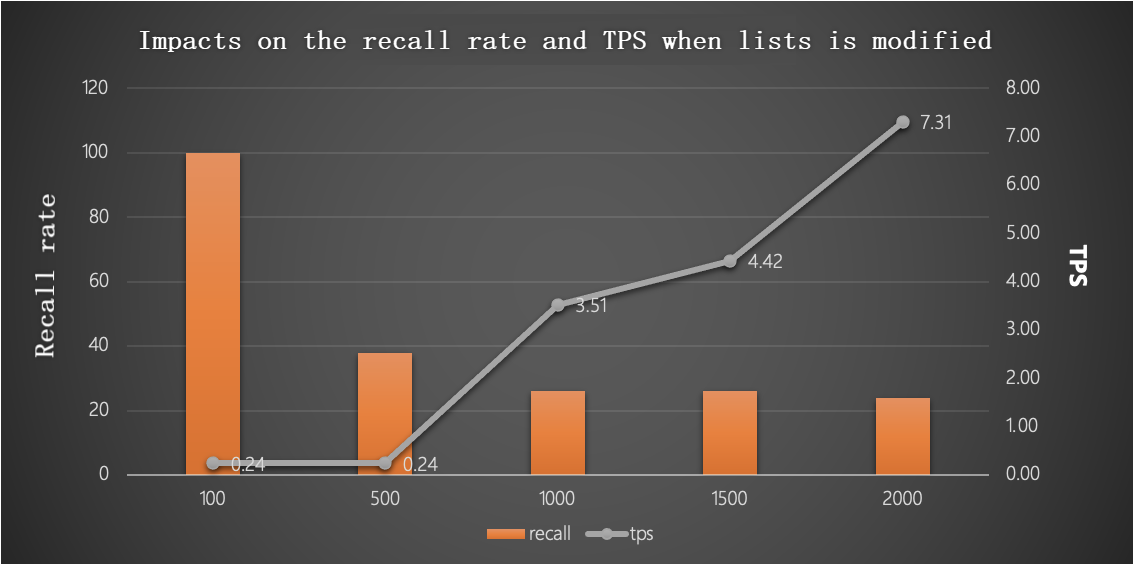
Com probes = 20 e 1.000.000 de linhas: um valor maior de lists resulta em uma taxa de recall menor, mas aumenta o TPS.
Ajuste lists e probes para produção
O gráfico a seguir ilustra o equilíbrio combinado entre recall e throughput conforme ambos os parâmetros variam.
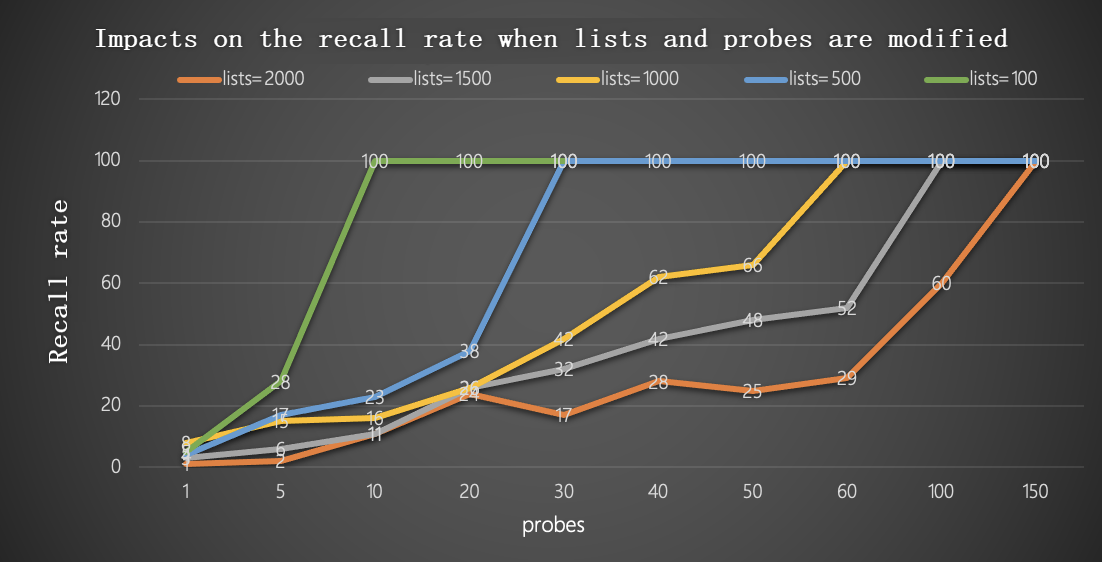
Utilize estas fórmulas como ponto de partida com base no número de linhas da sua tabela:
Até 1.000.000 de linhas:
lists  = row_count / 1,000
probes = lists / 10
Mais de 1.000.000 de linhas:
lists  = sqrt(row_count)
probes = sqrt(lists)sqrt é a função de raiz quadrada. Após aplicar as fórmulas, aumente o valor de probes se o recall for insuficiente ou diminua-o para melhorar o throughput.