Desenvolvido pela DeepSeek, o DeepSeek-R1 se destaca em matemática, programação e raciocínio. Este tópico orienta você no ajuste fino do modelo DeepSeek-R1-Distill-Qwen-7B com o PAI Model Gallery.
Modelos compatíveis
O PAI Model Gallery suporta o ajuste fino supervisionado (SFT) com LoRA para seis modelos de destilação. A tabela a seguir lista as configurações mínimas de recursos recomendadas para os hiperparâmetros padrão e o conjunto de dados fornecido.
|
Modelo de destilação |
Modelo base |
Método de treinamento compatível |
Configuração mínima |
|
DeepSeek-R1-Distill-Qwen-1,5B |
Ajuste fino supervisionado com LoRA |
1 × A10 (24 GB de memória de vídeo) |
|
|
DeepSeek-R1-Distill-Qwen-7B |
1 × A10 (24 GB de memória de vídeo) |
||
|
DeepSeek-R1-Distill-Llama-8B |
1 × A10 (24 GB de memória de vídeo) |
||
|
DeepSeek-R1-Distill-Qwen-14B |
1 × GU8IS (48 GB de memória de vídeo) |
||
|
DeepSeek-R1-Distill-Qwen-32B |
2 × GU8IS (48 GB de memória de vídeo) |
||
|
DeepSeek-R1-Distill-Llama-70B |
8 × GU100 (80 GB de memória de vídeo) |
Início rápido
-
acesse a página do Model Gallery.
Faça logon no PAI console. No painel de navegação à esquerda, selecione o Workspace de destino.
-
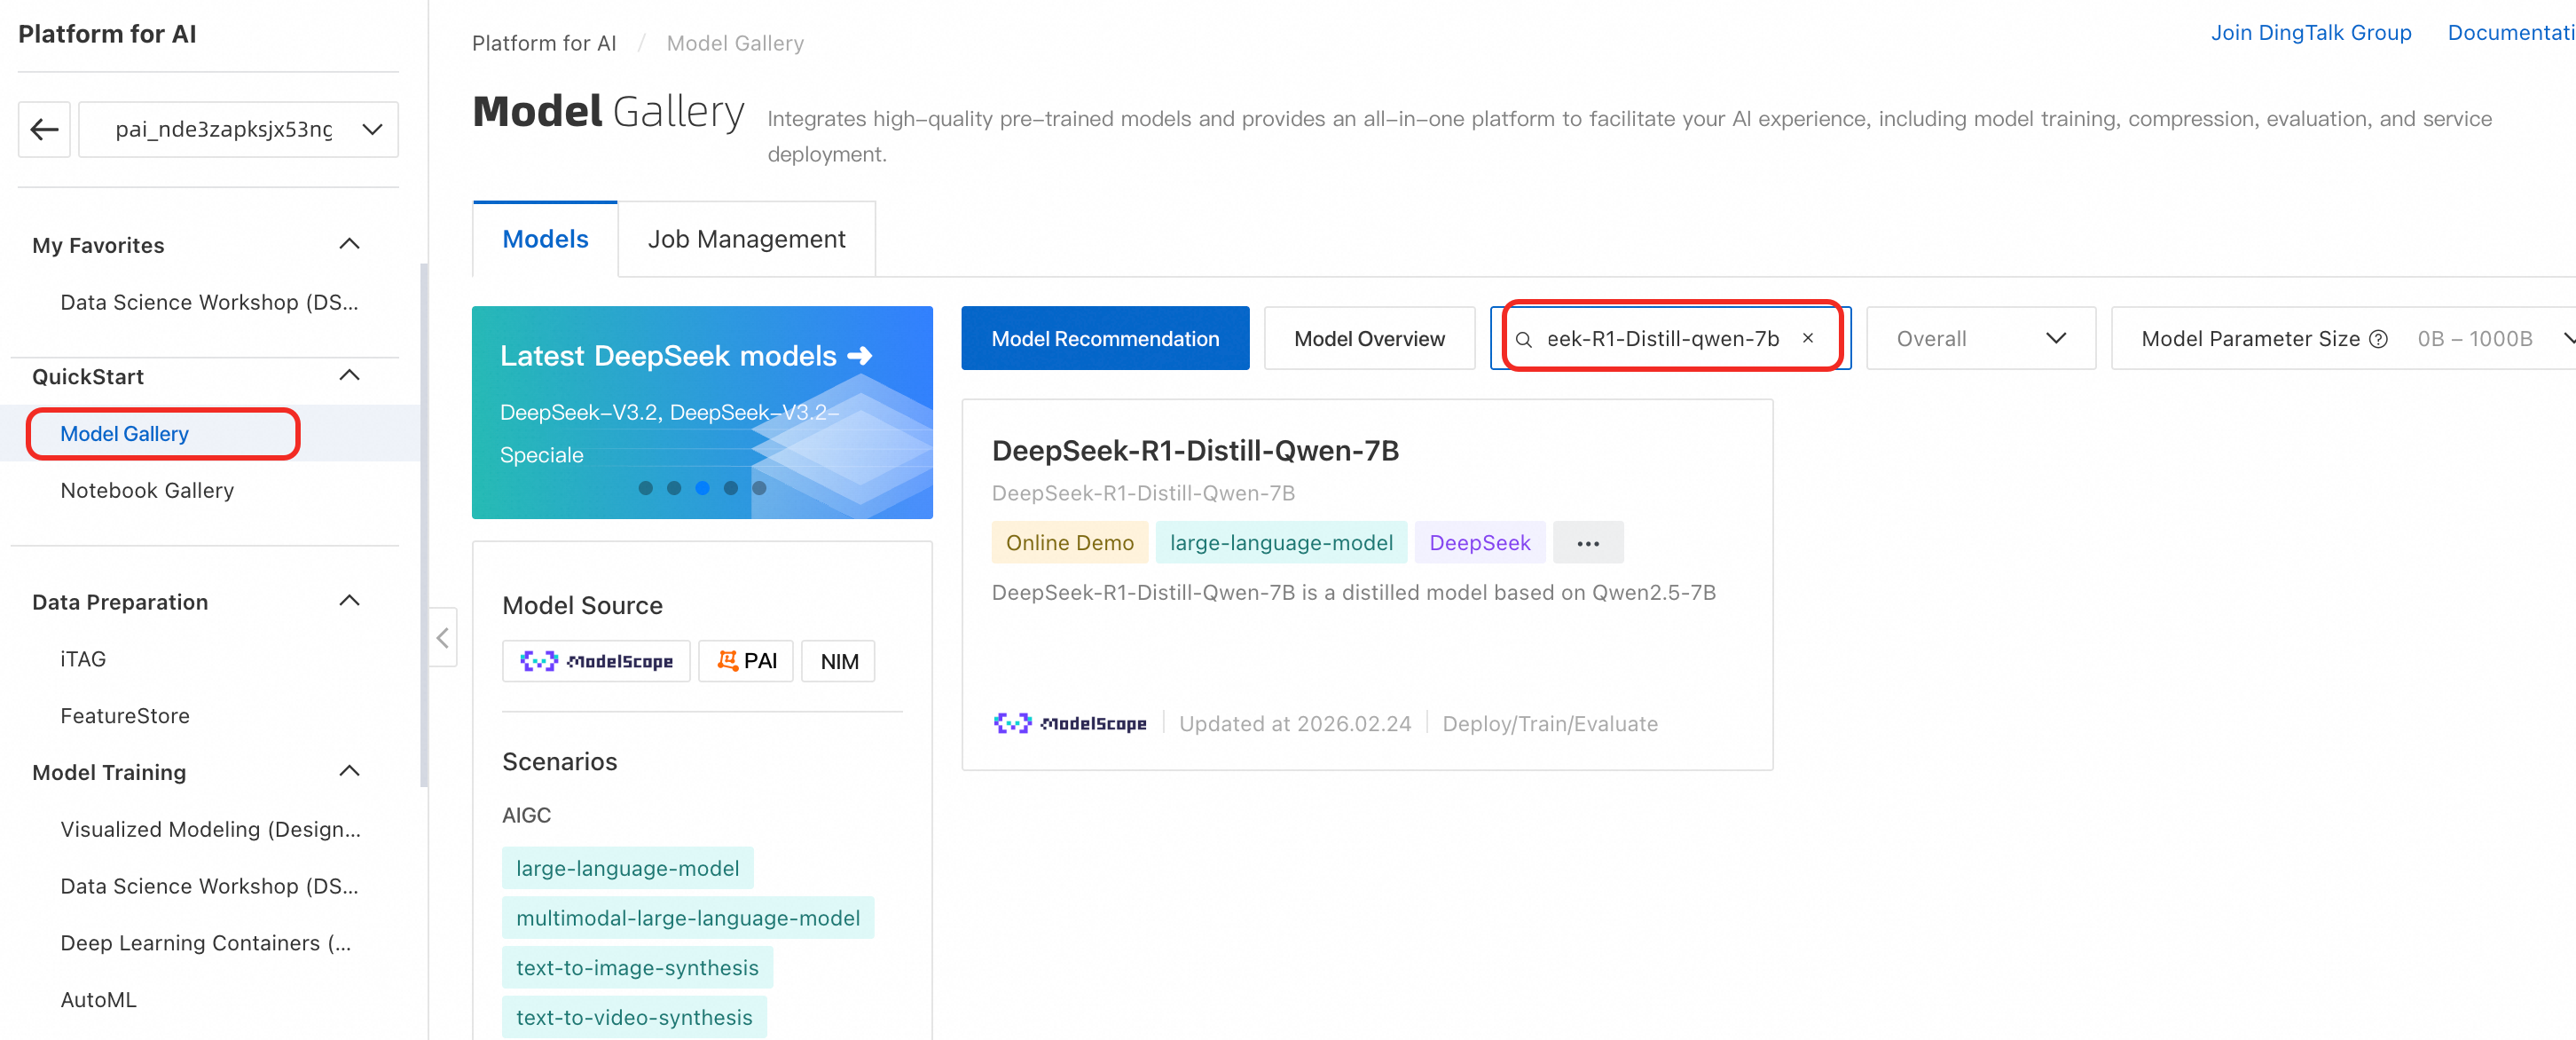
No painel de navegação à esquerda, escolha QuickStart > Model Gallery.
-
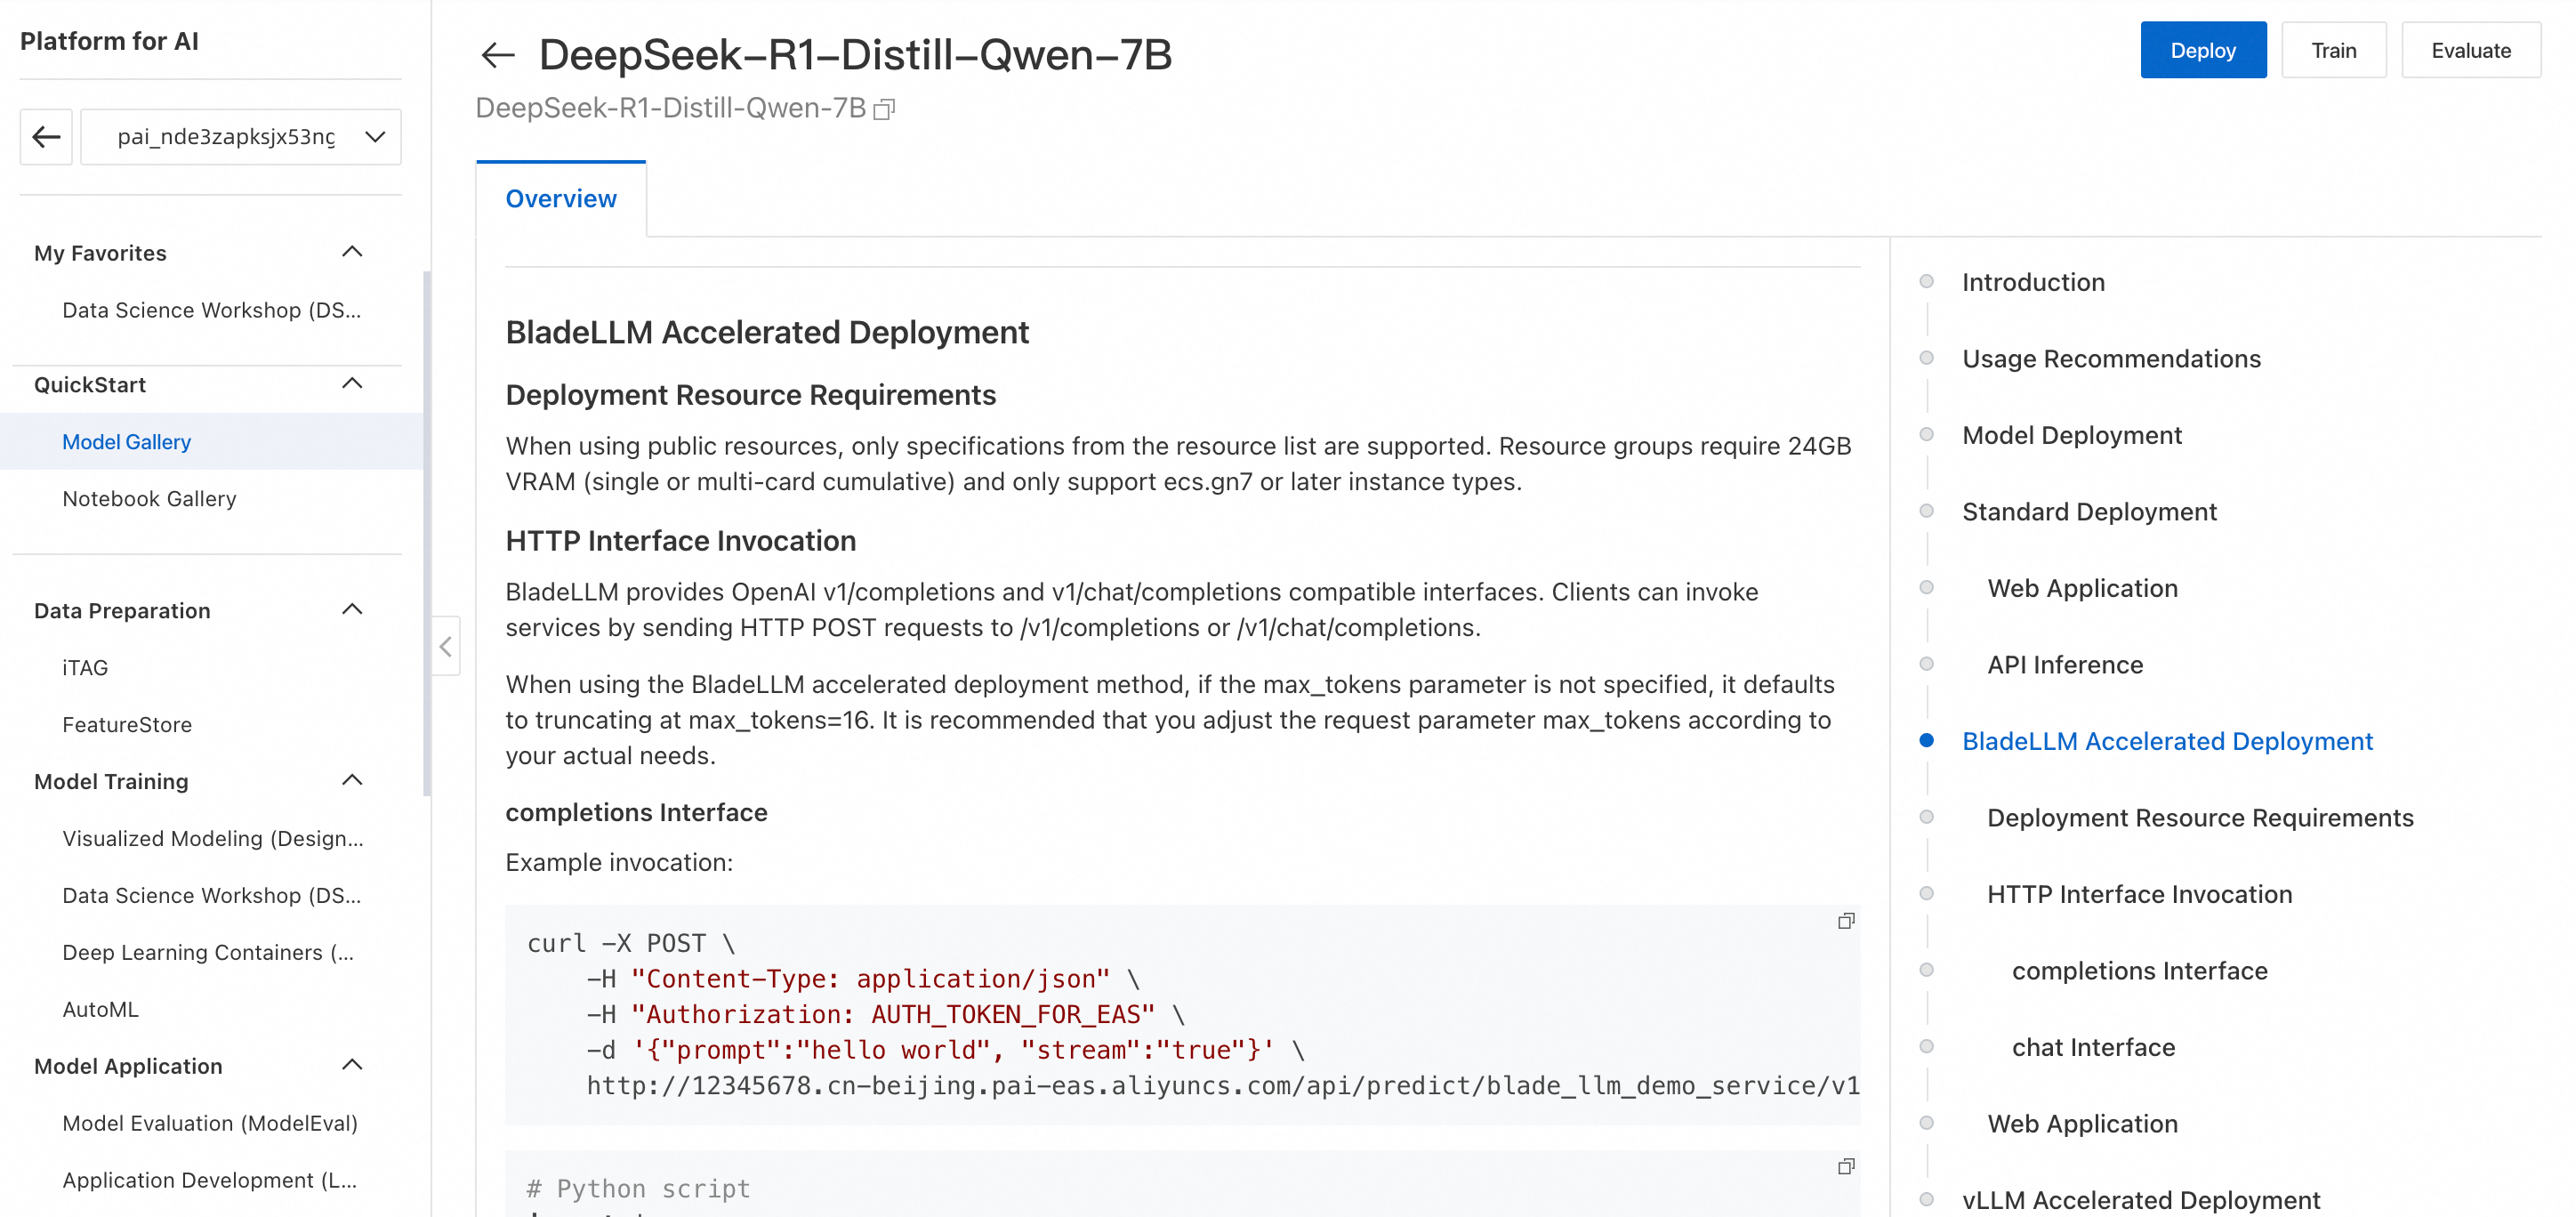
Na página do Model Gallery, pesquise e clique em DeepSeek-R1-Distill-Qwen-7B. A página de detalhes do modelo descreve o treinamento e a implantação, incluindo o formato de dados SFT obrigatório e os métodos de invocação.
-
clique em Train no canto superior direito. Configure os seguintes parâmetros principais:
Dataset: este exemplo usa o conjunto de dados padrão. Para usar seus próprios dados, prepare um conjunto de dados personalizado de acordo com o formato na página de detalhes do modelo e envie para um bucket do Object Storage Service (OSS).
Model output path: selecione um caminho do OSS para armazenar o modelo após o ajuste fino.
Compute Resource: para Source, selecione public resource. Para Instance type, selecione
ecs.gn7i-c16g1.4xlarge.-
Hyperparameters: hiperparâmetros compatíveis para SFT com LoRA. Ajuste conforme necessário. Fine-tuning guide for large language models.
-
clique em Train. O PAI redireciona você para a página do job de treinamento para monitorar o status do job e visualizar os logs.
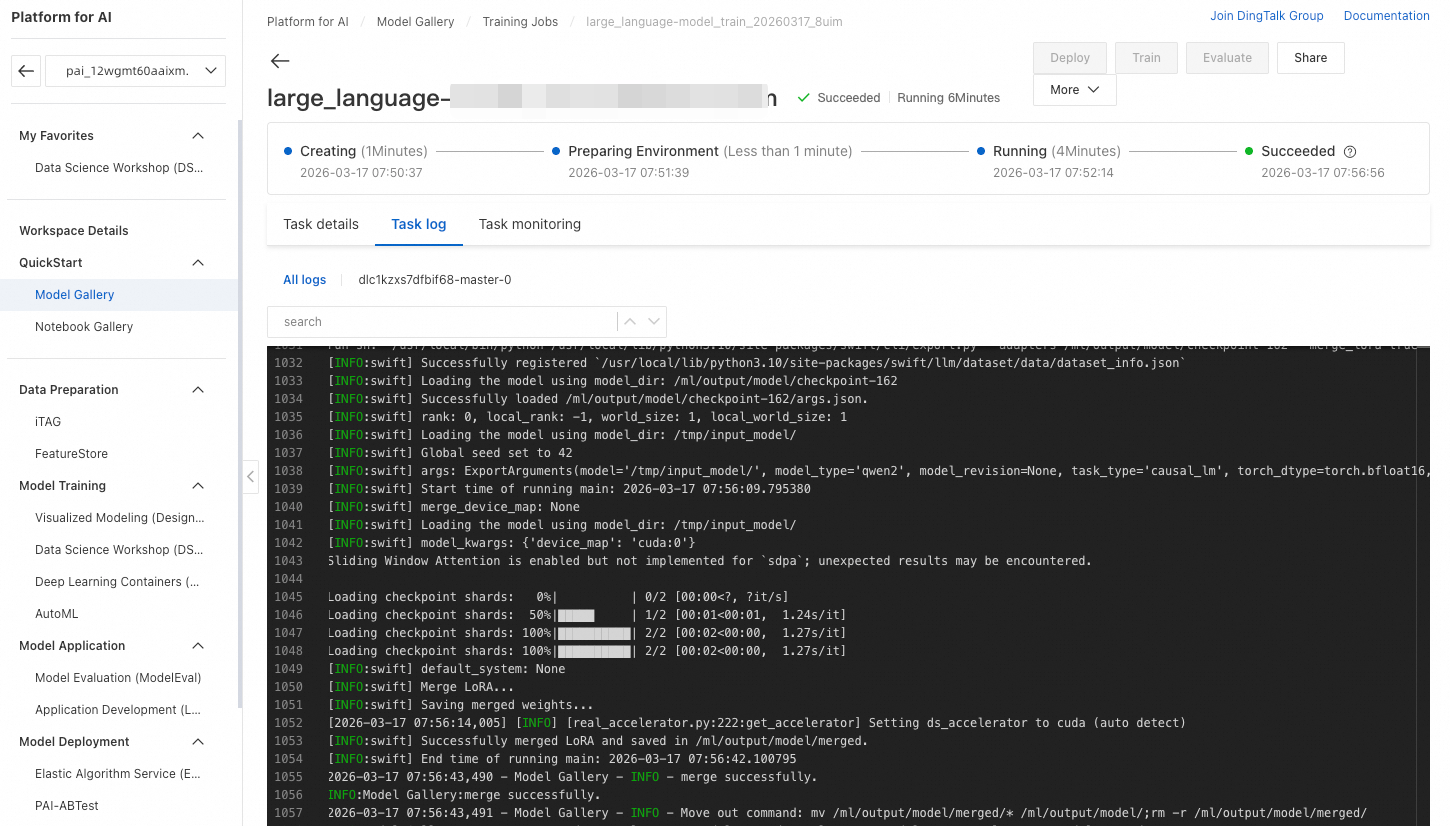
Após a conclusão bem-sucedida do treinamento, o PAI registra automaticamente o modelo ajustado em AI Asset Management - Models, para que você visualize o modelo ou implante-o. Register and manage models.
-
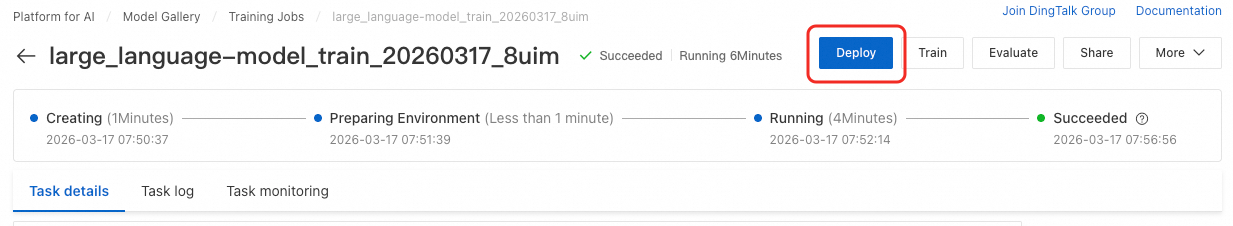
Após a conclusão do treinamento, clique em Deploy para implantar o modelo ajustado como um service do EAS. Use o mesmo método de invocação do modelo de destilação original, descrito na página de detalhes do modelo e em Deploy DeepSeek-V3 and DeepSeek-R1 models.
Faturamento
O treinamento no Model Gallery usa o DLC, cobrado pela duração do job. Billing for DLC.
Perguntas frequentes
P: Como solucionar problemas de um job de treinamento com falha?
-
defina um
max_lengthadequado na configuração de treinamento. O algoritmo descarta dados que excedem omax_lengthe registra a ação no log: Se o algoritmo descartar muitos dados, o conjunto de dados de treinamento ou validação poderá ficar vazio e causar a falha do job:

O erro
failed to compose dlc job specs, resource limiting triggered, you are trying to use more GPU resources than the thresholdsignifica que o job atingiu o limiar de recursos de GPU. Por padrão, o limite é de 2 GPUs em execução simultânea. Aguarde a conclusão dos jobs em execução ou envie um ticket para solicitar um aumento de cota.O erro
the specified vswitch vsw-**** cannot create the required resource ecs.gn7i-c32g1.8xlarge, zone not matchsignifica que o tipo de instância não está disponível na zona de disponibilidade do vSwitch. Soluções: 1. Remova a configuração do vSwitch para que o DLC selecione automaticamente uma zona disponível. 2. Mude para um tipo de instância diferente.
P: Posso baixar o modelo após o treinamento?
Sim. defina o caminho de saída do modelo para um diretório do OSS e crie o job de treinamento. Após a conclusão do job, baixe o modelo desse caminho do OSS.

P: O que devo fazer se o desempenho do modelo for ruim?
Tente o seguinte:
Use um modelo com melhor desempenho de base, como um modelo das séries DeepSeek ou Qwen3 com um número maior de parâmetros.
Refine seus prompts.
Aumente o valor de
max_tokens.Divida tarefas complexas em subtarefas menores.