O algoritmo Factorization Machine (FM) é um modelo não linear que incorpora interações de features, ideal para cenários de recomendação em e-commerce, publicidade e transmissões ao vivo. O Machine Learning Designer do Platform for AI (PAI) oferece um modelo de algoritmo FM predefinido para criar modelos de recomendação FM baseados no framework Alink.
Procedimento
-
Acesse a página do Machine Learning Designer.
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique no nome do workspace que deseja gerenciar.
No painel de navegação à esquerda, escolha .
-
Crie um pipeline.
Na página Visualized Modeling (Designer), clique na aba Preset Templates.
Nesta aba, localize o modelo [Alink]FM-Embedding for Rec-System e clique em Create.
-
Na caixa de diálogo Create Pipeline, configure os parâmetros. Use as configurações padrão para todos os parâmetros.
O parâmetro Data Storage define um caminho de bucket do OSS para armazenar dados temporários e modelos gerados durante a execução do pipeline.
-
Clique em Confirm.
A criação do pipeline leva cerca de 10 segundos.
-
Na aba Pipelines, clique no pipeline criado. Na seção Basic Information, à direita, clique em Open.
Na aba de configuração do pipeline, visualize o pipeline criado em uma tela.

Este pipeline suporta dois métodos para treinamento e previsão FM com o algoritmo Alink:
-
Método 1: Use os componentes encapsulados FM Train e FM Prediction para executar o treinamento e a previsão FM.
FM Train e FM Prediction são componentes Alink marcados com um ponto roxo e podem ser executados em grupos. Para mais informações sobre execução em grupo, consulte Alink component.
-
Método 2: Use componentes PyAlink para realizar o treinamento e a previsão FM.
Componentes PyAlink personalizados alcançam o mesmo resultado do Método 1 por meio de código Python. Para operadores suportados, consulte Visão geral do Alink.
-
-
Configure os parâmetros do nó FM Train-1.
Clique no nó FM Train-1 na tela.
-
Na aba Fields Setting do painel à direita, configure os parâmetros descritos na tabela a seguir.
Parâmetro
Descrição
Feature Columns
Nome da coluna de feature. Os dados nesta coluna seguem o formato key:value. Vários pares chave-valor na coluna de feature são separados por vírgulas (,).
Label column
Nome da coluna de rótulo. Esta coluna deve ser do tipo de dados DOUBLE.
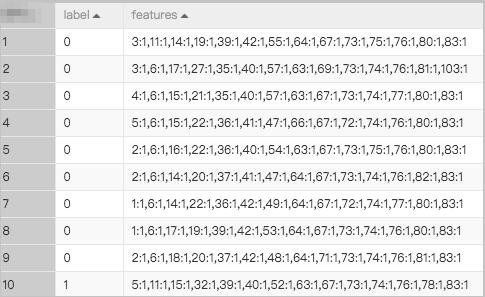
O algoritmo FM fornecido pelo Machine Learning Designer suporta apenas dados no formato LIBSVM. Converta dados em outros formatos para LIBSVM usando um componente de codificação one-hot. Para mais detalhes, consulte One-hot encoding. Os dados de entrada devem incluir uma coluna de feature e uma coluna de rótulo, conforme ilustrado na figura abaixo.
-
Nas abas Parameters Setting e Tuning do painel à direita, configure os parâmetros de treinamento.
Para um pipeline com 120 milhões de amostras e 1,3 milhão de features, use os valores recomendados na tabela abaixo e mantenha o padrão para os demais parâmetros. Ajuste esses valores conforme o volume dos seus dados.
Aba
Parâmetro
Descrição
Parameters Setting
Learning rate
Taxa de aprendizado. Valor recomendado: 0,005. Se o treinamento divergir, defina este parâmetro com um valor menor.
Dimensions
Número de dimensões. Valor recomendado: 1,1,16.
Block size
-
Tamanho do bloco. Para menos de dois milhões de registros de dados de feature, defina este parâmetro como 1.000.000.
-
Para dois milhões de registros de dados de feature ou mais, não é necessário configurar este parâmetro.
Tuning
Number of Workers
Quantidade de nós a serem utilizados. Valor recomendado: 32. Para grandes volumes de dados, defina este parâmetro com um valor maior.
Memory Size per Node (MB)
Tamanho de memória a ser alocado para cada nó. Valor recomendado: 16.384. Unidade: MB.
-
-
Escreva o código para o nó de treinamento FM PyAlink e para o nó de previsão FM PyAlink.
-
Escreva o código para o nó de treinamento FM PyAlink.
from pyalink.alink import * def main(sources, sinks, parameter): print('start') # Mode 1 for calling the Alink algorithm. # train = HugeFmTrainBatchOp().setVectorCol('features').setLabelCol('label').linkFrom(sources[0]) # Mode 2 for calling the Alink algorithm. train = HugeFmTrainBatchOp( vectorCol='features', labelCol='label', task='binary_classification', numEpochs=10) # Obtain the training data from input port 0. The trained model is generated from output port 0 and passed downstream. sources[0].link(train).link(sinks[0]) BatchOperator.execute() print('end') -
Escreva o código para o nó de previsão FM PyAlink.
from pyalink.alink import *

def main(sources, sinks, parameter):
    predictor = HugeFmPredictBatchOp().setPredictionCol("prediction_result")\
    .setPredictionDetailCol("prediction_detail").setReservedCols(["label"])
    output = predictor.linkFrom(sources[0], sources[1])
    # The prediction result is generated from the first output port and passed downstream.
    output.link(sinks[0])
    BatchOperator.execute()
    print('predict end')
-
No canto superior esquerdo da tela, clique no ícone Run.
-
Após a execução do pipeline, clique com o botão direito em um nó Binary Classification Evaluation na tela e selecione Visual Analysis.
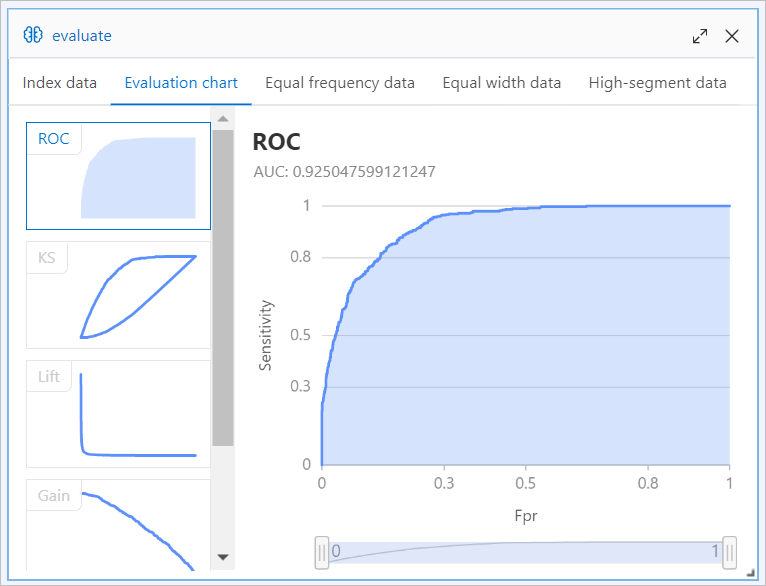
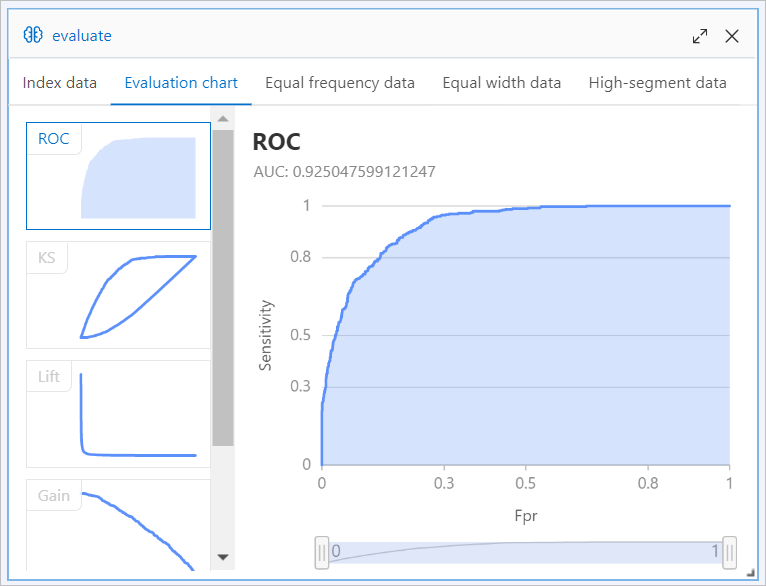
Com os dados do modelo [Alink]FM-Embedding for Rec-System, o algoritmo FM atinge uma área sob a curva (AUC) próxima de 0,92.
Relatório de avaliação gerado pelo Método 1
Relatório de avaliação gerado pelo Método 2