A codificação one-hot converte um recurso categórico com m valores possíveis em m recursos binários mutuamente exclusivos, mantendo apenas um ativo por linha. A saída é armazenada em uma estrutura chave-valor (KV) esparsa.
Funcionamento
Para cada coluna especificada, o componente mapeia cada valor distinto a um índice único e gera um indicador binário para cada mapeamento. Uma coluna com três valores distintos produz três colunas binárias, com exatamente uma definida como 1,0 por linha.
O componente oferece suporte a dois modos:
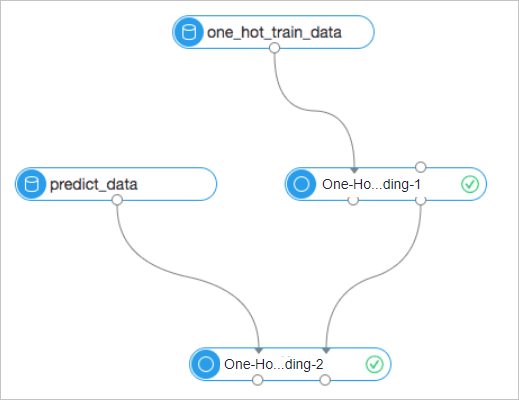
Treinamento: Lê os dados de entrada, cria uma tabela de mapeamento e grava tanto o resultado codificado quanto a tabela de modelo. Apenas o nó de entrada à esquerda (Input Table Name) é obrigatório.
Predição: Lê uma tabela de modelo criada anteriormente no nó de entrada à direita (Input Model Table) e aplica a codificação existente aos novos dados. Valores ausentes na tabela de mapeamento são ignorados e não codificados.
Configure o componente
Método 1: Configure na página do pipeline
| Aba | Parâmetro | Descrição |
|---|---|---|
| Fields setting | Select binary column | Obrigatório. Colunas a codificar. Aceita qualquer tipo de dado. |
| Other reserved features | Colunas repassadas para a saída no formato KV. Devem ser do tipo DOUBLE. Essas colunas não passam por codificação; elas são indexadas a partir de 0. | |
| Appended columns | Colunas copiadas para a tabela de saída sem transformação. | |
| Parameters setting | Output table type | KV (esparso, recomendado para recursos de alta cardinalidade) ou Table (denso, máximo de 1.024 colunas). |
| Delete encoding of last enumeration | Quando definido como true, garante a independência linear dos dados codificados. | |
| Ignore empty elements | Se definido como true, valores NULL não são codificados. Se definido como false (padrão), NULL é tratado como uma categoria distinta e recebe seu próprio índice. | |
| Lifecycle | Período de retenção da tabela de saída em dias. Padrão: 7. | |
| Cores | Número de núcleos para o job. O sistema determina o valor se o campo estiver em branco. | |
| Memory size per node | Memória alocada para cada núcleo, em MB. Intervalo válido: 2.048–65.536 MB. O sistema determina o valor se o campo estiver em branco. |
Método 2: Usar comandos PAI
Chame o componente a partir do componente SQL Script usando a seguinte sintaxe:
PAI -name one_hot
    -project algo_public
    -DinputTable=one_hot_test
    -DbinaryCols=f0,f1,f2
    -DmodelTable=one_hot_model
    -DoutputTable=one_hot_output
    -Dlifecycle=28;
Para obter mais informações sobre como chamar comandos PAI, consulte Script SQL.
Referência de parâmetros
|
Parâmetro |
Obrigatório |
Padrão |
Descrição |
|
|
Sim |
— |
Nome da tabela de entrada. |
|
|
Não |
Todas as partições |
Partições da tabela de entrada a usar durante o treinamento. |
|
|
Sim |
— |
Lista separada por vírgulas das colunas a codificar. Aceita recursos de enumeração de qualquer tipo de dado. |
|
|
Não |
Vazio |
Colunas repassadas no formato KV. Devem ser do tipo DOUBLE. Essas colunas não passam por codificação e são indexadas a partir de 0. |
|
|
Não |
— |
Colunas copiadas para a tabela de saída sem transformação. |
|
|
Sim |
— |
Nome da tabela de saída. Os resultados são armazenados no formato KV por padrão. |
|
|
Não |
Vazio |
Tabela de modelo existente a usar para predição. |
|
|
Não |
Vazio |
Nome da tabela de modelo a gravar durante o treinamento. |
|
|
Não |
7 |
Período de retenção da tabela de saída em dias. |
|
|
Sim |
false |
Quando true, remove a última coluna binária de cada recurso para garantir a independência linear dos dados codificados. |
|
|
Sim |
kv |
Formato de saída. |
|
|
Sim |
false |
Quando true, valores NULL são ignorados durante a codificação. Quando false, NULL é tratado como uma categoria distinta com seu próprio índice. |
|
|
Não |
Determinado pelo sistema |
Número de núcleos para o job. |
|
|
Não |
Determinado pelo sistema |
Memória por núcleo em MB. Intervalo válido: 2.048–65.536 MB. |
Nota: Ao usar um modelo treinado para codificações subsequentes, os parâmetrosdropLast,ignoreNullereserveColsficam bloqueados nos valores definidos durante o treinamento e não podem ser alterados. Para usar valores diferentes para esses parâmetros, retreine o modelo.
Exemplo
O exemplo a seguir codifica três colunas — f0 (BIGINT), f2 (DATETIME) e f4 (BOOLEAN) — enquanto repassa f3 (DOUBLE) como recurso reservado e anexa as colunas originais f0, f2 e f4 à saída.
Etapa 1: Dados de entrada de amostra
|
f0 (BIGINT) |
f1 (STRING) |
f2 (DATETIME) |
f3 (DOUBLE) |
f4 (BOOLEAN) |
|
12 |
prefix1 |
1970-09-15 12:50:22 |
0,1 |
true |
|
12 |
prefix3 |
1971-01-22 03:15:33 |
0,4 |
false |
|
NULL |
prefix3 |
1970-01-01 08:00:00 |
0,2 |
NULL |
|
3 |
NULL |
1970-01-01 08:00:00 |
0,3 |
false |
|
34 |
NULL |
1970-09-15 12:50:22 |
0,4 |
NULL |
|
3 |
prefix1 |
1970-09-15 12:50:22 |
0,2 |
true |
|
3 |
prefix1 |
1970-09-15 12:50:22 |
0,3 |
false |
|
3 |
prefix3 |
1970-01-01 08:00:00 |
0,2 |
true |
|
3 |
prefix3 |
1971-01-22 03:15:33 |
0,1 |
false |
|
NULL |
prefix3 |
1970-01-01 08:00:00 |
0,3 |
false |
Etapa 2: Comando PAI
PAI -project algo_public -name one_hot
    -DinputTable=one_hot
    -DbinaryCols=f0,f2,f4
    -DoutputModelTable=one_hot_model_8
    -DoutputTable=one_hot_in_table_1_output_8
    -DdropLast=false
    -DappendCols=f0,f2,f4
    -DignoreNull=false
    -DoutputTableType=table
    -DreserveCols=f3
    -DcoreNum=4
    -DmemSizePerCore=2048;
Etapa 3: Saída
A tabela de modelo mapeia cada valor distinto a um índice. A primeira linha (com col_name fixo em _reserve_) armazena o mapeamento da coluna reservada. Todas as outras linhas correspondem aos mapeamentos de codificação.
|
col_name |
col_value |
mapping |
|
_reserve_ |
f3 |
0 |
|
f0 |
12 |
1 |
|
f0 |
3 |
2 |
|
f0 |
34 |
3 |
|
f0 |
null |
4 |
|
f2 |
0 |
5 |
|
f2 |
22222222000 |
6 |
|
f2 |
33333333000 |
7 |
|
f4 |
0 |
8 |
|
f4 |
1 |
9 |
|
f4 |
null |
10 |
Table
A tabela de resultados codificados (formato Table) usa o padrão de nomenclatura de coluna {field}_{value}_{index}:
|
f0 |
f2 |
f4 |
_reserve__f3_0 |
f0_12_1 |
f0_3_2 |
f0_34_3 |
f0_null_4 |
f2_0_5 |
f2_22222222_6 |
f2_33333333_7 |
f4_0_8 |
f4_1_9 |
f4_null_10 |
|
12 |
1970-09-15 12:50:22 |
true |
0,1 |
1,0 |
0,0 |
0,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
|
12 |
1971-01-22 03:15:33 |
false |
0,4 |
1,0 |
0,0 |
0,0 |
0,0 |
0,0 |
0,0 |
1,0 |
1,0 |
0,0 |
0,0 |
|
NULL |
1970-01-01 08:00:00 |
NULL |
0,2 |
0,0 |
0,0 |
0,0 |
1,0 |
1,0 |
0,0 |
0,0 |
0,0 |
0,0 |
1,0 |
|
3 |
1970-01-01 08:00:00 |
false |
0,3 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
|
34 |
1970-09-15 12:50:22 |
NULL |
0,4 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
0,0 |
1,0 |
|
3 |
1970-09-15 12:50:22 |
true |
0,2 |
0,0 |
1,0 |
0,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
|
3 |
1970-09-15 12:50:22 |
false |
0,3 |
0,0 |
1,0 |
0,0 |
0,0 |
0,0 |
1,0 |
0,0 |
1,0 |
0,0 |
0,0 |
|
3 |
1970-01-01 08:00:00 |
true |
0,2 |
0,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
0,0 |
1,0 |
0,0 |
|
3 |
1971-01-22 03:15:33 |
false |
0,1 |
0,0 |
1,0 |
0,0 |
0,0 |
0,0 |
0,0 |
1,0 |
1,0 |
0,0 |
0,0 |
|
NULL |
1970-01-01 08:00:00 |
false |
0,3 |
0,0 |
0,0 |
0,0 |
1,0 |
1,0 |
0,0 |
0,0 |
1,0 |
0,0 |
0,0 |
KV
Os mesmos dados no formato KV:
|
f0 |
f2 |
f4 |
kv |
|
12 |
1970-09-15 12:50:22 |
true |
0:0,1,1:1,6:1,9:1 |
|
12 |
1971-01-22 03:15:33 |
false |
0:0,4,1:1,7:1,8:1 |
|
NULL |
1970-01-01 08:00:00 |
NULL |
0:0,2,4:1,5:1,10:1 |
|
3 |
1970-01-01 08:00:00 |
false |
0:0,3,2:1,5:1,8:1 |
|
34 |
1970-09-15 12:50:22 |
NULL |
0:0,4,3:1,6:1,10:1 |
|
3 |
1970-09-15 12:50:22 |
true |
0:0,2,2:1,6:1,9:1 |
|
3 |
1970-09-15 12:50:22 |
false |
0:0,3,2:1,6:1,8:1 |
|
3 |
1970-01-01 08:00:00 |
true |
0:0,2,2:1,5:1,9:1 |
|
3 |
1971-01-22 03:15:33 |
false |
0:0,1,2:1,7:1,8:1 |
|
NULL |
1970-01-01 08:00:00 |
false |
0:0,3,4:1,5:1,8:1 |
Teste de escalabilidade
Dados de teste: 200 milhões de amostras, 100.000 valores de enumeração distintos.
|
Contagem de núcleos |
Tempo de treinamento |
Tempo de predição |
Taxa de aceleração |
|
5 |
84s |
181s |
1/1 |
|
10 |
60s |
93s |
1,4/1,95 |
|
20 |
46s |
56s |
1,8/3,23 |
Notas de uso
Uma única coluna de codificação pode ter até dezenas de milhões de valores distintos.
A saída KV usa indexação baseada em zero.
Ao prever com um modelo treinado,
dropLast,ignoreNullereserveColspermanecem fixos nos valores do treinamento e não podem ser substituídos. Retreine o modelo caso precise de valores diferentes.Se os novos dados codificados pelo modelo contiverem valores discretos ausentes na tabela de mapeamento, esses valores serão ignorados e não codificados. Para incluir tais valores, retreine a tabela de mapeamento do modelo.
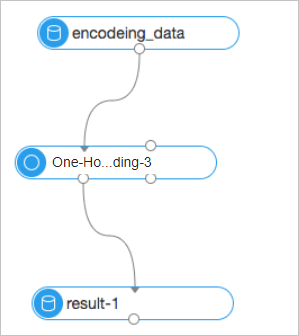
Exemplos de fluxo de trabalho no console:
Use o componente diretamente para codificação.
Treine um modelo com o componente e use-o para codificar novos dados.