Este tópico descreve como criar, ler e gravar dados em tabelas externas Parquet no Object Storage Service (OSS).
Escopo
As tabelas externas do OSS não suportam a propriedade de cluster.
O tamanho de um único arquivo não pode exceder 2 GB. Divida os arquivos maiores que 2 GB.
O MaxCompute e o OSS devem estar na mesma região.
Descrição de permissões
Ao acessar tabelas externas do OSS, o sistema utiliza a função especificada no parâmetro
odps.properties.rolearn, seja com uma conta Alibaba Cloud, um usuário RAM ou uma função RAM. Portanto, crie uma função RAM, conceda permissões para acessar o bucket do OSS de destino e configure o ARN da função no parâmetroodps.properties.rolearn. Para mais informações, consulte Parâmetros.Autorize o acesso na mesma conta ou entre contas diferentes, de acordo com os requisitos do seu negócio. Recomendamos o uso de uma política de autorização personalizada para um controle de acesso mais refinado. Para mais informações, consulte Autorização para fontes de dados externas.
Criar uma tabela externa
Sintaxe
Quando o schema do arquivo Parquet difere do schema da tabela externa:
Incompatibilidade na quantidade de colunas: se o arquivo Parquet tiver menos colunas do que as definidas na DDL da tabela externa, as colunas ausentes retornarão NULL. Se o arquivo tiver mais colunas, o sistema ignorará as colunas extras.
Incompatibilidade no tipo de coluna: se o tipo de uma coluna no arquivo Parquet não corresponder ao tipo correspondente na DDL, a operação de leitura falhará. Por exemplo, ocorrerá um erro como
ODPS-0123131:User defined function exception - Traceback:xxxse você tentar ler uma coluna INT como um campo STRING.
Sintaxe simplificada
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
STORED AS parquet
LOCATION '<oss_location>'
[tblproperties ('<tbproperty_name>'='<tbproperty_value>',...)];
Sintaxe detalhada
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
WITH serdeproperties(
    'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>',
    'mcfed.parquet.compression'='ZSTD/SNAPPY/GZIP'
)
STORED AS parquet
LOCATION '<oss_location>'
;
Parâmetros comuns
Para mais informações sobre os parâmetros comuns, consulte Parâmetros de sintaxe básica.
Parâmetros específicos
Parâmetros with serdeproperties
Nome da propriedade | Quando usar | Descrição | Valor da propriedade | Padrão |
mcfed.parquet.compression | Adicione esta propriedade para gravar dados Parquet no OSS em formato compactado. | Propriedade de compactação do Parquet. Por padrão, os dados Parquet não são compactados. |
| Nenhum |
mcfed.parquet.compression.codec.zstd.level | Adicione esta propriedade quando | Um nível mais alto aumenta a taxa de compactação. No entanto, testes mostram que níveis altos proporcionam ganhos mínimos na redução do tamanho dos dados, ao mesmo tempo que aumentam significativamente o tempo e o consumo de recursos. Para cenários de big data, um nível baixo de ZSTD (3 a 5) oferece o melhor equilíbrio entre desempenho e compactação. Por exemplo: | O valor pode variar de 1 a 22. | 3 |
parquet.file.cache.size | Adicione esta propriedade para melhorar o desempenho da leitura de arquivos de dados do OSS ao processar dados Parquet. | Especifica a quantidade de dados que o sistema pode armazenar em cache ao ler arquivos de dados do OSS. Unidade: KB. | 1024 | Nenhum |
parquet.io.buffer.size | Adicione esta propriedade para melhorar o desempenho da leitura de arquivos de dados do OSS ao processar dados Parquet. | Especifica a quantidade de dados que o sistema pode armazenar em cache quando o tamanho do arquivo de dados do OSS excede 1024 KB. Unidade: KB. | 4096 | Nenhum |
Parâmetros tblproperties
Nome da propriedade | Quando usar | Descrição | Valor da propriedade | Padrão |
io.compression.codecs | Adicione esta propriedade se os seus arquivos de dados do OSS estiverem no formato Raw-Snappy. | Habilita o parser de código aberto integrado para o formato SNAPPY. Se você definir este parâmetro como True, o MaxCompute poderá ler os dados compactados. Caso contrário, a operação de leitura falhará. | com.aliyun.odps.io.compress.SnappyRawCodec. | Nenhum |
odps.external.data.output.prefix (Compatível com odps.external.data.prefix) | Adicione esta propriedade para especificar um prefixo personalizado para os arquivos de saída. |
| Uma combinação válida de caracteres, como 'mc_'. | Nenhum |
odps.external.data.enable.extension | Adicione esta propriedade para exibir a extensão dos arquivos de saída. | Defina como True para exibir a extensão do arquivo. Caso contrário, a extensão ficará oculta. |
| False |
odps.external.data.output.suffix | Adicione esta propriedade para especificar um sufixo personalizado para os arquivos de saída. | Deve conter apenas letras, dígitos e sublinhados (a-z, A-Z, 0-9, _). | Uma combinação válida de caracteres, como '_hangzhou'. | Nenhum |
odps.external.data.output.explicit.extension | Adicione esta propriedade para especificar uma extensão personalizada para os arquivos de saída. |
| Uma combinação válida de caracteres, como "jsonl". | Nenhum |
odps.ext.column.mapping | Adicione esta propriedade quando os nomes dos campos nos arquivos de dados do OSS contiverem caracteres especiais. | Esta propriedade define mapeamentos personalizados de nomes de colunas. Por exemplo, se os campos do arquivo OSS forem id BIGINT, $_test DOUBLE e =name STRING, defina o valor do parâmetro como t_test:$_test,t_name:=_name ao criar a tabela externa. Você só precisa especificar mapeamentos para campos que contêm caracteres especiais. | Sem valor fixo | Nenhum |
odps.ext.column.mapping.delimiters (Use apenas quando os caracteres nos nomes das colunas entrarem em conflito com os delimitadores padrão nos mapeamentos de nomes de colunas. Geralmente não recomendado.) | Adicione esta propriedade quando os nomes das colunas contiverem os caracteres especiais | Esta propriedade personaliza os delimitadores intra-grupo e inter-grupo para pares chave-valor. O valor deve conter exatamente dois caracteres: o primeiro caractere serve como delimitador chave-valor, e o segundo caractere serve como delimitador entre diferentes pares chave-valor. | Sem valor fixo. Exemplo: | Valor padrão:
|
mcfed.parquet.compression | Adicione esta propriedade para gravar dados Parquet no OSS em formato compactado. Nenhum parâmetro extra é necessário para ler arquivos compactados. | Propriedade de compactação do Parquet. Por padrão, os dados Parquet não são compactados. |
| Nenhum |
mcfed.parquet.block.size | Controla o tamanho do bloco dos arquivos Parquet, o que afeta a eficiência de armazenamento e o desempenho de leitura. | Propriedade de ajuste do Parquet. Define o tamanho do bloco Parquet em bytes. | Inteiro não negativo | 134217728 (128 MB) |
mcfed.parquet.block.row.count.limit | Ao gravar dados em uma tabela externa Parquet, limita o número de registros em cada grupo de linhas para evitar erros de falta de memória (OOM). | Propriedade de ajuste do Parquet. Controla o número máximo de registros por grupo de linhas. Se ocorrer um erro OOM, reduza o valor deste parâmetro. Sugestão:
| Inteiro não negativo | 2147483647 (Integer.MAX_VALUE) |
mcfed.parquet.page.size.row.check.min | Ao gravar dados em uma tabela externa Parquet, controla a frequência das verificações de memória para evitar erros OOM. | Propriedade de ajuste do Parquet. Limita o número mínimo de registros entre as verificações de memória. Se ocorrer um erro OOM, reduza o valor deste parâmetro. | Inteiro não negativo | 100 |
mcfed.parquet.page.size.row.check.max | Ao gravar dados em uma tabela externa Parquet, controla a frequência das verificações de memória para evitar erros OOM. | Propriedade de ajuste do Parquet. Limita o número mínimo de registros entre as verificações de memória. Se ocorrer um erro OOM, reduza o valor deste parâmetro. Como as verificações frequentes de memória adicionam sobrecarga, o ajuste deste parâmetro pode afetar o desempenho. Recomendações de parâmetros:
| Inteiro não negativo | 1000 |
mcfed.parquet.compression.codec.zstd.level | Adicione esta propriedade para especificar o nível de compactação do algoritmo ZSTD ao gravar dados Parquet no OSS com compactação ZSTD. | Propriedade de compactação do Parquet. Especifica o nível de compactação do algoritmo ZSTD. O valor pode variar de 1 a 22. | Inteiro não negativo | 3 |
Lista de permissões e lista de bloqueios
As tabelas externas do OSS no MaxCompute suportam filtragem por lista de permissões e lista de bloqueios. Defina os parâmetros de lista de permissões e lista de bloqueios em tblproperties para filtrar os arquivos a serem lidos de um diretório. Para mais detalhes, consulte Lista de permissões e lista de bloqueios.
Gravar dados
Para mais detalhes sobre a sintaxe de gravação no MaxCompute, consulte Sintaxe de gravação.
Consulta e análise
Consulte Sintaxe de consulta para obter detalhes sobre a sintaxe SELECT.
Consulte Otimização de consulta para obter detalhes sobre a otimização de planos de consulta.
Para mais informações sobre como ler arquivos LOCATION diretamente, consulte Consulta sem schema.
-
Otimização de consulta: as tabelas externas Parquet suportam otimização de consulta ao ativar o Predicate Push Down (PPD). Para resultados de desempenho, consulte Suporte ao Predicate Push Down (Parquet PPD).
Adicione os seguintes parâmetros antes da sua instrução SQL para ativar o PPD:
-- PPD parameters must be used in Native mode, which means the Native switch must be set to true.
-- Enable the Parquet native reader.
SET odps.ext.parquet.native = true;
-- Enable Parquet PPD.
SET odps.sql.parquet.use.predicate.pushdown = true;
Suporte ao Predicate Push Down (Parquet PPD)
Por padrão, as tabelas externas Parquet não suportam o Predicate Push Down (PPD). Quando você executa uma consulta com uma condição de filtro WHERE, o MaxCompute verifica todos os dados. Isso causa E/S desnecessária, consumo de recursos e latência de consulta. Para resolver esse problema, ative o PPD usando um parâmetro. Esse recurso utiliza os metadados nos arquivos Parquet para filtrar dados no nível do grupo de linhas durante a fase de verificação, o que melhora o desempenho da consulta e reduz o consumo de recursos e os custos.
Uso
-
Ativar o Predicate Push Down (PPD)
Antes de executar uma consulta SQL, use o comando
setpara definir os dois parâmetros a seguir no nível da sessão e ativar o PPD para Parquet.-- Enable the Parquet native reader. set odps.ext.parquet.native = true; -- Enable Parquet PPD. set odps.sql.parquet.use.predicate.pushdown = true; -
Exemplo
Este exemplo usa um conjunto de dados de teste TPC-DS de 1 TB e a tabela externa Parquet
tpcds_1t_store_sales. Neste exemplo, com o PPD ativado, executamos uma consulta de filtro. O volume total de dados é de2,879,987,999linhas.-- Create the external table tpcds_1t_store_sales. CREATE EXTERNAL TABLE IF NOT EXISTS tpcds_1t_store_sales ( ss_sold_date_sk BIGINT, ss_sold_time_sk BIGINT, ss_item_sk BIGINT, ss_customer_sk BIGINT, ss_cdemo_sk BIGINT, ss_hdemo_sk BIGINT, ss_addr_sk BIGINT, ss_store_sk BIGINT, ss_promo_sk BIGINT, ss_ticket_number BIGINT, ss_quantity BIGINT, ss_wholesale_cost DECIMAL(7,2), ss_list_price DECIMAL(7,2), ss_sales_price DECIMAL(7,2), ss_ext_discount_amt DECIMAL(7,2), ss_ext_sales_price DECIMAL(7,2), ss_ext_wholesale_cost DECIMAL(7,2), ss_ext_list_price DECIMAL(7,2), ss_ext_tax DECIMAL(7,2), ss_coupon_amt DECIMAL(7,2), ss_net_paid DECIMAL(7,2), ss_net_paid_inc_tax DECIMAL(7,2), ss_net_profit DECIMAL(7,2) ) ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe' WITH serdeproperties( 'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>', 'mcfed.parquet.compression'='zstd' ) STORED AS parquet LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss_bucket_path/'; -- Use the 1 TB TPC-DS test dataset. INSERT OVERWRITE TABLE tpcds_1t_store_sales SELECT ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit FROM bigdata_public_dataset.tpcds_1t.store_sales; -- Run the query. SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales WHERE ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Comparação de desempenho
Ativar o PPD reduz a quantidade de dados verificados, o que diminui a latência da consulta e o consumo de recursos.
|
Modo |
Total de linhas na tabela |
Linhas verificadas |
Bytes verificados |
Tempo do Mapper |
Consumo total de recursos |
Descrição |
|
Tabela externa Parquet sem PPD |
2.879.987.999 |
2.879.987.999 (100%) |
19386793984 (100%) |
18s |
CPU 19,25 Core-minutos, Memória 24,07 GB-minutos 100% |
|
|
Tabela externa Parquet com PPD |
2.879.987.999 |
762.366.649 (26,47%) |
3.339.386.880 (17,22%) |
12s |
cpu 11,47 Core × Min, memória 14,33 GB × Min ~59,58% |
A redução na verificação de dados diminui significativamente a latência e o consumo de recursos. |
|
Tabela interna com PPD |
2.879.987.999 |
32.830.000 (1,14%) |
1.633.880.386 (8,43%) |
9s |
cpu 5,62 Core × Min, memória 7,02 GB × Min ~29,19% |
O PPD é mais eficaz em tabelas internas porque os dados estão ordenados. |
Detalhes do teste
-
Tabela externa Parquet sem PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = false;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;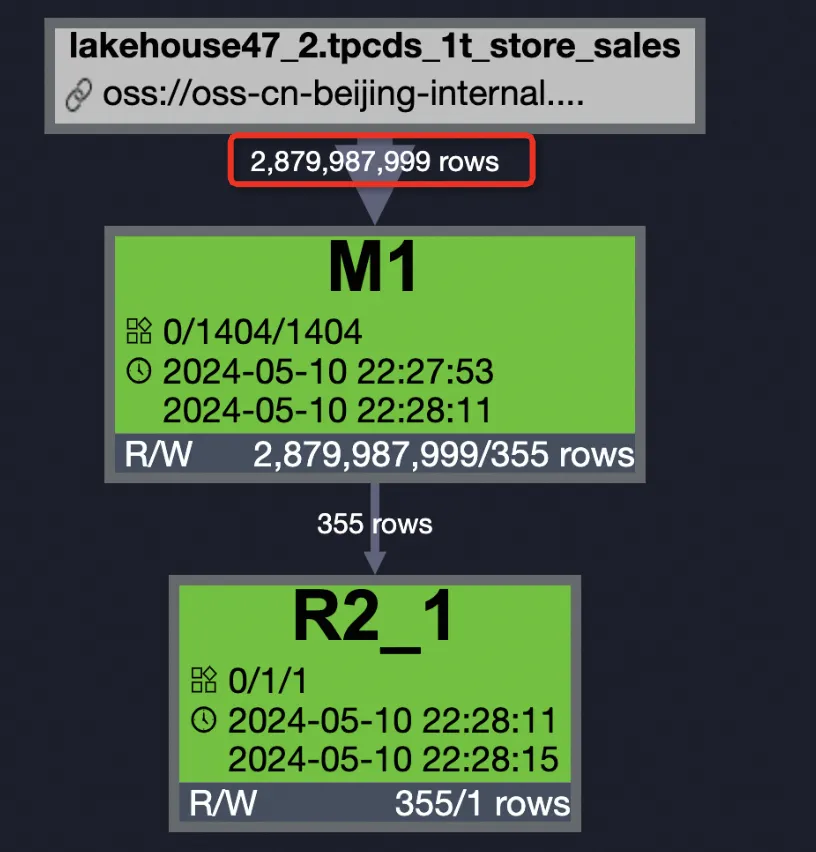
Os resultados mostram que, para a tarefa M1 em Fuxi Jobs, IO Records Input é 2,9 G, IO Bytes Input é 18,06 GB e Latency é 00:00:18.000.
A aba Summary dos resultados de execução mostra que o consumo de recursos é cpu
19.25 Core × Mine memória24.07 GB × Min. O tempo de execução do job é de23.000segundos, e o modo de execução éfuxi job 2.0. A tarefa M1 tem 1.404 instâncias, tempo de execução de18.000segundos, 2.879.987.999 registros de entrada e 355 registros de saída. A tarefa R2_1 tem 1 instância, tempo de execução de4.000segundos e 1 registro de saída. -
Tabela externa Parquet com PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = true;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;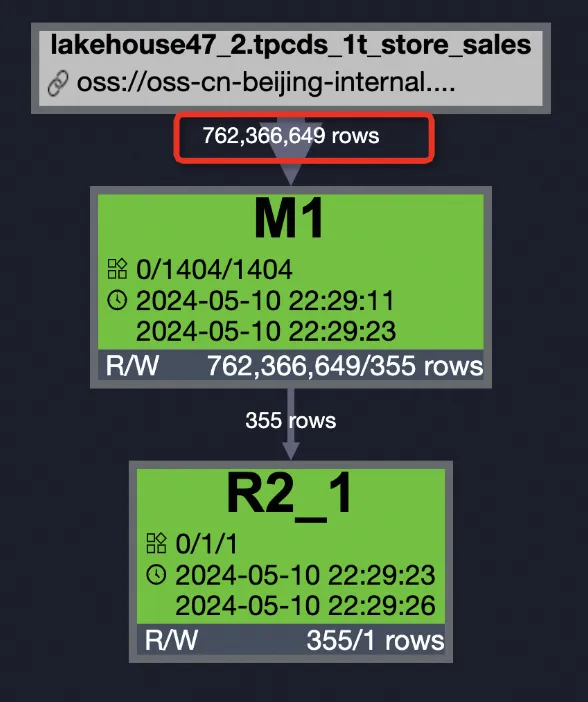
Após executar esta consulta, o Summary do job mostra que o consumo de recursos é
cpu 11.47 Core × Min, memory 14.33 GB × Min, com um tempo total de execução de 15 segundos. O estágio M1 tem 1.404 instâncias, tempo de execução de 12 segundos e 762.366.649 registros de entrada (aproximadamente 3.339.386.880 bytes). O estágio R2_1 tem 1 instância e tempo de execução de 3 segundos.Muitos mappers estão vazios e não precisam ler dados:
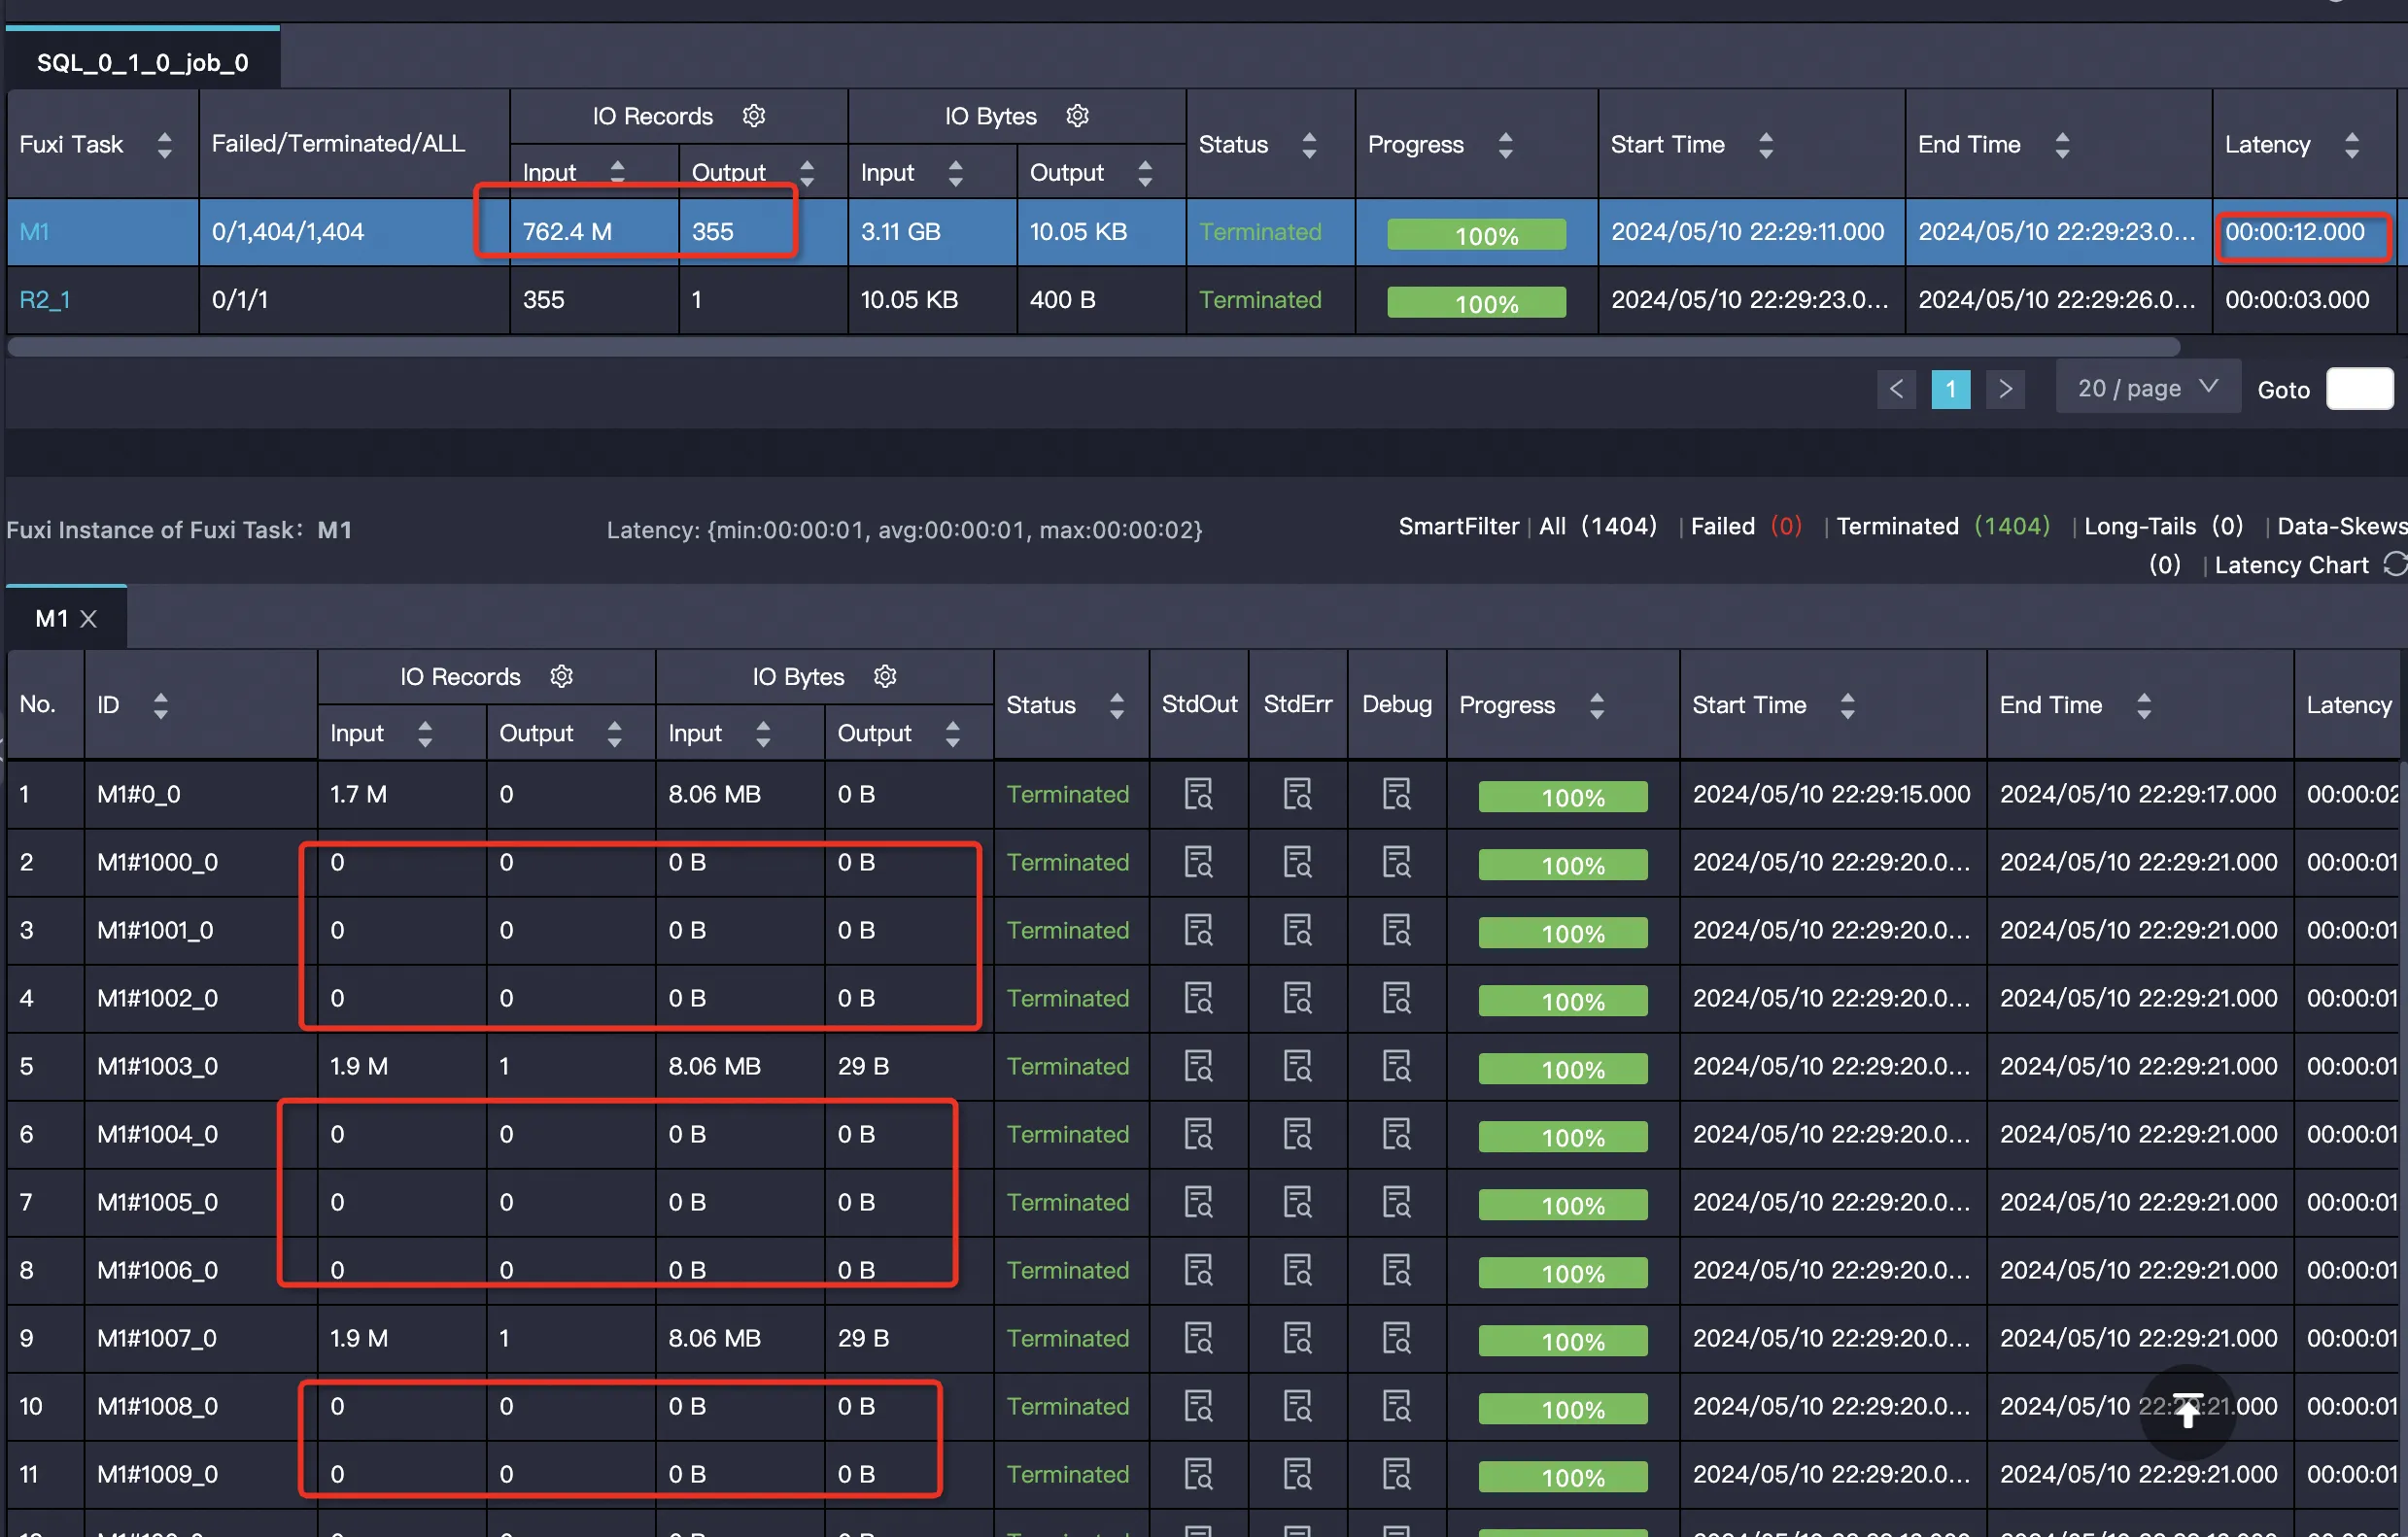
Log do recorte real de grupos de linhas:
[2024-05-10 22:29:22.692182] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_row_group_pruner.cpp:100] The expression to prune row groups:(((ss_store_s k == 2:int64) and (ss_sold_date_sk >= 2451871:int64)) and (ss_sold_date_sk <= 2451880:int64)) [2024-05-10 22:29:22.705508] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_reader_factory.cpp:136] Parquet row group pruning is enabled, millisecon ds elapsed:13 Total row group count:1 Pruned row group count:1 The first several row group indexes: [2024-05-10 22:29:22.705532] [INFO] [239551] [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70 16/common/table/file_formats/parquet/parquet_reader_factory.cpp:60] total feasible parquet row group count:0] -
Tabela interna com PPD
O efeito de recorte é mais significativo porque os dados na tabela interna estão ordenados.
SELECT SUM(ss_sold_date_sk) FROM bigdata_public_dataset.tpcds_1t.store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Após executar esta consulta, o DAG do job mostra que o número total de linhas na fonte de dados é 2.879.987.999, mas o número real de linhas verificadas é de apenas 32.830.000. O estágio M1 (703 instâncias) lê 32.830.000 linhas e gera 323 linhas. O estágio R2_1 recebe 323 linhas e gera 1 linha. Isso mostra que o efeito de recorte é significativo quando o PPD está ativado para uma tabela interna com dados ordenados.
O monitoramento do Fuxi Jobs mostra que o job
SQL_0_1_0_job_0foi concluído. Ele inclui duas Fuxi Tasks, M1 e R2_1, ambas com status Terminated. M1 tem 703 instâncias, entrada de 32,8M registros (1,52 GB), saída de 323 registros e latência de 00:00:09.375. R2_1 tem 1 instância, entrada de 323 registros, saída de 1 registro e latência de 00:00:03.873. Os detalhes da instância M1 mostram 4 instâncias Data-Skew. Instâncias comoM1#101_0,M1#103_0eM1#105_0têm 0 tanto para Input quanto para Output. Isso indica que são instâncias de dry-run e que esta consulta tem um problema de data skew.resource cost: cpu 5.62 Core * Min, memory 7.02 GB * Min inputs: lakehouse47_2.default.tpcds_1t_store_sales2: 32830000 (1633880386 bytes) outputs: Job run time: 14.000 Job run mode: fuxi job 2.0 Job run engine: execution engine M1: instance count: 703 run time: 9.000 instance time: min: 0.000, max: 2.000, avg: 0.000 input records: TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) output records: StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) metrics_output_count: Calc1: 58025 (min: 0, max: 461, avg: 82) HashAgg1: 323 (min: 0, max: 1, avg: 0) StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) metrics_inner_time_ms: Calc1: 4 (min: 0, max: 2, avg: 0) MaxInstance: 21 GlobalInit: 57752 (min: 60, max: 386, avg: 82) MaxInstance: 17 HashAgg1: 0 (min: 0, max: 0, avg: 0) MaxInstance: 2 StreamLineWrite1: 20469 (min: 5, max: 899, avg: 29) MaxInstance: 400 TableScan1: 131977 (min: 51, max: 1417, avg: 187) MaxInstance: 301 R2_1: instance count: 1 run time: 4.000 instance time: min: 0.000, max: 0.000, avg: 0.000 input records: StreamLineRead1: 323 (min: 323, max: 323, avg: 323) output records: AdhocSink1: 1 (min: 1, max: 1, avg: 1) metrics_output_count: AdhocSink1: 1 (min: 1, max: 1, avg: 1)
Comparação de desempenho entre Parquet e ZSTD
A seção a seguir compara o desempenho de diferentes formatos de compactação para tabelas externas Parquet.
Nota: Os resultados dos testes são apenas para referência. O desempenho pode variar de acordo com o cenário de negócio. Recomendamos realizar mais testes e avaliações para o seu caso de uso específico.
Desempenho de consulta
Conjunto de dados: TPC-DS 1 TB
Recursos: mais de 900 CU
Método de teste: ETL
|
Métrica |
Parquet sem compactação |
Parquet-Snappy |
Parquet-ZSTD |
|
tempo de execução do job (s) |
4372 |
4215 |
3649 |
|
Custo de CPU |
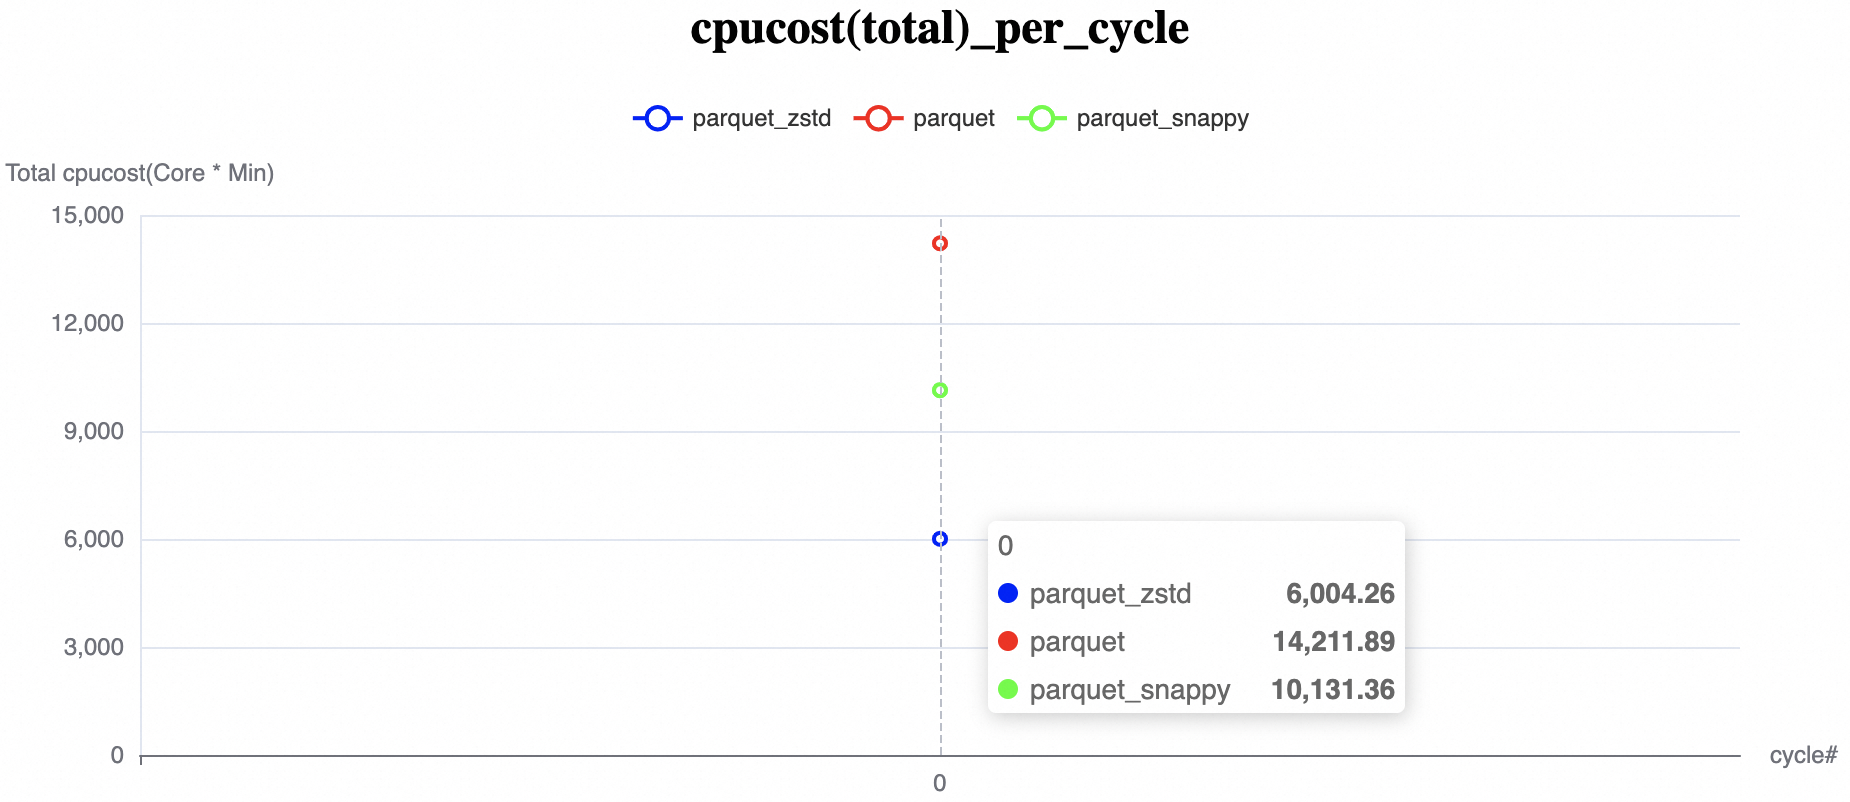
14.211,89 |
10.131,36 |
6.004,26 |
|
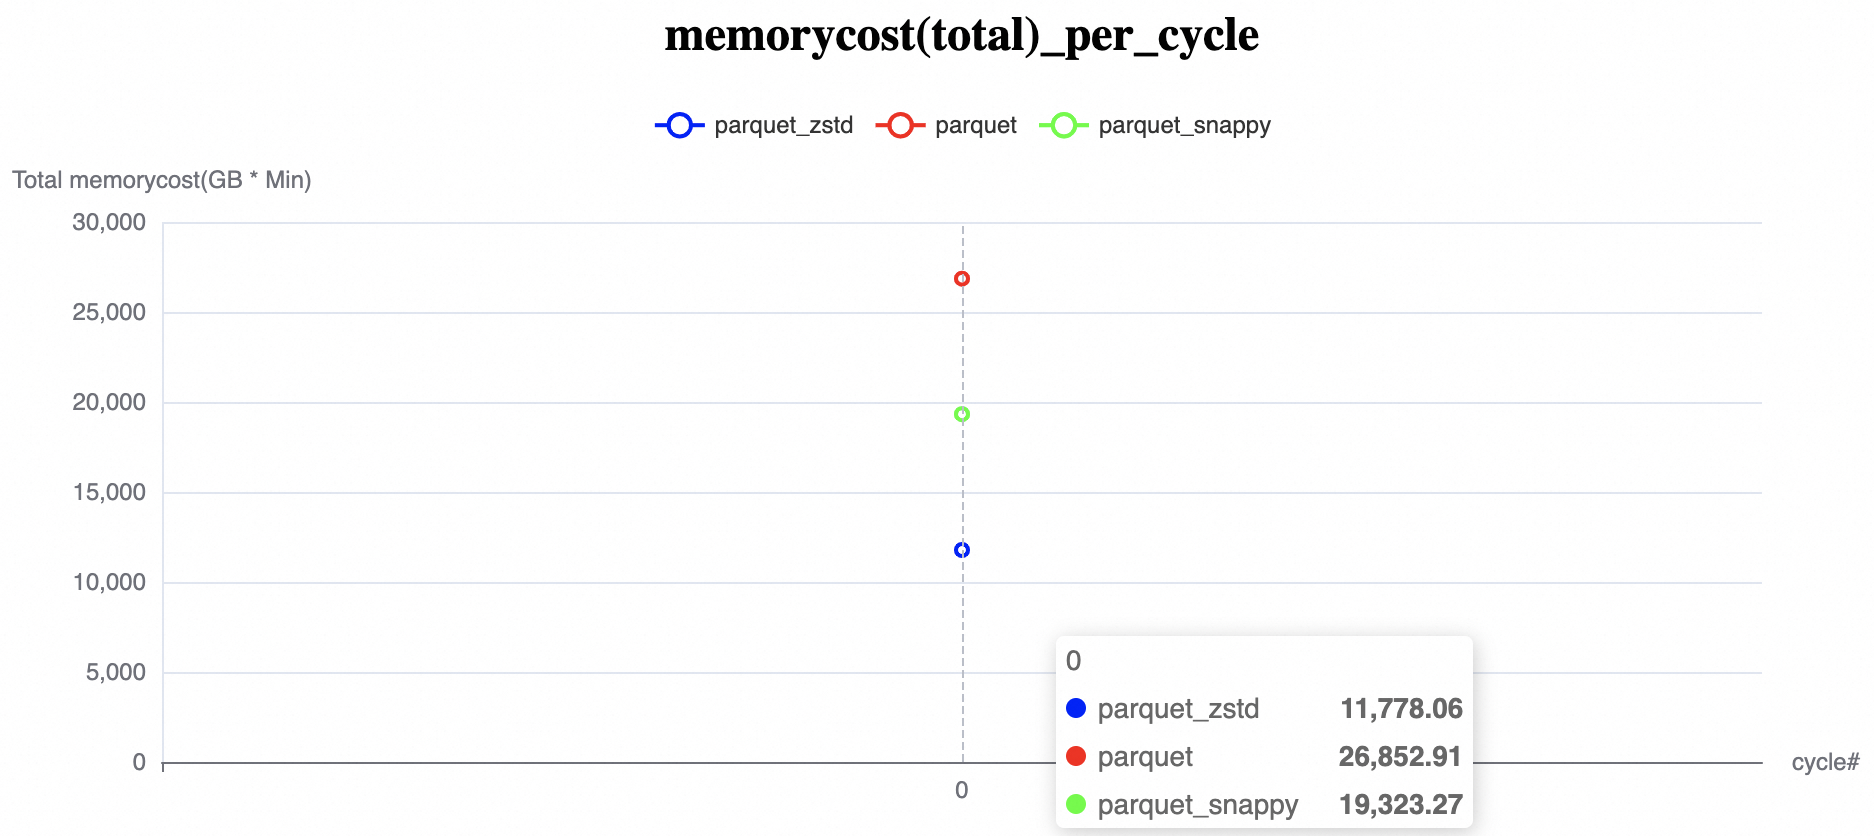
Custo de memória |
26.852,91 |
19.323,27 |
11.778,06 |
|
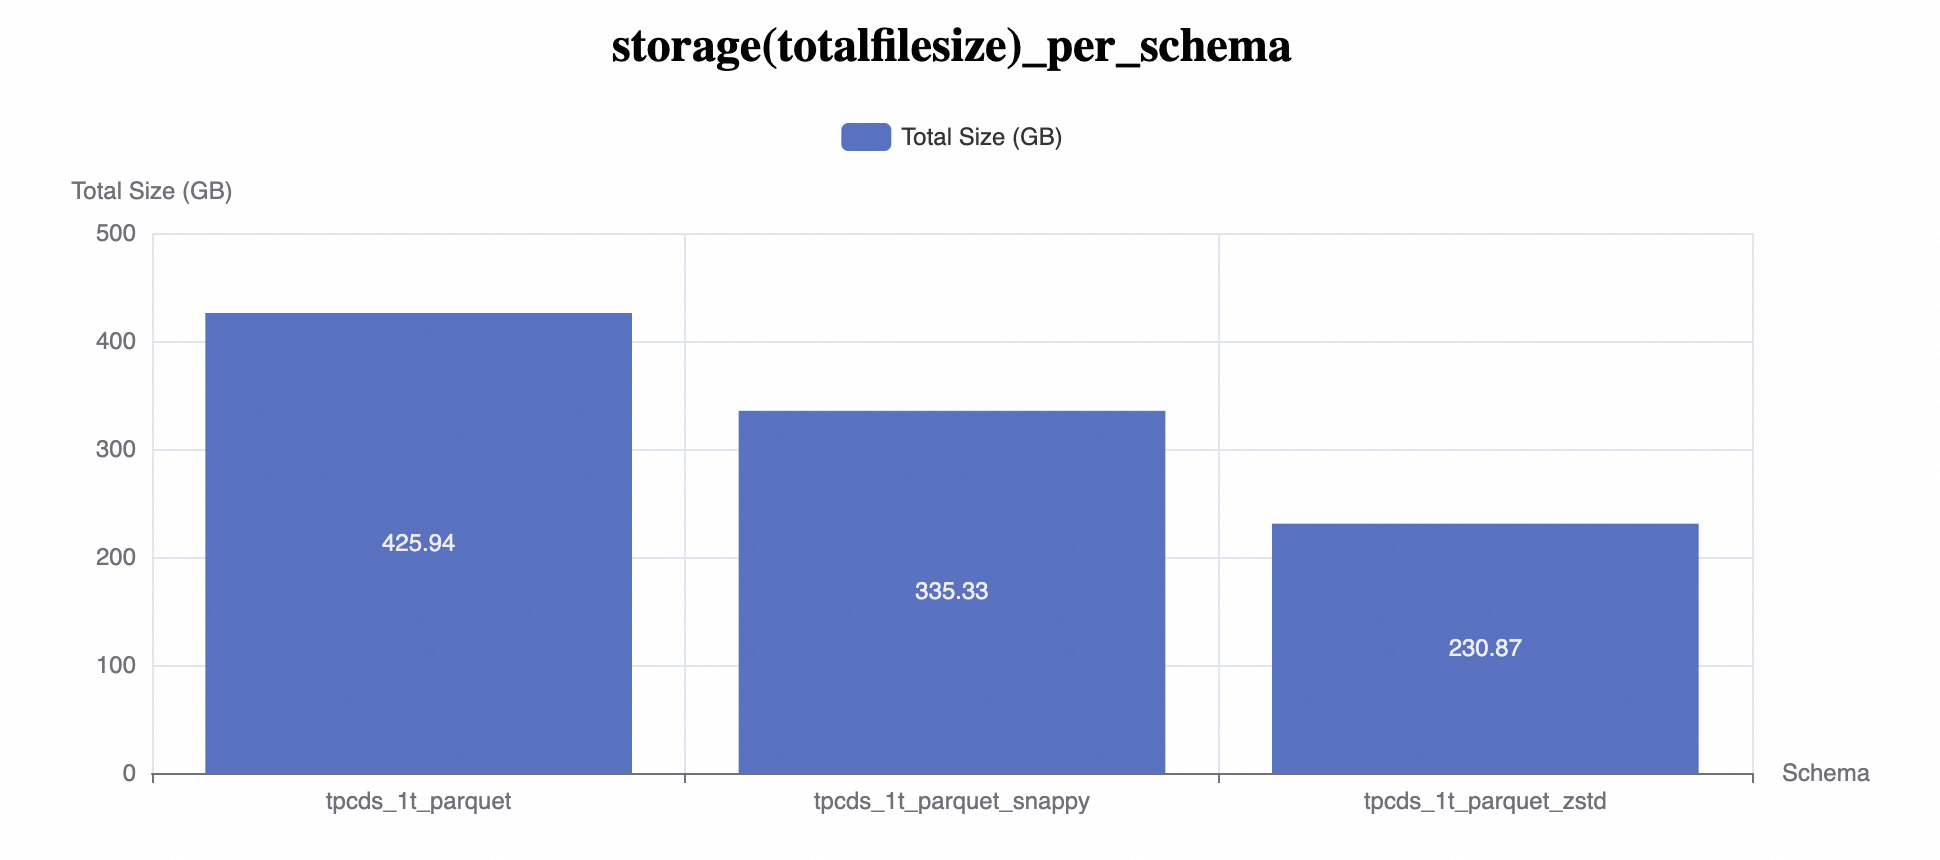
Armazenamento (GB) |
425,94 |
335,33 |
230,87 |
Latência: o ZSTD é 13,4% mais rápido que o Snappy e 16,5% mais rápido que o formato sem compactação.
CPU: o ZSTD usa 40,7% menos CPU que o Snappy e 57,75% menos que o formato sem compactação.
Memória: o ZSTD usa 39,04% menos memória que o Snappy e 56,13% menos que o formato sem compactação.
Armazenamento: o ZSTD usa 31,15% menos armazenamento que o Snappy e 45,8% menos que o formato sem compactação.
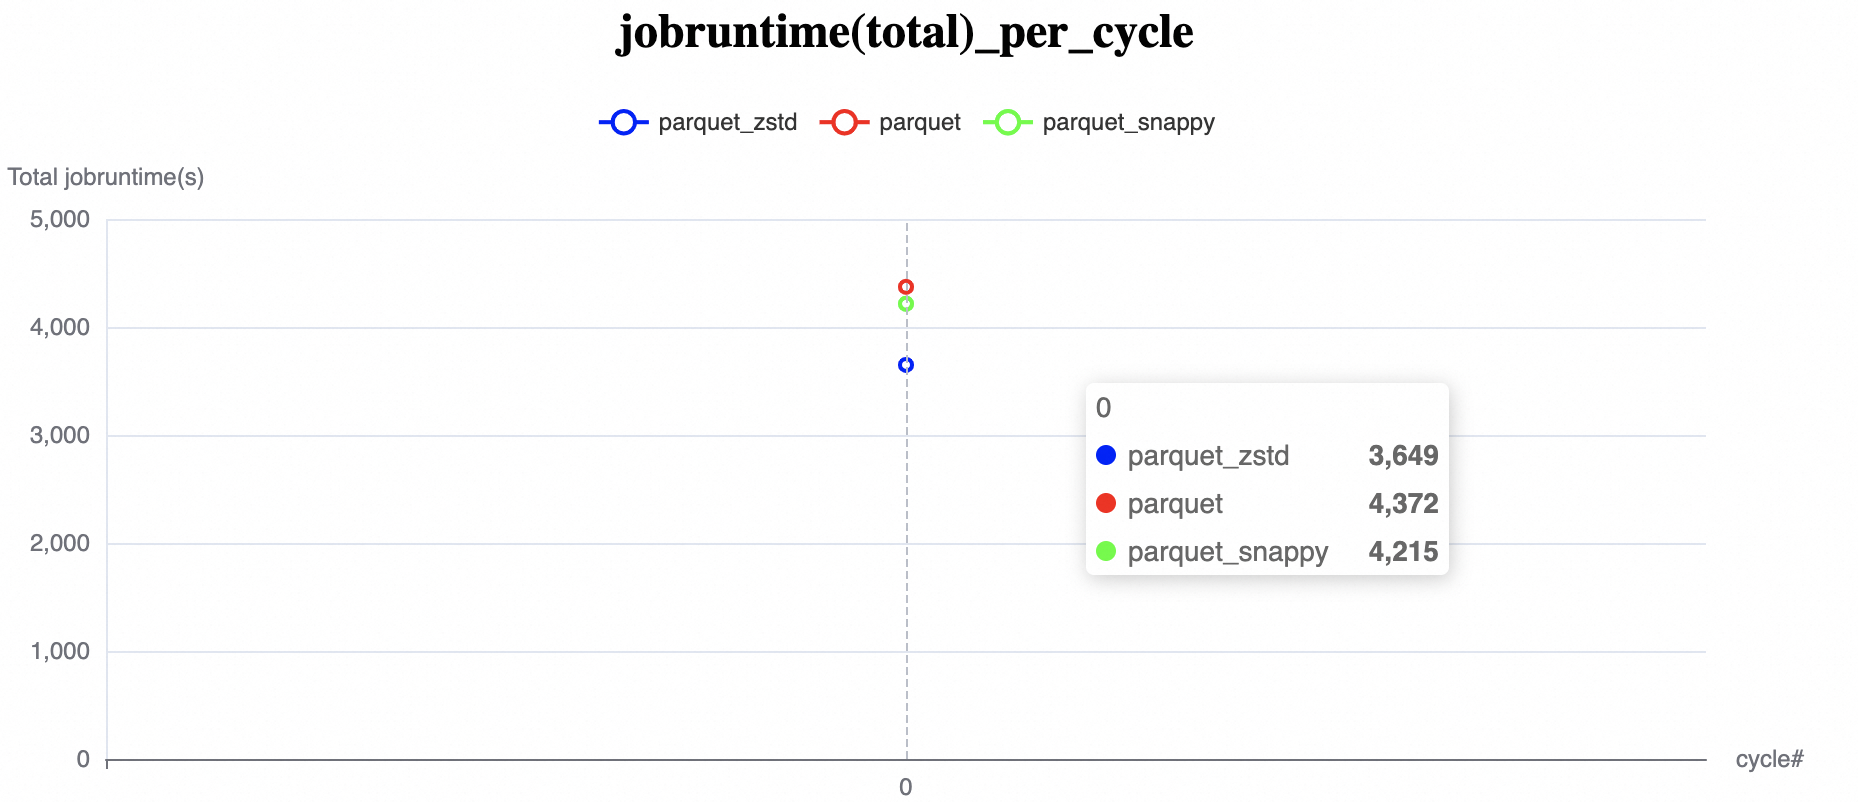
Eficiência de armazenamento
Conjunto de dados: TPC-DS 1 TB
Recursos: mais de 900 CU
Método de teste: ETL
sem compactação: embora este formato não seja compactado, ele resulta em volumes de dados maiores e maior sobrecarga de E/S, o que leva a um desempenho geral ruim.
snappy: a velocidade de compactação não é mais rápida que a do ZSTD de nível baixo, mas a taxa de compactação é maior. Isso resulta em um desempenho geral inferior ao do ZSTD de nível baixo.
zstd: o tamanho dos dados de saída converge rapidamente. Níveis mais altos proporcionam uma compactação adicional mínima (apenas 13,87% a mais), mas causam um aumento rápido no tempo e no consumo de recursos, o que reduz drasticamente a relação custo-benefício. Para este cenário, o ZSTD de nível baixo (níveis 3 a 5) oferece os melhores resultados. O nível 3 é o padrão.
No conjunto de dados TPC-DS de 1 TB, o ZSTD usou 31,1% menos espaço de armazenamento que o Snappy e 45,8% menos que o formato sem compactação.
|
Formato de compactação |
Tamanho dos dados de saída (GB / Taxa de compactação) |
Tempo de execução do job (s) |
Tempo do TableSink (s, % do tempo de execução do job) |
CPU (Core × Min) |
Memória (GB × Min) |
|
sem compactação |
486,67 (100%) |
256,406 |
~ 134,61 (52,5%) |
2.353,19 |
3.361,71 |
|
snappy |
238,33 (48,97%) |
239,087 |
~ 73,88 (30,9%) |
2.110,31 |
3.014,73 |
|
zstd (nível 1, mín) |
164,71 (33,84%) |
233,170 |
~ 65,75 (28,2%) |
2.110,23 |
3.014,61 |
|
zstd (nível 2) |
165,3 (33,97%) |
231,226 |
~ 64,51 (27,9%) |
2.100,79 |
3.001,13 |
|
zstd (nível 3, padrão) |
158,9 (32,65%) |
236,985 |
~ 67,07 (28,3%) |
2.115,10 |
3.021,57 |
|
zstd (nível 4) |
159,52 (32,77%) |
232,477 |
~ 67,65 (29,1%) |
2.100,13 |
3.000,19 |
|
zstd (nível 5) |
157,89 (32,44%) |
232,248 |
~ 71,07 (30,6%) |
2.103,96 |
3.005,66 |
|
zstd (nível 6) |
160,47 (32,97%) |
236,669 |
~ 78,10 (33,0%) |
2.137,63 |
3.053,75 |
|
zstd (nível 9) |
152,00 (31,23%) |
254,073 |
~ 100,36 (39,5%) |
2.287,61 |
3.268,01 |
|
zstd (nível 14) |
144,63 (29,72%) |
455,019 |
~ 341,26 (75,5%) |
4.076,00 |
5.822,86 |
|
zstd (nível 19) |
150,87 (31,00%) |
727,841 |
~ 614,30 (84,4%) |
6.933,10 |
9.904,43 |
|
zstd (nível 22, máx) |
150,81 (30,99%) |
5.381,359 |
~ 5.257,59 (97,7%) |
42.848,13 |
61.211,62 |
Cenário de exemplo
Este exemplo mostra como criar uma tabela externa Parquet particionada com compactação ZSTD e, em seguida, ler e gravar dados na tabela.
-
Pré-requisitos
Você criou um projeto MaxCompute. Para mais informações, consulte Criar um projeto MaxCompute.
-
Você preparou um bucket e um diretório no OSS. Para mais informações, consulte Criar um bucket e Gerenciar diretórios.
Certifique-se de que o seu bucket esteja na mesma região do seu projeto MaxCompute.
-
Conceda permissões.
Tenha permissão para acessar o OSS. Utilize uma conta Alibaba Cloud, um usuário RAM ou uma função RAM para acessar a tabela externa do OSS. Para mais informações sobre como conceder permissões, consulte Autorização no modo STS para OSS.
Tenha a permissão CreateTable no projeto MaxCompute. Para mais informações sobre permissões relacionadas a tabelas, consulte Permissões do MaxCompute.
-
Prepare um arquivo de dados no formato ZSTD.
No bucket
oss-mc-testpara os dados de amostra, crie a pastaparquet_zstd_jni/dt=20230418e armazene o arquivo de dados na pasta da partiçãodt=20230418. -
Crie uma tabela externa Parquet que use o formato de compactação ZSTD.
CREATE EXTERNAL TABLE IF NOT EXISTS mc_oss_parquet_data_type_zstd ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongtitue DOUBLE, recordTime STRING, direction STRING ) PARTITIONED BY (dt STRING ) ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe' WITH serdeproperties( 'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>', 'mcfed.parquet.compression'='zstd' ) STORED AS parquet LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/parquet_zstd_jni/'; -
Importe os dados da partição. Se a tabela externa do OSS for uma tabela particionada, importe também os dados da partição. Para mais informações, consulte Tabelas externas do OSS.
-- Import partition data. MSCK REPAIR TABLE mc_oss_parquet_data_type_zstd ADD PARTITIONS; -
Leia os dados da tabela externa Parquet.
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt='20230418' LIMIT 10;O sistema retorna o seguinte exemplo de saída:
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ | vehicleid | recordid | patientid | calls | locationlatitute | locationlongtitue | recordtime | direction | dt | +------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ | 1 | 12 | 76 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:10 | SW | 20230418 | | 1 | 1 | 51 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:00 | S | 20230418 | | 1 | 2 | 13 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:01 | NE | 20230418 | | 1 | 3 | 48 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:02 | NE | 20230418 | | 1 | 4 | 30 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:03 | W | 20230418 | | 1 | 5 | 47 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:04 | S | 20230418 | | 1 | 6 | 9 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:05 | S | 20230418 | | 1 | 7 | 53 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:06 | N | 20230418 | | 1 | 8 | 63 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:07 | SW | 20230418 | | 1 | 9 | 4 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:08 | NE | 20230418 | | 1 | 10 | 31 | 1 | 46.81006 | -92.08174 | 9/14/2014 0:09 | N | 20230418 | +------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+ -
Grave dados na tabela externa Parquet.
INSERT INTO mc_oss_parquet_data_type_zstd PARTITION ( dt = '20230418')
  VALUES  (1,16,76,1,46.81006,-92.08174,'9/14/2014 0:10','SW');
-- Query the newly written data
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt = '20230418' AND recordid=16;
O resultado é o seguinte:
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| vehicleid  | recordid   | patientid  | calls      | locationlatitute | locationlongtitue | recordtime     | direction  | dt         |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| 1          | 16         | 76         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:10 | SW         | 20230418   |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
Tipos de dados suportados
Para mais informações sobre os tipos de dados do MaxCompute, consulte Tipos de dados (versão 1.0) e Tipos de dados (versão 2.0).
Modo Java Native Interface (JNI):
set odps.ext.parquet.native=false. Este modo usa a implementação original de código aberto baseada em Java para analisar arquivos de dados Parquet ao ler de uma tabela externa. Ele suporta operações de leitura e gravação.-
Modo Nativo:
set odps.ext.parquet.native=true. Este modo usa a nova implementação nativa baseada em C++ para analisar arquivos de dados Parquet ao ler de uma tabela externa. Ele suporta apenas operações de leitura.Modo
Modo Java (leitura/gravação)
Modo Nativo (somente leitura)
TINYINT
SMALLINT
INT
BIGINT
BINARY
FLOAT
DOUBLE
DECIMAL(precision,scale)
VARCHAR(n)
CHAR(n)
STRING
DATE
DATETIME
TIMESTAMP
TIMESTAMP_NTZ
BOOLEAN
ARRAY
MAP
STRUCT
JSON
Formatos de compactação suportados
Para ler ou gravar arquivos compactados do OSS, adicione a configuração da propriedade with serdeproperties à instrução de criação da tabela. Para mais informações, consulte Parâmetros da propriedade with serdeproperties.
|
Propriedade de compactação |
Leitura |
Gravação |
|
Gzip |
|
|
|
ZSTD |
|
|
|
SNAPPY (SnappyRawCodec) |
|
|
|
SNAPPY (SnappyCodec) |
|
|
Suporte à evolução de schema
As tabelas externas Parquet mapeiam os valores das colunas entre o schema e as colunas do arquivo por nome.
A coluna Problemas de compatibilidade de dados na tabela a seguir descreve se a leitura dos dados ocorre corretamente após uma operação de evolução de schema. Isso se aplica tanto a novos dados que estão em conformidade com o schema modificado quanto a dados históricos que usam o schema antigo.
Tipo de operação | Suportado | Descrição | Problemas de compatibilidade de dados |
Adicionar coluna |
|
| |
Excluir coluna | As tabelas externas Parquet mapeiam os valores das colunas por nome. | Compatível | |
Reordenar colunas | As tabelas externas Parquet mapeiam os valores das colunas por nome. | Compatível | |
Alterar o tipo de dados da coluna | O sistema não suporta esta operação. O formato Parquet possui validação rigorosa de schema. Alterar um tipo de dados pode tornar os dados ilegíveis. | Não aplicável | |
Renomear coluna | O sistema não suporta esta operação. O formato Parquet possui validação rigorosa de schema, o que pode fazer com que tipos anteriormente compatíveis se tornem ilegíveis após a modificação. | Não aplicável | |
Modificar o comentário da coluna | O comentário deve ser uma string válida com no máximo 1024 bytes. Caso contrário, ocorrerá um erro. | Compatível | |
Modificar a propriedade não nula de uma coluna | O sistema não suporta esta operação. As colunas são anuláveis por padrão. | Não aplicável |
FAQ
Tipos de coluna incompatíveis entre um arquivo Parquet e uma DDL de tabela externa
-
Mensagem de erro
ODPS-0123131:User defined function exception - Traceback: java.lang.ClassCastException: org.apache.hadoop.io.LongWritable cannot be cast to org.apache.hadoop.io.IntWritable at org.apache.hadoop.hive.serde2.objectinspector.primitive.WritableIntObjectInspector.getPrimitiveJavaObject(WritableIntObjectInspector.java:46) -
Descrição do erro
O tipo de campo LongWritable do arquivo Parquet não corresponde ao tipo INT na DDL da tabela externa.
-
Solução
Altere o tipo INT na DDL da tabela externa para BIGINT.
Erro ao gravar em uma tabela externa: java.lang.OutOfMemoryError
-
Mensagem de erro
ODPS-0123131:User defined function exception - Traceback: java.lang.OutOfMemoryError: Java heap space at java.io.ByteArrayOutputStream.<init>(ByteArrayOutputStream.java:77) at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:175) at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:173) at org.apache.parquet.bytes.BytesInput.toByteArray(BytesInput.java:161) -
Descrição do erro
Ocorre um erro de falta de memória (OOM) quando você grava um grande volume de dados em uma tabela externa Parquet.
-
Solução
Ao criar uma tabela externa, primeiro diminua o parâmetro
mcfed.parquet.block.row.count.limit. Se um erro OOM ainda ocorrer ou o arquivo de saída for muito grande, diminua o parâmetromcfed.parquet.page.size.row.check.maxpara verificar a memória com mais frequência. Para mais informações, consulte Parâmetros específicos.Antes de gravar dados na tabela externa Parquet, adicione os seguintes parâmetros.
-- Set the maximum memory size for the UDF JVM heap.
SET odps.sql.udf.jvm.memory=12288;
-- Control the batch size on the runtime side.
SET odps.sql.executionengine.batch.rowcount =64;
-- Set the memory size for each Map worker.
SET odps.stage.mapper.mem=12288;
-- Set the input data volume for each Map worker (input file shard size) to indirectly control the number of workers per Map stage.
SET odps.stage.mapper.split.size=64;