O MaxCompute suporta tabelas externas do OSS que mapeiam diretórios do Object Storage Service (OSS). Use essas tabelas para ler dados não estruturados ou gravar dados no OSS.
Observações de uso
Tabelas externas do OSS não suportam a propriedade de cluster.
O tamanho de um único arquivo não pode exceder 2 GB. Divida arquivos maiores que esse limite.
O MaxCompute e o OSS devem estar na mesma região.
Métodos de acesso
As plataformas a seguir permitem criar e usar tabelas externas do OSS.
Método | Plataforma |
MaxCompute SQL | |
Visualização |
Pré-requisitos
Você já crie um projeto MaxCompute.
-
Prepare um bucket e um diretório no OSS. Consulte Crie um bucket e Gerencie diretórios.
O MaxCompute cria diretórios no OSS automaticamente. Se uma instrução SQL incluir tabelas externas e UDFs, uma única instrução poderá ler ou gravar na tabela externa e executar a UDF. A criação manual de diretórios também é suportada.
Como o MaxCompute está implantado apenas em algumas regiões, a conectividade de rede entre regiões pode ser um problema. Mantenha seu bucket na mesma região do projeto MaxCompute.
-
Autorização
Obtenha permissões para acessar o OSS. Uma conta Alibaba Cloud, um usuário RAM ou uma função RAM podem acessar tabelas externas do OSS. Consulte STS authorization for OSS.
Obtenha a permissão CreateTable no projeto MaxCompute. Consulte MaxCompute permissions.
Descrição das permissões
Ao acessar tabelas externas do OSS, os dados são acessados por meio da função especificada no parâmetro
odps.properties.rolearn, independentemente do uso de conta Alibaba Cloud, usuário RAM ou função RAM. Portanto, crie uma função RAM, conceda a ela permissões para acessar o bucket OSS de destino e configure o ARN da função no parâmetroodps.properties.rolearn. Para mais informações, consulte Parameters.Autorize o acesso à mesma conta ou entre contas conforme suas necessidades de negócio. Recomendamos o uso de uma política de autorização personalizada para um controle de acesso mais refinado. Para mais informações, consulte Authorization for external data sources.
Criar uma tabela externa do OSS
-
Tabelas particionadas e não particionadas:
Escolha com base na forma como seus arquivos de dados estão armazenados no OSS. Use uma tabela particionada se os arquivos estiverem em caminhos particionados; caso contrário, use uma tabela não particionada.
Tabelas externas do OSS suportam Partition operations.
Nome de domínio de rede: Use o nome de domínio da rede clássica para o OSS. O MaxCompute não garante conectividade de rede para nomes de domínio de rede pública.
Uma tabela externa do OSS registra apenas o mapeamento para um diretório do OSS. Excluir a tabela externa não remove os arquivos de dados no diretório mapeado.
Se um arquivo de dados do OSS for um objeto arquivado, primeiro execute restore the object.
A sintaxe CREATE EXTERNAL TABLE varia conforme o formato do arquivo de dados. Adapte a sintaxe e os parâmetros ao formato dos seus dados. Configurações incorretas causam falhas de leitura e gravação.
Sintaxe
Criar uma tabela externa usando o analisador de dados de texto integrado
Sintaxe | Formato do arquivo de dados | Exemplo |
| Formatos de arquivo de dados suportados para leitura ou gravação no OSS:
|
Criar uma tabela externa usando um analisador de dados open source integrado
Sintaxe | Formato do arquivo de dados | Exemplo |
| Formatos de arquivo de dados suportados para leitura ou gravação no OSS:
|
Criar uma tabela externa usando um analisador personalizado
Sintaxe | Formato do arquivo de dados | Exemplo |
| Formatos de arquivo de dados suportados para leitura ou gravação no OSS: Arquivos de dados em formatos diferentes dos listados acima. |
Parâmetros
Os parâmetros a seguir são comuns a todos os formatos de tabela externa. Para parâmetros específicos de cada formato, consulte a documentação correspondente.
-
Parâmetros básicos de sintaxe
Parâmetro
Obrigatório
Descrição
mc_oss_extable_name
Sim
Nome da tabela externa do OSS a ser criada.
Os nomes das tabelas não diferenciam maiúsculas de minúsculas e não podem ser forçados para um formato específico.
col_name
Sim
Nome de uma coluna na tabela externa do OSS.
O esquema da tabela externa deve corresponder ao esquema do arquivo de dados do OSS. Caso contrário, os dados não poderão ser lidos.
data_type
Sim
Tipo de dados de uma coluna na tabela externa do OSS.
O tipo de dados de cada coluna deve corresponder à coluna equivalente no arquivo de dados do OSS. Caso contrário, os dados não poderão ser lidos.
table_comment
Não
Comentário da tabela. Deve ser uma string válida com no máximo 1.024 bytes. Caso contrário, um erro será relatado.
partitioned by (col_name data_type, ...)
Não
Se os arquivos de dados no OSS estiverem armazenados em um caminho particionado, inclua este parâmetro para criar uma tabela particionada.
col_name: Nome da coluna da chave de partição.
data_type: Tipo de dados da coluna da chave de partição.
'<(tb)property_name>'='<(tb)property_value>'
Sim
Propriedades estendidas da tabela externa. Consulte a documentação específica do formato para obter detalhes.
oss_location
Sim
Caminho do OSS onde os arquivos de dados estão localizados. Por padrão, todos os arquivos de dados neste caminho são lidos.
O formato é
oss://<oss_endpoint>/<Bucket name>/<OSS directory name>/.oss_endpoint:
Nome de domínio do OSS. Use o endpoint da rede clássica fornecido pelo OSS, que contém
-internal.Exemplo:
oss://oss-cn-beijing-internal.aliyuncs.com/xxx.Os nomes de domínio da rede clássica do OSS estão listados em Regions and endpoints.
Mantenha a região do OSS onde os arquivos de dados estão armazenados igual à região do projeto MaxCompute. Se estiverem em regiões diferentes, problemas de conectividade de rede podem ocorrer.
Se você não especificar um endpoint, o sistema usará o endpoint da região onde o projeto atual está localizado.
Este método não é recomendado, pois o armazenamento de arquivos entre regiões pode causar problemas de conectividade de rede.
Bucket name: Nome do bucket do OSS. O nome do bucket deve seguir o
oss_endpoint.Exemplo:
oss://oss-cn-beijing-internal.aliyuncs.com/your_bucket/path/.Visualize os nomes dos buckets em List buckets.
Directory name: Nome do diretório do OSS. Não especifique um nome de arquivo após o diretório.
Exemplo:
oss://oss-cn-beijing-internal.aliyuncs.com/oss-mc-test/Demo1/.Exemplos incorretos:
 -- Conexões HTTP não são suportadas.
    http://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- Conexões HTTPS não são suportadas.
    https://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
    -- Endereço de conexão incorreto.
    oss://oss-cn-shanghai-internal.aliyuncs.com/Demo1
    -- Não especifique um nome de arquivo.
    oss://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/vehicle.csv
-
Atributos WITH serdeproperties
property_name
Cenário
property_value
Valor padrão
odps.properties.rolearn
Adicione esta propriedade ao usar autorização STS.
Especifique o ARN da função RAM que tem permissões para acessar o OSS.
Obtenha o ARN nos detalhes da função no RAM console. Exemplo:
acs:ram::xxxxxx:role/<role_name>.Se os proprietários do MaxCompute e do OSS forem a mesma conta:
Se você não especificar
odps.properties.rolearnna instrução de criação da tabela, o ARN da funçãoaliyunodpsdefaultroleserá usado por padrão. Crie primeiro a função RAM usando STS authorization. A funçãoAliyunODPSDefaultRolepossui permissões amplas. Recomendamos conceder permissões por meio de uma função personalizada.Para usar o ARN de uma função personalizada, crie primeiro a função personalizada. Consulte STS authorization for OSS (custom authorization).
Se os proprietários do MaxCompute e do OSS forem contas diferentes, especifique o ARN de uma função personalizada. Para mais informações, consulte STS authorization for OSS (custom authorization).
Lista de permissões e lista de bloqueios
As tabelas externas do OSS no MaxCompute suportam filtragem por lista de permissões e lista de bloqueios. Ao definir parâmetros de lista de permissões e lista de bloqueios em tblproperties, filtre quais arquivos devem ser lidos de um diretório.
-
Parâmetros tblproperties
-
Regras efetivas
A lista de bloqueios tem prioridade sobre a lista de permissões: se um arquivo corresponder a qualquer condição da lista de bloqueios, ele será excluído.
-
O sinalizador de sessão e o parâmetro de lista de bloqueios em tblproperties possuem uma relação "OU". Se ambos estiverem configurados, ambos terão efeito — um arquivo que corresponder a qualquer condição de bloqueio será excluído. Recomenda-se a configuração via tblProperties.
Método de configuração
Tipo de caminho
Parâmetro
session flag
Caminho absoluto
odps.sql.unstructured.file.pattern.black.list
tblproperties
Caminho relativo
odps.external.data.file.blacklist.regex
-
Observações sobre Regex
Os âncoras de início de linha
^e fim de linha$são opcionais. Por exemplo, para corresponder a arquivos.json,.*\.jsoné suficiente.-
Apenas um padrão regex é suportado. Para excluir vários tipos de arquivos, utilize |:
-- Exclude csv, txt, and parquet files
"odps.external.data.file.blacklist.regex": ".*\\.(txt|csv|parquet)$"
-
Atualizar parâmetros de lista de permissões e lista de bloqueios
ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.whitelist.regex'='new_regex') ALTER TABLE {table_name} SET tblproperties('odps.external.data.file.blacklist.regex'='new_regex') -
Exemplos
-
Dados de amostra
-- Assume the OSS directory contains the following files: oss://xxx/bucket/level1/data1.txt oss://xxx/bucket/level1/data2.json oss://xxx/bucket/level1/data3.csv oss://xxx/bucket/level1/level2/data4.txt oss://xxx/bucket/level1/level2/data5.json oss://xxx/bucket/level1/level2/data6.parquet -
Lista de permissões: ler apenas arquivos JSON
CREATE EXTERNAL TABLE test_whitelist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED AS textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: JSON files only -- By running SELECT * FROM test_whitelist_table, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json -
Lista de bloqueios: excluir arquivos txt, csv e parquet
CREATE EXTERNAL TABLE test_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.blacklist.regex'='.*\\.(txt|csv|parquet)$'); -- Blacklist: exclude txt, csv, parquet -- By running SELECT * FROM test_blacklist_table, all TXT, CSV, and Parquet files are filtered out. -- Query returns data from data2.json and level2/data5.json -
Combinação de lista de permissões e lista de bloqueios: ler arquivos txt, excluir diretório level2
CREATE EXTERNAL TABLE test_whitelist_blacklist_table ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.txt', -- Whitelist: txt files only 'odps.external.data.file.blacklist.regex'='.*level2/.*'); -- Blacklist: exclude level2 directory -- By running select * from test_whitelist_blacklist_table, -- Whitelist filters txt files, then blacklist excludes level2 directory -- Query returns data from data1.txt only -
Listagem recursiva: controlar a leitura de arquivos em subdiretórios
CREATE EXTERNAL TABLE test_recursive_enabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='true'); -- Recursive enabled -- By running SELECT * FROM test_recursive_enabled, all JSON files are selected. -- Query returns data from data2.json and level2/data5.json CREATE EXTERNAL TABLE test_recursive_disabled ( id INT, name STRING ) row format serde 'org.apache.hive.hcatalog.data.JsonSerDe' STORED as textfile LOCATION 'oss://xxx/bucket/level1' TBLPROPERTIES ( 'odps.external.data.enable.extension'='true', -- Enable file extension support 'odps.external.data.file.whitelist.regex'='.*\\.json' -- Whitelist: json files only 'odps.external.data.file.recursive.listing.enabled'='false' -- Recursive disabled ); -- By running SELECT * FROM test_recursive_disabled, all JSON files are selected, but recursive reading is disabled. -- Query returns data from data2.json only (level2 directory excluded) -
Atualizar lista de permissões e lista de bloqueios via ALTER TABLE
CREATE EXTERNAL TABLE test_alter_table_properties
(
  id INT,
  name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- Enable file extension support
  'odps.external.data.file.whitelist.regex'='.*\\.json'); -- Whitelist: json files only

-- By running SELECT * FROM test_alter_table_properties, all JSON files are selected
-- Query returns data from data2.json and level2/data5.json

ALTER TABLE test_alter_table_properties
SET tblproperties(
  'odps.external.data.file.whitelist.regex'='.*level2/.*\\.json'
)
-- By running select * from test_alter_table_properties
-- Query now returns data from level2/data5.json only
-
Após criar uma tabela externa do OSS, leia dados do OSS através dela. Para tipos de arquivos de dados suportados e sintaxe de criação, consulte Syntax.
Se uma instrução SQL envolver tipos de dados complexos, adicione
set odps.sql.type.system.odps2=true;antes e envie-as juntas. Consulte Data type versions.Para tabelas externas do OSS que mapeiam dados open source, defina
set odps.sql.hive.compatible=true;no nível de sessão antes de ler dados do OSS. Caso contrário, um erro será relatado.O OSS possui limites de largura de banda. Se o tráfego de leitura/gravação exceder o limite de largura de banda da instância em um curto período, o desempenho da tabela externa diminuirá. Consulte Limits and performance metrics.
select_statement: A cláusula
SELECT, que consulta os dados a serem inseridos na tabela de destino a partir da tabela de origem.from_statement: A cláusula
FROM, que especifica a fonte de dados, como o nome da tabela externa.-
Método 1 (Recomendado): Importe os dados de formato open source do OSS para uma tabela interna do MaxCompute e, em seguida, leia os dados.
Ideal para cálculos repetidos ou cenários de alto desempenho. Crie uma tabela interna com o mesmo esquema da tabela externa, importe os dados e execute consultas complexas. O armazenamento interno se beneficia da otimização do MaxCompute. Comando de exemplo:
CREATE TABLE <table_internal> LIKE <mc_oss_extable_name>; INSERT OVERWRITE TABLE <table_internal> SELECT * FROM <mc_oss_extable_name>; -
Método 2: Leia dados diretamente do OSS, semelhante às operações em tabelas internas do MaxCompute.
Indicado para cenários de baixo desempenho. Cada consulta lê dados diretamente do OSS em vez do armazenamento interno.
-
Método 1 (Recomendado): Armazene dados no OSS usando um standard partitioned path format ou um custom partitioned path format.
Especifique a partição e o oss_location na instrução de criação da tabela. Caminhos particionados padrão são recomendados.
-
Método 2: Planeje múltiplos caminhos de armazenamento de dados.
Crie várias tabelas externas, cada uma apontando para um subconjunto de dados do OSS. Este método é trabalhoso e não recomendado.
-
Ativar Sinalizador
SET odps.meta.exttable.stats.onlinecollect=true; -
Conclusão
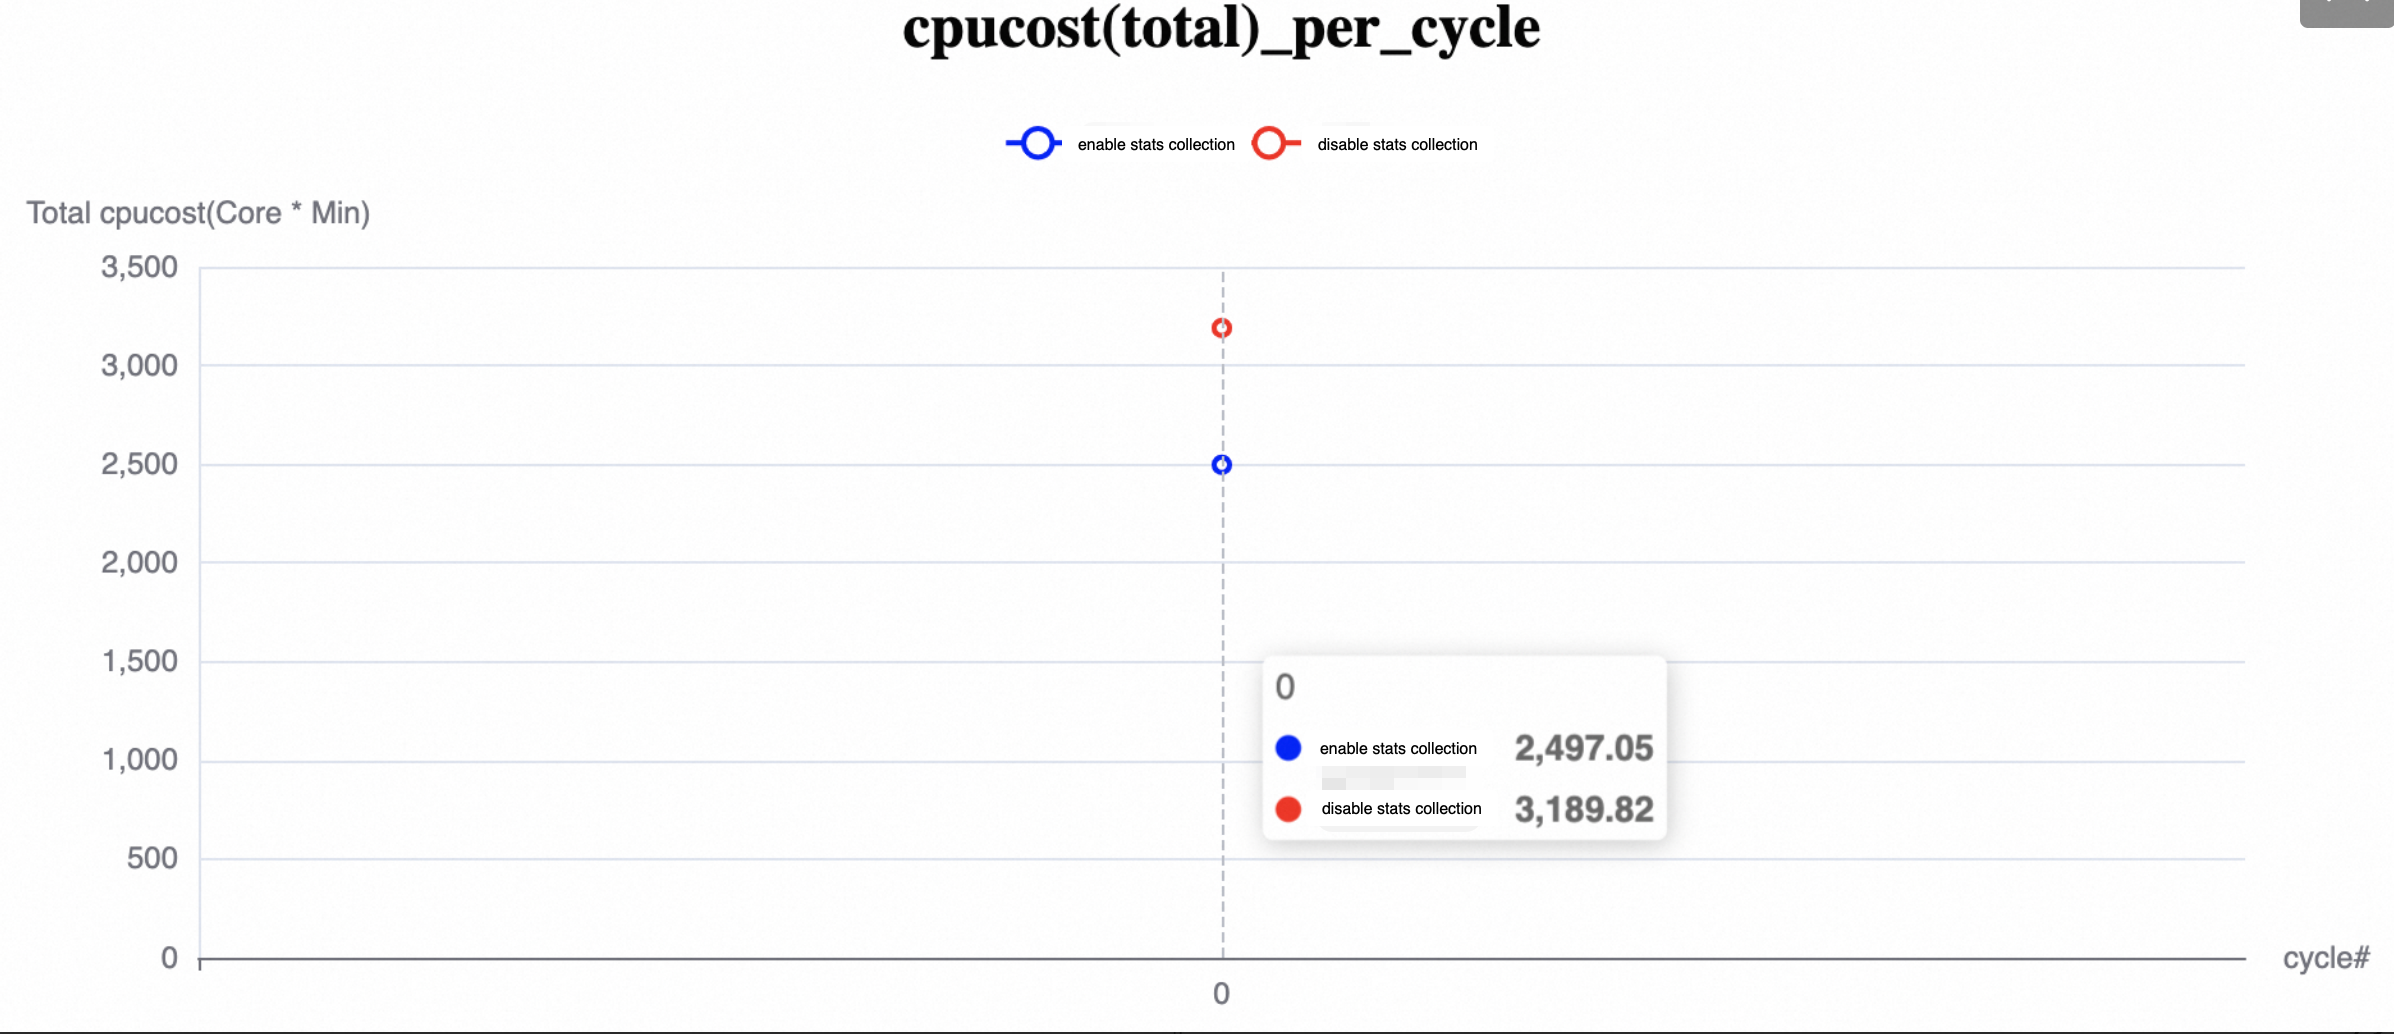
O tempo de execução do job diminuiu 22,75%, o uso de CPU diminuiu 21,72% e o uso de memória diminuiu 24%.
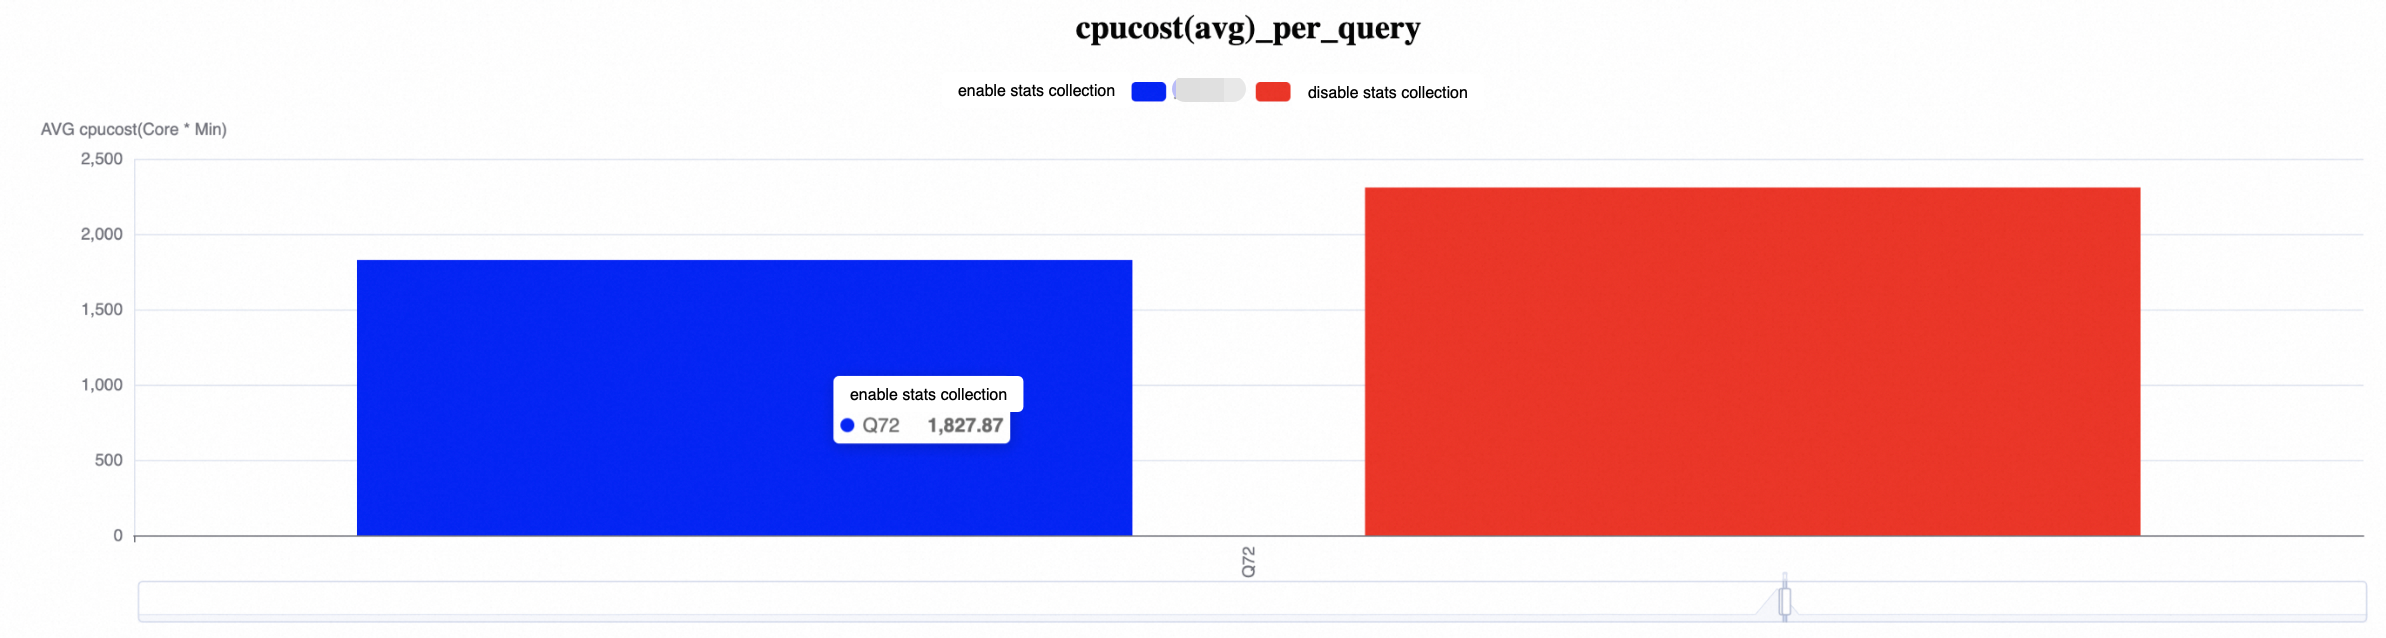
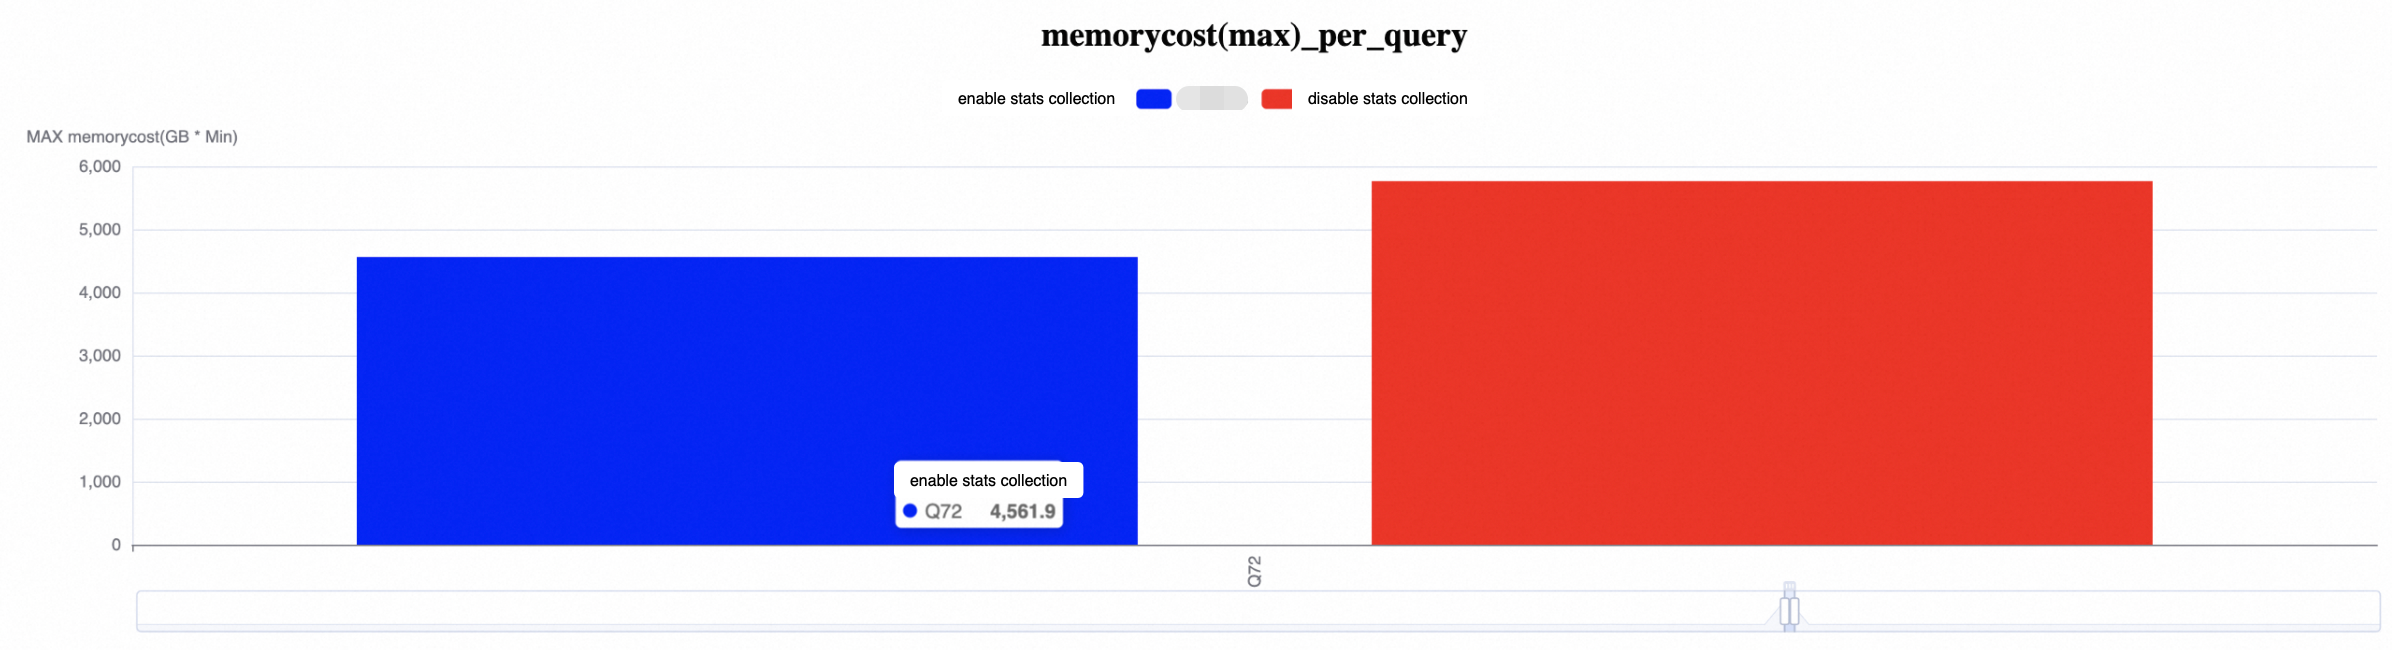
Q72 é a consulta mais lenta, com tempo de execução do job reduzido em 17,61%, CPU em 20,82% e memória em 20,86%.
Para TPCDS-Q72, a falta de estatísticas em tabelas pequenas causa degradação significativa do plano de execução; adicionar estatísticas melhora o desempenho em até 5 vezes. Q3, Q18, Q19, Q72 e Q99 também mostram melhorias notáveis.
No geral, a maioria das consultas se beneficia consideravelmente. Um pequeno número de consultas não vê melhoria no tempo de ponta a ponta, pois seus planos de execução não são afetados, incorrendo apenas em sobrecarga adicional da coleta de estatísticas. A latência extra introduzida na fase do Otimizador varia de dezenas a centenas de milissegundos, com impacto mínimo no tempo total.
-
Todas as consultas
O tempo de execução do job diminuiu 22,75%, o uso de CPU diminuiu 21,72% e o uso de memória diminuiu 24%.



-
Q72
Q72 é a consulta mais lenta, com tempo de execução do job reduzido em 17,61%, CPU em 20,82% e memória em 20,86%.

Se o volume de dados for grande e o tamanho da divisão for muito pequeno, divisões excessivas causam alto paralelismo e a instância passa a maior parte do tempo aguardando recursos.
Se o volume de dados for pequeno e o tamanho da divisão for muito grande, poucas divisões causam concorrência insuficiente e recursos ociosos.
Se o valor dop for maior que o número de arquivos no diretório OSS, a concorrência real poderá diferir significativamente do valor dop configurado.
Se o valor dop for muito pequeno, ele não terá efeito. Use o parâmetro
odps.input.file.num.limitpara alterar o número máximo de arquivos que uma única instância pode processar.Grave dados no OSS usando um analisador de dados de texto ou open source integrado: Built-in text parser, Built-in open-source parser.
Grave dados no OSS usando um analisador personalizado: Example: Create an OSS external table using a custom parser.
Grave dados no OSS usando o recurso de upload multipart do OSS: Write data to OSS using the OSS multipart upload feature.
Se a operação
INSERT OVERWRITE ... SELECT ... FROM ...;alocar 1.000 mappers na tabela de origem from_tablename, 1.000 arquivos TSV ou CSV serão gerados.-
Controle o número de arquivos gerados usando configurações fornecidas pelo MaxCompute.
Se o outputter estiver em um mapper: Use
odps.stage.mapper.split.sizepara controlar o número de mappers concorrentes, ajustando assim o número de arquivos gerados.Se o outputter estiver em um reducer ou joiner: Use
odps.stage.reducer.numeodps.stage.joiner.numrespectivamente para ajustar o número de arquivos gerados.
Risco de gravações inconsistentes: Ao usar uma instrução INSERT OVERWRITE em uma tabela externa do OSS ou usar o comando UNLOAD para exportar arquivos para o OSS, os dados no subdiretório do local OSS especificado ou no local correspondente à partição são excluídos antes que novos dados sejam gravados. Se o diretório de localização contiver dados importantes gravados diretamente no OSS por outros mecanismos externos, esses dados também serão excluídos antes da gravação dos novos dados. Portanto, garanta que os arquivos existentes no diretório de localização da tabela externa estejam em backup ou que o diretório UNLOAD esteja vazio. Para outros riscos de gravações inconsistentes, consulte Scope.
Contém apenas dígitos, letras e underscores (a-z, A-Z, 0-9, _).
O comprimento deve estar entre 1 e 10 caracteres.
True
False
Contém apenas dígitos, letras e underscores (a-z, A-Z, 0-9, _).
O comprimento deve estar entre 1 e 10 caracteres.
Tem prioridade maior que o parâmetro
odps.external.data.enable.extension.-
Defina o prefixo personalizado para arquivos gravados no OSS como
test06_. O DDL é o seguinte:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='test06_') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');Após a gravação dos dados, os arquivos gerados no OSS serão nomeados com o prefixo personalizado
test06_, por exemplo,test06_202509101. -
Para personalizar o sufixo dos arquivos gravados no OSS como
_beijing, o DDL é o seguinte:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
Para gerar automaticamente uma extensão de arquivo para os arquivos de saída, use o seguinte DDL:
CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Automatically generate a file extension. 'odps.external.data.enable.extension'='true') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW'); -
Para personalizar a extensão do arquivo como
jsonlpara arquivos gravados no OSS, o DDL é o seguinte:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');O nome do arquivo gerado é
20250905072538695g3mlopvxicr4_M1_1_0_0-0_TableSink1.jsonl, com a extensão de arquivo personalizada.jsonl. -
Para arquivos gravados no OSS, defina o prefixo como
mc_, o sufixo como_beijinge a extensão do arquivo comojsonl. O DDL é o seguinte:CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- Add a custom prefix. 'odps.external.data.output.prefix'='mc_', -- Add a custom suffix. 'odps.external.data.output.suffix'='_beijing', -- Add a custom file extension. 'odps.external.data.output.explicit.extension'='jsonl') ; -- Write data to the external table. INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');O nome do arquivo gerado é
mc_20250905073013526gra1l214x6t6_M1_1_0_0-0_TableSink1_beijing.jsonl, onde20250905073013526é o carimbo de data/hora gerado pelo sistema e a parte intermediária é o identificador da tarefa. Vantagem: Controle o tamanho desejado do arquivo de saída configurando o valor do parâmetro.
Desvantagem: O tempo total de execução é maior porque a gravação de arquivos grandes reduz o grau de paralelismo, o que, por sua vez, aumenta o tempo de execução.
Prepare os dados de teste. Use a tabela de conjunto de dados público
bigdata_public_dataset.tpcds_1t.web_sales, que tem cerca de 30 GB. Os dados são armazenados em formato compactado no MaxCompute, portanto, o tamanho aumenta após a exportação.-
Crie uma tabela externa JSON.
-- Sample table name: json_ext_web_sales CREATE EXTERNAL TABLE json_ext_web_sales( c_int INT , c_string STRING ) PARTITIONED BY (pt STRING) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/demo-test/'; -
Sem definir nenhum parâmetro, grave a tabela de teste na tabela externa JSON em formato de partição dinâmica.
-- The service.mode must be turned off. set odps.service.mode=off; -- Enable the Layer 3 syntax switch. SET odps.namespace.schema=true; -- Write to the JSON external table in a dynamic partition format. INSERT OVERWRITE json_ext_web_sales PARTITION(pt) SELECT CAST(ws_item_sk AS INT) AS c_int, CAST(ws_bill_customer_sk AS string) AS c_string , COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt FROM bigdata_public_dataset.tpcds_1t.web_sales;Dois arquivos são armazenados no OSS, com tamanhos de 2.112 GB e 2.102 GB, respectivamente.
-
Adicione o parâmetro
odps.adaptive.shuffle.desired.partition.sizepara saída de arquivos grandes e grave a tabela de teste na tabela externa JSON em formato de partição dinâmica.-- The service.mode must be turned off. SET odps.service.mode=off; -- Enable the Layer 3 syntax switch. SET odps.namespace.schema=true; -- The dynamic partition capability must be enabled. SET odps.sql.reshuffle.dynamicpt=true; -- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB. SET odps.adaptive.shuffle.desired.partition.size=4096; -- Write to the JSON external table in a dynamic partition format. INSERT OVERWRITE json_ext_web_sales PARTITION(pt) SELECT CAST(ws_item_sk AS INT) AS c_int, CAST(ws_bill_customer_sk AS string) AS c_string , COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt FROM bigdata_public_dataset.tpcds_1t.web_sales;O único arquivo de dados gerado tem aproximadamente 4.214 GB de tamanho.
LOAD command: Importa dados de armazenamento externo, como o OSS, para uma tabela ou partição do MaxCompute.
UNLOAD command: Exporta dados de um projeto MaxCompute para armazenamento externo, como o OSS, para uso por outros mecanismos de computação.
-
Preparar diretórios do OSS
As informações dos dados de amostra fornecidos são as seguintes:
oss_endpoint:
oss-cn-hangzhou-internal.aliyuncs.com, que é China (Hangzhou).Nome do Bucket:
oss-mc-test.Nomes dos diretórios:
Demo1/,Demo2/,Demo3/eSampleData/.
-
Dados de tabela não particionada
O arquivo carregado no diretório
Demo1/é vehicle.csv, que contém os seguintes dados. O diretórioDemo1/é usado para mapear uma tabela não particionada criada com o analisador de dados de texto integrado.1,1,51,1,46.81006,-92.08174,9/14/2014 0:00,S 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00,W 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00,S 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00,S 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00,N 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00,SW 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00,NE 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00,N -
Dados de tabela particionada
O diretório
Demo2/contém cinco subdiretórios:direction=N/,direction=NE/,direction=S/,direction=SW/edirection=W/. Os arquivos carregados são vehicle1.csv, vehicle2.csv, vehicle3.csv, vehicle4.csv e vehicle5.csv, respectivamente. Esses arquivos contêm os seguintes dados. O diretórioDemo2/é usado para mapear uma tabela particionada criada com o analisador de dados de texto integrado.--vehicle1.csv 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle2.csv 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle3.csv 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle4.csv 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle5.csv 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00 -
Dados compactados
O arquivo carregado no diretório
Demo3/é vehicle.csv.gz. O arquivo dentro do pacote compactado é vehicle.csv, que tem o mesmo conteúdo do arquivo no diretórioDemo1/. Ele é usado para mapear uma tabela externa do OSS com propriedades de compactação. -
Dados de analisador personalizado
O arquivo carregado no diretório
SampleData/é vehicle6.csv, que contém os seguintes dados. O diretórioSampleData/é usado para mapear uma tabela externa do OSS criada com um analisador de dados open source.1|1|51|1|46.81006|-92.08174|9/14/2014 0:00|S 1|2|13|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|3|48|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|4|30|1|46.81006|-92.08174|9/14/2014 0:00|W 1|5|47|1|46.81006|-92.08174|9/14/2014 0:00|S 1|6|9|1|46.81006|-92.08174|9/14/2014 0:00|S 1|7|53|1|46.81006|-92.08174|9/14/2014 0:00|N 1|8|63|1|46.81006|-92.08174|9/14/2014 0:00|SW 1|9|4|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|10|31|1|46.81006|-92.08174|9/14/2014 0:00|N How do I merge multiple small files into a single file using an OSS external table?
How do I resolve the "Couldn't connect to server" error when reading from an OSS external table?
How do I resolve slow SQL job execution on an OSS external table?
Solution for the "table not found" error when accessing an OSS external table from Spark
-
Problema
Ao processar dados do OSS, o erro
Inline data exceeds the maximum allowed sizeé relatado. -
Causa
O OSS Store tem um limite de tamanho para cada arquivo pequeno. Um erro é relatado se um arquivo exceder 3 GB.
-
Solução
Ajuste as duas propriedades a seguir para controlar o tamanho dos dados que cada reducer grava na tabela externa, mantendo os arquivos dentro do limite de 3 GB.
set odps.sql.mapper.split.size=256; # Adjusts the size of data read by each mapper, in MB. set odps.stage.reducer.num=100; # Adjusts the number of workers in the reduce stage. -
Problema
Ao acessar uma tabela externa do OSS no MaxCompute, uma UDF que passou nos testes locais retorna o seguinte erro após ser carregada.
FAILED: ODPS-0123131:User defined function exception - Traceback: java.lang.OutOfMemoryError: Java heap spaceApós definir os seguintes parâmetros, o tempo de execução aumenta, mas o erro persiste.
set odps.stage.mapper.mem = 2048; set odps.stage.mapper.jvm.mem = 4096; -
Causa
Existem muitos arquivos de objetos na tabela externa, o que causa uso excessivo de memória, e nenhuma partição foi definida.
-
Solução
Use uma quantidade menor de dados para a consulta.
Particione os arquivos de objetos para reduzir o uso de memória.
Se for um reducer, execute a instrução
set odps.stage.reducer.num=1;Se for um joiner, execute a instrução
set odps.stage.joiner.num=1;-
Problema
Ao ler dados de uma tabela externa do OSS, o erro
ODPS-0123131:User defined function exception - common/io/oss/oss_client.cpp(95): OSSRequestException: req_id: , http status code: -998, error code: HttpIoError, message: Couldn't connect to serveré relatado. -
Causa
Causa 1: Quando a tabela externa do OSS foi criada, um endpoint público foi usado para o
oss_endpointno endereço oss_location, em vez de um endpoint interno.Causa 2: Quando a tabela externa do OSS foi criada, o endpoint de outra região foi usado para o
oss_endpointno endereço oss_location.
-
Solução
-
Para a Causa 1
Verifique se o
oss_endpointem oss_location é um endpoint interno. Se for um endpoint público, altere-o para um endpoint interno. Consulte Parameters.Por exemplo, se um usuário na região Indonesia (Jakarta) usou o endereço
oss://oss-ap-southeast-5.aliyuncs.com/<bucket>/....para criar uma tabela externa, ele deve ser alterado para o endereço interno correspondenteoss://oss-ap-southeast-5-internal.aliyuncs.com/<bucket>/..... -
Para a Causa 2
Verifique se o
oss_endpointem oss_location corresponde à região que você deseja acessar. Os nomes de domínio da rede clássica do OSS estão listados em Regions and endpoints.
-
-
Problema
Ao criar uma tabela externa do OSS, o erro
ODPS-0130071:[1,1] Semantic analysis exception - external table checking failure, error message: Cannot connect to the endpoint 'oss-cn-beijing.aliyuncs.com': Connect to bucket.oss-cn-beijing.aliyuncs.com:80 [bucket.oss-cn-beijing.aliyuncs.com] failed: Network is unreachable (connect failed)é relatado. -
Causa
Quando a tabela externa do OSS foi criada, um endpoint público foi usado para o
oss_endpointno endereço oss_location, em vez de um endpoint interno. -
Solução
Verifique se o
oss_endpointem oss_location é um endpoint interno. Se for um endpoint público, altere-o para um endpoint interno. Consulte Parameters.Por exemplo, se um usuário na região China (Beijing) usou o endereço
oss://oss-cn-beijing.aliyuncs.com/<bucket>/....para criar uma tabela externa, ele deve ser alterado para o endereço interno correspondenteoss://oss-cn-beijing-internal.aliyuncs.com/<bucket>/..... -
Leitura lenta de arquivos compactados GZ em uma tabela externa do OSS
-
Sintomas
Um usuário criou uma tabela externa do OSS com uma fonte de dados de um arquivo compactado GZ de 200 GB no OSS. O processo de leitura de dados é lento.
-
Causa
A velocidade de processamento SQL é lenta porque poucos mappers estão executando a computação no estágio map.
-
Solução
-
Para dados estruturados, defina o seguinte parâmetro para ajustar a quantidade de dados lidos por um único mapper e acelerar a execução do SQL.
set odps.sql.mapper.split.size=256; # Adjusts the size of table data read by each mapper, in MB. Para dados não estruturados, verifique se há apenas um arquivo OSS no caminho da tabela externa do OSS. Se houver apenas um, apenas um mapper poderá ser gerado porque dados não estruturados em formato compactado não podem ser divididos. Isso resulta em velocidade de processamento lenta. Recomendamos dividir o arquivo OSS grande em arquivos menores no caminho da tabela externa correspondente no OSS. Isso aumenta o número de mappers gerados quando a tabela externa é lida e melhora a velocidade de leitura.
-
-
-
Busca lenta de dados de tabela externa do MaxCompute usando um SDK
-
Sintomas
A busca de dados de tabela externa do MaxCompute usando um SDK é lenta.
-
Solução
Tabelas externas suportam apenas varreduras completas de tabela, o que é lento. Use uma tabela interna do MaxCompute em vez disso.
-
-
Problema
Em um cenário de
insert overwrite, se o job falhar em casos extremos, o resultado pode ser inconsistente com o esperado. Os dados antigos são excluídos, mas os novos dados não são gravados. -
Causa
Os dados recém-gravados falham ao serem escritos na tabela de destino devido a uma probabilidade muito baixa de falha de hardware ou falha de atualização de metadados. A operação de exclusão no OSS não suporta rollback, portanto, os dados antigos excluídos não podem ser recuperados.
-
Solução
Se você estiver sobrescrevendo uma tabela externa do OSS com base em seus dados antigos, por exemplo,
insert overwrite table T select * from table T;, faça backup dos dados do OSS antecipadamente. Se o job falhar, você poderá então sobrescrever a tabela externa do OSS com base nos dados antigos do backup.Se o job
insert overwritepuder ser reenviado, simplesmente reenvie o job se ele falhar.
-
Problema
Ao usar o Spark para acessar uma tabela externa do OSS, a tarefa falha com um erro "table not found".
-
Solução
-
Adicione os seguintes parâmetros:
Habilitar configuração de tabela externa:spark.sql.catalog.odps.enableExternalTable=true;
Configurar a região onde o OSS está localizado:spark.hadoop.odps.oss.region.default=cn-<region>
-
Se o erro persistir após adicionar os parâmetros acima:
at java.lang.Thread.run(Thread.java:745) Caused by: java.lang.Exception: com.aliyun.odps.cupid.CupidException: connectionId and rolearn are mutually exclusive at com.aliyun.odps.cupid.table.v1.commontable.impl.reader.CupidCommonTableReadSession.splitTableRecrie a tabela externa do OSS e acesse-a novamente.
-
-
Formatos de tabela externa do OSS suportados:
Criar uma tabela externa do OSS e ler ou gravar no OSS usando um analisador personalizado: Custom parsers.
Analisar um arquivo do OSS em um conjunto de dados com um esquema que suporta filtragem e processamento de colunas: Special feature: Schemaless Query.
Ler dados do OSS
Observações
Sintaxe
<select_statement> FROM <from_statement>;Dados não particionados
Dados não particionados
Após criar uma tabela externa do OSS não particionada, leia dados do OSS usando um dos métodos a seguir:
Dados particionados
Dados particionados
O MaxCompute realiza uma varredura completa de todos os dados no diretório do OSS, incluindo subdiretórios. Para grandes conjuntos de dados, isso causa E/S desnecessária e aumenta o tempo de processamento. Duas soluções estão disponíveis.
Formato de caminho particionado padrão
oss://<oss_endpoint>/<Bucket name>/<directory name>/<partitionKey1=value1>/<partitionKey2=value2>/...Exemplo: Uma empresa armazena arquivos de log diários em formato CSV no OSS e processa os dados diariamente usando o MaxCompute. O caminho particionado padrão para armazenar dados do OSS deve ser definido da seguinte forma.
oss://oss-odps-test/log_data/year=2016/month=06/day=01/logfile
oss://oss-odps-test/log_data/year=2016/month=06/day=02/logfile
oss://oss-odps-test/log_data/year=2016/month=07/day=10/logfile
oss://oss-odps-test/log_data/year=2016/month=08/day=08/logfile
...
Formato de caminho particionado personalizado
Um formato de caminho particionado personalizado contém apenas valores de colunas de partição, não nomes de colunas de partição. Exemplo:
oss://oss-odps-test/log_data_customized/2016/06/01/logfile
oss://oss-odps-test/log_data_customized/2016/06/02/logfile
oss://oss-odps-test/log_data_customized/2016/07/10/logfile
oss://oss-odps-test/log_data_customized/2016/08/08/logfile
...
Se os dados do OSS usarem um caminho particionado não padrão, vincule subdiretórios a partições manualmente.
Após criar a tabela externa, use alter table ... add partition ... location ... para vincular subdiretórios a partições. Exemplo:
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '01')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/01/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '02')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/02/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '07', day = '10')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/07/10/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '08', day = '08')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/08/08/';
Otimização de consulta
Coleta dinâmica de estatísticas
Coleta dinâmica de estatísticas
Dados externos carecem de estatísticas pré-existentes, fazendo com que o otimizador de consultas use uma estratégia conservadora e de baixa eficiência. A coleta dinâmica de estatísticas permite que o otimizador colete estatísticas da tabela durante a execução da consulta para identificar tabelas pequenas, habilitando Hash Join, ordem de junção otimizada, menos shuffles e pipelines de execução mais curtos.
Os parâmetros a seguir aplicam-se apenas a cenários de tabelas Hive no OSS (como Parquet, ORC, JSON e CSV) e não se aplicam a cenários de tabelas de lake, como tabelas externas Paimon, tabelas externas Hudi ou tabelas externas Delta Lake.
SET odps.meta.exttable.stats.onlinecollect=true;
SELECT * FROM <tablename>;
Teste de desempenho
Conjunto de dados de teste: TPC-DS data
Escala do teste: 100 GB
Recursos do teste: 100 CU
Observações: Como os cenários de negócios variam, recomenda-se uma avaliação adicional com base em suas cargas de trabalho específicas. Ative o sinalizador seletivamente de acordo com seu SQL de negócios.
Otimização de divisão de tabela externa
Otimização de divisão de tabela externa
Ajuste o tamanho da divisão para controlar a quantidade de dados que cada tarefa concorrente processa.
-- You can use either of the following parameters.

-- Unit: MiB. Default value: 256 MiB. Applies to internal or external tables.
SET odps.stage.mapper.split.size=<value>;
SELECT * FROM <tablename>;

-- Unit: MiB. Default value: 256 MiB. Applies only to external tables.
SET odps.sql.unstructured.data.split.size=<value>;
SELECT * FROM <tablename>;
Controle de DOP
Controlar paralelismo com DOP
Defina o parâmetro odps.sql.split.dop para ajustar o grau de paralelismo ao ler dados. Este parâmetro tem prioridade maior que odps.sql.mapper.split.size.
Sintaxe
-- Syntax for the two-tier model: set odps.sql.split.dop={"project.table": xxx};
-- Syntax for the three-tier model: set odps.sql.split.dop={"project.schema.table": xxx};

SET odps.sql.split.dop={
  "project.schema.table1": xxx,
  "project.schema.table2": yyy
};

SET odps.sql.common.table.planner.ext.hive.bridge=FALSE;

SELECT * FROM <your_table>;
Exemplo de uso
Problema e solução para distorção de DOP causada por muitos arquivos pequenos
O MaxCompute limita uma única instância a processar no máximo 240 arquivos. Se um diretório de tabela externa do OSS contiver 3.449 arquivos, o grau mínimo de paralelismo será 3.449 / 240 ≈ 15. Se você definir o DOP com um valor menor que 15, a configuração será ignorada.
Para resolver isso, defina odps.input.file.num.limit para alterar o número máximo de arquivos que uma única instância pode processar.
SET odps.sql.split.dop = {"lakehouse47_3.tpch_1t_parquet_snappy.lineitem": 2};
SET odps.input.file.num.limit = 5000;
Uma única instância pode processar até 5.000 arquivos do OSS. Como o número de arquivos na tabela lineitem está bem abaixo desse limite, o grau real de paralelismo corresponde ao valor DOP configurado.
Gravar dados no OSS
O MaxCompute pode gravar dados de tabelas internas ou tabelas externas processadas no OSS. Para limites, consulte Scope.
Sintaxe
INSERT {INTO|OVERWRITE} TABLE <table_name> PARTITION (<ptcol_name>[, <ptcol_name> ...])
<select_statement> FROM <from_statement>;|
Parâmetro |
Obrigatório |
Descrição |
|
table_name |
Sim |
Nome da tabela externa onde os dados serão gravados. |
|
select_statement |
Sim |
A cláusula |
|
from_statement |
Sim |
A cláusula |
Para inserir dados em partições dinâmicas, consulte Insert or overwrite data into dynamic partitions .
Observações
Gravar dados no OSS usando o recurso de upload multipart do OSS
Para gravar dados no OSS em formato open source, crie uma tabela externa com um analisador de dados open source e ative o recurso multipart upload do OSS.
Para ativar o recurso de upload multipart do OSS, defina o seguinte:
Cenário | Comando |
Definir no nível do projeto | Tem efeito em todo o projeto. |
Definir no nível da sessão | Tem efeito apenas na tarefa atual. |
O valor padrão de odps.sql.unstructured.oss.commit.mode é false. Os dois modos funcionam da seguinte forma:
|
Valor |
Princípio |
|
false |
Os dados são armazenados em uma pasta .odps sob o diretório LOCATION, com um arquivo .meta para consistência dos dados. O conteúdo de .odps só pode ser processado corretamente pelo MaxCompute. Outros mecanismos podem falhar ao analisá-lo. |
|
true |
O MaxCompute usa o recurso de upload multipart para ser compatível com outros mecanismos de processamento de dados. Ele utiliza um método de |
Gerenciar arquivos exportados
Parâmetros
Adicione um prefixo, sufixo ou extensão aos arquivos de dados de saída usando os seguintes parâmetros.
property_name | Cenário | Descrição | property_value | Valor padrão |
odps.external.data.output.prefix (Compatível com odps.external.data.prefix) | Adicione esta propriedade quando precisar adicionar um prefixo personalizado aos arquivos de saída. | Uma combinação de caracteres permitidos, como 'mc_' | Nenhum | |
odps.external.data.enable.extension | Adicione esta propriedade quando precisar exibir a extensão dos arquivos de saída. | True indica que a extensão do arquivo de saída é exibida. False indica que não é exibida. | False | |
odps.external.data.output.suffix | Adicione esta propriedade quando precisar adicionar um sufixo personalizado aos arquivos de saída. | Contém apenas dígitos, letras e underscores (a-z, A-Z, 0-9, _). | Uma combinação de caracteres permitidos, como '_hangzhou' | Nenhum |
odps.external.data.output.explicit.extension | Adicione esta propriedade quando precisar adicionar uma extensão personalizada aos arquivos de saída. | Uma combinação de caracteres permitidos, como "jsonl" | Nenhum |
Exemplos
Gravar arquivos grandes usando partições dinâmicas
Cenário de negócios
Exporte resultados de cálculo de uma tabela ancestral para o OSS como partições, gravando-os como arquivos grandes (ex.: 4 GB). Configure o parâmetro odps.adaptive.shuffle.desired.partition.size (em MB) com partições dinâmicas.
Descrições das métricas
-- The service.mode must be turned off.
SET odps.service.mode=off;

-- The dynamic partition capability must be enabled.
SET odps.sql.reshuffle.dynamicpt=true;

-- Set the desired data consumption for each reducer. Assume you want each file to be 4 GB.
SET odps.adaptive.shuffle.desired.partition.size=4096;
Exemplo
Grave um arquivo JSON de aproximadamente 4 GB no OSS.
Operações de partição em tabelas externas do OSS
Tabelas externas do OSS suportam operações de partição. Consulte Partition operations on OSS external tables e Partition operations on internal tables. A tabela a seguir lista as operações suportadas.
|
Operação |
Suportado |
|
Adicionar partição |
|
|
Modificar hora de atualização da partição |
|
|
Modificar valor da partição |
|
|
Mesclar partições |
|
|
Listar partições |
|
|
Visualizar informações da partição |
|
|
Excluir partição |
|
|
Truncar partição |
|
Importar do OSS ou exportar para o OSS
Apêndice: Preparar dados de amostra
Perguntas frequentes sobre tabelas externas do OSS
Como resolvo o erro "Inline data exceeds the maximum allowed size" ao processar dados do OSS usando uma tabela externa?
Como resolvo um erro de estouro de memória que ocorre após carregar uma UDF para acessar uma tabela externa do OSS no MaxCompute, mesmo que a UDF tenha passado nos testes locais?
Como mesclar vários arquivos pequenos em um único arquivo usando uma tabela externa do OSS?
Verifique o log do Logview para ver se o último estágio no plano de execução SQL é um reducer ou um joiner.
Como resolvo o erro "Couldn't connect to server" ao ler de uma tabela externa do OSS?
Como resolvo o erro "Network is unreachable (connect failed)" ao criar uma tabela externa do OSS?
Como resolvo a execução lenta de jobs SQL em uma tabela externa do OSS?
Como resolvo o problema em que dados antigos são excluídos, mas novos dados não são gravados ao usar o recurso de upload multipart do OSS?
Solução para o erro "table not found" ao acessar uma tabela externa do OSS a partir do Spark