Neste tutorial, você utiliza o Realtime Compute for Apache Flink para processar dados de log e gravar os resultados no Alibaba Cloud Elasticsearch para pesquisa. O exemplo usa o Simple Log Service (SLS) como source de logs.
Pré-requisitos
Antes de começar, conclua as seguintes operações:
Ative o Realtime Compute for Apache Flink e crie um projeto.
Crie uma instância do Alibaba Cloud Elasticsearch. Para mais informações, consulte Create an Alibaba Cloud Elasticsearch cluster.
Ative o SLS e crie um projeto e um Logstore. Para mais informações, consulte Activate Simple Log Service, Manage projects e Create a basic LogStore.
Informações de fundo
O Realtime Compute for Apache Flink é um service Flink da Alibaba Cloud que lê e grava em vários sistemas, incluindo Kafka e Elasticsearch. É possível combinar Flink e Elasticsearch para cenários de recuperação de logs.
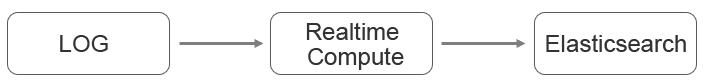
Logs provenientes de sistemas como Kafka ou SLS são computados no Flink e depois gravados no Elasticsearch para pesquisa. O Flink executa a computação em tempo real e o Elasticsearch atende às consultas, permitindo que você pesquise dados assim que eles chegam.
O Flink integra-se diretamente ao Elasticsearch. Por exemplo, se seus logs ou dados comerciais forem gravados no SLS e precisarem ser computados antes de se tornarem pesquisáveis no Elasticsearch, utilize o seguinte link de dados.
Procedimento
Faça login no console do Realtime Compute.
Crie um job do Realtime Compute for Apache Flink. Para mais informações, consulte Flink SQL job.
-
Escreva o Flink SQL.
-
Crie uma tabela source do SLS.
create table sls_stream(
  a int,
  b int,
  c VARCHAR
)
WITH (
  type ='sls',
  endPoint ='<yourEndpoint>',
  accessId ='<yourAccessId>',
  accessKey ='<yourAccessKey>',
  startTime = '<yourStartTime>',
  project ='<yourProjectName>',
  logStore ='<yourLogStoreName>',
  consumerGroup ='<yourConsumerGroupName>'
);
Os parâmetros WITH estão descritos na tabela a seguir.
Parâmetro
Descrição
endPoint
Endpoint público do SLS, correspondente à URL usada para acessar o projeto do SLS e os dados de log nele contidos. Para mais informações, consulte Endpoints. Por exemplo, o endpoint do SLS na região de Hangzhou é
http://cn-hangzhou.log.aliyuncs.com. Caso o valor do endpoint obtido não inclua um esquema, adicionehttp://antes do valor.accessId
AccessKey ID da sua conta.
accessKey
AccessKey secret da sua conta.
startTime
Momento em que o consumo de logs tem início. Ao iniciar um job do Flink, o horário de consumo selecionado deve ser posterior a este valor.
project
Nome do projeto do SLS.
logStore
Nome do Logstore no projeto do SLS.
consumerGroup
Nome do grupo de consumidores do SLS.
-
Crie uma tabela de resultados do Elasticsearch.
O Flink 3.2.2 e versões posteriores suportam tabelas de resultados do Elasticsearch. Ao criar um job do Flink, selecione a versão 3.2.2 ou superior.
A tabela de resultados do Elasticsearch utiliza a REST API e é compatível com todas as versões do Elasticsearch.
CREATE TABLE es_stream_sink(
  a int,
  cnt BIGINT,
  PRIMARY KEY(a)
)
WITH(
  type ='elasticsearch-7',
  endPoint = 'http://<instanceId>.public.elasticsearch.aliyuncs.com:9200',
  accessId = '<yourAccessId>',
  accessKey = '<yourAccessSecret>',
  index = '<yourIndex>',
  typeName = '<yourTypeName>'
);
Os parâmetros WITH estão descritos na tabela a seguir.
Parâmetro
Descrição
endPoint
Endpoint público da instância do Alibaba Cloud Elasticsearch, no formato
http://<instanceId>.public.elasticsearch.aliyuncs.com:9200. É possível obter o endpoint na página Basic Information da instância. Para mais informações, consulte Basic cluster information.accessId
Nome de usuário utilizado para acessar a instância do Alibaba Cloud Elasticsearch. O nome de usuário padrão é
elastic.accessKey
Senha do usuário que acessa a instância do Alibaba Cloud Elasticsearch. A senha do usuário
elasticé definida durante a criação da instância. Caso tenha esquecido a senha, você pode redefini-la. Para precauções e procedimento de redefinição de senha, consulte Reset the Elasticsearch cluster password.index
Nome do índice. Se ainda não tiver criado um índice, crie-o primeiro. Para mais informações, consulte Beginner: Create a cluster and retrieve data. Também é possível ativar a criação automática de índices, e o Elasticsearch criará o índice para você. Para mais informações, consulte Configure YML parameters.
typeName
Tipo do índice. Para instâncias do Elasticsearch versão 7,0 ou posterior, este parâmetro deve ser _doc.
O Elasticsearch atualiza documentos com base na
PRIMARY KEY, e aPRIMARY KEYpode conter apenas um campo. Após especificar aPRIMARY KEY, o ID do documento corresponde ao valor do campoPRIMARY KEY. Se você não especificar aPRIMARY KEY, o sistema gera um ID de documento aleatório. Para mais informações, consulte Index API.-
O Elasticsearch suporta múltiplos modos de atualização. Na cláusula WITH da tabela de resultados
es_stream_sink, o parâmetro opcional que controla o modo de atualização é updateMode:Quando
updateMode=full, novos documentos sobrescrevem completamente os documentos existentes.Quando
updateMode=inc, o Elasticsearch atualiza os campos correspondentes com base nos valores dos campos de entrada.Por padrão, todas as atualizações do Elasticsearch usam semântica UPSERT, o que significa INSERT ou UPDATE.
-
Processe a lógica de negócios e sincronize os dados.
INSERT INTO es_stream_sink
SELECT
  a,
  count(*) as cnt
FROM sls_stream GROUP BY a
-
Publique e inicie o job. Após publicar e iniciar o job, os dados no SLS são agregados e então gravados no Alibaba Cloud Elasticsearch.
Mais informações
Se você tiver requisitos de gravação no Elasticsearch mais complexos, utilize o recurso de sink personalizado do Realtime Compute for Apache Flink.