Falhas no nível de zona de disponibilidade são eventos extremos, mas possíveis, em serviços de nuvem. Caso ocorram, as cargas de trabalho nessa zona podem ficar indisponíveis, inacessíveis ou retornar erros de dados. Este tópico demonstra como usar o Container Service for Kubernetes (ACK) da Alibaba Cloud em conjunto com o Service Mesh (ASM) da Alibaba Cloud para implementar a recuperação de desastres nesses cenários.
Contexto
Alta disponibilidade de componentes gerenciados
Todos os componentes gerenciados dos clusters ACK e das instâncias ASM são implantados com múltiplas réplicas distribuídas uniformemente por várias zonas de disponibilidade. Isso garante que o cluster e o plano de controle da malha de serviço permaneçam operacionais mesmo se uma única zona de disponibilidade falhar. Da mesma forma, os nós de trabalho e as instâncias de contêiner elástico dentro do cluster também se distribuem por diferentes zonas de disponibilidade. Em caso de falha no nível de zona de disponibilidade, como uma interrupção de energia ou de rede, as zonas saudáveis continuam a operar normalmente.
Configurações de alta disponibilidade e malha de serviço para falhas em zonas de disponibilidade
Para lidar com falhas no nível de zona de disponibilidade, implante suas cargas de trabalho de aplicação uniformemente entre diferentes zonas de disponibilidade.
O ACK oferece suporte a pools de nós multizona (AZ). Ao criar e gerenciar um pool de nós, selecione vSwitches de AZs diferentes e escolha uma política de distribuição equilibrada ao configurar uma política de dimensionamento automático. Isso permite distribuir as instâncias ECS uniformemente pelas múltiplas AZs especificadas para o grupo de dimensionamento. Além disso, use recursos como dimensionamento automático de nós, conjuntos de implantação e distribuição multi-AZ, combinados com restrições de propagação de topologia do Kubernetes, para implantar cargas de trabalho de maneira uniforme em diferentes AZs. Para obter detalhes, consulte Configurações recomendadas para uma arquitetura de cluster de alta disponibilidade.
Após implantar sua aplicação em múltiplas zonas de disponibilidade, monitore a integridade das aplicações Kubernetes e do cluster em tempo real para detectar falhas nas zonas de disponibilidade e responder rapidamente na restauração dos serviços.
A tecnologia de malha de serviço melhora a observabilidade de rede do sistema. Os proxies do plano de dados na malha de serviço expõem métricas essenciais relacionadas a solicitações de rede e interações de serviços de aplicação. Essas métricas, que incluem dados específicos de zonas de disponibilidade, podem sinalizar vários problemas e ajudar na detecção de falhas nessas zonas.
Para falhas no nível de zona de disponibilidade, o ASM fornece recuperação de desastres combinando seus recursos de deslocamento de tráfego com os do balanceador de carga. Quando uma zona de disponibilidade fica indisponível, responda aos alertas configurando o deslocamento de tráfego para redirecionar temporariamente o tráfego de rede intracluster para longe da zona afetada. Assim que a zona recuperar a integridade, retome o envio de tráfego para ela.
Arquitetura de recuperação de desastres
O tratamento de falhas no nível de zona de disponibilidade envolve várias etapas:
Implantar cargas de trabalho uniformemente em múltiplas zonas de disponibilidade e provisionar capacidade em cada uma delas.
Monitorar métricas de serviço para detectar falhas.
-
Quando uma zona de disponibilidade falhar, deslocar rapidamente o tráfego para longe da zona afetada (manual ou automaticamente) para recuperar o serviço. Isso envolve principalmente:
Deslocamento de tráfego de entrada: garantir que o balanceador de carga que atua como entrada de tráfego pare de enviar requisições para a zona de disponibilidade afetada.
Deslocamento de tráfego intracluster: garantir que as chamadas de serviço dentro do cluster não enviem mais tráfego para a zona de disponibilidade afetada.
Conforme ilustrado na figura a seguir, para lidar com falhas em múltiplas zonas de disponibilidade, crie um cluster ACK com nós de trabalho em várias zonas e implante suas cargas de trabalho uniformemente entre elas. Colete logs do plano de controle e eventos do cluster ACK e das instâncias ASM no Log Service (SLS). O ACK e o ASM podem coletar métricas relacionadas a nós, contêineres e serviços no Alibaba Cloud Managed Service for Prometheus. Essa configuração permite observar prontamente eventos de falha em diferentes níveis e visualizar o status dos serviços dentro do cluster por meio de logs e painéis do Grafana. Para a entrada do cluster, utilize um balanceador de carga compatível com arquitetura multi-zona ativo-ativo, como um Network Load Balancer (NLB) ou um Application Load Balancer (ALB).

O ASM relata continuamente logs de acesso e métricas de solicitação para todo o tráfego de entrada e saída dos serviços no cluster. Ele agrega métricas como códigos de resposta, latência e tamanhos de solicitação. Quando ocorre uma falha parcial em uma zona de disponibilidade, as métricas de solicitação e as configurações de alerta fornecidas pela malha de serviço são valiosas para determinar o escopo e os sintomas da falha. Este exemplo descreve como visualizar as métricas de tráfego de serviço relatadas pela malha. Para informações sobre métricas de carga de trabalho do cluster e configurações de alerta, consulte Conectar e configurar o Managed Service for Prometheus, Gerenciamento de alarmes para Container Service e Monitoramento de eventos.
Configuração de recuperação de desastres
Este exemplo demonstra como executar a recuperação de desastres para uma falha no nível de zona de disponibilidade usando um cluster que abrange múltiplas zonas.
Etapa 1: Preparar o ambiente
Crie um cluster gerenciado ACK. Durante a criação do cluster, selecione vSwitches de duas zonas de disponibilidade para habilitar o suporte multi-AZ. Mantenha os valores padrão para as demais configurações. O pool de nós usa a política de dimensionamento de distribuição equilibrada por padrão. Para mais informações, consulte Criar um cluster gerenciado ACK.
Crie uma instância ASM com a mesma configuração de zona de disponibilidade do cluster ACK. Para mais informações, consulte Criar uma instância ASM.
-
Implante o gateway e uma aplicação de exemplo.
-
Na instância ASM, crie um ASM Gateway e associe-o a um Network Load Balancer (NLB). Selecione as mesmas duas zonas de disponibilidade para o NLB que foram usadas para a instância ASM e o cluster ACK (neste exemplo,
cn-hangzhou-kecn-hangzhou-h). Para mais informações, consulte Usar uma instância NLB em um gateway de entrada ASM.NotaEste exemplo usa um ASM Gateway associado a um NLB como entrada de tráfego. Também é possível usar um Application Load Balancer (ALB) como entrada para sua aplicação. Os ALBs também oferecem recursos de recuperação de desastres multi-zona e remoção de registros DNS.
Desative o recurso de encaminhamento entre zonas para o NLB. Isso garante que o NLB em cada zona de disponibilidade encaminhe o tráfego apenas para backends dentro da mesma zona.
Ative a injeção automática de sidecar para o namespace
default. Para mais informações, consulte Gerenciar o namespace global.-
Implante a aplicação de exemplo.
O comando anterior implanta uma aplicação composta pelos serviços
mocka,mockbemockc. Cada serviço inclui dois deployments stateless, cada um com uma única réplica. Os deployments são distribuídos para nós em diferentes zonas de disponibilidade usando camposnodeSelectordistintos e configurados com variáveis de ambiente para retornar a zona de disponibilidade onde estão localizados.NotaPara fornecer uma demonstração clara, este exemplo usa o campo
nodeSelectorde um pod para selecionar manualmente a zona de disponibilidade do pod. Em um ambiente de produção de alta disponibilidade, configure restrições de propagação de topologia para garantir que os pods sejam distribuídos entre diferentes zonas de disponibilidade tanto quanto possível. Para mais informações, consulte Configuração de alta disponibilidade de carga de trabalho.
-
Etapa 2: Monitorar métricas de serviço
Quando ocorre uma falha, logs de carga de trabalho, métricas e alertas ajudam a detectar rapidamente o problema, determinar seu escopo e entender seu impacto ou causa raiz.
-
Adicione uma dimensão de zona de disponibilidade às métricas de solicitação.
O proxy da malha detecta automaticamente a zona de disponibilidade onde uma carga de trabalho está implantada e armazena essa informação nos metadados do proxy. Edite as dimensões da métrica para adicionar a dimensão
localityàs métricas da malha de serviço e defina seu valor comoxds.node.locality.zone, que representa a zona de disponibilidade da carga de trabalho. Para mais informações, consulte Configurações de observabilidade. -
Envie solicitações para a aplicação de exemplo para gerar métricas de requisição.
watch -n 0.1 curl nlb-xxxxxxxxxxxxx.cn-xxxxxxx.nlb.aliyuncsslb.com/mock -vSaída esperada:
> GET /mock HTTP/1.1
> Host: nlb-85h289ly4hz9qhaz58.cn-hangzhou.nlb.aliyuncsslb.com
> User-Agent: curl/8.7.1
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< date: Sun, 08 Dec 2024 11:53:26 GMT
< content-length: 150
< content-type: text/plain; charset=utf-8
< x-envoy-upstream-service-time: 5
< server: istio-envoy
<
* Connection #0 to host nlb-85h289ly4hz9qhaz58.cn-hangzhou.nlb.aliyuncsslb.com left intact
-> mocka(version: cn-hangzhou-h, ip: 192.168.122.66)-> mockb(version: cn-hangzhou-k, ip: 192.168.0.47)-> mockc(version: cn-hangzhou-h, ip: 192.168.122.44)%
A saída mostra que as solicitações são roteadas aleatoriamente para as duas zonas de disponibilidade diferentes, o que indica que as cargas de trabalho em ambas as zonas estão disponíveis.
-
Após enviar solicitações por um período, explore as métricas no Managed Service for Prometheus. Para mais informações, consulte Metric Explorer.
-
Visualize as informações de código de status de solicitação para cargas de trabalho em diferentes zonas de disponibilidade.
Para verificar a taxa de solicitação de cargas de trabalho em uma zona de disponibilidade específica (agrupada por nome de serviço e código de resposta), use a seguinte consulta PromQL na sua instância do Prometheus:
sum by(app, response_code) (rate(istio_requests_total{locality="cn-hangzhou-h", reporter="destination"}[$__rate_interval]))Resultado esperado:
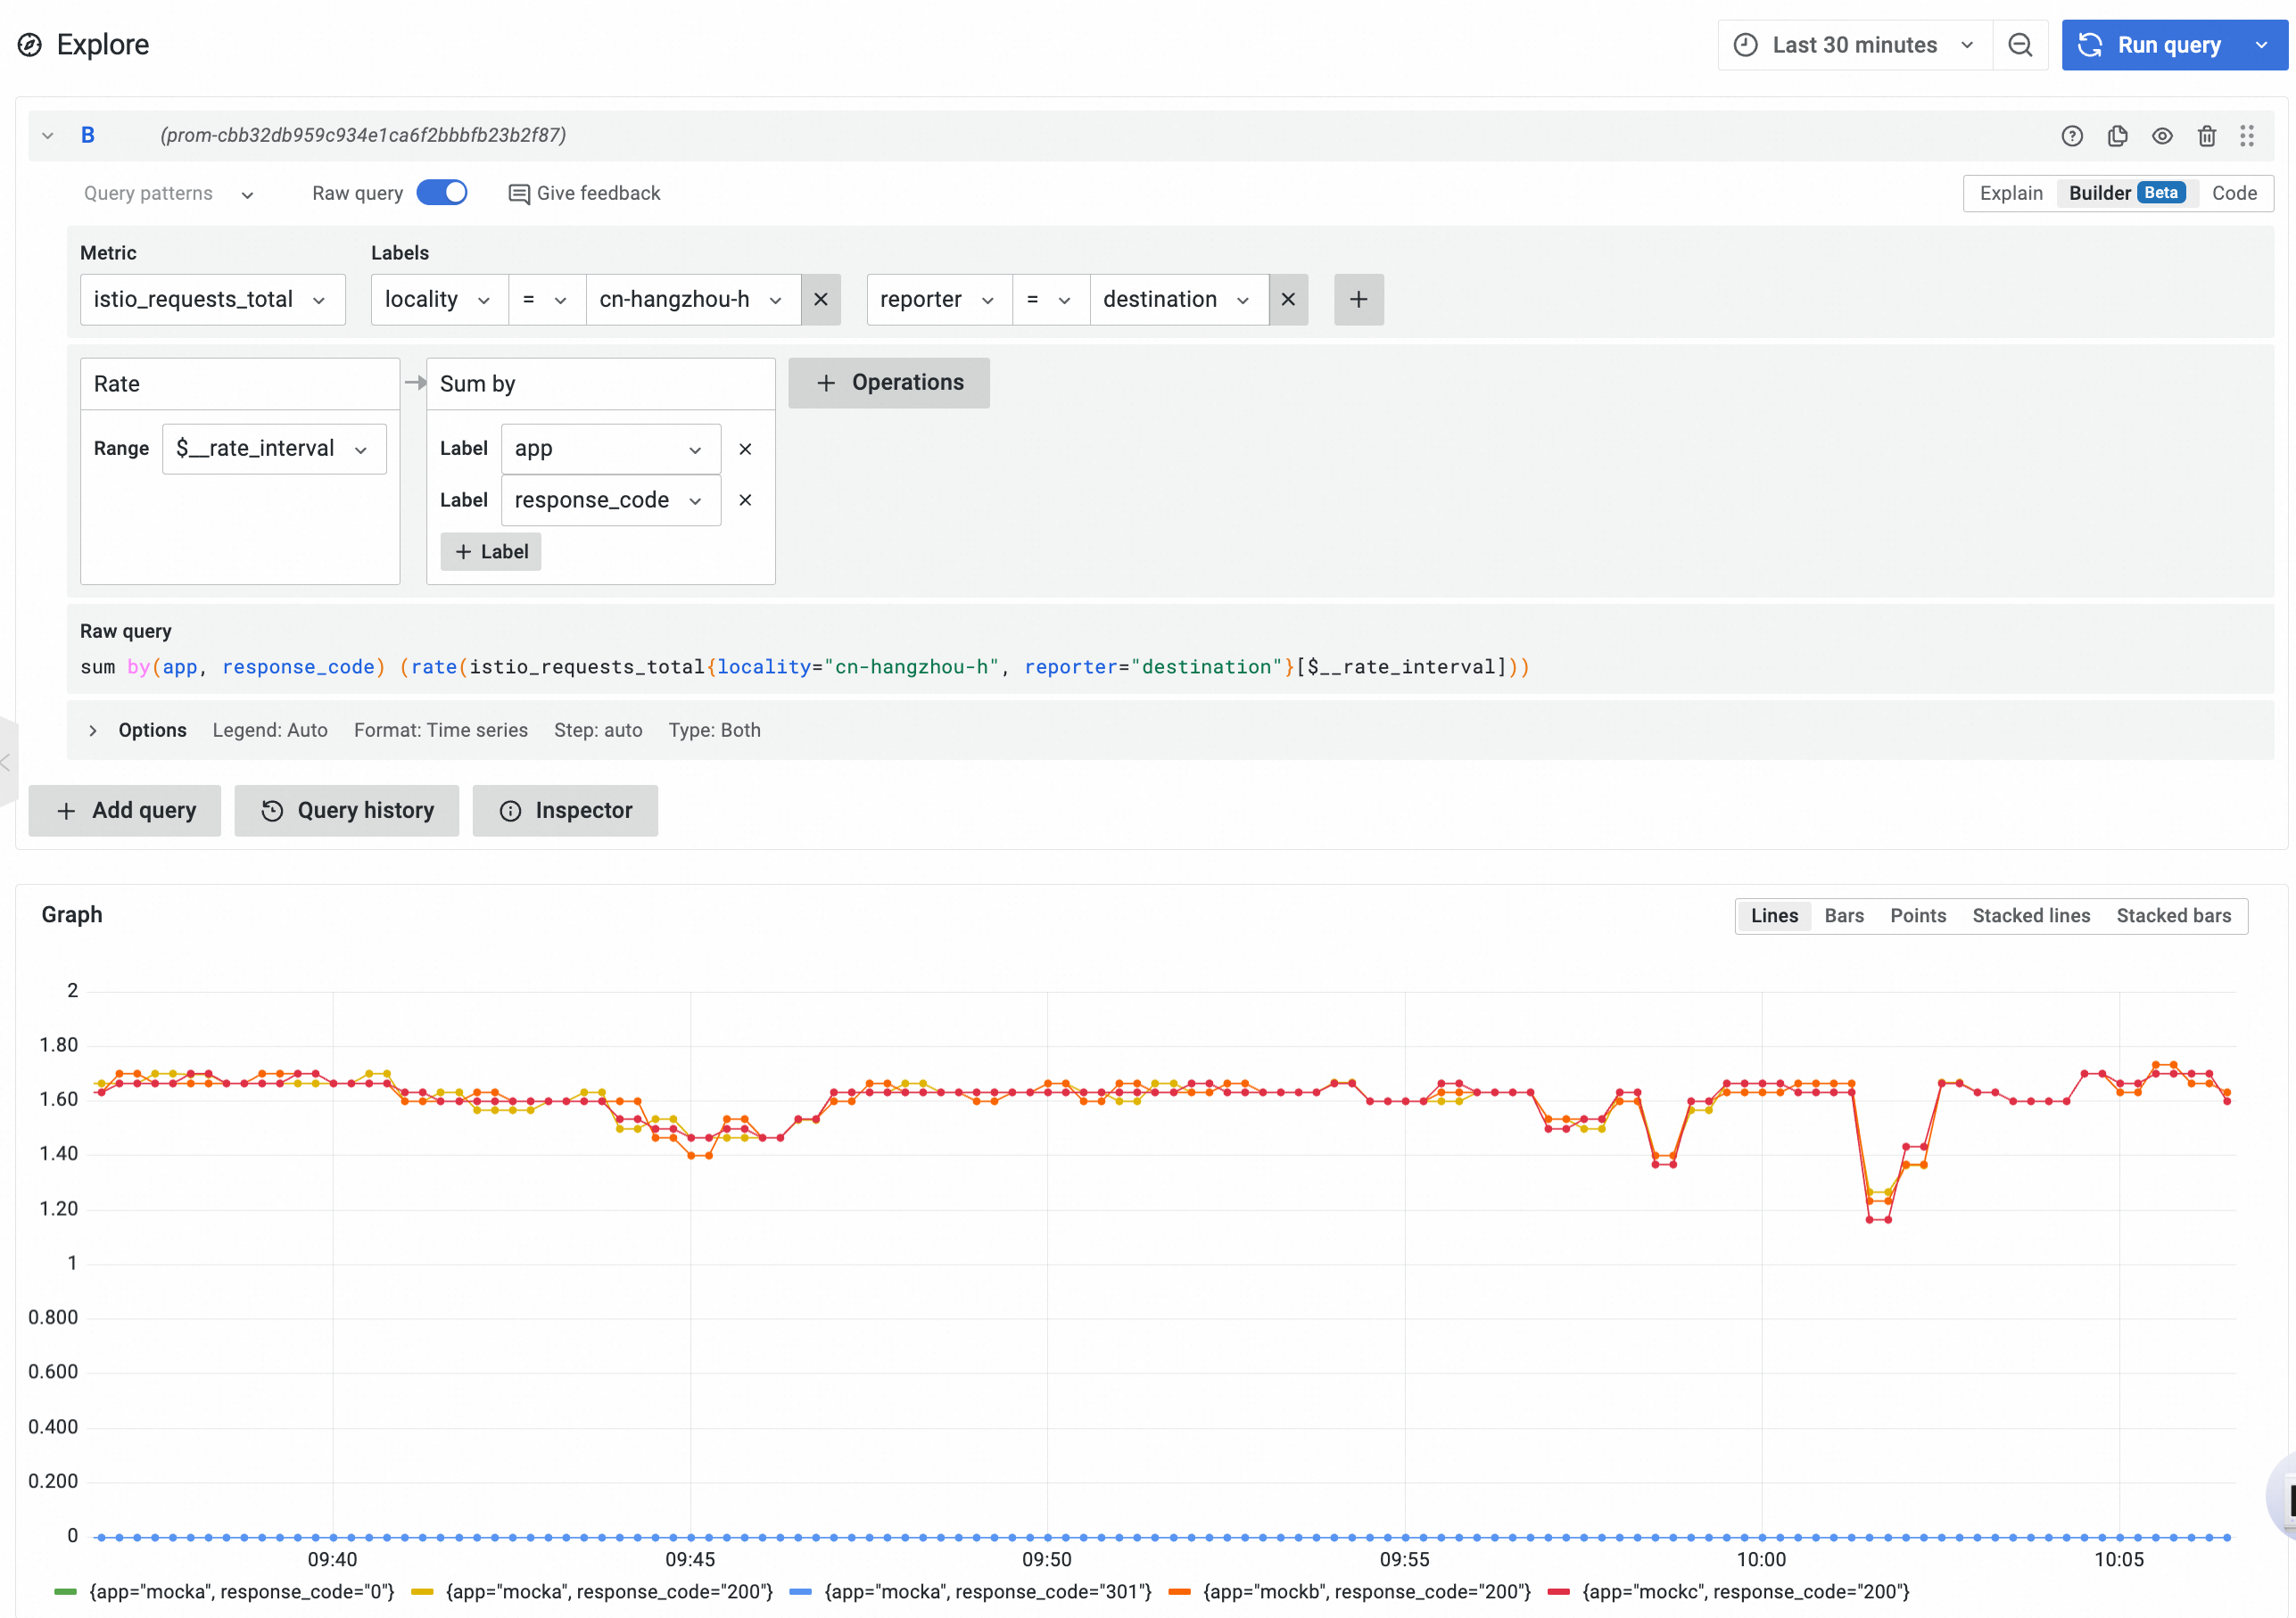
Com uma implantação uniforme, as taxas de solicitação recebidas pelas duas zonas de disponibilidade são quase idênticas. Altere a condição de filtro para
locality="cn-hangzhou-k"para visualizar a taxa de solicitação e as informações de código de status da zona de disponibilidadecn-hangzhou-k. -
Visualize as informações de latência de solicitação para cargas de trabalho em diferentes zonas de disponibilidade.
Para verificar a latência média de solicitação de cargas de trabalho em uma zona de disponibilidade específica (agrupada por nome de serviço e código de resposta), use a seguinte consulta PromQL na sua instância do Prometheus:
sum by(app, response_code) (rate(istio_request_duration_milliseconds_sum{locality="cn-hangzhou-h", reporter="destination"}[$__rate_interval]))Altere a condição de filtro para
locality="cn-hangzhou-k"para visualizar as informações de latência média da zona de disponibilidadecn-hangzhou-k.
-
-
Configure regras de alerta com base nas métricas.
Configure alertas usando consultas PromQL personalizadas. Quando a latência do serviço ou a taxa de códigos de status diferentes de 200 exceder um limiar, o Prometheus envia um alerta para o contato especificado. Para mais informações, consulte Criar uma regra de alerta do Prometheus.
-
Crie uma regra de alerta baseada na latência da aplicação.
Use a seguinte consulta PromQL para criar um alerta para o serviço
mockb.sum by(response_code, locality) (rate(istio_request_duration_milliseconds_sum{app="mockb",reporter= "destination"}[1m])) > 3A consulta acima aciona um alerta se a latência média do serviço
mockbdurante um intervalo de um minuto exceder 3 ms. Os alertas são agrupados por código de status e zona de disponibilidade. -
Crie uma regra de alerta baseada no código de status de resposta do serviço.
Use a seguinte consulta PromQL para criar um alerta para o serviço
mocka.sum by (locality, response_code) (rate(istio_requests_total{app="mocka",reporter="destination",response_code!="200"}[1m])) >= 0
Crie regras de alerta para outras aplicações alterando a configuração
app="mockb"nas regras de alerta anteriores. -
Etapa 3: Executar um simulado de recuperação de desastres
Ao receber um alerta indicando que uma zona de disponibilidade no seu cluster ACK está comprometida ou com falha, isole as cargas de trabalho de serviço implantadas nessa zona das demais. Isso permite investigar a causa da falha mantendo o negócio em funcionamento. Após a resolução da falha, restaure o tráfego para a zona de disponibilidade.
-
Isole os nós na zona de disponibilidade afetada.
Aplique um taint aos nós para impedir que novos pods sejam agendados neles. Após aplicar o taint, os nós tornam-se não agendáveis. Os pods existentes permanecem nos nós, mas nenhum novo pod é agendado naquela zona de disponibilidade. Para mais informações, consulte Definir o status de agendamento para um nó. O exemplo a seguir mostra como isolar a zona de disponibilidade
cn-hangzhou-hmarcando todos os seus nós como não agendáveis. -
Desloque o tráfego de entrada norte-sul.
Como o NLB está configurado para encaminhamento na mesma zona, use o recurso de remoção de registro DNS do NLB (ou ALB) para deslocar rapidamente o tráfego norte-sul na camada de entrada quando ocorrer uma falha. Isso impede que o tráfego externo continue fluindo para a zona de disponibilidade com falha.
Faça login no console do NLB e clique em na instância NLB associada ao ASM Gateway.
Na página de detalhes da instância do NLB, na aba Zone, localize a zona de disponibilidade afetada. Na coluna Actions, clique em Remove DNS e, em seguida, clique em OK na caixa de diálogo exibida. Após a remoção do registro DNS, o endereço IP público do NLB na zona de disponibilidade afetada deixa de ser incluído nos registros de resolução DNS.
-
Desloque o tráfego leste-oeste.
Utilize o recurso de deslocamento de tráfego por zona de disponibilidade do Alibaba Cloud Service Mesh (ASM) para redirecionar rapidamente o tráfego leste-oeste dentro do cluster, impedindo que ele alcance endpoints em uma zona de disponibilidade específica.
Faça login no console do Service Mesh e clique em na instância ASM que gerencia o cluster.
Na página de detalhes da malha, clique em Service Discovery Selectors. Clique em Show Advanced Settings, insira as informações de região e zona de disponibilidade onde os pods estão localizados e clique em OK.
Após essa operação, a instância entra brevemente em estado de atualização. Quando a atualização for concluída, os endpoints na zona de disponibilidade especificada serão excluídos do escopo de descoberta de serviço.
-
Observe o efeito do isolamento.
Continue acessando a aplicação de exemplo. Você notará que todas as respostas vêm de serviços na zona de disponibilidade
cn-hangzhou-k. Isso indica que o tráfego foi completamente deslocado para longe da zona de disponibilidadecn-hangzhou-h. Saída esperada:> Host: nlb-xxxxxxxxxxxxxxxxxxx8.cn-hangzhou.nlb.aliyuncsslb.com > User-Agent: curl/8.7.1q > Accept: */* > A * Request completely sent off < HTTP/1.1 200 OKe < date: Tue, 10 Dec 2024 04:03:26 GMT < content-length: 1500 < content-type: text/plain; charset=utf-8 < x-envoy-upstream-service-time: 30 < server: istio-envoyr < s { [150 bytes data] {100 150 100 150 0 0 2262 0 --:--:-- --:--:-- --:--:-- 2238 * Connection #0 to host nlb-xxxxxxxxxxxxxxxxxxx8.cn-hangzhou.nlb.aliyuncsslb.com left intact -> mocka(version: cn-hangzhou-k, ip: 192.168.0.44)-> mockb(version: cn-hangzhou-k, ip: 192.168.0.47)-> mockc(version: cn-hangzhou-k, ip: 192.168.0.46)