Container Service for Kubernetes oferece alta disponibilidade para planos de controle, nós, cargas de trabalho e balanceamento de carga.
Orientações deste Documento
Destinado a desenvolvedores e administradores de clusters do Container Service for Kubernetes. Este documento apresenta recomendações gerais para planejar e construir clusters de alta disponibilidade. As configurações reais variam conforme o ambiente do cluster e os requisitos de negócio. Este documento aborda configurações de alta disponibilidade tanto para o plano de controle quanto para o plano de dados do cluster.
|
Arquitetura do Documento |
Função de Manutenção |
Tipos de Cluster Aplicáveis |
|
Gerenciado pelo ACK. |
Aplica-se apenas a determinados clusters gerenciados do ACK, incluindo ACK managed clusters (Pro Edition, Basic Edition), ACK Serverless clusters (Pro Edition, Basic Edition), ACK Edge clusters e LINGJUN Clusters. Outros tipos de cluster, como ACK dedicated clusters e clusters registrados, estão excluídos (você mantém seus planos de controle), mas podem usar estas configurações como referência. |
|
|
Configurações de Alta Disponibilidade para Pools de Nós e Nós Virtuais |
Mantido por você. |
Geral. |
|
Configurações de Alta Disponibilidade para Cargas de Trabalho |
||
|
Configurações de Alta Disponibilidade para Balanceamento de Carga |
||
Arquitetura de Exemplo de Cluster
Um cluster ACK consiste em duas partes principais: o plano de controle e nós regulares ou virtuais.
-
O plano de controle gerencia o cluster, incluindo o agendamento de cargas de trabalho e a manutenção do estado. Tome como exemplo um ACK managed cluster. Um ACK managed cluster usa arquitetura Kubernetes-on-Kubernetes para hospedar componentes do plano de controle, como Kube API Server, etcd e Kube Scheduler.
-
Nós regulares ou virtuais: os clusters ACK suportam nós regulares (instâncias ECS) e nós virtuais. Os nós executam cargas de trabalho e fornecem recursos para contêineres.
Os clusters ACK fornecem implantação de alta disponibilidade multizona (multi-AZ) por padrão. A figura a seguir mostra a arquitetura de um ACK managed cluster.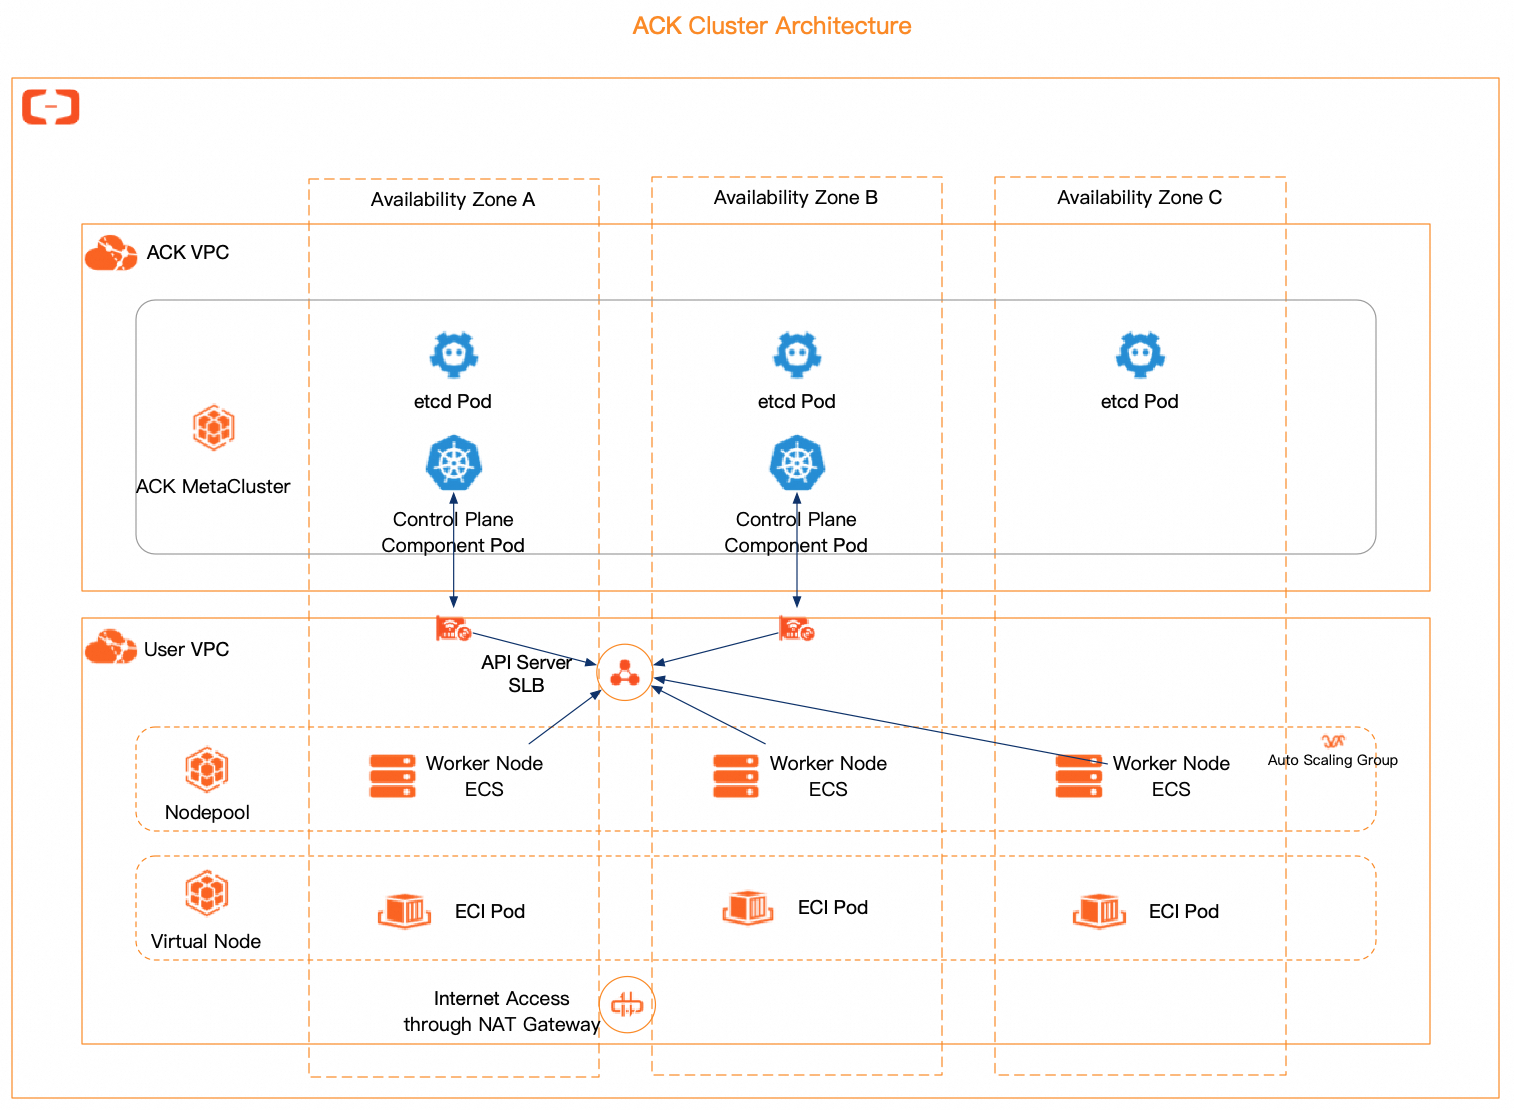
Alta Disponibilidade da Arquitetura do Plano de Controle
Para clusters gerenciados do ACK, como ACK managed clusters (Pro Edition e Basic Edition), ACK Serverless clusters (Pro Edition e Basic Edition), ACK Edge clusters e LINGJUN Clusters, o ACK gerencia seus planos de controle e componentes como kube-apiserver, etcd e kube-scheduler.
-
Regiões multizona: todos os componentes gerenciados usam implantação balanceada com múltiplas réplicas e múltiplas zonas de disponibilidade, garantindo a continuidade do serviço durante falhas de zona única ou de nó.
-
Regiões de zona única: todos os componentes gerenciados usam implantação com múltiplas réplicas e múltiplos nós, garantindo a continuidade do serviço durante falhas de nó único.
Especificamente, o etcd possui pelo menos três réplicas e o kube-apiserver pelo menos duas. Todas as réplicas do kube-apiserver se conectam à VPC do cluster por meio de Elastic Network Interfaces (ENIs). O kubelet e o Kube Proxy se conectam ao kube-apiserver por meio do Classic Load Balancer (CLB) do API Server ou de uma ENI.
Todos os componentes gerenciados essenciais escalam elasticamente com base no uso de recursos, como CPU e memória, atendendo dinamicamente aos requisitos do API Server com garantias estáveis de Service-Level Agreement (SLA).
Além da alta disponibilidade multizona padrão do plano de controle, configure a alta disponibilidade do plano de dados: Configurações de Alta Disponibilidade para Pools de Nós e Nós Virtuais, Configurações de Alta Disponibilidade para Cargas de Trabalho, Configurações de Alta Disponibilidade para Balanceamento de Carga e Configurações Recomendadas de Componentes.
Configurações de Alta Disponibilidade para Pools de Nós e Nós Virtuais
Os clusters ACK suportam nós regulares (instâncias ECS) e nós virtuais, gerenciados por meio de pools de nós para operações como atualizações, dimensionamento e O&M. Use instâncias ECS para tráfego estável ou previsível e nós virtuais para tráfego de pico, reduzindo custos. Consulte Visão geral dos pools de nós gerenciados.
Configurações de Alta Disponibilidade para Pools de Nós
Combine dimensionamento automático de nós, conjuntos de implantação, implantações multizona e restrições de distribuição de topologia do Kubernetes para isolar serviços entre domínios de falha e reduzir pontos únicos de falha.
Configurar Dimensionamento Automático de Nós
Cada pool de nós é apoiado por um grupo de Auto Scaling (ESS), que suporta dimensionamento manual e automático na camada de agendamento de carga ou de recursos do cluster. Consulte Dimensionamento automático e Ativar dimensionamento automático de nós.
Ativar Conjuntos de Implantação
Um conjunto de implantação dispersa instâncias ECS entre servidores físicos para evitar falhas co-localizadas. Especifique um conjunto de implantação para um pool de nós de modo que as instâncias expandidas sejam colocadas em máquinas físicas separadas, melhorando a recuperação de desastres e a disponibilidade. Consulte Melhores práticas para conjuntos de implantação de pools de nós.
Configurar Distribuição Multizona
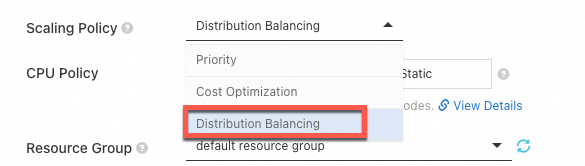
O ACK suporta pools de nós multizona. Selecione vários vSwitches de zonas diferentes ao criar um pool de nós e defina a Scaling Policy como Distribution Balancing para distribuir uniformemente as instâncias ECS entre as zonas. Se ocorrer um desequilíbrio de recursos devido a falta de estoque, execute uma operação de reequilíbrio. Consulte Ativar dimensionamento automático de nós.
Ativar Restrições de Distribuição de Topologia
O dimensionamento automático de nós, os conjuntos de implantação e a distribuição multizona, combinados com as restrições de distribuição de topologia do Kubernetes, alcançam diferentes níveis de isolamento de domínio de falha. Os nós do pool de nós do ACK recebem automaticamente rótulos de topologia como kubernetes.io/hostname, topology.kubernetes.io/zone e topology.kubernetes.io/region. Use essas restrições para controlar a distribuição de pods entre domínios de falha e melhorar a tolerância a falhas de infraestrutura.

Os clusters ACK suportam agendamento com reconhecimento de topologia, como tentar novamente pods entre domínios de topologia ou agendar pods em instâncias ECS no mesmo conjunto de implantação de baixa latência.
Configurações de Alta Disponibilidade para Nós Virtuais
Os nós virtuais do ACK agendam pods no Elastic Container Instance (ECI) sem gerenciar servidores ECS subjacentes. As instâncias ECI são criadas sob demanda com faturamento pay-as-you-go por segundo.
O dimensionamento horizontal rápido ou o lançamento de Jobs em lote podem esgotar o inventário de instâncias ou endereços IP de vSwitch em uma zona, causando falhas na criação de ECI. O recurso multizona dos clusters ACK Serverless melhora as taxas de sucesso na criação de ECI.
Configure o ECI Profile para nós virtuais e especifique vSwitches em zonas diferentes para implantação multizona.
-
O ECI distribui solicitações de criação de pods entre todos os vSwitches.
-
Se um vSwitch tiver inventário insuficiente, o ECI tenta automaticamente o próximo vSwitch.
Modifique o campo vSwitchIds no ConfigMap kube-system/eci-profile. Acrescente IDs de vSwitch separados por vírgulas (,). As alterações entram em vigor imediatamente. Consulte Criar pods ECI multizona.
kubectl -n kube-system edit cm eci-profileapiVersion: v1
data:
kube-proxy: "true"
privatezone: "true"
quota-cpu: "192000"
quota-memory: 640Ti
quota-pods: "4000"
regionId: cn-hangzhou
resourcegroup: ""
securitygroupId: sg-xxx
vpcId: vpc-xxx
vSwitchIds: vsw-xxx,vsw-yyy,vsw-zzz
kind: ConfigMapConfigurações de Alta Disponibilidade para Cargas de Trabalho
Garanta que os pods permaneçam em execução ou se recuperem rapidamente de falhas configurando restrições de distribuição de topologia, anti-afinidade de pods, Pod Disruption Budgets (PDBs) e verificações de integridade com autorrecuperação.
Configurar Restrições de Distribuição de Topologia
As restrições de distribuição de topologia distribuem pods uniformemente entre nós e zonas para melhorar a disponibilidade da aplicação. Isso se aplica a tipos de carga de trabalho como Deployment, StatefulSet, DaemonSet, Job e CronJob.
Defina maxSkew.topologyKey para controlar a distribuição de pods entre domínios de topologia, como distribuir cargas de trabalho uniformemente entre zonas. O exemplo a seguir ilustra essa configuração.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-run-per-zone
spec:
  replicas: 3
  selector:
    matchLabels:
      app: app-run-per-zone
  template:
    metadata:
      labels:
        app: app-run-per-zone
    spec:
      containers:
        - name: app-container
          image: app-image
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: "topology.kubernetes.io/zone"
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: app-run-per-zone
Configurar Anti-Afinidade de Pods
A anti-afinidade de pods impede que pods sejam agendados no mesmo nó, melhorando o isolamento de falhas. O exemplo a seguir ilustra essa configuração.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-run-per-node
spec:
  replicas: 3
  selector:
    matchLabels:
      app: app-run-per-node
  template:
    metadata:
      labels:
        app: app-run-per-node
    spec:
      containers:
        - name: app-container
          image: app-image
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: app
                    operator: In
                    values:
                      - app-run-per-node
              topologyKey: "kubernetes.io/hostname"
As restrições de distribuição de topologia também podem limitar os pods a um por nó. Com topologyKey: "kubernetes.io/hostname", cada nó funciona como um domínio de topologia.
O exemplo a seguir define maxSkew como 1, topologyKey como "kubernetes.io/hostname" e whenUnsatisfiable como DoNotSchedule, limitando a diferença de contagem de pods entre nós a no máximo um para distribuição uniforme.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app
spec:
  replicas: 3
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
        - name: my-app-container
          image: my-app-image
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: "kubernetes.io/hostname"
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: my-app
Configurar Pod Disruption Budget
Um Pod Disruption Budget (PDB) define o número mínimo de réplicas disponíveis durante a manutenção ou falha de nó, impedindo que muitas réplicas sejam encerradas simultaneamente. O exemplo a seguir ilustra essa configuração.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-with-pdb
spec:
  replicas: 3
  selector:
    matchLabels:
      app: app-with-pdb
  template:
    metadata:
      labels:
        app: app-with-pdb
    spec:
      containers:
        - name: app-container
          image: app-container-image
          ports:
            - containerPort: 80
---
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: pdb-for-app
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: app-with-pdb
Configurar Verificações de Integridade e Autorrecuperação de Pods
Configure sondas de liveness, readiness e startup com políticas de reinicialização para monitorar a integridade dos contêineres e habilitar a autorrecuperação. O exemplo a seguir ilustra essa configuração.
apiVersion: v1
kind: Pod
metadata:
  name: app-with-probe
spec:
  containers:
    - name: app-container
      image: app-image
      livenessProbe:
        httpGet:
          path: /health
          port: 80
        initialDelaySeconds: 10
        periodSeconds: 5
      readinessProbe:
        tcpSocket:
          port: 8080
        initialDelaySeconds: 15
        periodSeconds: 10
      startupProbe:
        exec:
          command:
            - cat
            - /tmp/ready
        initialDelaySeconds: 20
        periodSeconds: 15
  restartPolicy: Always
Configurações de Alta Disponibilidade para Balanceamento de Carga
Melhore a estabilidade do serviço e o isolamento de falhas especificando zonas primárias e secundárias para instâncias do Server Load Balancer (SLB) e ativando dicas com reconhecimento de topologia.
Especificar Zonas Primárias e Secundárias para Instâncias CLB
O CLB é implantado em várias zonas na maioria das regiões para recuperação de desastres entre data centers. Especifique zonas primárias e secundárias para instâncias CLB usando anotações de Service para corresponder às zonas das instâncias ECS do pool de nós, reduzindo o encaminhamento de dados entre zonas. Consulte Regiões e zonas que suportam CLB e Especificar zonas primárias e secundárias ao criar uma instância CLB.
O exemplo a seguir ilustra essa configuração.
apiVersion: v1
kind: Service
metadata:
  annotations:
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-master-zoneid: "cn-hangzhou-b"
    service.beta.kubernetes.io/alibaba-cloud-loadbalancer-slave-zoneid: "cn-hangzhou-i"
  name: nginx
  namespace: default
spec:
  ports:
  - port: 80
    protocol: TCP
    targetPort: 80
  selector:
    run: nginx
  type: LoadBalancer
Ativar dicas com reconhecimento de topologia
O Kubernetes 1.23 introduziu o roteamento com reconhecimento de topologia (dicas com reconhecimento de topologia) para reduzir o tráfego entre zonas e melhorar o desempenho da rede.
Ative esse recurso no Service. Quando endpoints suficientes estiverem disponíveis na zona, o controlador EndpointSlice prioriza o roteamento de tráfego para endpoints mais próximos da origem da solicitação com base nas dicas de topologia, mantendo o tráfego dentro da mesma zona para reduzir custos. Consulte Topology Aware Routing.
Configurações recomendadas de complementos
O ACK fornece vários componentes para estender a funcionalidade do cluster. Consulte Visão geral e notas de versão dos componentes e Gerenciar componentes.
Implantar Adequadamente o Nginx Ingress Controller
Distribua o Nginx Ingress Controller entre nós diferentes para evitar contenção de recursos e pontos únicos de falha. Use nós dedicados para melhor desempenho e estabilidade.
Evite limites de recursos para o Nginx Ingress Controller para prevenir interrupções de tráfego relacionadas a OOM. Se limites forem necessários, defina CPU em pelo menos 1000m e memória em pelo menos 2 GiB. Consulte Recomendações de uso do Nginx Ingress Controller.
Para controladores ALB Ingress ou MSE Ingress, configure várias zonas durante a criação. Consulte Criar um gateway nativo da nuvem, Criar e usar um ALB Ingress para expor Services e Comparação entre Nginx Ingress, ALB Ingress e MSE Ingress.
Implantar Adequadamente o CoreDNS
Distribua as réplicas do CoreDNS entre zonas e nós diferentes para evitar falhas de ponto único. O CoreDNS usa anti-afinidade fraca por nó por padrão; recursos insuficientes podem concentrar réplicas em um único nó. Exclua o pod para reagendar o agendamento se isso ocorrer.
Garanta que os nós do CoreDNS tenham CPU e memória suficientes para manter o QPS e a latência do DNS. Consulte Melhores práticas de DNS.
Referências
-
Use tipos de instância ECS maiores para nós de trabalho. Consulte Configurações recomendadas de tipos de instância ECS.
-
Para implantações de grande escala do ACK managed cluster Pro Edition (geralmente mais de 500 nós ou 10.000 pods), consulte Recomendações de uso para clusters de grande escala.