O diagnóstico de SQL do AnalyticDB for MySQL coleta estatísticas de execução nos níveis de consulta, stage e operador e apresenta sugestões de otimização. Este tópico explica os três tipos de resultados de diagnóstico no nível de stage e como agir com base neles.
Para obter instruções sobre como visualizar resultados de diagnóstico no nível de stage, consulte
Visualizar resultados de diagnóstico
.
Tipos de resultados de diagnóstico
Broadcast de grande volume de dados
O que significa
A operação de broadcast transmite dados de um stage upstream para um stage downstream. Quando um stage faz broadcast de um grande volume de dados, a consulta pode consumir memória excessiva. Para obter mais informações sobre broadcast e outros tipos de saída de dados, consulte Tipos de saída de dados.
Por que afeta o desempenho
Os dados de broadcast tornam-se a tabela direita em uma junção e são carregados em uma tabela hash na memória. Quanto maior o volume de broadcast, maior o consumo de memória.
Como resolver
Primeiro, determine se o broadcast é adequado para sua consulta:
-
O broadcast geralmente é a escolha correta quando a tabela direita é pequena. Ele elimina a redistribuição de dados da tabela esquerda (maior) e reduz as conexões de rede entre nós. O exemplo a seguir ilustra o motivo. Suponha que exista um skew severo de dados na coluna
bdeTsmall, enquantoTbigestá distribuída uniformemente pelos nós de armazenamento com base na colunaa. Sem o broadcast, a redistribuição deTbigcausa processamento de longa duração (long-tail), o que também atrasa o stage de junção downstream. Fazer o broadcast deTsmallelimina completamente a etapa de redistribuição e resolve o problema de long-tail.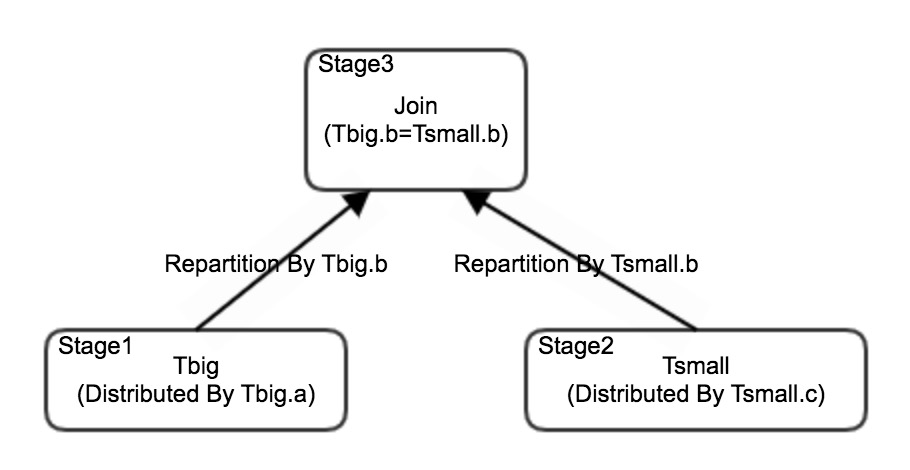
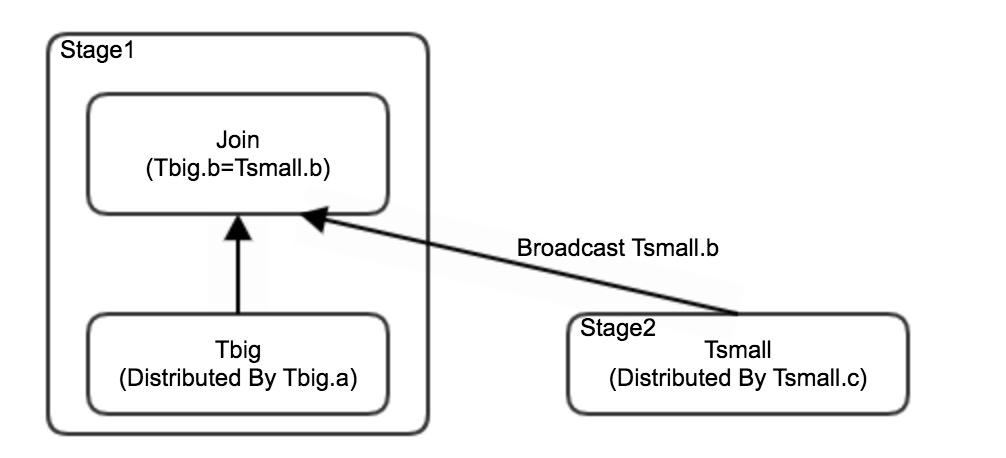
O broadcast pode ser inadequado quando as estatísticas estão desatualizadas. Estatísticas de tabela obsoletas fazem o otimizador produzir uma estimativa imprecisa do tamanho da tabela, o que leva ao broadcast não intencional de uma tabela grande. Nesse caso, adicione a dica
JOIN_DISTRIBUTION_TYPE=repartitionedpara desabilitar o broadcast e alternar para a redistribuição de dados.
Skew de dados na entrada do stage
O que significa
Os dados de entrada deste stage estão distribuídos de forma desigual entre os nós. Um ou poucos nós recebem significativamente mais dados que os demais.
Por que afeta o desempenho
A entrada com skew cria um gargalo: o nó sobrecarregado leva mais tempo para concluir, enquanto os outros ficam ociosos. O tempo total de execução do stage é determinado pelo nó mais lento.
Como resolver
Identifique a causa do skew:
Skew originado em varredura de tabela — A coluna de distribuição escolhida durante a criação da tabela gera uma distribuição desigual dos dados. Revise e altere a coluna de distribuição. Para obter orientações, consulte Diagnóstico de skew de campo de distribuição.
Skew originado em transferência de rede — O stage upstream gera dados com skew, que são então redistribuídos de forma desigual para este stage. Verifique se o stage upstream apresenta um resultado de diagnóstico de skew de dados na saída do stage e resolva o problema primeiramente naquele stage.
Skew de dados na saída do stage
O que significa
Os dados de saída deste stage estão distribuídos de forma desigual entre os nós antes de serem passados para o stage downstream.
Por que afeta o desempenho
A saída com skew causa tempos de processamento desiguais entre os nós e gera um efeito de longa duração (long-tail). Se o stage downstream executar operações complexas, o nó mais lento prolongará o tempo total de execução da consulta.
Como resolver
Inspecione as colunas exibidas nos resultados de diagnóstico para identificar padrões de skew. Uma causa comum é uma grande proporção de valores nulos em uma coluna de distribuição.