O recurso de diagnóstico SQL do AnalyticDB for MySQL visualiza o plano de execução de uma consulta SQL como um diagrama em árvore. Essa árvore possui duas camadas: stage e operador. Este tópico descreve como usar as árvores de plano de execução nessas camadas para analisar o desempenho das consultas.
Árvore de plano de execução da camada de stage
A árvore de plano de execução da camada de stage compõe-se de vários nós de stage, com dados fluindo de baixo para cima. O processo começa nos stages que contêm operadores de varredura para ler os dados. Em seguida, os dados passam por stages intermediários até o nó raiz, no topo, retornar os resultados da consulta ao cliente.
A árvore de plano de execução da camada de stage fornece as seguintes informações:
-
Informações básicas
Cada retângulo no diagrama representa um stage e contém informações como ID do stage, tipo de saída de dados e duração ou memória. O uso de memória é exibido ao ordenar o plano selecionando By Memory.
NotaUm ícone de alerta vermelho em um stage na árvore de plano de execução indica potencial de otimização.
-
Linhas de saída
O número na linha que conecta dois stages adjacentes representa a quantidade de linhas que o stage upstream envia para o stage downstream. Quanto maior o volume de linhas transferidas, mais espessa será a linha de conexão.
-
Método de saída de dados
Indica o método usado para transferir dados entre stages upstream e downstream. O AnalyticDB for MySQL oferece suporte aos seguintes métodos de saída de dados:
Método de saída
Descrição
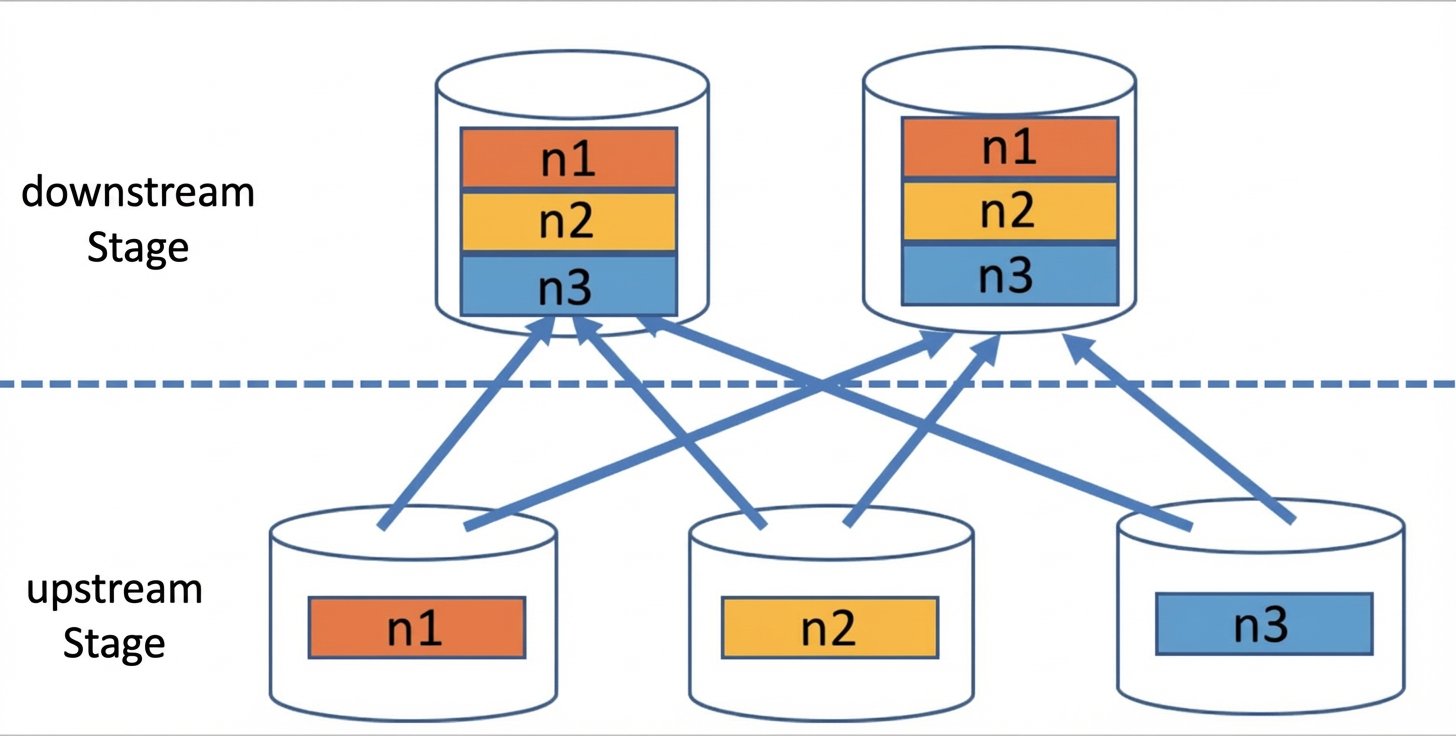
Broadcast
Copia os dados de cada nó de computação em um stage upstream para todos os nós de computação no stage downstream.
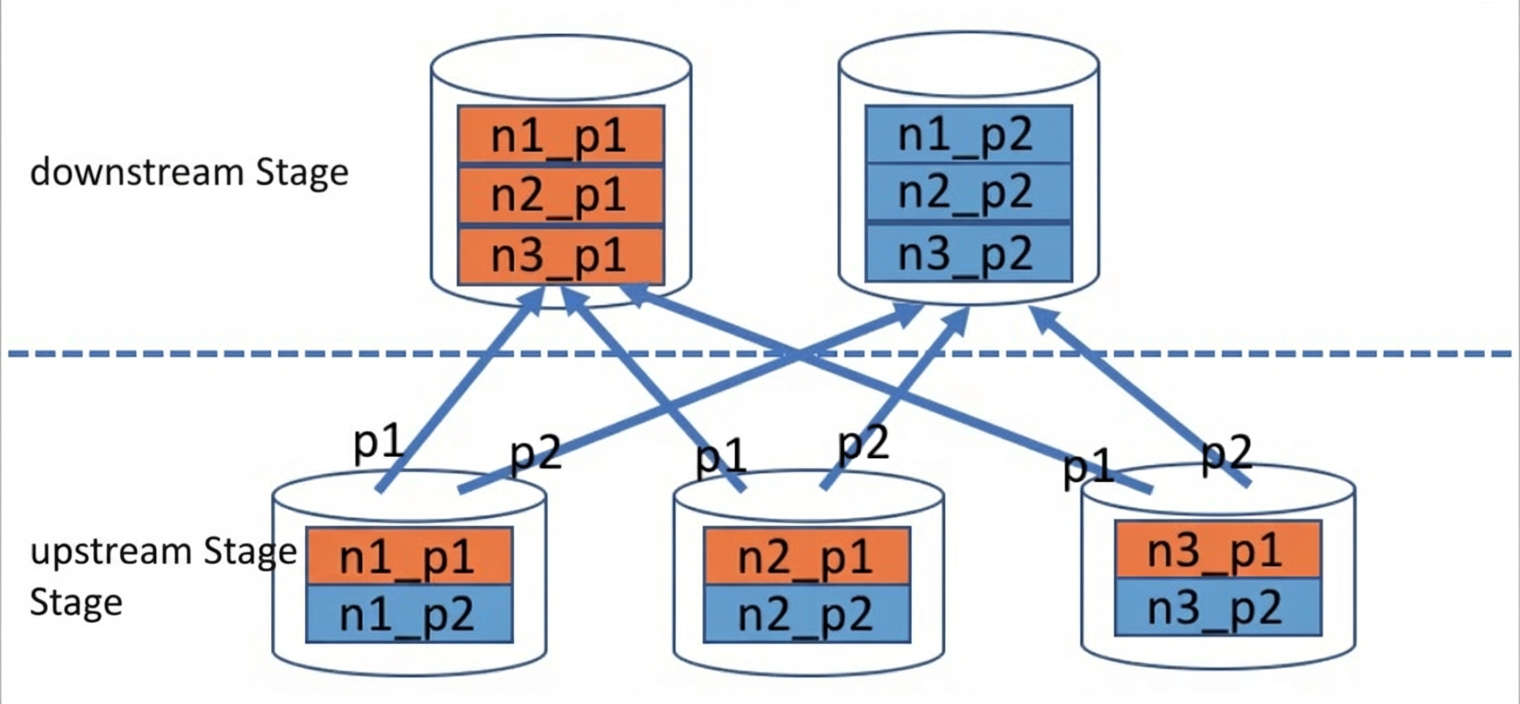
Repartition
Particiona os dados de cada nó de computação em um stage upstream com base em regras específicas e os distribui para os nós de computação especificados no stage downstream.
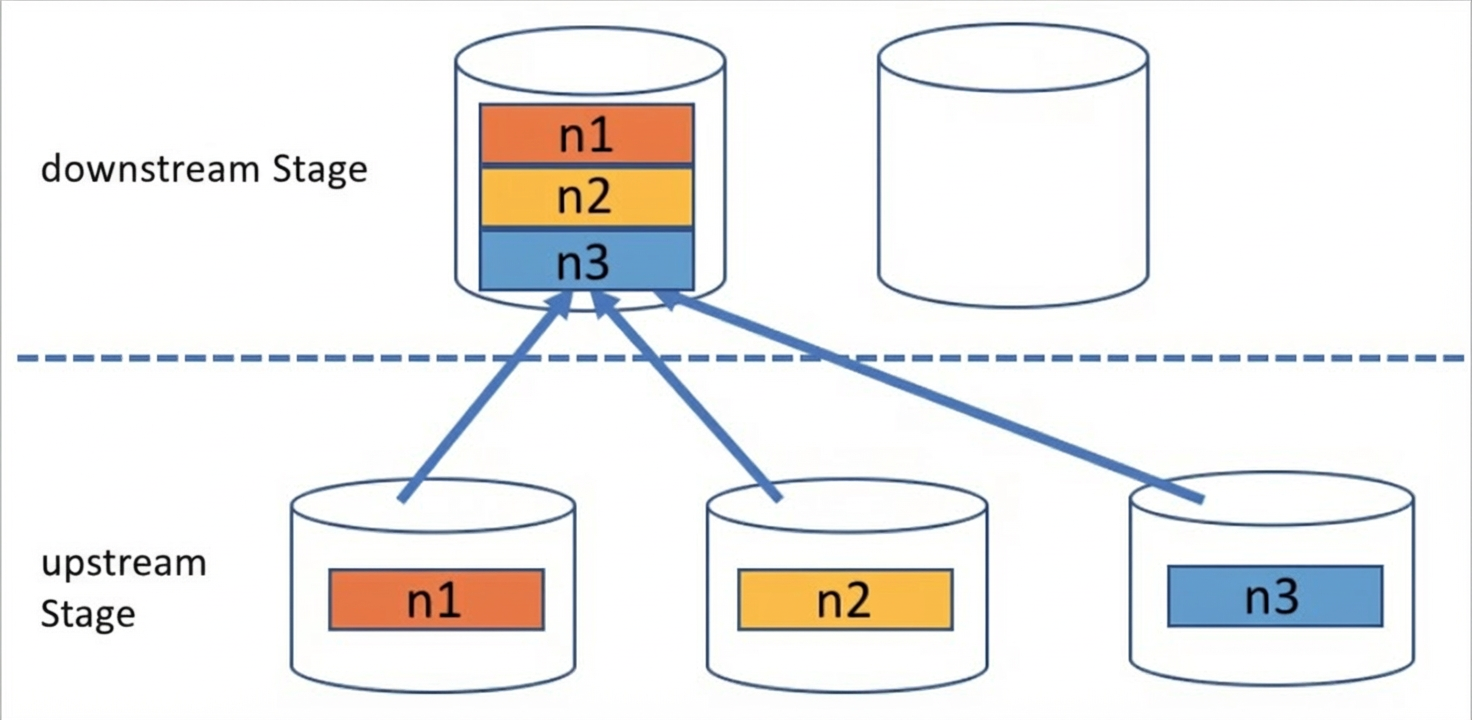
Gather
Envia dados de cada nó de computação em um stage upstream para um único nó de computação específico no stage downstream.
-
Top 10 stages por uso de memória ou duração de execução
A aba Top 10 Nodes in Descending Order by Duration or Memory, à direita da árvore de plano de execução, lista os IDs e as porcentagens correspondentes dos 10 stages que representam a maior parcela da duração total da consulta ou do uso total de memória.
NotaPor padrão, os stages são classificados By Duration. Também é possível selecionar By Memory no canto superior direito da árvore de plano de execução.
A aba Top 10 Nodes in Descending Order by Duration or Memory não exibe stages cujo uso de memória ou duração de execução represente menos de 1% do total.
Devido a diferenças nos métodos estatísticos, a soma das porcentagens de duração ou memória de todos os stages em uma consulta pode não ser exatamente 100%.
-
Diagnostic Results
Clique em um stage, como Stage[1], na árvore de plano de execução para visualizar seus detalhes no painel Diagnostic Results à direita. Estão incluídos dois tipos de diagnósticos:
Diagnóstico de stage: Fornece uma descrição detalhada dos resultados de diagnóstico para o stage alvo, incluindo problemas identificados, como broadcast de grande volume de dados ou skew de dados, além das recomendações de otimização correspondentes.
Diagnóstico de operador: Exibe apenas os nomes dos operadores problemáticos no stage atual e um breve resumo dos problemas. Para descrições detalhadas e soluções de otimização, consulte a árvore de plano de execução da camada de operador. Para obter mais informações, veja Árvore de plano de execução da camada de operador.
Para obter mais informações sobre os resultados de diagnóstico de um stage, consulte Resultados de diagnóstico no nível de stage.
-
Statistics
Abaixo do painel Diagnostic Results, a seção Statistics exibe métricas do stage selecionado.
Métrica
Descrição
Peak Memory
Memória de pico consumida pelo stage. O sistema seleciona automaticamente a unidade (Bytes, KB, MB, GB ou TB) com base no consumo real de memória.
Cumulative Duration
Soma dos tempos de execução de todos os operadores dentro do stage, agregada em todos os nós de computação e threads. O sistema seleciona automaticamente a unidade (ms, s, m ou h) com base na duração real.
NotaEssa duração cumulativa não pode ser comparada diretamente com a duração total da consulta.
Output Rows
Quantidade de linhas geradas pelo stage.
Amount of Output Data
Tamanho dos dados gerados pelo stage. O sistema seleciona automaticamente a unidade (Bytes, KB, MB, GB ou TB) conforme o tamanho real dos dados.
Input Rows
Quantidade de linhas recebidas pelo stage.
Amount of Input Data
Tamanho dos dados recebidos pelo stage. O sistema seleciona automaticamente a unidade (Bytes, KB, MB, GB ou TB) conforme o tamanho real dos dados.
Scanned Rows
Número de linhas varridas pelo stage.
NotaEsta métrica está disponível apenas se o stage contiver um operador de varredura.
Scan Size
Tamanho dos dados varridos pelo stage. O sistema seleciona automaticamente a unidade (Bytes, KB, MB, GB ou TB) conforme o tamanho real dos dados.
NotaEsta métrica está disponível apenas se o stage contiver um operador de varredura.
Árvore de plano de execução da camada de operador
O plano de execução da camada de operador consiste em múltiplos operadores. Cada retângulo no diagrama representa um operador, e os dados fluem de baixo para cima. O processo inicia com operadores na base da árvore, como TableScan e RemoteSource, que fazem a varredura dos dados ou os recebem via rede. Os dados então passam por operadores intermediários. Por fim, um operador raiz, como StageOutput ou Output, no topo, envia os dados para um stage downstream ou retorna o resultado final da consulta ao cliente.
Para visualizar a árvore de plano de execução da camada de operador, passe o mouse sobre um stage e clique em View Stage Plans na caixa pop-up para acessar a página de detalhes do plano desse stage.
A árvore de plano de execução da camada de operador fornece as seguintes informações:
Um ícone de alerta vermelho em um operador na árvore de plano de execução indica potencial de otimização.
-
Informações básicas
Cada retângulo no diagrama representa um operador e contém seu nome, ID e propriedades, como condições e algoritmo de junção para um operador
Join, além da duração ou memória. O uso de memória aparece ao ordenar o plano selecionando By Memory. -
Linhas de saída
O número na linha que conecta dois operadores adjacentes indica quantas linhas o operador upstream envia ao operador downstream. Linhas mais espessas representam um volume maior de linhas transferidas.
-
Top 10 operadores por uso de memória ou duração de execução
A aba Top 10 Nodes in Descending Order by Duration or Memory, à direita da árvore de plano de execução, mostra os IDs e as proporções correspondentes dos 10 operadores que mais contribuem para a duração total da consulta ou para o uso total de memória.
NotaPor padrão, a classificação dos operadores segue a opção By Duration. Alternativamente, selecione By Memory no canto superior direito da árvore de plano de execução.
Operadores com uso de memória ou duração de execução inferior a 1% do total não aparecem na aba Top 10 Nodes in Descending Order by Duration or Memory.
A soma das porcentagens de duração ou memória de todos os operadores em um stage pode não totalizar 100% devido a variações nos métodos estatísticos.
-
Diagnostic Results
Clique em um operador, como Join[36148], na árvore de plano de execução para visualizar seus detalhes no painel Diagnostic Results à direita. Os detalhes incluem problemas identificados, como explosão de dados ou tabela direita superdimensionada em uma junção, juntamente com recomendações de otimização. Para saber mais sobre diagnósticos de operadores, consulte Resultados de diagnóstico no nível de operador.
-
Statistics
Logo abaixo do painel Diagnostic Results, a seção Statistics apresenta as métricas do operador selecionado.
Métrica
Descrição
Peak Memory
Memória de pico consumida pelo operador. A unidade (Bytes, KB, MB, GB ou TB) é definida automaticamente pelo sistema conforme o consumo real.
Time Consumed
Duração média do operador em um determinado nível de simultaneidade. O sistema escolhe automaticamente a unidade (ms, s, m ou h) baseada na duração efetiva.
NotaEsta duração pode ser comparada diretamente com a duração total da consulta.
Output Rows
Total de linhas produzidas pelo operador.
Amount of Output Data
Volume de dados gerado pelo operador. A unidade (Bytes, KB, MB, GB ou TB) é ajustada automaticamente conforme o tamanho real.
Input Rows
Total de linhas recebidas pelo operador.
Amount of Input Data
Volume de dados recebido pelo operador. A unidade (Bytes, KB, MB, GB ou TB) é ajustada automaticamente conforme o tamanho real.
Builder Statistics
Inclui informações sobre o builder, como tipo, memória de pico, duração, linhas de entrada/saída e volume de dados. Os seguintes tipos de builder estão disponíveis:
-
HashBuilder: Utilizado para construir uma tabela hash destinada a cálculos de hash join. -
SetBuilder: Utilizado para criar uma estrutura de conjunto para cálculos de semi-join. -
NestLoopBuilder: Utilizado para executar cálculos de nested-loop join.
NotaEsta métrica aplica-se exclusivamente a operadores de junção.
Properties
As propriedades variam conforme o tipo de operador. Por exemplo, as propriedades de um operador de junção incluem o tipo e o método de junção. Para mais detalhes, consulte Operadores.
-