Use nós de trabalho ECS g8i em um cluster ACK com IPEX para inferências de texto para imagem com excelente custo-benefício. Opcionalmente, migre para um pool de nós de VM confidencial TDX para garantir a confidencialidade dos dados.
Este tópico usa o modelo stabilityai/sdxl-turbo como exemplo.
A Alibaba Cloud não garante a legitimidade, segurança ou precisão dos modelos de terceiros "Stable Diffusion" e "stabilityai/sdxl-turbo". A Alibaba Cloud não se responsabiliza por quaisquer perdas ou danos decorrentes do uso desses modelos.
Respeite os acordos de usuário, as especificações de uso e as leis e regulamentações relevantes dos modelos de terceiros. O uso desses modelos é de sua inteira responsabilidade.
O serviço de exemplo destina-se apenas a aprendizado, testes e prova de conceito (POC). As estatísticas servem apenas como referência. Os resultados reais podem variar conforme o ambiente.
Quando usar inferência via CPU
A combinação g8i + IPEX + Advanced Matrix Extensions (AMX) é uma alternativa prática à inferência via GPU quando:
O custo é prioritário: A troca de
ecs.gn7i-c8g1.2xlarge(GPU) paraecs.g8i.4xlargereduz o custo da instância em mais de 53%.Os requisitos de throughput são moderados: Com step=4 e batch=16, a instância
ecs.g8i.8xlargegera 1,2 imagens/s — acima do limiar de 1 imagem/s exigido por muitas cargas de trabalho em produção.A confidencialidade dos dados é obrigatória: Migre para um pool de nós de VM confidencial TDX sem alterar o código.
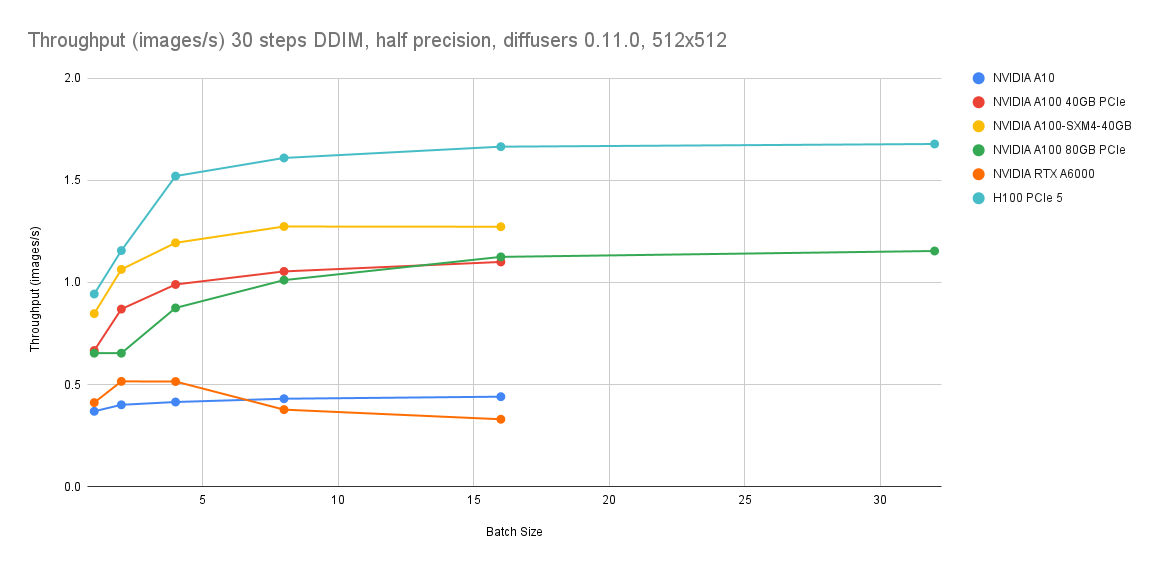
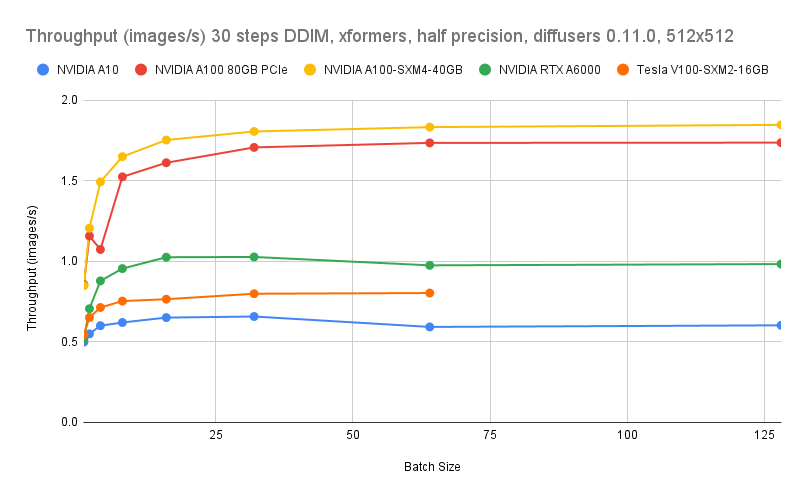
Se o seu SLO de latência exigir throughput equivalente ao de GPU (0,4 imagens/s com step=30 e batch=16), mantenha as instâncias GPU. Caso 1,2 imagens/s com step=4 seja aceitável, a instância g8i oferece melhor custo-benefício.
Contexto
A família de instâncias g8i
A família de instâncias ECS de uso geral g8i é alimentada por Unidades de Processamento de Infraestrutura em Nuvem (CIPUs) e Apsara Stack. Ela utiliza processadores Intel® Xeon® Scalable de 5ª geração (codinome Emerald Rapids) com AMX para aceleração de IA. Todas as instâncias g8i suportam Intel® TDX, permitindo cargas de trabalho em Ambiente de Execução Confiável (TEE) com sobrecarga mínima de desempenho e sem necessidade de alterações no código.
Consulte g8i, família de instâncias de uso geral.
Intel® TDX
O Intel® TDX é uma tecnologia TEE baseada em hardware que isola e criptografa instâncias ECS, protegendo registradores de CPU, memória e injeções de interrupção durante a execução. Essa tecnologia ajuda a prevenir acessos não autorizados a processos e dados sensíveis sem exigir mudanças no código.
IPEX
O Intel® Extension for PyTorch (IPEX) é uma extensão open source para PyTorch que acelera tarefas de IA em processadores Intel, sendo continuamente otimizado para os hardwares e softwares mais recentes da Intel.
Consulte IPEX.
Pré-requisitos
Antes de começar, certifique-se de ter:
Um cluster ACK Pro na região China (Beijing). Consulte Criar um cluster gerenciado ACK.
-
Um pool de nós com instâncias ECS g8i que atenda aos seguintes requisitos:
Tipo de instância: No mínimo 16 vCPUs. Recomendado:
ecs.g8i.4xlarge,ecs.g8i.8xlargeouecs.g8i.12xlarge.Espaço em disco: Pelo menos 200 GiB por nó (disco do sistema ou disco de dados).
Região e zona: Uma região e zona onde as instâncias g8i estejam disponíveis. Verifique os Tipos de instância disponíveis por região.
O kubectl conectado ao cluster ACK. Consulte Conectar-se a um cluster ACK usando kubectl.
Etapa 1: Preparar o modelo
A implantação utiliza o modelo stabilityai/sdxl-turbo. Escolha uma opção com base no local onde seu modelo está armazenado.
Opção 1: Usar o modelo oficial (recomendado)
A imagem do chart Helm (v0.1.5) inclui o modelo oficial stabilityai/sdxl-turbo. Crie o arquivo values.yaml com o conteúdo abaixo. Ajuste a CPU e a memória conforme o tipo da sua instância.
resources:
  limits:
    cpu: "16"
    memory: 32Gi
  requests:
    cpu: "14"
    memory: 24Gi
Opção 2: Usar um modelo personalizado do OSS
Se você armazena um modelo personalizado stabilityai/sdxl-turbo no Object Storage Service (OSS), monte-o usando um PersistentVolume (PV) e um PersistentVolumeClaim (PVC).
Crie um usuário do Resource Access Management (RAM) com permissões de leitura no OSS e obtenha seu par de AccessKey.
-
Crie o arquivo
models-oss-secret.yamlcom o seguinte conteúdo.apiVersion: v1 kind: Secret metadata: name: models-oss-secret namespace: default stringData: akId: <your-access-key-id> # AccessKey ID of the RAM user akSecret: <your-access-key-secret> # AccessKey secret of the RAM user -
Aplique o Secret.
kubectl create -f models-oss-secret.yamlSaída esperada:
secret/models-oss-secret created -
Crie o arquivo
models-oss-pv.yamlcom o conteúdo a seguir. Substitua os placeholders pelos detalhes do seu bucket OSS.apiVersion: v1 kind: PersistentVolume metadata: name: models-oss-pv labels: alicloud-pvname: models-oss-pv spec: capacity: storage: 50Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: models-oss-pv nodePublishSecretRef: name: models-oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" # OSS bucket to mount url: "<your-oss-endpoint>" # Use an internal endpoint, e.g., oss-cn-beijing-internal.aliyuncs.com otherOpts: "-o umask=022 -o max_stat_cache_size=0 -o allow_other" path: "/models" # Must contain the stabilityai/sdxl-turbo subdirectoryConsulte Método 1: Usar um Secret para ver os parâmetros do OSS.
-
Crie o PV.
kubectl create -f models-oss-pv.yamlSaída esperada:
persistentvolume/models-oss-pv created -
Crie o arquivo
models-oss-pvc.yamlcom o conteúdo abaixo.apiVersion: v1 kind: PersistentVolumeClaim metadata: name: models-oss-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 50Gi selector: matchLabels: alicloud-pvname: models-oss-pv -
Aplique o PVC.
kubectl create -f models-oss-pvc.yamlSaída esperada:
persistentvolumeclaim/models-oss-pvc created -
Crie o arquivo
values.yamlcom o volume do modelo personalizado habilitado. Ajuste os recursos conforme o tipo da sua instância.resources: limits: cpu: "16" memory: 32Gi requests: cpu: "14" memory: 24Gi # Set to true to mount the custom model from OSS instead of the bundled image model. useCustomModels: true volumes: models: name: data-volume persistentVolumeClaim: claimName: models-oss-pvc
Referência completa do values.yaml
O chart Helm suporta opções adicionais além dos recursos e da origem do modelo. Valores padrão:
# Number of pod replicas.
replicaCount: 1

# Container image configuration.
image:
  repository: registry-vpc.cn-beijing.aliyuncs.com/eric-dev/stable-diffusion-ipex
  pullPolicy: IfNotPresent
  tag: "v0.1.5"              # Bundles the official stabilityai/sdxl-turbo model
  tagOnlyApi: "v0.1.5-lite"  # API-only image; requires mounting the model manually (see useCustomModels)

# Credentials for pulling a private container image.
imagePullSecrets: []

# Output path for generated images inside the container.
outputDirPath: /tmp/sd

# Set to true to use a custom model mounted via the volumes.models PVC.
# When false, the image.tag image (which includes the model) is used.
useCustomModels: false

volumes:
  # Volume for the image output path.
  output:
    name: output-volume
    emptyDir: {}
  # Volume for the custom model. Only active when useCustomModels: true.
  # Place the model in the stabilityai/sdxl-turbo subdirectory of the mount path.
  models:
    name: data-volume
    persistentVolumeClaim:
      claimName: models-oss-pvc
  # Alternatively, use a host path:
  # models:
  #   hostPath:
  #     path: /data/models
  #     type: DirectoryOrCreate

# Service configuration.
service:
  type: ClusterIP
  port: 5000

# Container resource limits and requests.
resources:
  limits:
    cpu: "16"
    memory: 32Gi
  requests:
    cpu: "14"
    memory: 24Gi

# Workload update strategy.
strategy:
  type: RollingUpdate

# Scheduling configuration.
nodeSelector: {}
tolerations: []
affinity: {}

# Container security settings.
securityContext:
  capabilities:
    drop:
    - ALL
  runAsNonRoot: true
  runAsUser: 1000

# Horizontal Pod Autoscaler (HPA) configuration.
# https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/
autoscaling:
  enabled: false
  minReplicas: 1
  maxReplicas: 3
  targetCPUUtilizationPercentage: 80
  targetMemoryUtilizationPercentage: 90
Etapa 2: Implantar o serviço
-
Implante o serviço Stable Diffusion XL Turbo acelerado por IPEX usando o Helm.
helm install stable-diffusion-ipex \
  https://aliacs-app-catalog.oss-cn-hangzhou.aliyuncs.com/pre/charts-incubator/stable-diffusion-ipex-0.1.7.tgz \
  -f values.yaml
Saída esperada:
NAME: stable-diffusion-ipex LAST DEPLOYED: Mon Jan 22 20:42:35 2024 NAMESPACE: default STATUS: deployed REVISION: 1 TEST SUITE: None -
Aguarde cerca de 10 minutos para o carregamento do modelo e verifique se o pod está em execução.
kubectl get pod | grep stable-diffusion-ipexSaída esperada:
stable-diffusion-ipex-65d98cc78-vmj49 1/1 Running 0 1m44s
Após iniciar, o serviço expõe uma API de texto para imagem na porta 5000. Consulte a Referência da API para ver os parâmetros.
Etapa 3: Testar o serviço
-
Encaminhe a porta do serviço para sua máquina local.
kubectl port-forward svc/stable-diffusion-ipex 5000:5000Saída esperada:
Forwarding from 127.0.0.1:5000 -> 5000 Forwarding from [::1]:5000 -> 5000 -
Envie uma solicitação de geração. Tamanhos suportados:
512x512e1024x1024. Imagem 512x512curl -X POST http://127.0.0.1:5000/api/text2image \ -d '{"prompt": "A panda listening to music with headphones. highly detailed, 8k.", "number": 1}'Saída esperada:
{
  "averageImageGenerationTimeSeconds": 2.0333826541900635,
  "generationTimeSeconds": 2.0333826541900635,
  "id": "9ae43577-170b-45c9-ab80-69c783b41a70",
  "meta": {
    "input": {
      "batch": 1,
      "model": "stabilityai/sdxl-turbo",
      "number": 1,
      "prompt": "A panda listening to music with headphones. highly detailed, 8k.",
      "size": "512x512",
      "step": 4
    }
  },
  "output": [
    {
      "latencySeconds": 2.0333826541900635,
      "url": "http://127.0.0.1:5000/images/9ae43577-170b-45c9-ab80-69c783b41a70/0_0.png"
    }
  ],
  "status": "success"
}
Imagem 1024x1024
curl -X POST http://127.0.0.1:5000/api/text2image \
  -d '{"prompt": "A panda listening to music with headphones. highly detailed, 8k.", "number": 1, "size": "1024x1024"}'
Saída esperada:
{
  "averageImageGenerationTimeSeconds": 8.635204315185547,
  "generationTimeSeconds": 8.635204315185547,
  "id": "ac341ced-430d-4952-b9f9-efa57b4eeb60",
  "meta": {
    "input": {
      "batch": 1,
      "model": "stabilityai/sdxl-turbo",
      "number": 1,
      "prompt": "A panda listening to music with headphones. highly detailed, 8k.",
      "size": "1024x1024",
      "step": 4
    }
  },
  "output": [
    {
      "latencySeconds": 8.635204315185547,
      "url": "http://127.0.0.1:5000/images/ac341ced-430d-4952-b9f9-efa57b4eeb60/0_0.png"
    }
  ],
  "status": "success"
}
Abra a
urlem um navegador para visualizar a imagem gerada.
Benchmarks de desempenho
Tempos médios de geração em tipos de instância g8i (batch: 1, step: 4). Os resultados servem apenas como referência.
|
Tipo de instância |
Solicitação/Limite do Pod (vCPU) |
Duração média — 512x512 |
Duração média — 1024x1024 |
|
ecs.g8i.4xlarge (16 vCPUs, 64 GiB) |
14/16 |
2,2s |
8,8s |
|
ecs.g8i.8xlarge (32 vCPUs, 128 GiB) |
24/32 |
1,3s |
4,7s |
|
ecs.g8i.12xlarge (48 vCPUs, 192 GiB) |
32/32 |
1,1s |
3,9s |
Recomendação: A instância ecs.g8i.8xlarge oferece o melhor equilíbrio entre custo e throughput. Com step=4 e batch=16, ela gera 1,2 imagens/s sem comprometer a qualidade da imagem.
(Opcional) Etapa 4: Migrar para um pool de nós de VM confidencial TDX
Migre o serviço implantado para um pool de nós de VM confidencial TDX para obter isolamento e criptografia de memória baseados em hardware. Nenhuma alteração de código é necessária.
Pré-requisitos
Deve existir um pool de nós de VM confidencial TDX no cluster ACK com a seguinte configuração:
Tipo de instância: No mínimo 16 vCPUs. Recomendado:
ecs.g8i.4xlarge.Espaço em disco: Pelo menos 200 GiB por nó.
Rótulo do nó:
nodepool-label=tdx-vm-pool.
Consulte Criar um pool de nós compatível com VMs confidenciais TDX.
Migrar o serviço
-
Crie o arquivo
tdx_values.yamlcom o seletor de nós a seguir. Substituatdx-vm-poolcaso tenha usado um valor de rótulo diferente.nodeSelector: nodepool-label: tdx-vm-pool -
Atualize a release do Helm para reprogramar o pod no pool de nós TDX.
helm upgrade stable-diffusion-ipex \
  https://aliacs-app-catalog.oss-cn-hangzhou.aliyuncs.com/pre/charts-incubator/stable-diffusion-ipex-0.1.7.tgz \
  -f tdx_values.yaml
Saída esperada:
Release "stable-diffusion-ipex" has been upgraded. Happy Helming! NAME: stable-diffusion-ipex LAST DEPLOYED: Wed Jan 24 16:38:04 2024 NAMESPACE: default STATUS: deployed REVISION: 2 TEST SUITE: None -
Aguarde cerca de 10 minutos e verifique se o pod está em execução no pool de nós TDX.
kubectl get pod | grep stable-diffusion-ipexSaída esperada:
stable-diffusion-ipex-7f8c4f88f5-r478t 1/1 Running 0 1m44s Repita a Etapa 3: Testar o serviço para confirmar que o modelo funciona no pool de nós TDX.
Referência da API
Após a implantação, o serviço expõe uma API REST na porta 5000.
Sintaxe da solicitação
POST /api/text2imageRequest parameters
Sample request
Response parameters
Sample response
Comparação de desempenho
O pool de nós g8i usa AMX e IPEX para acelerar a inferência via CPU. Os benchmarks utilizam ecs.g8i.8xlarge (32 vCPUs, 128 GiB) com as ferramentas de benchmark lambda-diffusers. Os resultados servem apenas como referência.
Benchmarks de aceleração via CPU
|
Tipo de instância |
Modelo |
Step |
Comando |
|
ecs.g8i.8xlarge (32 vCPUs, 128 GiB) |
sdxl-turbo |
4 |
|
|
ecs.g8i.8xlarge (32 vCPUs, 128 GiB) |
stable-diffusion-2-1-base |
30 |
|
Resultados de desempenho (imagens/s):
|
Configuração |
Throughput |
|
ecs.g8i.8xlarge, step=4, batch=16 (sdxl-turbo) |
1,2 imagens/s |
|
ecs.g8i.8xlarge, step=30, batch=16 (sd-2-1-base) |
0,14 imagens/s |
Benchmarks de aceleração via GPU
Os benchmarks de GPU foram obtidos em Lambda Diffusers Benchmarking inference. Os resultados reais podem variar.
Comparação de custos
Estas estimativas comparam instâncias CPU g8i com a instância ecs.gn7i-c8g1.2xlarge (GPU). Para preços atuais, consulte a aba Pricing na página do Elastic Compute Service.
|
Tipo de instância |
Custo vs. ecs.gn7i-c8g1.2xlarge |
Throughput com step=4, batch=16 |
|
ecs.g8i.8xlarge |
9% menor |
1,2 imagens/s |
|
ecs.g8i.4xlarge |
>53% menor |
0,5 imagens/s |
Use a ecs.g8i.8xlarge quando precisar de economia de custos combinada com throughput superior a 1 imagem/s. Opte pela ecs.g8i.4xlarge quando a redução de custos, a confidencialidade de dados via TEE ou o fornecimento de recursos de CPU em larga escala forem prioritários e 0,5 imagens/s atender aos seus requisitos.