O ACK utiliza o Scheduling Framework para selecionar as combinações ideais de GPU no nó para treinamento distribuído do TensorFlow. Essa abordagem reduz a sobrecarga de sincronização entre nós e melhora o throughput.
Pré-requisitos
Verifique se você possui:
Um cluster ACK Pro com tipo de instância Elastic GPU Service. Consulte Criar um cluster gerenciado pelo ACK
O Arena instalado
O add-on de agendamento de GPU com reconhecimento de topologia instalado
Versões necessárias dos componentes:
|
Componente |
Versão necessária |
Comando de verificação |
|
Kubernetes |
1.18.8 ou posterior |
|
|
Driver NVIDIA |
418.87.01 ou posterior |
|
|
NCCL (NVIDIA Collective Communications Library) |
2,7 ou posterior |
|
|
Sistema operacional |
CentOS 7.6, CentOS 7.7, Ubuntu 16.04, Ubuntu 18.04, Alibaba Cloud Linux 2, Alibaba Cloud Linux 3 |
|
|
GPU |
V100 |
|
Conclua os pré-requisitos na ordem correta: crie o cluster ACK Pro, instale o Arena e, em seguida, instale o add-on de agendamento de GPU com reconhecimento de topologia. A instalação fora de ordem pode falhar.
Limitações
O agendamento de GPU com reconhecimento de topologia aplica-se apenas a jobs de Message Passing Interface (MPI) que utilizam um framework distribuído.
O agendamento padrão de GPU aloca os recursos apenas por disponibilidade, sem considerar a topologia de interconexão. Os workers podem ser alocados em GPUs de diferentes nós conectados por redes mais lentas, tornando a comunicação entre GPUs o gargalo do sistema. O agendamento com reconhecimento de topologia agrupa os workers em GPUs do mesmo nó via NVLink, o que reduz a latência de sincronização de gradientes.
Os pods são criados somente quando todos os recursos solicitados estão disponíveis (gang scheduling). Se os recursos forem insuficientes, o job permanece pendente até que haja GPUs livres o bastante.
Configure os nós
Adicione rótulos aos nós para ativar o agendamento de GPU com reconhecimento de topologia:
kubectl label node <your-node-name> ack.node.gpu.schedule=topologyAo ativar o agendamento com reconhecimento de topologia em um nó, o agendamento padrão de GPU é desativado para esse nó. Para restaurar o agendamento padrão, execute:
kubectl label node <your-node-name> ack.node.gpu.schedule=default --overwriteEnvie um job
Envie um job MPI com --gputopology=true e --gang:
arena submit mpi --gputopology=true --gang <other-parameters>Ambos os parâmetros são obrigatórios: --gputopology=true ativa a seleção de GPU com base na topologia; --gang impõe o gang scheduling para garantir que todos os workers iniciem juntos.
Exemplo 1: Treinar VGG16
Este exemplo utiliza um cluster com dois nós, cada um com oito GPUs V100.
Agendamento de GPU com reconhecimento de topologia
-
Envie o job de treinamento:
arena submit mpi \ --name=tensorflow-topo-4-vgg16 \ --gpus=1 \ --workers=4 \ --gang \ --gputopology=true \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=vgg16 --batch_size=64 --variable_update=horovod" -
Verifique o status do job:
arena get tensorflow-topo-4-vgg16 --type mpijobSaída esperada:
Name:      tensorflow-topo-4-vgg16
Status:    RUNNING
Namespace: default
Priority:  N/A
Trainer:   MPIJOB
Duration:  2m

Instances:
  NAME                                    STATUS   AGE  IS_CHIEF  GPU(Requested)  NODE
  ----                                    ------   ---  --------  --------------  ----
  tensorflow-topo-4-vgg16-launcher-lmhjl  Running  2m   true      0               cn-shanghai.192.168.16.172
  tensorflow-topo-4-vgg16-worker-0        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-1        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-2        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-3        Running  2m   false     1               cn-shanghai.192.168.16.173
Todos os quatro workers executam em um único nó, compartilhando a largura de banda do NVLink.
-
Visualize o log de treinamento:
arena logs -f tensorflow-topo-4-vgg16Saída esperada:
total images/sec: 991.92
Agendamento padrão de GPU
-
Envie o job sem os parâmetros de topologia:
arena submit mpi \ --name=tensorflow-4-vgg16 \ --gpus=1 \ --workers=4 \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=vgg16 --batch_size=64 --variable_update=horovod" -
Verifique o status do job:
arena get tensorflow-4-vgg16 --type mpijobSaída esperada:
Name:      tensorflow-4-vgg16
Status:    RUNNING
Namespace: default
Priority:  N/A
Trainer:   MPIJOB
Duration:  9s

Instances:
  NAME                               STATUS   AGE  IS_CHIEF  GPU(Requested)  NODE
  ----                               ------   ---  --------  --------------  ----
  tensorflow-4-vgg16-launcher-xc28k  Running  9s   true      0               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-0        Running  9s   false     1               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-1        Running  9s   false     1               cn-shanghai.192.168.16.173
  tensorflow-4-vgg16-worker-2        Running  9s   false     1               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-3        Running  9s   false     1               cn-shanghai.192.168.16.173
Os workers estão distribuídos em dois nós, portanto cada etapa de sincronização de gradiente exige comunicação entre nós.
-
Visualize o log de treinamento:
arena logs -f tensorflow-4-vgg16Saída esperada:
total images/sec: 200.47
Exemplo 2: Treinar ResNet50
Agendamento de GPU com reconhecimento de topologia
-
Envie o job de treinamento:
arena submit mpi \ --name=tensorflow-topo-4-resnet50 \ --gpus=1 \ --workers=4 \ --gang \ --gputopology=true \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=resnet50 --batch_size=64 --variable_update=horovod" -
Verifique o status do job:
arena get tensorflow-topo-4-resnet50 --type mpijobSaída esperada:
Name: tensorflow-topo-4-resnet50 Status: RUNNING Namespace: default Priority: N/A Trainer: MPIJOB Duration: 8s Instances: NAME STATUS AGE IS_CHIEF GPU(Requested) NODE ---- ------ --- -------- -------------- ---- tensorflow-topo-4-resnet50-launcher-7ln8j Running 8s true 0 cn-shanghai.192.168.16.172 tensorflow-topo-4-resnet50-worker-0 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-1 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-2 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-3 Running 8s false 1 cn-shanghai.192.168.16.173 -
Visualize o log de treinamento:
arena logs -f tensorflow-topo-4-resnet50Saída esperada:
total images/sec: 1471.55
Agendamento padrão de GPU
-
Envie o job sem os parâmetros de topologia:
arena submit mpi \ --name=tensorflow-4-resnet50 \ --gpus=1 \ --workers=4 \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=resnet50 --batch_size=64 --variable_update=horovod" -
Verifique o status do job:
arena get tensorflow-4-resnet50 --type mpijobSaída esperada:
Name: tensorflow-4-resnet50 Status: RUNNING Namespace: default Priority: N/A Trainer: MPIJOB Duration: 9s Instances: NAME STATUS AGE IS_CHIEF GPU(Requested) NODE ---- ------ --- -------- -------------- ---- tensorflow-4-resnet50-launcher-q24hv Running 9s true 0 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-0 Running 9s false 1 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-1 Running 9s false 1 cn-shanghai.192.168.16.173 tensorflow-4-resnet50-worker-2 Running 9s false 1 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-3 Running 9s false 1 cn-shanghai.192.168.16.173 -
Visualize o log de treinamento:
arena logs -f tensorflow-4-resnet50Saída esperada:
total images/sec: 745.38
Comparação de desempenho
Throughput para treinamento de VGG16 e ResNet50 com agendamento de GPU com reconhecimento de topologia e agendamento padrão:
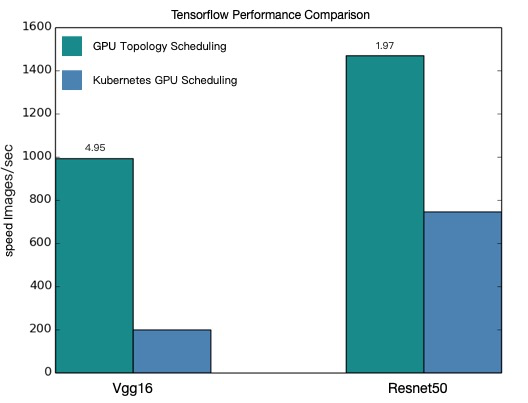
|
Modelo |
Com reconhecimento de topologia (imagens/s) |
Padrão (imagens/s) |
Melhoria |
|
VGG16 |
991,92 |
200,47 |
~4,9x |
|
ResNet50 |
1.471,55 |
745,38 |
~2,0x |
Os valores de desempenho são teóricos. Os resultados reais variam conforme o modelo, a configuração do cluster e as condições da rede. Execute os exemplos em seu cluster para medir os ganhos obtidos.