Para resolver a visibilidade limitada na camada do mecanismo de contêiner, o SysOM oferece monitoramento no nível do kernel do SO. Isso melhora a observabilidade de problemas de memória e facilita a migração de contêineres. Este tópico explica como usar o SysOM para diagnosticar problemas de memória em contêineres, incluindo detalhamentos do working set além das métricas padrão.
Pré-requisitos
Verifique se você tem:
Um ACK Managed Cluster ou ACK Serverless Cluster criado após outubro de 2021, executando Kubernetes 1.18.8 ou posterior. Se necessário, faça o upgrade manual.
O Prometheus Service for Alibaba Cloud ativado.
O recurso ack-sysom-monitor habilitado.
Faturamento
Quando ativado, o ack-sysom-monitor envia métricas de monitoramento para o Prometheus Service for Alibaba Cloud. Essas métricas são cobradas como Custom Metrics e geram custos adicionais.
Consulte a visão geral de faturamento do Prometheus Service for Alibaba Cloud antes de ativar este recurso. Os custos variam conforme o tamanho do cluster e a quantidade de aplicações. Use o Resource Consumption para monitorar o uso.
Conceitos principais
Componentes de memória do contêiner
O ACK fornece monitoramento de contêineres no nível do kernel do SO para rastrear com precisão o uso de memória e evitar problemas de OOM.
A memória do contêiner divide-se em três categorias:
|
Categoria |
Subcategoria |
Descrição |
|
Memória da aplicação |
Memória anônima: heap, stack e segmentos de dados de um processo, alocados via chamadas de sistema |
Memória usada pela aplicação em execução |
|
Cache de arquivos: dados armazenados em cache para E/S de arquivos. O cache acessado frequentemente ( |
||
|
Buffers: metadados para dispositivos de bloco ou sistemas de arquivos |
||
|
HugeTLB: memória alocada via HugePages |
||
|
Memória do kernel |
Slab: pool de memória para caches de objetos do kernel |
Memória consumida pelo kernel do SO |
|
Vmalloc: aloca grandes blocos de memória virtual |
||
|
allocpage: aloca memória local |
||
|
Outros: stack do kernel, tabela de páginas e memória reservada |
||
|
Memória livre |
— |
Memória disponível e não usada |
Working set vs. RSS
O Kubernetes rastreia duas métricas de memória essenciais:
Working set: memória que o contêiner usa ativamente (
working set = inactive_anon + active_anon + active_file). O OOM killer e o Kubernetes usam essa métrica para decidir se devem remover ou encerrar um contêiner.RSS (resident set size): memória física mapeada no espaço de endereçamento do contêiner, excluindo o cache de arquivos. O RSS reflete a memória real da aplicação, mas exclui a memória em cache que o Kubernetes considera para o limite.
Como o Kubernetes usa o working set para decisões de remoção, o cache de arquivos pode inflá-lo silenciosamente e acionar encerramentos por OOM mesmo quando a memória da aplicação está estável. O SysOM detalha o working set em componentes para identificar qual tipo de memória causa o problema.
Como funciona
O SysOM expõe métricas no nível do kernel do SO nos painéis do Prometheus Monitoring no console do ACK. Ele organiza a memória do pod em componentes do working set para rastrear o alto uso até tipos específicos de memória.
Use estas fórmulas ao diagnosticar problemas de memória:
Total pod memory = RSS + Cache ≈ inactive_anon + active_anon + inactive_file + active_fileworking set = inactive_anon + active_anon + active_file
Localizar e corrigir problemas de memória de contêiner
Etapa 1: Abrir o painel do SysOM
Faça logon no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do cluster. No painel de navegação à esquerda, clique em Operations > Prometheus Monitoring.
Na página Prometheus Monitoring, clique na aba SysOM e, em seguida, clique em SysOM - Pods.
Etapa 2: Identificar o buraco negro de memória
-
Na seção Pod Memory Monitor, aplique a fórmula de memória total do pod para dividir a memória em cache e RSS. Analise as proporções de cache (
active_file,inactive_file,shmem) e RSS (active_anon,inactive_anon). Neste exemplo, oinactive_anonpredomina.
-
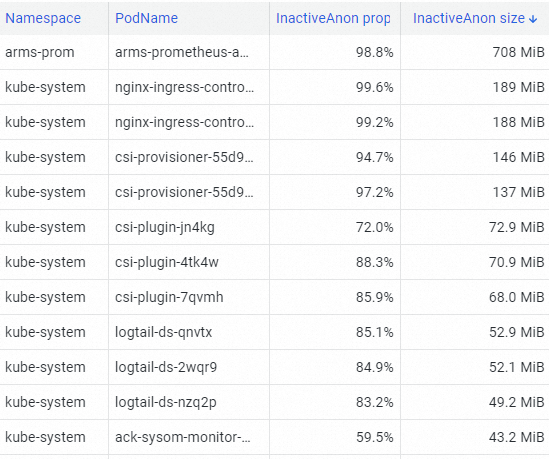
Na seção Pod Resource Analysis, use o top para identificar o pod com maior consumo de InactiveAnon. Neste exemplo, o arms-prom apresenta o maior consumo.
-
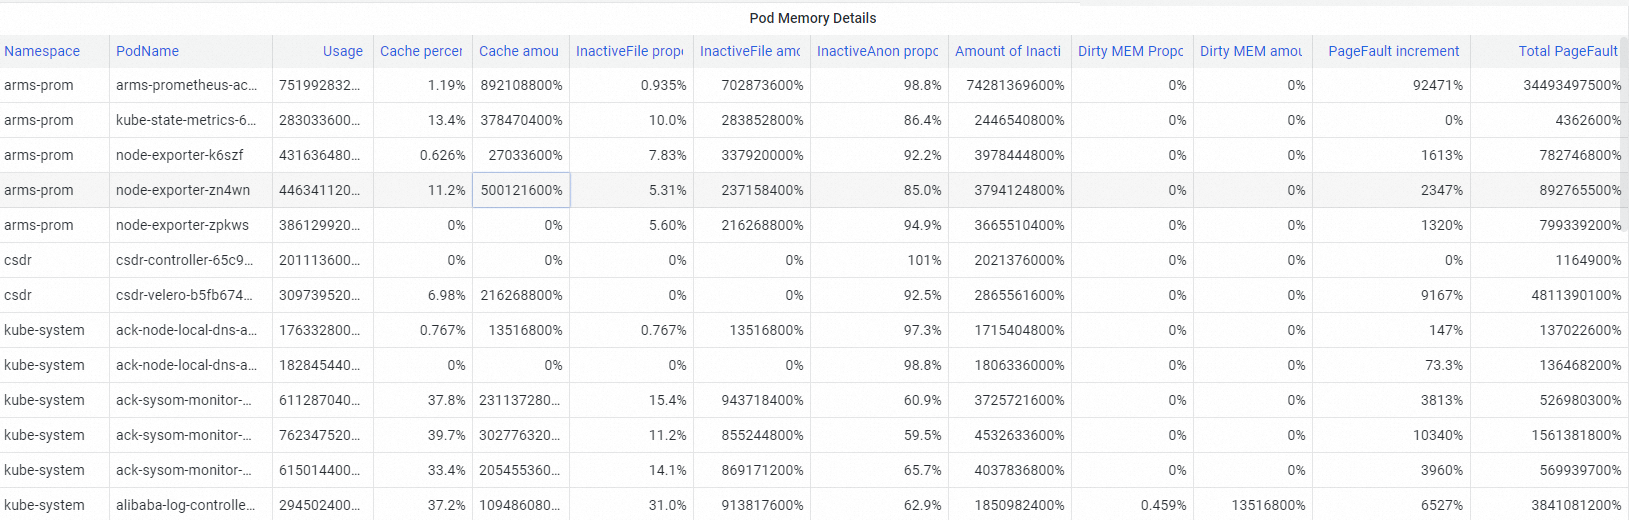
Na seção Pod Memory Details, visualize a composição de memória do pod identificado. Os componentes incluem Pod Cache, InactiveFile (cache de arquivos inativos), InactiveAnon (memória anônima inativa) e dirty memory (modificações não gravadas). Use esses detalhamentos para localizar exatamente o buraco negro de memória.
Etapa 3: Investigar o uso de cache de arquivos
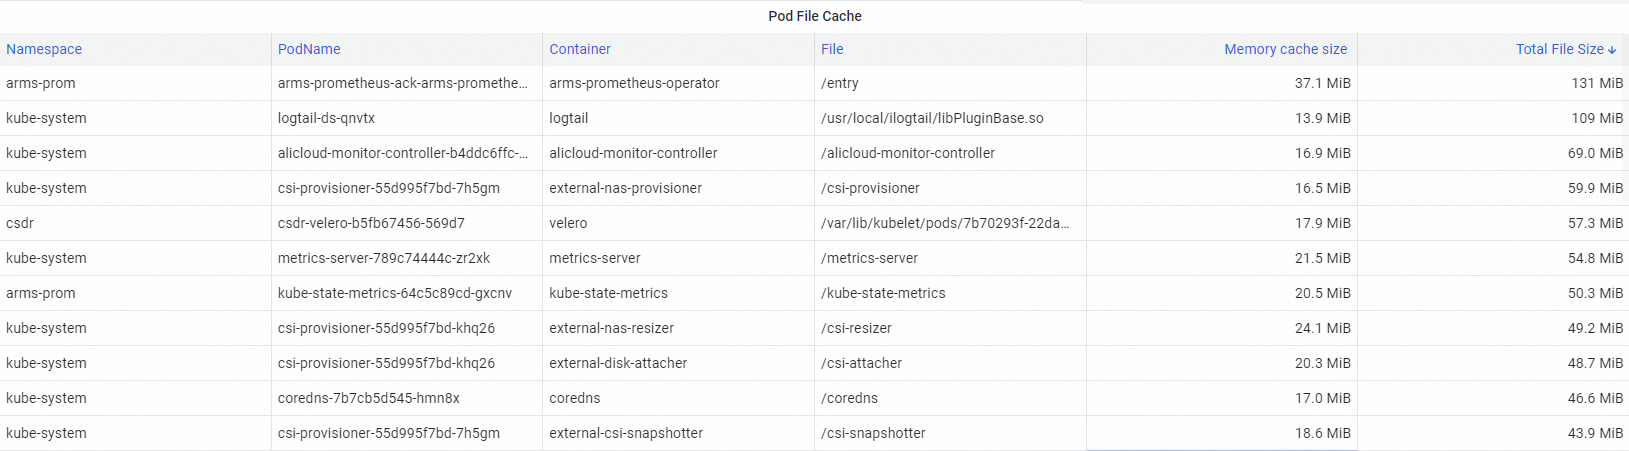
Na seção Pod File Cache, identifique a causa do alto consumo de memória de cache.
O cache de arquivos não recuperável infla o working set e torna-se um buraco negro de memória. Esse volume conta para o limite de memória do pod e pode acionar remoções ou encerramentos por OOM sem aumento na memória da aplicação.
Etapa 4: Corrigir o buraco negro de memória
Após identificar o buraco negro de memória, resolva-o com o agendamento refinado do ACK. Consulte Ativar QoS de memória de contêiner.
Próximas etapas
Para visualizar todas as métricas do SysOM, consulte Monitoramento de contêineres no nível do kernel com SysOM.
Para conhecer os recursos do kernel subjacentes ao QoS de memória do ACK, consulte Visão geral dos recursos e interfaces do kernel.