O SysOM (System Observer Monitoring) oferece observabilidade do Container Monitoring na camada do kernel do sistema operacional e oferece suporte à implantação, migração e monitoramento em contêineres. Este tópico descreve como ativar e usar o recurso ack-sysom-monitor e explica as métricas de monitoramento relacionadas.
Pré-requisitos
Você criou um cluster ACK gerenciado ou um cluster ACK serverless criado após outubro de 2021 e garantiu que a versão do cluster seja 1.18.8 ou posterior. Se precisar atualizar um cluster, consulte Atualizar um cluster manualmente.
Você ativou o Managed Service for Prometheus.
Visão geral do add-on ack-sysom-monitor
O ack-sysom-monitor é o add-on de monitoramento do SysOM. Com base na tecnologia eBPF, ele coleta métricas na camada do kernel nas dimensões de nó e contêiner. Além das métricas básicas do sistema, fornece métricas aprimoradas e aprofundadas que detectam problemas típicos, como oscilações do sistema, latência, vazamentos de recursos e anomalias de memória em Pods.
Faturamento do recurso de monitoramento ack-sysom-monitor
Ao ativar o recurso de monitoramento ack-sysom-monitor, os componentes relacionados enviam automaticamente as métricas de monitoramento para o Managed Service for Prometheus. Essas métricas são tratadas como métricas personalizadas. O uso de métricas personalizadas gera cobranças adicionais.
Para evitar cobranças extras, leia atentamente a Visão geral do faturamento do Managed Service for Prometheus antes de ativar este recurso, a fim de compreender a política de faturamento das métricas personalizadas. Os valores variam de acordo com fatores como o tamanho do seu cluster e o número de aplicações. Use o recurso de estatísticas de consumo de recursos para monitorar e gerencie o uso dos seus recursos.
Ative o recurso de monitoramento ack-sysom-monitor
Acesse o console do ARMS.
No painel de navegação à esquerda, clique em Integration Center.
Na página Integration Center, na seção Infrastructure, clique em SysOM.
No painel SysOM, na aba Start Access, selecione o cluster de contêineres a ser conectado e, em seguida, clique em OK.
Usar o recurso de monitoramento ack-sysom-monitor
Procedimento
Acesse o console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique em nome do seu cluster. No painel de navegação à esquerda, clique em .
-
Na página Prometheus Monitoring, clique na aba SysOM e visualize o recurso de monitoramento ack-sysom-monitor.
O ack-sysom-monitor fornece monitoramento na camada do kernel do sistema operacional nas dimensões de nó e Pod.
-
Monitoramento na camada do kernel do sistema operacional na dimensão do nó
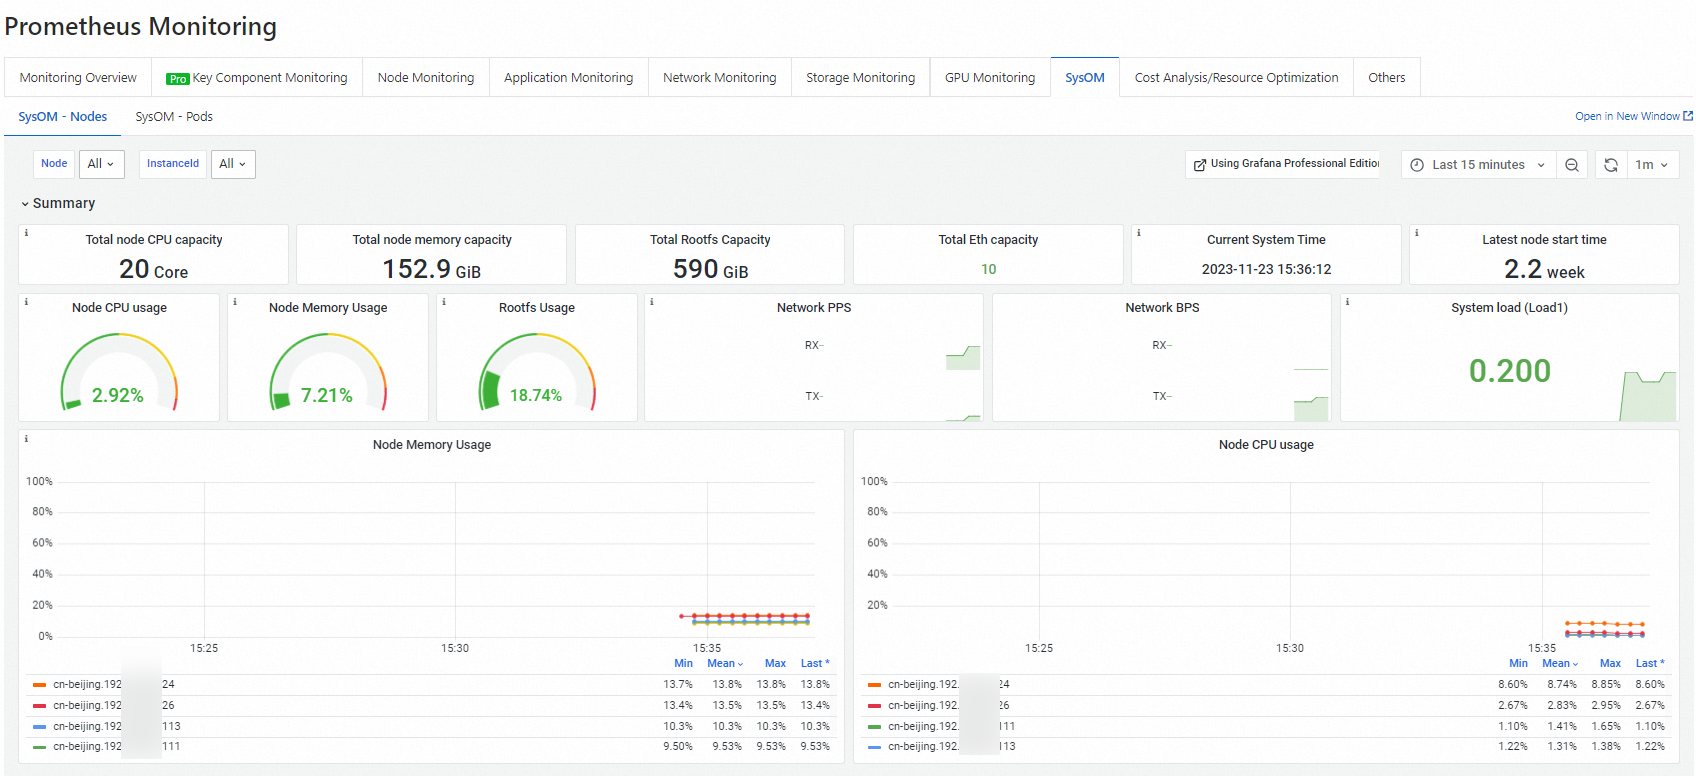
Na aba SysOM - Nodes, monitore as métricas de módulos como memória, CPU e agendamento, armazenamento e rede na dimensão do nó.
-
Monitoramento na camada do kernel do sistema operacional na dimensão do Pod
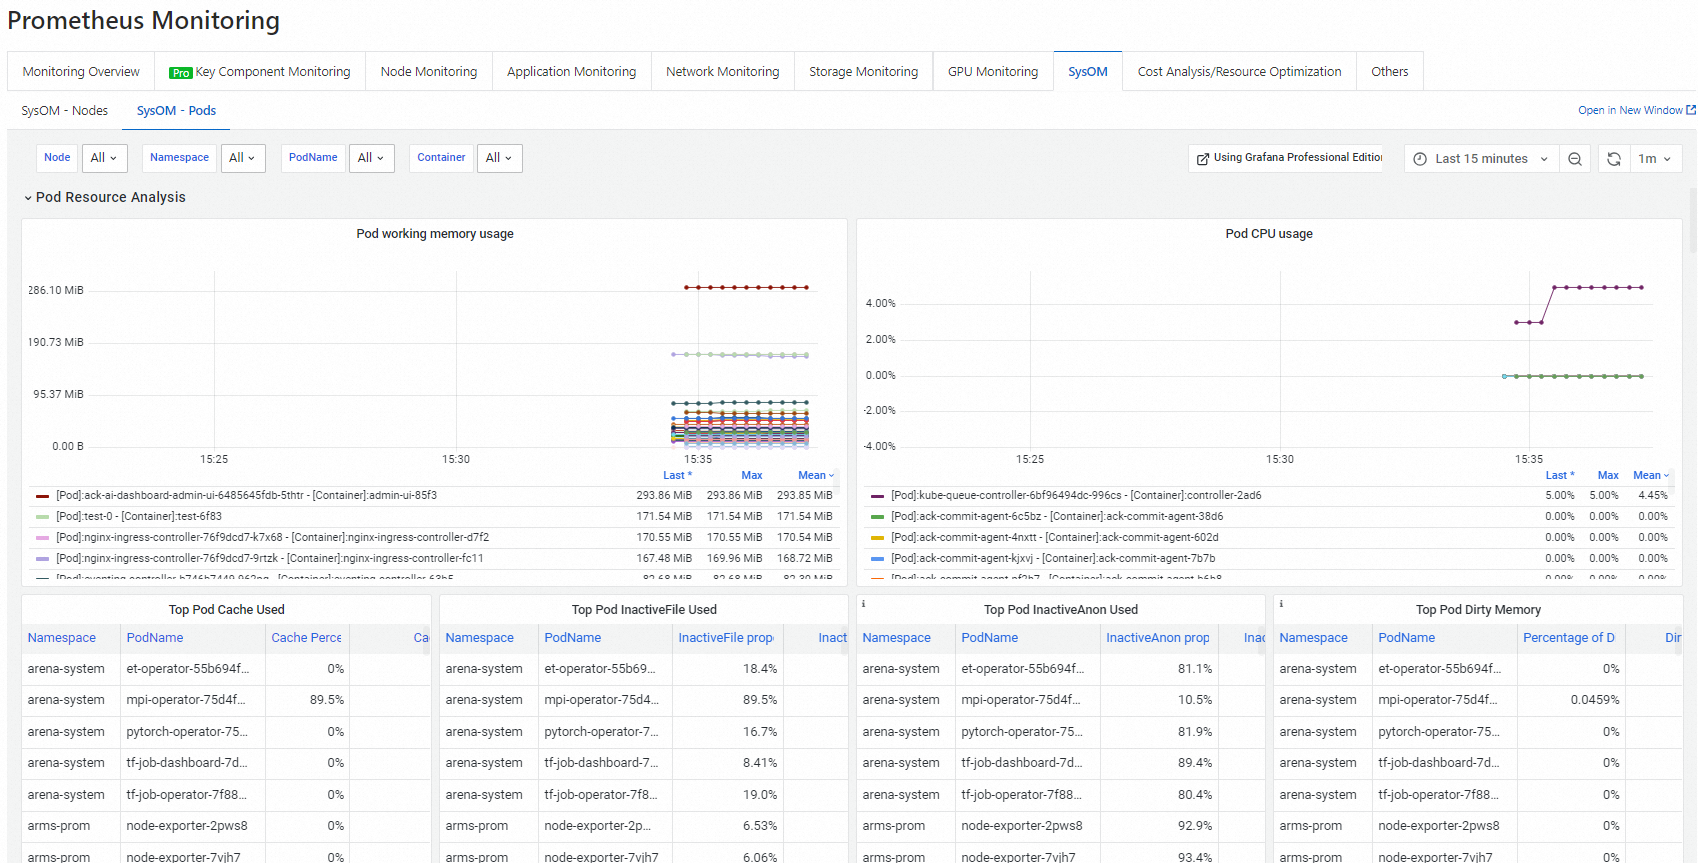
Na aba SysOM - Pods, monitore em tempo real as métricas de módulos como memória, CPU, rede e I/O na dimensão do Pod.
-
Operações relacionadas
Para desativar o monitoramento de contêineres na camada do kernel do SysOM, exclua o add-on ack-sysom-monitor para evitar cobranças adicionais. Execute o procedimento consultando Componentes.
Descrição das métricas
As métricas de monitoramento do ack-sysom-monitor são definidas no formato padrão de métricas do Prometheus.
Métricas de nó
As métricas de nó são categorizadas em CPU, memória, armazenamento, rede e outras métricas.
Métricas de CPU e agendamento
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_proc_cpu_total |
gauge |
% |
Exibe a proporção do tempo total de execução da CPU no nó. Essa métrica indica a razão entre o tempo de execução de todas as CPUs em cada estado e o tempo total de execução da CPU. Esses estados incluem modo de usuário, modo de kernel, interrupção de software (softirq), interrupção de hardware (hardirq), ocioso e espera de I/O (iowait). |
|
sysom_proc_cpus |
gauge |
% |
Apresenta a proporção do tempo de execução de uma CPU específica no nó. Ela indica a razão entre o tempo de execução de uma CPU específica em diferentes estados do sistema e o tempo total de execução da CPU. Tais estados incluem modo de usuário, modo de kernel, interrupção de software (softirq), interrupção de hardware (hardirq), ocioso e espera de I/O (iowait). |
|
sysom_proc_sirq |
gauge |
% |
Indica o status de interrupção de software do nó. Fornece o número de ocorrências de vários tipos de interrupções de software (softirq) no sistema. Os tipos contabilizados incluem HI (alta prioridade), TIMER (temporizador), NET_TX (transmissão de rede), NET_RX (recebimento de rede), BLOCK (dispositivo de bloco), IRQ_POLL (polling de interrupção), TASKLET (fila de tarefas), SCHED (agendador), HRTIMER (temporizador de alta resolução) e interrupções de software RCU. |
|
sysom_proc_stat_counters |
gauge |
- |
Revela se o nó possui processos excessivos no estado D, auxiliando na compreensão da carga do sistema. A métrica apresenta o número de processos em diferentes estados (Running e estado D) no sistema, além do tempo de inicialização do sistema e do número de trocas de contexto. |
|
sysom_proc_loadavg |
gauge |
- |
Representa a carga média do nó. Indica a carga média (load average) do sistema, incluindo o tamanho da fila de execução (runq), a carga média no último minuto, nos últimos 5 minutos, nos últimos 15 minutos e o número total de processos no sistema. |
|
sysom_proc_schedstat |
gauge |
ns (nanossegundos) |
Exibe a latência de agendamento do nó. Fornece estatísticas relacionadas ao agendamento de CPU, incluindo o tempo consumido pelos processos em espera na fila de agendamento da CPU atual e o tamanho da fatia de tempo em execução na CPU atual. |
|
sysom_cpu_dist |
gauge |
- |
Apresenta o status geral de agendamento do nó. Fornece estatísticas sobre o tempo decorrido desde a liberação da CPU por um processo até seu próximo agendamento para execução. Inclui o número de vezes que todos os processos no sistema passaram da liberação da CPU para o reagendamento em diferentes intervalos de tempo (1us, 10us, 100us, 1ms, 10ms, 100ms e 1s). |
Métricas de memória
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_proc_meminfo |
gauge |
KiB |
Exibe o uso de vários tipos de memória no nó. A métrica detalha o uso de memória, incluindo, entre outros, memória total (Total), memória livre (Free), memória disponível (Available), cache de página (Cache), cache de buffer (Buffers), memória recuperável (SReclaimable) e memória irrecuperável (SUnreclaim). |
|
sysom_proc_vmstat |
gauge |
- |
Indica o uso detalhado de memória e os eventos de memória do nó. Apresenta estatísticas de memória do sistema baseadas em páginas e estatísticas de alguns eventos de memória. As informações incluem: o número de páginas livres (Free Pages), páginas sujas (Dirty Pages), páginas lidas ou gravadas no disco (Pages Read/Write), páginas recuperadas da lista inativa (Pages Reclaimed from Inactive List) e encerramentos por falta de memória (OOM). |
|
sysom_proc_buddyinfo |
gauge |
- |
Mostra estatísticas sobre a alocação e liberação do sistema buddy no gerenciamento de memória do kernel do nó. Fornece detalhes sobre o sistema buddy do kernel, incluindo todos os nós de memória (Node) e zonas (Zone) no sistema, e o número de blocos de página nas listas do sistema buddy de diferentes tamanhos. |
Métricas de armazenamento
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_proc_disks |
gauge |
- |
Apresenta estatísticas como leituras, gravações, solicitações de I/O e latência de cada disco e partição no nó, auxiliando na compreensão do status de I/O. A métrica fornece dados sobre discos e partições no sistema, incluindo o número de solicitações de leitura e gravação concluídas, o tempo total gasto nessas solicitações, o número de solicitações mescladas e o número de operações de I/O incompletas (Inflight) no dispositivo. |
|
sysom_fs_stat |
gauge |
- |
Exibe o uso de sistemas de arquivos montados no nó. Fornece estatísticas de uso de cada sistema de arquivos (FS) no sistema, incluindo o destino de montagem, o tamanho do bloco, o número de blocos usados e disponíveis, e o número de inodes usados e disponíveis. |
Métricas de rede
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_proc_networks |
gauge |
- |
Indica o tráfego de cada placa de interface de rede (NIC) no nó. A métrica apresenta estatísticas de tráfego de cada NIC, incluindo o número total de pacotes enviados/recebidos, o total de bytes, o total de pacotes descartados pelo driver do dispositivo durante o envio/recebimento e o total de erros durante a transmissão/recepção de pacotes. |
|
sysom_proc_pkt_status |
gauge |
- |
Mostra o status geral de processamento de pacotes de dados pela pilha de protocolos de rede do nó. Fornece o número de eventos que ocorrem quando os pacotes atravessam a pilha de protocolos, incluindo descartes de pacotes, estouros de pilha e falhas de asserção. |
|
sysom_sock_stat |
gauge |
- |
Ajuda a detectar situações como esgotamento de soquetes e buffers causados por problemas na lógica da aplicação ou nas configurações de parâmetros do sistema. Apresenta estatísticas sobre o uso de soquetes e seus buffers no nó, incluindo o uso de soquetes total/raw/tcp/udp, o número de soquetes no estado TCP time wait ou orphan e o uso de memória dos soquetes TCP/UDP. |
|
sysom_softnets |
gauge |
- |
Exibe o status dos pacotes recebidos pela interrupção de software da NIC de cada CPU no nó. Fornece estatísticas relacionadas a interrupções de software de rede, incluindo o número de pacotes recebidos e descartados em interrupções de software em uma CPU e o número de chamadas para o manipulador de interrupção de software de recebimento de pacotes net_rx_action. |
|
sysom_net_health_hist |
gauge |
- |
Apresenta a distribuição do tempo de ida e volta (RTT) de todas as conexões TCP no nó, auxiliando na compreensão da latência dos links TCP. Inclui estatísticas sobre o número de vezes que o RTT suavizado se enquadra em diferentes faixas de tempo, como dentro de 10ms, 100ms e 1s. |
|
sysom_net_health_count |
gauge |
- |
Semelhante à métrica |
|
sysom_net_retrans_count |
gauge |
- |
Mostra o status de retransmissão de todas as conexões TCP no nó e ajuda a entender rapidamente as causas das retransmissões. Fornece os tipos de pacotes retransmitidos e as contagens correspondentes, incluindo retransmissões devido a RTO (Retransmission Timeout) e retransmissões de diferentes tipos de pacotes (como Syn, Syn-ack e Reset). |
|
sysom_net_tcp_count |
gauge |
- |
Indica o status básico das conexões TCP no nó. Apresenta estatísticas relacionadas às conexões TCP, incluindo o número de conexões estabelecidas e ativas, segmentos TCP recebidos/enviados, segmentos TCP retransmitidos e pacotes com erros no lado do receptor. |
|
sysom_net_udp_count |
gauge |
- |
Exibe o status básico das conexões UDP no nó. Fornece estatísticas relacionadas às conexões UDP, incluindo o número de pacotes UDP enviados/recebidos, erros nos buffers de envio/recebimento UDP e pacotes com erro causados pela falta de portas disponíveis. |
|
sysom_net_ip_count |
gauge |
- |
Apresenta o status básico da camada ip no nó. Mostra estatísticas relacionadas à camada ip, incluindo o número de pacotes ip encaminhados, recebidos e enviados no sistema. |
|
sysom_net_icmp_count |
gauge |
- |
Indica o status básico do protocolo ICMP no nó. Fornece estatísticas relacionadas ao protocolo ICMP, incluindo o número de pacotes ICMP enviados/recebidos e pacotes com erros de envio/recebimento. |
Outras métricas do sistema
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_cgroups |
gauge |
- |
Exibe o número de cgroups usados por cada subsistema cgroup no sistema, auxiliando na observação de possíveis vazamentos de cgroup. A métrica fornece o número de cgroups sob cada subsistema, incluindo os diretórios de subsistemas como CPU, Cpuacct, Memory, Pids, Blkio e Devices. |
|
sysom_uptime |
gauge |
s (segundos) |
Ajuda a entender a carga do sistema até certo ponto. Indica o tempo decorrido desde a inicialização do sistema e o tempo ocioso do sistema. |
Métricas de contêiner
As métricas de contêiner são categorizadas em CPU, memória, I/O, rede e outras métricas.
Métricas de CPU e agendamento
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_container_cpu_stat |
gauge |
- |
Monitora e avalia a necessidade de ajustar o ResourceQuota ou aplicar outras otimizações. A métrica fornece estatísticas sobre os limites de recursos de CPU no contêiner, incluindo o número de eventos periódicos de limitação (throttling) de CPU no cgroup, a quantidade de ocorrências de limitação e o tempo total de limitação. |
|
sysom_container_cpu_acctstat |
gauge |
% |
Exibe o uso detalhado de CPU do contêiner. Apresenta o uso de CPU de todas as tarefas em execução em cada modo, incluindo o uso no modo de usuário (User), modo de kernel (Kernel) e o uso geral. |
|
sysom_container_cpu_cfsquota |
gauge |
- |
Indica o tempo de execução do contêiner limitado pelo agendador CFS. Fornece o tempo de execução permitido em cada janela de tempo de agendamento CFS, incluindo cfs_period_us e cfs_quota_us.
|
Métricas de memória
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_container_memory_stat |
gauge |
KiB |
Exibe o uso de vários tipos de memória no contêiner. Apresenta estatísticas de uso, incluindo memória total (Total), memória livre (Free), memória disponível (Available), cache de página (Cache), cache de buffer (Buffers), memória compartilhada (Shmem), memória recuperável (SReclaimable) e memória irrecuperável (SUnreclaim). |
|
sysom_container_memory_filecache |
gauge |
KiB |
Auxilia na compreensão rápida do uso do cache de arquivos no contêiner, permitindo localizar problemas de escassez e oscilações de latência de memória causados por uso excessivo. Fornece estatísticas sobre o uso do cache de arquivos (Page Cache), incluindo os 10 principais arquivos que mais ocupam esse cache em cada contêiner, com seus respectivos tamanhos e quantidades ocupadas. |
|
sysom_container_memory_gdrcm_latency |
gauge |
count |
Indica se o contêiner apresenta contagens e tempos de latência causados pela recuperação direta de memória devido à pressão de memória do nó. Fornece estatísticas sobre o tempo e a contagem de latência, incluindo ocorrências de 1 a 5 milissegundos, 5 a 10 milissegundos, 10 a 100 milissegundos, 100 a 500 milissegundos, 500 a 1000 milissegundos e acima de 1000 milissegundos. |
|
sysom_container_memory_cdrcm_latency |
gauge |
count |
Exibe se o contêiner apresenta contagens e tempos de latência causados pela recuperação direta de memória devido à pressão no grupo de controle de memória atual (Memory CGroup). Nota
Essa métrica só é relevante quando o grupo de controle de memória atual é não raiz (Non-Root) ou caso você defina um limite de memória para ele. Fornece estatísticas sobre o tempo e a contagem de latência causados pela recuperação direta, incluindo ocorrências de 1 a 5 milissegundos, 5 a 10 milissegundos, 10 a 100 milissegundos, 100 a 500 milissegundos, 500 a 1000 milissegundos e acima de 1000 milissegundos. |
|
sysom_container_memory_cpt_latency |
gauge |
count |
Indica a ocorrência de latência causada pela compactação de memória do kernel quando os processos no contêiner solicitam memória, devido à pressão de memória do nó ou excesso de fragmentos de memória. Apresenta estatísticas sobre a contagem e o tempo de latência causados pela compactação direta, incluindo ocorrências de 1 a 5 milissegundos, 5 a 10 milissegundos, 10 a 100 milissegundos, 100 a 500 milissegundos, 500 a 1000 milissegundos e acima de 1000 milissegundos. |
Métricas de I/O
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_container_blkio_stat |
gauge |
- |
Exibe o status básico de I/O do contêiner. Fornece estatísticas de I/O no disco correspondente, incluindo o número de solicitações de leitura/gravação iniciadas, bytes solicitados, solicitações de I/O entrando na fila e o tempo de espera de I/O de leitura/gravação. |
Métricas de rede
|
Metric name |
Metric type |
Unit |
Description |
|
sysom_container_network_stat |
gauge |
- |
Apresenta o tráfego de rede básico do contêiner. Fornece estatísticas de tráfego na NIC virtual, incluindo pacotes enviados/recebidos, total de bytes e pacotes descartados (os descartes consideram apenas a camada do dispositivo da NIC virtual, excluindo a pilha de protocolos de rede). |