O plano de controle predefinido do ACK Pro aloca recursos de linha de base dedicados aos componentes do plano de controle para garantir desempenho consistente. Monitore as métricas de capacidade principal e a utilização de recursos para avaliar se seu cluster precisa de uma atualização de tier.
Monitoramento de planejamento de capacidade
Métricas de capacidade principal
As especificações de tier do plano de controle predefinido são definidas pelas três métricas de capacidade principal a seguir. Cada métrica reflete a capacidade de processamento do plano de controle em uma dimensão diferente.
|
Métrica |
Unidade |
PromQL |
Descrição |
|
Simultaneidade de solicitações da API |
Seats |
|
A especificação do tier define a simultaneidade máxima de solicitações da API em termos de Seats. O plano de controle predefinido garante a capacidade de processamento de solicitações em cenários de alta simultaneidade ao alocar recursos de linha de base dedicados ao servidor de API. Esta métrica de monitoramento baseia-se no mecanismo Kubernetes API Priority and Fairness (APF) e reflete o número de solicitações simultâneas atualmente em processamento. |
|
Taxa de agendamento de Pods |
Pods/s |
|
Taxa na qual o agendador do cluster agenda Pods nos nós por segundo. O plano de controle predefinido assegura taxas de agendamento determinísticas por meio de cota fixa de recursos, evitando flutuações de desempenho de agendamento causadas pelo dimensionamento elástico do plano de controle. |
|
Tamanho do banco de dados etcd |
GB |
|
Capacidade de armazenamento dos dados completos do cluster. Quando o uso do banco de dados se aproximar do limite superior do tier atual, atualize o tier ou limpe recursos não utilizados em tempo hábil. |
Visualize painel de capacidade principal
Na página Cluster Information do cluster desejado, clique em aba Cluster Monitoring.
-
Compare as seguintes métricas de capacidade com ACK Pro preset control plane tier specifications para seleção de tier.
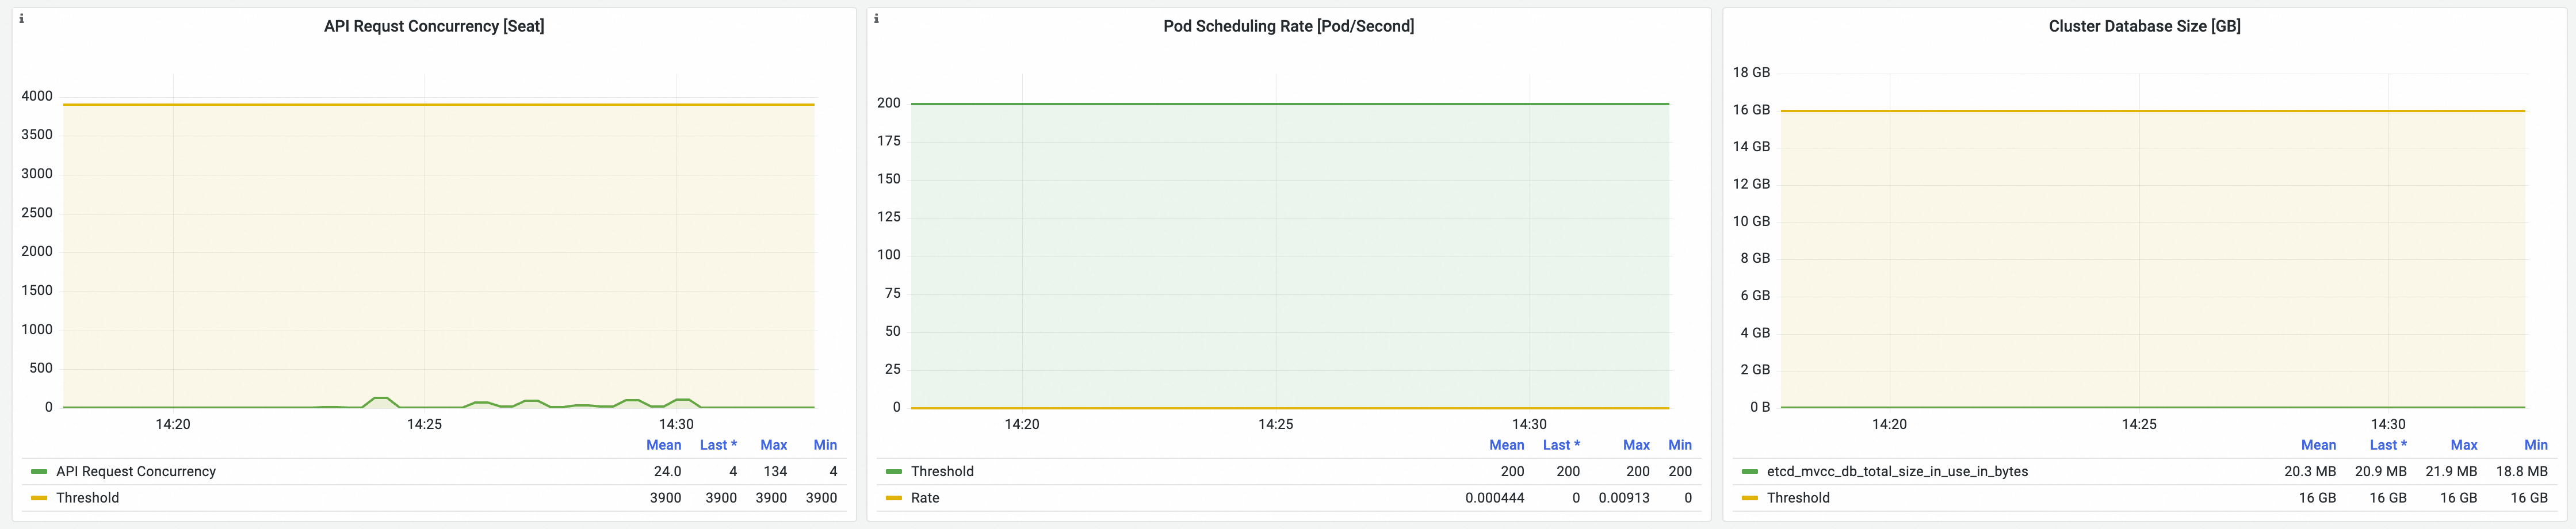
O painel exibe os seguintes painéis:
Simultaneidade de solicitações da API: Corresponde à especificação de Seats do tier, refletindo a pressão de processamento simultâneo sobre o servidor de API.
Taxa de agendamento de Pods: Mostra o número de solicitações de agendamento de Pods processadas por segundo para determinar se o agendador apresenta gargalo.
Tamanho do banco de dados etcd (Tamanho do banco de dados do cluster): Exibe o uso de armazenamento do etcd para verifique se o volume de dados permanece dentro do limite seguro do tier atual.
Critérios de referência para troca de tier
Antes de avaliar uma possível atualização de tier, revise as especificações de tier para obter os valores específicos de capacidade do seu tier atual.
Quando qualquer uma das condições a seguir ocorrer no cluster, avalie a necessidade de atualizar o tier:
|
Dimensão |
Condição de referência para atualização |
Descrição |
|
Simultaneidade de solicitações da API |
Os Seats simultâneos atuais atingem continuamente 80% ou mais do limite superior do tier atual. |
A capacidade de processamento simultâneo do servidor de API está próxima da saturação. Podem ocorrer filas de solicitações ou limitação HTTP 429. |
|
Taxa de agendamento de Pods |
A taxa de agendamento se aproxima continuamente do limite superior do tier atual e Pods Pending estão se acumulando. |
O agendador tornou-se um gargalo e o dimensionamento da carga de trabalho está restrito. |
|
Tamanho do banco de dados etcd |
O uso do banco de dados excede 80% da capacidade do tier atual. |
Espaço de armazenamento insuficiente pode fazer com que o etcd rejeite gravações, afetando alterações de estado do cluster. |
|
Utilização de recursos de componentes do plano de controle |
A utilização de CPU ou memória de qualquer componente do plano de controle (como kube-apiserver, etcd e kube-scheduler) permanece continuamente em status |
A alocação de recursos do tier atual está sob pressão, apresentando risco de não conseguir suportar a carga de trabalho real. Atualize o tier para obter uma cota maior de recursos. |
As condições acima são recomendações de referência. As decisões de atualização devem basear-se em uma avaliação abrangente dos seus cenários de negócios, períodos de pico de carga e duração. Observe tendências das métricas em vez de picos momentâneos e planeje atualizações antecipadamente antes dos períodos de pico de carga.
Monitoramento e alertas de utilização de recursos
Visualize utilização de recursos
Na página do product do cluster desejado, no painel de navegação à esquerda, escolha Operations > Prometheus Monitoring.
-
Clique em aba Key Component Monitoring e alterne entre as abas de componentes. Concentre-se na utilização de recursos de memória e CPU dos componentes kube-apiserver, etcd e kube-scheduler.
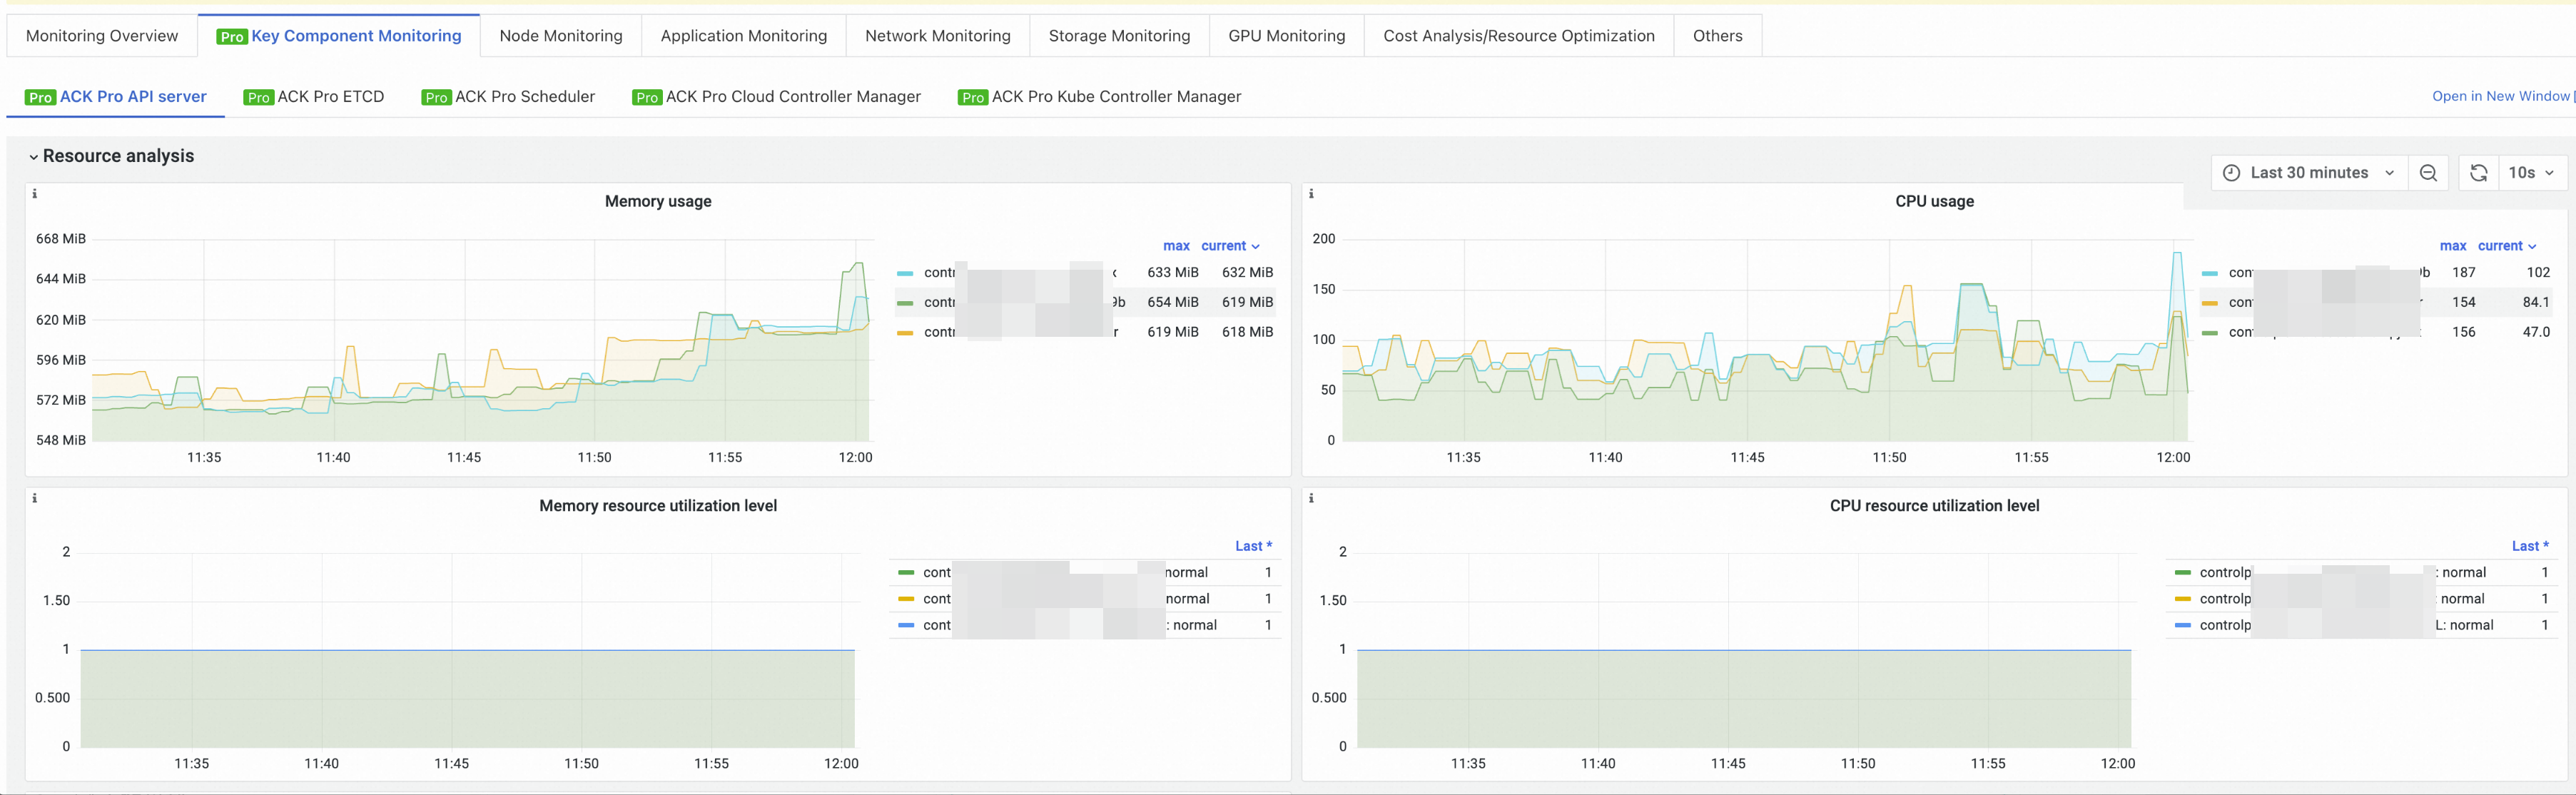
As métricas de utilização de recursos são exibidas para cada componente.
Tomando o kube-apiserver como exemplo, a utilização de recursos é medida pelas seguintes métricas:
|
Tipo de recurso |
Métrica |
Descrição |
|
Utilização de memória |
|
Um valor igual a 1 indica que a utilização de memória é ≥ 80%. |
|
Utilização de memória |
|
Um valor igual a 1 indica que a utilização de memória é < 80%. |
|
Utilização de CPU |
|
Um valor igual a 1 indica que a utilização de CPU é ≥ 80%. |
|
Utilização de CPU |
|
Um valor igual a 1 indica que a utilização de CPU é < 80%. |
Quando as métricas de utilização permanecem continuamente em status high (utilização ≥ 80%), os recursos atuais do plano de controle estão sob pressão. Atualize o tier em tempo hábil.
A tabela acima usa o kube-apiserver como exemplo. O campo container também se aplica a outros componentes do plano de controle, como etcd, kube-scheduler e kube-controller-manager.
Alertas de utilização de recursos de componentes do plano de controle
O plano de controle predefinido do ACK Pro vem pré-configurado com alertas de utilização de recursos dos componentes do plano de controle. Quando a utilização de CPU ou memória de qualquer componente do plano de controle excede continuamente o limiar, o sistema aciona automaticamente notificações de alerta.
|
Propriedade |
Descrição |
|
Nome do alerta |
Alta utilização de memória de componente gerenciado do plano de controle / Alta utilização de CPU de componente gerenciado do plano de controle. |
|
Condição de acionamento |
A utilização de CPU ou memória de um componente gerenciado do plano de controle (como kube-apiserver, etcd e kube-scheduler) permanece continuamente ≥ 80%. |
|
Método de notificação |
As notificações são enviadas por meio do grupo de contatos de alerta configurado para o cluster. Os canais suportados incluem SMS, e-mail e DingTalk. |
|
Ação recomendada |
Após receber um alerta, faça login no console para verifique o status de utilização de recursos. Atualize o tier em tempo hábil para evitar degradação de desempenho do plano de controle ou indisponibilidade do service. |
Exemplo de alerta:
Alert Name: High Memory Utilization of Control Plane Managed Component_<cluster-name>
Alert Level: P1
Cluster Name: <cluster-name>
Alert Content: High memory utilization of control plane managed component
Referências
ACK Pro preset control plane tier specifications: Conheça as especificações de tier, regras de troca e cenários aplicáveis do plano de controle predefinido do ACK Pro.