Resolva falhas de agendamento de pods, erros de pull de imagem, travamentos na inicialização, OOM kills e problemas em tempo de execução.
Para solução de problemas via console — visualização de status, eventos e logs do pod, acesso a terminais e execução de diagnósticos — consulte Procedimentos comuns de solução de problemas.
Procedimento rápido de diagnóstico
Para diagnosticar um pod anormal, acesse a página de detalhes do Pods alvo. Clique em aba Events para revisar as descrições de eventos anormais. Em seguida, clique em aba Logs para verificar logs anormais recentes.
Pod no estado Pending
Se um Pod apresentar status Unschedulable em seus Status Details ou se um evento FailedScheduling aparecer em Events, acesse para verificar a integridade dos nós e os níveis de recursos (CPU e memória). Verifique também se as regras de afinidade do pod — nodeSelector, nodeAffinity e tolerâncias — são restritivas demais. Consulte Problemas de agendamento.
Falha no pull de imagem (ImagePullBackOff/ErrImagePull)
Na página de detalhes de Pods, acesse a aba Container e verifique o endereço da Image. Acesse o nó do pod e execute crictl pull <image-address> ou curl -v https://<image-address> para verificar a conectividade de rede com o repositório de imagens. No canto superior direito, clique em Edit YAML e confirme se o Secret especificado no campo spec.imagePullSecrets da workload existe e é válido. Para mais etapas de solução de problemas, consulte problemas de pull de imagem.
Falha na inicialização do Pod (CrashLoopBackOff)
A aplicação trava e reinicia repetidamente. Na página de detalhes de Pods, clique em aba Logs e selecione Show the log of the last container exit para visualizar a causa da falha. Para mais etapas de solução de problemas, consulte Solucionar falhas de inicialização de pod.
Pod em execução, mas não pronto
A sonda de prontidão (readiness probe) do pod falhou. Na página Edit da Workloads alvo, verifique se o caminho da requisição de health check (por exemplo, /healthz) e a porta correspondem aos fornecidos pela aplicação. Para mais etapas de solução de problemas, consulte O pod está Running mas não ready (Ready: False).
Desative temporariamente o health check e use curl no terminal do pod ou no nó host para verificar se o endpoint responde corretamente.
Pod com OOMKilled
Na página de detalhes de Pods, clique em aba Logs e selecione Show the log of the last container exit para visualizar os logs de OOM. Verifique se a aplicação apresenta vazamento de memória ou erro de out-of-memory (OOM). Para aplicações Java, otimize o parâmetro -Xmx. Ajuste o limite de recursos de memória da aplicação (resources.limits.memory) conforme necessário. Para mais etapas de solução de problemas, consulte OOMKilled.
Se uma sonda de vivacidade (liveness probe) estiver configurada, o pod permanece no estado OOMKilled apenas brevemente antes de reiniciar automaticamente.
Fluxo de trabalho de diagnóstico
Para diagnosticar um pod anormal, inspecione seus eventos, logs e configuração.

Fase 1: Problemas de agendamento
Pod não agendado em um nó
Se um pod permanecer no estado Pending por um período prolongado, ele não foi agendado em nenhum nó.
Mensagem de erro | Descrição | Solução |
| O cluster não possui nós disponíveis para agendamento de pods. |
|
| Nenhum nó disponível no cluster consegue atender às solicitações de recursos de CPU ou memória do pod. Um nó torna-se não agendável quando o total de | Na página de detalhes do cluster alvo, acesse e verifique a taxa de alocação de requests de CPU ou memória para o nó alvo. Passe o mouse sobre a taxa de alocação para visualizar os valores específicos de alocação de recursos.
Para visualizar o uso detalhado de recursos do nó, consulte Use kubectl to view node resource usage.
|
| Os nós existentes não correspondem à política de afinidade de nó do pod ( |
|
|
|
|
| O agendamento falha devido a um conflito de afinidade de nó de volume. Isso geralmente ocorre porque um disco cloud não pode ser montado em zonas diferentes. |
|
| A instância ECS não suporta o tipo de disco cloud especificado. | Consulte Instance families para confirmar os tipos de disco cloud suportados pela sua instância ECS. Ao montar, atualize o tipo de disco cloud para um que seja suportado pela instância ECS. |
| O pod não pode ser agendado em um nó porque falta uma tolerância para um dos taints do nó. |
|
| O nó possui armazenamento efêmero insuficiente. |
|
| O pod falhou ao vincular a uma persistent volume claim (PVC). | Verifique se a PVC ou PV especificado pelo pod foi criado. Execute |
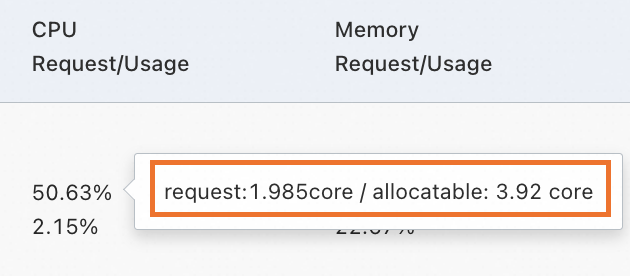
 > Node Affinity
Pod agendado, mas permanece Pending
Se um pod foi agendado, mas permanece Pending, siga estas etapas.
-
Se um pod usar
hostPort, apenas um pod com essahostPortpode ser executado por nó, portantohostPortlimita a contagem deReplicasao número de nós. Se a porta já estiver em uso, o agendamento falha.hostPortadiciona complexidade ao agendamento. Use um Service para expor pods em vez disso. -
Se o Pod não estiver configurado com
hostPort, siga as etapas abaixo para solucionar o problema.Visualize os eventos do pod com
kubectl describe pod <pod-name>. Causas comuns incluem falhas no pull de imagem, recursos insuficientes, restrições de política de segurança e erros de configuração.Se nenhum evento útil for encontrado, verifique os logs do kubelet no nó com
grep -i <pod name> /var/log/messages* | less.
Fase 2: Problemas de pull de imagem
ImagePullBackOff ou ErrImagePull
Um status de pod ImagePullBackOff ou ErrImagePull indica que o pull da imagem falhou. Examine os eventos do pod para identificar a causa.
Mensagem de erro | Descrição | Solução sugerida | ||||||
| O acesso ao repositório de imagens foi negado porque um | Verifique se o Secret especificado no campo Ao usar o ACR, utilize um credential helper para fazer pull de imagens sem senha. Consulte Pull images from the same account. | ||||||
| O endereço do repositório de imagens não pôde ser resolvido ao fazer pull de uma imagem via HTTPS. |
| ||||||
| O nó possui espaço em disco insuficiente. | Acesse o nó (consulte Choose an ECS remote connection method) e execute | ||||||
| O repositório de imagens de terceiros usa um certificado assinado por uma Autoridade Certificadora (CA) desconhecida ou insegura. |
ConsoleProcedimentoAs alterações não afetam contêineres em execução. Execute esta operação durante horários de menor demanda.
Exemplos de configuração
CLI
| ||||||
| A operação foi cancelada, possivelmente porque o arquivo de imagem é muito grande. O Kubernetes tem um tempo limite padrão para pull de imagens. Se o pull não progredir por um período específico, o Kubernetes assume que a operação falhou ou não está respondendo e cancela a tarefa. |
| ||||||
| Não é possível conectar ao repositório de imagens devido a problemas de rede. |
| ||||||
| Tempo limite de conexão excedido devido a problemas de rede ao fazer pull de uma imagem de um repositório no exterior. | Fazer pull de imagens de repositórios no exterior, como Docker Hub, pode falhar em clusters ACK devido a redes de operadoras instáveis. Para resolver isso, considere as seguintes soluções:
| ||||||
| O Docker Hub impõe limites de taxa nas requisições de pull de imagem. | Faça upload da imagem para Container Registry (ACR) e faça pull dela de um repositório de imagens ACR. | ||||||
O status | O mecanismo de limitação de taxa de pull de imagem do kubelet pode ter sido acionado. | Ajuste o |
 > Containerd Configuration.
Fase 3: Problemas de inicialização
Pod no estado Init
Mensagem de erro | Descrição | Solução |
Preso no estado | O pod possui M contêineres init; N concluídos, mas os M-N restantes falharam ao iniciar. |
Consulte Debug init containers. |
Preso no estado | Um contêiner init no pod falhou ao iniciar. | |
Preso no estado | Um contêiner init no pod falhou ao iniciar e está em um loop de reinicialização. |
Pod no estado Creating
Mensagem de erro | Descrição | Solução |
| Este é um comportamento esperado devido ao design do plugin de rede Flannel. | Atualize o componente Flannel para v0.15.1.11-7e95fe23-aliyun ou posterior. Consulte Flannel. |
Em clusters que executam uma versão do Kubernetes anterior a 1.20, pode ocorrer vazamento de endereço IP se um pod reiniciar repetidamente ou se pods de um CronJob concluírem suas tarefas e saírem rapidamente. | Atualize o cluster para Kubernetes 1.20 ou posterior (recomenda-se o mais recente). Consulte Manually upgrade a cluster. | |
Defeitos no containerd e runC causam esse problema. | Para uma correção de emergência, consulte Why does my pod fail to start with the error "no IP addresses available in range"? | |
| O plugin de rede Terway mantém um banco de dados interno no nó para rastrear e gerenciar elastic network interfaces (ENIs). Esse erro ocorre quando o estado do banco de dados é inconsistente com a configuração real do dispositivo de rede, causando falha na alocação de ENI. |
|
| O plugin de rede Terway pode ter falhado ao solicitar um endereço IP do vSwitch. |
|
Falha na inicialização do Pod (CrashLoopBackOff)
Mensagem de erro | Descrição | Solução |
O log contém |
| |
Os eventos do pod mostram | A sonda de vivacidade falhou, causando a reinicialização da aplicação. |
|
Os eventos do pod mostram | A sonda de inicialização falhou, causando a reinicialização da aplicação. |
|
O log do pod contém | Espaço em disco cloud insuficiente. |
|
A inicialização falha sem informações de evento. | Esse problema ocorre quando um contêiner requer mais recursos do que seus limites declarados, causando sua falha. | Verifique se a configuração de recursos do pod está correta. Ative resource profiling para obter configurações recomendadas de Request e Limit para o contêiner. |
O log do pod mostra | Existe um conflito de porta entre contêineres no mesmo pod. |
|
O log do pod mostra | A workload monta um Secret, mas o valor no Secret não está codificado em Base64. |
|
Problema específico da aplicação. | Examine os logs do pod para solucionar o problema. | |
Pod em execução, mas não pronto (Ready: False)
Mensagem de erro | Descrição | Solução |
| A sonda de prontidão falhou, impedindo o pod alvo de receber tráfego. |
|
O status do pod é o mesmo acima. Os eventos do pod mostram | Uma sonda de inicialização com falha causa a reinicialização do contêiner. Este erro não deve resultar em um estado Running/NotReady persistente, mas sim em um estado 'CrashLoopBackOff'. | Solucione este problema conforme descrito na seção "Falha na inicialização do Pod (CrashLoopBackOff)" para Startups. |
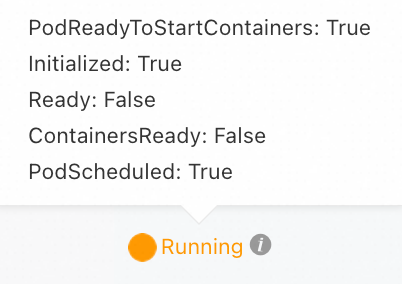 Os eventos do pod mostram
Fase 4: Problemas de runtime do Pod
OOMKilled
Quando um contêiner excede seu limite de memória, ele é terminado por um OOM kill. Consulte Assign Memory Resources to Containers and Pods.
Se o processo terminado for o processo principal do contêiner, o contêiner pode reiniciar inesperadamente.
Quando ocorre um evento OOM, ele aparece na aba Events da página de detalhes do pod no console, como
pod was OOM killed. node:XXX pod:XXX namespace:XXX.Configure um alerta de exceção de réplica de contêiner para receber notificações de OOM.
Nível de OOM | Descrição | Solução recomendada |
Nível de SO | Verifique o log do kernel em |
|
Nível de cgroup | Verifique o log do kernel em |
|
Consulte Causas e soluções para OOM Killer.
Terminating
Causa possível | Descrição | Solução recomendada |
O nó está no estado NotReady. | O pod é excluído automaticamente após o nó se recuperar do estado NotReady. | |
O pod está configurado com finalizers. | Se um pod estiver configurado com finalizers, o Kubernetes executa as operações de limpeza especificadas pelos finalizers antes de excluir o pod. Se uma operação de limpeza falhar ao responder, o pod permanece no estado Terminating. | Verifique a configuração de finalizer do pod com |
O hook preStop do pod é inválido ou está travado. | Se um hook preStop estiver configurado para o pod, o Kubernetes executa o hook antes de terminar o contêiner. O pod permanece no estado Terminating enquanto o hook está em execução. | Verifique a configuração do hook preStop do pod com |
Um período de desligamento gracioso está configurado para o pod. | Se um Pod estiver configurado com um período de desligamento gracioso ( | O Kubernetes exclui automaticamente o pod após o contêiner concluir um desligamento gracioso. |
O contêiner não responde. | Quando você solicita parar ou excluir um pod, o Kubernetes envia um sinal |
|
Evicted
Causa possível | Descrição | Solução recomendada |
O nó está sob pressão de recursos devido a fatores como uso de memória ou disco. | O nó pode estar enfrentando pressão de memória, pressão de disco ou pressão de PID.
|
|
Ocorre uma evicção inesperada. | Um taint NoExecute adicionado manualmente no nó do pod causou uma evicção inesperada. | Verifique se há um taint NoExecute com |
A evicção não prossegue conforme o esperado. |
| Em um cluster pequeno (50 nós ou menos), se mais de 55% dos nós falharem, a evicção de pods para. Consulte Rate limits on eviction. |
Em um cluster grande (mais de 50 nós), se a fração de nós não saudáveis exceder o | ||
Um pod é frequentemente reagendado para seu nó original após ser evacuado. | O kubelet evacua pods com base no uso real de recursos, enquanto o scheduler coloca pods com base em requests de recursos. Como uma evicção libera recursos, o scheduler pode reagendar um pod para o mesmo nó se seus requests ainda couberem. | Ajuste os requests de recursos do pod para caber nos recursos alocáveis do nó. Consulte Set CPU and memory resources for a container. Ative resource profiling para obter valores recomendados de request e limit. |
Completed
Todos os contêineres saíram com sucesso. Comum para jobs e contêineres init.
FAQ
Pod está em execução, mas não funciona
Erros de YAML podem fazer com que um pod entre em Running, mas falhe em funcionar.
Verifique as configurações do contêiner na configuração do pod.
-
Use os métodos a seguir para verificar sua configuração YAML quanto a erros de ortografia.
Se uma chave YAML estiver escrita incorretamente (por exemplo,
commandcomocommnd), o cluster cria o recurso sem erro, mas não consegue executar a chave incorreta em tempo de execução.O exemplo a seguir, no qual
commandestá escrito incorretamente comocommnd, descreve como solucionar problemas de ortografia.-
Adicione
--validateakubectl apply -fe executekubectl apply --validate -f XXX.yaml.Se você escrever uma palavra incorretamente, um erro será relatado:
XXX] unknown field: commnd XXX] this may be a false alarm, see https://gXXXb.XXX/6842pods/test. -
Compare a saída
pod.yamlcom o arquivo YAML original usado para criar o pod.Nota[$Pod]é o nome do Pod anômalo, que você pode obter executando o comandokubectl get pods.kubectl get pods [$Pod] -o yaml > pod.yamlSe o arquivo
pod.yamltiver mais linhas que o arquivo original, significa que o pod foi criado conforme esperado e o cluster adicionou valores padrão.Se linhas do seu arquivo YAML original estiverem ausentes em
pod.yaml, isso indica um erro de ortografia no seu arquivo original.
-
Verifique os logs do pod para solucionar o problema.
Acesse o contêiner através de um terminal e verifique se os arquivos locais dentro do contêiner estão conforme o esperado.
Verificar uso de recursos do nó com kubectl
-
Verifique o uso de CPU e memória de todos os nós no cluster.
kubectl describe nodes | awk '/^Name:/{print "\n"$2} /Resource +Requests +Limits/{print $0} /^[ \t]+cpu.*%/{print $0} /^[ \t]+memory.*%/{print $0}'Saída esperada:
cn-hangzhou.192.168.0.xxx
  Resource           Requests      Limits
  cpu                1725m (44%)   10320m (263%)
  memory             1750Mi (11%)  16044Mi (109%)

cn-hangzhou.192.168.16.xxx
  Resource           Requests      Limits
  cpu                1885m (48%)   16820m (429%)
  memory             2536Mi (17%)  25760Mi (179%)
Um nó com alta utilização de requests pode não conseguir satisfazer os
requestsde um novo Pod, impedindo que o Pod seja agendado. -
Substitua
YOUR_NODE_NAMEpelo nome real do nó para visualizar o uso de recursos de todos os Pods no nó.kubectl describe node YOUR_NODE_NAME | awk '/Non-terminated Pods/,/Allocated resources/{ if ($0 !~ /Allocated resources/) print }'Saída esperada:
Non-terminated Pods:          (11 in total)
  Namespace                   Name                                                        CPU Requests  CPU Limits   Memory Requests  Memory Limits  Age
  ---------                   ----                                                        ------------  ----------   ---------------  -------------  ---
  arms-prom                   node-exporter-gp95p                                         20m (0%)      1020m (26%)  160Mi (1%)       1152Mi (7%)    6d21h
  csdr                        csdr-velero-77c8bbc9c7-w46lq                                500m (12%)    1 (25%)      128Mi (0%)       2Gi (13%)      6d19h
  kube-system                 ack-cost-exporter-5b647ffc65-zdrsl                          100m (2%)     1 (25%)      200Mi (1%)       1Gi (6%)       6d21h
  kube-system                 ack-node-local-dns-admission-controller-5dfd74f5f4-9rl6n    100m (2%)     1 (25%)      100Mi (0%)       1Gi (6%)       6d21h
  kube-system                 ack-node-problem-detector-daemonset-6wql2                   200m (5%)     1200m (30%)  300Mi (2%)       1324Mi (9%)    6d21h
  kube-system                 coredns-7784559f6-dr9sn                                     100m (2%)     0 (0%)       100Mi (0%)       2Gi (13%)      6d21h
  kube-system                 csi-plugin-knz7j                                            130m (3%)     2 (51%)      176Mi (1%)       4Gi (27%)      6d21h
  kube-system                 kube-proxy-worker-rkbzv                                     100m (2%)     0 (0%)       100Mi (0%)       0 (0%)         6d21h
  kube-system                 loongcollector-ds-kw7cj                                     100m (2%)     2 (51%)      256Mi (1%)       2Gi (13%)      6d21h
  kube-system                 node-local-dns-pgzcn                                        25m (0%)      0 (0%)       30Mi (0%)        1Gi (6%)       6d21h
  kube-system                 terway-eniip-lnn8n                                          350m (8%)     1100m (28%)  200Mi (1%)       256Mi (1%)     6d21h
Ajuste a configuração de
requestscom base no consumo real de recursos.
Desconexões intermitentes de rede de pods para bancos de dados
Se um pod se desconectar intermitentemente de um banco de dados, siga estas etapas.
1. Verificar pod
Verifique os eventos do pod em busca de sinais de instabilidade de conexão, como problemas de rede, reinicializações ou recursos insuficientes.
Verifique os logs do pod em busca de mensagens de erro relacionadas à conexão com o banco de dados, como timeouts, falhas de autenticação ou gatilhos de reconexão.
Monitore o uso de CPU e memória do pod para garantir que a exaustão de recursos não cause falha na aplicação ou no driver do banco de dados.
Revise os
requestselimitsde recursos do pod para garantir que ele tenha CPU e memória suficientes.
2. Verificar nó
Verifique se há escassez de recursos (memória, disco) no nó. Consulte Monitor nodes.
Teste se há interrupções intermitentes de rede entre o nó e o banco de dados alvo.
3. Verificar banco de dados
Verifique o status e as métricas de desempenho do banco de dados em busca de reinicializações ou gargalos de desempenho.
Revise o número de conexões anômalas e as configurações de tempo limite de conexão, ajustando-as com base nos requisitos da sua aplicação.
Inspecione os logs do banco de dados em busca de registros relacionados a desconexões.
4. Verificar status dos componentes do cluster
Componentes do cluster com falha podem interromper a comunicação de rede de um pod.
kubectl get pod -n kube-system # Check the status of component pods.Além disso, verifique os seguintes componentes de rede:
CoreDNS: Verifique o status e os logs do componente para garantir que o pod possa resolver corretamente o endereço do service do banco de dados.
Flannel: Verifique o status e os logs do componente kube-flannel.
Terway: Verifique o status e os logs do componente terway-eniip.
5. Analisar tráfego de rede
Use tcpdump para capturar pacotes e analisar o tráfego de rede para ajudar a identificar a causa do problema.
-
Obtenha informações do Pod e do nó:
Liste pods e seus nós em um namespace específico:
kubectl get pod -n [namespace] -o wide -
Acesse o nó alvo e execute os seguintes comandos para encontrar o PID do contêiner.
Containerd
-
Visualize o
CONTAINERdo contêiner.crictl ps |grep <Pod name keyword>Saída esperada:
CONTAINER IMAGE CREATED STATE a1a214d2***** 35d28df4***** 2 days ago Running -
Visualize o PID do contêiner usando o
CONTAINER ID.crictl inspect a1a214d2***** |grep -i PIDSaída esperada:
    "pid": 2309838,    # The PID of the target container.
            "pid": 1
            "type": "pid"
Docker
-
Visualize o
CONTAINER IDdo contêiner.docker ps |grep <pod name keyword>Saída esperada:
CONTAINER ID IMAGE COMMAND a1a214d2***** 35d28df4***** "/nginx -
Visualize o PID do contêiner usando o
CONTAINER ID.docker inspect a1a214d2***** |grep -i PIDSaída esperada:
            "Pid": 2309838,  # The PID of the target container.
            "PidMode": "",
            "PidsLimit": null,
-
-
Capture pacotes.
Capture pacotes de rede entre o pod e o banco de dados alvo usando o PID do contêiner.
nsenter -t <container PID> tcpdump -i any -n -s 0 tcp and host <database IP address>Capture pacotes de rede entre o pod e o host usando o PID do contêiner.
nsenter -t <container PID> tcpdump -i any -n -s 0 tcp and host <node IP address>Capture pacotes de rede entre o host e o banco de dados.
tcpdump -i any -n -s 0 tcp and host <database IP address>
6. Otimizar aplicação
Implemente um mecanismo de reconexão automática na sua aplicação para garantir que ela possa restaurar conexões automaticamente durante um switchover ou migração de banco de dados.
Use conexões persistentes em vez de conexões de curta duração para se comunicar com o banco de dados. Conexões persistentes podem reduzir significativamente a sobrecarga de desempenho e o consumo de recursos, melhorando a eficiência geral do sistema.
Solução de problemas via console
Acesse o ACK console e acesse a página de detalhes do seu cluster para solucionar problemas de Pod.
Ações | Console |
Verificar o status de um Pod |
|
Verificar as informações básicas de um Pod |
|
Verificar a configuração de um Pod |
|
Verificar os eventos de um Pod |
|
Visualizar os logs de um Pod |
Nota O ACK integra-se ao Simple Log Service (SLS) para coleta de logs de contêineres. Consulte Collect container logs from an ACK cluster. |
Verificar os dados de monitoramento de um Pod |
Nota O ACK integra-se ao Managed Service for Prometheus para monitoramento em tempo real de clusters e contêineres. Consulte Configure Managed Service for Prometheus. |
Usar um terminal para acessar um contêiner e visualizar arquivos locais |
|
Executar diagnóstico de Pod |
Nota Container Intelligent Service fornece diagnósticos com um clique. Consulte Use cluster diagnostics. |
Exclusão inesperada de Pod
O kube-controller-manager (KCM) realiza coleta de lixo de pods no status Completed quando sua contagem excede o limiar padrão de 12.500. O parâmetro --terminated-pod-gc-threshold configura esse limiar. Consulte a documentação de parâmetros do KCM.
Recomendação: Limpe periodicamente pods Completed para evitar que afetem a eficiência do controlador.