Este tópico descreve o procedimento de diagnóstico para nós e como solucionar exceções neles. Também fornece respostas para algumas perguntas frequentes (FAQ) sobre nós.
Sumário
Categoria | Conteúdo |
Procedimento de diagnóstico | |
Métodos comuns de solução de problemas | |
Problemas comuns e soluções |
|
Procedimento de diagnóstico

-
Verifique se um nó está anormal. Para mais informações, consulte a seção Verificar status do nó deste tópico.
-
Se um nó estiver no estado NotReady, execute as etapas a seguir para solucionar o problema:
Verifique se os valores das seguintes condições do nó são True: PIDPressure, DiskPressure e MemoryPressure. Se alguma dessas condições for True, solucione o problema com base na palavra-chave da condição. Para mais informações, consulte as seções Exceções do dockerd - RuntimeOffline, Recursos de memória insuficientes - MemoryPressure ou Inodes insuficientes - InodesPressure deste tópico.
-
Verifique os componentes principais e os logs dos nós.
-
kubelet
Verifique o status, os logs e as configurações do kubelet. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no kubelet, solucione-a. Para mais informações, consulte a seção Exceções do kubelet deste tópico.
-
dockerd
Verifique o status, os logs e as configurações do dockerd. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no dockerd, solucione-a. Para mais informações, consulte a seção Exceções do dockerd - RuntimeOffline deste tópico.
-
containerd
Verifique o status, os logs e as configurações do containerd. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no containerd, solucione-a. Para mais informações, consulte a seção Exceções do containerd - RuntimeOffline deste tópico.
-
NTP
Verifique o status, os logs e as configurações do serviço Network Time Protocol (NTP). Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no serviço NTP, solucione-a. Para mais informações, consulte a seção Exceções de NTP - NTPProblem deste tópico.
-
Colete e verifique o log de diagnóstico do nó. Para mais informações, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
Verifique os dados de monitoramento do nó, incluindo o uso de CPU, memória e recursos de rede. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico. Se o uso de recursos estiver anormal, solucione a exceção. Para mais informações, consulte as seções Recursos de CPU insuficientes ou Recursos de memória insuficientes - MemoryPressure deste tópico.
-
Se o nó estiver no estado Unknown, execute as etapas a seguir para solucionar o problema:
Verifique se a instância do Elastic Compute Service (ECS) que hospeda o nó está no estado Running.
-
Verifique os componentes principais do nó.
-
kubelet
Verifique o status, os logs e as configurações do kubelet. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no kubelet, solucione-a. Para mais informações, consulte a seção Exceções do kubelet deste tópico.
-
dockerd
Verifique o status, os logs e as configurações do dockerd. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no dockerd, solucione-a. Para mais informações, consulte a seção Exceções do dockerd - RuntimeOffline deste tópico.
-
containerd
Verifique o status, os logs e as configurações do containerd. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no containerd, solucione-a. Para mais informações, consulte a seção Exceções do containerd - RuntimeOffline deste tópico.
-
NTP
Verifique o status, os logs e as configurações do serviço NTP. Para mais informações, consulte a seção Verificar componentes principais dos nós deste tópico.
Caso ocorra uma exceção no serviço NTP, solucione-a. Para mais informações, consulte a seção Exceções de NTP - NTPProblem deste tópico.
-
Verifique a conectividade de rede do nó. Para mais informações, consulte a seção Verificar grupos de segurança dos nós deste tópico. Se ocorrer uma exceção de rede, solucione-a. Para mais informações, consulte a seção Exceções de rede deste tópico.
Colete e verifique o log de diagnóstico do nó. Para mais informações, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
Verifique os dados de monitoramento do nó, incluindo o uso de CPU, memória e recursos de rede. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico. Se o uso de recursos estiver anormal, solucione a exceção. Para mais informações, consulte as seções Recursos de CPU insuficientes ou Recursos de memória insuficientes - MemoryPressure deste tópico.
-
Se o problema persistir após executar as operações anteriores, use o recurso de diagnóstico fornecido pelo Container Service for Kubernetes (ACK) para solucioná-lo. Para mais informações, consulte a seção Usar o recurso de diagnóstico de nó deste tópico.
Métodos comuns de solução de problemas
Usar o recurso de diagnóstico de nó
Quando ocorrer uma exceção em um nó, utilize o recurso de diagnóstico fornecido pelo ACK para solucioná-la.
Faça login no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
Na página Nodes, localize o nó desejado e escolha na coluna Actions.
No painel exibido, clique em Create diagnosis e visualize os resultados do diagnóstico e as sugestões de correção correspondentes na página do console.
Verificar detalhes do nó
Faça login no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
Na página Nodes, localize o nó que deseja verificar e clique no nome dele ou em Details na coluna Actions.
Verificar status do nó
Faça login no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
-
Na página Nodes, visualize o status de cada nó.
Se um nó estiver no estado Ready, ele está funcionando conforme o esperado.
-
Caso o nó não esteja no estado Ready, clique no nome dele ou em Details na coluna Actions do nó para visualizar seus detalhes.
NotaPara coletar informações sobre condições do nó como InodesPressure, DockerOffline e RuntimeOffline, é necessário instalar o node-problem-detector no cluster e criar um centro de eventos. O recurso de centro de eventos é ativado automaticamente durante a criação do cluster. Para mais informações, consulte Criar e usar o K8s Event Center.
Verificar eventos do nó
Faça login no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
-
Na página Nodes, localize o nó desejado e clique no nome dele ou em Details na coluna Actions.
Na parte inferior da página de detalhes do nó, é possível visualizar os eventos relacionados a ele.
Coletar logs de diagnóstico dos nós
Utilize o recurso de diagnóstico de nó fornecido pelo Container Intelligence Service no console para coletar logs de diagnóstico. Para mais informações, consulte Diagnóstico de nó.
Use um script para coletar logs de diagnóstico. Para mais informações, consulte a seção Coletar informações de diagnóstico do tópico "FAQ sobre gerenciamento de cluster".
Verificar componentes principais dos nós
-
kubelet:
-
Verificar o status do kubelet
Acesse o nó onde o kubelet está em execução e execute o comando a seguir para consultar o status do processo kubelet:
systemctl status kubeletSaída esperada:

-
Verificar os logs do kubelet
Acesse o nó onde o kubelet está em execução e execute o comando a seguir para imprimir os logs do kubelet. Para mais informações sobre como verificar os logs do kubelet, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
journalctl -u kubelet -
Verificar as configurações do kubelet
Acesse o nó onde o kubelet está em execução e execute o comando a seguir para verificar as configurações do kubelet:
cat /etc/systemd/system/kubelet.service.d/10-kubeadm.conf
-
-
Runtime:
-
Verificar o dockerd
-
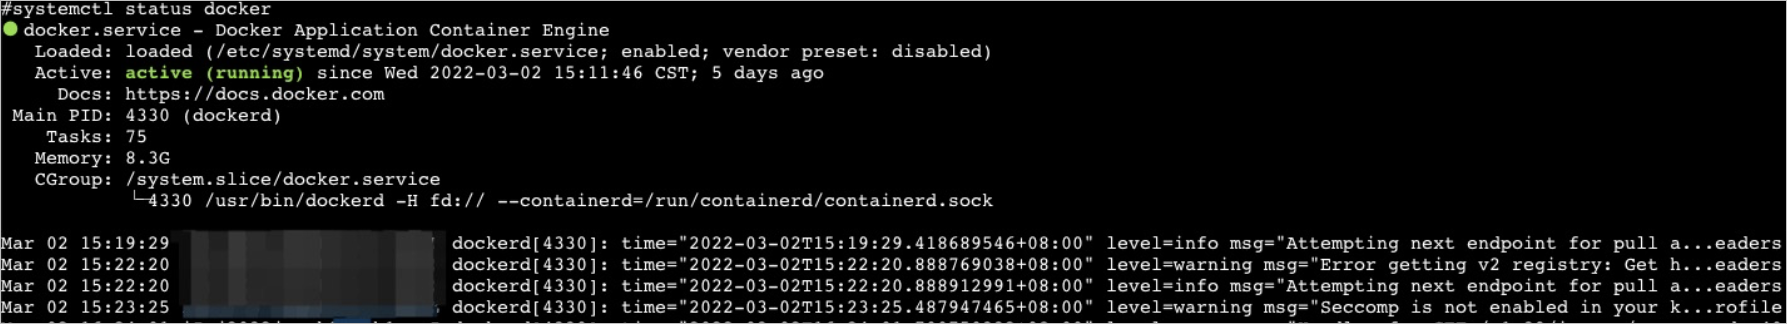
Verificar o status do dockerd
Acesse o nó onde o dockerd está em execução e execute o comando a seguir para consultar o status do processo dockerd:
systemctl status dockerSaída esperada:
-
Verificar os logs do dockerd
Acesse o nó onde o dockerd está em execução e execute o comando a seguir para imprimir os logs do dockerd. Para mais informações sobre como verificar os logs do dockerd, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
journalctl -u docker -
Verificar as configurações do dockerd
Acesse o nó onde o dockerd está em execução e execute o comando a seguir para consultar as configurações do dockerd:
cat /etc/docker/daemon.json
-
-
Verificar o containerd
-
Verificar o status do containerd
Acesse o nó onde o containerd está em execução e execute o comando a seguir para consultar o status do processo containerd:
systemctl status containerdSaída esperada:

-
Verificar os logs do containerd
Acesse o nó onde o containerd está em execução e execute o comando a seguir para imprimir os logs do containerd. Para mais informações sobre como verificar os logs do containerd, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
journalctl -u containerd
-
-
-
NTP:
-
Verificar o status do serviço NTP
Acesse o nó onde o serviço NTP está em execução e execute o comando a seguir para consultar o status do processo chronyd:
systemctl status chronydSaída esperada:

-
Verificar os logs do serviço NTP
Acesse o nó onde o serviço NTP está em execução e execute o comando a seguir para imprimir os logs do serviço NTP:
journalctl -u chronyd
-
Verificar dados de monitoramento dos nós
-
CloudMonitor
O ACK é integrado ao CloudMonitor. Faça login no console do CloudMonitor para visualizar os dados de monitoramento das instâncias ECS implantadas no seu cluster ACK. Para mais informações sobre como monitorar nós, consulte Monitorar nós.
-
Managed Service for Prometheus
Faça login no console do ACK. No painel de navegação à esquerda, clique em Clusters.
Na página Clusters, clique no nome do seu cluster. No painel de navegação à esquerda, clique em .
Na página Prometheus Monitoring, clique na aba Node Monitoring e, em seguida, na aba Nodes.
Na aba Nodes, selecione um nó na lista suspensa para visualizar os dados de monitoramento dele, como recursos de CPU, memória e disco.
Verificar grupos de segurança dos nós
Para mais informações, consulte Visão geral e Configurar grupos de segurança do cluster.
Exceções do kubelet
Causa
Exceções do kubelet geralmente são causadas por problemas no próprio processo kubelet, no runtime de contêiner ou por configurações inválidas do kubelet.
Problema
O status do kubelet é inactive.
Solução
-
Execute o comando a seguir para reiniciar o kubelet. A operação de reinicialização não afeta os contêineres em execução.
systemctl restart kubelet -
Após a reinicialização do kubelet, acesse o nó onde ele está em execução e execute o comando a seguir para verificar se o status do kubelet está normal:
systemctl status kubelet -
Se o status do kubelet estiver anormal, execute o comando a seguir no nó para imprimir os logs do kubelet:
journalctl -u kubeletSe encontrar uma exceção nos logs do kubelet, solucione-a com base na palavra-chave identificada.
-
Se a configuração do kubelet for inválida, execute o comando a seguir para modificá-la:
vi /etc/systemd/system/kubelet.service.d/10-kubeadm.conf   #Modify the configurations of kubelet.
systemctl daemon-reload;systemctl restart kubelet         #Reload the configurations and restart kubelet.
Exceções do dockerd - RuntimeOffline
Causa
Na maioria dos casos, uma exceção do dockerd ocorre porque a configuração do dockerd é inválida, o processo dockerd está sobrecarregado ou o nó está sobrecarregado.
Problemas
O status do dockerd é inactive.
O status do dockerd é active (running), mas o dockerd não funciona conforme o esperado, resultando em uma exceção no nó. Nesse cenário, pode haver falha ao executar o comando
docker psoudocker exec.O valor da condição do nó RuntimeOffline é True.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando ocorrer uma exceção no nó onde o dockerd está em execução. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Execute o comando a seguir para reiniciar o dockerd:
systemctl restart docker -
Após a reinicialização do dockerd, acesse o nó e execute o comando a seguir para verificar se o status do dockerd está normal:
systemctl status docker -
Se o status do dockerd estiver anormal, execute o comando a seguir no nó para imprimir os logs do dockerd:
journalctl -u docker
Exceções do containerd - RuntimeOffline
Causa
Na maioria dos casos, uma exceção do containerd ocorre porque a configuração do containerd é inválida, o processo containerd está sobrecarregado ou o nó está sobrecarregado.
O status do containerd é inactive.
O valor da condição do nó RuntimeOffline é True.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando ocorrer uma exceção no nó onde o containerd está em execução. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Execute o comando a seguir para reiniciar o containerd:
systemctl restart containerd -
Após a reinicialização do containerd, acesse o nó e execute o comando a seguir para verificar se o status do containerd está normal:
systemctl status containerd -
Se o status do containerd estiver anormal, execute o comando a seguir no nó para imprimir os logs do containerd:
journalctl -u containerd
Exceções de NTP - NTPProblem
Causa
Na maioria dos casos, uma exceção de NTP ocorre porque o status do processo NTP está anormal.
Problemas
O status do chronyd é inactive.
O valor da condição do nó NTPProblem é True.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando ocorrer uma exceção no nó onde o serviço NTP está em execução. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Execute o comando a seguir para reiniciar o chronyd:
systemctl restart chronyd -
Após a reinicialização do chronyd, acesse o nó e execute o comando a seguir para verificar se o status do chronyd está normal:
systemctl status chronyd -
Se o status do chronyd estiver anormal, execute o comando a seguir no nó para imprimir os logs do chronyd:
journalctl -u chronyd
Exceções de PLEG - PLEG is not healthy
Causa
O Pod Lifecycle Event Generator (PLEG) registra todos os eventos que ocorrem durante o ciclo de vida dos pods, como eventos relacionados à inicialização ou encerramento de contêineres. Na maioria dos casos, a exceção PLEG is not healthy ocorre porque o runtime de contêiner no nó está anormal ou o nó utiliza uma versão antiga do systemd.
Problemas
O status do nó é NotReady.
-
Os logs do kubelet contêm o seguinte conteúdo:
I0729 11:20:59.245243 9575 kubelet.go:1823] skipping pod synchronization - PLEG is not healthy: pleg was last seen active 3m57.138893648s ago; threshold is 3m0s. Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando ocorrer uma exceção de PLEG. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Reinicie os seguintes componentes principais no nó, nesta ordem: dockerd/containerd e kubelet. Em seguida, verifique se o status do nó voltou ao normal.
-
Se o nó não se recuperar após a reinicialização dos componentes principais, tente reiniciar toda a instância do nó. Para mais informações, consulte Reiniciar uma instância.
AvisoA operação de reinicialização também reinicia os pods no nó. Prossiga com cautela.
Se o nó anormal estiver executando CentOS 7.6, solucione a exceção consultando What Can I Do if the Logs of the kubelet Contain the "Reason:KubeletNotReady Message:PLEG is not healthy:" error When CentOS 7.6 Is Used.
Recursos insuficientes no nó para agendamento
Causa
Esse problema geralmente ocorre quando os nós do cluster não possuem recursos suficientes para atender às demandas de agendamento de novos pods.
Problemas
Se os recursos fornecidos pelos nós do seu cluster forem insuficientes, o agendamento de pods falhará e um dos seguintes erros será retornado:
Recursos de CPU insuficientes: 0/2 nodes are available: 2 Insufficient cpu
Recursos de memória insuficientes: 0/2 nodes are available: 2 Insufficient memory
Recursos de armazenamento temporário insuficientes: 0/2 nodes are available: 2 Insufficient ephemeral-storage
O agendador determina se os recursos fornecidos por um nó são insuficientes com base nas seguintes regras:
CPU insuficiente: CPU solicitada pelo Pod > (CPU alocável do Nó - CPU já alocada do Nó)
Memória insuficiente: Memória solicitada pelo Pod > (Memória alocável do Nó - Memória já alocada do Nó)
Armazenamento efêmero insuficiente: Armazenamento efêmero solicitado pelo Pod > (Armazenamento efêmero alocável do Nó - Armazenamento efêmero já alocado do Nó)
Se a quantidade de recursos solicitada por um pod for maior que a diferença entre o total de recursos alocáveis fornecidos por um nó e a quantidade de recursos já alocados nesse nó, o pod não será agendado para esse nó.
Execute o comando a seguir para consultar informações sobre a alocação de recursos no nó:
kubectl describe node [$nodeName]Saída esperada:
Allocatable:
  cpu:                3900m
  ephemeral-storage:  114022843818
  hugepages-1Gi:      0
  hugepages-2Mi:      0
  memory:             12601Mi
  pods:               60
Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests    Limits
  --------           --------    ------
  cpu                725m (18%)  6600m (169%)
  memory             977Mi (7%)  16640Mi (132%)
  ephemeral-storage  0 (0%)      0 (0%)
  hugepages-1Gi      0 (0%)      0 (0%)
  hugepages-2Mi      0 (0%)      0 (0%)
Parâmetros:
Allocatable: a quantidade de recursos de CPU, memória ou armazenamento temporário alocáveis fornecidos pelo nó.
Allocated resources: a quantidade de recursos de CPU, memória ou armazenamento temporário alocados do nó.
Solução
Se os recursos fornecidos pelos nós forem insuficientes, utilize um dos métodos a seguir para reduzir a carga dos nós:
Exclua os pods que não são mais necessários. Para mais informações, consulte Gerenciar pods.
-
Modifique as configurações de recursos dos pods conforme suas necessidades de negócio. Para mais informações, consulte a seção Definir solicitações e limites de CPU e memória do tópico "Gerenciar pods".
O recurso de perfilamento de recursos pode fornecer recomendações de especificação de recursos para contêineres com base nos dados históricos de uso de recursos. Isso simplifica significativamente a configuração de solicitações e limites de recursos para contêineres. Para mais informações, consulte Perfilamento de recursos.
Adicione nós ao cluster. Para mais informações, consulte Criar e gerenciar pools de nós.
Atualize os nós do cluster. Para mais informações, consulte Atualizar ou rebaixar as configurações de um nó worker.
Para mais informações, consulte as seções Recursos de CPU insuficientes, Recursos de memória insuficientes - MemoryPressure e Espaço em disco insuficiente - DiskPressure deste tópico.
Recursos de CPU insuficientes
Causa
Na maioria dos casos, os recursos de CPU fornecidos por um nó tornam-se insuficientes porque os contêineres no nó ocuparam uma quantidade excessiva de recursos de CPU.
Problemas
Quando um nó não possui recursos de CPU suficientes, o status do nó pode tornar-se anormal.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o uso de CPU do nó atingir ou exceder 85%. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Verifique a curva de uso de CPU na aba Node Monitoring do console e identifique o momento em que houve pico de uso. Em seguida, verifique se os processos em execução no nó estão ocupando uma quantidade excessiva de recursos de CPU. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Para mais informações sobre como reduzir a carga do nó, consulte a seção Recursos insuficientes no nó para agendamento deste tópico.
-
Reinicie o nó. Para mais informações, consulte Reiniciar uma instância.
AvisoA operação de reinicialização também reinicia os pods no nó. Prossiga com cautela.
Recursos de memória insuficientes - MemoryPressure
Causa
Na maioria dos casos, os recursos de memória fornecidos por um nó tornam-se insuficientes porque os contêineres no nó ocuparam uma quantidade excessiva de recursos de memória.
Problemas
Se a quantidade de recursos de memória disponíveis no nó cair abaixo do limiar
memory.available, o valor da condição do nó MemoryPressure muda para True. Os contêineres são removidos do nó. Para mais informações sobre remoção de contêineres, consulte Node-pressure Eviction.-
Se o nó não tiver recursos de memória suficientes, ocorrerão os seguintes problemas:
O valor da condição do nó MemoryPressure muda para True.
-
Os contêineres são removidos do nó:
É possível encontrar a informação The node was low on resource: memory nos eventos dos contêineres removidos.
É possível encontrar a informação attempting to reclaim memory no evento do nó.
Pode ocorrer um erro de falta de memória (OOM). Quando isso acontece, é possível encontrar a informação System OOM no evento do nó.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o uso de memória do nó atingir ou exceder 85%. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Verifique a curva de uso de memória na aba Node Monitoring do console e identifique o momento em que houve pico de uso. Em seguida, verifique se há vazamentos de memória nos processos em execução no nó. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Para mais informações sobre como reduzir a carga do nó, consulte a seção Recursos insuficientes no nó para agendamento deste tópico.
-
Reinicie o nó. Para mais informações, consulte Reiniciar uma instância.
AvisoA operação de reinicialização também reinicia os pods no nó. Prossiga com cautela.
Inodes insuficientes - InodesPressure
Causa
Na maioria dos casos, os inodes fornecidos por um nó tornam-se insuficientes porque os contêineres no nó ocuparam um número excessivo de inodes.
Problemas
Se o número de inodes disponíveis no nó cair abaixo do limiar
inodesFree, o valor da condição do nó InodesPressure muda para True. Os contêineres são removidos do nó. Para mais informações sobre remoção de contêineres, consulte Node-pressure Eviction.-
Se os inodes fornecidos por um nó tornarem-se insuficientes, ocorrerão os seguintes problemas:
O valor da condição do nó InodesPressure muda para True.
-
Os contêineres são removidos do nó:
É possível encontrar a informação The node was low on resource: inodes nos eventos dos contêineres removidos.
É possível encontrar a informação attempting to reclaim inodes no evento do nó.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o nó não tiver inodes suficientes. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Verifique a curva de uso de inodes na aba Node Monitoring do console e identifique o momento em que houve pico de uso. Em seguida, verifique se os processos em execução no nó estão ocupando um número excessivo de inodes. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Para mais informações sobre como solucionar outros problemas, consulte Resolver problemas de espaço em disco cheio em instâncias Linux.
PIDs insuficientes - NodePIDPressure
Causa
Na maioria dos casos, os IDs de processo (PIDs) fornecidos por um nó tornam-se insuficientes porque os contêineres no nó ocuparam um número excessivo de PIDs.
Problemas
Se o número de PIDs disponíveis no nó cair abaixo do limiar
pid.available, o valor da condição do nó NodePIDPressure muda para True. Os contêineres são removidos do nó. Para mais informações sobre remoção de contêineres, consulte Node-pressure Eviction.Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o nó não tiver PIDs suficientes. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Execute os comandos a seguir para consultar o número máximo de PIDs e o maior valor de PID no nó.
sysctl kernel.pid_max #Query the maximum number of PIDs. ps -eLf|awk '{print $2}' | sort -rn| head -n 1 #Query the greatest PID value. -
Execute o comando a seguir para consultar os cinco processos que ocuparam o maior número de PIDs:
ps -elT | awk '{print $4}' | sort | uniq -c | sort -k1 -g | tail -5Saída esperada:
#The first column displays the numbers of PIDs that are occupied by the processes. The second column displays the IDs of the processes.
73 9743
75 9316
76 2812
77 5726
93 5691
Utilize os IDs de processo para localizar os processos e pods correspondentes, diagnosticar o problema e otimizar o código.
Reduza a carga do nó. Para mais informações, consulte a seção Recursos insuficientes no nó para agendamento deste tópico.
-
Reinicie o nó. Para mais informações, consulte Reiniciar uma instância.
AvisoA operação de reinicialização também reinicia os pods no nó. Prossiga com cautela.
Espaço em disco insuficiente - DiskPressure
Causa
Na maioria dos casos, o espaço em disco fornecido por um nó torna-se insuficiente porque os contêineres no nó ocuparam uma quantidade excessiva de espaço em disco ou o tamanho da imagem do contêiner é excessivamente grande.
Problemas
Se a quantidade de espaço em disco disponível no nó cair abaixo do limiar
imagefs.available, o valor da condição do nó DiskPressure muda para True.Se a quantidade de espaço em disco disponível cair abaixo do limiar
nodefs.available, todos os contêineres no nó serão removidos. Para mais informações sobre remoção de contêineres, consulte Node-pressure Eviction.-
Se o espaço em disco de um nó tornar-se insuficiente, ocorrerão os seguintes problemas:
O valor da condição do nó DiskPressure muda para True.
Se a quantidade de espaço em disco disponível permanecer abaixo do limiar de integridade após a política de recuperação de imagens ser acionada, é possível encontrar a informação failed to garbage collect required amount of images no evento do nó. O valor padrão do limiar de integridade é 80%.
-
Os contêineres são removidos do nó:
É possível encontrar a informação The node was low on resource: [DiskPressure] nos eventos dos contêineres removidos.
É possível encontrar a informação attempting to reclaim ephemeral-storage ou attempting to reclaim nodefs no evento do nó.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o uso de disco do nó atingir ou exceder 85%. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Verifique a curva de uso de disco na aba Node Monitoring do console e identifique o momento em que houve pico de uso. Em seguida, verifique se os processos em execução no nó estão ocupando uma quantidade excessiva de espaço em disco. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Se muitos arquivos estiverem ocupando espaço em disco, exclua os arquivos que não são mais necessários. Para mais informações, consulte Resolver problemas de espaço em disco cheio em instâncias Linux.
Limite o
temporary storagealocado aos pods no nó. Para mais informações, consulte a seção Definir solicitações e limites de CPU e memória do tópico "Gerenciar pods".Recomenda-se utilizar os serviços de armazenamento fornecidos pela Alibaba Cloud e evitar o uso de volumes hostPath. Para mais informações, consulte Armazenamento.
Redimensione o disco do nó.
Reduza a carga do nó. Para mais informações, consulte a seção Recursos insuficientes no nó para agendamento deste tópico.
Endereços IP insuficientes - InvalidVSwitchId.IpNotEnough
Causa
Na maioria dos casos, os endereços IP fornecidos por um nó tornam-se insuficientes porque os contêineres no nó ocuparam um número excessivo de endereços IP.
Problemas
-
Falha ao iniciar pods. O status desses pods é ContainerCreating. É possível encontrar a informação InvalidVSwitchId.IpNotEnough nos logs dos pods. Para mais informações sobre como verificar os logs de um pod, consulte a seção Solução de problemas de pod do tópico "Solução de problemas de pod".
time="2020-03-17T07:03:40Z" level=warning msg="Assign private ip address failed: Aliyun API Error: RequestId: 2095E971-E473-4BA0-853F-0C41CF52651D Status Code: 403 Code: InvalidVSwitchId.IpNotEnough Message: The specified VSwitch \"vsw-AAA\" has not enough IpAddress., retrying" Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o nó não conseguir fornecer endereços IP suficientes. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
Reduza o número de contêineres no nó. Para mais informações, consulte a seção Recursos insuficientes no nó para agendamento deste tópico. Para mais informações sobre outras operações relevantes, consulte What Can I Do if Insufficient IP Addresses are Provided by a vSwitch in a Cluster that Uses Terway? e I added a new vSwitch to my Terway configuration, but my Pods are still failing to get an IP. Why is this happening?
Exceções de rede
Causa
Na maioria dos casos, uma exceção de rede ocorre porque o status do nó está anormal, as configurações dos grupos de segurança do nó são inválidas ou a rede está sobrecarregada.
Problemas
Falha ao fazer login no nó.
O status do nó é Unknown.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o uso da largura de banda de saída para a Internet do nó atingir ou exceder 85%. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Se houver falha ao fazer login no nó, execute as etapas a seguir para solucionar o problema:
Verifique se o nó está no estado Running.
Verifique as configurações dos grupos de segurança do nó. Para mais informações, consulte a seção Verificar grupos de segurança dos nós deste tópico.
-
Se a rede do nó estiver sobrecarregada, execute as etapas a seguir para solucionar o problema:
Verifique a curva de desempenho de rede do nó na aba Node Monitoring do console e procure por picos no uso da largura de banda. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Utilize políticas de rede para limitar o tráfego dos pods. Para mais informações, consulte Usar políticas de rede em clusters ACK.
Reinicializações inesperadas de nó
Causa
Na maioria dos casos, um nó é reiniciado inesperadamente porque está sobrecarregado.
Problemas
Durante o processo de reinicialização do nó, o status dele é NotReady.
Se o recurso de alertas para nós do cluster estiver ativado, você receberá alertas quando o nó for reiniciado inesperadamente. Para mais informações sobre como configurar regras de alerta, consulte Gerenciamento de alertas do ACK.
Solução
-
Execute o comando a seguir para consultar o momento em que o nó foi reiniciado:
last rebootSaída esperada:
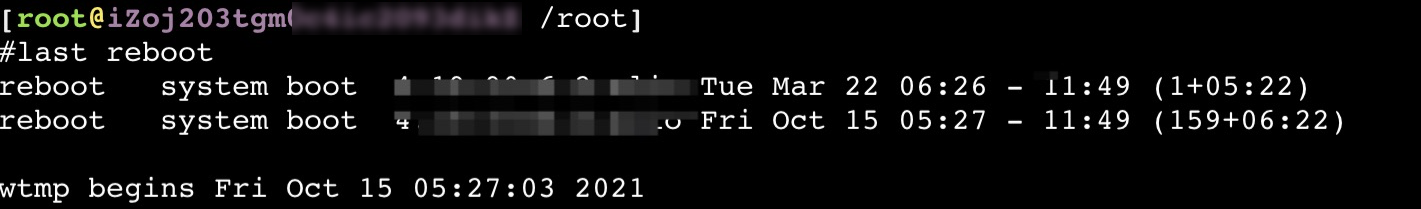
Verifique os dados de monitoramento do nó e solucione o uso anormal de recursos com base no momento em que o nó foi reiniciado. Para mais informações, consulte a seção Verificar dados de monitoramento dos nós deste tópico.
Verifique os logs do kernel do nó e solucione exceções com base no momento em que o nó foi reiniciado. Para mais informações, consulte a seção Coletar logs de diagnóstico dos nós deste tópico.
Como resolver o problema de alto I/O de disco causado pelo auditd ou a seguinte mensagem de erro aparece no log do sistema: audit: backlog limit exceeded?
Causa
Alguns nós existentes no cluster são configurados por padrão com regras de auditoria do auditd para Docker. Se os nós executarem Docker, o sistema gera logs de auditoria para Docker com base nas regras do auditd. Um grande volume de logs de auditoria pode ser gerado quando muitos contêineres reiniciam repetidamente ao mesmo tempo, quando uma grande quantidade de dados é gravada em um contêiner ou quando ocorrem bugs no kernel. Nesses casos, a utilização de I/O de disco do processo auditd pode ficar alta e a seguinte mensagem de erro pode aparecer no log do sistema: audit: backlog limit exceeded.
Problemas
Esse problema afeta apenas nós que executam Docker. Você pode observar os seguintes problemas no nó:
Após executar o comando iotop -o -d 1, os resultados indicam que o valor de
DISK WRITEpermanece em 1MB/s ou superior.Após executar o comando dmesg -d, os resultados incluem um log que contém a seguinte palavra-chave:
audit_printk_skb. Exemplo:audit_printk_skb: 100 callbacks suppressed.Após executar o comando dmesg -d, os resultados contêm a seguinte palavra-chave:
audit: backlog limit exceeded.
Solução
Execute as operações a seguir para verificar se o problema acima é causado pelas regras de auditoria do auditd:
Faça login no nó.
-
Execute o comando a seguir para consultar as regras do auditd:
sudo auditctl -l | grep -- ' -k docker'Se a saída a seguir for retornada, o problema acima é causado pelas regras de auditoria do auditd.
-w /var/lib/docker -k docker
Para resolver esse problema, utilize uma das soluções a seguir:
-
Atualizar o cluster
Atualize a versão do Kubernetes do cluster. Para mais informações, consulte Atualizar manualmente um cluster.
-
Alterar o runtime de contêiner para containerd
Se a versão do Kubernetes do cluster não puder ser atualizada, altere o runtime de contêiner para containerd para evitar esse problema. Execute as operações a seguir nos pools de nós que usam Docker como runtime de contêiner:
Crie novos pools de nós clonando os pools de nós que executam Docker. Os novos pools de nós usarão containerd como runtime de contêiner. Certifique-se de que as configurações dos novos pools de nós sejam idênticas às dos pools clonados, exceto pelo runtime de contêiner.
Drene os nós um por um dos pools de nós que executam Docker durante horários de baixa demanda até que todos os pods de aplicação sejam removidos desses pools.
-
Atualizar as configurações do auditd
Se as soluções anteriores não forem aplicáveis, atualize manualmente as configurações do auditd no nó para resolver esse problema. Execute as operações a seguir nos nós que usam Docker como runtime de contêiner:
Faça login no nó.
-
Execute o comando a seguir para excluir as regras do auditd para Docker:
sudo test -f /etc/audit/rules.d/audit.rules && sudo sed -i.bak '/ -k docker/d' /etc/audit/rules.d/audit.rules sudo test -f /etc/audit/audit.rules && sudo sed -i.bak '/ -k docker/d' /etc/audit/audit.rules -
Execute o comando a seguir para aplicar as novas regras do auditd:
if service auditd status |grep running || systemctl status auditd |grep running; then
    sudo service auditd restart || sudo systemctl restart auditd
    sudo service auditd status || sudo systemctl status auditd
fi