Identifique e resolva problemas em nós com verificações de diagnóstico e análise de causa raiz assistida por IA.
Ao executar o diagnóstico de nós, o ACK coleta a versão do sistema, o status de cargas de trabalho/docker/kubelet e os principais erros de logs do sistema de cada nó.
O diagnóstico de nós é composto por dois componentes:
Itens de diagnóstico: diagnosticam nós, componentes de nó, componentes de cluster, o gerenciador de controladores do Elastic Compute Service (ECS) e nós acelerados por GPU.
Causas raízes: localizam as causas raízes e sugerem correções ao coletar dados do cluster e dos nós, identificar anomalias e analisar detalhes.
Como funciona
O diagnóstico de nós baseia-se em um sistema de diagnóstico de falhas fundamentado na experiência de especialistas e em um modelo de diagnóstico de falhas por IA treinado com grandes volumes de dados. Ele combina os modos de diagnóstico baseados em experiência de especialistas e assistidos por IA para localizar causas raízes de forma aprofundada.
Os resultados do diagnóstico passam por quatro etapas:
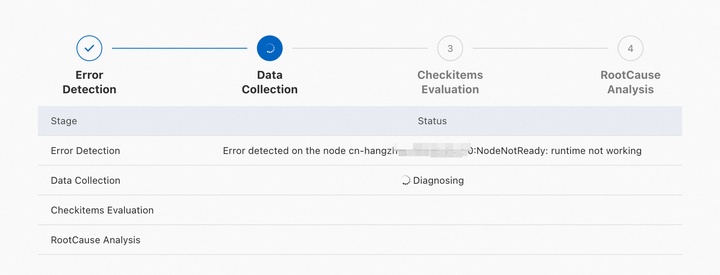
Anomaly identification: Coleta sinais básicos — status do nó, status do pod e fluxos de eventos do cluster — e identifica anomalias.
Data collection: Reúne dados específicos de contexto com base nas anomalias identificadas, incluindo informações de nós do Kubernetes, detalhes de instâncias ECS e status de processos docker/kubelet.
Diagnostic item check: Verifica se as métricas principais estão dentro das faixas normais. Os itens são agrupados por categoria, cada um com uma descrição.
Root cause analysis: Para alguns problemas, determina automaticamente a causa raiz com base nos dados coletados e nos resultados das verificações.
Resultados do diagnóstico
Os resultados dividem-se em dois tipos:
Root cause analysis results: incluem anomalias detectadas, a causa raiz identificada e sugestões de correção.
Diagnostic item check results: incluem resultados de verificação por item. Estes podem revelar causas que a análise de causa raiz não detectou.
Os itens de diagnóstico variam conforme a configuração do cluster e refletem sua configuração real.
Casos de uso
O diagnóstico de nós e o diagnóstico assistido por IA cobrem os seguintes cenários.
Categoria | Cenário |
Diagnóstico de nós | Node NotReady — rede não pronta, IDs de processo (PIDs) insuficientes, memória insuficiente, espaço em disco insuficiente, exceções de runtime ou ausência de heartbeat |
Inodes insuficientes | |
PIDs insuficientes | |
Hora do nó incorreta | |
Sistema de arquivos do nó somente leitura | |
Deadlocks no kernel do nó | |
Diagnóstico assistido por IA | Status anormal do nó |
Status anormal da instância ECS | |
Erros de kubelet nos nós | |
Exceções de runtime nos nós | |
Espaço em disco insuficiente | |
Alta utilização de CPU nos nós |
Itens de diagnóstico
|
Categoria |
O que é verificado |
|
Status do nó, status da rede, logs do kernel, processos principais e disponibilidade de services |
|
|
Status de componentes essenciais do nó, incluindo componentes de rede e armazenamento |
|
|
Disponibilidade do API Service, disponibilidade de DNS e status do gateway NAT |
|
|
Status da instância ECS, conexões de rede, integridade do sistema operacional e E/S de disco |
|
|
Status do módulo NVIDIA e configurações de runtime de contêineres em nós acelerados por GPU |
Nó
Se o problema persistir após aplicar a correção sugerida, colete os logs do nó e envie um ticket.
|
Item de diagnóstico |
O que é detectado |
Correção |
|
Erros de conectividade com o servidor de API do Kubernetes |
Se o nó consegue alcançar o servidor de API do cluster. |
Verifique a configuração do cluster. Consulte Solucionar problemas de clusters ACK. |
|
Travamentos de montagem AUFS |
Se há travamentos de montagem AUFS no nó. |
|
|
Erros BufferIOError |
Se há erros BufferIOError no kernel do nó. |
|
|
Vazamentos de cgroup |
Se há vazamentos de cgroup. |
Vazamentos de cgroup podem interromper a coleta de dados de monitoramento e causar falhas na inicialização de contêineres. Faça login no nó e exclua os diretórios cgroup afetados. |
|
Status anormal do processo chronyd |
Se o processo chronyd está em execução normal. Um processo chronyd anormal pode afetar a sincronização do relógio do sistema. |
Execute |
|
Pull de imagens pelo containerd |
Se o runtime containerd consegue baixar imagens conforme esperado. |
Verifique a configuração de rede do nó e as definições de imagem. |
|
Status do containerd |
Se o runtime containerd está em execução. |
|
|
Disponibilidade do pod CoreDNS |
Se o nó consegue alcançar o endereço IP do pod CoreDNS. |
Verifique se o nó acessa o endereço IP do pod CoreDNS. Consulte What do I do if the DNS query load is not balanced among CoreDNS pods?. |
|
Status das imagens |
Se as imagens estão íntegras. |
|
|
Status overlay2 das imagens |
Se o sistema de arquivos overlay2 nas imagens está corrompido. |
|
|
Hora do sistema |
Se o relógio do sistema está preciso. |
Nenhuma. |
|
Inicialização de contêineres docker |
Se há falhas na inicialização de contêineres docker. |
|
|
Pull de imagens docker |
Se o nó consegue baixar imagens docker conforme esperado. |
Verifique a configuração de rede do nó e as definições de imagem. |
|
Status do docker |
Se o runtime docker está em execução. |
|
|
Tempo de inicialização do docker |
O tempo de inicialização do Dockerd. |
Nenhuma. |
|
Erros de travamento do docker |
Se há erros de travamento do docker no nó. |
Execute |
|
Existência da instância ECS |
Se a instância ECS subjacente existe. |
Verifique o status da instância ECS. Consulte FAQ about nodes and node pools. |
|
Status da instância ECS |
Se a instância ECS está em estado saudável. |
Verifique o status da instância ECS. Consulte FAQ about nodes and node pools. |
|
Erros Ext4FsError |
Se há erros Ext4FsError no kernel do nó. |
|
|
Sistema de arquivos do nó somente leitura |
Se o sistema de arquivos do nó tornou-se somente leitura. Isso geralmente indica falha de disco e bloqueia todas as operações de escrita, afetando as cargas de trabalho. |
Execute |
|
Hora do hardware |
Se o relógio de hardware e o relógio do sistema estão sincronizados. Uma diferença superior a 2 minutos pode causar erros em componentes. |
Execute |
|
DNS do nó |
Se os nomes de domínio podem ser resolvidos no nó. |
Consulte DNS troubleshooting. |
|
Erros de oops do kernel |
Se há erros de oops no kernel do nó. |
|
|
Versões do kernel |
Se a versão do kernel está desatualizada. Kernels desatualizados podem apresentar problemas conhecidos de estabilidade. |
Atualize o kernel do nó. Consulte FAQ about nodes and node pools. |
|
Disponibilidade do DNS do cluster |
Se o nó consegue alcançar o ClusterIP do Service kube-dns para usar o service de DNS do cluster. |
Verifique o status e os logs dos pods CoreDNS. Consulte DNS troubleshooting. |
|
Status do kubelet |
Se o kubelet está em execução normal. |
Verifique os logs do kubelet. Consulte Solucionar problemas de clusters ACK. |
|
Tempo de inicialização do kubelet |
O tempo de inicialização do kubelet. |
Nenhuma. |
|
Utilização de CPU |
Se a utilização de CPU do nó está excessivamente alta. |
Nenhuma. |
|
Utilização de memória |
Se a utilização de memória do nó está excessivamente alta. |
Nenhuma. |
|
Fragmentação de memória |
Se existe fragmentação de memória no nó. |
Faça login no nó e execute |
|
Memória swap |
Se a memória swap está ativada. |
Faça login no nó e desative a memória swap. |
|
Carregamento de drivers de dispositivos de rede |
Se os drivers VirtIO nos dispositivos de rede foram carregados corretamente. |
|
|
Utilização de CPU excessivamente alta no nó |
Se a utilização de CPU esteve alta na última semana. Se muitos pods forem agendados em um nó com uso consistentemente alto de CPU, a contenção de recursos pode resultar em interrupções de service. |
Defina solicitações e limites de recursos adequadamente para evitar sobrecarga no nó. |
|
Existência de IP privado do nó |
Se o nó possui um endereço IP privado atribuído. |
Remova o nó do cluster e adicione-o novamente. Não libere a instância ECS ao removê-lo. Consulte Remove a node e Add existing ECS instances. |
|
Utilização de memória excessivamente alta no nó |
Se a utilização de memória esteve alta na última semana. Alta utilização de memória combinada com agendamento intenso de pods pode causar erros de falta de memória (OOM) e interrupções de service. |
Defina solicitações e limites de recursos adequadamente para evitar sobrecarga no nó. |
|
Status do nó |
Se o nó está no estado Ready. |
Reinicie o nó. Consulte FAQ about nodes and node pools. |
|
Agendabilidade do nó |
Se o nó está marcado como não agendável. |
Verifique a configuração de agendamento do nó. Consulte Node draining and scheduling status. |
|
Erros OOM |
Se há erros de falta de memória (OOM) no nó. |
|
|
Verificação de runtime |
Se o runtime de contêineres do nó corresponde ao runtime configurado no cluster. |
Consulte Can I change the container runtime of a cluster from containerd to docker?. |
|
Versões desatualizadas do SO |
Se a versão do SO do nó possui bugs conhecidos ou problemas de estabilidade. Versões desatualizadas do SO podem fazer com que os runtimes docker e containerd funcionem mal. |
Atualize a versão do SO. |
|
Acesso à internet |
Se o nó consegue acessar a internet. |
Verifique se o SNAT está ativado para o cluster. Consulte Enable an existing ACK cluster to access the internet. |
|
Erros RCUStallError |
Se há erros RCUStallError no kernel do nó. |
|
|
Versões do SO |
A versão do SO usada pelo nó. Versões desatualizadas do SO podem impedir o funcionamento normal do cluster. |
Nenhuma. |
|
Vazamentos de processos runc |
Se há vazamentos de processos runc. Vazamentos de processos runc podem fazer com que o nó entre periodicamente no estado NotReady. |
Identifique os processos runc vazados e encerre-os manualmente. |
|
Erros SoftLockupError |
Se há erros SoftLockupError no kernel do nó. |
|
|
Travamentos do systemd |
Se há travamentos do systemd. |
Faça login no nó e execute |
|
Versões desatualizadas do systemd |
Se a versão do systemd possui bugs conhecidos. Versões desatualizadas podem causar mau funcionamento do docker e do containerd. |
Atualize a versão do systemd. Consulte systemd. |
|
Processos travados |
Se existem processos travados no nó. |
|
|
Erros unregister_netdevice |
Se há erros unregister_netdevice no kernel do nó. |
NodeComponent
|
Item de diagnóstico |
O que é detectado |
Correção |
|
Status do componente CNI |
Se o plugin Container Network Interface (CNI) está em execução conforme esperado. |
Verifique o status do componente de rede do cluster. Consulte FAQ about network management. |
|
Status do componente CSI |
Se o plugin Container Storage Interface (CSI) está em execução conforme esperado. |
Verifique o status do componente de armazenamento do cluster. Consulte FAQ about CSI. |
ClusterComponent
|
Item de diagnóstico |
O que é detectado |
Correção |
|
Versão do aliyun-acr-credential-helper |
Se a versão do componente aliyun-acr-credential-helper está desatualizada. |
Atualize o aliyun-acr-credential-helper. Consulte Use the aliyun-acr-credential-helper component to pull images without using a secret. |
|
Disponibilidade do API Service |
Se o API Service do cluster está disponível. |
Execute |
|
Blocos CIDR de pod disponíveis insuficientes |
Se restam menos de cinco blocos CIDR de pod em um cluster Flannel. Cada nó usa um bloco; quando eles se esgotam, novos nós não funcionam corretamente. |
|
|
Endpoints do CoreDNS |
O número de endpoints ativos do CoreDNS. |
Verifique o status e os logs dos pods CoreDNS. Consulte DNS troubleshooting. |
|
Endereços IP de cluster do CoreDNS |
Se o Service de DNS do cluster possui um ClusterIP atribuído. Sem ele, o DNS do cluster falha e as cargas de trabalho são afetadas. |
Verifique o status e os logs dos pods CoreDNS. Consulte DNS troubleshooting. |
|
Status do gateway NAT |
Se o gateway NAT do cluster está funcionando normalmente. |
Acesse o console do NAT Gateway e verifique se o gateway está bloqueado devido a pagamentos atrasados. |
|
Taxa excessivamente alta de quedas de conexões simultâneas no gateway NAT |
Se o gateway NAT está descartando uma taxa anormalmente alta de conexões simultâneas. |
Atualize o gateway NAT. Consulte FAQ sobre atualização de gateways NAT de Internet padrão para gateways NAT de Internet aprimorados. |
ECSControllerManager
Item de diagnóstico | O que é detectado | Correção |
Pagamentos atrasados relacionados a componentes da instância ECS | Se o disco ou a largura de banda de rede da instância está restrito devido a pagamentos atrasados. | Recarregue sua conta para restaurar o acesso. |
Pagamentos atrasados relacionados à instância ECS | Se a instância ECS com pagamento conforme o uso foi suspensa devido a pagamentos atrasados. | Recarregue sua conta e reinicie a instância. |
Status da NIC da instância ECS | Se a placa de interface de rede (NIC) da instância está funcionando normalmente. | Reinicie a instância. |
Status de inicialização da instância ECS | Se a instância pode ser iniciada normalmente. | Se a inicialização falhar, crie uma nova instância. |
Status do sistema de gerenciamento de backend da instância ECS | Se o sistema de gerenciamento de backend da instância está operando normalmente. | Reinicie a instância. |
Status das CPUs da instância ECS | Se há contenção de CPU ou falhas de vinculação de CPU na camada subjacente da instância. | A contenção de CPU pode impedir que a instância obtenha recursos de CPU. Reinicie a instância. |
Split locks nas CPUs da instância ECS | Se há split locks nas CPUs da instância ECS. | Há split locks nas CPUs da instância ECS. |
Status da mitigação de DDoS para a instância ECS | Se o endereço IP público da instância está sob ataque DDoS. | Adquira um service anti-DDoS. Consulte Comparison of Alibaba Cloud Anti-DDoS solutions. |
Capacidades de leitura/gravação limitadas do disco em nuvem | Se o throughput de leitura/gravação do disco em nuvem está sendo limitado. | Reduza a frequência de leitura/gravação do disco ou atualize para um tipo de disco em nuvem de maior desempenho. Para mais informações sobre as métricas de desempenho de leitura/gravação de discos em nuvem, consulte Block storage performance. |
Carregamento do disco da instância ECS | Se o disco em nuvem pode ser anexado quando a instância inicia. | Pare a instância e inicie-a novamente. |
Expiração da instância ECS | Se a instância por assinatura expirou. | Renove a instância. Consulte Renovar uma instância por assinatura. |
Falhas do SO da instância ECS | Se ocorreram falhas do SO nas últimas 48 horas. | Revise os logs do sistema para identificar a causa. Consulte View system logs and screenshots. |
Status do host da instância ECS | Se o servidor físico que hospeda a instância apresenta falhas. | Falhas no host podem degradar o desempenho da instância. Reinicie a instância. |
Carregamento da imagem da instância ECS | Se a instância consegue carregar sua imagem durante a inicialização. | Reinicie a instância. |
Travamentos de E/S no disco da instância ECS | Se há travamentos de E/S no disco do sistema. | Verifique as métricas do disco. Consulte View the monitoring data of a cloud disk. Para Alibaba Cloud Linux 2, consulte Detect I/O hangs of file systems and block layers. |
Limite superior de largura de banda da instância ECS | Se a largura de banda total da instância atingiu o máximo para seu tipo de instância. | Atualize para um tipo de instância com maior largura de banda. Consulte Overview of instance configuration changes. |
Limite superior da largura de banda burst da instância ECS | Se a largura de banda burst da instância excedeu o máximo permitido para seu tipo de instância. | Atualize para um tipo de instância com maior largura de banda. Consulte Overview of instance configuration changes. |
Carregamento da NIC da instância ECS | Se a NIC pode ser carregada na instância. | Se a NIC falhar ao carregar, a instância perde a conectividade de rede. Reinicie a instância. |
Estabelecimento de sessão da NIC na instância ECS | Se sessões podem ser estabelecidas para a NIC. | Se a NIC não conseguir estabelecer sessões ou atingir seu limite de sessões, a conectividade de rede ou o throughput será afetado. Reinicie a instância. |
Operações principais na instância ECS | Se operações recentes na instância — como iniciar, parar ou atualizar — foram concluídas com sucesso. | Tente novamente a operação que falhou. |
Perda de pacotes na NIC da instância ECS | Se há perda de pacotes de entrada ou saída na NIC. | Reinicie a instância. |
Degradação de desempenho da instância ECS | Se o desempenho da instância foi temporariamente degradado devido a problemas de software ou hardware. | Visualize os eventos históricos ou logs do sistema da instância para identificar a causa. Consulte View historical system events. |
Desempenho comprometido da instância ECS | Se o desempenho da instância está reduzido. | A instância ECS só consegue fornecer o desempenho básico devido a créditos de CPU disponíveis insuficientes. |
Redimensionamento de disco da instância ECS | Se o disco foi redimensionado, mas o SO ainda não expandiu o sistema de arquivos. | O SO falhou ao redimensionar o sistema de arquivos após o redimensionamento do disco, portanto o espaço adicionado está indisponível. Redimensione o disco novamente. |
Aplicação de recursos da instância ECS | Se há recursos físicos de CPU e memória suficientes disponíveis para a instância. | Recursos físicos insuficientes impedem a inicialização da instância. Aguarde alguns minutos e tente iniciar a instância novamente. Se o problema persistir, crie uma instância em outra região ou zona. |
Status do SO da instância ECS | Se ocorreram kernel panics, erros OOM ou falhas internas no SO da instância. | Essas falhas geralmente são causadas por configurações incorretas da instância ou programas do usuário. Reinicie a instância. |
Status de virtualização da instância ECS | Se há exceções na camada de virtualização subjacente. | Essas exceções podem fazer com que a instância pare de responder ou seja suspensa inesperadamente. Reinicie a instância. |
GPUNode
Item de diagnóstico | O que é detectado | Correção |
Runtime de contêineres | Se o runtime de contêineres no nó acelerado por GPU é válido. O ACK suporta apenas docker e containerd para nós acelerados por GPU. | Verifique o status do runtime docker ou containerd no nó. |
Versão do NVIDIA-Container-Runtime | Se a versão do NVIDIA-Container-Runtime é compatível com o cluster. |
|
Status do módulo cGPU | Se o módulo cGPU está em execução conforme esperado em nós com compartilhamento de GPU ativado. |
|
Configurações do runtime de contêineres | Se o runtime de contêineres no nó acelerado por GPU está configurado corretamente. Configurações incorretas impedem a execução de contêineres GPU. | Verifique se o campo |
Status do NVIDIA-Container-Runtime | Se o NVIDIA-Container-Runtime está em execução conforme esperado. | Colete dados de diagnóstico e envie um ticket. Consulte Collect diagnostic data from GPU-accelerated nodes. |
Status do módulo NVIDIA | Se o módulo de kernel NVIDIA está em execução conforme esperado no nó acelerado por GPU. Um módulo NVIDIA com falha impede a execução de todas as cargas de trabalho GPU. |
|