DaemonSet モードで LoongCollector をデプロイし、SLS コンソールで収集設定を作成することで、Kubernetes コンテナログの収集を一元化し、効率的なクエリと分析のために構造化処理を有効にします。
前提条件
ランタイム環境
Container Service for Kubernetes (ACK) (マネージド版および専用版) と自己管理型 Kubernetes クラスターをサポートします。
Mount propagation: HostToContainerをサポートする Kubernetes 1.10.0 以降。コンテナランタイム (Docker および Containerd のみ)
Docker:
docker.sock へのアクセスが必要です。
標準出力の収集は JSON ログドライバーのみをサポートします。
overlay および overlay2 ストレージドライバーのみをサポートします。他のタイプのストレージドライバーを使用するには、ログディレクトリを手動でマウントしてください。
Containerd:containerd.sock へのアクセスが必要です。
リソース要件: LoongCollector (Logtail) は system-cluster-critical 高優先度クラスで実行されます。リソースが限られたクラスターにデプロイすると、既存の Pod が退去させられる可能性があります。
CPU:少なくとも 0.1 コアを予約してください。
メモリ:収集コンポーネントに少なくとも 150 MB、コントローラーコンポーネントに少なくとも 100 MB を予約してください。
実際の使用量は、収集レート、監視対象のディレクトリとファイルの数、および送信の輻輳に依存します。リソース使用量を指定された制限の 80% 未満に保ってください。
権限要件: デプロイするには、Alibaba Cloud アカウントまたは RAM ユーザーに
AliyunLogFullAccess権限が必要です。詳細な権限を持つカスタムポリシーを作成するには、AliyunCSManagedLogRolePolicy システムポリシーから権限をコピーし、対象の RAM ユーザーまたはロールに付与します。
収集設定
LoongCollector のインストール: LoongCollector を DaemonSet モードでデプロイします。これにより、クラスター内の各ノードで収集コンテナが実行され、そのノード上のすべてのコンテナからログを収集します。
Sidecar パターンについては、「Kubernetes Pod からテキストログを収集する (Sidecar パターン)」をご参照ください。
Logstore の作成: Logstore は収集されたログを保存します。
グローバル設定と入力設定:収集設定の名前を定義し、ログ収集のソースと範囲を指定します。
ログの処理と構造化:ログのフォーマットに基づいて処理ルールを設定します。
複数行ログ:Java の例外スタックや Python のトレースバックなど、複数行にまたがるログエントリを、各エントリの開始を識別するための先頭行の正規表現を定義して処理します。
構造化解析:正規表現、デリミタ、NGINX モードなどの解析プラグインを設定して、生の文字列を構造化されたキーと値のペアに抽出し、効率的なクエリと分析を可能にします。
ログフィルタリング:収集ブラックリストとコンテンツフィルタリングルールを設定して、不要なログデータをフィルタリングします。これにより、冗長なデータ転送とストレージを削減できます。
ログの分類:ログトピックとタグを設定して、異なるサービス、コンテナ、またはパスソースからのログを区別します。
クエリと分析の設定:キーワード検索のためにフルテキストインデックスがデフォルトで有効になっています。構造化されたフィールドの正確なクエリと分析のためには、フィールドインデックスを有効にして検索効率を向上させます。
検証とトラブルシューティング:設定完了後、ログが正常に収集されていることを確認します。データ収集の失敗、ハートビートの失敗、解析エラーなどの問題が発生した場合は、「トラブルシューティング FAQ」をご参照ください。
ステップ 1:LoongCollector のインストール
LoongCollector は、Simple Log Service (SLS) による次世代のログ収集エージェントであり、Logtail の後継です。LoongCollector と Logtail は共存できません。Logtail をインストールするには、「Logtail のインストール、実行、アップグレード、アンインストール」をご参照ください。
以下のいずれかの方法で LoongCollector をインストールします。パラメーターの詳細については、「インストールと設定」をご参照ください。LoongCollector または Logtail が既にインストールされている場合は、「ステップ 2:Logstore の作成」に進んでください。
LoongCollector (Logtail) の実行中にホスト時刻を変更すると、重複収集やデータ損失が発生する可能性があります。
ACK クラスター
Container Service for Kubernetes (ACK) コンソールで LoongCollector をインストールします。デフォルトでは、ログは現在の Alibaba Cloud アカウント内の SLS プロジェクトに送信されます。
-
ACK コンソールにログインします。左側のナビゲーションウィンドウで、クラスターリスト をクリックします。
対象クラスターの名前をクリックします。
左側のナビゲーションウィンドウで、アドオン管理 をクリックします。
ログとモニタリング タブで LoongCollector を見つけ、インストール をクリックします。
説明クラスターを作成する際に、コンポーネント設定 ページで Log Service の使用 を選択できます。プロジェクトの作成 または プロジェクトの選択 を選択できます。既存のクラスターに LoongCollector をインストールする場合、インストールダイアログボックスでは
projectNameパラメーターを使用してプロジェクト名を指定できます。空のままにすると、デフォルト値のk8s-log-{cluster_id}が使用されます。インストールが完了すると、SLS は現在のアカウントに以下のリソースを自動的に作成します。これらは SLS コンソールで確認できます。
リソースタイプ
リソース名
説明
プロジェクト
k8s-log-${cluster_id}異なるサービスのログを分離します。
柔軟なログ管理のために、「プロジェクトの作成」をご参照ください。
マシングループ
k8s-group-${cluster_id}ログ収集ノードのコレクションです。Kubernetes ノードの IP アドレスはクラスターのスケールインまたはスケールアウトに伴い動的に変更されるため、IP アドレスでマシングループを識別するとハートビートの失敗を引き起こす可能性があります。そのため、Kubernetes シナリオのマシングループではカスタム識別子を使用します。詳細については、「収集設定とマシングループを関連付けるためのガイド」をご参照ください。
重要LoongCollector コンポーネントは config-operation-log という名前の Logstore を作成しません。この Logstore が既に存在する場合、LoongCollector はそこにログを書き込みません。
自己管理型クラスター
Kubernetes クラスターに接続し、ご利用のリージョンに適したコマンドを実行します:
中国リージョン
wget https://aliyun-observability-release-cn-shanghai.oss-cn-shanghai.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.sh中国以外のリージョン
wget https://aliyun-observability-release-ap-southeast-1.oss-ap-southeast-1.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.shloongcollector-custom-k8s-packageディレクトリに移動し、./loongcollector/values.yaml設定ファイルを変更します。# ===================== 必須情報 ===================== # このクラスターからのログが送信されるプロジェクトの名前。例:k8s-log-custom-sd89ehdq projectName: "" # プロジェクトが配置されているリージョン。例:cn-shanghai region: "" # プロジェクトを所有する Alibaba Cloud アカウントの UID。UID は引用符 ("") で囲んでください。例:"123456789" aliUid: "" # ネットワークタイプ。有効な値:Internet および Intranet。デフォルト値:Internet。 net: Internet # Alibaba Cloud アカウントまたは RAM ユーザーの AccessKey ID と AccessKey Secret。アカウントまたは RAM ユーザーには AliyunLogFullAccess システムポリシー権限が必要です。 accessKeyID: "" accessKeySecret: "" # カスタムクラスター ID。ID には、大文字、小文字、数字、ハイフン (-) のみを含めることができます。 clusterID: ""loongcollector-custom-k8s-packageディレクトリで、以下のコマンドを実行して LoongCollector とその依存関係をインストールします:bash k8s-custom-install.sh installインストールが完了したら、コンポーネントが実行されていることを確認します。
Pod の起動に失敗した場合は、values.yaml ファイルの設定を確認し、必要なイメージがプルされていることを確認してください。
# Pod のステータスを確認
kubectl get po -n kube-system | grep loongcollector-ds
SLS はまた、以下のリソースを自動的に作成します。これらは SLS コンソールで確認できます。
リソースタイプ
リソース名
説明
プロジェクト
values.yaml ファイルで指定した
projectNameの値異なるサービスのログを分離します。
柔軟なログ管理のために、「プロジェクトの作成」をご参照ください。
マシングループ
k8s-group-${cluster_id}ログ収集ノードのコレクションです。Kubernetes ノードの IP アドレスはクラスターのスケールインまたはスケールアウトに伴い動的に変更されるため、IP アドレスでマシングループを識別するとハートビートの失敗を引き起こす可能性があります。そのため、Kubernetes シナリオのマシングループではカスタム識別子を使用します。詳細については、「収集設定とマシングループを関連付けるためのガイド」をご参照ください。
重要LoongCollector コンポーネントは config-operation-log という名前の Logstore を作成しません。この Logstore が既に存在する場合、LoongCollector はそこにログを書き込みません。
ステップ 2:Logstore の作成
Logstore は、SLS におけるログの基本的なストレージユニットです。
SLS コンソールにログインし、対象のプロジェクト名をクリックします。
左側のナビゲーションウィンドウで、
 を選択し、+ をクリックして Logstore を作成します:
Logstore 名:プロジェクト内で一意の名前を入力します。この名前は作成後に変更できません。
Logstore タイプ:機能比較に基づいて、標準またはクエリを選択します。
課金モード:
使用機能課金 (変更できません):ストレージ、インデックス、読み書き操作など、各リソースに対して個別に課金されます。このモードは、小規模なユースケースや機能の使用量が不確定な場合に適しています。
書き込みデータ量課金:書き込む生データの量に対してのみ課金されます。このモードでは、30 日間の無料ストレージと、データ変換や配信などの無料機能が提供されます。このモードは、ストレージ期間が 30 日に近いビジネスユースケースや、データ処理パイプラインが複雑な場合に適しています。
データ保持時間:ログを保持する日数。値は 1 から 3,650 までです。3,650 の値は永久保持を示します。デフォルト値は 30 日です。
その他の設定はデフォルト値のままにし、OK をクリックします。「Logstore の管理」をご参照ください。
ステップ 3:ログ収集ルールの設定
どのログを収集し、どのように解析し、コンテンツをフィルタリングするかを定義し、その設定をマシングループに適用します。
 Logstore ページで、対象の Logstore 名の前にある
 アイコンをクリックして展開します。
データのインポート の横にある
 アイコンをクリックします。表示された データのインポート ダイアログボックスで、ログソースに応じたテンプレートを選択して 今すぐ統合 をクリックします:
コンテナの標準出力については、K8s-Standard Output-New を選択します。
コンテナの標準出力を収集するためのテンプレートには、新旧 2 つのバージョンがあります。新しいバージョンの使用を推奨します。バージョンの比較については、「付録:新旧コンテナ標準出力バージョンの比較」をご参照ください。
クラスターのテキストログについては、Kubernetes-File を選択します。
サーバグループ設定 セクションで、設定を完了し、次へ をクリックします:
使用シナリオ:Docker シナリオ を選択します。
デプロイ方法:ACK DaemonSet または ユーザー作成クラスター Daemonset を選択します。
ソースサーバーグループ リストから、システムが作成したマシングループ
k8s-group-${cluster_id}を 適用されたサーバーグループ リストに移動します。
Logtail構成 ページで、以下の設定を行い、次へ をクリックします。
1. グローバル設定と入力設定
このステップでは、収集設定の名前、ログソース、および範囲を定義します。
コンテナ標準出力
グローバル設定
設定名:収集設定のカスタム名を入力します。名前はプロジェクト内で一意である必要があり、作成後に変更することはできません。命名規則:
小文字、数字、ハイフン (-)、アンダースコア (_) のみを含めることができます。
小文字または数字で開始および終了する必要があります。
入力設定
標準出力 および/または 標準エラー のトグルをオンにします。デフォルトでは両方とも有効になっています。
重要標準出力と標準エラーを同時に有効にすることは推奨されません。ログ収集の順序が乱れる可能性があります。
クラスターテキストログ
グローバル設定:
設定名:収集設定のカスタム名を入力します。名前はプロジェクト内で一意である必要があり、作成後に変更することはできません。命名規則:
小文字、数字、ハイフン (-)、アンダースコア (_) のみを含めることができます。
小文字または数字で開始および終了する必要があります。
入力設定:
ファイルパスのタイプ:
コンテナ内のパス:コンテナ内からログファイルを収集します。
ホストパス:ホストマシン上のローカルサービスからログを収集します。
ファイルパス:ログ収集のための絶対パス。
Linux:スラッシュ (/) で始まる必要があります。例:
/data/mylogs/**/*.log。このパスは、/data/mylogsディレクトリとそのサブディレクトリにある .log で終わるすべてのファイルを示します。Windows:ドライブ文字で始まる必要があります。例:
C:\Program Files\Intel\**\*.log。
ディレクトリ監視の最大深度:ファイルパス の
**ワイルドカードが一致できる最大ディレクトリ深度。デフォルトは 0 (カレントディレクトリのみ) で、有効範囲は 0 から 1,000 です。これを 0 に設定し、ログファイルを含むディレクトリへのパスを設定することを推奨します。
2. ログの処理と構造化
処理ルールを設定して、生ログを構造化された検索可能なデータに変換します。ルールを設定する前にログサンプルを追加してください。
Logtail構成 ページの 設定の処理 エリアで、ログサンプルの追加 をクリックし、収集したいログコンテンツを入力します。システムはサンプルを使用してログ形式を識別し、正規表現と解析ルールの生成を支援することで、設定プロセスを簡素化します。
ユースケース 1:複数行ログの処理
Java のスタックトレースや JSON オブジェクトなどのログは、しばしば複数行にわたります。デフォルトでは、これらは不完全なレコードに分割されます。複数行モードを有効にし、先頭行の正規表現を設定して、連続する行を完全なレコードにマージします。
例:
未処理の生ログ | デフォルトモードでは、各行が個別のログとして扱われ、スタックトレースが分断され、コンテキストが失われます。 | 複数行モードを有効にすると、先頭行の正規表現が完全なログを識別し、その意味構造を保持します。 |
|
|
|


手順: Logtail構成 ページの 設定の処理 エリアで、マルチラインモード を有効にします。
タイプ:カスタム または マルチライン JSON を選択します。
カスタム:生ログのフォーマットが固定されていない場合、各ログエントリの開始行を識別するために 行先頭の正規表現 を設定する必要があります。
行先頭の正規表現:これを自動生成するか、手動で入力できます。式はデータの一行全体に一致する必要があります。上記の例では、一致する正規表現は
\[\d+-\d+-\w+:\d+:\d+,\d+]\s\[\w+]\s.*です。自動生成:[正規表現の自動生成] をクリックします。ログサンプル テキストボックスで、抽出するログコンテンツを選択し、[正規表現の生成] をクリックします。
手動入力:[正規表現の手動入力] をクリックします。式を入力した後、[検証] をクリックします。
マルチライン JSON:生ログが標準の JSON 形式である場合にこのオプションを選択します。LoongCollector は、単一の JSON エントリ内の改行を自動的に処理します。
分割失敗の処理方法:
Discard:テキストセグメントが先頭行の正規表現に一致しない場合、それは破棄されます。
単一行を保持:一致しないテキストは、元の単一行モードに従って分割され保持されます。
ユースケース 2:ログの構造化
生ログが非構造化テキスト (例:Nginx アクセスログ) の場合、直接のクエリは非効率です。LoongCollector は、生ログを分析、モニタリング、アラート機能のための構造化されたキーと値のペアに変換する解析プラグインを提供します。
例:
未処理の生ログ | 構造化解析後のログ |
| |
手順: Logtail構成 ページの 設定の処理 エリアで:
解析プラグインの追加: 処理プラグインの追加 をクリックし、ログ形式に基づいて正規表現、デリミタ、または JSON 解析プラグインを設定します。この NGINX の例では、 を選択します。
NGINX ログの設定:Nginx サーバーの設定ファイル (nginx.conf) から
log_formatの定義全体をコピーし、このテキストボックスに貼り付けます。例:
log_format main '$remote_addr - $remote_user [$time_local] "$request" ''$request_time $request_length ''$status $body_bytes_sent "$http_referer" ''"$http_user_agent"';重要ここでのフォーマット定義は、サーバーでログを生成するフォーマットと完全に一致する必要があります。そうでない場合、解析は失敗します。
共通パラメーター: 以下のパラメーターは複数のデータ解析プラグインに共通しており、同じように機能します。
オリジナルフィールド: 解析するソースフィールドを指定します。デフォルトは
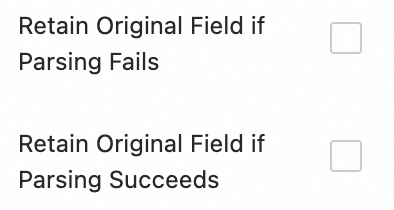
contentで、これは収集されたログエントリ全体です。失敗時にオリジナルフィールドを保持: 推奨。ログの解析に失敗した場合 (例:フォーマットの不一致)、このオプションは指定されたオリジナルフィールドに元のログコンテンツを保持します。
成功時にオリジナルフィールドを保持: 選択すると、解析が成功した後でも元のログコンテンツが保持されます。
3. ログフィルタリング
DEBUG や INFO レベルなどの価値の低い、または無関係なログを収集すると、ストレージを浪費し、コストを増加させ、クエリパフォーマンスを低下させ、セキュリティリスクをもたらす可能性があります。効率的で安全なログ収集のために、詳細なフィルタリングポリシーを実装してください。
コンテンツフィルタリング
フィールドコンテンツに基づいてログをフィルタリングします。例えば、レベルが WARNING または ERROR のログのみを収集します。
例:
未処理の生ログ |
|
| |
手順: Logtail構成 ページの 設定の処理 エリアで:
処理プラグインの追加 をクリックし、 を選択します。
Field Name:フィルタリング対象のログフィールド。
フィールド値:フィルタリング用の正規表現。全文一致のみがサポートされており、部分的なキーワード一致はサポートされていません。
収集ブラックリスト
ブラックリストを使用して指定されたディレクトリやファイルを排除し、無関係または機密性の高いログのアップロードを防ぎます。
手順: Logtail構成 ページで、 エリアに移動し、ブラックリストの収集 を有効にし、追加 をクリックします。
ディレクトリとファイル名の完全一致およびワイルドカード一致をサポートします。サポートされているワイルドカードはアスタリスク (*) と疑問符 (?) のみです。
ファイルパスのブラックリスト:無視するファイルパス。例:
/home/admin/private*.log:/home/admin/ディレクトリ内の "private" で始まり ".log" で終わるすべてのファイルを無視します。/home/admin/private*/*_inner.log:/home/admin/ディレクトリ下の "private" で始まるサブディレクトリにある "_inner.log" で終わるファイルを無視します。
ファイルのブラックリスト:収集中に無視するファイル名。例:
app_inner.log:app_inner.logという名前のすべてのファイルを無視します。
ディレクトリのブラックリスト:ディレクトリパスはスラッシュ (/) で終わることはできません。例:
/home/admin/dir1/:ディレクトリブラックリストは有効になりません。/home/admin/dir*:/home/admin/のサブディレクトリで "dir" で始まるものの中のすべてのファイルを無視します。/home/admin/*/dir:/home/admin/下の第 2 レベルのサブディレクトリで "dir" という名前のものの中のすべてのファイルを無視します。例えば、/home/admin/a/dir内のファイルは無視されますが、/home/admin/a/b/dir内のファイルは収集されます。
コンテナフィルタリング
環境変数、Pod ラベル、名前空間、コンテナ名などのコンテナメタデータに基づいて収集条件を設定し、どのコンテナのログを収集するかを正確に制御します。
手順: Logtail構成 ページの 入力設定 エリアで、コンテナフィルター を有効にし、追加 をクリックします。
複数の条件は論理「AND」で結合されます。すべての正規表現マッチングは Go の RE2 エンジンに基づいており、PCRE などのエンジンと比較して制限があります。式が「付録:正規表現の使用制限 (コンテナフィルタリング)」に準拠していることを確認してください。
環境変数ブロックリスト/許可リスト:コンテナの環境変数に基づいてフィルタリングします。
K8s Pod ラベルブロックリスト/許可リスト:Pod のラベルに基づいてフィルタリングします。
K8s Pod 名正規表現マッチ:指定された正規表現に名前が一致する Pod からログを収集します。
K8s 名前空間正規表現マッチ:名前空間名に基づいて収集対象のコンテナを選択します。
K8s コンテナ名正規表現マッチ:指定された正規表現に名前が一致するコンテナからログを収集します。
コンテナラベルブロックリスト/許可リスト:一致するラベルを持つコンテナからログを収集します。これは Docker シナリオ向けであり、K8s シナリオでは推奨されません。
4. ログの分類
複数のアプリケーションが同じログ形式を共有するシナリオでは、ソースを区別することが困難です。ログトピックとタグを設定して、自動的なコンテキストの関連付けと論理的な分類を可能にします。
ログトピック
複数のアプリケーションやインスタンスが同じログ形式を共有しているが、パスが異なる場合 (例:/apps/app-A/run.log と /apps/app-B/run.log)、ソースを区別することが困難です。この問題を解決するために、マシングループ、カスタム名、またはファイルパスの抽出に基づいてログトピックを生成し、さまざまなビジネスまたはパスソースからのログを区別できます。
手順: に移動し、以下の 3 つのオプションからトピック生成方法を選択します:
マシングループトピック: 収集設定が複数のマシングループに適用されると、LoongCollector は自動的にマシングループ名を
__topic__フィールドの値として使用します。これは、ホストクラスターごとにログを分類するシナリオに適しています。カスタム:フォーマットは
customized://<custom_topic_name>です。例:customized://app-login。これは、固定のビジネス識別子を持つ静的なトピックシナリオに適しています。ファイルパスの抽出: ログファイルの完全なパスからキー情報を抽出し、ログソースを動的にマークします。これは、複数のユーザーまたはアプリケーションが同じログファイル名を共有しているが、パスが異なる場合に適しています。
複数のユーザーまたはサービスが、同一のサブパスとファイル名を持つ異なるトップレベルディレクトリにログを書き込む場合、ファイル名だけではソースを区別できません。例:
/data/logs ├── userA │ └── serviceA │ └── service.log ├── userB │ └── serviceA │ └── service.log └── userC └── serviceA └── service.logこの場合、ファイルパスの抽出を設定し、正規表現を使用して完全なパスからキー情報を抽出できます。一致した結果は、ログトピックとして Logstore にアップロードされます。
抽出ルール:正規表現キャプチャグループ
正規表現を設定すると、システムはキャプチャグループの数と名前に基づいて、以下のように出力フィールド形式を自動的に決定します:
ファイルパスの正規表現では、スラッシュ (/) はエスケープする必要があります。
キャプチャグループタイプ
ユースケース
生成されるフィールド
正規表現の例
パスの例
生成されるフィールド
単一キャプチャグループ (1 つの
(.*?))ソースを区別するために単一のディメンションが必要 (例:ユーザー名、環境)。
__topic__フィールドを生成します。\/logs\/(.*?)\/app\.log/logs/userA/app.log__topic__:userA複数の名前なしキャプチャグループ (複数の
(.*?))意味的なラベルなしで複数のディメンションが必要。
__tag__:__topic_{i}__:valueの形式でタグフィールドを生成します。ここで{i}はキャプチャグループのインデックスです。\/logs\/(.*?)\/(.*?)\/app\.log/logs/userA/svcA/app.log__tag__:__topic_1__:userA;__tag__:__topic_2__:svcA複数の名前付きキャプチャグループ (
(?P<name>.*?)を使用)クエリと分析を容易にするために、明確で意味のあるフィールド名を持つ複数のディメンションが必要。
__tag__:{name}:valueの形式でタグフィールドを生成します。\/logs\/(?P<user>.*?)\/(?P<service>.*?)\/app\.log/logs/userA/svcA/app.log__tag__:user:userA;__tag__:service:svcA
ログのタグ付け
ログタグエンリッチメント機能を有効にして、コンテナの環境変数や Kubernetes Pod のラベルからキー情報を抽出し、詳細なロググルーピングのためにタグとしてアタッチします。
手順: Logtail構成 ページの 入力設定 エリアで、ログタグのエンリッチメント を有効にし、追加 をクリックします。
環境変数関連:環境変数名とタグキーを設定します。環境変数の値がタグの値として保存されます。
環境変数名:抽出する環境変数の名前。
タグキー:新しいタグのキー。
Pod Label 関連:Pod ラベルキーとタグキーを設定します。Pod ラベルの値がタグの値として保存されます。
Pod ラベルキー:抽出する Kubernetes Pod ラベルのキー。
タグキー:新しいタグのキー。
5. 出力設定
デフォルトでは、すべてのログが lz4 圧縮で現在の Logstore に送信されます。同じソースからのログを異なる Logstore に配信するには、以下の手順に従ってください。
複数宛先への動的配信
複数宛先への動的配信は、LoongCollector 3.0.0 以降でのみ利用可能です。この機能は Logtail ではサポートされていません。
最大 5 つの出力先を設定できます。
複数の出力先を設定した後、この収集設定は現在の Logstore の収集設定リストに表示されなくなります。設定を表示、変更、または削除するには、「複数宛先配信設定を管理するにはどうすればよいですか?」をご参照ください。
手順: Logtail構成 ページの 出力設定 エリアで:
 をクリックして出力設定を展開します。
出力先の追加 をクリックし、以下の設定を完了します:
Logstores:ターゲットの Logstore を選択します。
圧縮方法:lz4 と zstd をサポートします。
ルート設定:タグフィールドに基づいてログをルーティングします。ルーティング設定に一致するログは、ターゲットの Logstore に送信されます。これを空のままにすると、収集されたすべてのログがターゲットの Logstore に送信されます。
タグ名: ルーティングに使用するタグキーです。
__tag__:プレフィックスを付けずに、キーを直接入力します (例:__path__)。タグフィールドは 2 つのカテゴリに分類されます。タグについては、「LoongCollector 収集タグの管理」で説明されています。
エージェント関連:収集エージェントによって生成され、どのプラグインにも依存しません。例:
__hostname__、__user_defined_id__。入力プラグイン関連:入力プラグインによって提供およびエンリッチされます。例:ファイル収集からの
__path__、K8s 収集からの_pod_name_または_container_name_。
タグ値:タグ値がこの設定に一致するログが、ターゲットの Logstore に送信されます。
このタグフィールドを破棄するかどうか:有効にすると、このタグフィールドはアップロードされるログに含まれなくなります。
ステップ 4:クエリと分析
ログ処理とプラグインを設定した後、次へ をクリックして クエリと分析の設定 ページに進みます:
デフォルトでは、システムはフルテキストインデックスを有効にし、キーワードで生ログコンテンツを検索できます。
特定のフィールドでデータをクエリするには、[プレビューデータ] がロードされた後、自動インデックスの生成 をクリックします。Log Service は、プレビューデータの最初のログエントリに基づいてフィールドインデックスを生成します。
設定完了後、次へ をクリックして収集プロセスを完了します。
ステップ 5:検証とトラブルシューティング
収集設定を作成してマシングループに適用すると、システムは自動的にそれをデプロイし、増分ログの収集を開始します。
収集されたログの表示
ログファイルに新しいコンテンツがあることを確認する:LoongCollector は増分ログのみを収集します。
tail -f /path/to/your/log/fileを実行し、ビジネス運用をトリガーして、新しいログが書き込まれていることを確認します。ログの検索:対象の Logstore の検索 & 分析ページに移動します。検索と分析 をクリックします。デフォルトの時間範囲は過去 15 分です。新しいログが取り込まれているか確認します。収集された各コンテナテキストログには、デフォルトで以下のフィールドが含まれます:
パラメーター
説明
__tag__:__hostname__コンテナホストの名前。
__tag__:__path__コンテナ内のログファイルのパス。
__tag__:_container_ip_コンテナの IP アドレス。
__tag__:_image_name_コンテナが使用するイメージの名前。
__tag__:_pod_name_Pod の名前。
__tag__:_namespace_Pod の名前空間。
__tag__:_pod_uid_Pod の一意の識別子 (UID)。
Pod の履歴ノードのクエリ
Pod がドリフトまたは再起動した場合、ACK クラスターの Kubernetes イベントログを SLS でクエリして、Pod が以前に実行されていたノードを見つけることができます。
SLS コンソールにログインし、プロジェクトリストで
k8s-log-{cluster_id}プロジェクトを見つけます。k8s-event LogStore をクリックして、クエリと分析ページに移動します。
検索ボックスに、Pod 名でフィルタリングするクエリ文を入力します。例:
pod_name: my-pod、そして [検索 & 分析] をクリックします。返された結果で、
hostnameフィールドの値を確認します。この値は、Pod が実行されていたノードのホスト名です。
k8s-event LogStore では、フィールド名は pod_name と hostname であり、__tag__: プレフィックスはありません。__tag__: プレフィックス形式は、コンテナの標準出力とテキストログ収集に適用され、Kubernetes イベントログには適用されません。
一般的な問題のトラブルシューティング
マシングループのハートビート失敗
ユーザー識別子の確認:サーバーが ECS インスタンスでない場合、または ECS インスタンスとプロジェクトが異なる Alibaba Cloud アカウントに属している場合は、指定されたディレクトリに正しいユーザー識別子が存在することを確認してください。
Linux では、
cd /etc/ilogtail/users/ && touch <uid>コマンドを実行してユーザー識別子ファイルを作成します。Windows:
C:\LogtailData\users\ディレクトリに移動し、<uid>という名前の空のファイルを作成します。
指定されたパスに、現在のプロジェクトの Alibaba Cloud アカウント ID と同じ名前のファイルが含まれている場合、ユーザー識別子は正しく設定されています。
マシングループ識別子の確認:マシングループにカスタム識別子を使用している場合は、指定されたディレクトリに
user_defined_idファイルが存在するかどうかを確認します。ファイルが存在する場合は、その内容がマシングループに設定されたカスタム識別子と一致するかどうかを確認します。Linux:
# カスタム識別子を設定します。ディレクトリが存在しない場合は、手動で作成してください。
echo "user-defined-1" > /etc/ilogtail/user_defined_id
Windows:
C:\LogtailDataディレクトリに、user_defined_idという名前のファイルを作成し、カスタム識別子をファイルに書き込みます。(ディレクトリが存在しない場合は、手動で作成してください。)
ユーザー識別子とマシングループ識別子が正しく設定されている場合は、「LoongCollector (Logtail) マシングループのトラブルシューティング」を参照して、さらなるトラブルシューティングを行ってください。
ログ収集エラーまたはフォーマットエラー
この問題は通常、ネットワーク接続と基本設定が正しいにもかかわらず、ログの内容が解析ルールと一致しない場合に発生します。問題を診断するには、特定のエラーメッセージを表示します:
Logtail構成 ページで、収集エラーがある LoongCollector (Logtail) 構成の名前をクリックします。(ログ収集エラー) タブで、コスト上の理由 をクリックしてクエリ時間を設定します。
セクションで、エラーログのアラートタイプを表示し、「データ収集の一般的なエラータイプ」を参照して対応する解決策を見つけます。
次のステップ
コンテナログ収集のトラブルシューティング
対象のログファイルに新しいログが生成されていることを確認します。Logtail は新しいログが表示されるまでデータを収集しません。
よくある質問
複数宛先配信設定の管理
複数宛先配信設定は複数の Logstore に適用されるため、プロジェクトレベルの管理ページから管理します:
SLS コンソールにログインし、対象のプロジェクト名をクリックします。
「プロジェクト」ページの左側のナビゲーションウィンドウで、
 をクリックします。説明
このページでは、誤って削除された Logstore の設定を含む、プロジェクト内のすべての収集設定を管理します。
ACK ログをクロスアカウントのプロジェクトに送信する
ACK クラスターに LoongCollector (Logtail) コンポーネントを手動でインストールし、対象アカウントの Alibaba Cloud アカウント ID またはアクセス認証情報 (AccessKey) で設定することで、コンテナログを別の Alibaba Cloud アカウントの SLS プロジェクトに送信できます。
シナリオの説明:組織、権限、またはモニタリングの目的で、別のアカウントの SLS プロジェクトにログデータを収集する必要がある場合は、LoongCollector (Logtail) を手動でインストールしてクロスアカウント収集を有効にします。
手順:LoongCollector を手動でインストールするには、以下の手順に従ってください。Logtail のインストール方法については、「Logtail のインストールと設定」をご参照ください。
Kubernetes クラスターに接続し、ご利用のリージョンに適したコマンドを実行します:
中国リージョン
wget https://aliyun-observability-release-cn-shanghai.oss-cn-shanghai.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.sh中国以外のリージョン
wget https://aliyun-observability-release-ap-southeast-1.oss-ap-southeast-1.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.shloongcollector-custom-k8s-packageディレクトリに移動し、./loongcollector/values.yaml設定ファイルを変更します。# ===================== 必須情報 ===================== # このクラスターからのログが送信されるプロジェクトの名前。例:k8s-log-custom-sd89ehdq projectName: "" # プロジェクトが配置されているリージョン。例:cn-shanghai region: "" # プロジェクトを所有する Alibaba Cloud アカウントの UID。UID は引用符 ("") で囲んでください。例:"123456789" aliUid: "" # ネットワークタイプ。有効な値:Internet および Intranet。デフォルト値:Internet。 net: Internet # Alibaba Cloud アカウントまたは RAM ユーザーの AccessKey ID と AccessKey Secret。アカウントまたは RAM ユーザーには AliyunLogFullAccess システムポリシー権限が必要です。 accessKeyID: "" accessKeySecret: "" # カスタムクラスター ID。ID には、大文字、小文字、数字、ハイフン (-) のみを含めることができます。 clusterID: ""loongcollector-custom-k8s-packageディレクトリで、以下のコマンドを実行して LoongCollector とその依存関係をインストールします:bash k8s-custom-install.sh installインストールが完了したら、コンポーネントが実行されていることを確認します。
Pod の起動に失敗した場合は、values.yaml ファイルの設定を確認し、必要なイメージがプルされていることを確認してください。
# Pod のステータスを確認
kubectl get po -n kube-system | grep loongcollector-ds
SLS はまた、以下のリソースを自動的に作成します。これらは SLS コンソールで確認できます。
リソースタイプ
リソース名
説明
プロジェクト
values.yaml ファイルで指定した
projectNameの値異なるサービスのログを分離します。
柔軟なログ管理のために、「プロジェクトの作成」をご参照ください。
マシングループ
k8s-group-${cluster_id}ログ収集ノードのコレクションです。Kubernetes ノードの IP アドレスはクラスターのスケールインまたはスケールアウトに伴い動的に変更されるため、IP アドレスでマシングループを識別するとハートビートの失敗を引き起こす可能性があります。そのため、Kubernetes シナリオのマシングループではカスタム識別子を使用します。詳細については、「収集設定とマシングループを関連付けるためのガイド」をご参照ください。
重要LoongCollector コンポーネントは config-operation-log という名前の Logstore を作成しません。この Logstore が既に存在する場合、LoongCollector はそこにログを書き込みません。
同じソースに対して複数の設定を使用する
デフォルトでは、データの重複を防ぐため、SLS は各ソースからログを収集するために 1 つの収集設定のみを許可します:
テキストログファイルは、1 つの Logtail 収集設定にのみ一致できます。
コンテナの標準出力 (stdout):
新しいバージョンの標準出力テンプレートを使用する場合、stdout はデフォルトで 1 つの標準出力収集設定によってのみ収集できます。
古いバージョンの標準出力テンプレートを使用する場合、追加の設定は不要で、デフォルトで複数の収集がサポートされます。
SLS コンソールにログインし、対象のプロジェクトに移動します。
左側のナビゲーションウィンドウで、
[Logstores] を選択し、対象の Logstore を見つけます。その名前の隣にある
アイコンをクリックして Logstore を展開します。Logtail構成 をクリックします。設定のリストで、対象の Logtail 構成を見つけ、[操作] 列の Logtail 設定の管理 をクリックします。
Logtail 構成ページで、編集 をクリックし、入力設定 セクションまでスクロールします:
テキストファイルログを収集するには、ファイルを複数回収集できるようにする を有効にします。
コンテナの標準出力を収集するには、標準出力の複数回の収集を許可する を有効にします。
loongcollector のアンインストール時の依存関係エラー
問題: ACK で loongcollector (logtail-ds) コンポーネントをアンインストールしようとすると、コンポーネントの依存関係が満たされていないというエラーが表示されます。
Dependencies of addons are not met: terway-eniip depends on logtail-ds(>0.0) whose version is v3.x.x.x-aliyun or will be v3.x.x.x-aliyun.
原因: terway-eniip ネットワークプラグインでログ収集が有効になっており、これにより loongcollector (logtail-ds) コンポーネントへの依存関係が作成されます。そのため、この依存関係を削除するまで、ACK は loongcollector (logtail-ds) のアンインストールを許可しません。
解決策: 以下の手順に従って依存関係を削除し、コンポーネントをアンインストールします:
ACK コンソールにログインします。
クラスターリストで、対象クラスターの名前をクリックして詳細ページに移動します。
左側のナビゲーションウィンドウで、アドオン管理 をクリックします。
アドオンのリストで、
terway-eniipコンポーネントを検索し、 をクリックします。表示されるダイアログボックスで、OK をクリックします。
設定が有効になった後、loongcollector (logtail-ds) コンポーネントを再度アンインストールしてみてください。
最後のログエントリの遅延または切り捨て
原因: ログの切り捨ては通常、ログファイルの最後の改行が欠落している場合、または例外スタックなどの複数行のログエントリが完全に書き込まれていない場合に発生します。コレクターはログエントリが完了したかどうかを判断できないため、最後のログエントリが分割されたり遅延したりすることがあります。これがどのように処理されるかは、お使いの LoongCollector (Logtail) のバージョンによって異なります:
1.8 より前のバージョン:
ログの最後の行に改行がない場合、または複数行のログブロックが不完全な場合、コレクターは次の書き込み操作が出力をトリガーするのを待ちます。これにより、新しいログが書き込まれるまで最後のログエントリが大幅に遅延する可能性があります。バージョン 1.8 以降:
これらのバージョンでは、ログが滞留するのを防ぐためのタイムアウトフラッシュメカニズムが導入されています。不完全なログ行が検出されると、システムはタイマーを開始します。タイムアウト期間が経過すると、現在のコンテンツが自動的に送信され、ログが最終的に収集されることが保証されます。デフォルトのタイムアウト:60 秒 (ほとんどのシナリオでデータ整合性を保証)
要件に応じてこの値を調整できます。ただし、0 に設定するとログの切り捨てや部分的なデータ損失が発生する可能性があるため、推奨されません。
解決策:
待機時間を延長して、収集される前に完全なログエントリが書き込まれるようにすることができます:
SLS コンソールにログインし、対象のプロジェクトに移動します。
左側のナビゲーションウィンドウで、
 [Logstores] を選択し、対象の Logstore を見つけます。
その名前の隣にある
 アイコンをクリックして Logstore を展開します。
Logtail構成 をクリックします。設定のリストで、対象の Logtail 構成を見つけ、[操作] 列の Logtail 設定の管理 をクリックします。
Logtail 構成ページで、編集 をクリックします。
に移動し、以下の JSON 設定を追加してタイムアウト期間をカスタマイズします。
{
  "FlushTimeoutSecs": 1
}
デフォルト値:
default_reader_flush_timeout起動パラメーターによって決定され、通常は数秒です。単位:秒。
推奨値:≥ 1 秒。0 に設定するとログの切り捨てや部分的なデータ損失が発生する可能性があるため、推奨されません。
設定完了後、OK をクリックします。
LoongCollector ネットワークのフェールオーバーと回復
LoongCollector (Logtail) が内部ネットワーク接続の問題 (障害やタイムアウトなど) を検出すると、自動的にパブリックネットワークに切り替わります。このフェールオーバーメカニズムにより、信頼性の高いログ収集が保証され、バックログやデータ損失が防止されます。
LoongCollector:ネットワークが回復すると、自動的に内部ネットワークに切り替わります。
Logtail:自動的には切り替わりません。内部ネットワーク通信を復元するには、再起動する必要があります。
付録:ネイティブプロセッサー
Logtail構成 ページの 設定の処理 エリアで、処理プラグインを追加して生ログを構造化できます。既存の収集設定に処理プラグインを追加するには、以下の手順に従います:
左側のナビゲーションウィンドウで、
 [Logstores] を選択し、宛先の Logstore を見つけます。
その名前の左にある
 をクリックして Logstore を展開します。
Logtail構成 をクリックします。構成リストで、宛先の Logtail 構成を見つけ、[操作] 列の Logtail 設定の管理 をクリックします。
Logtail 構成ページで、編集 をクリックします。
このセクションでは、一般的なログ処理シナリオをカバーする、よく使用される処理プラグインのみを紹介します。その他の機能については、「拡張処理プラグイン」をご参照ください。
プラグインの組み合わせルール (LoongCollector / Logtail 2.0 以降に適用):
ネイティブおよび拡張処理プラグインは、必要に応じて独立して、または組み合わせて使用できます。
ネイティブ処理プラグインは、パフォーマンスと安定性が高いため、最初に使用することを推奨します。
ネイティブ機能がビジネス要件を満たせない場合は、設定済みのネイティブプラグインの後に拡張処理プラグインを追加して、補足的な処理を実行できます。
順序の制約:
すべてのプラグインは設定された順序で順次実行され、処理チェーンを形成します。注意:すべてのネイティブ処理プラグインは、どの拡張処理プラグインよりも前に配置する必要があります。拡張処理プラグインを追加した後は、さらにネイティブ処理プラグインを追加することはできません。
正規表現解析
このプロセッサは、正規表現を使用してログをキーと値のペアに解析します。その後、抽出された各フィールドを個別にクエリおよび分析できます。
例:
生ログ | 解析結果 |
| |
手順: Logtail構成 ページの 設定の処理 エリアで、処理プラグインの追加 をクリックし、 を選択します:
正規表現:ログエントリに一致します。自動生成するか、手動で入力できます。
正規表現を自動生成するには:
[正規表現の生成] をクリックします。
ログサンプル ボックスで、抽出するコンテンツをハイライトします。
[生成] をクリックします。

ログ形式に基づいて正規表現を手動で入力します。
式を設定した後、[検証] をクリックして、ログサンプルを正しく解析できるかテストします。
ログ抽出フィールド:抽出されたコンテンツ (値) に名前 (キー) を割り当てます。
その他のパラメーターについては、「シナリオ 2:構造化ログ」の共通設定パラメーターの説明をご参照ください。
デリミタ解析
このプロセッサは、デリミタを使用してログをキーと値のペアに解析します。単一または複数文字のデリミタを使用できます。
例:
生ログ | 指定された文字 |
| |
手順: Logtail構成 ページの 設定の処理 エリアで、処理プラグインの追加 をクリックし、 を選択します:
区切りモード:ログ内のフィールドを区切る文字。
例:CSV ファイルの場合、カスタム を選択し、カンマ (,) を入力します。
引用符:フィールド値を囲むために使用される文字。フィールド値にデリミタが含まれる可能性がある場合に必要で、誤った分割を防ぎます。
ログ抽出フィールド:各列に順番にフィールド名 (キー) を割り当てます。フィールド名は以下のルールに従う必要があります:
文字、数字、アンダースコア (_) のみを含めることができます。
文字またはアンダースコア (_) で始まる必要があります。
最大長:128 バイト。
その他のパラメーターについては、「シナリオ 2:構造化ログ」の共通設定パラメーターの説明をご参照ください。
標準 JSON 解析
このプロセッサは、JSON オブジェクトであるログエントリをキーと値のペアに解析します。
例:
生ログ | 解析結果 |
| |
手順: Logtail構成 ページの 設定の処理 セクションで、処理プラグインの追加 をクリックし、 を選択します:
元のフィールド:デフォルト値は
contentです。このフィールドには、解析対象の生ログコンテンツが格納されます。その他のパラメーターについては、「シナリオ 2:構造化ログ」の共通設定パラメーターの説明をご参照ください。
ネストされた JSON 解析
このプロセッサは、ネストされた JSON オブジェクトをキーと値のペアに展開します。JSON 展開深度 設定で展開を制御します。
例:
生ログ | 結果 (深度:0) | 結果 (深度:1) |
| | |
手順: Logtail構成 ページの 設定の処理 セクションで、処理プラグインの追加 をクリックし、 を選択します:
元のフィールド:展開する元のフィールドの名前。例:
content。JSON 拡張度: JSON オブジェクトを展開する階層数です。
0(デフォルト) はすべての階層を展開し、1は最上位階層のみを展開します。以降も同様です。JSON 拡張連結文字:ネストされたオブジェクトのキーを結合するために使用される文字。デフォルトはアンダースコア (
_) です。JSON のフィールドプレフィックス拡張:展開された各キーの名前に追加するプレフィックス。
配列を展開する:このオプションを有効にすると、配列がインデックス付きのキーと値のペアに展開されます。
例:
{"k":["a","b"]}は{"k[0]":"a","k[1]":"b"}に展開されます。展開されたフィールドの名前を変更する場合 (例:
prefix_s_key_k1からnew_field_nameへ)、このプロセッサの後に フィールドの名前変更 プロセッサを追加します。その他のパラメーターについては、「シナリオ 2:構造化ログ」の共通設定パラメーターの説明をご参照ください。
JSON 配列解析
json_extract 関数を使用して、JSON 配列から JSON オブジェクトを抽出します。
例:
生ログ | 解析結果 |
| |
手順: Logtail構成 ページの 設定の処理 セクションで、処理モード を SPL に設定します。次に、SPL 文を設定して json_extract 関数を使用し、JSON 配列から JSON オブジェクトを抽出します。
例: ログフィールド content から、JSON 配列の要素を抽出し、結果をそれぞれ新しいフィールド json1 と json2 に格納します。
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Apache ログ解析
このプロセッサは、Apache の LogFormat ディレクティブに基づいて、Apache アクセスログをキーと値のペアに解析します。
例:
生ログ | Apache 共通ログ形式 |
| |
手順: Logtail構成 ページの 設定の処理 セクションで、処理プラグインの追加 をクリックし、 を選択します:
ログ形式:combined
APACHE 設定フィールド:システムは、選択された ログ形式 に基づいてこのフィールドを自動的に入力します。
重要自動入力された内容が、サーバーの Apache 設定ファイル (通常は
/etc/apache2/apache2.confにあります) で定義されている LogFormat ディレクティブと同一であることを確認してください。その他のパラメーターについては、「シナリオ 2:構造化ログ」の共通設定パラメーターの説明をご参照ください。
データマスキング
ログ内の機密データをマスキングします。
例:
生ログ | マスキング結果 |
| |
手順: Logtail構成 ページの 設定の処理 セクションで、処理プラグインの追加 をクリックし、 を選択します:
時間解析
ログの時間フィールドを解析し、解析結果をログの __time__ フィールドとして設定します。
例:
生ログ | 解析結果 |
|
|

手順: Logtail構成 ページの 設定の処理 セクションで、処理プラグインの追加 をクリックし、 を選択します:
元のフィールド:解析する時間文字列を含むソースフィールド。
時間形式:ログの時間文字列に対応する時間形式。
タイムゾーン:ログの時間フィールドのタイムゾーン。指定しない場合、LoongCollector (Logtail) を実行しているマシンのタイムゾーンがデフォルトになります。
付録:正規表現の制限 (コンテナフィルタリング)
コンテナフィルタリングの正規表現は、Go RE2 エンジンを使用します。PCRE などの他のエンジンと比較して、RE2 エンジンにはいくつかの構文上の制限があります。正規表現を作成する際には、以下の点に注意してください:
1. 名前付きグループの構文の違い
Go は (?P<name>...) 構文を使用して名前付きグループを定義し、PCRE の (?<name>...) 構文はサポートしていません。
正しい:
(?P<year>\d{4})誤り:
(?<year>\d{4})
2. サポートされていない正規表現機能
RE2 エンジンは、以下の一般的だが複雑な正規表現機能をサポートしていません。これらは使用しないでください:
アサーション:
(?=...),(?!...),(?<=...), および(?<!...)条件式:
(?(condition)true|false)再帰的マッチング:
(?R)および(?0)サブルーチン参照:
(?&name)および(?P>name)アトミックグループ:
(?>...)
3. 推奨事項
Regex101 などのツールを使用して正規表現をデバッグしてください。互換性を確保するために、検証には Golang (RE2) モードを選択してください。サポートされていない構文を使用すると、プラグインは式の解析またはマッチングに失敗します。
付録:コンテナ標準出力バージョンの比較
ストレージ効率と収集の一貫性を向上させるため、コンテナ標準出力のログメタデータ形式がアップグレードされました。新しい形式では、メタデータが __tag__ フィールドに統合され、ストレージが最適化され、形式が標準化されます。
新しい標準出力の主な利点
大幅なパフォーマンス向上
C++ でリファクタリングされた新しいバージョンは、以前の Go 実装に比べて 180% から 300% のパフォーマンス向上を実現します。
ネイティブプラグインによるデータ処理とマルチスレッド並列処理をサポートし、システムリソースを最大限に活用します。
ネイティブプラグインと Go プラグインの柔軟な組み合わせをサポートし、複雑なシナリオのニーズに対応します。
より高い信頼性
標準出力ログのローテーションキューをサポートし、ログ収集メカニズムをファイル収集メカニズムと統一することで、標準出力ログが急速にローテーションする場合でも高い信頼性を提供します。
より低いリソース消費
CPU 使用率が 20% から 25% 削減されます。
メモリ使用量が 20% から 25% 削減されます。
O&M の一貫性向上
統一されたパラメーター設定:新しい標準出力収集プラグインの設定パラメーターは、ファイル収集プラグインのものと一貫しています。
統一されたメタデータ管理:コンテナメタデータフィールドの命名とタグの保存場所がファイル収集シナリオと統一されているため、コンシューマー側は 1 つの処理ロジックのみを維持します。
新旧バージョンの機能比較
特徴 | 旧バージョン | 新バージョン |
保存方法 | メタデータは通常のフィールドとしてログコンテンツに埋め込まれます。 | メタデータは |
ストレージ効率 | 各ログエントリはメタデータの完全なコピーを保持するため、より多くのストレージスペースを消費します。 | 同じコンテキスト内の複数のログエントリはメタデータを再利用できるため、ストレージコストを節約できます。 |
フォーマットの一貫性 | フォーマットはコンテナファイル収集フォーマットと一貫性がありません。 | フィールドの命名とストレージ構造はコンテナファイル収集と完全に整合しており、統一された体験を提供します。 |
クエリアクセス方法 | メタデータはフィールド名で直接クエリできます。例: |
|
コンテナメタデータフィールドのマッピング
旧フィールド名 | 新フィールド名 |
|
|
|
|
|
|
|
|
|
|
|
|
新しいバージョンでは、すべてのメタデータフィールドはログコンテンツに埋め込まれるのではなく、__tag__:<key> 形式でログのタグセクションに保存されます。
新バージョンがユーザーに与える影響
コンシューマー側の適応:保存場所がコンテンツからタグに変更されるため、ログ消費ロジックをそれに応じて調整する必要があります。例えば、クエリを実行する際には
__tag__を通じてフィールドにアクセスする必要があります。SQL 互換性:クエリ SQL は既に両方のバージョンに自動的に互換性があるため、どちらのバージョンのログを処理する場合でもクエリ文を変更する必要はありません。
詳細情報
グローバルパラメーター
入力パラメーター
プロセッサーパラメーター
パラメーター | 説明 |
ログサンプル | 収集したいログのサンプル。実際のユースケースからログサンプルを使用してください。サンプルは、処理パラメーターをより簡単に設定するのに役立ちます。複数のサンプルを追加できます。合計長は 1,500 文字を超えることはできません。 |
複数行モード |
|
処理モード | 処理プラグインの組み合わせ。これには ネイティブ処理プラグイン と 拡張処理プラグイン が含まれます。プロセッサーの詳細については、「ネイティブおよび拡張プロセッサーの使用」をご参照ください。 重要 プロセッサーの使用制限については、コンソールのプロンプトをご参照ください。
|