Machine Learning Designer は、パイプラインを使用してモデルを構築します。パイプラインを作成し、キャンバス上にコンポーネントを配置し、処理ロジックを定義します。このチュートリアルでは、心臓病予測のためのビジュアルモデルを、データ準備からデプロイまで、構築してデプロイする手順を説明します。
前提条件
-
PAI がアクティブ化され、ワークスペースが作成されていること。詳細については、「デフォルトワークスペースのアクティブ化と作成」をご参照ください。
-
ワークスペースが MaxCompute リソースに関連付けられていること。詳細については、「クイックスタート - 前提条件」をご参照ください。
手順1:パイプラインの作成
Machine Learning Designer を開き、ワークスペースを選択し、右上隅にある [New Pipeline] をクリックします。パイプライン名を入力し、[OK] をクリックします。
|
パラメーター |
説明 |
|
ワークフロー名 |
カスタムのワークフロー名。 |
|
ワークフローデータストレージ |
一時データおよびモデル用の OSS バケットパスです。構成されていない場合は、デフォルトでワークスペースストレージが使用されます。 実行ごとに、Designer は |
|
可視性 |
|
手順2:データ準備と前処理
モデルを構築する前に、トレーニングデータを準備し、前処理を行います。
データ準備
[ソース/ターゲット] コンポーネントを追加して、MaxCompute、OSS、またはその他のソースからデータを読み取ります。詳細については、「ソース/ターゲットコンポーネントリファレンス」をご参照ください。この例では、[テーブル読み取り] を使用して、PAI から公開されている心臓病データセットを読み取ります。詳細については、「心臓病データセット」をご参照ください。
-
データを読み取るための [ソース/ターゲット] コンポーネントを選択します。
左側のコンポーネントリストで [ソース/ターゲット] をクリックし、[テーブル読み取り] をキャンバスにドラッグします。[テーブル読み取り-1] ノードが作成されます。
-
ソーステーブルを設定します。
キャンバスで [テーブル読み取り-1] を選択します。右側の設定ペインで、[テーブル名] に MaxCompute のテーブル名を入力します。この例では、
pai_online_project.heart_disease_predictionと入力します。 -
[Fields] タブに切り替えて、フィールドの詳細を表示します。
データの前処理
二項ロジスティック回帰コンポーネントは、DOUBLE 型または BIGINT 型の入力を必要とします。モデルをトレーニングするために、データ型変換を使用してデータセットを前処理します。
-
非数値フィールドを数値型に変換します。
-
[SQL スクリプト] を検索し、キャンバスにドラッグします。[SQL スクリプト-1] ノードが作成されます。
-
[テーブル読み取り-1] を [SQL スクリプト-1] の [t1] 入力ポートに接続します。
-
ノードを設定します。
[SQL スクリプト-1] をクリックします。設定ペインで、次の SQL を入力します。[Parameters] タブの [Input source] は t1 です。
select age, (case sex when 'male' then 1 else 0 end) as sex, (case cp when 'angina' then 0 when 'notang' then 1 else 2 end) as cp, trestbps, chol, (case fbs when 'true' then 1 else 0 end) as fbs, (case restecg when 'norm' then 0 when 'abn' then 1 else 2 end) as restecg, thalach, (case exang when 'true' then 1 else 0 end) as exang, oldpeak, (case slop when 'up' then 0 when 'flat' then 1 else 2 end) as slop, ca, (case thal when 'norm' then 0 when 'fix' then 1 else 2 end) as thal, (case status when 'sick' then 1 else 0 end) as ifHealth from ${t1}; -
キャンバスの左上隅にある [Save] をクリックします。
-
[SQL スクリプト-1] コンポーネントを右クリックし、[ルートノードからここまで実行] を選択して、パイプラインをデバッグして実行します。
ノードは順番に実行されます。実行が成功すると、各ノードに
 アイコンが表示されます。説明
キャンバスの左上隅にある
 (実行) をクリックして、パイプライン全体を実行することもできます。複雑なパイプラインの場合は、個々のノードを実行するとデバッグが簡単になります。実行が失敗した場合は、失敗したノードを右クリックし、[ログを表示] を選択してトラブルシューティングを行います。
-
実行後、[SQL スクリプト-1] などの宛先ノードを右クリックし、 を選択して出力を確認します。
-
-
すべてのフィールドを DOUBLE データ型に変換します。
[データ型変換] をキャンバスにドラッグし、[SQL スクリプト-1] の後に接続します。[Set fields] タブで、[Columns to convert to double] の下にある [Select fields] をクリックし、すべてのフィールドを選択します。
-
特徴を [0, 1] の範囲に正規化します。
[正規化] をキャンバスにドラッグし、[データ型変換-1] の後に接続します。[Set fields] タブですべてのフィールドを選択します。
-
データをトレーニングセットとテストセットに分割します。
[分割] をキャンバスにドラッグし、[正規化-1] の後に接続します。このコンポーネントは2つのテーブルを出力します。
デフォルトでは、データは 4:1 の比率で分割されます。[Parameters] タブで [分割比率] を調整します。詳細については、「分割」をご参照ください。
-
[データ型変換-1] を右クリックし、[ここから実行] を選択して残りのノードを実行します。
手順3:モデルのトレーニング
心臓病の予測は二項分類の問題です。各サンプルは、病気か健康かを示します。二項ロジスティック回帰コンポーネントを使用してモデルを構築します。
-
ロジスティック回帰 (二値分類) コンポーネントをキャンバスにドラッグし、[分割-1] ノードの [Output Table 1] ポートに接続します。
-
ノードを設定します。
[二項ロジスティック回帰-1] をクリックします。[Set fields] タブで、[ラベル列] を [ifHealth] に、[特徴列] を残りのすべての列に設定します。詳細については、「二項ロジスティック回帰」をご参照ください。
説明「手順6:モデルのデプロイ (任意)」でモデルをデプロイするには、[二項ロジスティック回帰] を選択し、[Set fields] タブで [PMML ファイルの生成] にチェックを入れる必要があります。
-
ノードを実行します。
手順4:予測の実行
-
予測ノードを実行し、結果を表示します。
予測ノードを右クリックし、[データを表示] > [Output of Prediction Result] を選択します。
出力には、[ifHealth] (実際のラベル、1.0 または 0.0)、[prediction_result] (予測結果)、[prediction_score] (信頼度スコア)、および [prediction_detail] (JSON 形式のクラスごとの確率) が含まれます。
手順5:モデルの評価
-
[二項分類評価] をキャンバスにドラッグし、[予測-1] の後に接続します。
-
[二項分類評価-1] をクリックします。[Set fields] タブで、[元のラベル列] を [ifHealth] に設定します。
-
評価ノードを実行します。
[二項分類評価] を右クリックし、[可視化分析] を選択して評価メトリクスを表示します。
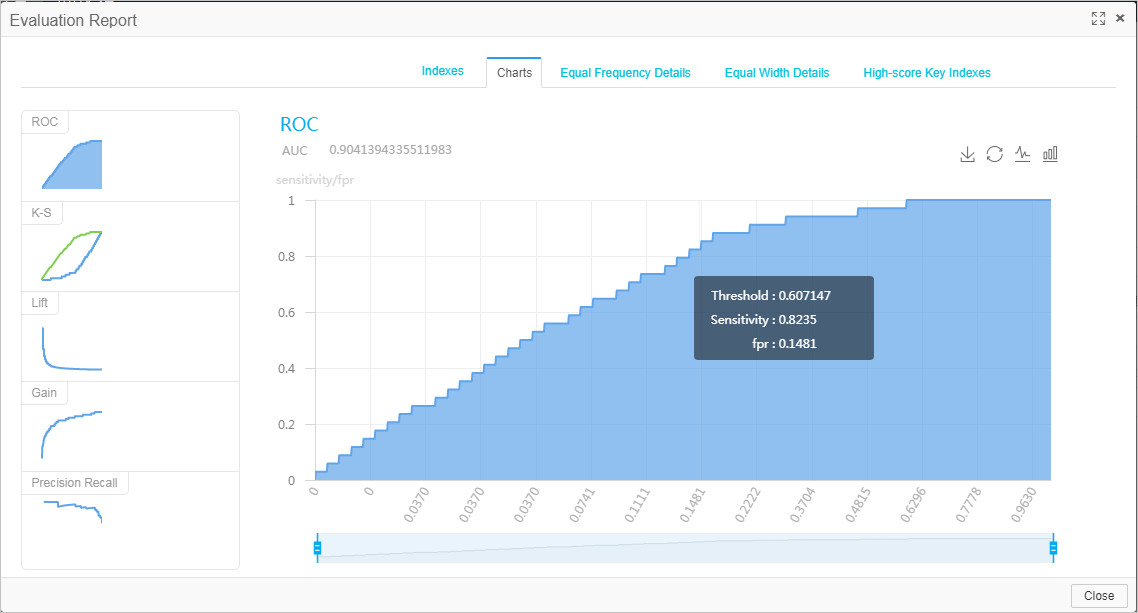
手順6:モデルのデプロイ (任意)
Machine Learning Designer は、Elastic Algorithm Service (EAS) と統合されています。トレーニング、予測、評価の後、モデルを EAS にオンラインサービスとしてデプロイできます。
-
パイプラインの実行後、[モデル一覧] をクリックし、モデルを選択して、[EAS にデプロイ] をクリックします。
-
設定を確認します。詳細については、「モデルをオンラインサービスとしてデプロイ」をご参照ください。
[モデルファイル] と [プロセッサタイプ] は事前に設定されています。必要に応じて他のパラメーターを調整します。
-
[Deploy] をクリックします。
[サービスステータス] が [Creating] から [Running] に変わると、サービスがデプロイされたことになります。
重要不要な課金を避けるため、サービスが不要になったら [Actions] 列の [Stop] をクリックしてください。
関連ドキュメント
-
Designer は、モデル構築のためのパイプラインテンプレートを提供しています。詳細については、「テンプレートパイプライン」をご参照ください。
-
DataWorks を使用してオフラインパイプラインをスケジューリングし、モデルを定期的に更新します。詳細については、「DataWorksを使用したDesignerオフラインパイプラインのスケジューリング」をご参照ください。
-
グローバル変数を設定することで、オンラインサービスや DataWorks でスケジューリングされたジョブにおいて、パイプラインをより柔軟かつ効率的に利用できます。詳細については、「グローバル変数」をご参照ください。