画像動画生成 を利用する際に、 プロンプト最適化 や 公式動画エフェクト の呼び出しで 特定のアクション、エフェクト、スタイル に関するカスタム要件を満たせない場合は、 モデルファインチューニング を使用します。
適用範囲
-
適用リージョン:本ドキュメントで説明する機能は、シンガポールリージョンでのみ利用可能です。このリージョンで作成された API キー を使用する必要があります。
-
サポートされるファインチューニング手法:効率的な SFT-LoRA ファインチューニング。
-
ファインチューニングをサポートするモデル:
- 画像動画生成 (先頭フレームベース):wan2.7-i2v、wan2.6-i2v、wan2.5-i2v-preview、wan2.2-i2v-flash。
- 画像動画生成 (先頭・最終フレームベース):wan2.2-kf2v-flash。
モデルのファインチューニング方法
画像動画生成 (先頭フレームベース)
ファインチューニングの目標:マネーレインエフェクト用の LoRA モデルをトレーニングする。期待される結果:先頭フレーム画像を入力すると、プロンプトなしでモデルがマネーレインエフェクト付きの動画を生成する。
入力された先頭フレーム画像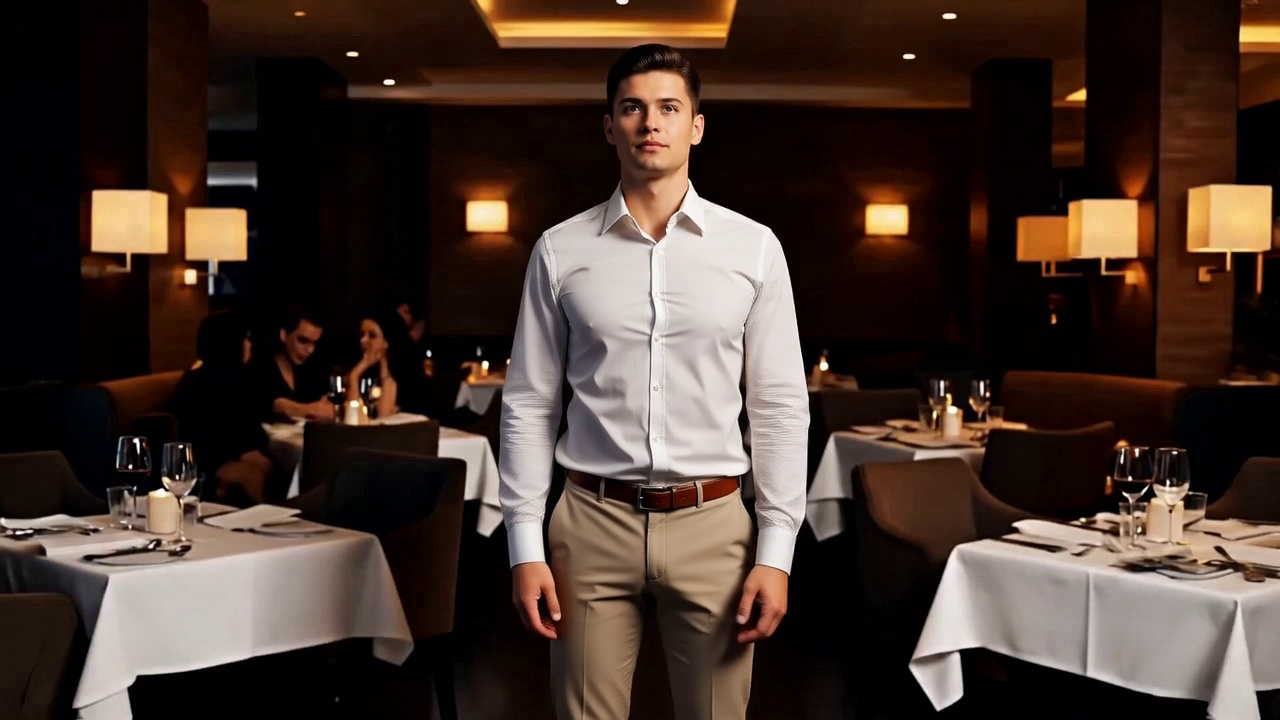 | 出力動画 (ファインチューニング前)
| 出力動画 (ファインチューニング後)
|
画像動画生成 (先頭・最終フレームベース)
ファインチューニングの目標:ファッション雑誌エフェクト用の LoRA モデルをトレーニングする。期待される結果:先頭フレーム画像と最終フレーム画像を入力すると、プロンプトなしでモデルがファッション雑誌エフェクト付きの動画を生成する。
入力された先頭フレーム画像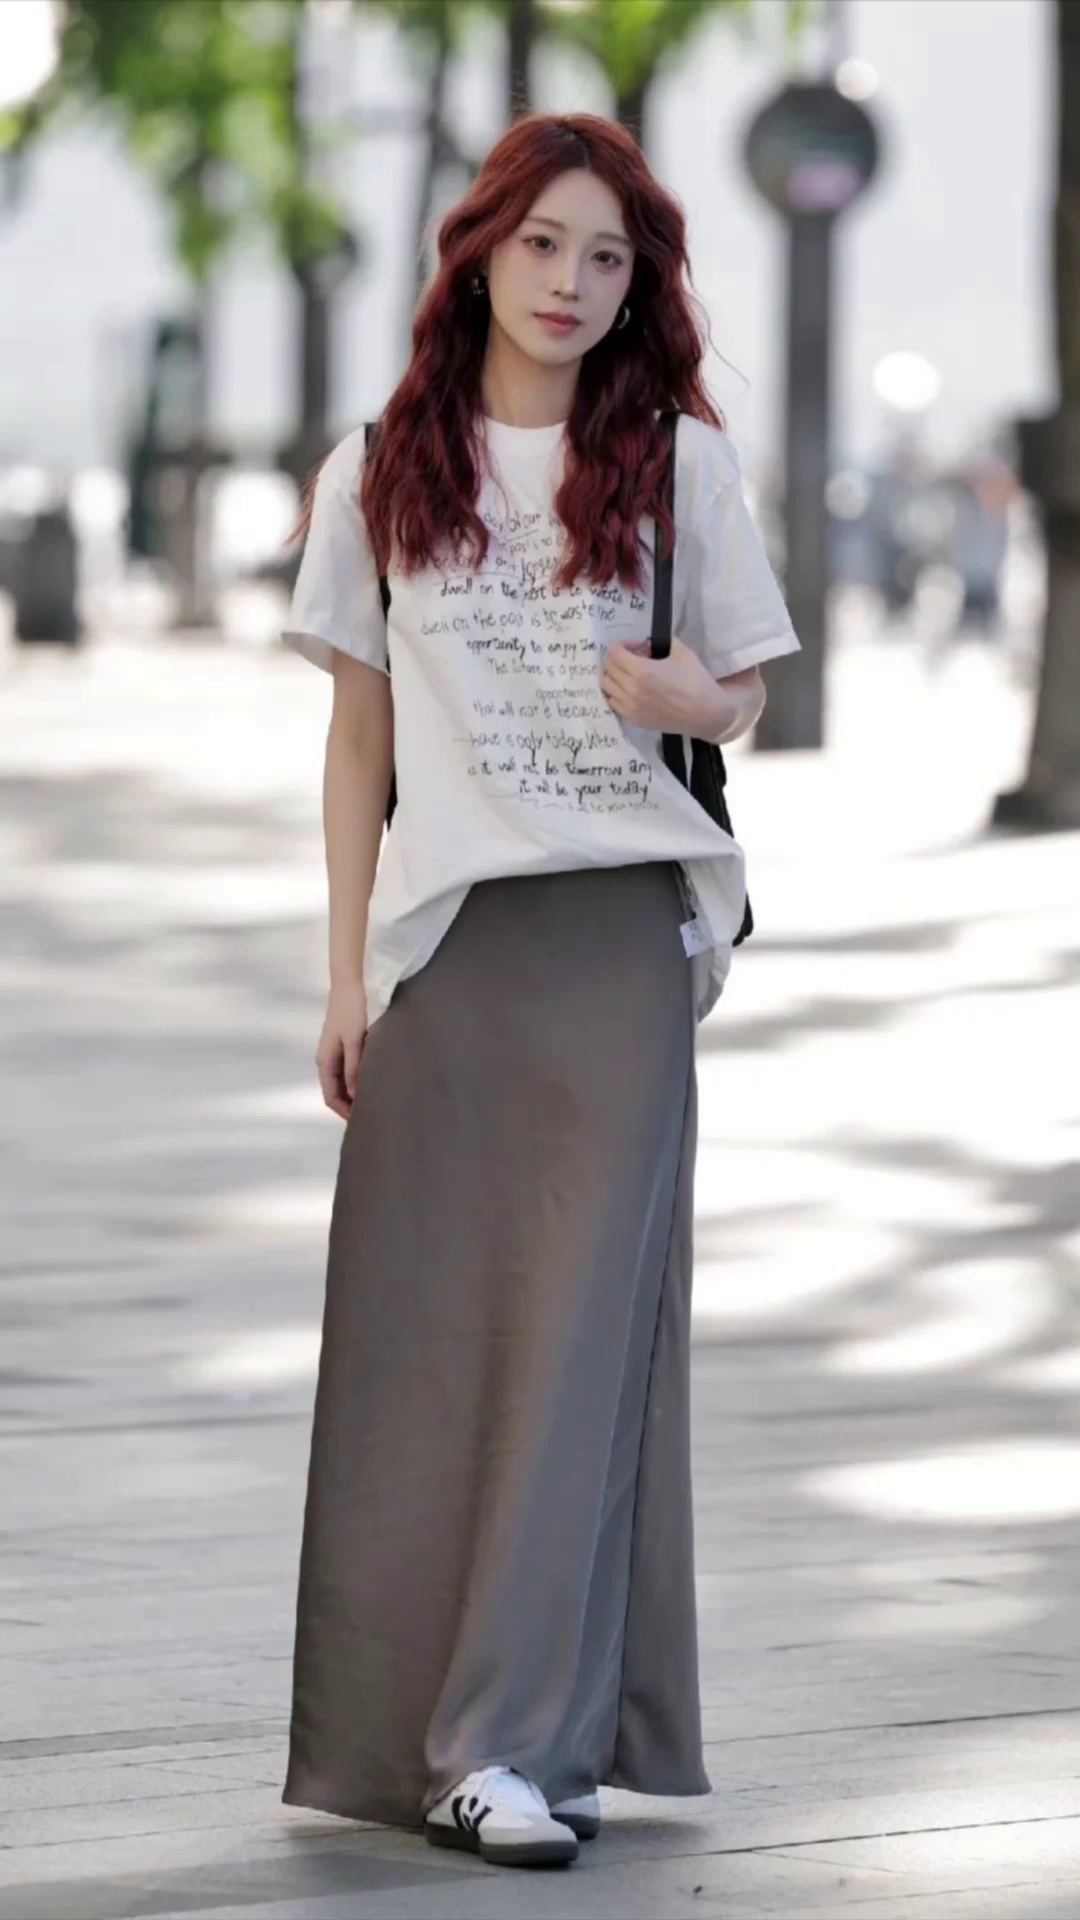 | 入力された最終フレーム画像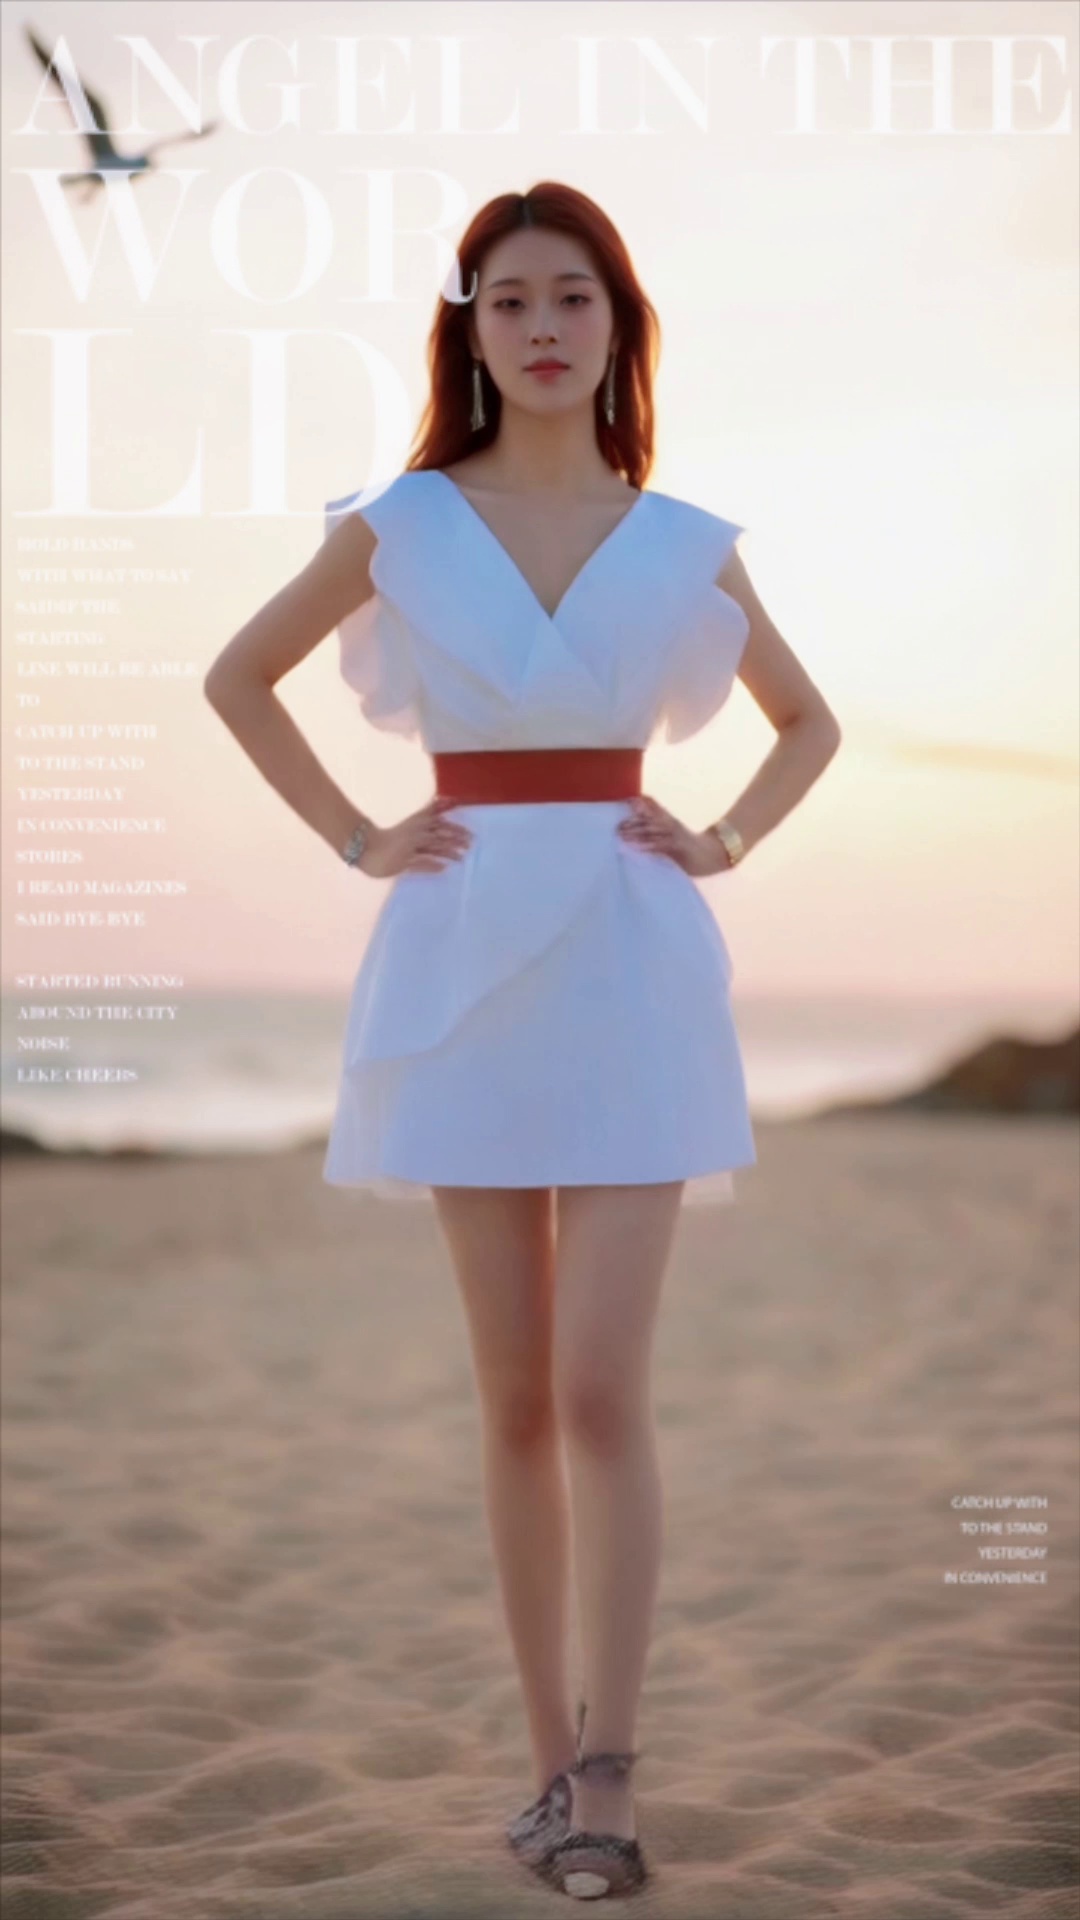 | 出力動画 (ファインチューニング前)
| 出力動画 (ファインチューニング後)
|
以下のコードを実行する前に、API キーと API ホストを取得し、API キーを設定してください。
ステップ 1:データセットのアップロード
ローカルのデータセット (.zip 形式) を Alibaba Cloud Model Studio にアップロードし、ファイル ID (id) を取得します。
トレーニングデータセットのサンプル:フォーマットの詳細はトレーニングセットをご参照ください。
- 画像動画生成 (先頭フレームベース):wan-i2v-training-dataset.zip。
- 画像動画生成 (先頭・最終フレームベース):wan-kf2v-training-dataset.zip。
この例では、先頭フレームベースの画像動画生成モデルを使用します。トレーニングセットのみをアップロードしてください。システムが自動的に一部を検証データセットとして分割します。データセットのアップロードには数分かかります。正確な時間はファイルサイズによって異なります。
curl --location --request POST 'https://dashscope-intl.aliyuncs.com/compatible-mode/v1/files' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--form 'file=@"./wan-i2v-training-dataset.zip"' \
--form 'purpose="fine-tune"'
id を保存します。これは、アップロードしたデータセットの一意の識別子です。
{
    "id": "file-ft-b2416bacc4d742xxxx",
    "object": "file",
    "bytes": 73310369,
    "filename": "wan-i2v-training-dataset.zip",
    "purpose": "fine-tune",
    "status": "processed",
    "created_at": 1766127125
}
ステップ 2:モデルのファインチューニング
ステップ 2.1 ファインチューニングジョブの作成
ステップ 1 で取得したファイル ID を使用してトレーニングを開始します。
リクエスト例前のステップで取得した id の値で <replace with training dataset file ID> を完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model": "wan2.7-i2v",
    "training_file_ids": [
        "<your-training-dataset-file-id>"
    ],
    "training_type": "efficient_sft",
    "hyper_parameters": {
        "n_epochs": 50,
        "batch_size": 1,
        "learning_rate": 2e-5,
        "split": 0.9,
        "max_split_val_dataset_sample": 5,
        "eval_epochs": 20,
        "max_pixels": 102400,
        "save_total_limit": 10,
        "lora_rank": 32,
        "lora_alpha": 32
    }
}'
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model": "wan2.2-kf2v-flash",
    "training_file_ids": [
        "<your-training-dataset-file-id>"
    ],
    "training_type": "efficient_sft",
    "hyper_parameters": {
        "n_epochs": 50,
        "batch_size": 4,
        "learning_rate": 2e-5,
        "split": 0.9,
        "max_split_val_dataset_sample": 5,
        "eval_epochs": 20,
        "max_pixels": 262144,
        "save_total_limit": 10,
        "lora_rank": 32,
        "lora_alpha": 32
    }
}'
フィールド | タイプ | 必須 | 説明 | 推奨値 |
|---|---|---|---|---|
batch_size | int | はい | バッチサイズ。一度にトレーニングのためにモデルに送信されるデータサンプルの数。 このパラメーターはインスタンスごとの設定です。各モデルのデフォルト値を使用することを推奨します。必要な場合以外は調整しないでください。
| モデルに依存 |
n_epochs | int | はい | トレーニングエポック。steps = n_epochs x ceiling(データセットサイズ / batch_size)。合計ステップ数は 800 以上である必要があります。
| 50 |
learning_rate | float | はい | 学習率。モデルの重み更新の大きさを制御します。高すぎるとモデルが劣化する可能性があり、低すぎると変更がごくわずかになる可能性があります。 | 2e-5 |
eval_epochs | int | はい | 評価間隔。値は | 20 |
max_pixels | int | はい | トレーニング動画の最大解像度 (総ピクセル数 = 幅 x 高さ)。システムは、この値を超える動画のみをスケーリングします。
| モデルに依存 |
split | float | いいえ | トレーニングセットの分割比率。値の範囲:(0,1)。validation_datasets が指定されていない場合にのみ有効です。 | 0.9 |
max_split_val_dataset_sample | int | いいえ | 自動分割による検証サンプルの最大数。検証数 = min(合計 x (1 - split), この値)。 | 5 |
save_total_limit | int | いいえ | 保持するチェックポイントの最大数。システムは最後の N 個のチェックポイントのみを保持します。 | 10 |
lora_rank | int | いいえ | LoRA の低ランク行列の次元。値は 2n (16/32/64) である必要があります。 | 32 |
lora_alpha | int | いいえ | LoRA の重みスケーリング係数。値は 2n (16/32/64) である必要があります。 | 32 |
output の中のこれら 3 つの主要なパラメーターを確認してください:
job_id:ジョブ ID。進捗状況の確認に使用します。finetuned_output:新しくファインチューニングされたモデルの名前。デプロイメントにこの名前を使用します。status:トレーニングステータス。ジョブ作成後、初期ステータスは PENDING です。トレーニングはまだ開始されていません。
{
    ...
    "output": {
        "job_id": "ft-202511111122-xxxx",
        "status": "PENDING",
        "finetuned_output": "xxxx-ft-202511111122-xxxx",
        ...
    }
}
ステップ 2.2 ファインチューニングジョブのステータス確認
ステップ 2.1 で取得した job_id を使用して進捗を確認します。status が SUCCEEDED になるまで、このエンドポイントをポーリングします。
注記このファインチューニングジョブには数時間かかります。正確な時間はモデルによって異なります。しばらくお待ちください。
URL 内の <replace with fine-tuning job job_id> を job_id の値で完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<your-job-id>' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json'
output フィールドのこれら 2 つのパラメーターを確認してください:
status:この値が SUCCEEDED になると、トレーニングは完了です。モデルをデプロイできます。usage:トレーニングに使用された合計トークン数。課金に使用されます。
{
    ...
    "output": {
        "job_id": "ft-202511111122-xxxx",
        "status": "SUCCEEDED",
        "usage": 432000,
        ...
    }
}
ステップ 3:ファインチューニング済みモデルのデプロイ
ステップ 3.1 モデルをオンラインサービスとしてデプロイ
ファインチューニングジョブのステータスが SUCCEEDED になった後、モデルをオンラインサービスとしてデプロイします。
リクエスト例ファインチューニングジョブの作成で取得した finetuned_output の値で <replace with model name model_name> を完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/deployments' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "<your-model-name>",
    "aigc_config": {
        "use_input_prompt": false,
        "prompt": "Provide a video description based on the image content. The description must include the phrase “Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding them. The bills continue to fall, while the camera slowly zooms in, they stretch their arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.”\nOutput Template:\nThe video begins with a shot of [subject description]. [Environment description]. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding them. The bills continue to fall, while the camera slowly zooms in, they stretch their arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.\nExample:\nThe video begins showing a young woman standing in front of a brick wall covered with ivy. She has long, smooth reddish-brown hair, wearing a white sleeveless dress, a shiny silver necklace, and a smile on her face. The brick wall in the background is covered with green vines, appearing rustic and natural. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding her. The bills continue to fall, while the camera slowly zooms in, she stretches her arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.",
        "lora_prompt_default": "Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding the main character. The bills continue to fall, while the camera slowly zooms in, the main character stretches their arms upward, neck slightly tilted back, with a surprised expression, completely immersed in this wild money rain."
    },
    "capacity": 1,
    "plan": "lora"
}'
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/deployments' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "<your-model-name>",
    "aigc_config": {
        "use_input_prompt": false,
        "prompt": "Provide a video description based on the image content. The description must include the phrase “Then they begin the s86b5p transformation.”\nOutput Template:\nThe video begins with a shot of [subject description]. [Environment description]. Then they begin the s86b5p transformation.\nExample:\nThe video begins with a young woman in an outdoor setting. She has short, curly dark brown hair and a friendly smile. She is wearing a black Polo shirt with colorful floral embroidery. The background features green vegetation and distant mountains. Then she begins the s86b5p transformation.",
        "lora_prompt_default": "Then they begin the s86b5p transformation."
    },
    "capacity": 1,
    "plan": "lora"
}'
output の中のこれら 2 つのパラメーターを確認してください:
deployed_model:デプロイ済みモデルの名前。デプロイメントステータスの確認とモデルの呼び出しに使用します。status:デプロイメントステータス。ファインチューニング済みモデルをデプロイした後、初期ステータスは PENDING です。デプロイメントはまだ開始されていません。
{
    ...
    "output": {
        "deployed_model": "xxxx-ft-202511111122-xxxx",
        "status": "PENDING",
        ...
    }
}
ステップ 3.2 デプロイメントステータスの確認
status が RUNNING になるまで、このエンドポイントをポーリングします。
注記このファインチューニング済みモデルのデプロイには約 5〜10 分かかります。
ステップ 3.1 で取得した deployed_model の値で <replace with deployed_model> を完全に置き換えます。
output フィールドのこれら 2 つのパラメーターを確認してください:
status:ステータスが RUNNING になると、モデルは正常にデプロイされました。呼び出しを開始できます。deployed_model:デプロイ済みモデルの名前。
{
    ...
    "output": {
        "status": "RUNNING",
        "deployed_model": "xxxx-ft-202511111122-xxxx",
        ...
    }
}
ステップ 4:モデルを呼び出して動画を生成
モデルのデプロイが成功した後 (デプロイメントの status が RUNNING の場合)、モデルの呼び出しを開始できます。
ステップ 4.1:動画生成タスクを作成し、task_id を取得する
前のステップで出力された deployed_model の値で <replace with deployed_model name> を置き換えます。
画像動画生成 (先頭フレームベース)
期待される結果:先頭フレーム画像を入力します。プロンプトは不要です。モデルは画像に基づいて「マネーレインエフェクト」付きの動画を自動的に生成します。
レスポンス例次のステップで結果をクエリするために、task_id をコピーして保存します。
{
    "output": {
        "task_status": "PENDING",
        "task_id": "0385dc79-5ff8-4d82-bcb6-xxxxxx"
    },
    "request_id": "4909100c-7b5a-9f92-bfe5-xxxxxx"
}
注記ファインチューニング済みの LoRA モデルを呼び出す際、Wan2.7 の入力パラメーターの使用方法は、Wan2.7 - 画像動画生成とほぼ同じです。Wan2.6/Wan2.5/Wan2.2 については、Wan - 画像動画生成 - 先頭フレーム API リファレンス (2.1-2.6)をご参照ください。
以下の表には、LoRA 固有のパラメーターの使用方法または制限のみが記載されています。ここに記載されていない一般的なパラメーター (例:duration) については、API ドキュメントをご参照ください。
フィールド | タイプ | 必須 | 説明 | 値の例 |
|---|---|---|---|---|
model | string | はい | モデル名。 正常にデプロイされ、ステータスが RUNNING のファインチューニング済みモデルを使用する必要があります。 | xxxx-ft-202511111122-xxxx |
input.prompt | string | いいえ | テキストプロンプト。 このパラメーターが有効になるかどうかは、aigc_config.use_input_prompt の設定に依存します:
| - |
parameters.resolution | string | いいえ | 生成される動画の解像度。 wan2.2 および wan2.5 モデル:480P、720P。デフォルトは 720P です。 wan2.6 モデル:720P、1080P。デフォルトは 720P です。 wan2.7 モデル:720P、1080P。デフォルトは 1080P です。 | 720P |
parameters.prompt_extend | boolean | いいえ | プロンプトリライトを有効にします。 ファインチューニングされた LoRA モデルを呼び出す際は、これを無効化し、false に設定してください。 | false |
画像動画生成 (先頭・最終フレームベース)
期待される結果:先頭フレーム画像と最終フレーム画像を入力します。プロンプトは不要です。モデルは画像に基づいて「ファッション雑誌エフェクト」付きの動画を自動的に生成します。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/services/aigc/image2video/video-synthesis' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--header 'X-DashScope-Async: enable' \
--data '{
    "model": "<デプロイしたモデル名に置き換えます>",
    "input": {
        "first_frame_url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20260113/typemn/kf2v-first.webp",
        "last_frame_url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20260113/ekzmff/kf2v_last.webp"
    },
    "parameters": {
        "resolution": "720P",
        "prompt_extend": false
    }
}'
次のステップで結果をクエリするために、task_id をコピーして保存します。
{
    "output": {
        "task_status": "PENDING",
        "task_id": "0385dc79-5ff8-4d82-bcb6-xxxxxx"
    },
    "request_id": "4909100c-7b5a-9f92-bfe5-xxxxxx"
}
注記ファインチューニング済みの LoRA モデルを呼び出す際、入力パラメーターの使用方法は、先頭・最終フレームベースの画像動画生成 API とほぼ同じです。
以下の表には、LoRA 固有のパラメーターの使用方法または制限のみが記載されています。ここに記載されていない一般的なパラメーター (例:duration) については、API リファレンスをご参照ください。
フィールド | タイプ | 必須 | 説明 | 値の例 |
|---|---|---|---|---|
model | string | はい | モデル名。 正常にデプロイされ、ステータスが RUNNING のファインチューニング済みモデルを使用する必要があります。 | xxxx-ft-202511111122-xxxx |
input.prompt | string | いいえ | テキストプロンプト。 このパラメーターが有効になるかどうかは、aigc_config.use_input_prompt の設定に依存します:
| - |
input.first_frame_url | string | はい | 先頭フレーム画像の URL。 これを渡す方法については、first_frame_url パラメーターをご参照ください。 | |
input.last_frame_url | string | いいえ | 最終フレーム画像の URL。 これを渡す方法については、last_frame_url パラメーターをご参照ください。 | |
parameters.resolution | string | いいえ | 生成される動画の解像度。 ファインチューニング済みモデルは 480P、720P をサポートします。デフォルトは 720P です。 | 720P |
parameters.prompt_extend | boolean | いいえ | プロンプトリライトを有効にします。 ファインチューニング済みの LoRA モデルを呼び出す際は、これを無効にします。false に設定してください。 | false |

ステップ 4.2:task_id を使用して結果をクエリする
task_id を使用してタスクステータスをポーリングし、task_status が SUCCEEDED になるまで待ちます。その後、動画の URL を取得します。
86ecf553-d340-4e21-xxxxxxxxxを実際の task_id に置き換えてください。
curl -X GET https://dashscope-intl.aliyuncs.com/api/v1/tasks/86ecf553-d340-4e21-xxxxxxxxx \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
動画 URL は 24 時間有効です。速やかに動画をダウンロードしてください。
{
    "request_id": "c87415d2-f436-41c3-9fe8-xxxxxx",
    "output": {
        "task_id": "a017e64c-012b-431a-84fd-xxxxxx",
        "task_status": "SUCCEEDED",
        "submit_time": "2025-11-12 11:03:33.672",
        "scheduled_time": "2025-11-12 11:03:33.699",
        "end_time": "2025-11-12 11:04:07.088",
        "orig_prompt": "",
        "video_url": "https://dashscope-result-sh.oss-cn-shanghai.aliyuncs.com/xxx.mp4?Expires=xxxx"
    },
    "usage": {
        "duration": 5,
        "video_count": 1,
        "SR": 480
    }
}
カスタムデータセットの構築
このガイドのサンプルデータセットを使用するだけでなく、ファインチューニング用に独自のデータセットを構築することもできます。
データセットにはトレーニングセット (必須) を含める必要があり、検証データセット (任意、トレーニングセットからの自動分割をサポート) を含めることもできます。すべてのファイルを .zip ファイルにパッケージ化します。ファイル名には英字、数字、アンダースコア、ハイフンのみを使用してください。
データセットのフォーマット
トレーニングセット:必須
画像動画生成 (先頭フレームベース)
トレーニングセットには、先頭フレーム画像、トレーニング動画、およびアノテーションファイル (data.jsonl) が含まれます。
- トレーニングセットのサンプル:wan-i2v-training-dataset.zip。
- ZIP ディレクトリ構造:
wan-i2v-training-dataset.zip
├── data.jsonl        # data.jsonl という名前にする必要があります。最大サイズ:20 MB。
├── image_1.jpeg      # 最大解像度:4096×4096。フォーマット:BMP、JPEG、PNG、WEBP。
├── video_1.mp4       # 最大解像度:4096×4096。フォーマット:MP4、MOV。
├── image_2.jpeg
└── video_2.mp4
- アノテーションファイル (data.jsonl):各行が 1 つのトレーニングサンプルです。JSON オブジェクトである必要があります。構造:
{
    "prompt": "The video begins showing a young woman standing in front of a brick wall covered with ivy. She has long, smooth reddish-brown hair, wearing a white sleeveless dress, a shiny silver necklace, and a smile on her face. The brick wall in the background is covered with green vines, appearing rustic and natural. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding her. The bills continue to fall, she stretches her arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.",
    "first_frame_path": "image_1.jpg",
    "video_path": "video_1.mp4"
}
画像動画生成 (先頭・最終フレームベース)
トレーニングセットには、先頭フレーム画像、最終フレーム画像、トレーニング動画、およびアノテーションファイル (data.jsonl) が含まれます。
- トレーニングセットのサンプル:wan-kf2v-training-dataset.zip。
- ZIP ディレクトリ構造:
wan-kf2v-training-dataset.zip
├── data.jsonl                # data.jsonl という名前にする必要があります。最大サイズ:20 MB。
├── image/                    # 先頭フレームと最終フレームの画像。
│   ├── image_1_first.jpg     # 最大解像度:4096×4096。フォーマット:BMP、JPEG、PNG、WEBP。
│   └── image_1_last.png
└── video/                    # トレーニング動画。
    ├── video_1.mp4           # 最大解像度:4096×4096。フォーマット:MP4、MOV。
    └── video_2.mov
- アノテーションファイル (data.jsonl):各行が 1 つのトレーニングサンプルです。JSON オブジェクトである必要があります。構造:
{
    "prompt": "The video begins by showing a young woman in an outdoor setting. She has short, curly dark brown hair, a smile on her face, and looks very friendly. She is wearing a black polo shirt with colorful floral embroidery, with a background of green vegetation and distant mountains. Then she begins the s86b5p transformation.",
    "first_frame_path": "image/image_1_first.jpg",
    "last_frame_path": "image/image_1_last.jpg",
    "video_path": "video/video_1.mp4"
}
検証データセット:任意
画像動画生成 (先頭フレームベース)
検証データセットには、先頭フレーム画像とアノテーションファイル (data.jsonl) が含まれます。動画は不要です。各評価ポイントで、トレーニングジョブは自動的にモデルサービスを呼び出し、検証画像とプロンプトを使用してプレビュー動画を生成します。
- 検証データセットのサンプル:wan-i2v-valid-dataset.zip。
- ZIP ディレクトリ構造:
wan-i2v-valid-dataset.zip
├── data.jsonl       # data.jsonl という名前にする必要があります。最大サイズ:20 MB。
├── image_1.jpeg     # 最大解像度:4096×4096。フォーマット:BMP、JPEG、PNG、WEBP。
└── image_2.jpeg
- アノテーションファイル (data.jsonl):各行が 1 つの検証サンプルです。JSON オブジェクトである必要があります。構造:
{
    "prompt": "The video begins showing a scene of a young man standing in front of a cityscape. He is wearing a black and white checkered jacket over a black hoodie, with a smile on his face and a confident expression. The background is a city skyline at sunset, with a famous domed building and layered roofs visible in the distance, the sky filled with clouds showing warm orange-yellow hues. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding him. The bills continue to fall while the camera slowly zooms in, he stretches his arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.",
    "first_frame_path": "image_1.jpg"
}
画像動画生成 (先頭・最終フレームベース)
検証データセットには、先頭フレーム画像、最終フレーム画像、およびアノテーションファイル (data.jsonl) が含まれます。動画は不要です。各評価ポイントで、トレーニングジョブは自動的にモデルサービスを呼び出し、検証画像とプロンプトを使用してプレビュー動画を生成します。
- 検証データセットのサンプル:wan-kf2v-valid-dataset.zip。
- ZIP ディレクトリ構造:
wan-kf2v-valid-dataset.zip
├── data.jsonl                 # data.jsonl という名前にする必要があります。最大サイズ:20 MB。
└── image/                     # 先頭フレームと最終フレームの画像。
    ├── image_1_first.jpg      # 最大解像度:4096×4096。フォーマット:BMP、JPEG、PNG、WEBP。
    └── image_1_last.jpg
- アノテーションファイル (data.jsonl):各行が 1 つの検証サンプルです。JSON オブジェクトである必要があります。構造:
{
    "prompt": "The video begins showing a scene of a young man standing in front of a cityscape. He is wearing a black and white checkered jacket over a black hoodie, with a smile on his face and a confident expression. The background is a city skyline at sunset, with a famous domed building and layered roofs visible in the distance, the sky filled with clouds showing warm orange-yellow hues. Then the s86b5p money rain effect begins, countless huge-sized US dollar bills (beige background/dark green patterns) pour down like a torrential rain, densely hitting and surrounding him. The bills continue to fall while the camera slowly zooms in, he stretches his arms upward, neck slightly tilted back, expression surprised, completely immersed in this wild money rain.",
    "first_frame_path": "image/image_1_first.jpg",
    "last_frame_path": "image/image_1_last.jpg",
}
データ規模と制限
-
データ量:少なくとも 10 サンプルを提供してください。トレーニングデータが多いほど、より良い結果が得られます。安定したパフォーマンスのためには 20〜100 サンプルを推奨します。
-
ZIP アーカイブ:API 経由でアップロードする場合、合計サイズは 1 GB 以下です。
-
トレーニング画像の要件:
- フォーマット:BMP、JPEG、PNG、WEBP。
- 解像度 ≤ 4096×4096。
- 個々のファイルサイズに厳密な制限はありません (システムが自動的に前処理します)。
-
トレーニング動画の要件:
- フォーマット:MP4、MOV。
- 解像度 ≤ 4096×4096。
- 個々のファイルサイズに厳密な制限はありません (システムが自動的に前処理します)。
- 動画ごとの持続時間:wan2.2 モデルでは 2〜5 秒を推奨、wan2.5 モデルでは 2〜10 秒を推奨、wan2.6 および wan2.7 モデルでは 2〜10 秒を推奨。
データ収集とクリーニング
1. ファインチューニングシナリオの定義
Wanxiang は、以下のシナリオで画像動画生成のファインチューニングをサポートします:
- 固定の動画エフェクト:カルーセルや魔法の衣装チェンジなど、特定の視覚的変化をモデルに学習させます。
- 固定のキャラクターアクション:ダンスの動きや武術の技など、特定の身体の動きを再現するモデルの能力を向上させます。
- 固定のカメラモーション:プッシュ、プル、パン、チルト、オービットショットなど、複雑な撮影技術を再現します。
2. 生アセットの収集
- AI 生成とフィルタリング:Wanxiang 基盤モデルを使用して動画をバッチ生成します。ターゲットエフェクトに最も一致する高品質なサンプルを手動で選択します。これが最も一般的な方法です。
- 実写撮影:インタラクティブなシーン (例:ハグ、握手) で高いリアリズムが必要な場合は、実際の映像を使用します。
- 3D ソフトウェアレンダリング:精密な制御が必要なエフェクトや抽象的なアニメーションには、3D ソフトウェア (例:Blender、Cinema 4D) を使用します。
3. データのクリーニング
ディメンション | 肯定的要件 | 悪い例 |
|---|---|---|
一貫性 | コアな特徴は非常に均一でなければなりません。 例:「360 度回転」のトレーニングでは、すべての動画がほぼ同じ速度で時計回りに回転する必要があります。 | 方向が混在している。 データセットに時計回りと反時計回りの両方の回転が含まれている。モデルはどちらの方向を学習すべきか分かりません。 |
多様性 | 被写体やシーンの多様性が高いほど良い。 さまざまな被写体 (男性、女性、子供、動物、建物) や構図 (クローズアップ、ワイドショット、ハイアングル、ローアングル) をカバーします。解像度やアスペクト比も多様化させます。 | 単一のシーンや被写体。 すべての動画が「白い壁の前で回転する赤い服の人」を示している。モデルは「赤い服」と「白い壁」をエフェクトの一部として誤って扱う可能性があります。服が変わると失敗します。 |
バランス | データタイプはバランスが取れているべきです。 複数のスタイルが存在する場合、それらの数はほぼ等しくあるべきです。 | 深刻な不均衡。 90% が縦長の動画で、10% が横長の動画。モデルは横長の動画でパフォーマンスが低下する可能性があります。 |
純粋さ | クリーンでクリアなビジュアル。 干渉のないオリジナルアセットを使用します。 | 干渉要素。 動画に字幕、ロゴ、ウォーターマーク、明らかな黒枠、またはノイズが含まれている。モデルはウォーターマークをエフェクトの一部として学習する可能性があります。 |
持続時間 | アセットの持続時間 ≤ ターゲットの持続時間。 5 秒の動画が必要な場合、アセットを 4〜5 秒にトリミングします。 | 長すぎるアセット。 5 秒の動画が必要なのに、モデルに 8 秒のアセットを与える。これにより、アクションの学習が不完全になり、途切れ途切れの感じになります。 |
動画アノテーション:動画のプロンプト作成
データセットのアノテーションファイル (data.jsonl) では、各動画に対応するプロンプトがあります。プロンプトは動画の内容を記述します。プロンプトの品質は、モデルが何を学習するかを直接決定します。
| プロンプト例 動画は、ツタで覆われたレンガの壁の前に立つ若い女性から始まります。彼女は長く滑らかな赤褐色の髪で、白いノースリーブのドレスを着て、光沢のある銀のネックレスをつけ、笑顔を浮かべています。背景は緑のツタで覆われたレンガの壁で、素朴で自然な雰囲気です。そして、s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼女を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼女は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。 |
プロンプト作成の公式
プロンプト = [被写体の説明] + [背景の説明] + [トリガーワード] + [動きの説明]プロンプト要素 | 説明 | ガイダンス | 例 |
|---|---|---|---|
主題の説明 | フレーム内に存在する人物やオブジェクトを説明する | 必須 | 動画は若い女性から始まります... |
背景の説明 | 被写体がいる環境を説明する | 必須 | 背景は緑のツタで覆われたレンガの壁です... |
トリガーワード | 珍しく、意味のない単語 | 推奨 | s86b5p または m01aa |
動きの説明 | エフェクト中の動的な変化を詳細に説明する | 推奨 | 巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ... |
良いプロンプトの書き方
エフェクト説明の一貫性ルールに従う
同じエフェクトを含むすべてのサンプルについて、動きの説明部分をできるだけ一貫させるようにしてください。このルールはトレーニングセットと検証セットの両方に適用します。
-
目的:モデルが
s86b5pの後に同じ固定された説明を見て、常にマネーレインが表示されると、s86b5p = マネーレインの視覚効果であると学習します。 -
例:被写体が「若い女性」であれ「スーツの男性」であれ、マネーレインエフェクトのプロンプトは同じように終わります:「...そして s86b5p のマネーレインエフェクトが始まり、無数の米ドル紙幣が豪雨のように降り注ぎ...」
サンプルの種類
プロンプトの内容 (下線部分の一貫性に注意)
トレーニングサンプル 1
動画はレンガの壁の前に立つ若い女性から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼女を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼女は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。トレーニングサンプル 2
動画は高級レストランにいるスーツの男性から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼を密集して打ちつけ、取り囲みます。紙幣は降り続け、彼は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。検証サンプル 1
動画は街並みの前に立つ幼い子供から始まります... (環境説明は省略)...
そして s86b5p のマネーレインエフェクトが始まり、巨大な米ドル紙幣 (ベージュの背景/濃い緑の模様) が豪雨のように降り注ぎ、彼を密集して打ちつけ、取り囲みます。紙幣は降り続け、カメラがゆっくりとズームインする間、彼は腕を上に伸ばし、首を少し後ろに傾け、驚いた表情で、この激しいマネーレインに完全に没頭しています。
AI を使用してプロンプトを生成する
高品質なプロンプトを得るために、Qwen-VL などのマルチモーダル大規模言語モデルを使用して支援を受けることができます。
-
AI を使用して初期の説明を生成する
-
自由形式のブレインストーミング (インスピレーションを見つける):エフェクトをどのように説明すればよいかわからない場合は、AI に自由に探求させます。
- 「
動画の内容を詳細に説明してください」と送信し、モデルの出力を観察します。 - モデルが動きの軌跡に使用する用語 (例:「豪雨のように降り注ぐ」、「カメラがゆっくりとズームインする」) に注目します。これらの用語は後の最適化に使用できます。
- 「
-
固定形式のプロンプト (出力を標準化する):大まかなアイデアが固まったら、固定形式を設計して、AI がテンプレートに一致するプロンプトを生成するように誘導します。
コード例
API 呼び出しの詳細については、「視覚理解」をご参照ください。
import os
from openai import OpenAI

client = OpenAI(
    # API キーは北京リージョンとシンガポールリージョンで異なります。API キーの取得:https://www.alibabacloud.com/help/zh/model-studio/get-api-key
    # 環境変数を設定していない場合は、次の行を api_key="sk-xxx" に置き換えてください。
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # シンガポールリージョンのベース URL。北京リージョンの場合は、https://dashscope.aliyuncs.com/compatible-mode/v1 に置き換えてください。
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3-vl-plus",
    messages=[
        {"role": "user","content": [{
            # 動画ファイルを直接渡す場合、type を video_url に設定します。
            # OpenAI SDK を使用する場合、フレームはデフォルトで 0.5 秒ごとにサンプリングされ、変更できません。カスタムフレームレートの場合は、DashScope SDK を使用してください。
            "type": "video_url",
            "video_url": {"url": "https://cloud.video.taobao.com/vod/Tm1s_RpnvdXfarR12RekQtR66lbYXj1uziPzMmJoPmI.mp4"}},
            {"type": "text", "text": "Analyze the video carefully and generate a detailed video description using the following fixed format:"
                                    "Format template: The video begins with [subject description]. The background is [background description]. Then the s86b5p melting effect begins, [detailed motion description]."
                                    "Requirements:"
                                    "1.[Subject description]: Describe people or objects in the frame in detail, including appearance, clothing, and expressions."
                                    "2.[Background description]: Describe the environment, lighting, and weather in detail."
                                    "3.[Motion description]: Describe dynamic changes during the effect (e.g., how objects move, how lighting changes, how the camera moves)."
                                    "4.Integrate all content naturally into the format. Do not keep “[ ]” symbols or add unrelated text."}]
         }]
)
print(completion.choices[0].message.content)
-
-
エフェクトテンプレートの抽出
- 同じエフェクトを持つサンプルでこのプロセスを複数回実行します。エフェクトを説明するために使用される高頻度で正確なフレーズを特定します。一般的な「エフェクト説明」を抽出します。
- この標準化されたエフェクト説明を、そのエフェクトのすべてのサンプルにコピー&ペーストします。
- 各サンプルのユニークな「被写体」と「背景」の説明は保持します。「エフェクト説明」部分のみを統一されたテンプレートに置き換えます。
-
手動レビュー
AI はハルシネーションを起こしたり、検出エラーを犯したりする可能性があります。最終ステップとして、手動でチェックを行います。例えば、エンティティと背景の説明が実際のシーンと一致しているかを確認します。
検証データセットを使用したモデルの評価
検証データセットの指定
ファインチューニングジョブにはトレーニングセットが必要です。検証データセットは任意です。システムに自動分割させるか、手動でアップロードするかを選択できます。以下のように指定します:
方法 1:検証データセットをアップロードしない (システムが自動分割)
ファインチューニングジョブを作成する際に、別の検証データセットをアップロードしない場合、つまり validation_file_ids パラメーターが渡されない場合、システムは以下の 2 つのハイパーパラメーターに基づいてトレーニングセットの一部を自動的に分割して検証セットとして使用します:
split:分割するトレーニングデータの割合。例えば、0.9 は 90% をトレーニング用、10% を検証用とすることを意味します。max_split_val_dataset_sample:自動分割される検証セットの最大サンプル数。
検証セットの分割ルール:システムは データセットサイズ × (1 - split) と max_split_val_dataset_sample の小さい方の値を選択します。
-
例:100 サンプルのトレーニングセットのみをアップロードし、split=0.9 (10% が検証用)、max_split_val_dataset_sample=5 とします。
- 理論上の分割:100 × 10% = 10 サンプル。
- 実際の分割:min(10, 5)=5。したがって、システムは検証セットにわずか 5 サンプルしか使用しません。
方法 2:検証データセットを手動でアップロードする (validation_file_ids を使用)
ランダムなシステム分割に頼るのではなく、独自に準備したデータでチェックポイントを評価したい場合は、カスタム検証データセットをアップロードします。
注意:手動アップロードを選択すると、システムは上記の自動分割ルールを無視し、アップロードしたデータのみで検証します。
デプロイメントに最適なチェックポイントの選択
トレーニング中、システムは定期的に「スナップショット」(チェックポイント) を保存します。デフォルトでは、システムは最終チェックポイントをファインチューニング済みモデルとして出力します。しかし、中間チェックポイントが最終バージョンを上回ることもあります。デプロイメントに最適なものを選択できます。
システムは、ハイパーパラメーター eval_epochs で定義された間隔で、検証セット上でチェックポイントを実行し、プレビュー動画を生成します。
- 評価:プレビュー動画を直接見て判断します。
- 選択基準:最高の視覚品質で、動きの歪みがないチェックポイントを選択します。
手順
ステップ 1:チェックポイントのプレビュー結果の表示
ステップ 1.1 検証済みチェックポイントのリスト表示
この API は、検証に合格し、プレビュー動画の生成に成功したチェックポイントのみを返します。失敗したチェックポイントはリストされません。
リクエスト例<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成 API からのjob_idで完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine-tuning_job_id>/validation-results' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json'
この API は、検証に合格したチェックポイント名のリストを返します。
{
    "request_id": "da1310f5-5a21-4e29-99d4-xxxxxx",
    "output": [
        {
            "checkpoint": "checkpoint-160"
        },
        ...
    ]
}
ステップ 1.2 チェックポイントの検証結果の表示
上記のリストから 1 つのチェックポイント (例:「checkpoint-160」) を選択し、その動画結果を表示します。
リクエスト例<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。<replace_with_selected_checkpoint>:チェックポイントの値 (例:「checkpoint-160」) で完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine-tuning_job_id>/validation-details/<replace_with_selected_checkpoint>?page_no=1&page_size=10' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
プレビュー動画の URL は video_path です。24 時間有効です。速やかにダウンロードして確認してください。このステップを繰り返して複数のチェックポイントを比較し、最適なものを見つけます。
{
    "request_id": "375b3ad0-d3fa-451f-b629-xxxxxxx",
    "output": {
        "page_no": 1,
        "page_size": 10,
        "total": 1,
        "list": [
            {
                "video_path": "https://finetune-result.oss-cn-wulanchabu.aliyuncs.com/xxx.mp4?Expires=xxxx",
                "prompt": "The video begins with a young man sitting in a cafe...",
                "first_frame_path": "https://finetune-result.oss-cn-wulanchabu.aliyuncs.com/xxx.jpeg"
            }
        ]
    }
}
ステップ 2:チェックポイントをエクスポートし、デプロイ用のモデル名を取得する
ステップ 2.1 モデルのエクスポート
「checkpoint-160」が最良の結果をもたらすと仮定します。これをエクスポートします。
リクエスト例<replace_with_fine_tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。<replace_with_checkpoint_to_export>:チェックポイントの値 (例:「checkpoint-160」) で完全に置き換えます。<replace_with_exported_model_name_for_console_display>:コンソール表示用のカスタムモデル名 (例:「wan2.5-checkpoint-160」) で完全に置き換えます。この名前はグローバルに一意である必要があります。重複した名前は許可されません。パラメーターのガイダンスについては、チェックポイントのエクスポートをご参照ください。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine-tuning_job_id>/export/<replace_with_checkpoint_to_export>?model_name=<replace_with_exported_model_name_for_console_display>' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
レスポンスパラメーター output=true は、エクスポートリクエストが正常に作成されたことを意味します。
{
    "request_id": "0817d1ed-b6b6-4383-9650-xxxxx",
    "output": true
}
ステップ 2.2 デプロイ後の新しいモデル名のクエリ
すべてのチェックポイントのステータスをクエリして、エクスポートの完了を確認し、デプロイ用の一意のモデル名 (model_name) を取得します。
<replace_with_fine-tuning_job_id>:ファインチューニングジョブの作成からのjob_idで完全に置き換えます。
curl --location 'https://dashscope-intl.aliyuncs.com/api/v1/fine-tunes/<replace_with_fine-tuning_job_id>/checkpoints' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY"
返されたリストで、エクスポートされたチェックポイント (例:checkpoint-160) を見つけます。その status が SUCCEEDED になると、エクスポートは成功です。model_name フィールドが、デプロイメントと呼び出し用の新しいモデル名です。
{
    "request_id": "b0e33c6e-404b-4524-87ac-xxxxxx",
    "output": [
         ...,
        {
            "create_time": "2025-11-11T13:27:29",
            "full_name": "ft-202511111122-496e-checkpoint-160",
            "job_id": "ft-202511111122-496e",
            "checkpoint": "checkpoint-160",
            "model_name": "xxxx-ft-202511111122-xxxx-c160", // 重要フィールド。モデルのデプロイメントと呼び出しに使用します。
            "model_display_name": "xxxx-ft-202511111122-xxxx",
            "status": "SUCCEEDED" // 正常にエクスポートされたチェックポイント。
        },
        ...

    ]
}
ステップ 3:モデルのデプロイと呼び出し
チェックポイントを正常にエクスポートし、model_name を取得した後、以下のステップに従います:
- モデルのデプロイメント:入力パラメーター
model_nameに、エクスポート後に取得した特定の値を入力します。 - モデルの呼び出し:API ドキュメントに従って、デプロイされたモデルを呼び出します。
本番運用
本番環境で、最初にトレーニングしたモデルのパフォーマンスが低い場合 (例:視覚的な歪み、弱いエフェクト、不正確な動き)、以下のディメンションに沿って調整します:
1. データとプロンプトの確認- データの一貫性:一貫性は非常に重要です。逆方向や大きく異なるスタイルの「不良サンプル」がないか確認してください。
- サンプル数:高品質なデータを 20 サンプル以上に増やしてください。
- プロンプト:トリガーワードが意味のない、珍しい用語 (例:s86b5p) であることを確認してください。干渉を引き起こす一般的な単語 (例:running) は避けてください。
-
n_epochs (トレーニングエポック)
-
デフォルト:50。必要な場合以外はデフォルトを使用してください。調整する場合は、「合計トレーニングステップ数 ≥ 800」のルールに従ってください。
-
合計ステップ数の数式:
steps = n_epochs × ceiling (トレーニングセットサイズ / バッチサイズ)。 -
n_epochs の最小値の数式:
n_epochs = 800 / ceiling (データセットサイズ / バッチサイズ)。 -
例:5 サンプルのトレーニングセットがあり、Wan2.5 モデル (batch_size=4) を使用するとします。
- エポックあたりのステップ数:5 / 4 = 1.25、切り上げて 2。合計エポック数:n_epochs = 800 / 2 = 400。これが推奨される最小値です。必要に応じて増やすことができます。
-
-
batch_size (バッチサイズ)
- バッチサイズ。一度にトレーニングのためにモデルに送信されるデータサンプルの数。
- このパラメーターはインスタンスごとの設定です。各モデルのデフォルト値を使用することを推奨します。必要な場合以外は調整しないでください。
- wan2.7-i2v:推奨値:1。
- wan2.5-i2v-preview:推奨値:4。
- wan2.2-i2v-flash:推奨値:4。
- wan2.2-kf2v-flash:推奨値:4。
トレーニングジョブで実行される実際のインスタンス数は、プラットフォームのスケジューリングによって決定されます。トレーニングログの Global Step 出力は推定結果と異なる場合がありますが、これはトレーニングデータの総量や最終的なモデルのパフォーマンスには影響しません。
-
learning_rate (学習率):デフォルト値 (2e-5) を使用してください。通常、変更は不要です。
課金
-
モデルトレーニング:課金対象。
- コスト = 合計トレーニングトークン数 × 単価。モデルトレーニングの課金をご参照ください。
- トレーニング後、ファインチューニングジョブのステータスをクエリする API の
usageフィールドで消費された合計トークン数を確認してください。
-
モデルデプロイメント:無料。
-
モデルの呼び出し:課金対象。
- ファインチューニングされた基盤モデルの標準呼び出し価格に従って課金されます。モデルの価格設定をご参照ください。
API リファレンス
よくある質問
Q:トレーニングセットと検証セットのデータ量はどのように計算されますか?
A:トレーニングセットは必須で、検証セットは任意です。計算方法は以下の通りです:
-
検証セットが提供されていない場合:アップロードされたトレーニングセットが「合計データセットサイズ」となります。システムは自動的にデータの一部を検証用に分割します。
- 検証セットサイズ =
min(合計データセットサイズ × (1 − split), max_split_val_dataset_sample)。例については、検証データセットの指定をご参照ください。 - トレーニングセットサイズ =
合計データセットサイズ − 検証セットサイズ。
- 検証セットサイズ =
-
検証セットが手動でアップロードされた場合:システムはトレーニングデータから検証セットを分割しなくなります。
- トレーニングセットサイズ = アップロードされたトレーニングセットのデータ量。
- 検証セットサイズ = アップロードされた検証セットのデータ量。
Q:良いトリガーワードを設計するにはどうすればよいですか?
A:以下のルールに従ってください:
- 意味のない文字の組み合わせを使用します。例:sksstyle、a8z2_bbb。
- 一般的な英単語 (例:beautiful、fire、dance) は避けてください。これにより、モデルがこれらの単語に対して元々持っている理解を汚染するのを防ぎます。
Q:ファインチューニングで動画の解像度や持続時間を変更できますか?
A:いいえ。ファインチューニングは「内容」と「ダイナミクス」を学習するものであり、「仕様」ではありません。出力動画のフォーマット (解像度、フレームレート、最大持続時間) は、依然として基盤モデルによって決定されます。