視覚理解モデルは、提供された画像や動画に基づいて質問に回答できます。単一または複数の画像入力に対応し、画像キャプション、視覚質問応答、物体位置特定など、さまざまなタスクに適しています。
オンラインで試す:Alibaba Cloud Model Studio コンソールに移動します。ページの右上隅で、ターゲットリージョンを選択します。その後、Vision Models ページに移動してモデルを試します。
はじめに
前提条件- API キーを取得し、環境変数として設定します。
- SDK を使用して呼び出しを行うには、SDK をインストールします。DashScope Python SDK はバージョン 1.24.6 以降、DashScope Java SDK はバージョン 2.21.10 以降である必要があります。
以下の例は、モデルを呼び出して画像の内容を説明する方法を示しています。ローカルファイルと画像の制限に関する詳細については、「ローカルファイルの渡し方」および「画像の制限」をご参照ください。
OpenAI 互換
Python
from openai import OpenAI
import os

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
    model="qwen3.8-max",  # この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"
                    },
                },
                {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"},
            ],
        },
    ],
)
print(completion.choices[0].message.content)
応答
これはビーチで撮影された写真です。写真には、人と犬が砂の上に座っており、背景には海と空が写っています。人と犬は交流しているようで、犬の前足が人の手に乗っています。フレームの右側から太陽光が差し込み、シーンに暖かい雰囲気を加えています。
Node.js
import OpenAI from "openai";

const openai = new OpenAI({
  // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
  // 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
  apiKey: process.env.DASHSCOPE_API_KEY,
  // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
  baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
});

async function main() {
  const response = await openai.chat.completions.create({
    model: "qwen3.8-max",   // この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages: [
      {
        role: "user",
        content: [{
            type: "image_url",
            image_url: {
              "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"
            }
          },
          {
            type: "text",
            text: "画像にはどのようなシーンが描かれていますか?"
          }
        ]
      }
    ]
  });
  console.log(response.choices[0].message.content);
}
main()
応答
これはビーチで撮影された写真です。写真には、人と犬が砂の上に座っており、背景には海と空が写っています。人と犬は交流しているようで、犬の前足が人の手に乗っています。フレームの右側から太陽光が差し込み、シーンに暖かい雰囲気を加えています。
Java
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.http.StreamResponse;
import com.openai.models.chat.completions.*;

import java.util.List;

public class Main {
    public static void main(String[] args) {
        // 環境変数から API キーを使用してクライアントを作成します
        OpenAIClient client = OpenAIOkHttpClient.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Bailian API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
                .baseUrl("https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1")
                .build();

        // マルチモーダルメッセージのコンテンツを構築します:画像 + テキスト
        ChatCompletionContentPart imagePart = ChatCompletionContentPart.ofImageUrl(
                ChatCompletionContentPartImage.builder()
                        .imageUrl(ChatCompletionContentPartImage.ImageUrl.builder()
                                .url("https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg")
                                .build())
                        .build());
        ChatCompletionContentPart textPart = ChatCompletionContentPart.ofText(
                ChatCompletionContentPartText.builder()
                        .text("画像にはどのようなシーンが描かれていますか?")
                        .build());

        // チャットリクエストを作成します
        ChatCompletionCreateParams chatParams = ChatCompletionCreateParams.builder()
                // この例では qwen3.8-max を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
                .model("qwen3.8-max")
                .addUserMessageOfArrayOfContentParts(List.of(imagePart, textPart))
                .build();

        StringBuilder fullResponse = new StringBuilder();

        // すべてのコード例では、モデルの出力プロセスを明確に示すためにストリーミング出力を使用しています。非ストリーミングの例については、https://www.alibabacloud.com/help/ja/model-studio/text-generation をご参照ください
        try (StreamResponse<ChatCompletionChunk> streamResponse = client.chat().completions().createStreaming(chatParams)) {
            streamResponse.stream().forEach(chunk -> {
                System.out.println(chunk);
                String content = chunk.choices().get(0).delta().content().orElse("");
                if (!content.isEmpty()) {
                    fullResponse.append(content);
                }
            });
            System.out.println(fullResponse);
        } catch (Exception e) {
            System.err.println("エラーメッセージ: " + e.getMessage());
            System.err.println("参照: https://www.alibabacloud.com/help/ja/model-studio/developer-reference/error-code");
        }
    }
}
応答
これはビーチで撮影された写真です。写真には、人と犬が砂の上に座っており、背景には海と空が写っています。人と犬は交流しているようで、犬の前足が人の手に乗っています。フレームの右側から太陽光が差し込み、シーンに暖かい雰囲気を加えています。
curl
# ======= 重要事項 =======
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
  "model": "qwen3.8-max",
  "messages": [
    {"role": "user",
     "content": [
        {"type": "image_url", "image_url": {"url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"}},
        {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"}
    ]
  }]
}'
応答
{
  "choices": [
    {
      "message": {
        "content": "これはビーチで撮影された写真です。写真には、人と犬が砂の上に座っており、背景には海と空が写っています。人と犬は交流しているようで、犬の前足が人の手に乗っています。フレームの右側から太陽光が差し込み、シーンに暖かい雰囲気を加えています。",
        "role": "assistant"
      },
      "finish_reason": "stop",
      "index": 0,
      "logprobs": null
    }
  ],
  "object": "chat.completion",
  "usage": {
    "prompt_tokens": 1270,
    "completion_tokens": 54,
    "total_tokens": 1324
  },
  "created": 1725948561,
  "system_fingerprint": null,
  "model": "qwen3.8-max",
  "id": "chatcmpl-0fd66f46-b09e-9164-a84f-3ebbbedbac15"
}
DashScope
Python
import os
import dashscope

# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

messages = [
{
    "role": "user",
    "content": [
    {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},
    {"text": "画像にはどのようなシーンが描かれていますか?"}]
}]

response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',   # この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages
)

print(response.output.choices[0].message.content[0]["text"])
応答
これはビーチで撮影された写真です。写真には女性と犬が写っています。女性は砂の上に座り、笑顔で犬と交流しています。犬は首輪をつけており、女性と握手しているようです。背景は海と空で、彼らに当たる太陽光が暖かい雰囲気を醸し出しています。
Java
import java.util.Arrays;
import java.util.Collections;

import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    static {
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    public static void simpleMultiModalConversationCall()
            throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(
                        Collections.singletonMap("image", "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"),
                        Collections.singletonMap("text", "画像にはどのようなシーンが描かれていますか?"))).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")  //  この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
                .messages(Arrays.asList(userMessage))
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }
    public static void main(String[] args) {
        try {
            simpleMultiModalConversationCall();
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
応答
これはビーチで撮影された写真です。写真には、チェック柄のシャツを着た人と首輪をつけた犬が写っています。人と犬は向かい合って座っており、交流しているようです。背景は海と空で、彼らに当たる太陽光が暖かい雰囲気を醸し出しています。
curl
# ======= 重要事項 =======
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
                "role": "user",
                "content": [
                    {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},
                    {"text": "画像にはどのようなシーンが描かれていますか?"}
                ]
            }
        ]
    }
}'
応答
{
  "output": {
    "choices": [
      {
        "finish_reason": "stop",
        "message": {
          "role": "assistant",
          "content": [
            {
              "text": "これはビーチで撮影された写真です。写真には、チェック柄のシャツを着た人と首輪をつけた犬が写っています。彼らは砂の上に座っており、背景には海と空が写っています。フレームの右側から太陽光が差し込み、シーンに暖かい雰囲気を加えています。"
            }
          ]
        }
      }
    ]
  },
  "usage": {
    "output_tokens": 55,
    "input_tokens": 1271,
    "image_tokens": 1247
  },
  "request_id": "ccf845a3-dc33-9cda-b581-20fe7dc23f70"
}
モデルのパフォーマンス
画像 Q&A
画像の内容を説明したり、人物、場所、動物、植物などを識別して分類・ラベル付けしたりします。
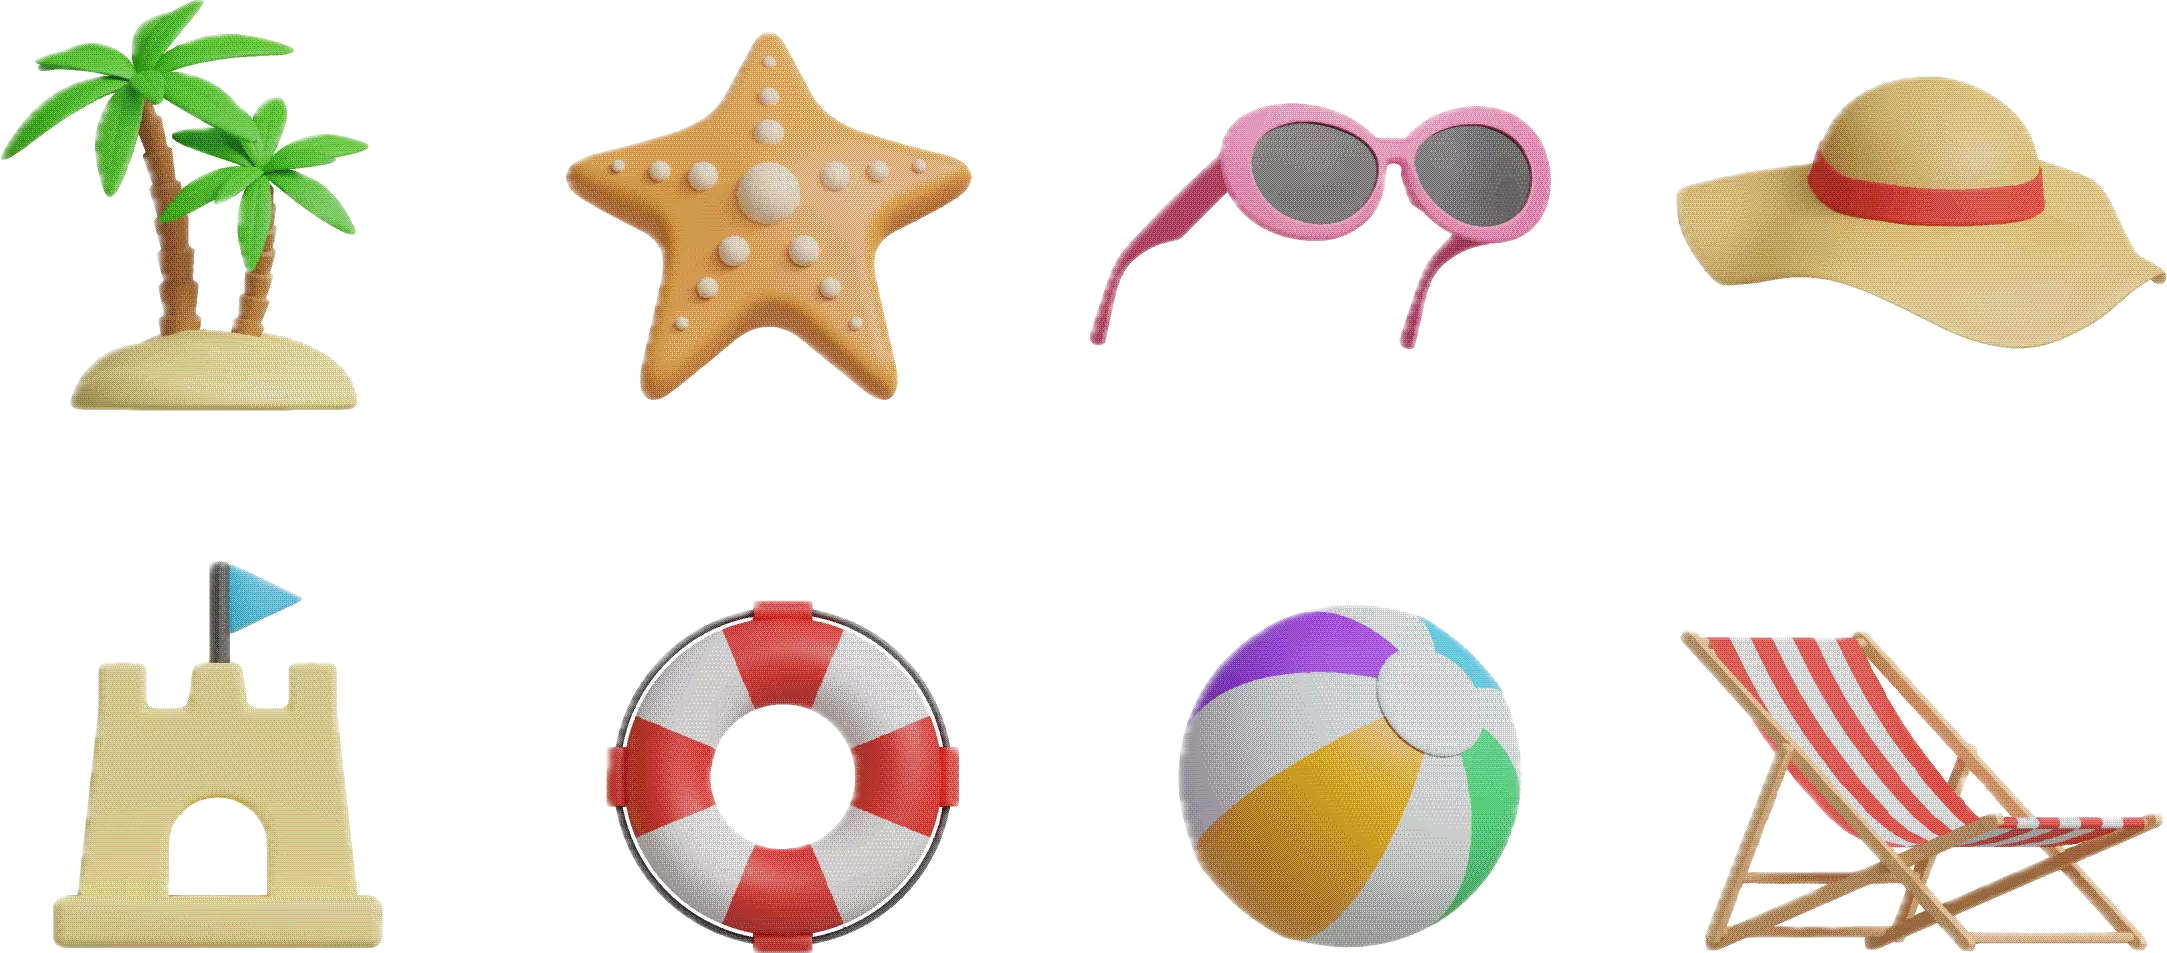
この画像の中で、太陽が眩しすぎるときに使うべきアイテムは何ですか? | 太陽が眩しすぎる場合は、画像にあるピンクのサングラスを使用すべきです。サングラスは強い光を効果的に遮断し、紫外線による目へのダメージを軽減し、明るい日差しの中での視力を保護し、視覚的な快適さを向上させるのに役立ちます。 |
|---|
クリエイティブライティング
画像や動画の内容に基づいて鮮やかなテキスト記述を生成し、物語の執筆、コピーライティング、ショートビデオのスクリプトなどのクリエイティブなシナリオに適しています。
画像の内容に基づいて、面白い SNS 投稿を作成してください。 | 承知いたしました。この画像は豊かな中秋節の雰囲気に満ちており、古典的な要素と現代的な要素を巧みに組み合わせています。画像内の主要な要素に基づいて、異なるスタイルの SNS 投稿をいくつかご用意しましたので、お選びください。 詩的で美しいスタイル 今宵、月は誰の目にも明るく輝くが、秋の想いがどこに落ちるかは誰にもわからない。嫦娥は月に飛び、玉兎は薬をつく。古人のロマンスが今宵、灯される。この明るい月があなたの帰り道を照らし、私の深い想いを運びますように。中秋節おめでとうございます! 温かい願いのスタイル 月は満ち、人々は再会する。中秋の夜は最も穏やかだ。花火が咲くのを見て、空に浮かぶ満月を愛で、月餅を一口食べ、健康を願う。あなたと私の願いがすべて叶いますように。皆様、中秋節おめでとうございます。ご家族が幸せでありますように! |

テキスト認識と情報抽出
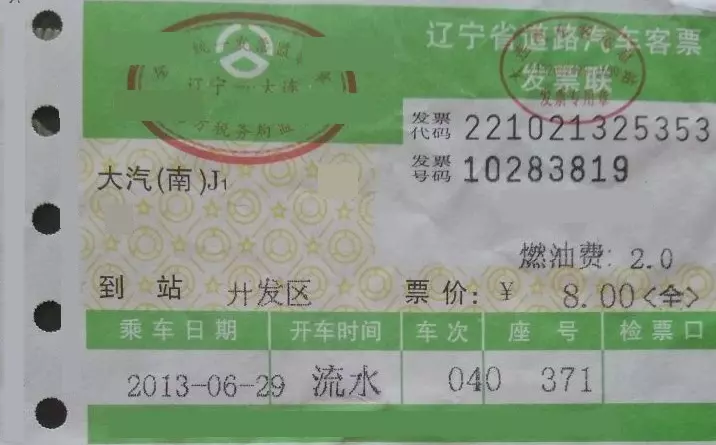
画像内のテキストや数式を認識したり、領収書、証明書、フォームから情報を抽出したりします。フォーマットされたテキスト出力に対応しています。
画像から次の情報を抽出してください:['請求書コード', '請求書番号', '目的地', '燃料サーチャージ', '運賃', '日付', '出発時刻', '列車番号', '座席番号']。JSON 形式で出力してください。 | { "Invoice Code": "221021325353", "Invoice Number": "10283819", "Destination": "開発区", "Fuel Surcharge": "2.0", "Fare": "8.00<Full>", "Date": "2013-06-29", "Departure Time": "随時", "Train Number": "040", "Seat Number": "371" } |
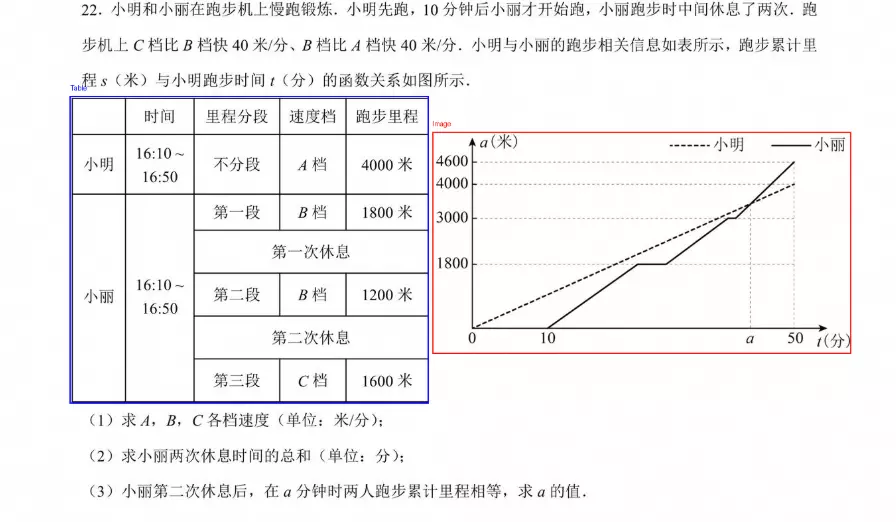
多分野にわたる問題解決
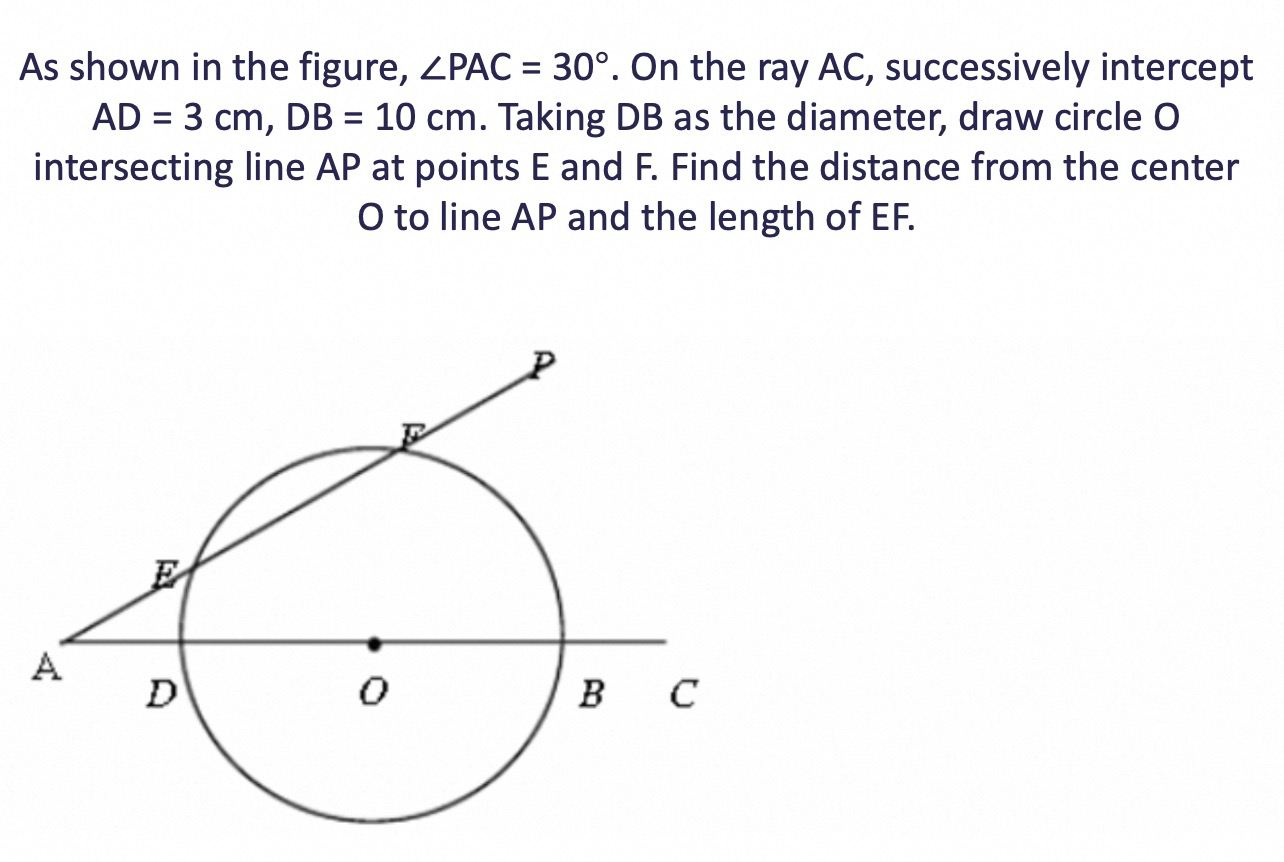
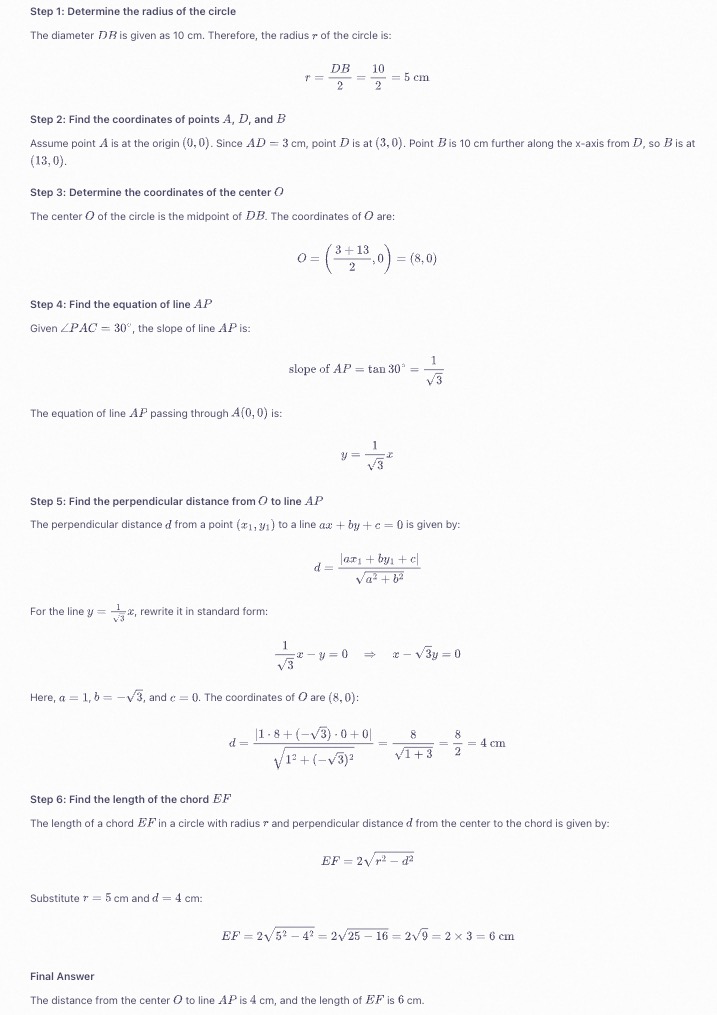
画像内の数学、物理、化学などの問題を解決します。K-12、大学、成人教育に適しています。
グラフ内の数学の問題を段階的に解いてください。 |
|
|---|
ビジュアルプログラミング
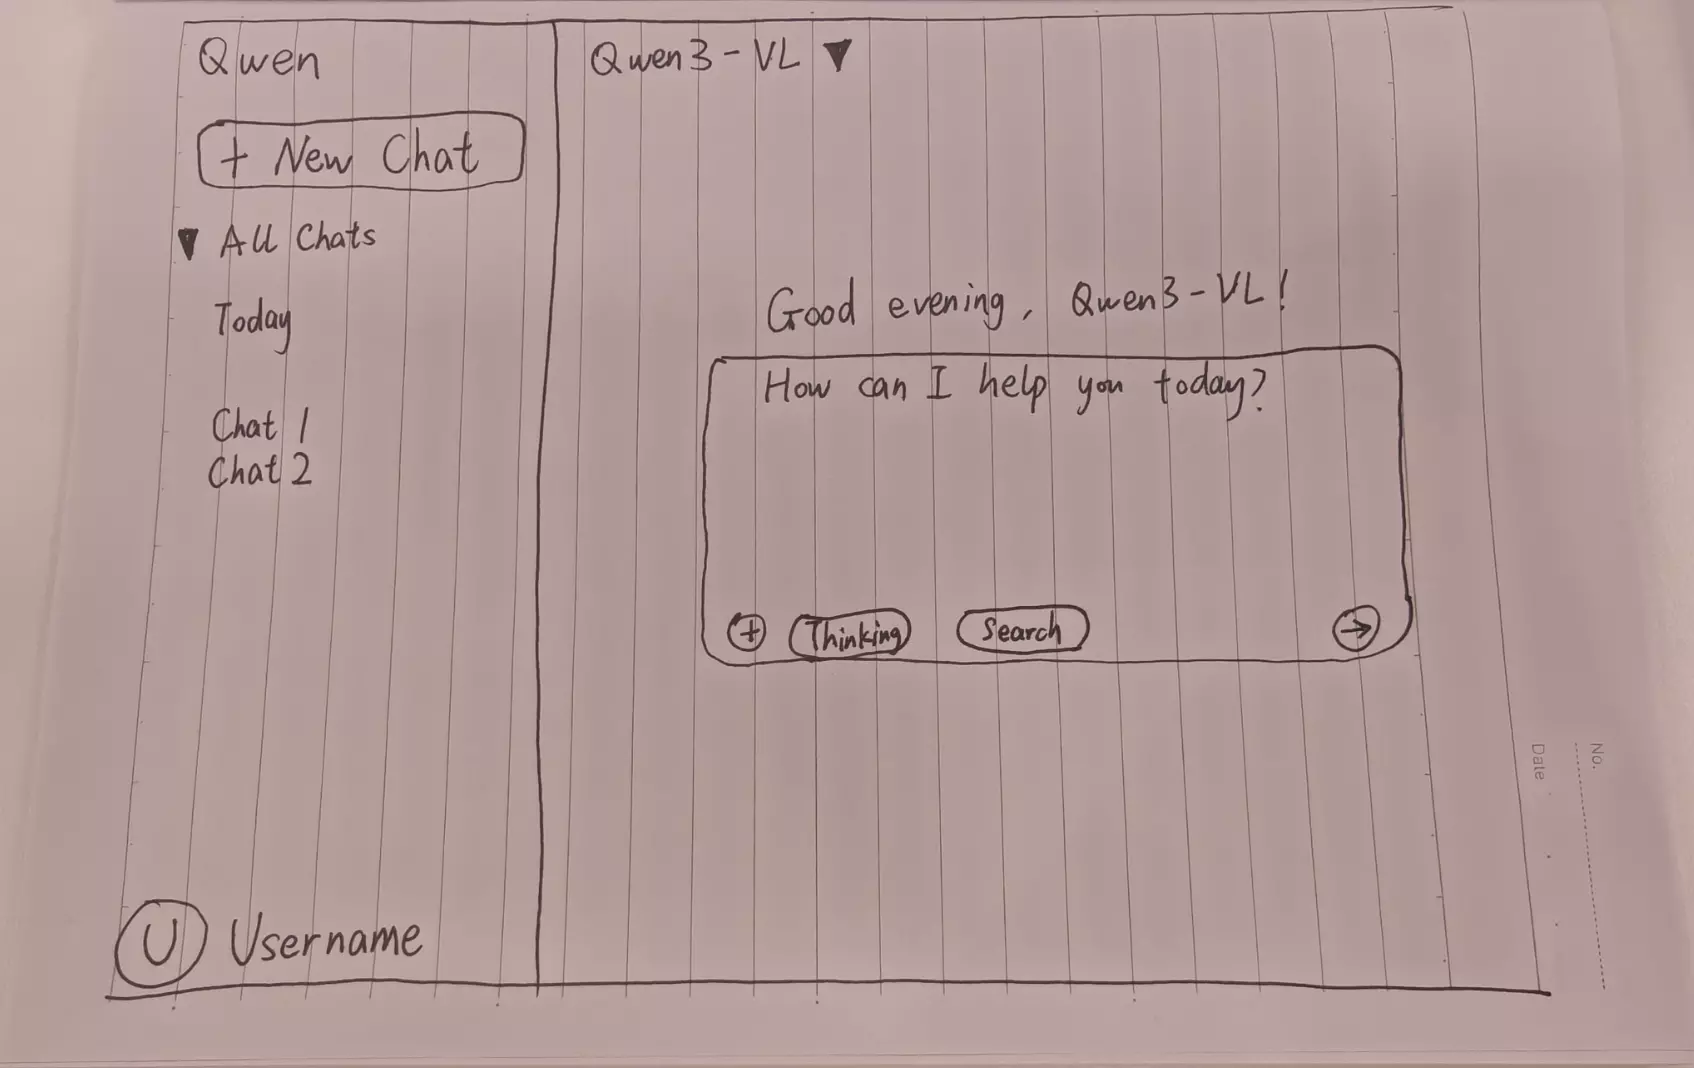
画像や動画からコードを生成します。この機能を使用して、デザイン案、ウェブサイトのスクリーンショットなどから HTML、CSS、JS コードを生成できます。
私のスケッチに基づいて、HTML と CSS を使用してウェブページを作成してください。メインカラーは黒にしてください。 |
ウェブページのプレビュー |
|---|

物体位置特定
2D および 3D の位置特定に対応しています。この機能を使用して、物体の向き、視点の変化、およびオクルージョン関係を判断できます。3D 位置特定は、Qwen3-VL モデルに追加された新機能です。
Qwen2.5-VL モデルの物体位置特定性能は、480 × 480 から 2560 × 2560 の解像度範囲内で安定しています。この範囲外では、検出精度が低下し、時折検出フレームのドリフトが発生する可能性があります。
位置特定の結果を元の画像に描画する方法については、「よくある質問」をご参照ください。
2D 位置特定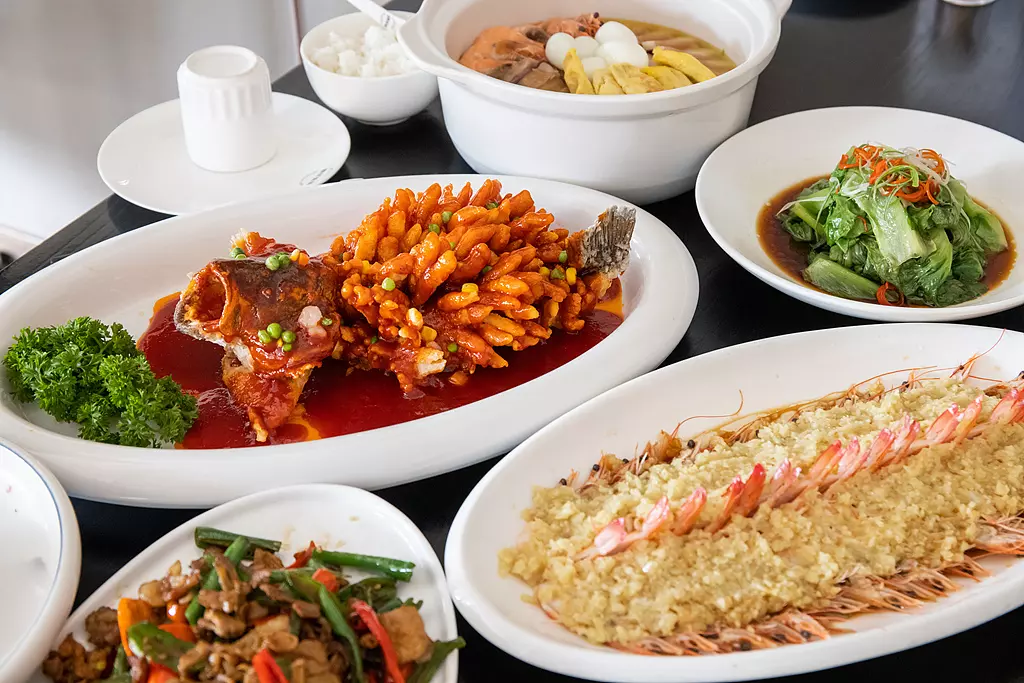
| 2D 位置特定結果の可視化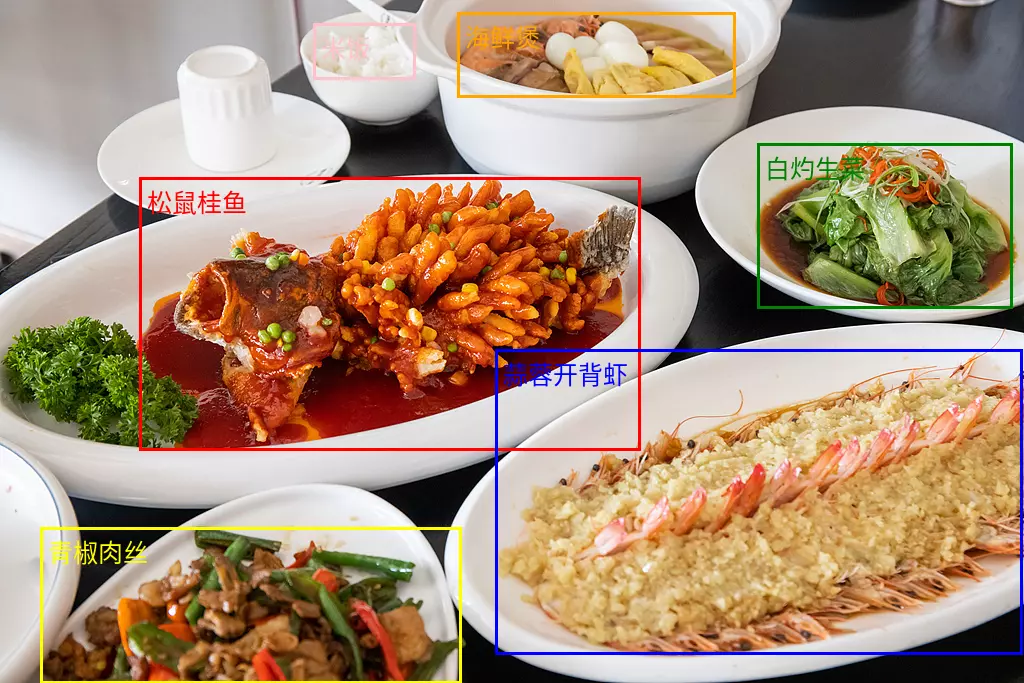 |
3D 位置特定 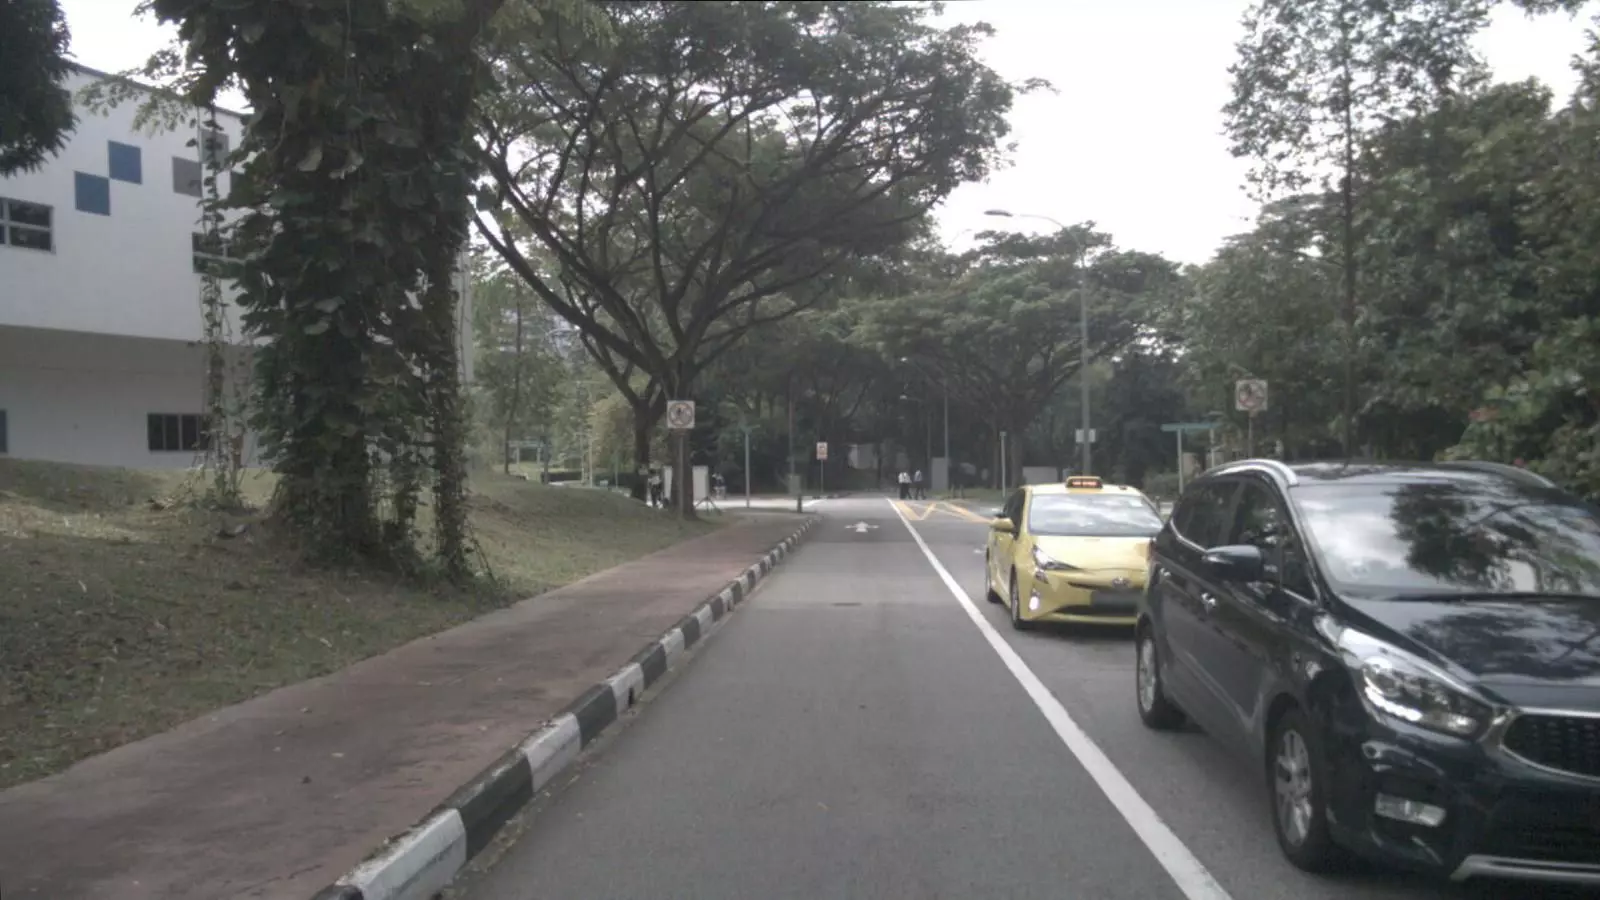 画像内の車を検出し、その 3D 位置を予測します。出力 JSON: | 3D 位置特定結果の可視化 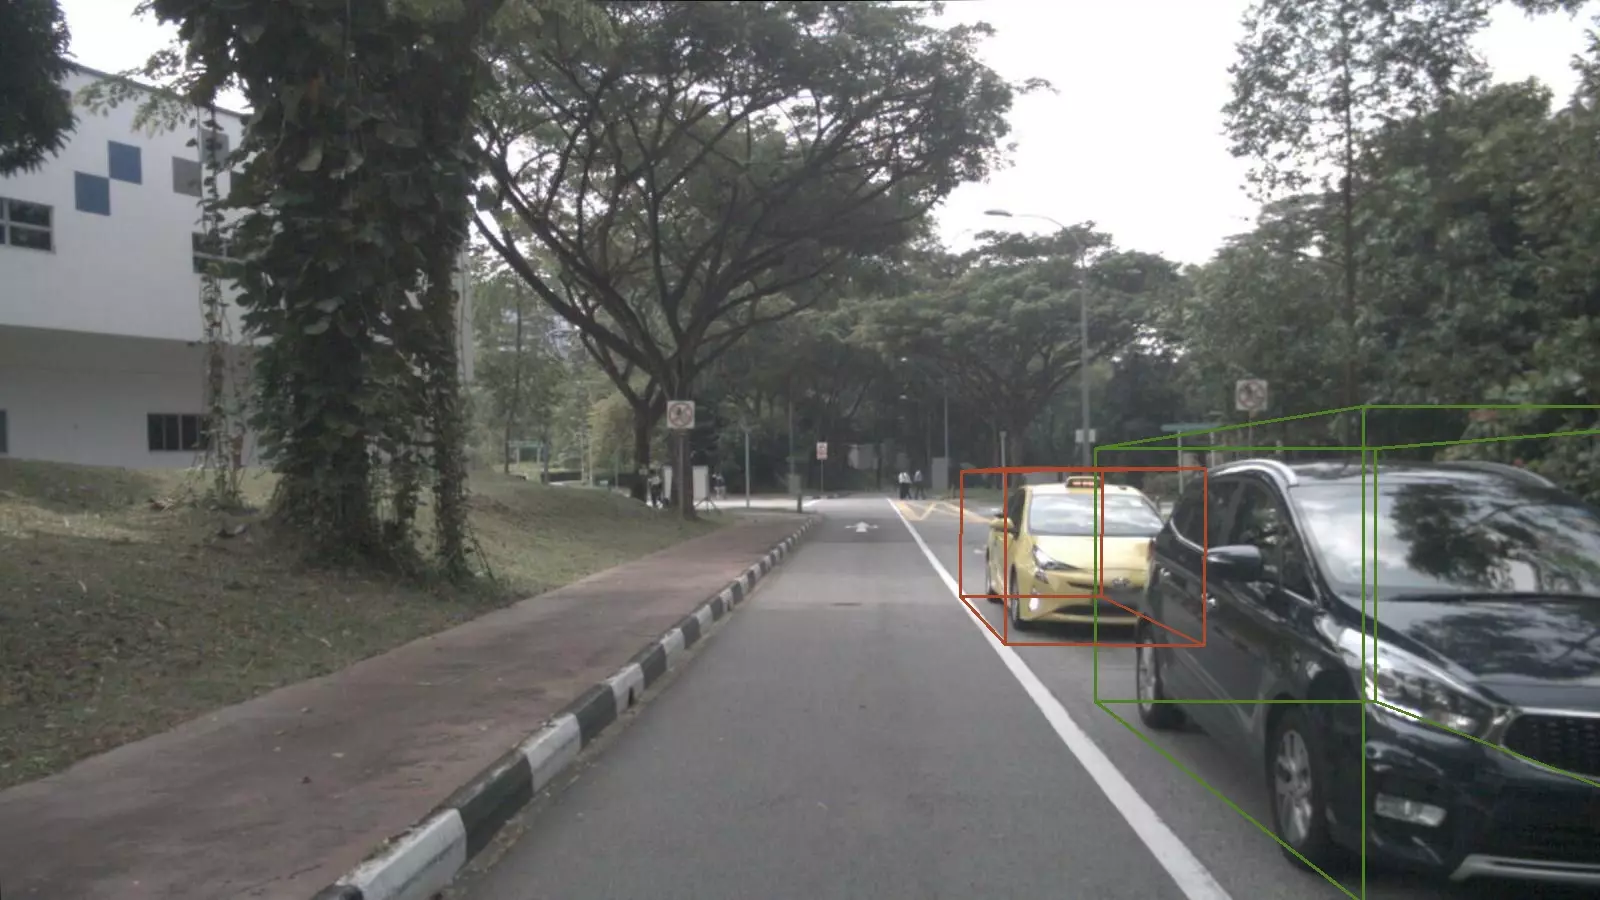 |
ドキュメント解析
画像ベースのドキュメント (スキャンコピーや画像 PDF など) を QwenVL HTML または QwenVL Markdown 形式に解析します。この形式は、テキストを正確に認識するだけでなく、画像や表などの要素の位置情報も取得します。Qwen3-VL モデルでは、Markdown 形式への解析機能が追加されました。
推奨されるプロンプトは次のとおりです:
qwenvl html(HTML 形式に解析する場合) またはqwenvl markdown(Markdown 形式に解析する場合)。
qwenvl markdown. |
結果の可視化 |
|---|

動画理解
特定のイベントの位置特定やタイムスタンプの取得、主要な時間帯の要約生成など、動画コンテンツを分析します。
動画内の人物の一連の行動を説明してください。開始時刻 (start_time)、終了時刻 (end_time)、およびイベント (event) を JSON 形式で出力してください。タイムスタンプには HH:mm:ss を使用してください。 | { "events": [ { "start_time": "00:00:00", "end_time": "00:00:05", "event": "人物が段ボール箱を持ってテーブルに向かって歩き、テーブルの上に置きます。" }, { "start_time": "00:00:05", "end_time": "00:00:15", "event": "人物がスキャナーを手に取り、段ボール箱のラベルをスキャンします。" }, { "start_time": "00:00:15", "end_time": "00:00:21", "event": "人物がスキャナーを元の場所に戻し、ペンを手に取ってノートに情報を記録します。"}] } |
コア機能
思考モードの有効化または無効化
-
qwen3.8、qwen3.7、qwen3.6、qwen3.5、qwen3-vl-plus、およびqwen3-vl-flashシリーズのモデルは、ハイブリッド思考モデルです。応答する前に思考することも、直接応答することもできます。enable_thinkingパラメーターを使用して、思考モードを有効にするかどうかを制御します:true:思考モードを有効にします。qwen3.8、qwen3.7、qwen3.6、およびqwen3.5シリーズのモデルのデフォルト値はtrueです。false:思考モードを無効にします。qwen3-vl-plusおよびqwen3-vl-flashシリーズのモデルのデフォルト値はfalseです。
-
thinkingサフィックスを持つモデル (例:qwen3-vl-235b-a22b-thinking) は、思考専用モデルです。常に応答する前に思考し、この機能は無効にできません。
重要
- モデル構成:Agent ツール呼び出しを伴わない一般的な会話シナリオでは、最適なパフォーマンスを維持するために
System Messageを設定しないでください。モデルのロール設定や出力形式の要件などの命令は、User Messageを通じて渡すことができます。 - ストリーミング出力を優先:思考モードが有効な場合、ストリーミングと非ストリーミングの両方の出力がサポートされます。応答が長すぎることによるタイムアウトを避けるために、ストリーミング出力を優先して使用してください。
- 思考の長さを制限:ディープシンキングモデルは、時々長い推論プロセスを出力することがあります。
thinking_budgetパラメーターを使用して、思考プロセスの長さを制限できます。モデルの思考プロセス中に生成されたトークン数がthinking_budgetを超えると、推論コンテンツは切り捨てられ、モデルはすぐに最終応答の生成を開始します。thinking_budgetのデフォルト値は、モデルの最大 Chain-of-Thought 長です。詳細については、モデルリストをご参照ください。
OpenAI 互換
enable_thinking パラメーターは標準の OpenAI パラメーターではありません。OpenAI Python SDK を使用する場合は、extra_body を通じて渡してください。
import os
from openai import OpenAI

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
)

reasoning_content = ""  # 完全な思考プロセスを定義します
answer_content = ""     # 完全な応答を定義します
is_answering = False   # 思考プロセスを終了して応答を開始するかどうかを判断します
enable_thinking = True
# チャット補完リクエストを作成します
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg"
                    },
                },
                {"type": "text", "text": "この問題の解き方を教えてください。"},
            ],
        },
    ],
    stream=True,
    # enable_thinking パラメーターは思考プロセスを有効にし、thinking_budget パラメーターは推論プロセスの最大トークン数を設定します。
    # enable_thinking パラメーターを使用して思考モードを切り替えます。
    extra_body={
        'enable_thinking': enable_thinking,
        "thinking_budget": 81920},

    # 最後のチャンクでトークン使用量を返すには、次の行のコメントを解除します。
    # stream_options={
    #     "include_usage": True
    # }
)

if enable_thinking:
    print("\n" + "=" * 20 + "思考プロセス" + "=" * 20 + "\n")

for chunk in completion:
    # chunk.choices が空の場合は、使用量を出力します。
    if not chunk.choices:
        print("\n使用量:")
        print(chunk.usage)
    else:
        delta = chunk.choices[0].delta
        # 思考プロセスを出力します。
        if hasattr(delta, 'reasoning_content') and delta.reasoning_content is not None:
            print(delta.reasoning_content, end='', flush=True)
            reasoning_content += delta.reasoning_content
        else:
            # 応答を開始します。
            if delta.content != "" and is_answering is False:
                print("\n" + "=" * 20 + "完全な応答" + "=" * 20 + "\n")
                is_answering = True
            # 応答プロセスを出力します。
            print(delta.content, end='', flush=True)
            answer_content += delta.content

# print("=" * 20 + "完全な思考プロセス" + "=" * 20 + "\n")
# print(reasoning_content)
# print("=" * 20 + "完全な応答" + "=" * 20 + "\n")
# print(answer_content)
import OpenAI from "openai";

// OpenAI クライアントを初期化します
const openai = new OpenAI({
  // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
  // 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
  apiKey: process.env.DASHSCOPE_API_KEY,
  // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
  baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
});

let reasoningContent = '';
let answerContent = '';
let isAnswering = false;
let enableThinking = true;

let messages = [
    {
        role: "user",
        content: [
        { type: "image_url", image_url: { "url": "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg" } },
        { type: "text", text: "この問題を解いてください" },
    ]
}]

async function main() {
    try {
        const stream = await openai.chat.completions.create({
            model: 'qwen3.7-plus',
            messages: messages,
            stream: true,
          // 注:Node.js SDK では、enableThinking のような非標準パラメーターはトップレベルのプロパティとして渡され、extra_body に配置する必要はありません。
          enable_thinking: enableThinking,
          thinking_budget: 81920

        });

        if (enableThinking){console.log('\n' + '='.repeat(20) + '思考プロセス' + '='.repeat(20) + '\n');}

        for await (const chunk of stream) {
            if (!chunk.choices?.length) {
                console.log('\n使用量:');
                console.log(chunk.usage);
                continue;
            }

            const delta = chunk.choices[0].delta;

            // 思考プロセスを処理します。
            if (delta.reasoning_content) {
                process.stdout.write(delta.reasoning_content);
                reasoningContent += delta.reasoning_content;
            }
            // 正式な応答を処理します。
            else if (delta.content) {
                if (!isAnswering) {
                    console.log('\n' + '='.repeat(20) + '完全な応答' + '='.repeat(20) + '\n');
                    isAnswering = true;
                }
                process.stdout.write(delta.content);
                answerContent += delta.content;
            }
        }
    } catch (error) {
        console.error('エラー:', error);
    }
}

main();
# ======= 重要事項 =======
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model": "qwen3.8-max",
    "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg"
          }
        },
        {
          "type": "text",
          "text": "この問題を解いてください"
        }
      ]
    }
  ],
    "stream":true,
    "stream_options":{"include_usage":true},
    "enable_thinking": true,
    "thinking_budget": 81920
}'
DashScope
import os
import dashscope
from dashscope import MultiModalConversation

# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"

enable_thinking=True

messages = [
    {
        "role": "user",
        "content": [
            {"image": "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg"},
            {"text": "この問題を解いてください。"}
        ]
    }
]

response = MultiModalConversation.call(
    # 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx",
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model="qwen3.8-max",
    messages=messages,
    stream=True,
    # enable_thinking パラメーターは思考プロセスを有効にします。
    # enable_thinking パラメーターを使用して思考モードを切り替えます。
    enable_thinking=enable_thinking,
    # thinking_budget パラメーターは推論プロセスの最大トークン数を設定します。
    thinking_budget=81920,

)

# 完全な思考プロセスを定義します
reasoning_content = ""
# 完全な応答を定義します
answer_content = ""
# 思考プロセスを終了して応答を開始するかどうかを判断します
is_answering = False

if enable_thinking:
    print("=" * 20 + "思考プロセス" + "=" * 20)

for chunk in response:
    # 思考プロセスと応答の両方が空の場合は無視します。
    message = chunk.output.choices[0].message
    reasoning_content_chunk = message.get("reasoning_content", None)
    if (chunk.output.choices[0].message.content == [] and
        reasoning_content_chunk == ""):
        pass
    else:
        # 現在思考プロセス中の場合
        if reasoning_content_chunk is not None and chunk.output.choices[0].message.content == []:
            print(chunk.output.choices[0].message.reasoning_content, end="")
            reasoning_content += chunk.output.choices[0].message.reasoning_content
        # 現在応答中の場合
        elif chunk.output.choices[0].message.content != []:
            if not is_answering:
                print("\n" + "=" * 20 + "完全な応答" + "=" * 20)
                is_answering = True
            print(chunk.output.choices[0].message.content[0]["text"], end="")
            answer_content += chunk.output.choices[0].message.content[0]["text"]

# 完全な思考プロセスと応答を出力します。
# print("=" * 20 + "完全な思考プロセス" + "=" * 20 + "\n")
# print(f"{reasoning_content}")
# print("=" * 20 + "完全な応答" + "=" * 20 + "\n")
# print(f"{answer_content}")
// DashScope SDK のバージョンは 2.21.10 以降である必要があります。
import java.util.*;

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import io.reactivex.Flowable;

import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.exception.InputRequiredException;
import java.lang.System;
import com.alibaba.dashscope.utils.Constants;

public class Main {
    // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    static {Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";}

    private static final Logger logger = LoggerFactory.getLogger(Main.class);
    private static StringBuilder reasoningContent = new StringBuilder();
    private static StringBuilder finalContent = new StringBuilder();
    private static boolean isFirstPrint = true;

    private static void handleGenerationResult(MultiModalConversationResult message) {
        String re = message.getOutput().getChoices().get(0).getMessage().getReasoningContent();
        String reasoning = Objects.isNull(re)?"":re; // デフォルト値

        List<Map<String, Object>> content = message.getOutput().getChoices().get(0).getMessage().getContent();
        if (!reasoning.isEmpty()) {
            reasoningContent.append(reasoning);
            if (isFirstPrint) {
                System.out.println("====================思考プロセス====================");
                isFirstPrint = false;
            }
            System.out.print(reasoning);
        }

        if (Objects.nonNull(content) && !content.isEmpty()) {
            Object text = content.get(0).get("text");
            finalContent.append(content.get(0).get("text"));
            if (!isFirstPrint) {
                System.out.println("\n====================完全な応答====================");
                isFirstPrint = true;
            }
            System.out.print(text);
        }
    }
    public static MultiModalConversationParam buildMultiModalConversationParam(MultiModalMessage Msg)  {
        return MultiModalConversationParam.builder()
                // 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(Msg))
                .enableThinking(true)
                .thinkingBudget(81920)
                .incrementalOutput(true)
                .build();
    }

    public static void streamCallWithMessage(MultiModalConversation conv, MultiModalMessage Msg)
            throws NoApiKeyException, ApiException, InputRequiredException, UploadFileException {
        MultiModalConversationParam param = buildMultiModalConversationParam(Msg);
        Flowable<MultiModalConversationResult> result = conv.streamCall(param);
        result.blockingForEach(message -> {
            handleGenerationResult(message);
        });
    }
    public static void main(String[] args) {
        try {
            MultiModalConversation conv = new MultiModalConversation();
            MultiModalMessage userMsg = MultiModalMessage.builder()
                    .role(Role.USER.getValue())
                    .content(Arrays.asList(Collections.singletonMap("image", "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg"),
                            Collections.singletonMap("text", "この問題を解いてください")))
                    .build();
            streamCallWithMessage(conv, userMsg);
//             最終結果を出力します。
//            if (reasoningContent.length() > 0) {
//                System.out.println("\n====================完全な応答====================");
//                System.out.println(finalContent.toString());
//            }
        } catch (ApiException | NoApiKeyException | UploadFileException | InputRequiredException e) {
            logger.error("例外が発生しました: {}", e.getMessage());
        }
        System.exit(0);
    }
}
# ======= 重要事項 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-H 'X-DashScope-SSE: enable' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
                "role": "user",
                "content": [
                    {"image": "https://img.alicdn.com/imgextra/i1/O1CN01gDEY8M1W114Hi3XcN_!!6000000002727-0-tps-1024-406.jpg"},
                    {"text": "この問題を解いてください"}
                ]
            }
        ]
    },
    "parameters":{
        "enable_thinking": true,
        "incremental_output": true,
        "thinking_budget": 81920
    }
}'
複数画像の入力
視覚理解モデルは、1 回のリクエストで複数の画像を渡すことをサポートしており、製品比較や複数ページのドキュメント処理などのタスクに使用できます。これを行うには、user message の content 配列に複数の画像オブジェクトを含めるだけです。
重要画像数は、モデルの画像とテキストの合計トークン制限によって制限されます。すべての画像とテキストの合計トークン数は、モデルの最大入力を超えてはなりません。
OpenAI 互換
Python
import os
from openai import OpenAI

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-max",  #  この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=[
        {"role": "user","content": [
            {"type": "image_url","image_url": {"url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},},
            {"type": "image_url","image_url": {"url": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"},},
            {"type": "text", "text": "これらの画像にはどのような内容が描かれていますか?"},
            ],
        }
    ],
)

print(completion.choices[0].message.content)
応答
画像 1 は、ビーチで女性とラブラドールレトリバーが交流しているシーンを示しています。女性はチェック柄のシャツを着て砂の上に座り、犬と握手しています。背景は海の波と空で、写真全体が暖かさと喜びに満ちています。

画像 2 は、森の中を歩く虎のシーンを示しています。虎の毛皮はオレンジ色で黒い縞模様があります。虎は前に進んでおり、周りには密集した木々や植物があり、地面は落ち葉で覆われています。写真全体が野生の自然を感じさせます。
Node.js
import OpenAI from "openai";

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

async function main() {
    const response = await openai.chat.completions.create({
        model: "qwen3.8-max",  // この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
        messages: [
          {role: "user",content: [
            {type: "image_url",image_url: {"url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"}},
            {type: "image_url",image_url: {"url": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"}},
            {type: "text", text: "これらの画像にはどのような内容が描かれていますか?" },
        ]}]
    });
    console.log(response.choices[0].message.content);
}

main()
応答
最初の画像では、人と犬がビーチで交流しています。人はチェック柄のシャツを着ており、犬は首輪をしています。彼らは握手またはハイタッチをしているようです。

2番目の画像では、虎が森の中を歩いています。虎の毛皮はオレンジ色で黒い縞模様があり、背景は緑の木々と植物です。
curl
# ======= 重要事項 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
  "model": "qwen3.8-max",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"
          }
        },
        {
          "type": "image_url",
          "image_url": {
            "url": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"
          }
        },
        {
          "type": "text",
          "text": "これらの画像にはどのような内容が描かれていますか?"
        }
      ]
    }
  ]
}'
応答
{
  "choices": [
    {
      "message": {
        "content": "画像 1 は、ビーチで女性とラブラドールレトリバーが交流しているシーンを示しています。女性はチェック柄のシャツを着て砂の上に座り、犬と握手しています。背景は海の景色と夕焼けの空で、シーン全体が非常に暖かく調和しているように見えます。\n\n画像 2 は、森の中を歩く虎のシーンを示しています。虎の毛皮はオレンジ色で黒い縞模様があります。虎は前に進んでおり、周りには密集した木々や植物があり、地面は落ち葉で覆われています。写真全体が自然の野性味と生命力に満ちています。",
        "role": "assistant"
      },
      "finish_reason": "stop",
      "index": 0,
      "logprobs": null
    }
  ],
  "object": "chat.completion",
  "usage": {
    "prompt_tokens": 2497,
    "completion_tokens": 109,
    "total_tokens": 2606
  },
  "created": 1725948561,
  "system_fingerprint": null,
  "model": "qwen3.8-max",
  "id": "chatcmpl-0fd66f46-b09e-9164-a84f-3ebbbedbac15"
}
DashScope
Python
import os
import dashscope

# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

messages = [
    {
        "role": "user",
        "content": [
            {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},
            {"image": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"},
            {"text": "これらの画像にはどのような内容が描かれていますか?"}
        ]
    }
]

response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数が設定されていない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus', #  この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages
)

print(response.output.choices[0].message.content[0]["text"])
応答
これらの画像には、いくつかの動物と自然の風景が写っています。最初の画像では、人と犬がビーチで交流しています。2番目の画像は、森の中を歩く虎です。
Java
import java.util.Arrays;
import java.util.Collections;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {
    static {
    // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }
    public static void simpleMultiModalConversationCall()
            throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(
                        Collections.singletonMap("image", "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"),
                        Collections.singletonMap("image", "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"),
                        Collections.singletonMap("text", "これらの画像にはどのような内容が描かれていますか?"))).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")  //  この例では qwen3.7-plus を使用しています。必要に応じて他のモデルに置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
                .messages(Arrays.asList(userMessage))
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));    }
    public static void main(String[] args) {
        try {
            simpleMultiModalConversationCall();
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
応答
これらの画像には、いくつかの動物と自然の風景が写っています。

1. 最初の画像:女性と犬がビーチで交流しています。女性はチェック柄のシャツを着て砂の上に座っており、犬は首輪をして女性と握手するために前足を伸ばしています。
2. 2番目の画像:虎が森の中を歩いています。虎の毛皮はオレンジ色で黒い縞模様があり、背景は木々と葉です。
curl
# ======= 重要事項 =======
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
                "role": "user",
                "content": [
                    {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241022/emyrja/dog_and_girl.jpeg"},
                    {"image": "https://dashscope.oss-cn-beijing.aliyuncs.com/images/tiger.png"},
                    {"text": "これらの画像にはどのような内容が写っていますか?"}
                ]
            }
        ]
    }
}'
応答
{
  "output": {
    "choices": [
      {
        "finish_reason": "stop",
        "message": {
          "role": "assistant",
          "content": [
            {
              "text": "これらの画像には、いくつかの動物と自然の風景が写っています。最初の画像では、人と犬がビーチで交流しています。2番目の画像は、森の中を歩く虎です。"
            }
          ]
        }
      }
    ]
  },
  "usage": {
    "output_tokens": 81,
    "input_tokens": 1277,
    "image_tokens": 2497
  },
  "request_id": "ccf845a3-dc33-9cda-b581-20fe7dc23f70"
}
動画理解
視覚理解モデルは、画像リスト (ビデオフレーム) またはビデオファイルとして提供される動画コンテンツを理解できます。以下の例は、URL で指定されたオンライン動画または画像リストを理解する方法を示しています。動画の制限や画像リストで渡せる画像数に関する詳細については、「動画の制限」をご参照ください。
動画ファイルを理解する際のパフォーマンスを向上させるには、最新または最近のスナップショットバージョンのモデルを使用してください。
ビデオファイル
視覚理解モデルは、動画から一連のフレームを抽出して動画コンテンツを分析します。以下の 2 つのパラメーターでフレーム抽出戦略を制御できます:
-
fps:フレーム抽出の頻度を制御します。1/fps 秒ごとに 1 フレームが抽出されます。値の範囲は [0.1, 10] で、デフォルト値は 2.0 です。
- 動きの速いシーンでは、より多くの詳細を捉えるために fps 値を高く設定します。
- 静的なシーンや長い動画では、パフォーマンスを向上させるために fps 値を低く設定します。
-
max_frames:動画から抽出する最大フレーム数。システムは動画の fps に基づいて合計フレーム数を計算します。合計フレーム数がこの制限を超えた場合、システムは制限を満たすようにフレームを均等にサンプリングします。このパラメーターは DashScope SDK を使用する場合にのみ利用可能です。
OpenAI 互換
OpenAI SDK または HTTP を使用してビデオファイルを視覚理解モデルに直接送信する場合、ユーザーメッセージの
"type"パラメーターを"video_url"に設定します。
import os
from openai import OpenAI

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {
            "role": "user",
            "content": [
                # ビデオファイルを直接渡す場合、type の値を video_url に設定します。
                {
                    "type": "video_url",
                    "video_url": {
                        "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4"
                    },
                    "fps": 2
                },
                {
                    "type": "text",
                    "text": "この動画の内容は何ですか?"
                }
            ]
        }
    ]
)

print(completion.choices[0].message.content)
import OpenAI from "openai";

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

async function main() {
    const response = await openai.chat.completions.create({
        model: "qwen3.8-max",
        messages: [
            {
                role: "user",
                content: [
                    // ビデオファイルを直接渡す場合、type の値を video_url に設定します。
                    {
                        type: "video_url",
                        video_url: {
                            "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4"
                        },
                        "fps": 2
                    },
                    {
                        type: "text",
                        text: "この動画の内容は何ですか?"
                    }
                ]
            }
        ]
    });

    console.log(response.choices[0].message.content);
}

main();
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください。===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "qwen3.8-max",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "video_url",
            "video_url": {
              "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4"
            },
            "fps":2
          },
          {
            "type": "text",
            "text": "この動画の内容は何ですか?"
          }
        ]
      }
    ]
  }'
DashScope
import dashscope
import os

# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
messages = [
    {"role": "user",
        "content": [
            # fps パラメーターは動画のフレーム抽出頻度を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。完全な使用法については、https://www.alibabacloud.com/help/ja/model-studio/use-qwen-by-calling-api?#2ed5ee7377fum をご参照ください
            {"video": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4","fps":2},
            {"text": "この動画の内容は何ですか?"}
        ]
    }
]

response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key ="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',
    messages=messages
)

print(response.output.choices[0].message.content[0]["text"])
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;

import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {
   static {
            // 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
            Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
        }
    public static void simpleMultiModalConversationCall()
            throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        // fps パラメーターは動画のフレーム抽出頻度を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。完全な使用法については、https://www.alibabacloud.com/help/ja/model-studio/use-qwen-by-calling-api?#2ed5ee7377fum をご参照ください
        Map<String, Object> params = new HashMap<>();
        params.put("video", "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4");
        params.put("fps", 2);
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(
                        params,
                        Collections.singletonMap("text", "この動画の内容は何ですか?"))).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // 中国 (北京) リージョンのモデルを使用する場合、そのリージョンの API キーを使用する必要があります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(userMessage))
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }
    public static void main(String[] args) {
        try {
            simpleMultiModalConversationCall();
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。呼び出しを行う際に、{WorkspaceId} をワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください。===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {"role": "user","content": [{"video": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4","fps":2},
            {"text": "この動画の内容は何ですか?"}]}]}
}'
画像リスト
事前に抽出したフレームのリストとして動画を提供する場合、fps パラメーターを使用してフレーム間の時間間隔を指定します。これにより、モデルはイベントのシーケンス、持続時間、および動的な変化をよりよく理解できます。fps パラメーターは、元の動画から 1/fps 秒ごとにフレームが抽出されたことを示します。このパラメーターは、Qwen3.6、Qwen3-VL、および Qwen2.5-VL モデルでサポートされています。
OpenAI 互換
OpenAI SDK または HTTP を使用して、動画を画像のリストとして視覚理解モデルに入力する場合、ユーザーメッセージの
"type"パラメーターを"video"に設定します。
import os
from openai import OpenAI

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-max", # この例では qwen3.7-plus を使用しています。必要に応じて他のモデル名に置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/ja/model-studio/models をご参照ください
    messages=[{"role": "user","content": [
        # 画像のリストを入力する場合、ユーザーメッセージの "type" パラメーターは "video" です
         {"type": "video","video": [
         "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
         "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
         "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
         "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"],
         "fps":2},
         {"type": "text","text": "この動画の具体的なプロセスを説明してください"},
    ]}]
)

print(completion.choices[0].message.content)
// package.json ファイルで "type": "module" を指定していることを確認してください。
import OpenAI from "openai";

const openai = new OpenAI({
    // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx",
    apiKey: process.env.DASHSCOPE_API_KEY,
    // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
});

async function main() {
    const response = await openai.chat.completions.create({
        model: "qwen3.8-max",  // この例では qwen3.7-plus を使用しています。必要に応じて他のモデル名に置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/ja/model-studio/models をご参照ください
        messages: [{
            role: "user",
            content: [
                {
                    // 画像のリストを入力する場合、ユーザーメッセージの "type" パラメーターは "video" です
                    type: "video",
                    video: [
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"],
                        "fps": 2
                },
                {
                    type: "text",
                    text: "この動画の具体的なプロセスを説明してください"
                }
            ]
        }]
    });
    console.log(response.choices[0].message.content);
}

main();
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "messages": [{"role": "user","content": [{"type": "video","video": [
                  "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
                  "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
                  "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
                  "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"],
                  "fps":2},
                {"type": "text","text": "この動画の具体的なプロセスを説明してください"}]}]
}'
DashScope
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
messages = [{"role": "user",
             "content": [
                  # 画像のリストを入力する場合、fps パラメーターは Qwen3.6、Qwen3-VL、および Qwen2.5-VL シリーズのモデルに適用されます。
                 {"video":["https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
                           "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
                           "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
                           "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"],
                   "fps":2},
                 {"text": "この動画の具体的なプロセスを説明してください"}]}]
response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model='qwen3.7-plus',  # この例では qwen3.7-plus を使用しています。必要に応じて他のモデル名に置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages
)
print(response.output.choices[0].message.content[0]["text"])
// DashScope SDK のバージョンは 2.21.10 以降である必要があります。
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;

import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {
    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }
    private static final String MODEL_NAME = "qwen3.8-max";  // この例では qwen3.7-plus を使用しています。必要に応じて他のモデル名に置き換えることができます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    public static void videoImageListSample() throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        // 画像のリストを入力する場合、fps パラメーターは Qwen3.6、Qwen3-VL、および Qwen2.5-VL シリーズのモデルに適用されます。
        Map<String, Object> params = new HashMap<>();
        params.put("video", Arrays.asList("https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
                        "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"));
        params.put("fps", 2);
        MultiModalMessage userMessage = MultiModalMessage.builder()
                .role(Role.USER.getValue())
                .content(Arrays.asList(
                        params,
                        Collections.singletonMap("text", "この動画の具体的なプロセスを説明してください")))
                .build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model(MODEL_NAME)
                .messages(Arrays.asList(userMessage)).build();
        MultiModalConversationResult result = conv.call(param);
        System.out.print(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }
    public static void main(String[] args) {
        try {
            videoImageListSample();
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
  "model": "qwen3.8-max",
  "input": {
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "video": [
              "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/xzsgiz/football1.jpg",
              "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/tdescd/football2.jpg",
              "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/zefdja/football3.jpg",
              "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241108/aedbqh/football4.jpg"
            ],
            "fps":2

          },
          {
            "text": "この動画の具体的なプロセスを説明してください"
          }
        ]
      }
    ]
  }
}'
ローカルファイルの渡し方 (Base64 エンコーディングまたはファイルパス)
視覚理解モデルは、ローカルファイルをアップロードするための 2 つの方法をサポートしています:Base64 エンコーディングと直接ファイルパスアップロード。ファイルサイズと SDK の種類に基づいてアップロード方法を選択できます。推奨事項については、「ファイルアップロード方法の選択方法」をご参照ください。どちらの方法も、「画像の制限」で説明されているファイル要件を満たす必要があります。
Base64 エンコーディングを使用したアップロード
ファイルを Base64 エンコードされた文字列に変換し、モデルに渡します。この方法は、OpenAI および DashScope SDK、および HTTP リクエストに適用できます。
Base64 エンコードされた文字列を渡す手順 (画像の例)
-
ファイルのエンコード:ローカル画像を Base64 エンコーディングに変換します。
画像を Base64 エンコーディングに変換するサンプルコード
# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します import base64 def encode_image(image_path): with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode("utf-8") # xxx/eagle.png をローカル画像の絶対パスに置き換えてください base64_image = encode_image("xxx/eagle.png") -
次の形式で Data URL を構築します:
data:[MIME_type];base64,{base64_image}。MIME_typeを実際のメディアタイプに置き換えます。サポートされている画像形式 テーブルのMIME Type値と一致することを確認してください (例:image/jpegまたはimage/png)。base64_imageは、前のステップで生成された Base64 文字列です。
-
モデルの呼び出し:
imageまたはimage_urlパラメーターを使用してData URLを渡します。
ファイルパスを使用したアップロード
ローカルファイルパスを直接モデルに渡します。この方法は、DashScope Python および Java SDK でのみサポートされています。DashScope HTTP リクエストまたは OpenAI 互換モードではサポートされていません。
プログラミング言語とオペレーティングシステムに基づいてファイルパスを指定するには、次の表をご参照ください。
ファイルパスの指定 (画像の例)
システム | SDK | 渡すファイルパス | 例 |
|---|---|---|---|
Linux または macOS システム | Python SDK | file://{ファイルの絶対パス} | file:///home/images/test.png |
Java SDK | |||
Windows システム | Python SDK | file://{ファイルの絶対パス} | file://D:/images/test.png |
Java SDK | file:///{ファイルの絶対パス} | file:///D:/images/test.png |
画像
ファイルパスを使用した渡し方
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

# xxx/eagle.png をローカル画像の絶対パスに置き換えてください
local_path = "xxx/eagle.png"
image_path = f"file://{local_path}"
messages = [
                {'role':'user',
                'content': [{'image': image_path},
                            {'text': '画像にはどのようなシーンが描かれていますか?'}]}]
response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',  # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages)
print(response.output.choices[0].message.content[0]["text"])
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    public static void callWithLocalFile(String localPath)
            throws ApiException, NoApiKeyException, UploadFileException {
        String filePath = "file://"+localPath;
        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(new HashMap<String, Object>(){{put("image", filePath);}},
                        new HashMap<String, Object>(){{put("text", "画像にはどのようなシーンが描かれていますか?");}})).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")  // この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
                .messages(Arrays.asList(userMessage))
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));}

    public static void main(String[] args) {
        try {
            // xxx/eagle.png をローカル画像の絶対パスに置き換えてください
            callWithLocalFile("xxx/eagle.png");
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
Base64 エンコードされた入力
OpenAI 互換
Python
from openai import OpenAI
import os
import base64

# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode("utf-8")

# xxxx/eagle.png をローカル画像の絶対パスに置き換えてください
base64_image = encode_image("xxx/eagle.png")
client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    # 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max", # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    # Base64 画像データを渡す場合、画像形式 (image/{format}) はサポートされている画像のリストの Content Type と一致する必要があることに注意してください。"f" は文字列フォーマットのメソッドです。
                    # PNG 画像: f"data:image/png;base64,{base64_image}"
                    # JPEG 画像:f"data:image/jpeg;base64,{base64_image}"
                    # WEBP 画像:f"data:image/webp;base64,{base64_image}"
                    "image_url": {"url": f"data:image/png;base64,{base64_image}"},
                },
                {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"},
            ],
        }
    ],
)
print(completion.choices[0].message.content)
Node.js
import OpenAI from "openai";
import { readFileSync } from 'fs';

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

const encodeImage = (imagePath) => {
    const imageFile = readFileSync(imagePath);
    return imageFile.toString('base64');
  };
// xxx/eagle.png をローカル画像の絶対パスに置き換えてください
const base64Image = encodeImage("xxx/eagle.png")
async function main() {
    const completion = await openai.chat.completions.create({
        model: "qwen3.8-max",  // この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
        messages: [
            {"role": "user",
            "content": [{"type": "image_url",
                            // 注:Base64 データを渡す場合、画像形式 (image/{format}) はサポートされている画像のリストの Content Type と一致する必要があります。
                           // PNG 画像: data:image/png;base64,${base64Image}
                          // JPEG 画像:data:image/jpeg;base64,${base64Image}
                         // WEBP 画像:data:image/webp;base64,${base64Image}
                        "image_url": {"url": `data:image/png;base64,${base64Image}`},},
                        {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"}]}]
    });
    console.log(completion.choices[0].message.content);
}

main();
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
  "model": "qwen3.8-max",
  "messages": [
  {
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA"}},
      {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"}
    ]
  }]
}'
DashScope
Python
import base64
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode("utf-8")

# xxxx/eagle.png をローカル画像の絶対パスに置き換えてください
base64_image = encode_image("xxxx/eagle.png")

messages = [
    {
        "role": "user",
        "content": [
            # 注:Base64 データを渡す場合、画像形式 (image/{format}) はサポートされている画像のリストの Content Type と一致する必要があります。"f" は文字列フォーマットのメソッドです。
            # PNG 画像: f"data:image/png;base64,{base64_image}"
            # JPEG 画像:f"data:image/jpeg;base64,{base64_image}"
            # WEBP 画像:f"data:image/webp;base64,{base64_image}"
            {"image": f"data:image/png;base64,{base64_image}"},
            {"text": "画像にはどのようなシーンが描かれていますか?"},
        ],
    },
]

response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model="qwen3.8-max",  # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages,
)
print(response.output.choices[0].message.content[0]["text"])
Java
import java.io.IOException;
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import java.util.Base64;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;

import com.alibaba.dashscope.aigc.multimodalconversation.*;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    private static String encodeImageToBase64(String imagePath) throws IOException {
        Path path = Paths.get(imagePath);
        byte[] imageBytes = Files.readAllBytes(path);
        return Base64.getEncoder().encodeToString(imageBytes);
    }

    public static void callWithLocalFile(String localPath) throws ApiException, NoApiKeyException, UploadFileException, IOException {

        String base64Image = encodeImageToBase64(localPath); // Base64 エンコーディング

        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(
                        new HashMap<String, Object>() {{ put("image", "data:image/png;base64," + base64Image); }},
                        new HashMap<String, Object>() {{ put("text", "画像にはどのようなシーンが描かれていますか?"); }}
                )).build();

        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(userMessage))
                .build();

        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }

    public static void main(String[] args) {
        try {
            // xxx/eagle.png をローカル画像の絶対パスに置き換えてください
            callWithLocalFile("xxx/eagle.png");
        } catch (ApiException | NoApiKeyException | UploadFileException | IOException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
             "role": "user",
             "content": [
               {"image": "data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."},
               {"text": "画像にはどのようなシーンが描かれていますか?"}
                ]
            }
        ]
    }
}'
ビデオファイル
このセクションでは、ローカルに保存された test.mp4 ファイルを例として使用します。
ファイルパスを使用した渡し方
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

# xxxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
local_path = "xxx/test.mp4"
video_path = f"file://{local_path}"
messages = [
                {'role':'user',
                # fps パラメーターはビデオから抽出されるフレーム数を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。
                'content': [{'video': video_path,"fps":2},
                            {'text': 'このビデオはどのようなシーンを描いていますか?'}]}]
response = MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',
    messages=messages)
print(response.output.choices[0].message.content[0]["text"])
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    public static void callWithLocalFile(String localPath)
            throws ApiException, NoApiKeyException, UploadFileException {
        String filePath = "file://"+localPath;
        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(new HashMap<String, Object>()
                                       {{
                                           put("video", filePath);// fps パラメーターはビデオから抽出されるフレーム数を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。
                                           put("fps", 2);
                                       }},
                        new HashMap<String, Object>(){{put("text", "このビデオはどのようなシーンを描いていますか?");}})).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(userMessage))
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));}

    public static void main(String[] args) {
        try {
            // xxxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
            callWithLocalFile("xxx/test.mp4");
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
Base64 エンコードされた入力
OpenAI 互換
Python
from openai import OpenAI
import os
import base64

# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_video(video_path):
    with open(video_path, "rb") as video_file:
        return base64.b64encode(video_file.read()).decode("utf-8")

# xxxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
base64_video = encode_video("xxx/test.mp4")
client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    # 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    # ビデオファイルを直接渡す場合、type の値を video_url に設定します
                    "type": "video_url",
                    "video_url": {"url": f"data:video/mp4;base64,{base64_video}"},
                    "fps":2
                },
                {"type": "text", "text": "このビデオはどのようなシーンを描いていますか?"},
            ],
        }
    ],
)
print(completion.choices[0].message.content)
Node.js
import OpenAI from "openai";
import { readFileSync } from 'fs';

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

const encodeVideo = (videoPath) => {
    const videoFile = readFileSync(videoPath);
    return videoFile.toString('base64');
  };
// xxxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
const base64Video = encodeVideo("xxx/test.mp4")
async function main() {
    const completion = await openai.chat.completions.create({
        model: "qwen3.8-max",
        messages: [
            {"role": "user",
             "content": [{
                 // ビデオファイルを直接渡す場合、type の値を video_url に設定します
                "type": "video_url",
                "video_url": {"url": `data:video/mp4;base64,${base64Video}`},
                "fps":2},
                 {"type": "text", "text": "このビデオはどのようなシーンを描いていますか?"}]}]
    });
    console.log(completion.choices[0].message.content);
}

main();
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"data:video/mp4;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
  "model": "qwen3.8-max",
  "messages": [
  {
    "role": "user",
    "content": [
      {"type": "video_url", "video_url": {"url": "data:video/mp4;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."},"fps":2},
      {"type": "text", "text": "画像にはどのようなシーンが描かれていますか?"}
    ]
  }]
}'
DashScope
Python
import base64
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_video(video_path):
    with open(video_path, "rb") as video_file:
        return base64.b64encode(video_file.read()).decode("utf-8")

# xxxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
base64_video = encode_video("xxxx/test.mp4")

messages = [{'role':'user',
                # fps パラメーターはビデオから抽出されるフレーム数を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。
             'content': [{'video': f"data:video/mp4;base64,{base64_video}","fps":2},
                            {'text': 'このビデオはどのようなシーンを描いていますか?'}]}]
response = MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',
    messages=messages)

print(response.output.choices[0].message.content[0]["text"])
Java
import java.io.IOException;
import java.util.*;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;

import com.alibaba.dashscope.aigc.multimodalconversation.*;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    private static String encodeVideoToBase64(String videoPath) throws IOException {
        Path path = Paths.get(videoPath);
        byte[] videoBytes = Files.readAllBytes(path);
        return Base64.getEncoder().encodeToString(videoBytes);
    }

    public static void callWithLocalFile(String localPath)
            throws ApiException, NoApiKeyException, UploadFileException, IOException {

        String base64Video = encodeVideoToBase64(localPath); // Base64 エンコーディング

        MultiModalConversation conv = new MultiModalConversation();
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(new HashMap<String, Object>()
                                       {{
                                           put("video", "data:video/mp4;base64," + base64Video);// fps パラメーターはビデオから抽出されるフレーム数を制御します。1/fps 秒ごとに 1 フレームが抽出されることを示します。
                                           put("fps", 2);
                                       }},
                        new HashMap<String, Object>(){{put("text", "このビデオはどのようなシーンを描いていますか?");}})).build();

        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(userMessage))
                .build();

        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }

    public static void main(String[] args) {
        try {
            // xxx/test.mp4 をローカルビデオの絶対パスに置き換えてください
            callWithLocalFile("xxx/test.mp4");
        } catch (ApiException | NoApiKeyException | UploadFileException | IOException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"f"data:video/mp4;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
             "role": "user",
             "content": [
               {"video": "data:video/mp4;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."},
               {"text": "このビデオはどのようなシーンを描いていますか? "}
                ]
            }
        ]
    }
}'
画像リスト
このセクションでは、ローカルに保存されたファイル football1.jpg、football2.jpg、football3.jpg、および football4.jpg を例として使用します。
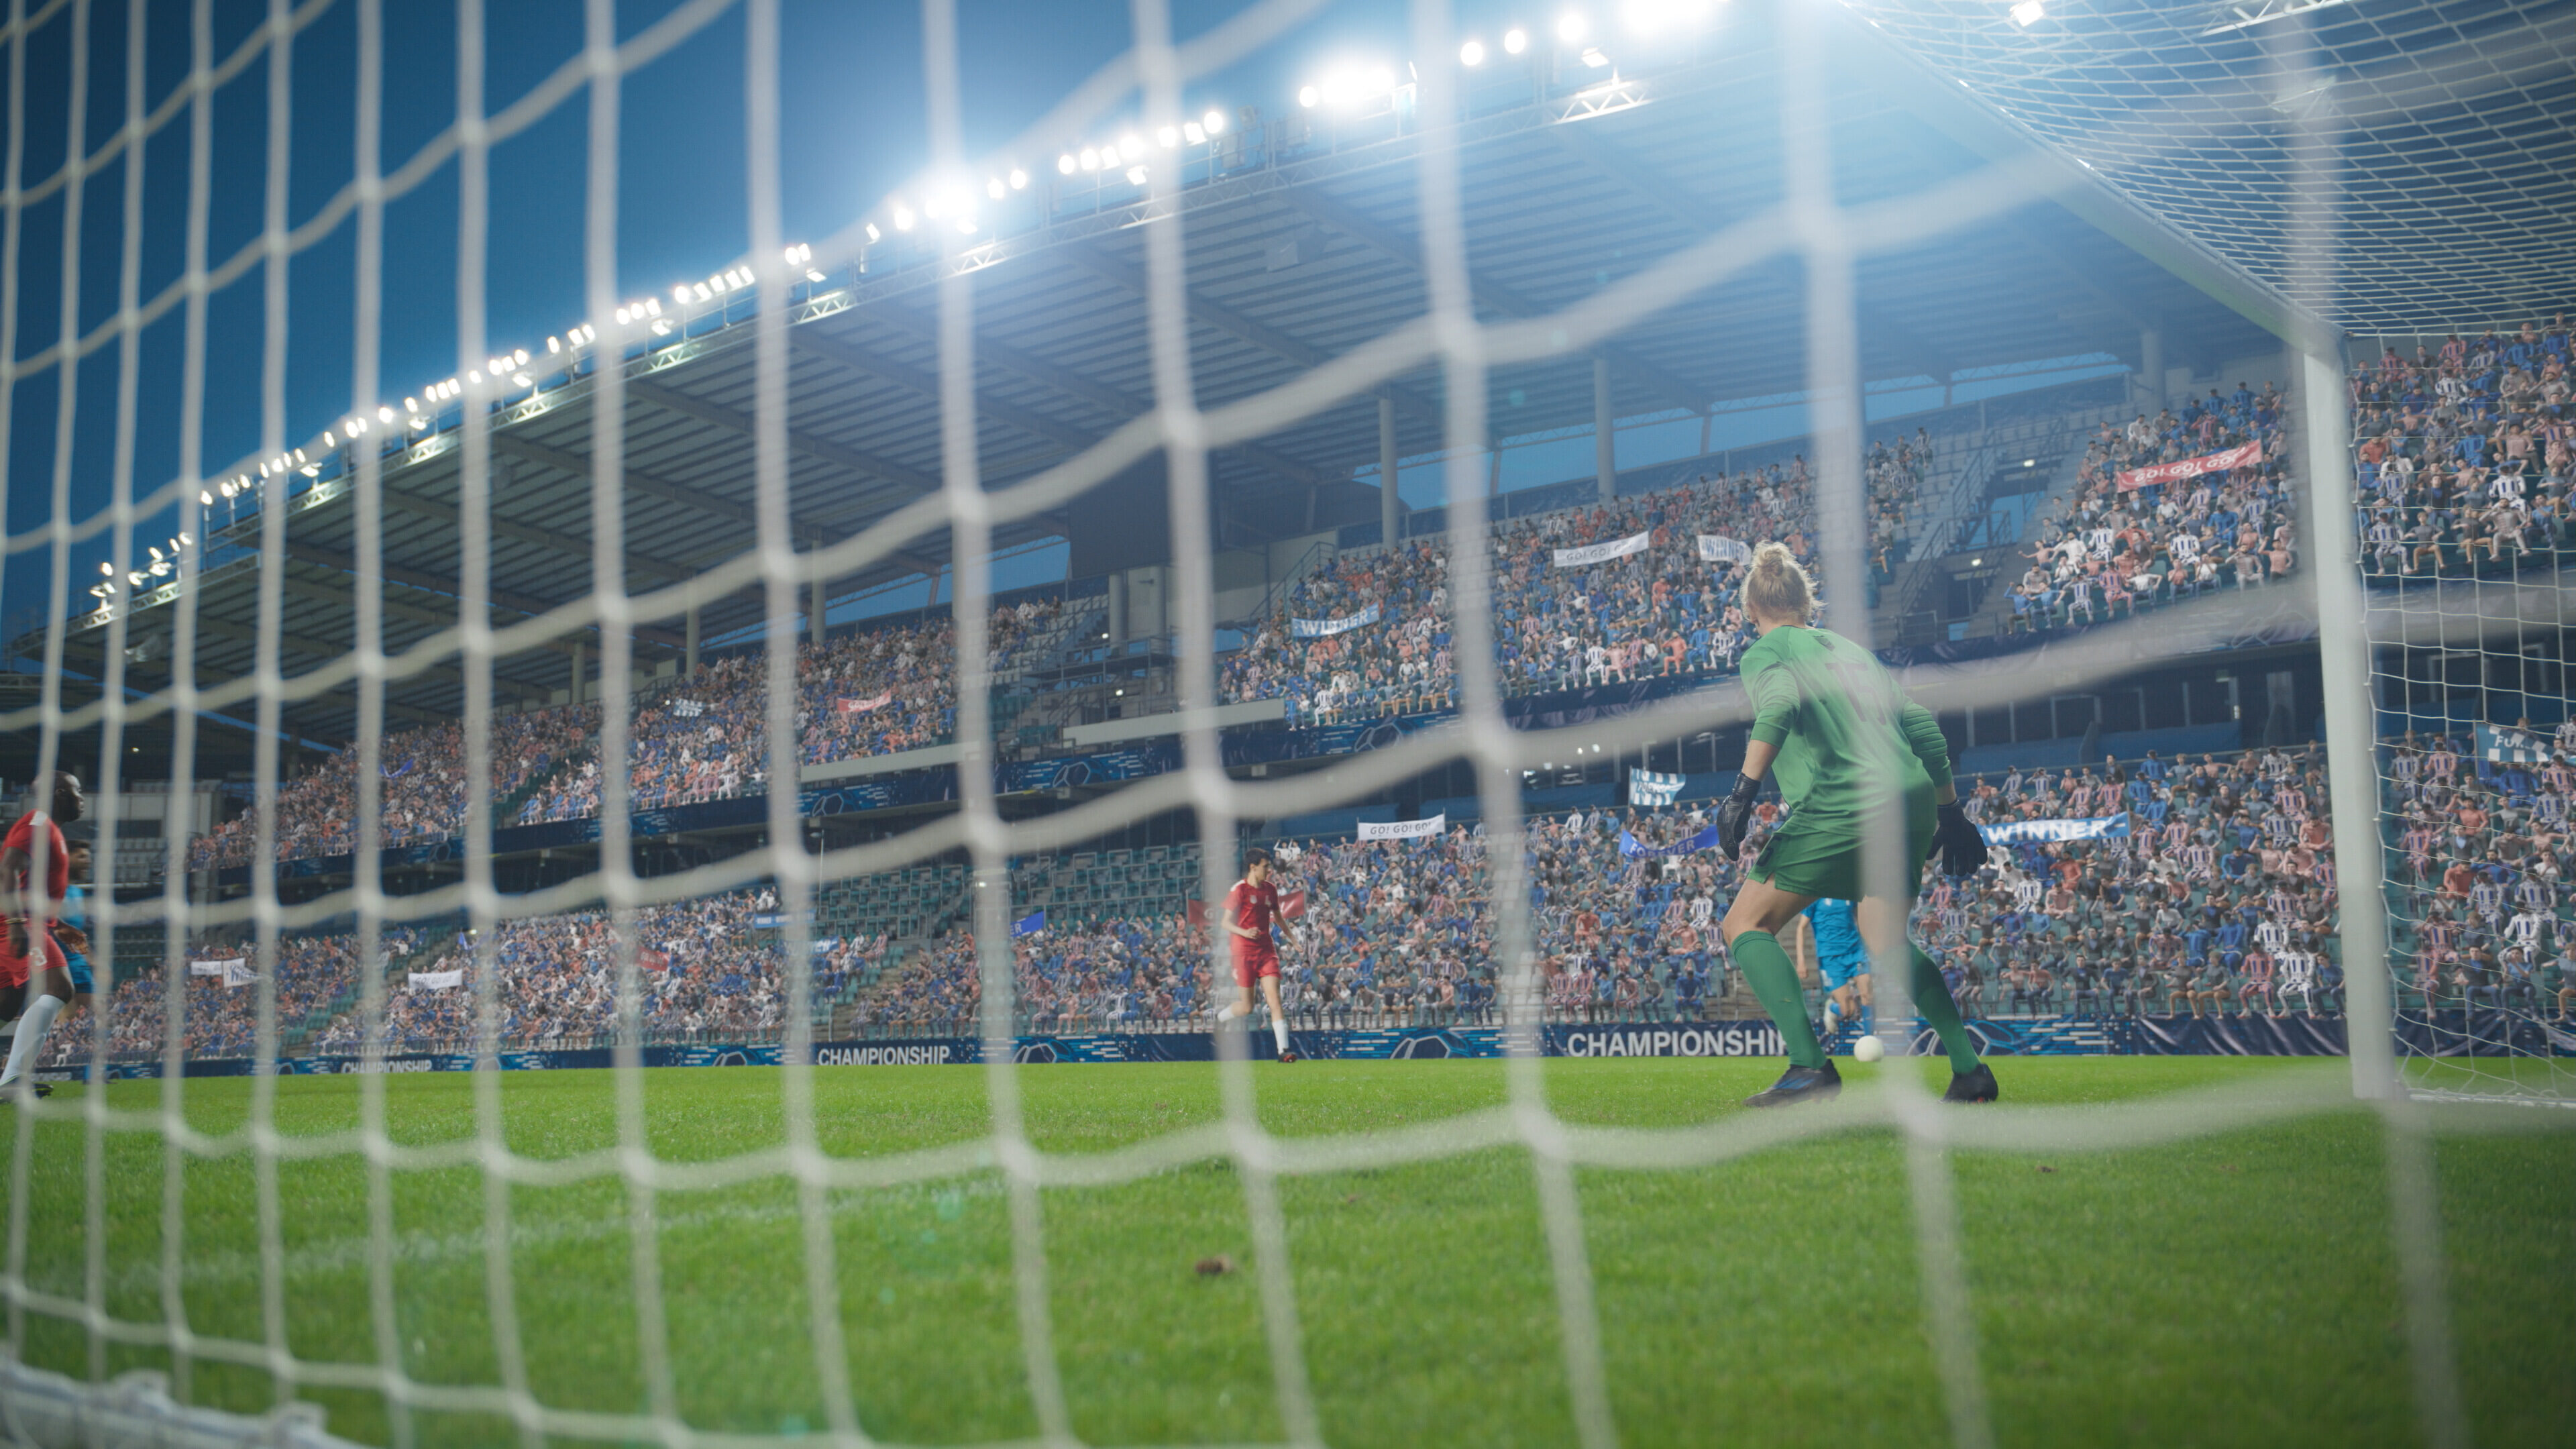


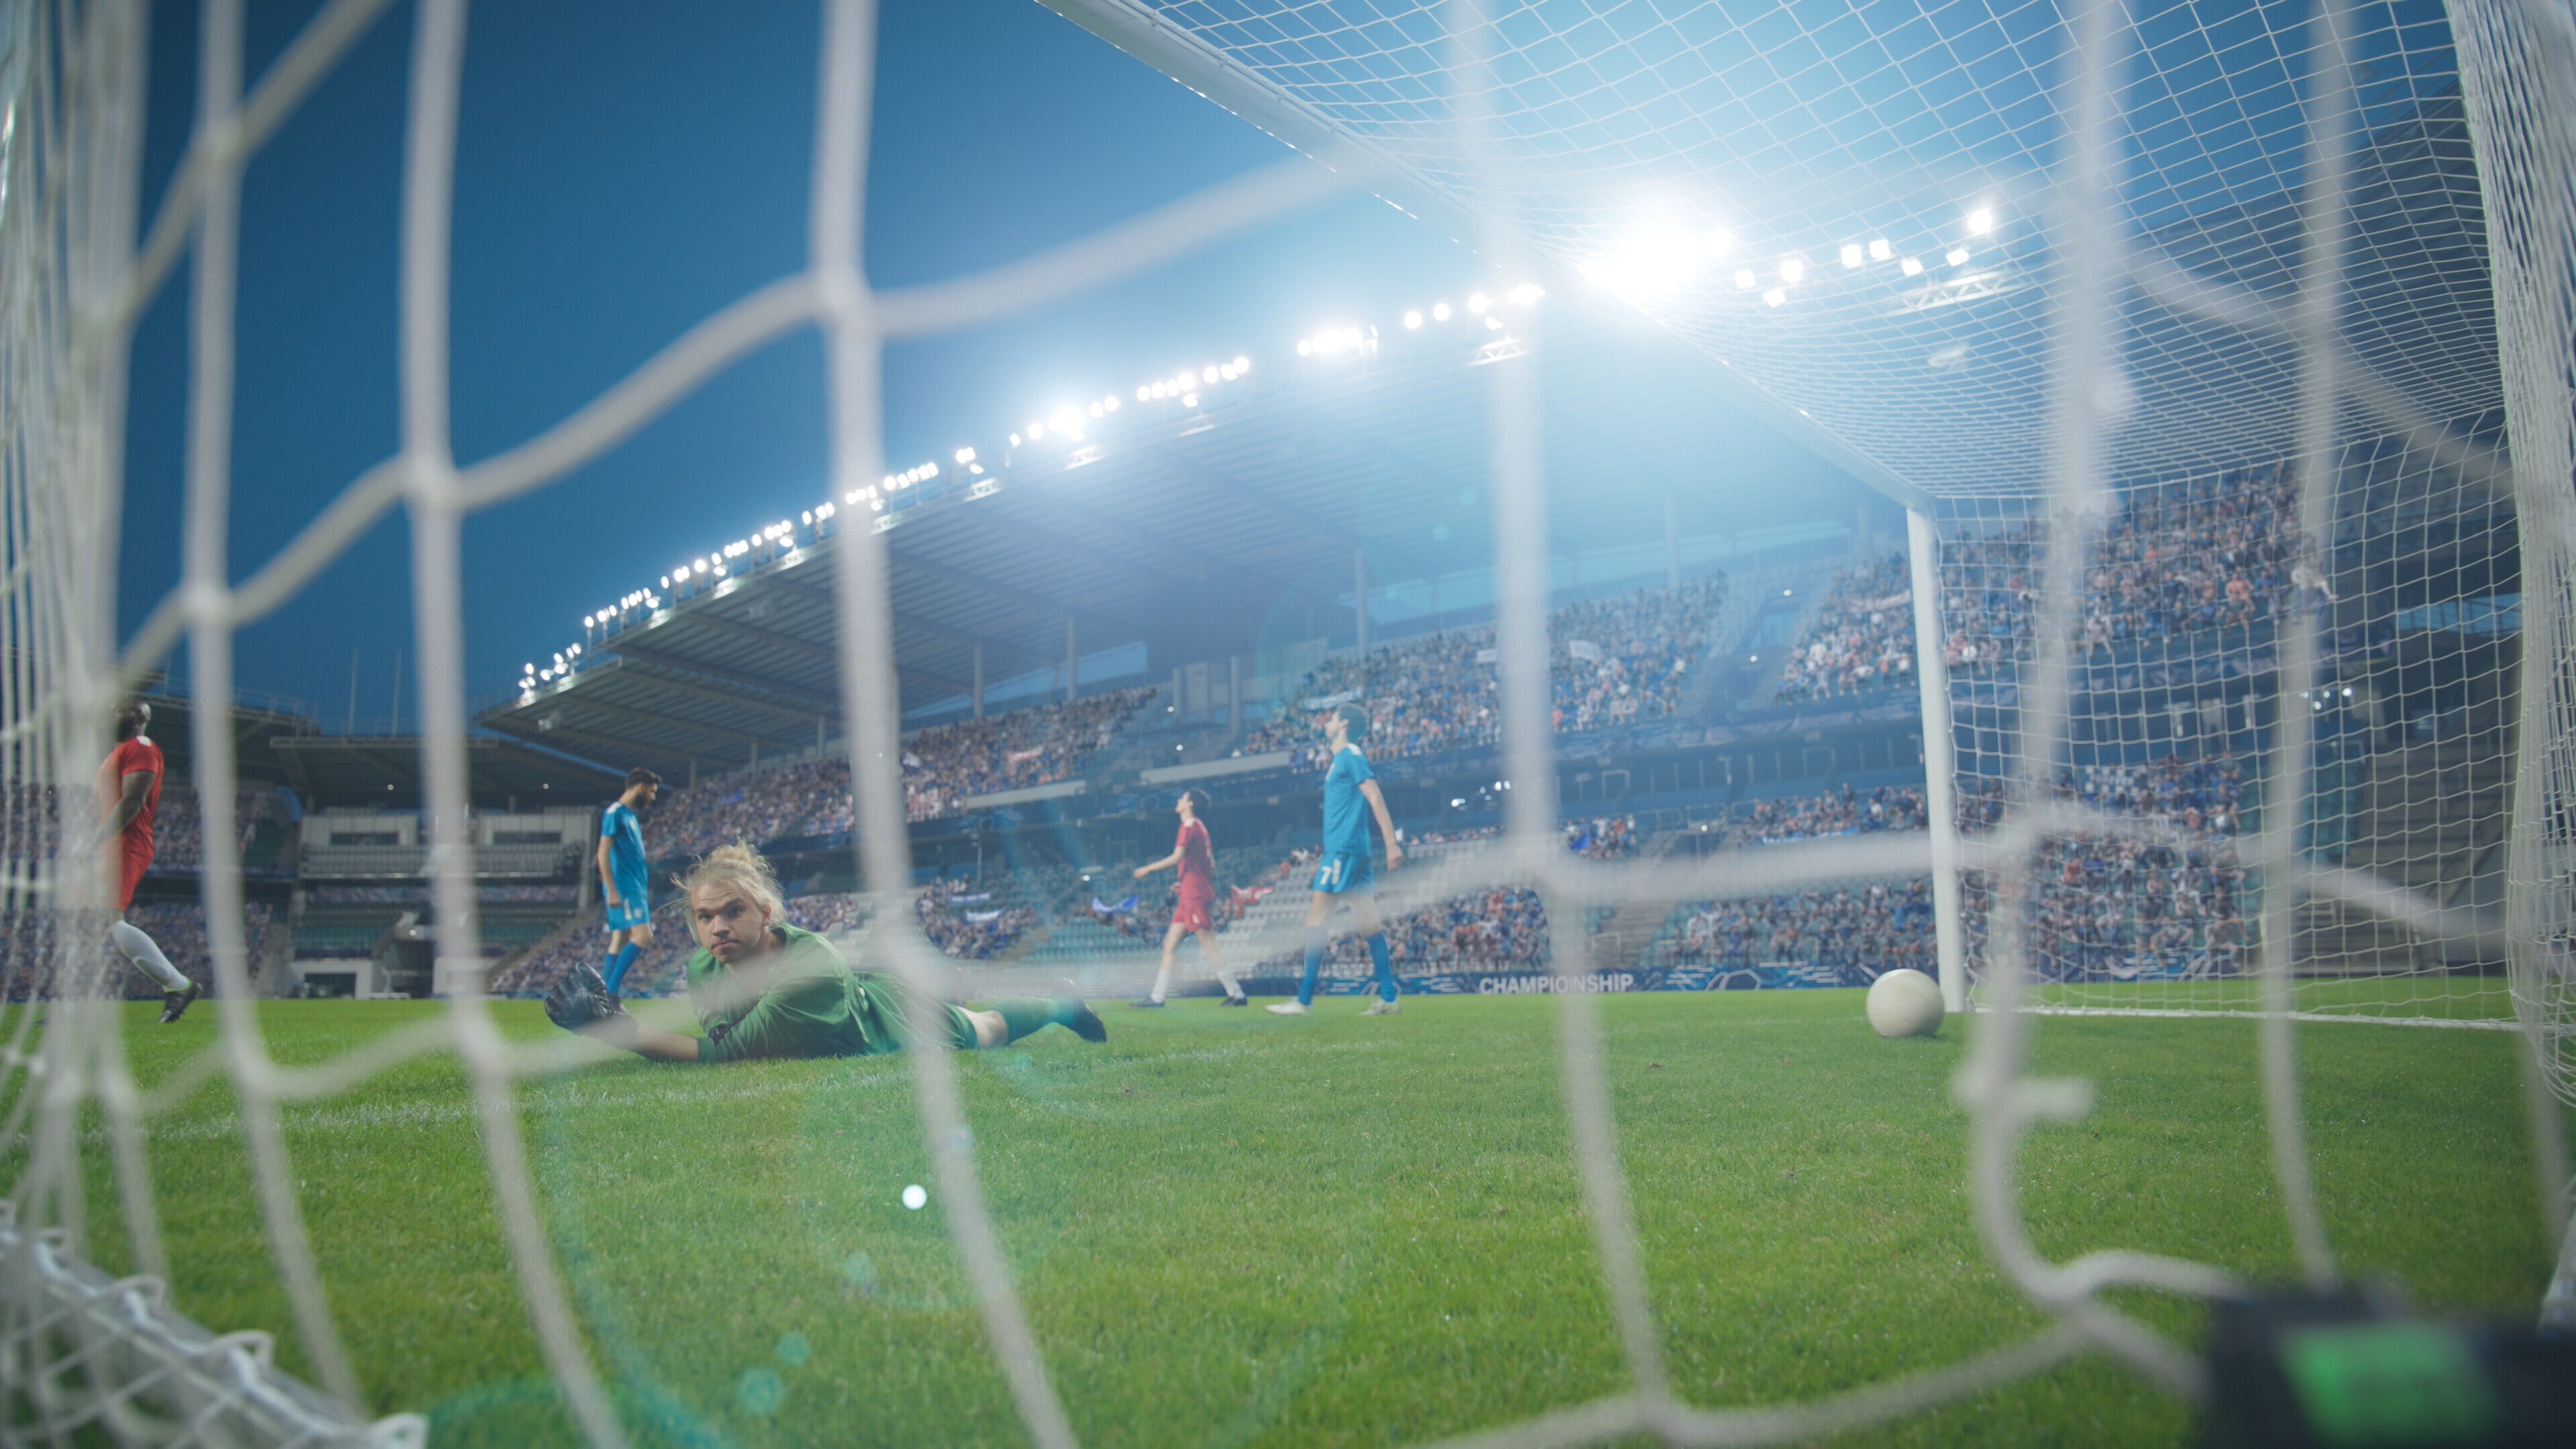
ファイルパスの渡し方
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

local_path1 = "football1.jpg"
local_path2 = "football2.jpg"
local_path3 = "football3.jpg"
local_path4 = "football4.jpg"

image_path1 = f"file://{local_path1}"
image_path2 = f"file://{local_path2}"
image_path3 = f"file://{local_path3}"
image_path4 = f"file://{local_path4}"

messages = [{'role':'user',
              #  画像リストを渡す場合、fps パラメーターは Qwen3.6、Qwen3-VL、および Qwen2.5-VL シリーズのモデルに適用されます。
             'content': [{'video': [image_path1,image_path2,image_path3,image_path4],"fps":2},
                         {'text': 'このビデオはどのようなシーンを描いていますか?'}]}]
response = MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.7-plus',  # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages)

print(response.output.choices[0].message.content[0]["text"])
// DashScope SDK のバージョンは 2.21.10 以降である必要があります。
import java.util.Arrays;
import java.util.Map;
import java.util.Collections;
import java.util.HashMap;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    private static final String MODEL_NAME = "qwen3.8-max";  // この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    public static void videoImageListSample(String localPath1, String localPath2, String localPath3, String localPath4)
            throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        String filePath1 = "file://" + localPath1;
        String filePath2 = "file://" + localPath2;
        String filePath3 = "file://" + localPath3;
        String filePath4 = "file://" + localPath4;
        Map<String, Object> params = new HashMap<>();
        params.put("video", Arrays.asList(filePath1,filePath2,filePath3,filePath4));
        //  画像リストを渡す場合、fps パラメーターは Qwen3.6、Qwen3-VL、および Qwen2.5-VL シリーズのモデルに適用されます。
        params.put("fps", 2);
        MultiModalMessage userMessage = MultiModalMessage.builder()
                .role(Role.USER.getValue())
                .content(Arrays.asList(params,
                        Collections.singletonMap("text", "この動画の具体的なプロセスを説明してください")))
                .build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model(MODEL_NAME)
                .messages(Arrays.asList(userMessage)).build();
        MultiModalConversationResult result = conv.call(param);
        System.out.print(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }
    public static void main(String[] args) {
        try {
            videoImageListSample(
                    "xxx/football1.jpg",
                    "xxx/football2.jpg",
                    "xxx/football3.jpg",
                    "xxx/football4.jpg");
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
Base64 エンコーディングを使用した渡し方
OpenAI 互換
Python
import os
from openai import OpenAI
import base64

# エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode("utf-8")

base64_image1 = encode_image("football1.jpg")
base64_image2 = encode_image("football2.jpg")
base64_image3 = encode_image("football3.jpg")
base64_image4 = encode_image("football4.jpg")
client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",  # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=[
    {"role": "user","content": [
        {"type": "video","video": [
            f"data:image/jpeg;base64,{base64_image1}",
            f"data:image/jpeg;base64,{base64_image2}",
            f"data:image/jpeg;base64,{base64_image3}",
            f"data:image/jpeg;base64,{base64_image4}",]},
        {"type": "text","text": "この動画の具体的なプロセスを説明してください"},
    ]}]
)
print(completion.choices[0].message.content)
Node.js
import OpenAI from "openai";
import { readFileSync } from 'fs';

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

const encodeImage = (imagePath) => {
    const imageFile = readFileSync(imagePath);
    return imageFile.toString('base64');
  };

const base64Image1 = encodeImage("football1.jpg")
const base64Image2 = encodeImage("football2.jpg")
const base64Image3 = encodeImage("football3.jpg")
const base64Image4 = encodeImage("football4.jpg")
async function main() {
    const completion = await openai.chat.completions.create({
        model: "qwen3.8-max",  // この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
        messages: [
            {"role": "user",
             "content": [{"type": "video",
                        "video": [
                            `data:image/jpeg;base64,${base64Image1}`,
                            `data:image/jpeg;base64,${base64Image2}`,
                            `data:image/jpeg;base64,${base64Image3}`,
                            `data:image/jpeg;base64,${base64Image4}`]},
                        {"type": "text", "text": "このビデオはどのようなシーンを描いていますか?"}]}]
    });
    console.log(completion.choices[0].message.content);
}

main();
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "messages": [{"role": "user",
                "content": [{"type": "video",
                "video": [
                          "data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA...",
                          "data:image/jpeg;base64,nEpp6jpnP57MoWSyOWwrkXMJhHRCWYeFYb...",
                          "data:image/jpeg;base64,JHWQnJPc40GwQ7zERAtRMK6iIhnWw4080s...",
                          "data:image/jpeg;base64,adB6QOU5HP7dAYBBOg/Fb7KIptlbyEOu58..."
                          ]},
                {"type": "text",
                "text": "この動画の具体的なプロセスを説明してください"}]}]
}'
DashScope
Python
import base64
import os
import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

#  エンコード関数:ローカルファイルを Base64 エンコードされた文字列に変換します
def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode("utf-8")

base64_image1 = encode_image("football1.jpg")
base64_image2 = encode_image("football2.jpg")
base64_image3 = encode_image("football3.jpg")
base64_image4 = encode_image("football4.jpg")

messages = [{'role':'user',
            'content': [
                    {'video':
                         [f"data:image/jpeg;base64,{base64_image1}",
                          f"data:image/jpeg;base64,{base64_image2}",
                          f"data:image/jpeg;base64,{base64_image3}",
                          f"data:image/jpeg;base64,{base64_image4}"
                         ]
                    },
                    {'text': 'この動画の具体的なプロセスを説明してください。'}]}]
response = dashscope.MultiModalConversation.call(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model='qwen3.7-plus',  # この例では qwen3.7-plus を使用しています。必要に応じてモデル名を変更できます。モデルのリストについては、https://www.alibabacloud.com/help/model-studio/getting-started/models をご参照ください
    messages=messages)

print(response.output.choices[0].message.content[0]["text"])
Java
import java.io.IOException;
import java.util.*;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;

import com.alibaba.dashscope.aigc.multimodalconversation.*;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    private static String encodeImageToBase64(String imagePath) throws IOException {
        Path path = Paths.get(imagePath);
        byte[] imageBytes = Files.readAllBytes(path);
        return Base64.getEncoder().encodeToString(imageBytes);
    }

    public static void videoImageListSample(String localPath1,String localPath2,String localPath3,String localPath4)
            throws ApiException, NoApiKeyException, UploadFileException, IOException {

        String base64Image1 = encodeImageToBase64(localPath1); // Base64 エンコーディング
        String base64Image2 = encodeImageToBase64(localPath2);
        String base64Image3 = encodeImageToBase64(localPath3);
        String base64Image4 = encodeImageToBase64(localPath4);

        MultiModalConversation conv = new MultiModalConversation();
        Map<String, Object> params = new HashMap<>();
        params.put("video", Arrays.asList(
                        "data:image/jpeg;base64," + base64Image1,
                        "data:image/jpeg;base64," + base64Image2,
                        "data:image/jpeg;base64," + base64Image3,
                        "data:image/jpeg;base64," + base64Image4));
        //  画像リストを渡す場合、fps パラメーターは Qwen3.6、Qwen3-VL、および Qwen2.5-VL シリーズのモデルに適用されます。
        params.put("fps", 2);
        MultiModalMessage userMessage = MultiModalMessage.builder()
                .role(Role.USER.getValue())
                .content(Arrays.asList(params,
                        Collections.singletonMap("text", "この動画の具体的なプロセスを説明してください")))
                .build();

        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .messages(Arrays.asList(userMessage))
                .build();

        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
    }

    public static void main(String[] args) {
        try {
            // xxx/football1.png およびその他のファイルをローカル画像の絶対パスに置き換えてください
            videoImageListSample(
                    "xxx/football1.jpg",
                    "xxx/football2.jpg",
                    "xxx/football3.jpg",
                    "xxx/football4.jpg"
            );
        } catch (ApiException | NoApiKeyException | UploadFileException | IOException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
curl
- ファイルを Base64 エンコードされた文字列に変換する方法については、サンプルコードをご参照ください。
- デモンストレーションのため、コード内の Base64 エンコードされた文字列
"data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA..."は切り捨てられています。実際の使用では、完全なエンコード文字列を渡すようにしてください。
# ======= 重要 =======
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
  "model": "qwen3.8-max",
  "input": {
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "video": [
                      "data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAA...",
                      "data:image/jpeg;base64,nEpp6jpnP57MoWSyOWwrkXMJhHRCWYeFYb...",
                      "data:image/jpeg;base64,JHWQnJPc40GwQ7zERAtRMK6iIhnWw4080s...",
                      "data:image/jpeg;base64,adB6QOU5HP7dAYBBOg/Fb7KIptlbyEOu58..."
            ],
            "fps":2
          },
          {
            "text": "この動画の具体的なプロセスを説明してください"
          }
        ]
      }
    ]
  }
}'
高解像度画像の処理
視覚理解モデル API には、単一のエンコードされた画像の視覚トークン数に制限があります。デフォルト設定では、高解像度画像は圧縮されるため、詳細が失われ、理解精度に影響を与える可能性があります。vl_high_resolution_images を有効にするか、max_pixels を調整して視覚トークン数を増やすことができます。これにより、より多くの画像の詳細が保持され、理解が向上します。
各モデルの視覚トークンあたりのピクセル数、トークン制限、ピクセル制限を表示
入力画像のピクセル数がモデルのピクセル制限を超えると、画像は制限内に収まるようにダウンスケールされます。
モデル | トークンあたりのピクセル数 | vl_high_resolution_images | max_pixels | トークン制限 | ピクセル制限 |
|
|
|
|
|
|
| カスタマイズ可能。デフォルト値は |
|
| ||
|
|
|
|
|
|
| カスタマイズ可能。デフォルト値は |
|
| ||
その他の |
|
|
|
|
|
| カスタマイズ可能。デフォルト値は |
|
|
-
vl_high_resolution_images=trueの場合、API は固定解像度ポリシーを使用し、max_pixels設定を無視します。これは、画像内の細かいテキスト、小さなオブジェクト、または豊富な詳細を認識するのに適しています。 -
vl_high_resolution_images=falseの場合、最終的なピクセル制限はmax_pixelsパラメーターの値に依存します。- 視覚トークンの消費を削減したいコストに敏感なシナリオの場合:
max_pixelsのデフォルト値を使用するか、より小さい値に設定します。max_pixelsは主に視覚トークンの数と呼び出しコストに影響します。私たちのテストでは、これを下げてもエンドツーエンドの応答時間に大きな影響はありませんでした。遅延を減らすには、「応答速度とモデルの選択」をご参照ください。 - 特定の詳細に焦点を当て、処理速度の低下を受け入れられる場合は、必要に応じて
max_pixelsの値を増やしてください。
- 視覚トークンの消費を削減したいコストに敏感なシナリオの場合:
応答速度とモデルの選択
遅延の影響を受けやすいシナリオでは、応答時間は主に選択したモデルによって決まり、max_pixels には依存しません。次の表は、同じ入力条件下での qwen-vl-max と qwen-vl-plus の応答時間を比較したものです:
モデル | 平均応答時間 | 特徴 |
|---|---|---|
| 約 12 秒 | 高精度の認識。豊富な詳細と低いエラー許容度を持つ画像に適しています。 |
| 約 8 秒 | 速度と精度のバランスが取れています。 |
上記の応答時間は、単一の 2480x3508 ピクセル画像に対する測定された参照値です (qwen-vl-max:12.75 秒と 11.84 秒、平均 12.29 秒;qwen-vl-plus:8.29 秒と 6.75 秒、平均 7.52 秒)。実際の遅延は、画像サイズ、出力長、およびネットワーク条件によって異なります。これらの値は参照用であり、パフォーマンスを保証するものではありません。
- ストリーミング出力 (
stream=True) を有効にすると、最初のトークンまでの時間が大幅に短縮されます:同じリクエストで、最初のトークンは約 0.95 秒で返されますが、完全な応答の合計時間は変わりません。これは、できるだけ早くフィードバックを表示する必要があるインタラクティブなシナリオに適しています。 - ワークフローなどの遅延の影響を受けやすい画像認識シナリオの場合:
qwen-vl-plusとstream=Trueを使用して、最初のトークンを約 1 秒で取得します。qwen-vl-plusの認識精度が要件を満たさない場合にのみ、qwen-vl-maxに切り替えてください。max_pixelsの調整は、速度を向上させる方法ではありません。
OpenAI 互換
vl_high_resolution_images は標準の OpenAI パラメーターではありません。これを渡す方法は、言語 SDK によって異なります:
- Python SDK:
extra_bodyディクショナリを通じて渡す必要があります。 - Node.js SDK:トップレベルのパラメーターとして直接渡すことができます。
import os
import time
from openai import OpenAI

client = OpenAI(
    # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {"role": "user","content": [
            {"type": "image_url","image_url": {"url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg"},
            # max_pixels は入力画像の最大ピクセルしきい値を表します。vl_high_resolution_images=True の場合は無効です。vl_high_resolution_images=False の場合はカスタマイズ可能で、最大値はモデルによって異なります。
            # "max_pixels": 16384 * 32 * 32
            },
           {"type": "text", "text": "この画像はどのような祭りの雰囲気を伝えていますか"},
            ],
        }
    ],
    extra_body={"vl_high_resolution_images":True}

)
print(f"モデルの出力: {completion.choices[0].message.content}")
print(f"合計入力トークン: {completion.usage.prompt_tokens}")
import OpenAI from "openai";

const openai = new OpenAI(
    {
        // API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:apiKey: "sk-xxx"
        apiKey: process.env.DASHSCOPE_API_KEY,
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        baseURL: "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1"
    }
);

const response = await openai.chat.completions.create({
        model: "qwen3.8-max",
        messages: [
        {role: "user",content: [
            {type: "image_url",
            image_url: {"url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg"},
            // max_pixels は入力画像の最大ピクセルしきい値を表します。vl_high_resolution_images=True の場合は効果がありません。vl_high_resolution_images=False の場合はカスタマイズ可能で、最大値はモデルによって異なります。
            // "max_pixels": 2560 * 32 * 32
            },
            {type: "text", text: "この画像はどのような祭りの雰囲気を伝えていますか?" },
        ]}],
        vl_high_resolution_images:true
    })

console.log("モデルの出力:",response.choices[0].message.content);
console.log("合計入力トークン",response.usage.prompt_tokens);
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
  "model": "qwen3.8-max",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg"
          }
        },
        {
          "type": "text",
          "text": "この画像はどのような祭りの雰囲気を伝えていますか?"
        }
      ]
    }
  ],
  "vl_high_resolution_images":true
}'
DashScope
import os
import time

import dashscope

# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

messages = [
    {
        "role": "user",
        "content": [
            {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg",
            # max_pixels は入力画像の最大ピクセルしきい値を表します。vl_high_resolution_images=True の場合は無効です。vl_high_resolution_images=False の場合はカスタマイズ可能で、最大値はモデルによって異なります。
            # "max_pixels": 16384 * 32 * 32
            },
            {"text": "この画像はどのような祭りの雰囲気を伝えていますか?"}
        ]
    }
]

response = dashscope.MultiModalConversation.call(
        # 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:api_key="sk-xxx"
        # API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
        api_key=os.getenv('DASHSCOPE_API_KEY'),
        model='qwen3.7-plus',
        messages=messages,
        vl_high_resolution_images=True
    )

print("モデルの出力",response.output.choices[0].message.content[0]["text"])
print("合計入力トークン:",response.usage.input_tokens)
import java.util.Arrays;
import java.util.Collections;
import java.util.Map;
import java.util.HashMap;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversation;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationParam;
import com.alibaba.dashscope.aigc.multimodalconversation.MultiModalConversationResult;
import com.alibaba.dashscope.common.MultiModalMessage;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import com.alibaba.dashscope.exception.UploadFileException;
import com.alibaba.dashscope.utils.Constants;

public class Main {

    static {
        // 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
        Constants.baseHttpApiUrl="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1";
    }

    public static void simpleMultiModalConversationCall()
            throws ApiException, NoApiKeyException, UploadFileException {
        MultiModalConversation conv = new MultiModalConversation();
        Map<String, Object> map = new HashMap<>();
        map.put("image", "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg");
        // max_pixels は入力画像の最大ピクセルしきい値を表します。vl_high_resolution_images=True の場合は無効です。vl_high_resolution_images=False の場合はカスタマイズ可能で、最大値はモデルによって異なります。
        // map.put("max_pixels", 2621440);
        MultiModalMessage userMessage = MultiModalMessage.builder().role(Role.USER.getValue())
                .content(Arrays.asList(
                        map,
                        Collections.singletonMap("text", "この画像はどのような祭りの雰囲気を伝えていますか?"))).build();
        MultiModalConversationParam param = MultiModalConversationParam.builder()
                // 環境変数を設定していない場合は、次の行を Model Studio API キーに置き換えてください:.apiKey("sk-xxx")
                .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                .model("qwen3.8-max")
                .message(userMessage)
                .vlHighResolutionImages(true)
                .build();
        MultiModalConversationResult result = conv.call(param);
        System.out.println(result.getOutput().getChoices().get(0).getMessage().getContent().get(0).get("text"));
        System.out.println(result.getUsage().getInputTokens());
    }

    public static void main(String[] args) {
        try {
            simpleMultiModalConversationCall();
        } catch (ApiException | NoApiKeyException | UploadFileException e) {
            System.out.println(e.getMessage());
        }
        System.exit(0);
    }
}
# ======= 重要 =======
# API キーはリージョンによって異なります。API キーを取得するには、https://www.alibabacloud.com/help/ja/model-studio/get-api-key をご参照ください
# 次の URL はシンガポールリージョン用です。API を呼び出す際に、{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
# === 実行前にこのコメントを削除してください ===

curl -X POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "model": "qwen3.8-max",
    "input":{
        "messages":[
            {
             "role": "user",
             "content": [
               {"image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250212/earbrt/vcg_VCG211286867973_RF.jpg"},
               {"text": "この画像はどのような祭りの雰囲気を伝えていますか?"}
                ]
            }
        ]
    },
    "parameters": {
        "vl_high_resolution_images": true
    }
}'
その他の使用法
使用制限
入力ファイルの制限
画像の制限
-
画像解像度:
-
最小サイズ:画像の幅と高さは両方とも
10ピクセルより大きい必要があります。 -
アスペクト比:元画像とスケーリングされた画像の両方で、長辺と短辺の比率が
200:1を超えてはなりません。画像のスケーリングロジックについては、「画像トークンの計算
smart_resize -
最大ピクセル数:
- 画像解像度を
8K (7680x4320)以内に保ってください。より高い解像度の画像は、ファイルサイズが大きく、ネットワーク転送時間が長くなるため、API 呼び出しのタイムアウトを引き起こす可能性があります。 - 自動スケーリング:モデルは
max_pixelsとmin_pixelsを使用して画像サイズを調整できます。高解像度の画像を提供しても検出精度は向上せず、むしろ呼び出し失敗のリスクが高まります。アップロードする前に、クライアント側で画像を適切なサイズにスケーリングしてください。
- 画像解像度を
-
-
サポートされている画像形式
-
4K
(3840x2160)未満の解像度では、次の画像形式がサポートされています:画像形式
一般的な拡張子
MIME タイプ
BMP
.bmp
image/bmp
JPEG
.jpe, .jpeg, .jpg
image/jpeg
PNG
.png
image/png
TIFF
.tif, .tiff
image/tiff
WEBP
.webp
image/webp
HEIC
.heic
image/heic
-
4K (3840x2160)と8K (7680x4320)の間の解像度では、JPEG、JPG、および PNG 形式のみがサポートされています。
-
-
画像サイズ:
以下の制限は個々の画像ごとに適用されます。複数画像の入力の場合、各画像は独立して評価され、サイズは合計されません。
- パブリック URL として渡す場合:Qwen3.8、Qwen3.7、Qwen3.6、および Qwen3.5 と Qwen3-VL シリーズのモデルでは、単一の画像は
20 MBを超えることはできません。その他のモデルでは、単一の画像は10 MBを超えることはできません。 - ローカルパスとして渡す場合:単一の画像は
10 MBを超えることはできません。 - Base64 エンコーディングとして渡す場合 (OpenAI 互換 API):Qwen3.8、Qwen3.7、Qwen3.6、Qwen3.5 および Qwen3-VL シリーズのモデルでは、エンコード前の元の画像ファイルは
20 MBを超えることはできません。その他のモデルでは、10 MBを超えることはできません。どちらの場合も、結果の Data URI 文字列は20 MBを超えることはできません。 - Base64 エンコーディングとして渡す場合 (Anthropic 互換 API):リクエストボディの合計は
6 MBを超えることはできません。複数の画像を渡す場合、このクォータを共有します。
これらの制限は使用するモデルによって異なります。上位のプランを購入したり、モデルのバージョンをアップグレードしたりしても、これらの制限を引き上げることはできません。
ファイルを圧縮するには、「画像または動画を必要なサイズに圧縮する方法」をご参照ください。
- パブリック URL として渡す場合:Qwen3.8、Qwen3.7、Qwen3.6、および Qwen3.5 と Qwen3-VL シリーズのモデルでは、単一の画像は
-
画像数量制限:複数画像入力でサポートされる最大画像数は、入力方法によって異なります:
-
パブリック URL またはローカルパスとして渡す場合:
- Qwen3.8-Max、Qwen3.8-Flash、Qwen3.7-Plus シリーズ:最大 2,048 枚の画像
- Qwen3.7-Flash、Qwen3.6-Plus、Qwen3.6-Flash、Qwen3.5-Plus、Qwen3.5-Flash、Qwen3-VL、Qwen-VL、QVQ シリーズ:最大 256 枚の画像
- Qwen-Omni シリーズについては、「Omni-modal」をご参照ください。
-
Base64 エンコードされた文字列として渡す場合:最大 250 枚の画像
-
すべての画像の合計トークン数も、モデルの最大入力トークン制限によって制限されます。すべての画像とテキストの合計トークン数は、モデルの最大入力を超えてはなりません。
動画の制限
-
画像リストとして渡す場合、リスト内の画像数は次のように制限されます:
qwen3.8、qwen3.7シリーズ、qwen3.6シリーズ、およびqwen3.5シリーズ:最小 4 枚、最大 8,000 枚の画像qwen3-vl-plusシリーズ、qwen3-vl-flashシリーズ、qwen3-vl-235b-a22b-thinking、およびqwen3-vl-235b-a22b-instruct:最小 4 枚、最大 2,000 枚の画像- その他のオープンソース
Qwen3-VL、Qwen2.5-VL(商用およびオープンソース版を含む)、およびQVQシリーズのモデル:最小 4 枚、最大 512 枚の画像 - その他のモデル:最小 4 枚、最大 80 枚の画像
-
ビデオファイルとして渡す場合:
-
ビデオサイズ:
-
パブリック URL として渡す場合:
qwen3.8シリーズ、qwen3.7シリーズ、qwen3.6シリーズ、qwen3.5シリーズ、Qwen3-VLシリーズ、およびqwen-vl-max:2 GB を超えることはできません。qwen-vl-plusシリーズ、その他のqwen-vl-maxモデル、オープンソースQwen2.5-VLシリーズ、およびQVQシリーズのモデル:1 GB を超えることはできません。- その他のモデル:150 MB を超えることはできません。
-
Base64 エンコードされた文字列として渡す場合:エンコードされた文字列は 10 MB 未満である必要があります。
-
ローカルファイルパスとして渡す場合:ビデオファイルは 100 MB を超えることはできません。
ファイルを圧縮するには、「画像または動画を必要なサイズに圧縮する方法」をご参照ください。
-
-
動画の持続時間:
qwen3.8シリーズ、qwen3.7シリーズ、qwen3.6シリーズ、およびqwen3.5シリーズ:2 秒から 2 時間。qwen3-vl-plusシリーズ、qwen3-vl-flashシリーズ、qwen3-vl-235b-a22b-thinking、およびqwen3-vl-235b-a22b-instruct:2 秒から 1 時間。- その他のオープンソース
Qwen3-VLシリーズおよびqwen-vl-max:2 秒から 20 分。 qwen-vl-plusシリーズ、その他のqwen-vl-maxモデル、オープンソースQwen2.5-VLシリーズ、およびQVQシリーズのモデル:2 秒から 10 分。- その他のモデル:2 秒から 40 秒。
-
ビデオフォーマット:MP4、AVI、MKV、MOV、FLV、WMV など。
-
ビデオのディメンション:特定の制限はありません。モデルは
max_pixelsとmin_pixelsを使用してビデオのディメンションを自動的に調整できます。大きなビデオファイルがより良い理解をもたらすわけではありません。 -
ビデオ数量制限:最大 64 本のビデオを渡すことができます。
-
音声理解:モデルはビデオファイルの音声トラックの理解をサポートしていません。
-
ビデオサイズ:
ファイル入力方法
-
パブリック URL:HTTP または HTTPS プロトコルをサポートする公開アクセス可能なファイルアドレスを提供します。最適な安定性とパフォーマンスを得るには、ファイルを OSS にアップロードしてパブリック URL を取得します。Model Studio は、
-internalを含む OSS 内部エンドポイント (例:https://<bucket>.oss-cn-hangzhou-internal.aliyuncs.com/image.jpg) にアクセスできません。内部アドレスを渡すと、ファイルのダウンロードに失敗し、InvalidParameterが返され、メッセージFailed to download multimodal contentが表示されます。代わりに、OSS パブリックエンドポイント (例:https://<bucket>.oss-cn-hangzhou.aliyuncs.com/image.jpg) または署名付き OSS URL を使用してください。重要モデルがファイルを正常にダウンロードできるようにするには、パブリック URL のレスポンスヘッダーに 必ず Content-Length (ファイルサイズ) と Content-Type (メディアタイプ、例:image/jpeg) を含める必要があります。どちらかのフィールドが欠落しているか、正しくない場合、ファイルのダウンロードは失敗します。
-
Base64 エンコーディング:ファイルを Base64 エンコードされた文字列に変換してから渡します。
-
ローカルファイルパス (DashScope SDK のみ):ローカルファイルのパスを渡します。
ファイル入力方法の選択に関する推奨事項については、「ファイルアップロード方法の選択方法
本番環境での使用
-
画像と動画の前処理:視覚理解モデルには入力ファイルのサイズ制限があります。ファイルを圧縮するには、「画像または動画の圧縮方法」をご参照ください。
-
テキストファイルの処理:視覚理解モデルは画像と動画ファイルのみをサポートしています。TXT、Word (.doc/.docx)、PDF、またはその他のテキストベースのファイルの処理はサポートしていません。次のいずれかの回避策を使用してください:
-
フォールトトレランスと安定性
- タイムアウト処理:非ストリーミング呼び出しでは、モデルが 300 秒以内に出力生成を完了しない場合、タイムアウトエラーが発生します。タイムアウトが発生すると、生成されたコンテンツがレスポンスボディで返されます。
x-dashscope-partialresponse: trueを含むレスポンスヘッダーは、応答がタイムアウトしたことを示します。一部のモデルでサポートされている部分補完モード機能を使用します。生成されたコンテンツをmessages配列に追加してリクエストを再送信します。これにより、大規模言語モデル (LLM) はコンテンツの生成を続行できます。詳細については、「不完全な出力からの生成の続行」をご参照ください。 - クライアント側のタイムアウト構成:前述のタイムアウトは、モデルが 300 秒以内に出力生成を完了しない場合に発生するサーバー側のタイムアウトです。これは、SDK のデフォルトのクライアント側タイムアウトとは異なります。4000 x 4000 ピクセルの画像などの大きな画像を処理する場合、リクエストが SDK のデフォルトのクライアント側タイムアウトよりも長くかかり、サーバー側の 300 秒の制限に達していなくても
APITimeoutErrorで中断されることがあります。これを避けるには、OpenAI Python SDK のwith_optionsを使用してクライアント側のタイムアウトを延長します:
- タイムアウト処理:非ストリーミング呼び出しでは、モデルが 300 秒以内に出力生成を完了しない場合、タイムアウトエラーが発生します。タイムアウトが発生すると、生成されたコンテンツがレスポンスボディで返されます。
client = client.with_options(timeout=1800.0)
response = client.chat.completions.create(
    model="qwen-vl-plus",
    messages=[...]
)
- ストリーミング出力:
stream=Trueを設定すると、モデルは単一の完全な応答を待つのではなく、コンテンツを増分的に返します。これにより、大きな画像を処理する際の長時間の非ストリーミング呼び出しによるクライアント側のタイムアウトを防ぎます:
stream = client.chat.completions.create(
    model="qwen-vl-plus",
    messages=[...],
    stream=True
)
for chunk in stream:
    print(chunk.choices[0].delta.content)
- リトライメカニズム:ネットワークの変動や一時的なサービスの利用不能に対処するために、指数バックオフなどの合理的な API 呼び出しリトライロジックを設計します。
課金とレート制限
-
課金:合計コストは、入力トークンと出力トークンの総数に基づいて計算されます。入力と出力の価格は、Model Studio コンソールで確認できます。
-
トークンの構成:入力トークンは、テキストトークンと、画像または動画から変換されたトークンで構成されます。出力トークンは、モデルによって生成されたテキストです。思考モードでは、モデルの思考プロセスも出力トークンとしてカウントされます。思考モードで思考プロセスが出力されない場合、課金はノンシンキングモードの価格設定に従います。
-
画像と動画のトークンを計算する:次のコードを使用して、画像または動画のトークン消費量を計算します。推定結果は参照用です。実際の使用量は API 応答に基づきます。
画像と動画のトークンを計算する
画像
数式:
画像トークン = h_bar * w_bar / token_pixels + 2-
h_bar, w_bar:スケーリングされた画像の高さと幅。画像を処理する前に、モデルは前処理を実行して特定のピクセル制限まで縮小します。この制限は、max_pixelsおよびvl_high_resolution_imagesパラメーターの値によって異なります。詳細については、「高解像度画像の処理」をご参照ください。 -
token_pixels:各視覚tokenに対応するピクセル値。これはモデルによって異なります:qwen3.8-series、qwen3.7-series、qwen3.6-series、qwen3.5-series、Qwen3-VL、qwen-vl-max、およびqwen-vl-plus:各tokenは32x32ピクセルに対応します。QVQおよびその他のQwen2.5-VLモデル:各トークンは28x28ピクセルに対応します。
次のコードは、モデルが使用するおおよその画像スケーリングロジックを示しています。これを使用して画像のトークンを推定します。実際の課金については、API 応答をご参照ください。
import math
from PIL import Image  # pip install Pillow

def smart_resize(image_path, max_pixels, vl_high_resolution_images):
    """モデルパラメーターに基づいてスケーリングされた画像のディメンションを計算し、画像トークンを推定します。"""
    image = Image.open(image_path)
    height, width = image.height, image.width

    # スケーリング係数は、Qwen3.6、Qwen3.5、Qwen3-VL などのモデルでは 32 です。その他のモデルでは 28 です。
    factor = 32
    h_bar = round(height / factor) * factor
    w_bar = round(width / factor) * factor

    # トークンの下限:4 トークン
    min_pixels = 4 * factor * factor

    # vl_high_resolution_images=True の場合、トークンの上限は 16384 に固定され、max_pixels は無視されます。
    if vl_high_resolution_images:
        max_pixels = 16384 * factor * factor

    # ピクセルの総数を [min_pixels, max_pixels] の範囲に制約します。
    if h_bar * w_bar > max_pixels:
        beta = math.sqrt((height * width) / max_pixels)
        h_bar = math.floor(height / beta / factor) * factor
        w_bar = math.floor(width / beta / factor) * factor
    elif h_bar * w_bar < min_pixels:
        beta = math.sqrt(min_pixels / (height * width))
        h_bar = math.ceil(height * beta / factor) * factor
        w_bar = math.ceil(width * beta / factor) * factor

    return h_bar, w_bar

if __name__ == "__main__":
    # 注:max_pixels と vl_high_resolution_images の値は、モデルを呼び出す際に渡されるパラメーターと一致する必要があります。
    h_bar, w_bar = smart_resize("xxx/test.jpg", max_pixels=2560 * 32 * 32, vl_high_resolution_images=False)
    print(f"スケーリングされた画像のディメンション:高さ {h_bar}、幅 {w_bar}")

    # 各画像には、1 つの <vision_bos> と 1 つの <vision_eos> トークンが含まれます。
    token = int(h_bar * w_bar / (32 * 32)) + 2
    print(f"画像トークン数:{token}")
動画
-
ビデオファイル:
ビデオファイルを処理する際、モデルはまずフレームを抽出し、次にすべてのビデオフレームの合計トークン数を計算します。この計算は複雑なため、次のコードを使用して、パスを指定することでビデオの合計トークン消費量を推定できます:
# 使用前にインストール:pip install opencv-python import math import os import logging import cv2 logger = logging.getLogger(__name__) FRAME_FACTOR = 2 # Qwen3.6、Qwen3.5、Qwen3-VL、qwen-vl-max-0813、qwen-vl-plus-0815、qwen-vl-plus-0710 などのモデルでは、画像のスケーリング係数は 32 です。 IMAGE_FACTOR = 32 # その他のモデルでは、画像のスケーリング係数は 28 です。 # IMAGE_FACTOR = 28 # ビデオフレームの最大アスペクト比 MAX_RATIO = 200 # ビデオフレームのピクセル下限 VIDEO_MIN_PIXELS = 4 * 32 * 32 # ビデオフレームのピクセル上限。Qwen3-VL-Plus モデルの場合、VIDEO_MAX_PIXELS は 640 * 32 * 32 です。その他のモデルの場合、768 * 32 * 32 です。 VIDEO_MAX_PIXELS = 640 * 32 * 32 # ユーザーが FPS パラメーターを渡さない場合、fps にはデフォルト値が使用されます。 FPS = 2.0 # 抽出されるフレームの最小数 FPS_MIN_FRAMES = 4 # 抽出されるフレームの最大数 (選択したモデルに基づいて設定) FPS_MAX_FRAMES = 2000 # ビデオ入力の最大ピクセル値。Qwen3-VL-Plus モデルの場合、VIDEO_TOTAL_PIXELS を 131072 * 32 * 32 に設定します。その他のモデルの場合、65536 * 32 * 32 に設定します。 VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_TOTAL_PIXELS', 131072 * 32 * 32))) def round_by_factor(number: int, factor: int) -> int: """'number' に最も近く、'factor' で割り切れる整数を返します。""" return round(number / factor) * factor def ceil_by_factor(number: int, factor: int) -> int: """'number' 以上で、'factor' で割り切れる最小の整数を返します。""" return math.ceil(number / factor) * factor def floor_by_factor(number: int, factor: int) -> int: """'number' 以下で、'factor' で割り切れる最大の整数を返します。""" return math.floor(number / factor) * factor def extract_vision_info(conversations): vision_infos = [] if isinstance(conversations[0], dict): conversations = [conversations] for conversation in conversations: for message in conversation: if isinstance(message["content"], list): for ele in message["content"]: if ( "image" in ele or "image_url" in ele or "video" in ele or ele.get("type","") in ("image", "image_url", "video") ): vision_infos.append(ele) return vision_infos def smart_nframes(ele,total_frames,video_fps): """抽出されたビデオフレームの数を計算します。 Args: ele (dict): ビデオ構成を含む辞書。 - fps: モデル用に抽出される入力フレームの数を制御します。 total_frames (int): ビデオの元の合計フレーム数。 video_fps (int | float): ビデオの元のフレームレート。 Raises: nframes が [FRAME_FACTOR, total_frames] の範囲内にない場合、エラーが報告されます。 Returns: モデル入力用のビデオフレーム数。 """ assert not ("fps" in ele and "nframes" in ele), "`fps` または `nframes` のいずれかのみを受け入れます" fps = ele.get("fps", FPS) min_frames = ceil_by_factor(ele.get("min_frames", FPS_MIN_FRAMES), FRAME_FACTOR) max_frames = floor_by_factor(ele.get("max_frames", min(FPS_MAX_FRAMES, total_frames)), FRAME_FACTOR) duration = total_frames / video_fps if video_fps != 0 else 0 if duration-int(duration)>(1/fps): total_frames = math.ceil(duration * video_fps) else: total_frames = math.ceil(int(duration)*video_fps) nframes = total_frames / video_fps * fps if nframes > total_frames: logger.warning(f"smart_nframes: nframes[{nframes}] > total_frames[{total_frames}]") nframes = int(min(min(max(nframes, min_frames), max_frames), total_frames)) if not (FRAME_FACTOR <= nframes and nframes <= total_frames): raise ValueError(f"nframes は [{FRAME_FACTOR}, {total_frames}] の範囲内である必要がありますが、{nframes} が取得されました。") return nframes def get_video(video_path): # ビデオ情報を取得します cap = cv2.VideoCapture(video_path) frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH)) # ビデオの高さを取得します frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT)) total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT)) video_fps = cap.get(cv2.CAP_PROP_FPS) return frame_height, frame_width, total_frames, video_fps def smart_resize(ele, path, factor=IMAGE_FACTOR): # ビデオの元の幅と高さを取得します height, width, total_frames, video_fps = get_video(path) # ビデオフレームのトークン下限 min_pixels = VIDEO_MIN_PIXELS total_pixels = VIDEO_TOTAL_PIXELS # 抽出されたビデオフレームの数 nframes = smart_nframes(ele, total_frames, video_fps) max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR),int(min_pixels * 1.05)) # ビデオのアスペクト比は 200:1 または 1:200 を超えてはなりません。 if max(height, width) / min(height, width) > MAX_RATIO: raise ValueError( f"絶対アスペクト比は {MAX_RATIO} より小さくなければなりませんが、{max(height, width) / min(height, width)} が取得されました" ) h_bar = max(factor, round_by_factor(height, factor)) w_bar = max(factor, round_by_factor(width, factor)) if h_bar * w_bar > max_pixels: beta = math.sqrt((height * width) / max_pixels) h_bar = floor_by_factor(height / beta, factor) w_bar = floor_by_factor(width / beta, factor) elif h_bar * w_bar < min_pixels: beta = math.sqrt(min_pixels / (height * width)) h_bar = ceil_by_factor(height * beta, factor) w_bar = ceil_by_factor(width * beta, factor) return h_bar, w_bar def token_calculate(video_path, fps): # ビデオパスと fps フレーム抽出パラメーターを渡します。 messages = [{"content": [{"video": video_path, "fps": fps}]}] vision_infos = extract_vision_info(messages)[0] resized_height, resized_width = smart_resize(vision_infos, video_path) height, width, total_frames, video_fps = get_video(video_path) num_frames = smart_nframes(vision_infos, total_frames, video_fps) print(f"元のビデオのディメンション:{height}*{width}、モデルの入力ディメンション:{resized_height}*{resized_width}、合計ビデオフレーム:{total_frames}、fps が {fps} の場合に抽出された合計フレーム:{num_frames}", end=", ") video_token = int(math.ceil(num_frames / 2) * resized_height / 32 * resized_width / 32) video_token += 2 # システムは自動的に <|vision_bos|> と <|vision_eos|> の視覚マーカー (各 1 トークン) を追加します。 return video_token video_token = token_calculate("xxx/test.mp4", 1) print("ビデオトークン:", video_token)-
画像リスト:
動画が画像のリストとして渡される場合、フレーム抽出はすでに行われていることを意味します。次のコードを使用して、画像のパスと数を指定してトークン消費量を計算します:
# 使用前にインストール:pip install Pillow import math import os import logging from typing import Tuple from PIL import Image logger = logging.getLogger(__name__) # ==================== 定数定義 ==================== FRAME_FACTOR = 2 # Qwen3-VL、qwen-vl-max-0813、qwen-vl-plus-0815、qwen-vl-plus-0710 などのモデルでは、スケーリング係数は 32 です。 IMAGE_FACTOR = 32 # その他のモデルでは、スケーリング係数は 28 です。 # IMAGE_FACTOR = 28 # トークン計算の定数 TOKEN_DIVISOR = 32 # トークン計算の除数 VISION_SPECIAL_TOKENS = 2 # <|vision_bos|> および <|vision_eos|> マーカー # ビデオフレームの最大アスペクト比 MAX_RATIO = 200 # ビデオフレームのピクセル下限 VIDEO_MIN_PIXELS = 4 * 32 * 32 # ビデオフレームのピクセル上限。Qwen3-VL-Plus モデルの場合、VIDEO_MAX_PIXELS は 640 * 32 * 32 です。その他のモデルの場合、768 * 32 * 32 です。 VIDEO_MAX_PIXELS = 640 * 32 * 32 # ビデオ入力の最大ピクセル値。Qwen3-VL-Plus モデルの場合、VIDEO_TOTAL_PIXELS を 131072 * 32 * 32 に設定します。その他のモデルの場合、65536 * 32 * 32 に設定します。 VIDEO_TOTAL_PIXELS = int(float(os.environ.get('VIDEO_TOTAL_PIXELS', 131072 * 32 * 32))) def round_by_factor(number: int, factor: int) -> int: """'number' に最も近く、'factor' で割り切れる整数を返します。""" return round(number / factor) * factor def ceil_by_factor(number: int, factor: int) -> int: """'number' 以上で、'factor' で割り切れる最小の整数を返します。""" return math.ceil(number / factor) * factor def floor_by_factor(number: int, factor: int) -> int: """'number' 以下で、'factor' で割り切れる最大の整数を返します。""" return math.floor(number / factor) * factor def get_image_size(image_path: str) -> Tuple[int, int]: if not os.path.exists(image_path): raise FileNotFoundError(f"画像ファイルが見つかりません: {image_path}") try: image = Image.open(image_path) height = image.height width = image.width image.close() # ファイルを速やかに閉じます return height, width except Exception as e: raise ValueError(f"画像ファイル {image_path} を読み取れません: {str(e)}") def smart_resize(height: int, width: int, nframes: int, factor: int = IMAGE_FACTOR) -> Tuple[int, int]: """ スケーリングされた画像のディメンションを計算します Args: height: 元の画像の高さ width: 元の画像の幅 nframes: ビデオフレームの数 factor: スケーリング係数、デフォルトは IMAGE_FACTOR Returns: (resized_height, resized_width) スケーリングされた高さと幅 Raises: ValueError: アスペクト比が制限を超えています """ # ビデオフレームのトークン下限 min_pixels = VIDEO_MIN_PIXELS total_pixels = VIDEO_TOTAL_PIXELS # 抽出されたビデオフレームの数 max_pixels = max(min(VIDEO_MAX_PIXELS, total_pixels / nframes * FRAME_FACTOR), int(min_pixels * 1.05)) # ビデオのアスペクト比は 200:1 または 1:200 を超えてはなりません。 aspect_ratio = max(height, width) / min(height, width) if aspect_ratio > MAX_RATIO: raise ValueError( f"画像のアスペクト比は {MAX_RATIO}:1 未満である必要がありますが、現在は {aspect_ratio:.2f}:1 です" ) h_bar = max(factor, round_by_factor(height, factor)) w_bar = max(factor, round_by_factor(width, factor)) if h_bar * w_bar > max_pixels: beta = math.sqrt((height * width) / max_pixels) h_bar = floor_by_factor(height / beta, factor) w_bar = floor_by_factor(width / beta, factor) elif h_bar * w_bar < min_pixels: beta = math.sqrt(min_pixels / (height * width)) h_bar = ceil_by_factor(height * beta, factor) w_bar = ceil_by_factor(width * beta, factor) return h_bar, w_bar def calculate_video_tokens(image_path: str, nframes: int = 1, factor: int = IMAGE_FACTOR, verbose: bool = True) -> int: """ Args: image_path: ビデオフレームファイルのパス nframes: ビデオフレームの数、 factor: スケーリング係数、デフォルトは IMAGE_FACTOR verbose: 詳細情報を出力するかどうか Returns: 消費されたトークン数 Raises: FileNotFoundError: ファイルが存在しません ValueError: ファイル形式が無効であるか、アスペクト比が制限を超えています """ # 元の画像のディメンションを取得します (1 回だけ読み取ります) height, width = get_image_size(image_path) # スケーリングされたディメンションを計算します resized_height, resized_width = smart_resize(height, width, nframes, factor) # トークン数を計算します # 数式:ceil(nframes/2) * (height/TOKEN_DIVISOR) * (width/TOKEN_DIVISOR) + VISION_SPECIAL_TOKENS video_token = int( math.ceil(nframes / 2) * (resized_height / TOKEN_DIVISOR) * (resized_width / TOKEN_DIVISOR) ) # 視覚マーカートークン (<|vision_bos|> と <|vision_eos|>) を追加します video_token += VISION_SPECIAL_TOKENS if verbose: print(f"元のビデオフレームのディメンション:{height}x{width}、モデルの入力ディメンション:{resized_height}x{resized_width}、", end="") return video_token if __name__ == "__main__": try: video_token = calculate_video_tokens("xxx/test.jpg", nframes=30) print(f"ビデオトークン:{video_token}\n") except Exception as e: print(f"エラー:{str(e)}\n") -
-
-
請求書の表示:Alibaba Cloud 管理コンソールの 課金管理 ページで請求書を表示したり、アカウントにチャージしたりできます。
-
レート制限:視覚理解モデルのレート制限条件に関する詳細については、「レート制限」をご参照ください。
-
無料クォータ(シンガポールリージョンのみ):視覚理解モデルには 100 万トークンの無料クォータが提供されます。90 日間の有効期間は、Model Studio を有効にした日、またはモデルリクエストが承認された日から始まります。
API リファレンス
視覚理解モデルの入力および出力パラメーターの詳細については、「テキスト生成」をご参照ください。
よくある質問
ファイルアップロード方法の選択方法
SDK の種類、ファイルサイズ、ネットワークの安定性に基づいて、最適なアップロード方法を選択してください。
ファイルタイプ | ファイル仕様 | DashScope SDK (Python, Java) | OpenAI 互換 / DashScope HTTP |
|---|---|---|---|
画像 | 7 MB より大きく 10 MB 未満 | ローカルパスを渡す | パブリックネットワーク URL のみサポートされています。 Alibaba Cloud Object Storage Service を使用してください。 |
7 MB 未満 | ローカルパスを渡す | Base64 エンコーディング | |
動画 | 100 MB より大きい | パブリックネットワーク URL のみに対応しています。Alibaba Cloud Object Storage Service をご利用ください | パブリックネットワーク URL のみがサポートされています。 Alibaba Cloud Object Storage Service をご利用ください。 |
7 MB より大きく 100 MB 未満 | ローカルパスを渡す | サポートされているのはパブリックネットワーク URL のみです。 Alibaba Cloud Object Storage Service をご利用ください。 | |
7 MB 未満 | ローカルパスを渡す | Base64 エンコーディング |
Base64 エンコーディングはデータサイズを増加させます。元のファイルサイズは 7 MB 未満である必要があります。
Base64 またはローカルパスを使用して、サーバー側のダウンロードタイムアウトを回避し、安定性を向上させます。
画像または動画を必要なサイズに圧縮する方法
視覚理解モデルには入力ファイルのサイズ制限があります。次の方法を使用してファイルを圧縮してください。
画像圧縮方法
- オンラインツール: CompressJPEG などを使用して、イメージを圧縮します。
- ローカルソフトウェア:Photoshop などのソフトウェアを使用して、エクスポート時に品質を調整します。
- コード実装:
# pip install pillow

from PIL import Image
def compress_image(input_path, output_path, quality=85):
    with Image.open(input_path) as img:
        img.save(output_path, "JPEG", optimize=True, quality=quality)

# ローカル画像を渡します
compress_image("/xxx/before-large.jpeg","/xxx/after-min.jpeg")

# ディレクトリ内の画像をバッチ圧縮します
import glob
import os

def batch_compress(input_dir, output_dir, quality=85):
    files = (
        glob.glob(os.path.join(input_dir, "*.jpg"))
        + glob.glob(os.path.join(input_dir, "*.jpeg"))
        + glob.glob(os.path.join(input_dir, "*.png"))
    )
    for i, f in enumerate(files, 1):
        try:
            compress_image(f, os.path.join(output_dir, os.path.basename(f)), quality)
            print(f"[{i}/{len(files)}] {os.path.basename(f)} 完了")
        except Exception as e:
            print(f"[{i}/{len(files)}] {os.path.basename(f)} エラー: {e}")

batch_compress("/xxx/input_dir", "/xxx/output_dir")
動画圧縮方法
- オンラインツール:FreeConvert などのオンラインツールを使用して動画を圧縮します。
- ローカルソフトウェア:HandBrake などのソフトウェアを使用します。
- コード実装:FFmpeg ツールを使用します。詳細については、FFmpeg 公式ウェブサイトをご参照ください。
# 基本的な変換コマンド
# -i, 機能:入力ファイルパス、例:input.mp4
# -vcodec, 機能:ビデオエンコーダー、一般的な値には libx264 (一般的に推奨) と libx265 (より高い圧縮率) があります
# -crf, 機能:ビデオ品質を制御、値の範囲:[18-28]。値が小さいほど品質が高く、ファイルサイズが大きくなります。
# --preset, 機能:エンコード速度と圧縮効率のバランスを制御します。一般的な値には slow、fast、faster があります。
# -y, 機能:既存のファイルを上書きします (値は不要)
# output.mp4, 機能:出力ファイルパス

ffmpeg -i input.mp4 -vcodec libx264 -crf 28 -preset slow output.mp4
モデルが物体位置特定の結果を出力した後、元の画像に検出フレームを描画する方法
視覚理解モデルが物体位置特定の結果を返した後、次のコードを使用して、元の画像に検出フレームとそのラベル情報を描画できます。
- Qwen2.5-VL:返される座標は、スケーリングされた画像の左上隅を基準としたピクセル単位の絶対値です。検出フレームを描画するには、qwen2_5_vl_2d.py のコードをご参照ください。
- Qwen3-VL、Qwen3.5、Qwen3.6、および Qwen3.7 シリーズ (例:qwen3.5-plus、qwen3.6-plus、qwen3.7-plus):返される座標は、
[0, 999]の範囲に正規化された相対値です。検出フレームを描画するには、qwen3_vl_2d.py (2D 位置特定) または qwen3_vl_3d.zip (3D 位置特定) のコードをご参照ください。
エラーコード
モデルの呼び出しに失敗した場合、エラーメッセージが返されます。エラーの解決方法については、「エラーコード」をご参照ください。