Qwen モデルを例に、API(HTTP)呼び出しで Alibaba Cloud Model Studio にモデルをデプロイする一連の手順を説明します。デプロイ、照会、推論、削除、および権限のトラブルシューティングを扱います。
前提条件
1. モデルのデプロイ
次のコマンドは、ファインチューニング済みカスタムモデル qwen3-8b-ft-202511132025-0260 を使用して、同名の専用サービス qwen3-8b-ft-202511132025-0260 を作成します。
カスタムモデル ID を取得するには、Model Studio コンソールのモデルファインチューニングページで、デプロイするモデルのタスク名をクリックします。続いて出力をクリックし、青色のモデル名をクリックします。表示されたマイモデルページの基本情報でモデル ID を確認できます。
モデル ID を model_name パラメーターに指定し、API でモデルをデプロイします。
プロビジョニング済みスループット(PTU)
注記デプロイコマンドを実行してサービスのデプロイが成功すると、使用していなくても直ちに課金が開始されます。操作前にサービスの課金ルールを確認することを推奨します。
プロビジョニング済みスループットの課金方式では、利用時間に基づいて課金されます。安定したスループット、高い同時実行性能、低レイテンシが求められ、トラフィックを予測できるシナリオに適しています。このモードでは、スループット/同時実行数と生成速度をプラットフォームが割り当て、ユーザーは調整できません。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_flash",
    "model_name": "qwen-flash-2025-07-28",
    "plan": "ptu",
    "ptu_capacity": {
        "input_tpm": 10000,
	"output_tpm": 1000
    }
}'
モデルユニット
注記
- デプロイコマンドを実行してサービスのデプロイが成功すると、使用していなくても直ちに課金が開始されます。操作前にサービスの課金ルールを確認することを推奨します。
- 後払いのモデルユニットプランのコンピューティングリソースは先着順で割り当てられます。購入が成立しない場合は全額返金されます。
モデルユニット課金では、利用時間に基づいて課金されます。ファインチューニング後の大規模な推論タスクに適しており、専用リソースの性能とコストを柔軟に調整できます。スループット/同時実行数と生成速度の両方をカスタマイズできます。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_plus",
    "model_name": "qwen-plus-2025-12-01",
    "plan": "mu",
    "deploy_spec": "MU1",
    "enable_thinking": true,
    "capacity": 4,
    "max_context_length": 10000,
    "rpm_limit": 500,
    "tpm_limit": 1000
}'
モデルユニットのデプロイモードでは、次の追加設定を利用できます。
設定項目 | 設定内容 |
サービス名 | デプロイサービスに付ける任意の名前です。 |
モデルの選択 | プラットフォームの組み込みモデルやファインチューニング済みモデルから、デプロイするモデルを選択します。 |
モデルユニットの種類 | デプロイ仕様を選択します。仕様によって計算能力と性能が異なります。 |
デプロイレプリカ数 | デプロイレプリカの初期数を設定します。サービスの同時実行能力に影響します。 |
デプロイテンプレート | 「単一ノードデプロイ」などのデプロイテンプレートを選択します。テンプレートごとにリソース構成が異なります。モデルユニット課金モードでのみ利用できます。 |
モデルの推論モードの設定 | モデルユニットモードでデプロイする一部のモデルでは、推論モード、最大コンテキスト長などを設定できます。
|
最大コンテキスト長 | 一部のモデルのモデルユニットデプロイモードで設定できます。最大コンテキスト長はモデルの種類によって異なります。 |
サービスのレート制限 | 一部のモデルのモデルユニットデプロイモードで設定できます。モデル呼び出しの RPM と TPM を制限できます。 |
API でこれらを設定する方法については、「API を使用したモデルデプロイタスクの作成」を参照してください。
トークン使用量
トークン使用量課金では、使用したトークン数に基づいて課金されます。同時実行数やレイテンシに厳しい要件がなく、コストを重視するシナリオに適しています。このモードは価格面で最も有利です。スループット/同時実行数と生成速度はプラットフォームが割り当て、ユーザーは調整できません。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "qwen3-8b-ft-202511132025-0260",
    "plan": "lora",
    "capacity": 1,
    "name": "qwen3-8b-ft"
}'
capacityは必須ですが、現在は効果がありません。スケーリングを依頼するには、専用デプロイのコンソールでフォームを送信してください。
dashscope CLI
dashscope コマンドラインから呼び出します。
export DASHSCOPE_API_KEY="your-api-key"
# Replace {WorkspaceId} with your workspace ID, ap-southeast-1 with your region (e.g., us-east-1, eu-central-1)
export DASHSCOPE_HTTP_BASE_URL="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"
# List deployed dedicated services
dashscope deployments list

# Create a dedicated service (--plan required)
# plan options: ptu (PTU reserved resources) / mu (model unit) / lora (LoRA deployment)
dashscope deployments create -m qwen2.5-7b-instruct -s tst -c 1 --plan ptu
-mはモデル名、-sはサービスの接尾辞、-cはデプロイ容量を指定します。
重要SDK Expert 対話型アシスタントを使用すると、自然言語で同様の開発やトラブルシューティングを行えます。
DashScope SDK Expertを参照してください。リージョンの全一覧は、Base URL の概要を参照してください。
コマンドが成功すると、次の結果が返されます(LoRA デプロイの例)。
{
    "request_id": "83b173ab-2b2f-41aa-8c57-b173e8be934e",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:06:46.405",
        "gmt_modified": "2025-11-20T20:06:46.405",
        "status": "PENDING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "workspace_id": "llm-8v*****",
        "charge_type": "post_paid",
        "creator": "16542*****",
        "modifier": "16542*****",
        "plan": "***"
    }
}
deployed_model は専用サービスの一意の ID です。
2. サービス状態の照会
次のコマンドを実行して、特定の専用サービスの詳細を照会します。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260" \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
コマンドが成功すると、次の結果が返されます。
{
    "request_id": "ca36952d-9136-426e-ab08-68a97ad72719",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-20T20:42:25",
        "status": "RUNNING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
サービスの状態が RUNNING になると、デプロイは完了です。
3. 推論リクエストの送信
注記DashScope SDK を初めて使用する場合は、SDK のインストールを参照してください。
API キーのワークスペースとモデルのデプロイ先ワークスペースが一致していることを確認してください。
デプロイ済み専用サービスを呼び出す際は、model パラメーターにデプロイ成功後に返されたモデルの code を指定します。専用デプロイコンソールで取得できます。
import os
import dashscope

# 以下はシンガポール (ap-southeast-1) リージョンの設定です。リージョンによって region の値は異なります。
client = dashscope.Client(
    # 環境変数が設定されていない場合は、api_key = "sk-xxx" に置き換えてください
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    region="ap-southeast-1",
)

messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Who are you?"},
]
response = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # モデルが正常にデプロイされた後に返されるコードに置き換えてください
    messages=messages,
    enable_thinking=False,
)
print(response)
import os
from openai import OpenAI

client = OpenAI(
    # If you have not configured environment variables, replace the next line with your Bailian API Key: api_key="sk-xxx",
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # Please replace with the code returned after the model is successfully deployed
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who are you?"},
    ],
    extra_body={"enable_thinking": False},
)
print(completion)
推論パラメーターの整合
Model Studio 推論エンジンのパラメーターのデフォルト値は、ローカルの推論フレームワークと異なる場合があります。vLLM のデフォルト値に合わせるには、API 呼び出し時に次の表を参照してください。SGLang など、他のフレームワークを使用する場合は、それぞれのドキュメントを参照してください。
パラメーター名 | 推奨値(vLLM のデフォルト値に対応) |
|---|---|
temperature | 範囲: [0, 2)。vLLM のデフォルト値に合わせるには 1.0 を指定します。 |
top_p | 範囲: (0, 1.0]。vLLM のデフォルト値に合わせるには 1.0 を指定します。 |
top_k | None または 100 より大きい値を指定すると、top_k サンプリングが無効になります(top_p のみ適用)。99 を指定すると、vLLM のデフォルト値 0(全体からのサンプリング)に近い動作になります。 |
presence_penalty | 範囲: [-2.0, 2.0]。vLLM のデフォルト値に合わせるには 0 を指定します。 |
repetition_penalty(DashScope プロトコル) | repetition_penalty を大きくすると、生成テキストの繰り返しが減ります。1.0 はペナルティなしを表します。範囲: 0 より大きい値。vLLM のデフォルト値に合わせるには 1.0 を指定します。 |
4. 専用サービスの削除
警告削除コマンドを実行すると、デプロイサービスは直ちに停止します。この操作は元に戻せず、次の影響があります。
- モデルを呼び出せなくなります。
- サービスの課金が停止します。
専用サービスが不要になった場合は、次のコマンドで削除できます。
curl --request DELETE 'https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260' \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
コマンドが成功すると、次の結果が返されます。
{
    "request_id": "8f726017-6042-420e-a465-0d366a3aba59",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-27T16:35:31.591",
        "status": "DELETING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
サービスの削除後は、2. サービス状態の照会の方法では状態を照会できなくなります。
権限のトラブルシューティング
モデルのデプロイ中に権限エラーが発生した場合は、デプロイ方法に応じて次の 2 つの手順で確認します。
コンソールでのデプロイ
-
「Missing permission for this module」と表示された場合は、業務ワークスペースの権限管理ページで、アカウントにモデルデプロイ - 操作権限があることを確認してください。
正常に操作できない場合は、組織または IT 管理者に、必要な権限の追加や権限の問題の確認を依頼してください。
-
デプロイ中に「xx business space does not have permission to deploy the xx model」というエラーが発生した場合は、Model Studio のワークスペース管理ページで、該当ワークスペースに対象モデルのデプロイ権限を追加してください。
API 呼び出しエラー:
Workspace xxx does not have deployment privilege for model xxxx.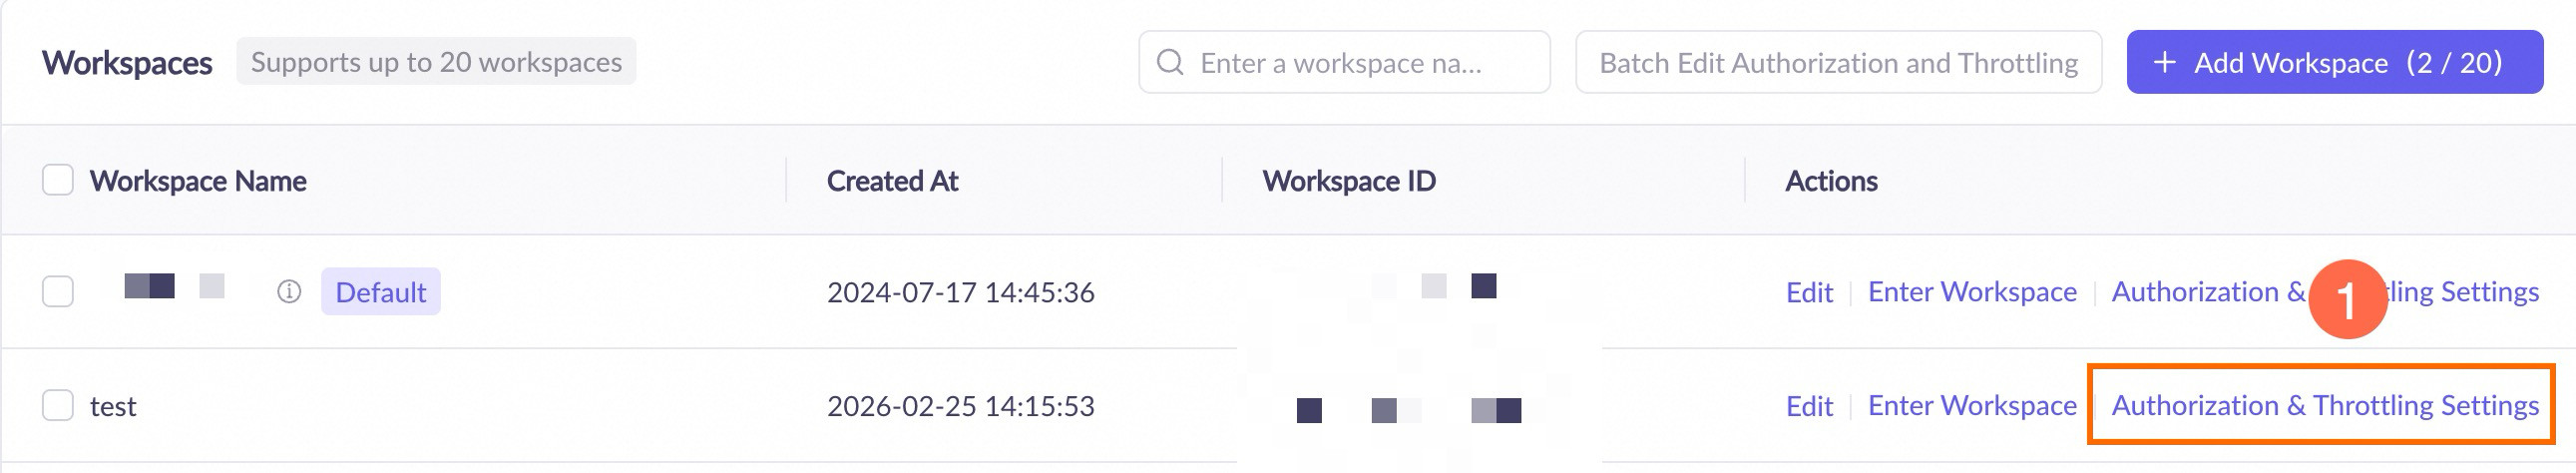
権限不足が表示された場合は、組織または IT 管理者に、必要な権限の追加または操作の代行を依頼してください。
API でのデプロイ
API でモデルをデプロイする場合は、次の点を確認してください。
-
API キーのワークスペースに、モデルを管理する権限が必要です。Model Studio のワークスペース管理ページで、該当ワークスペースのモデルデプロイ権限を確認してください。
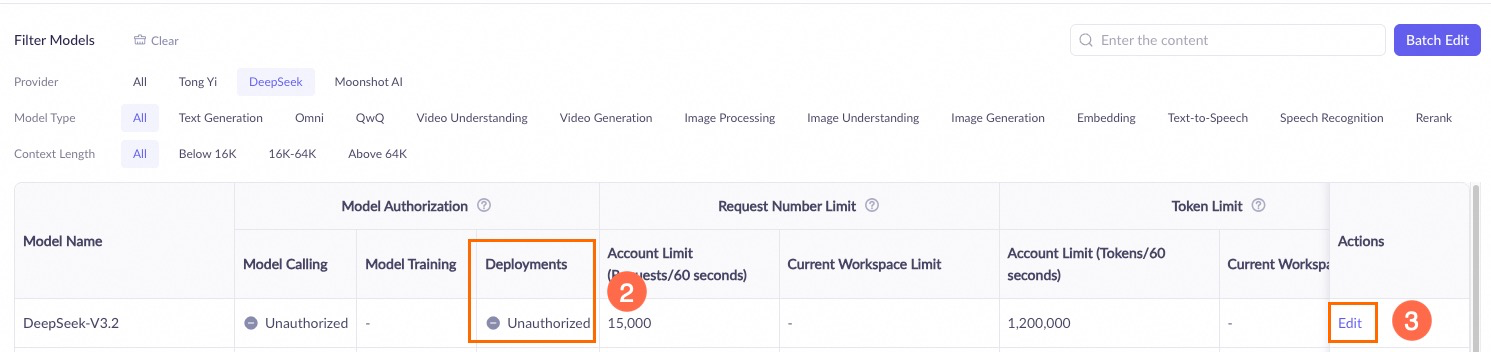
API 呼び出しエラー:
Workspace xxx does not have deployment privilege for model xxxx.該当ワークスペースの操作列で、モデル権限とレート制限の設定をクリックします。
モデル一覧で対象モデルを探し、モデルデプロイ列の権限状態を確認します。未承認の場合は、編集を操作列でクリックして権限を付与します。
権限不足が表示された場合は、組織または IT 管理者に、必要な権限の追加または操作の代行を依頼してください。
-
API キーを所有する所有者アカウントが、ワークスペースで必要な権限を持っていることを確認します。Model Studio コンソールの左下でワークスペースをクリックし、適切なワークスペースに切り替えます。続いて次のアイコンをクリックします:
 モデルデプロイの権限設定を確認してください。
API 呼び出しエラー:
Workspace access denied.左側のナビゲーションで権限管理をクリックし、ユーザー一覧に API キーの所有者アカウント(種類:プライマリアカウント)が含まれていることを確認します。
権限不足が表示された場合は、組織または IT 管理者に、必要な権限の追加または操作の代行を依頼してください。
API リファレンス
API 呼び出しの詳細については、API の詳細を参照してください。