サービスメッシュでは、サービスごとに必要となる可観測性データが異なる場合があります。そのため、サイドカープロキシとゲートウェイ Pod に対して別々の収集ルールを定義し、これらの設定を標準化して、クラウドネイティブアプリケーションの可観測性をより適切にサポートする必要があります。可観測性はクラウドネイティブアプリケーションにとって不可欠です。サービスの健全性とパフォーマンスをリアルタイムで監視し、障害やボトルネックを検知して解決し、最終的にアプリケーションの信頼性とパフォーマンスを向上させるのに役立ちます。Alibaba Cloud Service Mesh (ASM) は、テレメトリデータの生成と収集を設定するための統一された標準モデルを提供し、クラウドネイティブアプリケーションの可観測性を強化します。このトピックでは、可観測性の概念と機能について説明します。
可観測性
アプリケーションシステムの複雑性が増すにつれて、すべてのコンポーネントが安定して稼働し続けることを保証するのはますます困難になります。基盤となる問題により、システムの一部がパフォーマンスの低下した状態で動作する場合があります。そのため、信頼性と回復力の高いアプリケーションを構築するだけでなく、可観測性ツールを使用して、サービスとインフラストラクチャの実行時の挙動を把握する必要があります。このような可視性によって、障害の検知、予期しない問題のデバッグが可能になり、最終的に平均修復時間 (MTTR) を短縮してビジネスへの影響を最小化できます。
可観測性は、アプリケーションメトリクス、ネットワークメトリクス、インフラストラクチャのテレメトリなど、複数のレベルからデータを収集するシステムの特性です。この膨大なデータを相関付けることで、予測不能な事象を調査するための全体像を構築できます。サービスメッシュは、アプリケーションレベルのネットワークメトリクスの収集を大幅に強化します。実務上の観点では、重要なのはシステムの安定性を把握することです。すなわち、正しく動作しているときと問題が発生しているときを見分けられることです。これにより、エラーをより迅速に特定でき、可用性を維持するための自動または手動の制御を実装できます。
サービスメッシュのデータプレーンプロキシは、サービス間のネットワークパス上に配置されます。これらのプロキシからテレメトリを取得することで、アプリケーションネットワークとメッシュ自体の挙動を実行時に可視化できます。
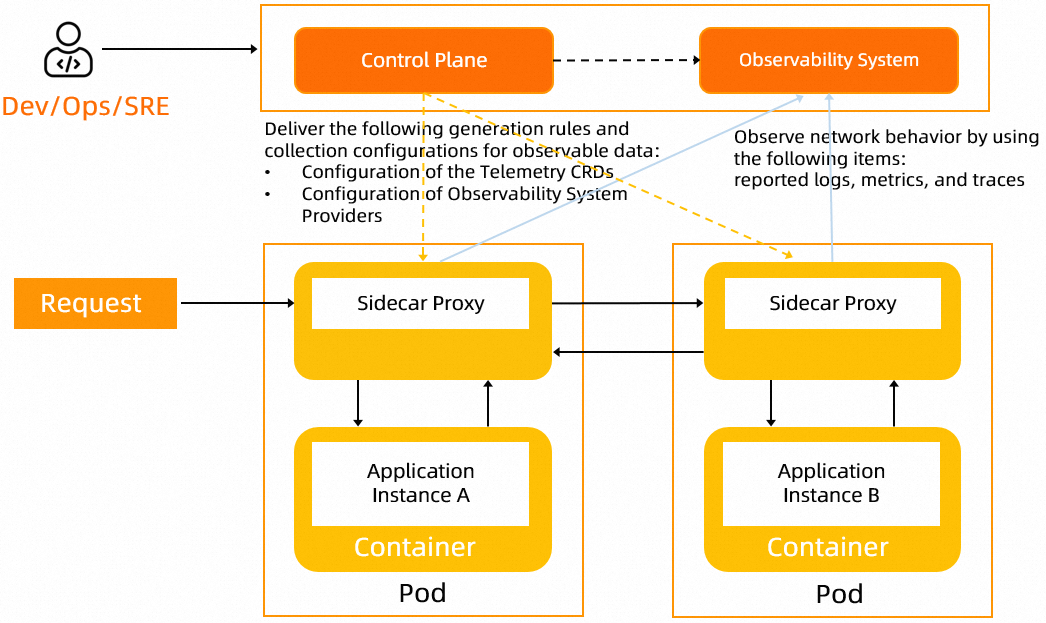
サービスメッシュで可観測性を実現するには、ログ、メトリクス、分散トレーシングなどの可観測性データの生成と収集を設定し、そのデータをクラウドホスト型またはセルフマネージドのサービスに送信する必要があります。また、異なるシナリオに対応するために、サイドカープロキシとゲートウェイ Pod に対して個別の収集設定を定義する必要があります。ASM は、クラウドネイティブアプリケーションの可観測性をより適切にサポートするために、データの生成と収集のための統一された統合的な設定モデルを提供します。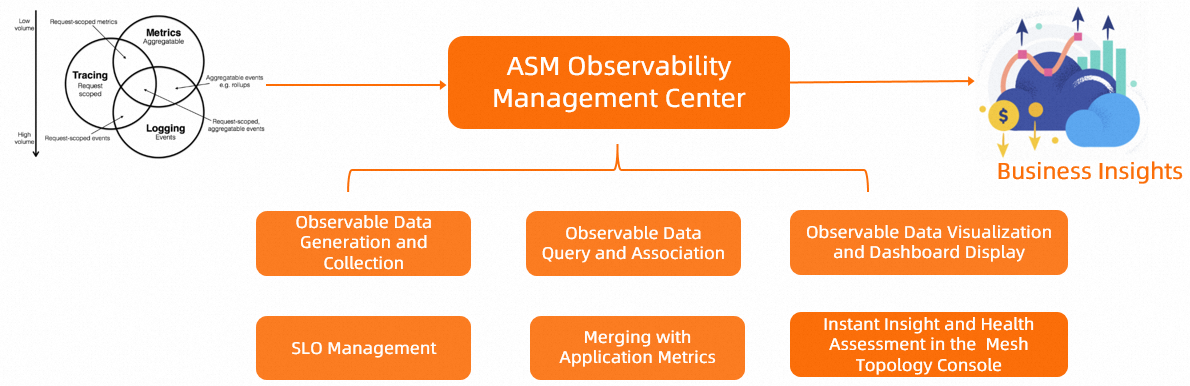
組み込みのベストプラクティス
Telemetry CRD を使用すると、異なる名前空間に複数のオブジェクトを作成できます。ただし、任意に定義すると、競合や予期しない挙動につながる可能性があります。設定が意図どおりに機能するように、次のベストプラクティスに従ってください:
-
istio-system のルート名前空間では、メッシュ全体に適用される Telemetry オブジェクトを複数定義できません。存在できるのは 1 つのみです。ASM はこのベストプラクティスを強制し、istio-system 名前空間に default という名前の Telemetry オブジェクトを 1 つだけ許可します。
-
各名前空間では、空のワークロードセレクターを持つ Telemetry オブジェクトは 1 つのみ許可され、名前は default にする必要があります。
-
ワークロードセレクターを使用して、特定の名前空間に新しい Telemetry オブジェクトを適用できます。これにより、対象ワークロードの設定が上書きされます。
-
同じワークロードセレクターを持つ 2 つの Telemetry オブジェクトが同じワークロードを対象とする場合、挙動は未定義です。
-
istio-system のルート名前空間にあるグローバル Telemetry オブジェクトでメトリクス設定が定義されていない場合、メトリクス生成はデフォルトで無効になります。
ログ
サービスメッシュでは、ログ収集は可観測性を実現する主要な手段です。すべてのサービスのログを一元的に集約すると、管理と検索が容易になります。これを実現するには、各サービスのログを stdout または stderr に書き込み、ログエージェントがそれらを収集して中央のログシステムに送信する必要があります。ASM はログのフィルタリングと整形機能を提供しており、必要に応じてログをフィルタリングおよび整形して、取得と分析を容易にできます。
ログ形式ルール
実際の運用環境では、サービスごとにログ形式が異なることがよくあります。生成ルールを設定して、ログの出力方法を制御できます。メッシュに追加された Kubernetes クラスターのデータプレーンにデプロイされる Envoy プロキシは、すべてのトラフィックの包括的なアクセスログを出力できます。ASM では、これらのアクセスログの内容をカスタマイズできます。
Telemetry CRD を使用して、ASM はログデータ形式の設定を簡素化するグラフィカルユーザーインターフェイス (GUI) を提供します。詳細については、「Customize access logs on the data plane」をご参照ください。
ログ形式ルールのグラフィカルな設定インターフェイスには、[Global]、[Namespace]、[Custom] の 3 つのスコープタブがあります。[Global] タブで [Enable Log Output] スイッチをオンにすると、変数設定テーブルで必要なログ変数を選択できます。変数タイプは [Envoy Built-in Attributes] と [Request Attributes] に分類されます。
次の YAML 設定と同等です:
envoyFileAccessLog:
    logFormat:
      text: '{"bytes_received":"%BYTES_RECEIVED%","bytes_sent":"%BYTES_SENT%","downstream_local_address":"%DOWNSTREAM_LOCAL_ADDRESS%","downstream_remote_address":"%DOWNSTREAM_REMOTE_ADDRESS%","duration":"%DURATION%","istio_policy_status":"%DYNAMIC_METADATA(istio.mixer:status)%","method":"%REQ(:METHOD)%","path":"%REQ(X-ENVOY-ORIGINAL-PATH?:PATH)%","protocol":"%PROTOCOL%","request_id":"%REQ(X-REQUEST-ID)%","requested_server_name":"%REQUESTED_SERVER_NAME%","response_code":"%RESPONSE_CODE%","response_flags":"%RESPONSE_FLAGS%","route_name":"%ROUTE_NAME%","start_time":"%START_TIME%","trace_id":"%REQ(X-B3-TRACEID)%","upstream_cluster":"%UPSTREAM_CLUSTER%","upstream_host":"%UPSTREAM_HOST%","upstream_local_address":"%UPSTREAM_LOCAL_ADDRESS%","upstream_service_time":"%RESP(X-ENVOY-UPSTREAM-SERVICE-TIME)%","upstream_transport_failure_reason":"%UPSTREAM_TRANSPORT_FAILURE_REASON%","user_agent":"%REQ(USER-AGENT)%","x_forwarded_for":"%REQ(X-FORWARDED-FOR)%","authority_for":"%REQ(:AUTHORITY)%","upstream_response_time":"%UPSTREAM_RESPONSE_TIME%","xff":"%REQ(X-FORWARDED-FOR)%","app_service_name":"%UPSTREAM_CLUSTER%"}'
    path: /dev/stdout
フィルター条件の例を次に示します:
  accessLogging:
  - disabled: false
    filter:
      expression: response.code >= 400
    providers:
    - name: envoy
データプレーンログの収集
データプレーンログを Simple Log Service (SLS) に収集する場合は、収集ルールを設定して、ログの収集方法と保持方法を制御します。Container Service for Kubernetes (ACK) は SLS と統合されており、データプレーン上のクラスターからアクセスログを収集できます。詳細については、「Use Simple Log Service to collect access logs on the data plane」をご参照ください。
設定ページには次の項目があります:
-
[Log Service Project]:[Use Default] または [Use Existing] を選択します。
-
[Gateway Access Log Storage Duration]:デフォルト値は 30 日です。
-
[Sidecar Access Log Storage Duration]:デフォルト値は 30 日です。
設定が完了したら、[Enable Data Plane Log Collection] をクリックします。
コントロールプレーンログとアラート
ASM は、コントロールプレーンログの収集と、ログベースのアラート設定をサポートします。たとえば、ASM のコントロールプレーンがデータプレーンのサイドカープロキシに設定をプッシュするログを収集できます。コントロールプレーンの主要な機能は、メッシュルールの設定をデータプレーンのサイドカープロキシとゲートウェイに配信することです。設定の競合によってプッシュが失敗すると、プロキシまたはゲートウェイは最新のルールを受け取れません。直前の正常な設定で稼働を継続できる場合もありますが、Pod の再起動によりプロキシまたはゲートウェイが失敗する可能性が高くなります。ゲートウェイやプロキシが利用できなくなる誤設定は一般的な問題です。コントロールプレーンログのアラートを有効にすることは、これらの問題を迅速に特定して解決するうえで不可欠です。詳細については、「Enable control-plane log collection and log-based alerting in an ASM instance of a version earlier than 1.17.2.35」または「Enable control-plane log collection and log-based alerting in an ASM instance of version 1.17.2.35 or later」をご参照ください。
メトリクス
メトリクスは、サービスメッシュにおける可観測性のもう 1 つの重要な側面であり、リクエスト処理、サービス間通信などを示すものです。Istio は Prometheus を使用してメトリクスを収集および保存します。各サービスの Envoy プロキシは大量のメトリクスを生成します。これらのメトリクスを使用して、サービスの健全性とパフォーマンスをリアルタイムで監視できるほか、異常検知やオートスケーリングなどのシナリオにも活用できます。
メトリクス生成ルール
サービスメッシュのデータプレーンメトリクスを有効にすると、ゲートウェイとサイドカープロキシが稼働状況に関するデータを生成できます。これらのメトリクスを Managed Service for Prometheus に送信して監視ダッシュボードを直接表示することも (費用が発生する場合があります)、セルフマネージドの Prometheus インスタンスを使用して ASM データプレーンからメトリクスをスクレイプすることもできます。
Telemetry CRD を使用して、ASM はカスタムメトリクス設定を簡素化する GUI を提供します。詳細については、「Create custom metrics in ASM」をご参照ください。
次の YAML 設定と同等です:
メトリクスに関する考慮事項
-
初めて有効化する場合:Managed Service for Prometheus は有料サービスです。過剰なコストを避けるために、実際の要件に基づいてメトリクス生成のスコープを慎重に定義してください。たとえば、ゲートウェイを監視するには、クライアント側メトリクスを有効にする必要があります。以前にメトリクスを設定している場合、再度有効にしてもその設定は保持されます。
-
メッシュトポロジーの設定:メッシュトポロジー機能は、サイドカープロキシが報告するメトリクスに依存します。メッシュトポロジーを有効にしている場合、特定のメトリクスを無効にすると、機能が低下したり利用できなくなったりする可能性があります。
-
REQUEST_COUNT のサーバー側メトリクスを有効にしない場合、HTTP または gRPC サービスのトポロジーグラフを生成できません。
-
TCP_SENT_BYTES のサーバー側メトリクスを有効にしない場合、TCP サービスのトポロジーグラフを生成できません。
-
REQUEST_SIZE と REQUEST_DURATION のサーバー側メトリクス、または REQUEST_SIZE のクライアント側メトリクスを無効にすると、トポロジーノード上の一部の監視情報が表示されなくなります。
-
メトリクスの収集
Prometheus でデータ収集を有効にし、収集したメトリクスを送信して保存および分析します。ASM は Managed Service for Prometheus と統合されており、サービスメッシュの監視を有効にできます。詳細については、「Integrate Managed Service for Prometheus to monitor ASM instances」をご参照ください。
Prometheus のスクレイプ間隔は、メトリクス収集のオーバーヘッドに大きく影響します。間隔を長くするとスクレイプされるデータポイントが減るため、処理、保存、計算コストを削減できます。デフォルトの間隔は 15 秒ですが、本番環境では頻繁すぎる場合があります。要件に応じて Prometheus 側で間隔を調整してください。Managed Service for Prometheus を使用している場合は、ARMS コンソールでこの設定を行います。詳細については、「Configure data collection rules」をご参照ください。
istio_request_duration_milliseconds_bucket、istio_request_bytes_bucket、istio_response_bytes_bucket などのヒストグラム関連メトリクスは、一般に高カーディナリティであり、コストが高くなる可能性があります。カスタムメトリクスに対する継続的な課金を回避するには、これらを破棄できます。Managed Service for Prometheus を使用している場合は、ARMS コンソールで設定します。詳細については、「Configure metrics」をご参照ください。
ASM は、メッシュ監視のためにセルフマネージドの Prometheus との統合もサポートします。詳細については、「Monitor ASM instances by using a self-managed Prometheus instance」をご参照ください。
次の図に示すように、Grafana で対応するダッシュボードを表示できます。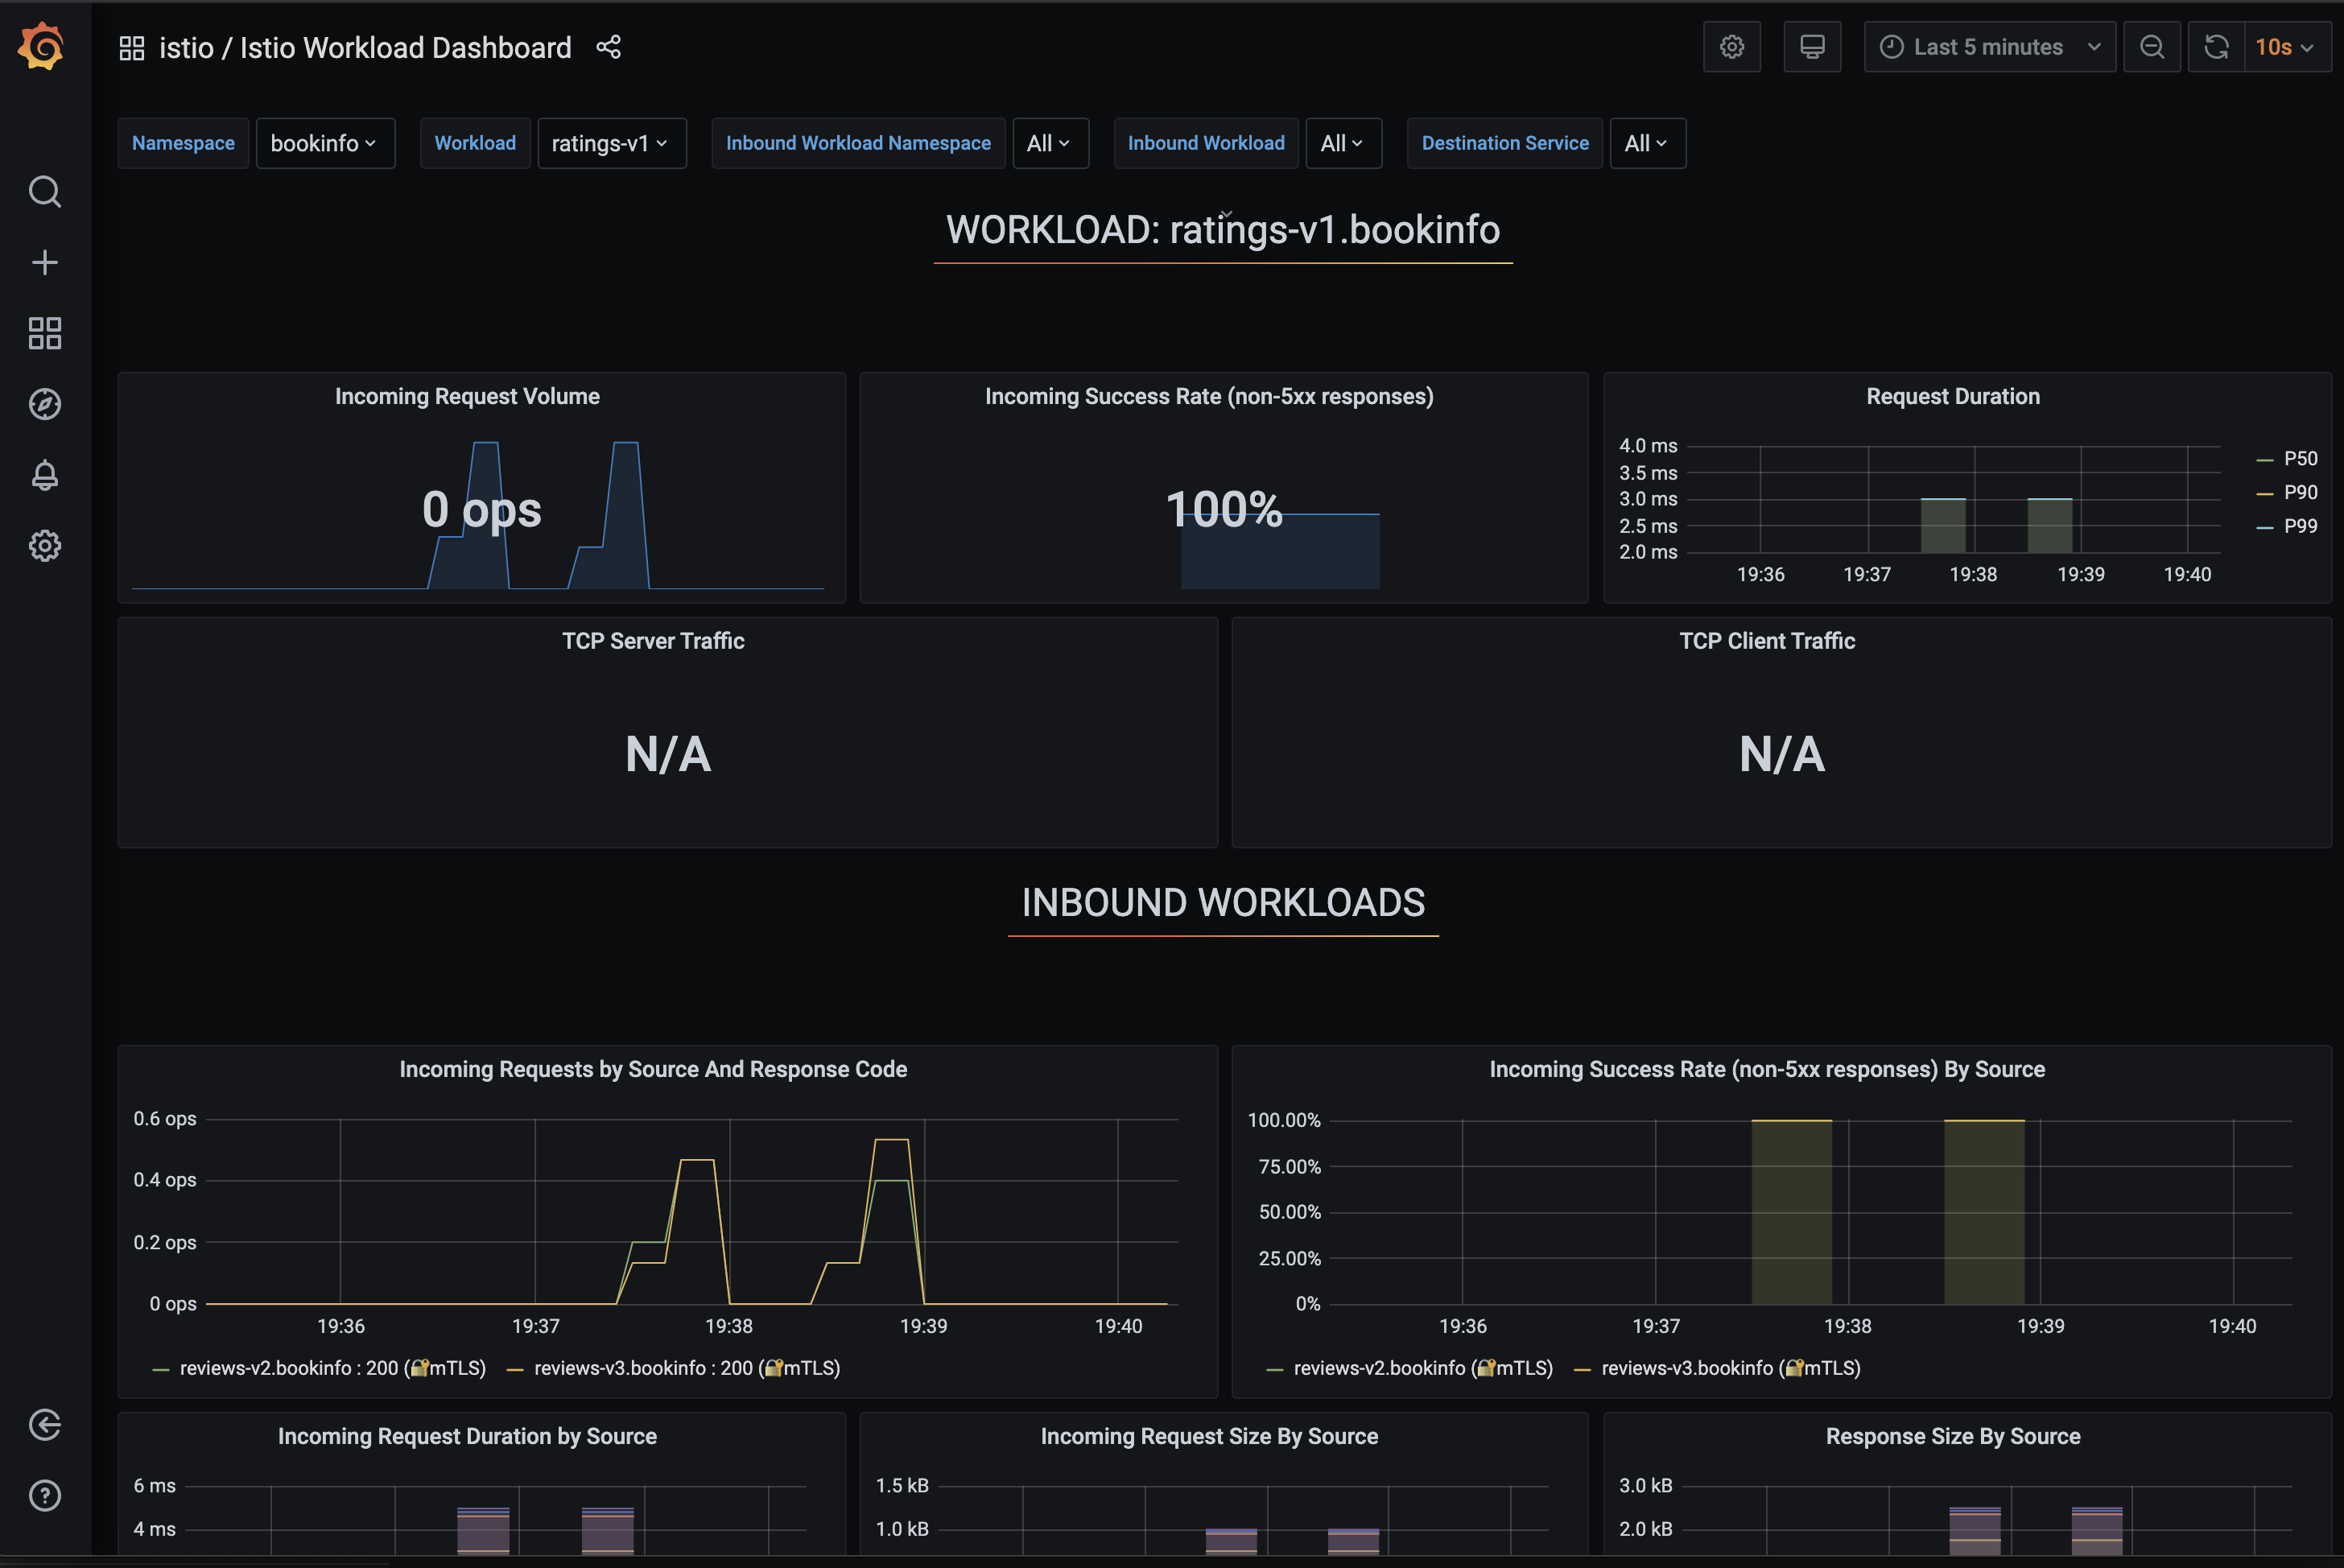
Istio メトリクスとアプリケーションメトリクスのマージ
すでに Prometheus のメトリクスエンドポイントを公開しているアプリケーションサービスでは、メトリクスマージ機能を有効にすることで、サイドカープロキシから既存のビジネスメトリクスをエクスポートできます。この機能を有効にすると、ASM はアプリケーションメトリクスを Istio メトリクスとマージします。ASM は、Prometheus によるメトリクスのスクレイプを有効にするために、すべてのデータプレーン Pod に対応する prometheus.io アノテーションを追加します。これらのアノテーションがすでに存在する場合、ASM はそれらを上書きします。サイドカープロキシがアプリケーションメトリクスと Istio メトリクスをマージし、その後 Prometheus は :15020/stats/prometheus エンドポイントからマージ済みメトリクスをスクレイプできます。詳細については、「Merge Istio metrics with application metrics」をご参照ください。
メッシュトポロジー
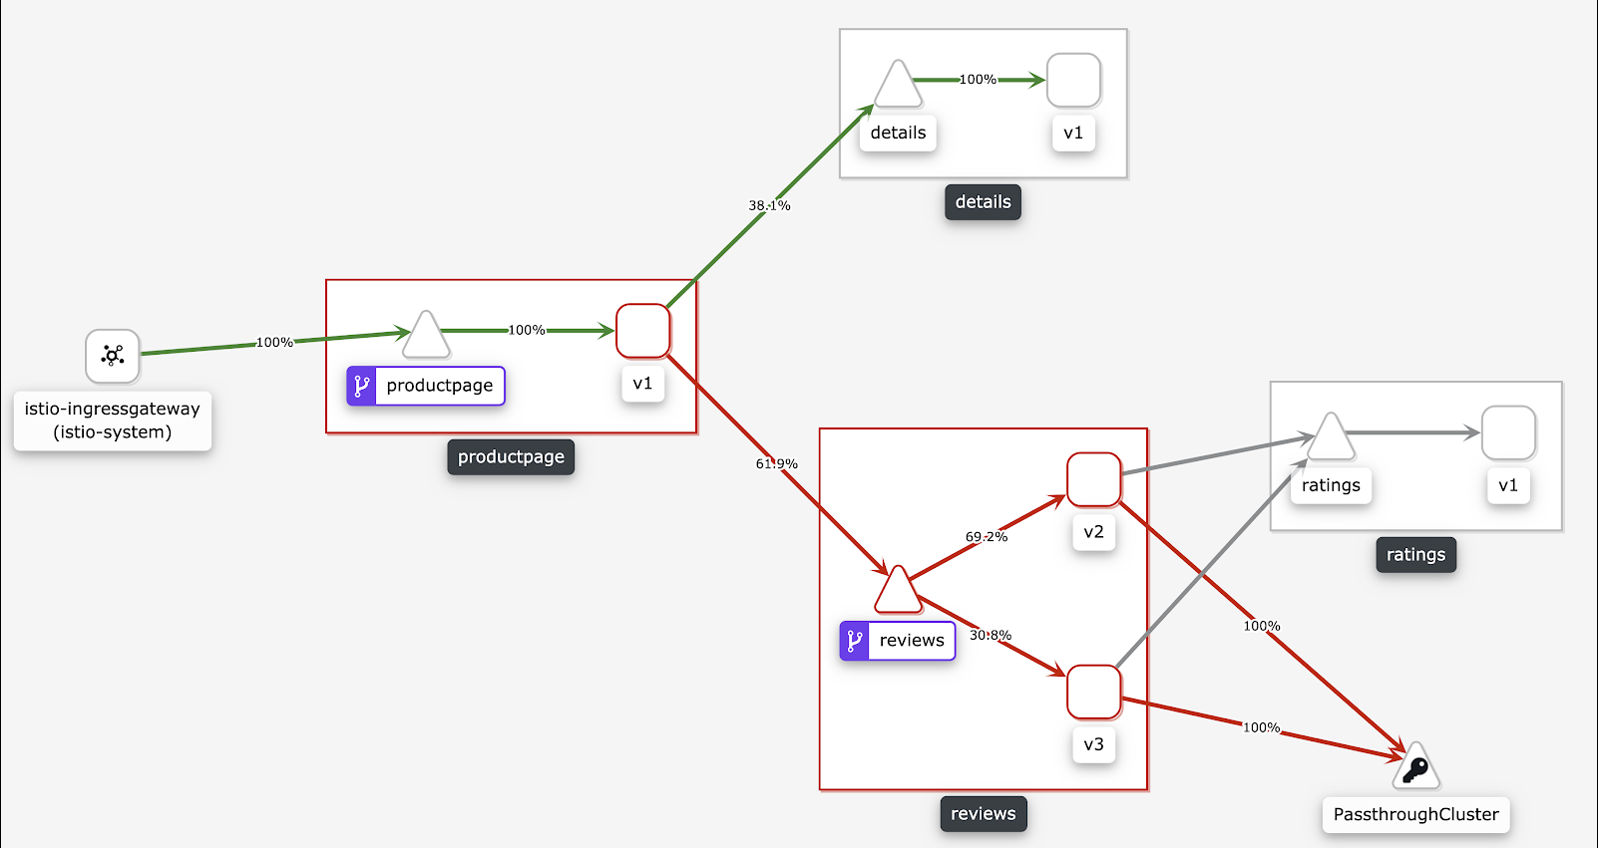
メッシュトポロジーは、サービスメッシュ向けの可観測性ツールです。関連するサービスと設定を確認できるビジュアルインターフェイスを提供します。次の図に示すように、ASM には組み込みのメッシュトポロジーが含まれています。詳細については、「Enable Mesh Topology to improve observability」をご参照ください。
サービスレベル目標 (SLO)
サービスレベルインジケーター (SLI) は、サービスの健全性を測定する指標です。サービスレベル目標 (SLO) は、1 つ以上の SLI に対する目標値または範囲です。
サービスレベル目標 (SLO) は、マイクロサービスアプリケーションのパフォーマンス、品質、信頼性を記述、測定、監視するための正式な方法を提供します。SLO は、アプリケーション開発、プラットフォーム、運用チーム間で共有できる品質のベースラインを提供し、サービスレベル品質を測定し継続的な改善を推進するための参照として機能します。複数の SLI を組み合わせて SLO を定義すると、チームはサービスの健全性をより正確に表現できます。
SLO の例を次に示します:
-
1 分あたりの平均 QPS > 100,000/s
-
アクセスレイテンシーの 99 パーセンタイル < 500 ms
-
1 分あたりの帯域幅の 99 パーセンタイル > 200 MB/s
ASM は、サービスレベル目標 (SLO) に基づくすぐに使える監視およびアラート機能を提供し、アプリケーションサービス間の呼び出しにおけるレイテンシーやエラー率などの特性を監視できます。
ASM でサポートされる SLI タイプは次のとおりです:
-
可用性:サービスが返す成功したレスポンスの割合です。対応する SLI プラグインタイプは availability です。HTTP ステータスコード 429 または 5XX (5 で始まるステータスコード) は利用不可の状態として扱われます。
-
レイテンシー:サービスがレスポンスを返すまでの時間 (ミリ秒) です。対応する SLI プラグインタイプは latency です。レイテンシーの上限しきい値をカスタマイズできます。しきい値を超えるレスポンスは非準拠として扱われます。
ASM は SLO 設定を定義するための UI を提供します。
SLO 作成ページには次の設定項目があります:
-
基本情報:[Namespace] を
defaultに設定し、[Target Service] をhttpbinに設定します。[Name] はasm-slo-default-httpbinとして自動生成されます。[Duration] を [30 Days] に設定します。 -
SLO ルール:[Name] を
asm-sloに設定し、[Target Value] を99に設定し、[Plugin Type] を [availability] に設定します。 -
アラートルール:アラートルールのスイッチをオンにし、[Alert Rule Name] を
asm-alertに設定し、[Critical] と [Warning] レベルのアラートルールを両方有効にします。
ASM を使用してアプリケーションレベルのサービスレベル目標 (SLO) を定義すると、ASM は Prometheus ルールを自動生成します。これらのルールを Prometheus にインポートすると、Prometheus は SLO を適用できます。Prometheus フレームワークでは、Alertmanager コンポーネントが Prometheus サーバーによって生成されたアラートを収集し、設定に基づいてさまざまな通知先に送信します。アラートがトリガーされると、[Alertmanager] ページで収集されたカスタムアラート情報を確認できます。SLO の詳細については、「SLO management」をご参照ください。
トリガーされた ASM の SLO アラートは「[asm-alert]」という名前で、次の 2 つのレコードを含みます:slo_severity="page" (slo_window="30m") と slo_severity="ticket" (slo_window="2h")。
分散トレーシング
分散トレーシングは、サービスメッシュにおける可観測性の重要な要素です。特にマイクロサービスアーキテクチャで構築されたアプリケーションをプロファイリングおよび監視するための手法です。マイクロサービスアーキテクチャでは、サービス間の通信がネットワーク越しに行われるため、サービス間の呼び出し関係を追跡して監視するには分散トレーシング技術が必要です。Istio では、Jaeger や Zipkin などの分散トレーシングツールを使用してこれを実現できます。分散トレーシングには 2 つの重要な概念があります:トレースとスパンです。
-
スパン:分散トレーシングの基本単位です。分散システムにおける 1 つの作業単位を表します。各スパンは、他のスパンへの参照を含めることができます。複数のスパンが集まって 1 つのトレースを構成します。
-
トレース:マイクロサービスシステムを通過するリクエストの完全な実行パスの記録です。完全なトレースは 1 つ以上のスパンで構成されます。
Istio プロキシはスパン情報を自動的に送信できますが、アプリケーションは適切な HTTP ヘッダーを引き続き伝播する必要があります。これにより、プロキシは送信時に個々のスパンを 1 つの完全なトレースに正しく関連付けできます。そのため、アプリケーションは受信リクエストから次のヘッダーを収集し、送信するすべてのリクエストに伝播する必要があります:
-
x-request-id
-
x-b3-traceid
-
x-b3-spanid
-
x-b3-parentspanid
-
x-b3-sampled
-
x-b3-flags
-
x-ot-span-context
トレーシングデータ生成ルール
Telemetry CRD に基づき、ASM は分散トレーシングデータを生成するルールの設定を簡素化する GUI を提供します。
次の YAML 設定と同等です:
  tracing:
  - customTags:
      mytag1:
        literal:
          value: fixedvalue
      mytag2:
        header:
          defaultValue: value1
          name: myheader1
      mytag3:
        environment:
          defaultValue: value1
          name: myenv1
    providers:
    - name: zipkin
    randomSamplingPercentage: 90
トレーシングデータの収集
収集したデータをマネージドなクラウドサービスまたはセルフマネージドのバックエンドに送信するには、次のいずれかの方法を使用します:
-
マネージドサービス:クラウドネイティブなアプリケーション管理サービスを使用してデータを収集および分析します。詳細については、「Enable distributed tracing in ASM」をご参照ください。
-
セルフマネージドサービス:Zipkin や Jaeger などのオープンソースの収集および分析ツールを使用します。詳細については、「Export ASM tracing data to a self-managed system」をご参照ください。