Menjelaskan cara menjalankan diagnostik instans dan menginterpretasikan laporan diagnostik, termasuk metrik kinerja, distribusi permintaan yang tidak merata, dan kueri lambat.
Lakukan diagnostik pada sebuah instans
Tair (Redis OSS-compatible) mengintegrasikan fitur Laporan Diagnostik dari Database Autonomy Service (DAS). Fitur ini memungkinkan Anda membuat laporan diagnostik untuk mengevaluasi status instans dalam periode waktu tertentu. Laporan diagnostik mengumpulkan metrik seperti tingkat kinerja, distribusi permintaan yang tidak merata, dan log kueri lambat guna membantu mengidentifikasi anomali pada instans tersebut.
Prosedur
Masuk ke Konsol dan buka halaman Instances. Di bilah navigasi atas, pilih wilayah tempat instans yang ingin Anda kelola berada. Kemudian, temukan instans tersebut dan klik ID instansnya.
- Di panel navigasi sebelah kiri, pilih .
- Klik Create Reports.
- Pada kotak dialog yang muncul, tentukan rentang waktu untuk pembuatan laporan diagnostik, lalu klik OK. Catatan Rentang waktu tidak boleh melebihi satu hari. Jika Anda menentukan rentang waktu yang lebih pendek untuk diagnostik, statistik yang lebih detail akan dikumpulkan dalam laporan diagnostik.
- Segarkan halaman Diagnostic Report untuk melihat progres task diagnostik. Setelah laporan diagnostik dibuat, klik View Report di kolom Actions. Catatan Untuk informasi selengkapnya tentang cara menginterpretasikan laporan diagnostik, lihat Understand an instance diagnostic report.
Memahami laporan diagnostik instans
Laporan diagnostik mengevaluasi kesehatan instans ApsaraDB for Redis dengan menganalisis metrik kinerja, distribusi permintaan, dan data kueri lambat. Gunakan laporan ini untuk mengidentifikasi anomali dan mengambil tindakan sebelum memengaruhi bisnis Anda.
Bagian laporan
Laporan diagnostik terdiri dari empat bagian:
-
Informasi dasar instans: ID instans, tipe instans, versi engine, dan zona tempat instans dideploy
-
Ringkasan: skor kesehatan instans dan rincian pengurangan nilai
-
Tingkat kinerja: kondisi saat ini dari metrik kinerja utama
-
10 node teratas dengan jumlah kueri lambat terbanyak: 10 node data dengan jumlah kueri lambat tertinggi, disertai detail kueri tersebut
Informasi dasar instans
Menampilkan ID instans, tipe instans, versi engine, dan wilayah tempat instans dideploy.
Periode diagnostik berlangsung dari pukul 11:10:23, 1 Maret 2021 hingga pukul 14:10:23, 1 Maret 2021. Informasi dasar instans mencakup bidang-bidang berikut:
-
Instance ID: ID instans dan nama instans (contoh akhiran: "-Diagnostic Report Test")
-
Specification: Edisi Kluster 2 GB (2 node)
-
Instance type: Redis 5.0
-
Zone: Tiongkok (Hangzhou)
Ringkasan
Menampilkan skor kesehatan keseluruhan instans. Skor maksimum adalah 100. Skor di bawah 100 mencantumkan item diagnostik yang menyebabkan pengurangan nilai serta penjelasannya.
Skor kesehatan adalah 70 dari 100. Item berikut menyebabkan pengurangan nilai:
-
Utilisasi CPU tinggi: Utilisasi CPU mencapai 85,9%, melebihi ambang batas aman. Nilai dikurangi 10 poin.
-
Penggunaan memori tinggi: Penggunaan memori mencapai 100,0%, melebihi ambang batas aman. Nilai dikurangi 10 poin.
-
Akses log lambat: Terdapat 12 entri log lambat teratas yang terekam di server. Nilai dikurangi 10 poin.
Tingkat kinerja
Menampilkan kondisi saat ini dari metrik kinerja utama. Perhatikan secara seksama metrik apa pun yang berada dalam kondisi Hazard — pembacaan yang terus-menerus melebihi ambang batas dapat menurunkan throughput dan meningkatkan latensi.
Untuk instans yang berjalan dalam arsitektur kluster atau arsitektur pemisahan baca/tulis, periksa apakah metrik tersebar tidak merata di antara node data. Tinjau grafik kurva Top 5 Nodes untuk setiap metrik guna mengidentifikasi node mana yang mengalami beban tertinggi. Untuk detail arsitektur, lihat Cluster master-replica instances dan Read/write splitting instances.
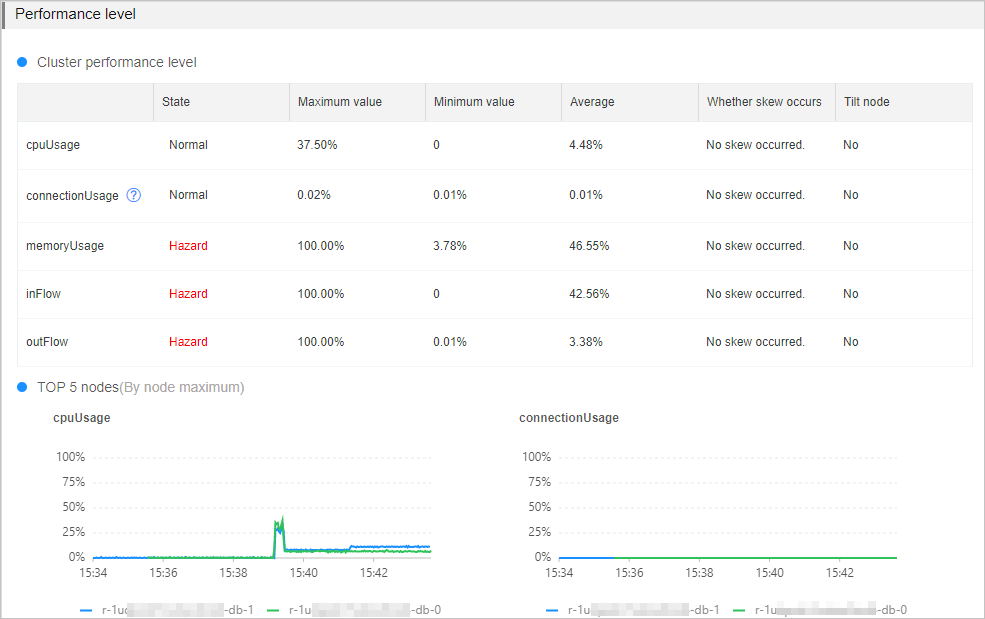
Tabel berikut menjelaskan setiap metrik, ambang batasnya, dampak bisnis jika ambang batas dilampaui, serta cara pemecahan masalahnya.
| Metric | Threshold | Applies to | Impact | Possible causes and next steps |
|---|---|---|---|---|
| CPU utilization | 60% | All architectures | Utilisasi CPU tinggi mengurangi throughput dan meningkatkan waktu respons. Client dapat menjadi tidak responsif. | Penyebab: perintah kompleksitas tinggi, hotkey, atau pembuatan koneksi yang terlalu sering. Lihat Troubleshoot high CPU utilization on an instance. |
| Memory usage | 80% | All architectures | Penggunaan memori tinggi secara berkelanjutan meningkatkan waktu respons, mengganggu stabilitas permintaan per detik (QPS), dan memicu eviksi kunci secara sering. | Penyebab: kehabisan memori atau banyak kunci berukuran besar. Lihat Troubleshoot high memory usage on an instance. |
| Connections usage of data nodes | 80% | Hanya untuk instans kluster dalam mode koneksi langsung. Saat client terhubung melalui node proxy, pantau koneksi di tingkat node proxy. Lihat Enable the direct connection mode dan View performance monitoring data. | Saat koneksi mencapai batas, permintaan koneksi baru mengalami timeout atau gagal. | Penyebab: lonjakan traffic atau koneksi idle yang tidak dilepas. Lihat Instance sessions. |
| Inbound traffic | 80% | All architectures | Saat traffic melebihi bandwidth yang disediakan oleh tipe instans, kinerja client menurun. | Penyebab: lonjakan workload atau kunci besar yang sering dibaca/ditulis. Lihat Troubleshoot high traffic usage on an instance. |
| Outbound traffic | 80% | All architectures |
Distribusi permintaan tidak merata
Untuk instans yang berjalan dalam arsitektur kluster atau arsitektur pemisahan baca/tulis, laporan juga memeriksa apakah permintaan tersebar merata di antara node data. Jika terdeteksi distribusi permintaan tidak merata untuk suatu metrik, identifikasi node mana yang menerima beban tidak seimbang tersebut.
Laporan menandai distribusi permintaan tidak merata ketika kedua kondisi berikut terpenuhi:
-
Nilai puncak di semua node data melebihi ambang batas minimum berikut:
-
Utilisasi CPU: 10%
-
Penggunaan memori: 20%
-
Traffic inbound dan outbound: 5 Mbit/s
-
Penggunaan koneksi: 5%
-
-
Skor keseimbangan melebihi 1,3. Skor keseimbangan dihitung sebagai:
max{nilai kinerja rata-rata semua node data} / nilai median kinerja semua node data. Misalnya, sebuah instans memiliki empat node data dengan utilisasi CPU rata-rata masing-masing 10%, 30%, 50%, dan 60%. Median-nya adalah 40%, sehingga skor keseimbangannya adalah 60% / 40% = 1,5. Karena 1,5 > 1,3, laporan menganggap utilisasi CPU tidak merata.
| Possible cause | Troubleshooting method |
|---|---|
| Node data memiliki kunci yang terlalu besar. | Gunakan fitur analisis kunci offline atau fitur statistik kunci teratas untuk mengidentifikasi dan mendistribusikannya kembali. |
| Sebuah node data memiliki hotkey. | Gunakan fitur statistik kunci teratas untuk mengidentifikasi hotkey. |
| Konfigurasi hash tag tidak tepat. Kunci dengan hash tag yang sama selalu ditempatkan pada node data yang sama. Jika banyak kunci berbagi hash tag yang sama, node tersebut menjadi kelebihan beban. | Tinjau dan sesuaikan konfigurasi hash tag Anda agar kunci tersebar merata di seluruh node. |
10 node teratas dengan jumlah kueri lambat terbanyak
Menampilkan 10 node data dengan jumlah kueri lambat tertinggi dan memberikan detail kueri tersebut. Laporan ini mengambil data log lambat dari dua sumber:
-
Log audit sistem: log lambat yang disimpan selama 4 hari
-
Log node data: 1.024 entri log terbaru, disimpan langsung di setiap node data. Hubungkan ke instans menggunakan redis-cli dan jalankan perintah
SLOWLOG GETuntuk mengambilnya.
Dua node, r-bp***-db-0 dan r-bp***-db-1, masing-masing memiliki 6 kueri lambat. Perintah kueri lambat utama dan durasi eksekusinya adalah sebagai berikut:
-
keys *: Waktu eksekusi maksimum sekitar 86 ms, rata-rata sekitar 86 ms -
keys key:0000001*: Waktu eksekusi maksimum sekitar 62 ms, rata-rata sekitar 59 ms -
Beberapa perintah
del: Waktu eksekusi sekitar 12–18 ms
Gunakan data kueri lambat ini untuk mengidentifikasi perintah yang menyebabkan masalah kinerja.
| Cause | Solution |
|---|---|
Perintah dengan kompleksitas waktu O(N) atau biaya CPU tinggi, seperti KEYS * |
Evaluasi dan nonaktifkan perintah berisiko tinggi seperti FLUSHALL, KEYS, dan HGETALL. Lihat Disable high-risk commands. |
| Kunci besar yang sering dibaca/ditulis ke node data | Analisis kunci besar tersebut menggunakan fitur analisis kunci offline, lalu pecah berdasarkan kebutuhan bisnis Anda. |