TorchEasyRec Processor bawaan di EAS menerapkan model rekomendasi yang dilatih dengan TorchEasyRec atau PyTorch sebagai layanan scoring dengan rekayasa fitur terintegrasi. Processor ini secara bersama mengoptimalkan rekayasa fitur dan model PyTorch untuk menghadirkan layanan scoring berkinerja tinggi. Topik ini menjelaskan cara menerapkan dan memanggil layanan model TorchEasyRec.
Latar Belakang
Diagram berikut menunjukkan arsitektur mesin rekomendasi berbasis TorchEasyRec Processor.
TorchEasyRec Processor terdiri dari modul-modul berikut:
-
Item Feature Cache: Menyimpan cache fitur sisi item dari FeatureStore di memori untuk mengurangi overhead jaringan, meringankan beban pada FeatureStore, dan meningkatkan kinerja layanan inferensi. Ketika fitur sisi item mencakup fitur real-time, FeatureStore menangani sinkronisasinya.
-
feature generator (FG): Mendefinisikan transformasi fitur dalam file konfigurasi dan menggunakan basis kode C++ terpadu untuk memastikan konsistensi logika antara pemrosesan fitur offline dan online.
-
TorchModel: Model PyTorch yang dilatih dengan TorchEasyRec atau PyTorch, lalu diekspor sebagai ScriptedModel.
Batasan
Dukungan terbatas pada model g6, g7, dan g8 dari keluarga instans tujuan umum, serta model GPU seperti RTX Pro 5000, L20, A10, dan T4. Untuk informasi lebih lanjut, lihat keluarga instans tujuan umum (seri g). Jika Anda menerapkan layanan GPU, pastikan versi CUDA Driver adalah 535 atau lebih baru.
Riwayat versi
TorchEasyRec Processor sedang dalam pengembangan aktif. Kami merekomendasikan penggunaan versi terbaru untuk menerapkan layanan inferensi Anda, yang menyediakan lebih banyak fitur dan kinerja inferensi lebih tinggi. Versi yang telah dirilis adalah sebagai berikut:
|
Processor |
Tanggal |
Versi Torch |
Versi FG |
Pembaruan |
|
easyrec-torch-0.1 |
2024-09-10 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.2 |
2024-09-30 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.3 |
2024-10-14 |
2.4 |
0.2.9 |
|
|
easyrec-torch-0.4 |
2024-10-28 |
2.4 |
0.3.1 |
|
|
easyrec-torch-0.5 |
2024-11-14 |
2.4 |
0.3.1 |
|
|
easyrec-torch-0.6 |
2024-11-18 |
2.4 |
0.3.6 |
|
|
easyrec-torch-0.7 |
2024-12-06 |
2.5 |
0.3.9 |
|
|
easyrec-torch-0.8 |
2024-12-25 |
2.5 |
0.3.9 |
|
|
easyrec-torch-0.9 |
2025-01-15 |
2.5 |
0.4.1 |
|
|
easyrec-torch-1.0 |
2025-02-06 |
2.5 |
0.4.2 |
|
|
easyrec-torch-1.1 |
2025-04-23 |
2.5 |
0.5.9 |
|
|
easyrec-torch-1.2 |
2025-05-12 |
2.5 |
0.6.0 |
|
|
easyrec-torch-1.3 |
2025-05-29 |
2.5 |
0.6.5 |
|
|
easyrec-torch-1.4 |
2025-07-15 |
2.5 |
0.6.9 |
|
|
easyrec-torch-1.5 |
2025-09-18 |
2.5 |
0.7.3 |
|
|
easyrec-torch-1.6 |
2025-10-21 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.7 |
2025-11-04 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.8 |
2025-12-01 |
2.5 |
0.7.4 |
|
|
easyrec-torch-1.9 |
2026-01-09 |
2.5 |
1.0.0 |
|
|
easyrec-torch-1.10 |
2026-01-23 |
2.5 |
1.0.1 |
|
|
easyrec-torch-1.11 |
2026-02-10 |
2.5 |
1.0.1 |
|
|
easyrec-torch-1.12 |
2026-03-13 |
2.5 |
1.0.1 |
|
|
Catatan tentang versi 2.0 dan seterusnya
|
||||
|
easyrec-torch-2.0 |
2026-03-17 |
2.8 |
1.0.1 |
|
|
easyrec-torch-2.1 |
2026-04-09 |
2.8 |
1.0.2 |
|
|
easyrec-torch-2.2 |
2026-04-29 |
2.8 |
1.0.5 |
|
|
easyrec-torch-2.3 |
2026-06-08 |
2.11 |
1.0.5 |
|
|
easyrec-torch-2.4 |
2026-07-21 |
2.11 |
1.0.5 |
|
|
easyrec-torch-2.5 |
2026-09-10 |
2.11 |
1.0.6 |
|
Langkah 1: Terapkan layanan
-
Siapkan file konfigurasi layanan
torcheasyrec.json.Anda perlu menentukan Jenis Processor sebagai easyrec-torch-{version}, dan memilih nilai untuk {version} dari riwayat versi. Contoh file konfigurasi JSON adalah sebagai berikut:
Contoh dengan FG (fg_mode='normal')
{
  "metadata": {
    "instance": 1,
    "name": "alirec_rank_with_fg",
    "rpc": {
      "enable_jemalloc": 1,
      "max_queue_size": 256,
      "worker_threads": 16
    }
  },
  "cloud": {
        "computing": {
            "instance_type": "ecs.gn6i-c16g1.4xlarge"
        }
  },
  "model_config": {
    "fg_mode": "normal",
    "fg_threads": 8,
    "region": "YOUR_REGION",
    "fs_project": "YOUR_FS_PROJECT",
    "fs_model": "YOUR_FS_MODEL",
    "fs_entity": "item",
    "load_feature_from_offlinestore": true,
    "access_key_id":"YOUR_ACCESS_KEY_ID",
    "access_key_secret":"YOUR_ACCESS_KEY_SECRET"
  },
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://xxx/xxx/export",
        "readOnly": false
      },
      "properties": {
        "resource_type": "code"
      }
    }
  ],
  "processor":"easyrec-torch-2.4"
}
Contoh tanpa FG (fg_mode='bypass')
{
  "metadata": {
    "instance": 1,
    "name": "alirec_rank_no_fg",
    "rpc": {
      "enable_jemalloc": 1,
      "max_queue_size": 256,
      "worker_threads": 16
    }
  },
  "cloud": {
        "computing": {
            "instance_type": "ecs.gn6i-c16g1.4xlarge"
        }
  },
  "model_config": {
    "fg_mode": "bypass"
  },
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://xxx/xxx/export",
        "readOnly": false
      },
      "properties": {
        "resource_type": "code"
      }
    }
  ],
  "processor":"easyrec-torch-2.4"
}
Untuk parameter lainnya, lihat Penerapan JSON.
Parameter
Wajib
Deskripsi
Contoh
processor
Ya
Processor TorchEasyRec.
"processor":"easyrec-torch-1.12"
path
Ya
Jalur OSS yang dipasang ke layanan untuk menyimpan file model.
"path": "oss://examplebucket/xxx/export"
fg_mode
Tidak
Menentukan mode rekayasa fitur. Nilai yang valid:
-
bypass (default): Menonaktifkan rekayasa fitur (FG). Hanya model Torch yang diterapkan.
-
Gunakan mode ini untuk pemrosesan fitur kustom.
-
Dalam mode ini, Processor tidak memerlukan parameter akses FeatureStore.
-
-
normal: Mengaktifkan FG. Mode ini biasanya digunakan dengan TorchEasyRec untuk pelatihan model.
"fg_mode": "normal"
fg_threads
Tidak
Jumlah thread konkuren untuk eksekusi FG per permintaan.
"fg_threads": 15
outputs
Tidak
Nama variabel output dari prediksi model Torch, seperti
probs_ctr. Gunakan koma (,) untuk memisahkan beberapa nama. Jika parameter ini tidak ditentukan, layanan mengembalikan semua variabel."outputs":"probs_ctr,probs_cvr"
item_empty_score
Tidak
Skor default yang dikembalikan ketika ID item tidak ada. Nilai default: 0.
"item_empty_score": -1
Parameter Recall Vektor Prosesor
faiss_neigh_num
Tidak
Jumlah item yang diambil untuk recall vektor FAISS. Layanan memprioritaskan nilai dari field
faiss_neigh_numdalam badan permintaan. Jika field ini tidak disediakan, layanan menggunakan nilai dari parameterfaiss_neigh_numdi bagianmodel_config. Nilai default adalah 1."faiss_neigh_num": 200
faiss_nprobe
Tidak
Parameter
nprobemenentukan jumlah kluster yang dicari selama pengambilan. Di FAISS, indeks file terbalik membagi data menjadi kluster yang lebih kecil dan mempertahankan daftar terbalik untuk masing-masing. Nilainprobeyang lebih besar umumnya meningkatkan akurasi recall dengan biaya komputasi dan waktu pencarian yang meningkat, sedangkan nilai yang lebih kecil mengurangi akurasi tetapi mempercepat pencarian. Nilai default adalah 800."faiss_nprobe" : 700
Parameter prosesor untuk akses FeatureStore
fs_project
Tidak
Nama proyek FeatureStore Anda. Parameter ini wajib saat menggunakan FeatureStore. Untuk informasi lebih lanjut, lihat Konfigurasi proyek FeatureStore.
"fs_project": "fs_demo"
fs_model
Tidak
Nama model fitur di FeatureStore.
"fs_model": "fs_rank_v1"
fs_entity
Tidak
Nama entitas di FeatureStore.
"fs_entity": "item"
region
Tidak
Wilayah tempat proyek FeatureStore Anda berada. Misalnya, tentukan
cn-beijinguntuk wilayah China (Beijing). Untuk daftar wilayah yang didukung dan titik akhirnya, lihat Titik Akhir."region": "cn-beijing"
access_key_id
Tidak
ID AccessKey untuk mengakses FeatureStore.
"access_key_id": "xxxxx"
access_key_secret
Tidak
Rahasia AccessKey untuk mengakses FeatureStore.
"access_key_secret": "xxxxx"
load_feature_from_offlinestore
Tidak
Menentukan apakah akan memuat fitur offline langsung dari OfflineStore FeatureStore. Nilai yang valid:
-
True: Memuat data dari OfflineStore FeatureStore.
-
False (default): Memuat data dari OnlineStore FeatureStore.
"load_feature_from_offlinestore": True
featuredb_username
Tidak
Username untuk FeatureDB.
"featuredb_username":"xxx"
featuredb_password
Tidak
Password untuk FeatureDB.
"featuredb_passwd":"xxx"
Parameter untuk ekspansi fitur otomatis (input_tile)
INPUT_TILE
Tidak
Mengaktifkan ekspansi fitur otomatis untuk mengoptimalkan kinerja. Untuk fitur yang memiliki nilai sama di semua item dalam satu permintaan, seperti
user_id, Anda dapat mengirimkan nilai hanya sekali. Ini membantu mengurangi ukuran muatan permintaan, latensi jaringan, dan waktu komputasi.Fitur ini harus digunakan dalam mode
normaldan dengan model yang dilatih dengan TorchEasyRec. Variabel lingkungan yang sesuai juga harus diatur selama ekspor model. Secara default, sistem membaca nilaiINPUT_TILEdari filemodel_acc.jsondi direktori model yang diekspor. Jika file ini tidak ada, sistem membaca nilai dari variabel lingkungan.Saat fitur ini diaktifkan:
-
Jika variabel lingkungan diatur ke 2, FG untuk fitur sisi pengguna hanya dihitung sekali.
-
Jika variabel lingkungan diatur ke 3, FG untuk fitur sisi pengguna hanya dihitung sekali. Sistem menghitung penyematan untuk fitur pengguna dan item secara terpisah, dan penyematan sisi pengguna hanya dihitung sekali. Pengaturan ini ideal untuk skenario dengan banyak fitur sisi pengguna.
"processor_envs":
[
{
"name": "INPUT_TILE",
"value": "2"
}
]
NO_GRAD_GUARD
Tidak
Menonaktifkan perhitungan gradien selama inferensi. Ini menghentikan pelacakan operasi dan mencegah pembentukan graf komputasi.
CatatanMenyetel parameter ini ke
1dapat menyebabkan masalah ketidakcocokan dengan beberapa model. Jika layanan hang selama eksekusi inferensi kedua, Anda dapat menyelesaikan masalah dengan menyetel variabel lingkunganPYTORCH_TENSOREXPR_FALLBACK=2. Ini melewati langkah kompilasi sambil mempertahankan beberapa kemampuan optimasi graf."processor_envs":
[
{
"name": "NO_GRAD_GUARD",
"value": "1"
}
]
Parameter pemanasan model
warmup_data_path
Tidak
Mengaktifkan fitur pemanasan model dan menentukan jalur untuk menyimpan file pemanasan. Untuk menyimpan file pemanasan secara persisten, Anda harus memasang jalur OSS ke lokasi ini dalam konfigurasi
storage."warmup_data_path": "/warmup"
warmup_cnt_per_file
Tidak
Jumlah kali menjalankan proses pemanasan untuk setiap file Protobuf. Nilai yang lebih tinggi memastikan pemanasan lebih menyeluruh tetapi meningkatkan waktu startup. Nilai default: 20.
"warmup_cnt_per_file": 20,
warmup_pb_files_count
Tidak
Jumlah permintaan online yang disimpan sebagai file Protobuf untuk startup layanan berikutnya. File-file ini digunakan untuk pemanasan model dan disimpan ke jalur yang ditentukan oleh
warmup_data_path. Nilai default: 64."warmup_pb_files_count": 64
Pencatatan dan penyimpanan permintaan lambat
long_request_threshold
Tidak
Ambang batas waktu dalam milidetik (ms) untuk mengidentifikasi permintaan lambat. Jika waktu pemrosesan permintaan melebihi ambang batas ini, sistem secara otomatis mencatat waktu eksekusi setiap tahap. Nilai default: 200.
"long_request_threshold": 200
save_long_request
Tidak
Menentukan apakah akan menyimpan permintaan yang melebihi
long_request_thresholdsebagai file Protobuf. Jika diatur ketrue, file disimpan ke direktoritorch_reqdi bawah direktori model. Nilai default:false."save_long_request": true
Menyimpan permintaan mentah dan fitur item ke OSS
request_log_path
Tidak
Jalur disk untuk menyimpan file Protobuf. Anda harus memasang jalur OSS ke lokasi ini dalam konfigurasi layanan.
"request_log_path": "/online_log_pb"
background_feature_thread_num
Tidak
Jumlah thread latar belakang yang didedikasikan untuk menulis file ke disk. Jika beban kerja penulisan disk berat, Anda dapat meningkatkan nilai ini untuk mempercepat proses penyimpanan. Nilai default: 4.
"background_feature_thread_num": 8
Konfigurasi Data Pass-Through
pass_through_data
Tidak
Menentukan data yang dilewatkan ke respons. Ini berguna untuk meneruskan informasi ke layanan downstream. Nilainya harus berupa objek JSON.
"pass_through_data": {"model_version": "20260513"}
-
-
Terapkan layanan model TorchEasyRec menggunakan salah satu metode berikut:
JSON (Direkomendasikan)
Ikuti langkah-langkah berikut:
Masuk ke Konsol PAI. Pilih wilayah di bagian atas halaman. Kemudian, pilih ruang kerja yang diinginkan dan klik Enter Elastic Algorithm Service (EAS).
-
Di halaman Elastic Algorithm Service (EAS), klik Deploy Service. Di bagian Custom Model Deployment, klik JSON Deployment.
-
Di editor JSON, tempel konfigurasi JSON Anda, lalu klik Deploy.
CLI eascmd
-
Unduh dan autentikasi klien. Langkah-langkah berikut menggunakan versi Windows 64-bit sebagai contoh.
-
Dari direktori yang berisi file JSON Anda, jalankan perintah berikut untuk membuat layanan. Untuk informasi lebih lanjut tentang perintah, lihat Referensi perintah.
eascmdwin64.exe create <service.json>Ganti <service.json> dengan nama file JSON Anda, misalnya,
torcheasyrec.json.
Langkah 2: Panggil layanan
Setelah menerapkan layanan model TorchEasyRec, ikuti langkah-langkah berikut untuk melihat informasi pemanggilan layanan:
-
Masuk ke Konsol PAI, pilih wilayah di bagian atas halaman dan ruang kerja di sebelah kanan, lalu klik Go to EAS.
-
Klik Invocation Information di kolom Service Type untuk layanan target guna melihat titik akhir dan token layanan.
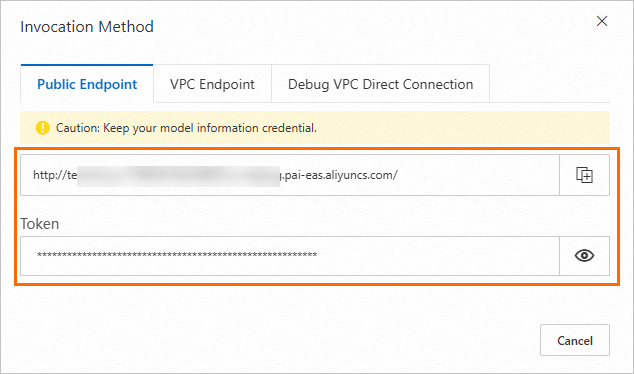
Di kotak dialog Invocation Information, pilih tab Public Address untuk mendapatkan public endpoint dan Token untuk pemanggilan layanan selanjutnya.
Layanan model TorchEasyRec menggunakan Protobuf sebagai format input/output-nya. Ada dua metode pemanggilan, tergantung pada apakah FG diaktifkan:
Gunakan FG (fg_mode='normal')
Anda dapat memanggil layanan menggunakan salah satu metode berikut:
SDK Java EAS
Sebelum menjalankan kode, konfigurasikan lingkungan Maven Anda. Untuk informasi lebih lanjut, lihat Petunjuk penggunaan SDK Java. Untuk versi terbaru SDK Java, lihat https://github.com/pai-eas/eas-java-sdk. Kode berikut menunjukkan cara mengirim permintaan ke layanan alirec_rank_with_fg.
package com.aliyun.openservices.eas.predict;

import com.aliyun.openservices.eas.predict.http.Compressor;
import com.aliyun.openservices.eas.predict.http.HttpConfig;
import com.aliyun.openservices.eas.predict.http.PredictClient;
import com.aliyun.openservices.eas.predict.proto.TorchRecPredictProtos;
import com.aliyun.openservices.eas.predict.request.TorchRecRequest;
import com.aliyun.openservices.eas.predict.proto.TorchPredictProtos.ArrayProto;

import java.util.*;


public class TorchRecPredictTest {
    public static PredictClient InitClient() {
        return new PredictClient(new HttpConfig());
    }

    public static TorchRecRequest buildPredictRequest() {
        TorchRecRequest TorchRecRequest = new TorchRecRequest();
        TorchRecRequest.appendItemId("7033");

        TorchRecRequest.addUserFeature("user_id", 33981,"int");

        ArrayList<Double> list = new ArrayList<>();
        list.add(0.24689289764507472);
        list.add(0.005758482924454689);
        list.add(0.6765301324940026);
        list.add(0.18137273055602343);
        TorchRecRequest.addUserFeature("raw_3", list,"List<double>");

        Map<String,Integer> myMap =new LinkedHashMap<>();
        myMap.put("866", 4143);
        myMap.put("1627", 2451);
        TorchRecRequest.addUserFeature("map_1", myMap,"map<string,int>");

        ArrayList<ArrayList<Float>> list2 = new ArrayList<>();
        ArrayList<Float> innerList1 = new ArrayList<>();
        innerList1.add(1.1f);
        innerList1.add(2.2f);
        innerList1.add(3.3f);
        list2.add(innerList1);
        ArrayList<Float> innerList2 = new ArrayList<>();
        innerList2.add(4.4f);
        innerList2.add(5.5f);
        list2.add(innerList2);
        TorchRecRequest.addUserFeature("click", list2,"list<list<float>>");

        TorchRecRequest.addContextFeature("id_2", list,"List<double>");
        TorchRecRequest.addContextFeature("id_2", list,"List<double>");

        System.out.println(TorchRecRequest.request);
        return TorchRecRequest;
    }

    public static void main(String[] args) throws Exception{
        PredictClient client = InitClient();
        client.setToken("tokenGeneratedFromService");
        client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com");
        client.setModelName("alirec_rank_with_fg");
        client.setRequestTimeout(100000);


        testInvoke(client);
        testDebugLevel(client);
        client.shutdown();
    }

    public static void testInvoke(PredictClient client) throws Exception {
        long startTime = System.currentTimeMillis();
        TorchRecPredictProtos.PBResponse response = client.predict(buildPredictRequest());
        for (Map.Entry<String, ArrayProto> entry : response.getMapOutputsMap().entrySet()) {

            System.out.println("Key: " + entry.getKey() + ", Value: " + entry.getValue());
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");

    }

    public static void testDebugLevel(PredictClient client) throws Exception {
        long startTime = System.currentTimeMillis();
        TorchRecRequest request = buildPredictRequest();
        request.setDebugLevel(1);
        TorchRecPredictProtos.PBResponse response = client.predict(request);
        Map<String, String> genFeas = response.getGenerateFeaturesMap();
        for(String itemId: genFeas.keySet()) {
            System.out.println(itemId);
            System.out.println(genFeas.get(itemId));
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");

    }
}
Parameter utama adalah:
-
client.setToken("tokenGeneratedFromService"): Ganti nilai dalam tanda kurung dengan token layanan Anda. Misalnya:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****. -
client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com"): Ganti nilai dalam tanda kurung dengan titik akhir layanan Anda. Misalnya:
175805416243****.cn-beijing.pai-eas.aliyuncs.com. -
client.setModelName("alirec_rank_with_fg"): Ganti nilai dalam tanda kurung dengan nama layanan Anda.
SDK Python EAS
Sebelum menjalankan kode, instal atau perbarui pustaka eas-prediction dengan menjalankan perintah pip install -U eas-prediction --user. Untuk detail konfigurasi lebih lanjut, lihat Menggunakan SDK Python. Anda dapat menemukan kode sumber di https://github.com/pai-eas/eas-python-sdk/blob/master/eas_prediction/torchrec_request.py. Berikut adalah kode contoh:
from eas_prediction import PredictClient
from eas_prediction.torchrec_request import TorchRecRequest


if __name__ == '__main__':
    endpoint = 'http://localhost:6016'

    client = PredictClient(endpoint, '<YOUR_SERVICE_NAME>')
    client.set_token('<your_service_token>')
    client.init()
    torchrec_req = TorchRecRequest()

    torchrec_req.add_user_fea('user_id', 'u001d', "STRING")
    torchrec_req.add_user_fea('age', 12, "INT")
    torchrec_req.add_user_fea('weight', 129.8, "FLOAT")
    torchrec_req.add_item_id('item_0001')
    torchrec_req.add_item_id('item_0002')
    torchrec_req.add_item_id('item_0003')
    torchrec_req.add_user_fea("raw_3", [0.24689289764507472, 0.005758482924454689, 0.6765301324940026, 0.18137273055602343], "list<double>")
    torchrec_req.add_user_fea("raw_4", [0.9965264740966043, 0.659596586238391, 0.16396649403055896, 0.08364986620265635], "list<double>")
    torchrec_req.add_user_fea("map_1", {"0":0.37845234405201145}, "map<int,float>")
    torchrec_req.add_user_fea("map_2", {"866":4143,"1627":2451}, "map<int,int>")
    torchrec_req.add_context_fea("id_2", [866], "list<int>" )
    torchrec_req.add_context_fea("id_2", [7022,1], "list<int>" )
    torchrec_req.add_context_fea("id_2", [7022,1], "list<int>" )
    torchrec_req.add_user_fea("click", [[0.94433516,0.49145547], [0.94433516, 0.49145597]], "list<list<float>>")

    res = client.predict(torchrec_req)
    print(res)
Pengaturan utama adalah:
-
endpoint: Atur parameter ini ke titik akhir layanan Anda. Misalnya:
http://175805416243****.cn-beijing.pai-eas.aliyuncs.com/. -
<your_service_name>: Ganti placeholder ini dengan nama layanan Anda.
-
<your_service_token>: Ganti placeholder ini dengan token layanan Anda. Misalnya:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****.
Tanpa FG (fg_mode='bypass')
SDK Java EAS
Sebelum menjalankan kode, konfigurasikan lingkungan Maven Anda. Untuk informasi lebih lanjut, lihat Gunakan SDK Java. Untuk mendapatkan versi SDK terbaru, lihat proyek di GitHub. Contoh berikut menunjukkan cara mengirim permintaan ke layanan alirec_rank_no_fg:
package com.aliyun.openservices.eas.predict;

import java.util.List;
import java.util.Arrays;


import com.aliyun.openservices.eas.predict.http.PredictClient;
import com.aliyun.openservices.eas.predict.http.HttpConfig;
import com.aliyun.openservices.eas.predict.request.TorchDataType;
import com.aliyun.openservices.eas.predict.request.TorchRequest;
import com.aliyun.openservices.eas.predict.response.TorchResponse;

public class Test_Torch {
    public static PredictClient InitClient() {
        return new PredictClient(new HttpConfig());
    }

    public static TorchRequest buildPredictRequest() {
        TorchRequest request = new TorchRequest();
        float[] content = new float[2304000];
        for (int i = 0; i < content.length; i++) {
            content[i] = (float) 0.0;
        }
        long[] content_i = new long[900];
        for (int i = 0; i < content_i.length; i++) {
            content_i[i] = 0;
        }

        long[] a = Arrays.copyOfRange(content_i, 0, 300);
        float[] b = Arrays.copyOfRange(content, 0, 230400);
        request.addFeed(0, TorchDataType.DT_INT64, new long[]{300,3}, content_i);
        request.addFeed(1, TorchDataType.DT_FLOAT, new long[]{300,10,768}, content);
        request.addFeed(2, TorchDataType.DT_FLOAT, new long[]{300,768}, b);
        request.addFeed(3, TorchDataType.DT_INT64, new long[]{300}, a);
        request.addFetch(0);
        request.setDebugLevel(903);
        return request;
    }

    public static void main(String[] args) throws Exception {
        PredictClient client = InitClient();
        client.setToken("tokenGeneratedFromService");
        client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com");
        client.setModelName("alirec_rank_no_fg");
        client.setIsCompressed(false);
        long startTime = System.currentTimeMillis();
        for (int i = 0; i < 10; i++) {
            TorchResponse response = null;
            try {
                response = client.predict(buildPredictRequest());
                List<Float> result = response.getFloatVals(0);
                System.out.print("Predict Result: [");
                for (int j = 0; j < result.size(); j++) {
                    System.out.print(result.get(j).floatValue());
                    if (j != result.size() - 1) {
                        System.out.print(", ");
                    }
                }
                System.out.print("]\n");
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");
        client.shutdown();
    }
}
Parameter utama adalah:
-
client.setToken("tokenGeneratedFromService"): Ganti nilai placeholder dengan token layanan Anda. Misalnya:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****. -
client.setEndpoint("175805416243****.cn-beijing.pai-eas.aliyuncs.com"): Ganti nilai placeholder dengan titik akhir layanan Anda. Misalnya:
175805416243****.cn-beijing.pai-eas.aliyuncs.com. -
client.setModelName("alirec_rank_no_fg"): Ganti nilai placeholder dengan nama layanan Anda.
SDK Python EAS
Sebelum menjalankan kode, jalankan pip install -U eas-prediction --user untuk menginstal atau memperbarui pustaka eas-prediction. Untuk informasi lebih lanjut, lihat Gunakan SDK Python. Contoh berikut menunjukkan cara mengirim permintaan ke layanan alirec_rank_no_fg:
from eas_prediction import PredictClient
from eas_prediction import TorchRequest

# snappy data
req = TorchRequest(False)

req.add_feed(0, [300, 3], TorchRequest.DT_INT64, [1] * 900)
req.add_feed(1, [300, 10, 768], TorchRequest.DT_FLOAT, [1.0] * 3 * 768000)
req.add_feed(2, [300, 768], TorchRequest.DT_FLOAT, [1.0] * 3 * 76800)
req.add_feed(3, [300], TorchRequest.DT_INT64, [1] * 300)


client = PredictClient('<your_endpoint>', '<your_service_name>')
client.set_token('<your_service_token>')

client.init()

resp = client.predict(req)
print(resp)
Pengaturan utama adalah:
-
<your_endpoint>: Ganti placeholder ini dengan titik akhir layanan Anda. Misalnya:
http://175805416243****.cn-beijing.pai-eas.aliyuncs.com/. -
<your_service_name>: Ganti placeholder ini dengan nama layanan Anda.
-
<your_service_token>: Ganti placeholder ini dengan token layanan Anda. Misalnya:
MmFiMDdlO****wYjhhNjgwZmZjYjBjMTM1YjliZmNkODhjOGVi****.
Untuk detail tentang kode status layanan, lihat Kode status layanan. Untuk membangun permintaan layanan, lihat juga Format permintaan.
Format permintaan
Untuk memanggil layanan, Anda dapat menghasilkan kode permintaan prediksi dari file .proto. Atau, untuk membangun permintaan sendiri, gunakan definisi Protobuf berikut:
pytorch_predict.proto: Model Torch
syntax = "proto3";

package pytorch.eas;
option cc_enable_arenas = true;
option java_package = "com.aliyun.openservices.eas.predict.proto";
option java_outer_classname = "TorchPredictProtos";

enum ArrayDataType {
  // Not a legal value for DataType. Used to indicate that a DataType field
  // has not been set.
  DT_INVALID = 0;

  // Data types that all computation devices are expected to support.
  DT_FLOAT = 1;
  DT_DOUBLE = 2;
  DT_INT32 = 3;
  DT_UINT8 = 4;
  DT_INT16 = 5;
  DT_INT8 = 6;
  DT_STRING = 7;
  DT_COMPLEX64 = 8;  // Single-precision complex
  DT_INT64 = 9;
  DT_BOOL = 10;
  DT_QINT8 = 11;     // Quantized int8
  DT_QUINT8 = 12;    // Quantized uint8
  DT_QINT32 = 13;    // Quantized int32
  DT_BFLOAT16 = 14;  // Float32 truncated to 16 bits. Only for cast ops.
  DT_QINT16 = 15;    // Quantized int16
  DT_QUINT16 = 16;   // Quantized uint16
  DT_UINT16 = 17;
  DT_COMPLEX128 = 18;  // Double-precision complex
  DT_HALF = 19;
  DT_RESOURCE = 20;
  DT_VARIANT = 21;  // Arbitrary C++ data types
}

// Dimensions of an array.
message ArrayShape {
  repeated int64 dim = 1 [packed = true];
}

// Represents an array.
message ArrayProto {
  // Data type.
  ArrayDataType dtype = 1;

  // Array shape.
  ArrayShape array_shape = 2;

  // DT_FLOAT.
  repeated float float_val = 3 [packed = true];

  // DT_DOUBLE.
  repeated double double_val = 4 [packed = true];

  // DT_INT32, DT_INT16, DT_INT8, DT_UINT8.
  repeated int32 int_val = 5 [packed = true];

  // DT_STRING.
  repeated bytes string_val = 6;

  // DT_INT64.
  repeated int64 int64_val = 7 [packed = true];

}


message PredictRequest {

  // Input tensors.
  repeated ArrayProto inputs = 1;

  // Output filter.
  repeated int32 output_filter = 2;

  // Input tensors for the recommendation model.
  map<string, ArrayProto> map_inputs = 3;

  // Debug level for the recommendation model.
  int32 debug_level = 100;
}

// Response for a successful PredictRequest.
message PredictResponse {
  // Output tensors.
  repeated ArrayProto outputs = 1;
  // Output tensors from the recommendation model.
  map<string, ArrayProto> map_outputs = 2;
}
torchrec_predict.proto: Model Torch dengan FG
syntax = "proto3";

option go_package = ".;torch_predict_protos";
option java_package = "com.aliyun.openservices.eas.predict.proto";
option java_outer_classname = "TorchRecPredictProtos";
package com.alibaba.pairec.processor;
import "pytorch_predict.proto";

// Mappings from int64.
message LongStringMap {
  map<int64, string> map_field = 1;
}
message LongIntMap {
  map<int64, int32> map_field = 1;
}
message LongLongMap {
  map<int64, int64> map_field = 1;
}
message LongFloatMap {
  map<int64, float> map_field = 1;
}
message LongDoubleMap {
  map<int64, double> map_field = 1;
}

// Mappings from string.
message StringStringMap {
  map<string, string> map_field = 1;
}
message StringIntMap {
  map<string, int32> map_field = 1;
}
message StringLongMap {
  map<string, int64> map_field = 1;
}
message StringFloatMap {
  map<string, float> map_field = 1;
}
message StringDoubleMap {
  map<string, double> map_field = 1;
}

// Mappings from int32.
message IntStringMap {
  map<int32, string> map_field = 1;
}
message IntIntMap {
  map<int32, int32> map_field = 1;
}
message IntLongMap {
  map<int32, int64> map_field = 1;
}
message IntFloatMap {
  map<int32, float> map_field = 1;
}
message IntDoubleMap {
  map<int32, double> map_field = 1;
}

// Single-level lists.
message IntList {
  repeated int32 features = 1;
}
message LongList {
  repeated int64 features  = 1;
}

message FloatList {
  repeated float features = 1;
}
message DoubleList {
  repeated double features = 1;
}
message StringList {
  repeated string features = 1;
}

// Nested lists.
message IntLists {
  repeated IntList lists = 1;
}
message LongLists {
  repeated LongList lists = 1;
}

message FloatLists {
  repeated FloatList lists = 1;
}
message DoubleLists {
  repeated DoubleList lists = 1;
}
message StringLists {
  repeated StringList lists = 1;
}

message PBFeature {
  oneof value {
    int32 int_feature = 1;
    int64 long_feature = 2;
    string string_feature = 3;
    float float_feature = 4;
    double double_feature=5;

    LongStringMap long_string_map = 6;
    LongIntMap long_int_map = 7;
    LongLongMap long_long_map = 8;
    LongFloatMap long_float_map = 9;
    LongDoubleMap long_double_map = 10;

    StringStringMap string_string_map = 11;
    StringIntMap string_int_map = 12;
    StringLongMap string_long_map = 13;
    StringFloatMap string_float_map = 14;
    StringDoubleMap string_double_map = 15;

    IntStringMap int_string_map = 16;
    IntIntMap int_int_map = 17;
    IntLongMap int_long_map = 18;
    IntFloatMap int_float_map = 19;
    IntDoubleMap int_double_map = 20;

    IntList int_list = 21;
    LongList long_list =22;
    StringList string_list = 23;
    FloatList float_list = 24;
    DoubleList double_list = 25;

    IntLists int_lists = 26;
    LongLists long_lists =27;
    StringLists string_lists = 28;
    FloatLists float_lists = 29;
    DoubleLists double_lists = 30;

  }
}

// Context features.
message ContextFeatures {
  repeated PBFeature features = 1;
}

// Defines the request sent to the aggregator.
message PBRequest {
  // Debug level.
  int32 debug_level = 1;

  // User features, keyed by the input name.
  map<string, PBFeature> user_features = 2;

  // Item IDs.
  repeated string item_ids = 3;

  // Context features for each item, keyed by the input name.
  map<string, ContextFeatures> context_features = 4;

  // The number of nearest neighbors to retrieve from Faiss.
  int32 faiss_neigh_num = 5;

  // Item features for each item, keyed by the input name.
  map<string, ContextFeatures> item_features = 6;

  // Optional metadata.
  map<string, string> meta_data = 7;
}

// Defines the response from the aggregator.
message PBResponse {
  // Torch output tensors.
  map<string, pytorch.eas.ArrayProto> map_outputs = 1;

  // Output features from the feature generator (FG).
  map<string, string> generate_features = 2;

  // All input features for the feature generator (FG).
  map<string, string> raw_features = 3;

  // Item IDs.
  repeated string item_ids = 4;

  // Pass-through data configured in the model.
  map<string, string> pass_through_data = 5;
}
Parameter debug_level adalah sebagai berikut:
Konfigurasi hanya diperlukan untuk debugging.
|
Nilai |
Deskripsi |
|
0 |
Menjalankan prediksi standar. |
|
1 |
Memvalidasi |
|
2 |
Memvalidasi |
|
3 |
Memvalidasi |
|
100 |
Menyimpan permintaan prediksi—termasuk permintaan asli, |
|
102 |
Menjalankan |
|
903 |
Mencatat |
|
904 |
Memeriksa permintaan untuk |
Kode status layanan
Bagian ini menjelaskan kode status utama untuk layanan TorchEasyRec. Untuk kode status layanan EAS, lihat Lampiran: Kode status layanan dan kesalahan umum.
|
Kode status |
Deskripsi |
|
200 |
Permintaan berhasil. |
|
400 |
Permintaan tidak valid. |
|
500 |
Prediksi gagal. Periksa log layanan untuk informasi lebih lanjut. |
Simpan dan urai permintaan Protobuf
Pada versi processor 1.12 atau yang lebih baru, Anda dapat mengaktifkan mode debug dengan menyetel debug=True dalam badan permintaan mesin PAI-REC. Ini menyimpan permintaan asli dan fitur input/output sisi item ke file protobuf untuk analisis dan validasi. Untuk menggunakan fitur ini, atur parameter request_log_path ke jalur tujuan dan pasang OSS ke jalur tersebut. Misalnya:
"model_config": {
        "fg_mode": "normal",
        "fg_threads": 8,
        "request_log_path": "/request_log",
        "background_feature_thread_num": 8
},
 "storage": [
    {
        "mount_path": "/request_log",
        "oss": {
            "path": "oss://my-bucket/my-model/myrequests/",
            "readOnly": false
        }
    },
    {
        "mount_path": "/home/admin/docker_ml/workspace/model/",
        "oss": {
            "path": "oss://my-bucket/my-model/20260316",
            "readOnly": false
        }
    }
]
Processor membuat subdirektori date_hour di jalur yang ditentukan oleh request_log_path untuk menyimpan data permintaan. Thread latar belakang menulis data ini ke disk secara asinkron. Gunakan parameter model_config.background_feature_thread_num untuk mengonfigurasi jumlah thread latar belakang. Nilai default adalah 4, dan menaikkannya dapat meningkatkan throughput penulisan. File Protobuf yang ditulis ke disk menggunakan format <request_id>_<random_str>.pb. Karena bandwidth tulis OSS terbatas, jangan aktifkan mode debug untuk volume permintaan tinggi di mesin PAI-REC. Jika penulisan disk tertinggal, antrean internal layanan model akan membuang permintaan baru.
Untuk mengurai file protobuf, Anda harus menggunakan EAS-Python-SDK 0.35 atau yang lebih baru, atau EAS-Java-SDK 2.0.29 atau yang lebih baru. Contoh berikut menunjukkan cara melakukannya di Python:
from eas_prediction.torchrec_predict_pb2 import PBLogData
with open('xxxx.pb', 'rb') as f:
    pb_data = f.read()
pb_log = PBLogData()
pb_log.ParseFromString(pb_data)
print(pb_log) # Print the entire log

print(pb_log.request) # Print the request
print(pb_log.raw_features) # Print the raw item-side features
print(pb_log.generate_features) # Print the item-side generated features
Pemanasan layanan model
Saat layanan model dimulai atau diperbarui, layanan tersebut mungkin mengalami lonjakan waktu respons. Untuk mengurangi lonjakan ini, konfigurasikan fitur pemanasan untuk processor. Misalnya, pada versi easyrec-torch-1.5 dan yang lebih baru, Anda dapat mengaktifkan fitur ini dengan menambahkan tiga parameter ke model_config.
"warmup_data_path": "/warmup",  # Mengaktifkan pemanasan dan menetapkan jalur untuk file pemanasan.
"warmup_cnt_per_file": 20, # Jumlah iterasi pemanasan per file. Nilai yang lebih tinggi menghasilkan pemanasan lebih menyeluruh.
"warmup_pb_files_count": 64 # Jumlah permintaan online yang disimpan sebagai file protobuf untuk pemanasan. Nilai yang lebih tinggi membantu mencakup lebih banyak pola data.
Untuk menyimpan file protobuf secara persisten, konfigurasikan pemasangan OSS di bagian storage pada warmup_data_path. Misalnya:
"storage": [
    ...,
    {
        "mount_path": "/warmup",
        "oss": {
            "path": "oss://<warmup Protobuf file path>",
            "readOnly": false
        }
    }
]
Pada startup pertama setelah konfigurasi, processor menangkap dan menyimpan jumlah permintaan online yang ditentukan oleh warmup_pb_files_count. Pada restart berikutnya, processor menggunakan file protobuf yang disimpan ini untuk pemanasan.
Pelatihan dan penerapan pembelajaran online
Dalam skenario rekomendasi dan periklanan, minat pengguna, popularitas item, dan data bisnis terus berubah. Model perlu menyerap sinyal umpan balik baru secara tepat waktu dan menyinkronkan hasil pelatihan ke layanan online. Pembelajaran online mengurangi waktu dari saat data baru berpartisipasi dalam pelatihan hingga memengaruhi hasil prediksi melalui pelatihan berkelanjutan dan pembaruan parameter.
Mulai dari easyrec-torch-2.5, Processor TorchEasyRec mendukung pembaruan embedding inkremental dan pembaruan panas model dense dalam mode inferensi embedding terdistribusi. Dikombinasikan dengan pekerjaan pelatihan TorchEasyRec dan FeatureDB, Anda dapat membangun pipeline end-to-end dari pelatihan berkelanjutan hingga penerbitan parameter hingga inferensi online, tanpa perlu me-restart atau menerapkan ulang layanan inferensi untuk setiap pembaruan parameter. TorchEasyRec bertanggung jawab atas pelatihan dan ekspor parameter model, FeatureDB menyimpan dan menyediakan data pembaruan embedding, dan Processor menerapkan pembaruan ke inferensi online.
Prinsip kerja
Pembelajaran online membagi pembaruan model menjadi dua jalur:
-
Pembaruan embedding inkremental: Sisi pelatihan menangkap embedding yang berubah dan menuliskannya ke FeatureDB. Processor menarik dan memperbarui tabel embedding lokal yang digunakan untuk inferensi, yang mengurangi overhead pemuatan ulang semua parameter. Mekanisme ini mendukung embedding floating-point dan terkuantisasi, serta mendukung pembersihan kunci embedding dinamis yang telah dieliminasi oleh sisi pelatihan.
-
Pembaruan panas model dense: Sisi pelatihan menerbitkan versi model dense baru. Setelah Processor mendeteksi pembaruan, Processor melakukan pemeriksaan kompatibilitas dan pemanasan, lalu beralih panas ke versi baru. Selama pemuatan dan pemanasan, model yang ada terus melayani permintaan inferensi.
Untuk mengoordinasikan kedua jalur tersebut, TorchEasyRec dan Processor menyediakan mekanisme penyelarasan pembaruan Dense/Sparse guna memastikan kualitas skoring online.
Penggunaan
-
Prasyarat
-
TorchEasyRec: >= 1.4.3 atau yang lebih baru
-
Processor: >= easyrec-torch-2.5
-
Processor berjalan di lingkungan GPU NVIDIA.
-
FeatureDB diaktifkan. Buat proyek dan konfigurasikan FeatureDB sebagai sumber data online.
-
-
Prosedur
-
Fase pelatihan
Fase pelatihan terdiri dari dua langkah: pelatihan offline penuh dan ekspor untuk menginisialisasi Processor, serta pelatihan online inkremental untuk terus memperbarui Processor.
-
Pelatihan data offline penuh: Latih model seperti sebelumnya, lalu ekspor dalam mode terdistribusi.
Perintah pelatihan:
torchrun --master_addr=localhost --master_port=<port> \
    --nnodes=1 --nproc-per-node=1 --node_rank=0 \
    -m tzrec.train_eval \
    --pipeline_config_path ${work_dir}/your_training_config.config \
    --train_input_path ${data_dir}/\*.parquet \
    --eval_input_path ${data_dir}\*.parquet \
    --model_dir ${work_dir}/your_model_dir
Perintah ekspor: Atur variabel lingkungan
USE_DISTRIBUTED_EMBEDDINGke 1. Jika diperlukan kuantisasi, atur jugaDIST_QUANT=INT8.export USE_DISTRIBUTED_EMBEDDING=1 torchrun --master_addr=localhost --master_port=<port> \ --nnodes=1 --nproc-per-node=1 --node_rank=0 \ -m tzrec.export \ --pipeline_config_path ${model_dir}/pipeline.config \ --export_dir ${model_dir}/export_dist # Direktori ekspor untuk pelatihan offline penuh. Direktori ini juga harus ditentukan selama pelatihan online. -
Pelatihan inkremental online: Unggah data embedding ke FeatureDB secara berkelanjutan dan ekspor model dense ke OSS secara berkelanjutan.
Untuk mengunggah data embedding ke FeatureDB secara berkelanjutan, tambahkan konfigurasi berikut ke field
train_configdalam konfigurasi pelatihan:```protobuf train_config{ delta_embedding_dump_config { paired_dump_interval_minutes: 5 # Wajib. Saklar frekuensi keseluruhan. Ekspor model dense setiap 5 menit, dan juga dump serta unggah embedding delta. sparse_dump_interval_minutes: 1 # Opsional. Saklar frekuensi detail halus untuk embedding sparse. Unggah embedding lebih sering. quant_type: DELTA_EMBEDDING_QUANT_INT8 feature_store_config { region: "cn-beijing" project_name: "dynemb_test" feature_view_name: "demo_dynemb_feature_view" version: "20260725" } } } ```Deskripsi parameter:
paired_dump_interval_minutes
Frekuensi keseluruhan pembelajaran online. Menentukan bahwa setiap N menit, embedding yang berubah selama interval dikumpulkan dan diunggah ke FeatureStore, dan snapshot model dense juga diekspor.
sparse_dump_interval_minutes
Frekuensi detail halus untuk unggahan embedding sparse. Menentukan bahwa setiap M menit, embedding yang berubah selama interval dikumpulkan dan diunggah ke FeatureStore, tanpa mengekspor snapshot model dense. Parameter ini opsional. Jika diatur, nilainya harus kurang dari paired_dump_interval_minutes.
paired_dump_interval_steps / sparse_dump_interval_steps
Sama seperti di atas, tetapi menggunakan langkah pelatihan sebagai dasar frekuensi alih-alih menit. Saling eksklusif dengan parameter berbasis menit.
quant_type
Jenis kuantisasi. Nilai yang valid:
DELTA_EMBEDDING_QUANT_NONE (tanpa kuantisasi)
DELTA_EMBEDDING_QUANT_INT8 (kuantisasi INT8)
Kuantisasi dinonaktifkan secara default. Kami merekomendasikan mengaktifkannya saat model besar.
feature_store_config
region
Wilayah tempat FeatureDB diaktifkan, misalnya, cn-beijing.
project_name
Nama proyek FeatureStore yang telah dibuat sebelumnya.
feature_view_name
Nama tampilan fitur. Jika tidak ada, sistem membuatnya secara otomatis.
version
Nomor versi pelatihan saat ini. Pelatihan online mengunggah data embedding ke kumpulan data yang ditentukan oleh versi ini, yang dikelola oleh FeatureStore. Processor juga harus menentukan versi ini.
Perintah pelatihan:
export ALIBABA_CLOUD_ACCESS_KEY_ID=your key
export ALIBABA_CLOUD_ACCESS_KEY_SECRET=your secret
export FEATUREDB_USERNAME=your fdb user
export FEATUREDB_PASSWORD=your fdb pw

export ONLINE_DENSE_EXPORT=1
export USE_DISTRIBUTED_EMBEDDING=1
export ONLINE_DENSE_EXPORT_DIR=your full offline export directory
export ONLINE_DENSE_EXPORT_KEEP_VERSIONS=20

torchrun --master_addr=localhost --master_port=32555 \
    --nnodes=1 --nproc-per-node=1 --node_rank=0 \
    -m tzrec.train_eval \
    --pipeline_config_path online_train.config \
    --continue_train \
    --train_input_path /<data_dir>/\*.parquet \
    --eval_input_path /<data-dir>/\*.parquet \
    --model_dir your_model_dir
Deskripsi variabel lingkungan:
ONLINE_DENSE_EXPORT=1
Mengaktifkan ekspor berkelanjutan model dense.
USE_DISTRIBUTED_EMBEDDING=1
Mengaktifkan ekspor terdistribusi dengan pemisahan sparse/dense.
ONLINE_DENSE_EXPORT_DIR
Direktori untuk ekspor offline penuh.
ONLINE_DENSE_EXPORT_KEEP_VERSIONS
Mengontrol pembersihan model dense yang diekspor. Nilai default: 0, yang berarti tidak ada pembersihan. Saat diatur ke nilai lebih besar dari 0, sistem menyimpan K versi terbaru. Nilai minimum K adalah 3. Ini mencegah penggunaan sumber daya berlebihan akibat terlalu banyak file.
-
-
Fase inferensi
Konfigurasi Processor:
"model_config": {
        "fg_mode": "normal",
        "featuredb_username": "your user",
        "featuredb_password": "your pw",
        "access_key_id": "your ak",
        "access_key_secret": "your as",
        "region": "your region"
        "fs_project": "your fs project",

        "dense_hot_load": {
            "enable": true,
            "dense_poll_interval_minutes": 1
        },
        "feature_store_embedding_polling": {
            "feature_view_name": "your feature view name",
            "mode": "apply",
            "version": "your feature store version",
            "sparse_poll_interval_secs": 10
        }
    },
    "processor": "easyrec-torch-2.5",
Deskripsi parameter:
dense_hot_load
enable: true
Mengaktifkan Processor untuk polling direktori model. Saat model dense baru terdeteksi, Processor secara otomatis memuat dan beralih ke model tersebut. Sebelum beralih, Processor menarik data dari FeatureDB untuk menyinkronkan embedding sparse.
dense_poll_interval_minutes
Frekuensi Processor melakukan polling direktori model, dalam menit. Nilai default: 1.
feature_store_embedding_polling
feature_view_name
Nama tampilan fitur untuk polling pembaruan embedding.
mode
Mode pembaruan. Atur parameter ini ke
apply.version
Versi FeatureStore yang sesuai dengan konfigurasi pelatihan.
sparse_poll_interval_secs
Interval Processor melakukan polling FeatureStore untuk pembaruan embedding sparse, dalam detik. Nilai default: 10.
-