Topik ini menjelaskan kode status dan kesalahan umum yang dikembalikan saat Anda memanggil suatu layanan.
Deskripsi kode status
|
Status code |
Description |
|
200 |
Layanan berhasil memproses permintaan. |
|
400 |
Format Request Body tidak benar atau terjadi pengecualian dalam kode custom processor. Catatan
Jika kode custom processor Anda melemparkan pengecualian, server akan mengembalikan kode status 400. Untuk membedakannya dari kesalahan lain, konfigurasikan custom processor Anda agar mengembalikan kode status tertentu untuk pengecualian tersebut. |
|
401 |
Otentikasi layanan gagal. Untuk informasi lebih lanjut, lihat 401 Authorization Failed. |
|
404 |
Layanan tidak ditemukan. Untuk informasi lebih lanjut, lihat 404 Not Found. |
|
405 |
Metode tidak diizinkan. Misalnya, server mengembalikan kesalahan 405 jika Anda mengirim permintaan POST ke server yang hanya mendukung permintaan GET. Coba gunakan metode HTTP yang berbeda. |
|
408 |
Permintaan timeout. Server memiliki timeout default 5 detik untuk setiap permintaan. Anda dapat mengonfigurasi nilai ini dengan mengatur field Catatan
Waktu pemrosesan total untuk satu permintaan mencakup waktu komputasi Processor, waktu penerimaan paket data jaringan, dan waktu tunggu dalam antrian. |
|
429 |
Permintaan memicu rate limiting.
|
|
450 |
|
|
499 |
Klien menutup koneksi. Saat klien secara aktif menutup koneksi, klien tersebut tidak menerima kode status 499. Sebaliknya, server mencatat semua permintaan yang belum diproses dari koneksi tersebut dengan kode status 499. Misalnya, jika klien memiliki timeout HTTP 30 ms dan latensi pemrosesan sisi server adalah 50 ms, klien akan membatalkan permintaan setelah 30 ms dan menutup koneksi. Kode status 499 kemudian akan muncul dalam pemantauan sisi server. |
|
500 |
Kesalahan internal server. Server mengalami kondisi tak terduga yang menghalanginya untuk memenuhi permintaan. |
|
501 |
Belum Diimplementasikan. Server tidak mendukung fungsionalitas yang diperlukan untuk memenuhi permintaan. |
|
502 |
Bad Gateway. Server, saat bertindak sebagai gateway atau proxy, menerima respons tidak valid dari server hulu (upstream). |
|
503 |
Layanan Tidak Tersedia. Saat Anda mengakses layanan melalui gateway, jika semua instans layanan backend tidak dalam keadaan siap (ready), gateway akan mengembalikan kode status 503. Untuk informasi lebih lanjut, lihat 503 no healthy upstream. |
|
504 |
Gateway Timeout. Untuk informasi lebih lanjut, lihat 504 timeout. |
|
505 |
Versi HTTP Tidak Didukung. Server tidak mendukung versi protokol HTTP yang digunakan dalam permintaan. |
Kode kesalahan pemanggilan SDK
Saat menggunakan SDK EAS resmi untuk memanggil layanan, SDK dapat menghasilkan kode kesalahan sendiri yang mungkin berbeda dari yang dikembalikan oleh server. Selalu gunakan kode kesalahan dalam log gateway dan layanan sebagai sumber kebenaran.
|
Status code |
Description |
|
512 |
Saat menggunakan EAS Golang SDK, jika klien secara aktif memutus koneksi, SDK akan mengembalikan kode kesalahan 512. Timeout sisi klien ini sesuai dengan Kode Status 499 di sisi server. |
Kesalahan umum
404 Not Found
Kesalahan 404 biasanya menunjukkan jalur permintaan tidak valid, badan permintaan salah, atau API yang tidak didukung oleh layanan. Gunakan skenario berikut untuk melakukan pemecahan masalah berdasarkan pesan kesalahan spesifik yang Anda terima.
Jenis kesalahan 1: {"object":"error","message":"The model `` does not exist.","type":"NotFoundError","param":null,"code":404}
Penyebab: Parameter model dalam badan permintaan kosong atau tidak valid saat memanggil endpoint /v1/chat/completions layanan yang diterapkan dengan vLLM.
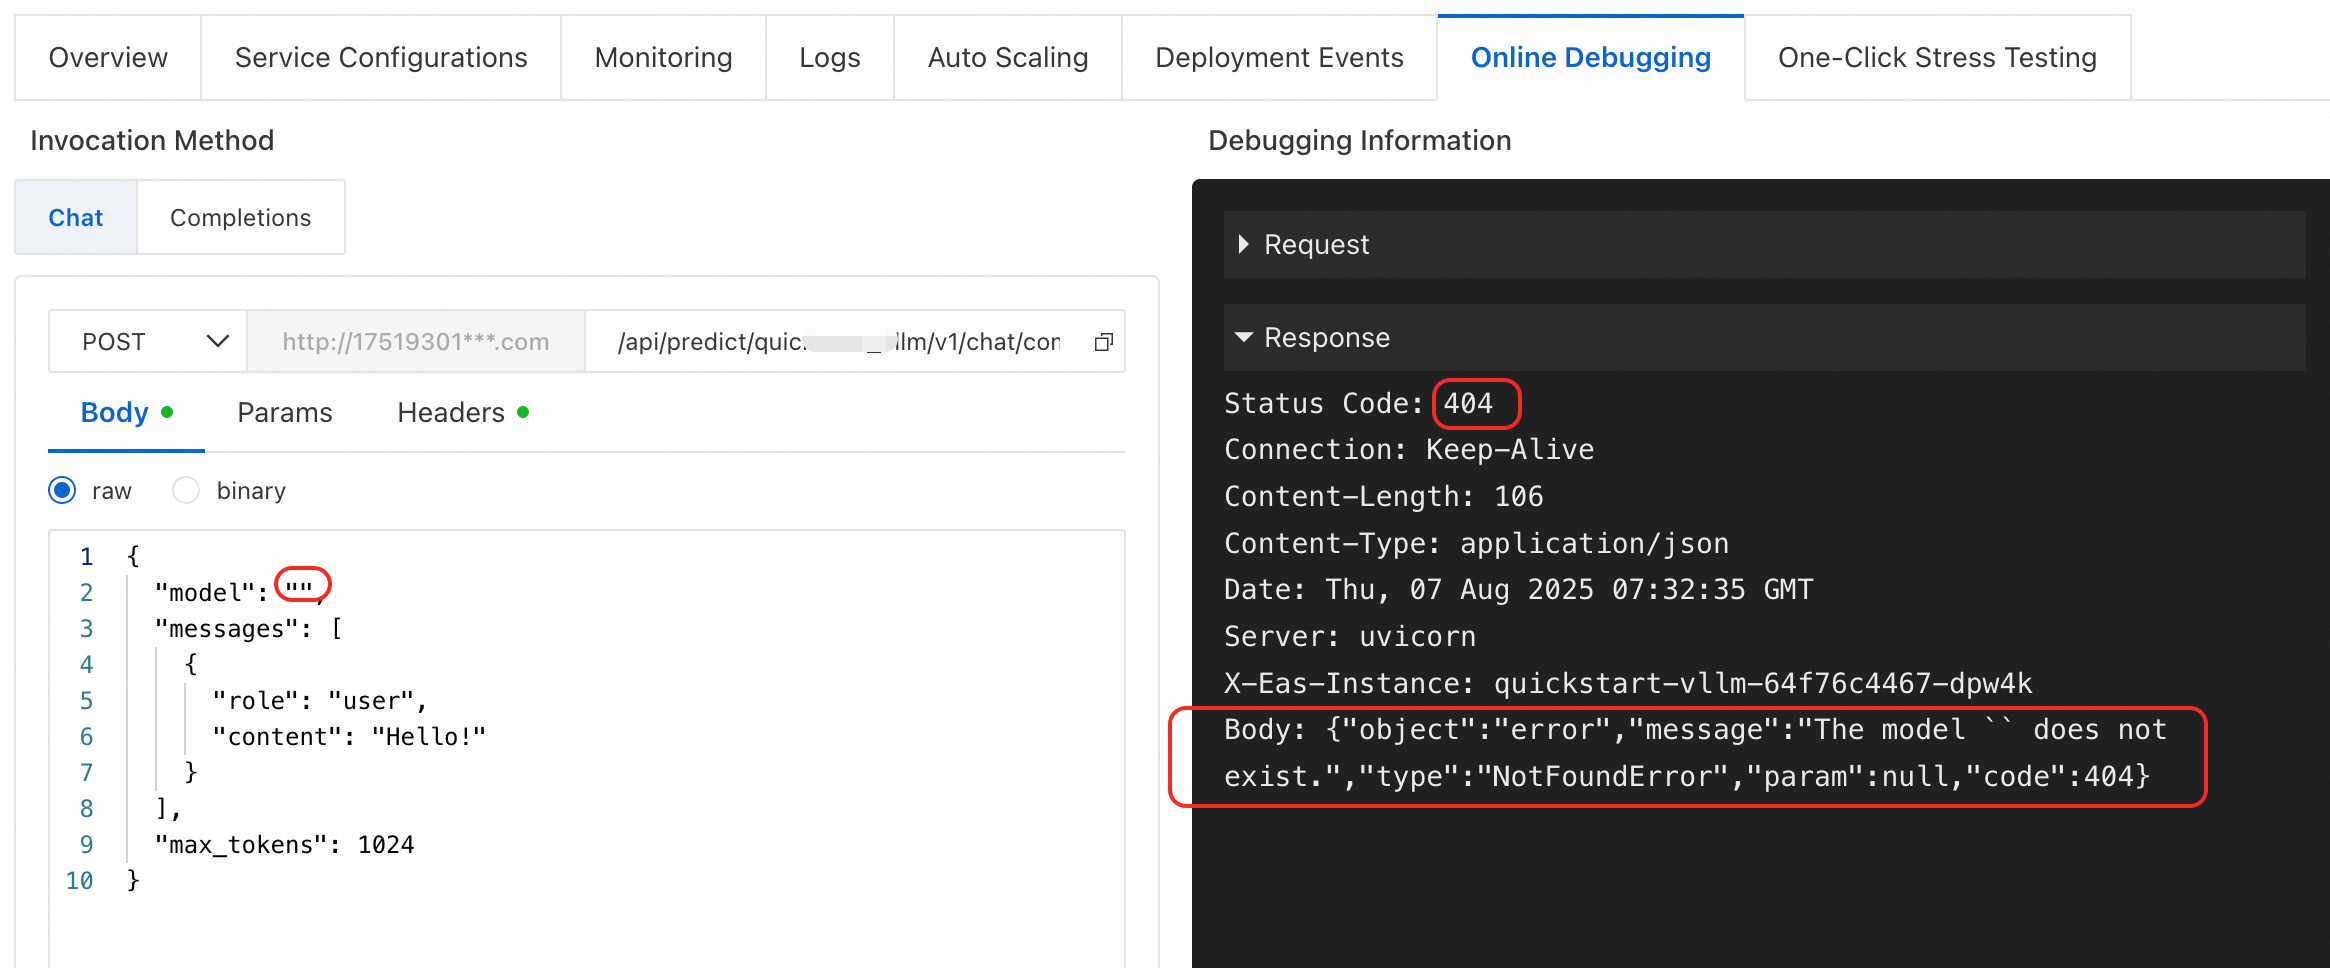
Solusi: Nilai parameter model harus berupa nama model yang valid. Cari tahu nama model yang valid dengan menggunakan endpoint v1/models.
Jenis kesalahan 2: {"detail":"Not Found"}
Penyebab: Jalur permintaan tidak lengkap atau salah. Misalnya, saat memanggil endpoint chat layanan LLM, Anda tidak menambahkan jalur v1/chat/completions ke URL dasar.
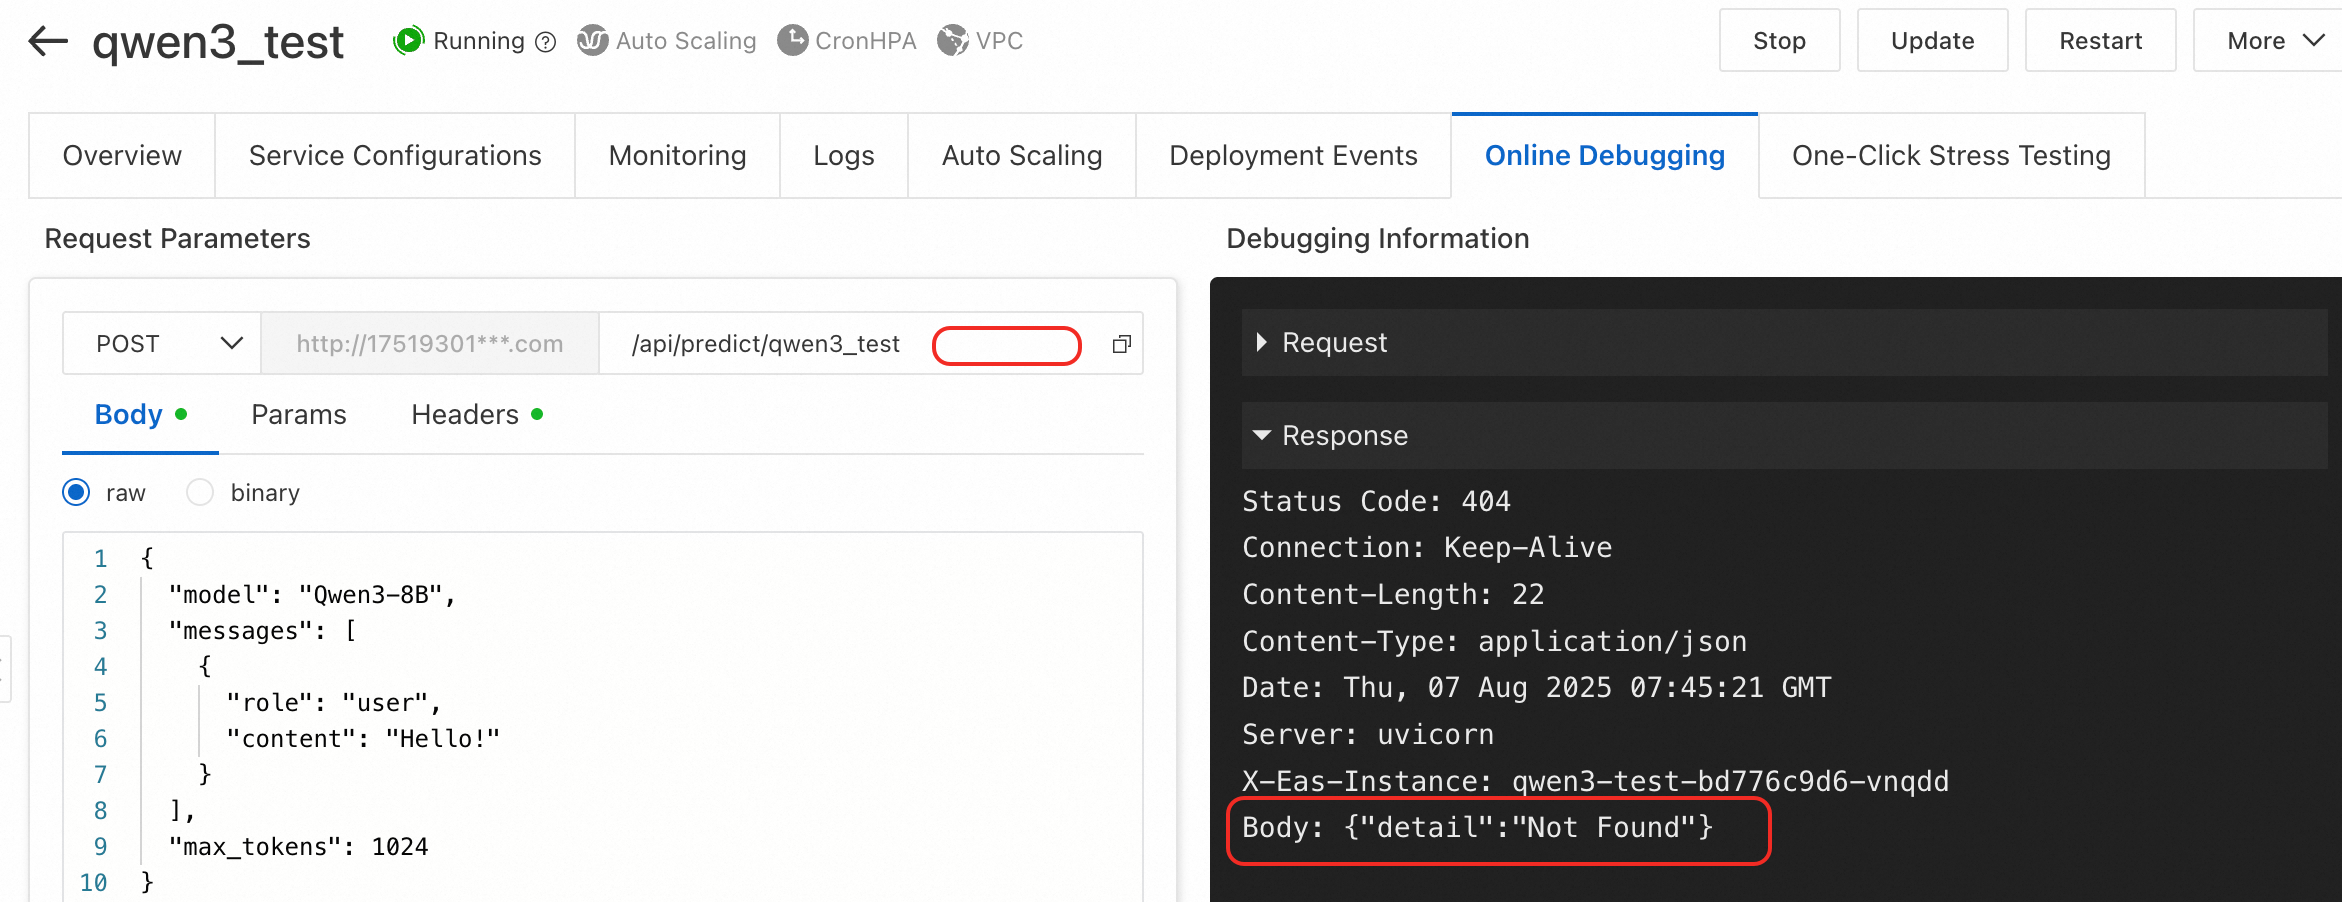
Solusi: Pastikan jalur permintaan API lengkap dan benar. Untuk layanan LLM, lihat pemanggilan layanan LLM.
Jenis kesalahan 3: Memanggil endpoint /v1/models BladeLLM mengembalikan 404: Not Found.
Penyebab: Layanan yang diterapkan dengan BladeLLM tidak mendukung endpoint v1/models.
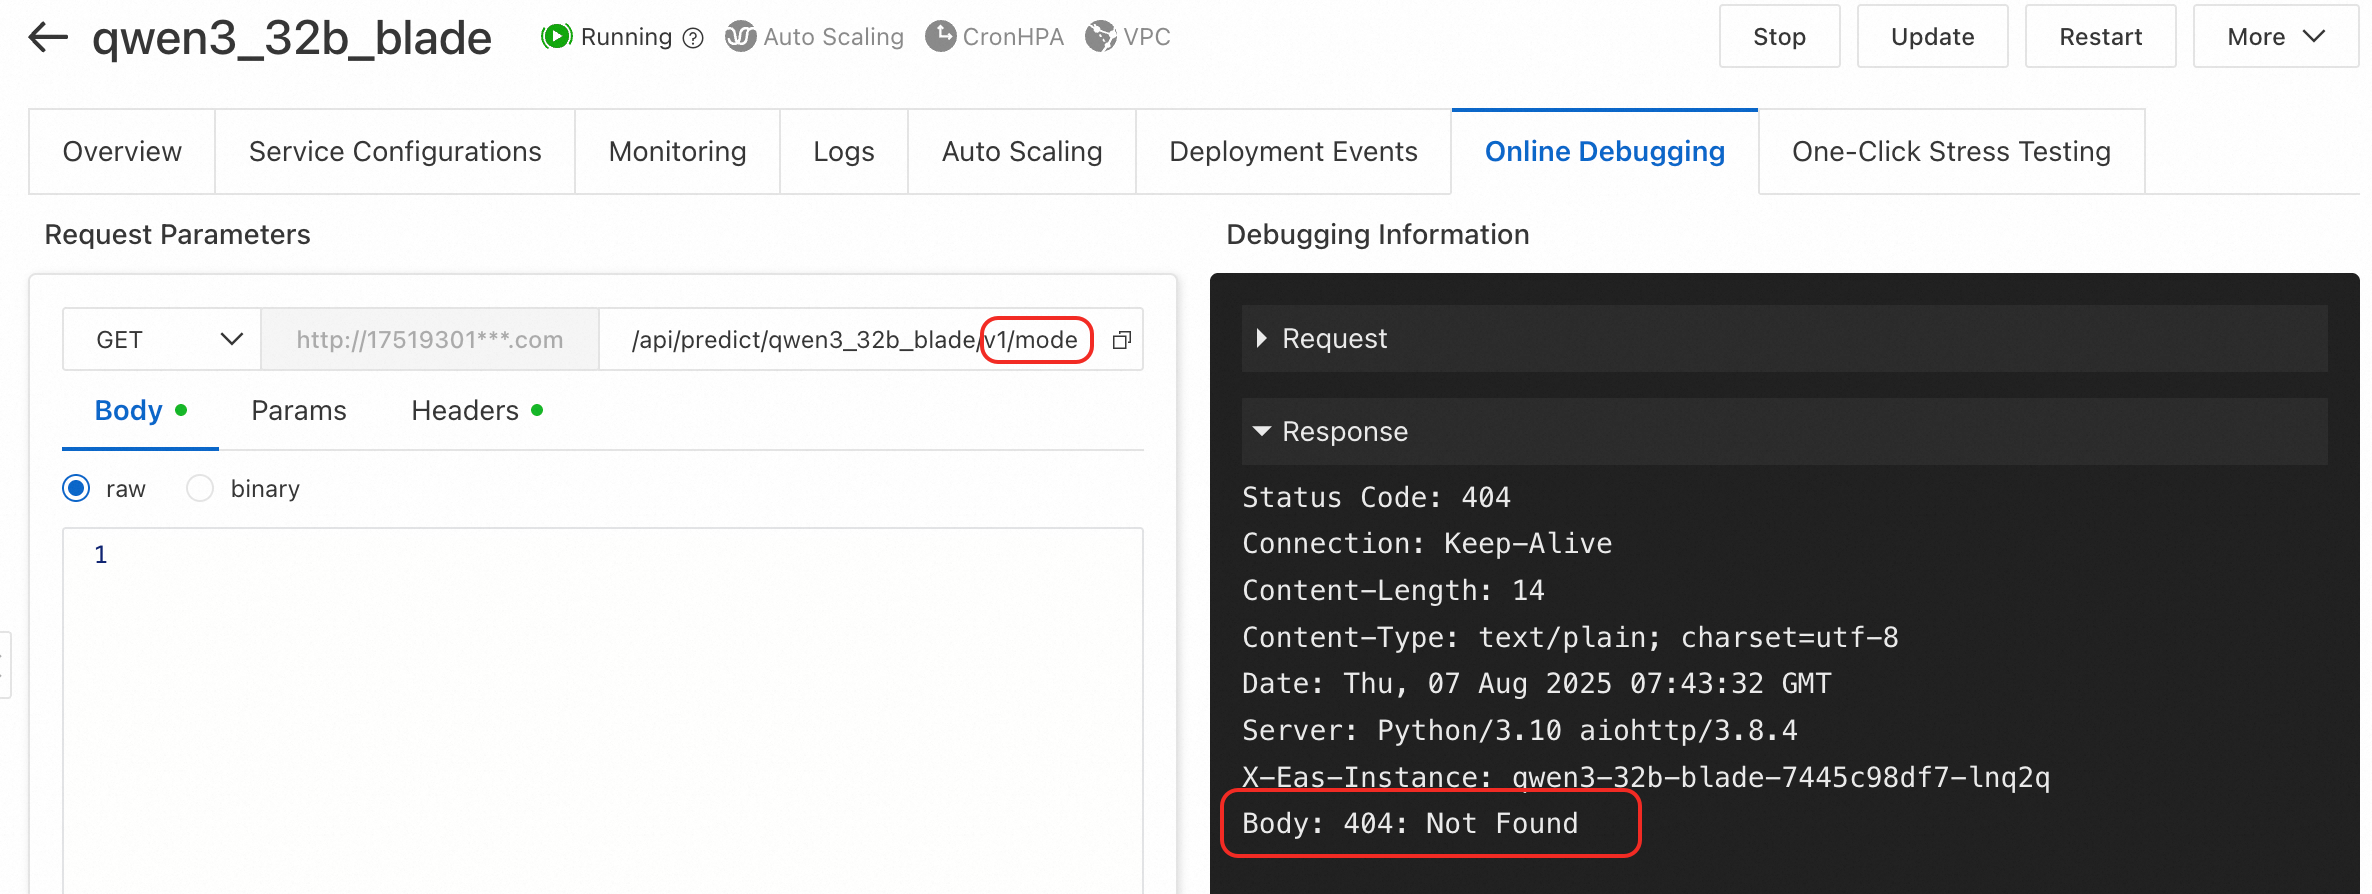
Solusi: Untuk daftar API yang didukung, lihat konfigurasi parameter pemanggilan layanan BladeLLM.
Jenis kesalahan 4: Halaman debugging online mengembalikan kesalahan 404 tanpa informasi tambahan.
Penyebab: Jalur permintaan salah. Saat menggunakan debugging online, URL dasar biasanya http://123***.cn-hangzhou.pai-eas.aliyuncs.com/predict/service_name. Mengubah atau menghapus bagian nama layanan dari URL secara tidak benar akan menghasilkan kesalahan 404.
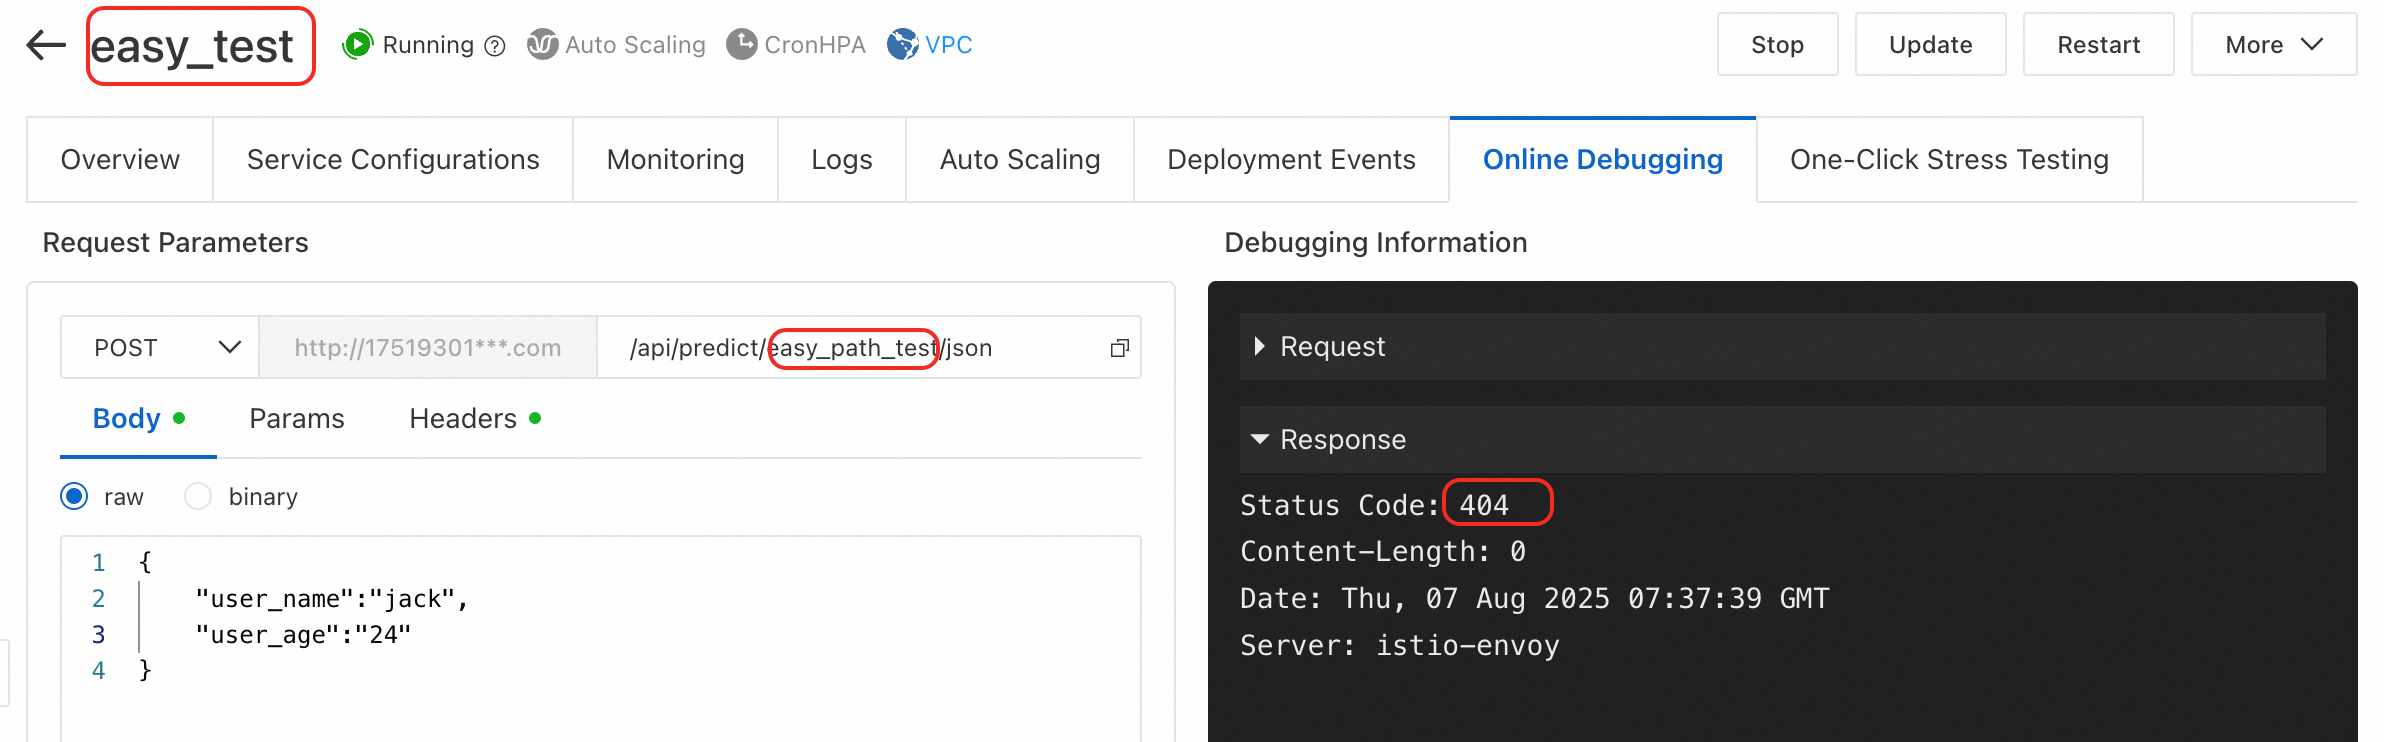
Solusi: Saat menggunakan debugging online, Anda biasanya tidak perlu mengubah atau menghapus URL default. Cukup tambahkan jalur API spesifik yang ingin Anda panggil.
Jenis kesalahan 5: Pemanggilan API ke ComfyUI mengembalikan "404 not found page".
400 Bad Request
Format badan permintaan tidak benar. Periksa dengan cermat format badan permintaan, seperti struktur JSON, nama field, dan tipe data.
401 Authorization Failed
Token otentikasi tidak ada, salah, atau digunakan secara tidak tepat. Periksa hal berikut:
-
Periksa apakah token sudah benar. Di halaman Overview layanan, klik View Invocation Information di bagian Basic Information.
CatatanSecara default, layanan secara otomatis menghasilkan token otentikasi. Anda juga dapat menentukan token kustom dan memperbaruinya selama pembaruan layanan.
-
Periksa apakah token telah diatur dengan benar.
-
Jika Anda menggunakan perintah
curl, tambahkan token ke fieldAuthorizationdalam Header HTTP. Contohnya:curl -H 'Authorization: NWMyN2UzNjBiZmI2YT***' http:// xxx.cn-shanghai.aliyuncs.com/api/predict/echo. -
Jika Anda menggunakan SDK untuk mengakses layanan, panggil fungsi
SetToken()yang sesuai. Untuk informasi lebih lanjut, lihat Petunjuk penggunaan Java SDK.
-
504 timeout
Server, yang bertindak sebagai gateway atau proxy, tidak menerima respons tepat waktu dari server hulu (upstream). Hal ini biasanya berarti inferensi model memakan waktu terlalu lama. Untuk mengatasi masalah ini:
-
Dalam kode klien Anda, tingkatkan timeout permintaan HTTP.
-
Untuk tugas berdurasi panjang, gunakan mode EAS Queue Service (Pemanggilan Asinkron), yang dirancang untuk menangani tugas inferensi batch atau berdurasi panjang.
450: Permintaan dibuang karena antrian penuh
Saat instans komputasi sisi server menerima permintaan, permintaan tersebut pertama-tama ditempatkan dalam antrian. Saat pekerja (worker) dalam instans tersedia, pekerja tersebut mengambil data dari antrian untuk diproses. Jumlah pekerja default adalah 5, yang dapat Anda sesuaikan dengan menggunakan field metadata.rpc.worker_threads dalam file JSON saat Anda membuat layanan. Jika waktu pemrosesan pekerja terlalu lama, permintaan dapat menumpuk di antrian. Saat antrian penuh, instans segera menolak permintaan baru dengan Kode Status 450 untuk mencegah antrian berlebihan yang meningkatkan latensi dan membuat layanan tidak tersedia. Panjang antrian default adalah 64, yang dapat Anda sesuaikan dengan menggunakan field metadata.rpc.max_queue_size dalam file JSON saat Anda membuat layanan.
Pembatasan panjang antrian juga berfungsi sebagai bentuk rate limiting untuk mencegah lonjakan traffic menyebabkan kegagalan berantai pada layanan.
Solusi:
-
Jika Anda menerima sejumlah kecil kode status 450, Anda dapat mencoba ulang permintaan. Karena instans sisi server bersifat independen, percobaan ulang mungkin diarahkan ke instans yang kurang sibuk, sehingga masalah ini transparan bagi klien. Namun, jangan mencoba ulang tanpa batas, karena hal ini akan menggagalkan tujuan perlindungan rate limiting.
-
Jika semua permintaan mengembalikan kode status 450, hal ini mungkin menunjukkan bahwa kode di dalam processor mengalami hang. Jika semua pekerja mengalami deadlock saat memproses permintaan dan tidak lagi mengambil data dari antrian, Anda perlu melakukan debug kode processor untuk menemukan bug tersebut.
503 no healthy upstream
Anda menerima kesalahan 503 dengan pesan "no healthy upstream" selama debugging online:

Lakukan pemecahan masalah sebagai berikut:
-
Periksa status instans. Jika instans telah berhenti, Restart Service.
-
Jika status layanan Running, instans mungkin memiliki sumber daya yang tidak mencukupi, seperti CPU, memori, atau Memori GPU, sehingga tidak memiliki ruang buffer.
-
Jika Anda menggunakan sumber daya publik, coba lakukan pemanggilan lagi selama jam sepi, atau beralih ke spesifikasi sumber daya atau Wilayah yang berbeda.
-
Jika Anda menggunakan sumber daya khusus (EAS Resource Group), pastikan kelompok sumber daya telah menyisihkan cukup CPU, memori, dan Memori GPU untuk instans. Kami merekomendasikan menyisakan setidaknya 20% sumber daya sebagai buffer.
-
-
Skenario umum lainnya adalah status layanan Running dan semua instans Ready setelah penerapan. Namun, permintaan memicu bug dalam kode, yang menyebabkan instans layanan backend crash dan tidak merespons. Dalam situasi ini, gateway mengembalikan Kode Status 503 ke klien. Untuk mengidentifikasi dan memperbaiki bug tersebut, gunakan log.
Kesalahan: Unexpected token 12606 while expecting start token 200006
Saat Anda menggunakan vllm untuk menerapkan gpt-oss, pemanggilan layanan mungkin mengembalikan kesalahan berikut:
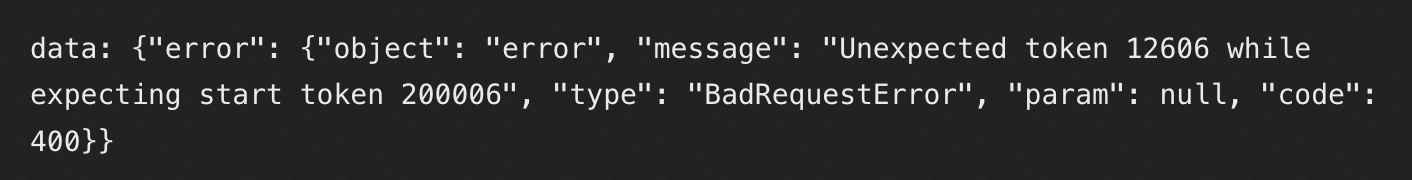
Solusi: Coba terapkan dengan akselerasi SGLang.
Kesalahan pemanggilan curl: no URL specified
Anda menerima kesalahan no URL specified setelah mengirim permintaan dengan perintah berikut:
curl -X http://17****.cn-hangzhou.pai-eas.aliyuncs.com/api/predict/service_name/**path** \
-H "Content-Type: application/json" \
-H "Authorization: **********==" \
-d '{"***":"****"}'
Penyebab: Perintah curl menggunakan flag -X tetapi tidak menyertakan metode, seperti POST.
Pemanggilan mengembalikan encoding ASCII
Ubah kode Anda sebagai berikut:
from flask import Flask, Response

@app.route('/hello', methods=['POST'])
def get_advice():
    result = "result"
    return Response(result, mimetype='text/plain', charset='utf-8')
Bagaimana cara mengatasi "[WARN] connection is closed: End of file" atau "Write a Invalid stream: End of file" dalam log layanan?
Log peringatan ini menunjukkan bahwa klien atau server menutup koneksi, dan server sedang mencoba menulis respons kembali ke koneksi yang telah ditutup tersebut. Koneksi dapat ditutup dengan dua cara:
-
Timeout sisi server: Dalam mode Processor, timeout default sisi server adalah 5 detik. Anda dapat mengubahnya dengan menggunakan parameter
metadata.rpc.keepalivelayanan. Saat timeout tercapai, server menutup koneksi dan mencatat kode status 408 dalam pemantauannya. -
Timeout sisi klien: Pengaturan kode pemanggil Anda menentukan timeout sisi klien. Jika klien tidak menerima respons HTTP dalam periode timeout yang dikonfigurasi, klien secara aktif menutup koneksi. Server kemudian mencatat kode status 499 dalam pemantauannya.
upstream connect error or disconnect/reset before headers. reset reason: connection termination
Masalah seperti timeout koneksi persisten atau beban instans yang tidak seimbang biasanya menyebabkan kesalahan ini. Jika waktu pemrosesan sisi server melebihi timeout HTTP yang dikonfigurasi pada klien, klien akan membatalkan permintaan dan secara aktif menutup koneksi. Kode status 499 kemudian akan muncul dalam pemantauan sisi server. Anda dapat memeriksa metrik pemantauan untuk konfirmasi lebih lanjut. Untuk tugas inferensi yang memakan waktu, terapkan layanan inferensi asinkron.
Bagaimana cara mengatasi kegagalan debugging online untuk layanan yang diterapkan dengan processor Tensorflow/Pytorch?
Karena alasan performa, Processor TensorFlow/PyTorch menggunakan format protobuf non-teks biasa untuk badan permintaan. Debugging online saat ini hanya mendukung input teks biasa. Oleh karena itu, Anda tidak dapat melakukan debugging langsung terhadap layanan yang diterapkan dengan processor ini di Konsol. Gunakan SDK EAS yang disediakan untuk memanggil layanan. Untuk informasi tentang SDK dalam berbagai bahasa, lihat SDK Pemanggilan Layanan.