Kategori | Tautan |
Pengumpulan log | |
Pemantauan Aplikasi | |
Managed Service for Prometheus |
|
Pemantauan Prometheus open source (add-on ack-prometheus-operator) | |
Manajemen peringatan | |
Isu lainnya |
Pengumpulan log
Bagaimana cara mengatasi error pengumpulan log kontainer?
Gejala
Jika Anda telah mengikuti petunjuk dalam Kumpulkan log kontainer kluster ACK tetapi tidak menemukan log pada halaman Preview di konsol Simple Log Service, kemungkinan pengumpulan log gagal. Untuk mengatasi masalah ini, periksa konfigurasi, status komponen dan node pengumpulan, serta log operasional kontainer pengumpul log.
Sebelum memulai
Perhatikan poin-poin berikut saat mengumpulkan log dari file kontainer.
Komponen pengumpul log hanya mengumpulkan log inkremental. Jika file log tidak diperbarui setelah konfigurasi Logtail diterapkan, komponen tersebut tidak akan mengumpulkan log dari file tersebut. Untuk informasi lebih lanjut, lihat Baca log.
Anda hanya dapat mengumpulkan log dari file yang menggunakan penyimpanan kontainer default atau dipasang ke path lokal. Metode penyimpanan lain tidak didukung.
Setelah log dikumpulkan, Anda harus membuat indeks sebelum dapat melakukan kueri dan analisis log di Logstore. Untuk informasi lebih lanjut, lihat Buat indeks.
Langkah 1: Periksa konfigurasi pengumpulan
Verifikasi bahwa konfigurasi Logtail sudah benar. Pastikan semua pengaturan pengumpulan log akurat dan kontainer terus-menerus menghasilkan log.
Konsol
Login ke Konsol ACK.
-
Pada halaman Clusters, klik nama kluster Anda. Di panel navigasi kiri, klik .
Pada tab Resource Object Browser, cari clusteraliyunpipelineconfig dan klik hasil ClusterAliyunPipelineConfig.
Di panel ClusterAliyunPipelineConfig, temukan resource target dan klik Edit YAML di kolom Actions.
kubectl
Jalankan perintah berikut untuk melihat semua konfigurasi Logtail yang dibuat oleh
AliyunPipelineConfig.kubectl get clusteraliyunpipelineconfigsLihat detail dan status konfigurasi Logtail yang dibuat oleh
AliyunPipelineConfig.Jalankan perintah berikut, lalu ganti
<config_name>dengan namaAliyunPipelineConfigsesuai kebutuhan.kubectl get clusteraliyunpipelineconfigs <config_name> -o yaml
Untuk informasi selengkapnya mengenai item konfigurasi, lihat Parameter CRD.
Item konfigurasi | Ikhtisar checkpoint | Contoh |
| Periksa apakah nama proyek sudah benar. Login ke Konsol Simple Log Service, dan temukan nama proyek yang dihasilkan oleh komponen pengumpulan log yang diinstal. |
|
| Periksa apakah path file log ada dan memiliki output. Untuk informasi lebih lanjut, lihat Pemetaan path file kontainer. |
|
| Fitur penemuan kontainer diaktifkan. |
|
| Endpoint Simple Log Service sudah benar. |
|
| Informasi wilayah sudah benar. |
|
Langkah 2: Periksa status komponen pengumpulan dan kelompok mesin
Konfirmasi bahwa komponen pengumpulan, seperti Logtail atau LoongCollector, telah diterapkan dan berjalan di setiap node pekerja, serta jumlah heartbeat OK dari kontainer pengumpulan sesuai dengan jumlah node pekerja.
Periksa status pod komponen pengumpulan.
Jalankan perintah berikut untuk memeriksa apakah semua pod pengumpulan terkait berada dalam status
Running. Jika sebuah pod berada dalam status abnormal, lihat Atasi exception pod.kubectl get pods -n kube-system -l 'k8s-app in (loongcollector-ds,logtail)'Outputnya mirip dengan berikut:
NAME                      READY   STATUS    RESTARTS   AGE
loongcollector-ds-fn5zn   1/1     Running   0          3d19h
loongcollector-ds-ks76g   1/1     Running   0          3d19h
Periksa status heartbeat kelompok mesin.
Login ke Konsol Simple Log Service.
Pada bagian Proyek, klik proyek yang diinginkan.

Di panel navigasi kiri, pilih
 Resource > Machine Groups.
Pada daftar kelompok mesin, klik kelompok mesin tujuan.
Pada halaman Machine Group Configuration, catat jumlah mesin dengan status heartbeat OK. Verifikasi bahwa jumlah ini sesuai dengan jumlah node pekerja di kluster. Untuk informasi lebih lanjut, lihat Solusi Status Heartbeat.
Langkah 3: Lihat log operasional LoongCollector (Logtail)
Periksa kontainer pengumpulan untuk mengidentifikasi error pengumpulan atau pesan kesalahan guna menganalisis lebih lanjut penyebab masalah.
Masuk ke pod komponen pengumpulan.
kubectl exec -it -n kube-system loongcollector-ds-XXXX -- bashLog Logtail disimpan di direktori
/usr/local/ilogtail/pada kontainer Logtail. Nama file-nya adalahilogtail.LOGdanlogtail_plugin.LOG. Anda dapat login ke kontainer Logtail dan menjalankan perintah berikut untuk melihat file log tersebut:# Buka direktori /usr/local/ilogtail/. cd /usr/local/ilogtail # Lihat file ilogtail.LOG dan logtail_plugin.LOG. cat ilogtail.LOG cat logtail_plugin.LOGPeriksa metrik alarm log error dan temukan solusi yang sesuai di Jenis error umum untuk pengumpulan data di Simple Log Service.
Operasi O&M lainnya
Lihat status komponen Simple Log Service di kluster Kubernetes
Periksa status komponen Kubernetes
Jalankan perintah berikut untuk melihat status dan informasi deployment Simple Log Service.
kubectl get deploy -n kube-system | grep -E 'alibaba-log-controller|loongcollector-operator'Output berikut dikembalikan:
NAME                     READY   UP-TO-DATE   AVAILABLE   AGE
alibaba-log-controller   1/1     1            1           11d
Jalankan perintah berikut untuk melihat informasi status resource DaemonSet.
kubectl get ds -n kube-system | grep -E 'logtail-ds|loongcollector-ds'Output berikut dikembalikan:
NAME         DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR  AGE
logtail-ds   2         2         2       2            2           **ux           11d
Lihat nomor versi, alamat IP, dan waktu startup Logtail
Informasi ini disimpan dalam file
/usr/local/ilogtail/app_info.jsonpada kontainer Logtail.kubectl exec logtail-ds-****k -n kube-system cat /usr/local/ilogtail/app_info.jsonOutputnya mirip dengan berikut:
{
   "UUID" : "",
   "hostname" : "logtail-****k",
   "instance_id" : "0EB****_172.20.4.2_1517810940",
   "ip" : "172.20.4.2",
   "logtail_version" : "0.16.2",
   "os" : "Linux; 3.10.0-693.2.2.el7.x86_64; #1 SMP Tue Sep 12 22:26:13 UTC 2017; x86_64",
   "update_time" : "2018-02-05 06:09:01"
}
Transfer log kluster ACK ke proyek di Akun Alibaba Cloud lain
Mengapa saya tidak dapat menghapus proyek?
Gejala
Topik ini menjelaskan cara menghapus proyek, serta langkah yang harus diambil jika Anda tidak dapat menghapus proyek dan menerima pesan error "izin tidak mencukupi".
Solusi
Untuk informasi selengkapnya tentang cara menghapus proyek atau Logstore, lihat Kelola proyek dan Kelola Logstore. Jika penghapusan proyek gagal, lihat Apa yang harus saya lakukan jika muncul pesan error "Operation denied, insufficient permissions" saat menghapus proyek?.
Jenis error umum untuk pengumpulan data di Simple Log Service
Jenis error | Deskripsi | Solusi |
LOG_GROUP_WAIT_TOO_LONG_ALARM | Paket data menunggu terlalu lama untuk dikirim setelah dihasilkan. | Periksa apakah paket dikirim sesuai harapan. Error ini dapat disebabkan oleh volume data yang melebihi konfigurasi default, kuota tidak mencukupi, atau masalah jaringan. |
LOGFILE_PERMISSION_ALARM | Logtail tidak memiliki izin untuk membaca file yang ditentukan. | Periksa akun startup Logtail di server. Atasi masalah ini dengan menjalankan Logtail sebagai pengguna root. |
SPLIT_LOG_FAIL_ALARM | Ekspresi reguler untuk awal baris tidak cocok dengan konten log, sehingga Logtail tidak dapat memisahkan log menjadi baris-baris terpisah. | Periksa apakah ekspresi reguler sudah benar. Untuk log satu baris, atur ekspresi reguler menjadi |
MULTI_CONFIG_MATCH_ALARM | Secara default, satu file log hanya dapat cocok dengan satu konfigurasi Logtail. Jika beberapa konfigurasi Logtail cocok dengan file yang sama, hanya satu yang berlaku. Catatan Beberapa konfigurasi Logtail dapat digunakan untuk mengumpulkan output standar dari Docker. |
|
REGEX_MATCH_ALARM | Dalam mode ekspresi reguler penuh, konten log tidak cocok dengan ekspresi reguler yang ditentukan. | Salin contoh log dari pesan error untuk menghasilkan ekspresi reguler baru. |
PARSE_LOG_FAIL_ALARM | Dalam mode seperti JSON dan delimiter, penguraian gagal karena format log tidak sesuai dengan format yang ditentukan. | Klik pesan error untuk melihat laporan error detail. |
CATEGORY_CONFIG_ALARM | Konfigurasi pengumpulan Logtail tidak valid. | Penyebab umum adalah ekspresi reguler gagal mengekstrak path file untuk digunakan sebagai topik. |
LOGTAIL_CRASH_ALARM | Logtail crash karena melebihi batas penggunaan sumber daya server. | Tingkatkan batas penggunaan CPU dan memori. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. |
REGISTER_INOTIFY_FAIL_ALARM | Logtail gagal mendaftarkan pendengar log di Linux. Error ini dapat terjadi karena Logtail tidak memiliki izin untuk mengakses folder, atau foldernya telah dihapus. | Periksa apakah Logtail memiliki izin untuk mengakses folder atau apakah foldernya telah dihapus. |
DISCARD_DATA_ALARM | Sumber daya CPU yang dikonfigurasi untuk Logtail tidak mencukupi, atau pembatasan kecepatan dipicu saat data dikirim melalui jaringan. | Tingkatkan batas penggunaan CPU atau batas konkurensi pengiriman jaringan. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. |
SEND_DATA_FAIL_ALARM |
|
|
REGISTER_INOTIFY_FAIL_ALARM | Logtail gagal mendaftarkan watcher inotify untuk direktori log. | Periksa apakah direktori ada dan verifikasi pengaturan izinnya. |
SEND_QUOTA_EXCEED_ALARM | Trafik penulisan log melebihi batas yang dikonfigurasi. | Tingkatkan jumlah shard di konsol. Untuk informasi lebih lanjut, lihat Kelola shard. |
READ_LOG_DELAY_ALARM | Pengumpulan log tertunda dan ketinggalan dari generasi log. Error ini biasanya disebabkan oleh sumber daya CPU Logtail yang tidak mencukupi atau pembatasan kecepatan pengiriman jaringan. | Tingkatkan batas penggunaan CPU atau batas konkurensi pengiriman jaringan. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. Jika Anda mengimpor data historis, sejumlah besar data dikumpulkan dalam waktu singkat. Anda dapat mengabaikan error ini. |
DROP_LOG_ALARM | Pengumpulan log tertunda, dan jumlah file log yang diputar yang belum diproses melebihi 20. Error ini biasanya disebabkan oleh sumber daya CPU Logtail yang tidak mencukupi atau pembatasan kecepatan pengiriman jaringan. | Tingkatkan batas penggunaan CPU atau batas konkurensi pengiriman jaringan. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. |
LOGDIR_PERMISSION_ALARM | Logtail tidak memiliki izin untuk membaca direktori pemantauan log. | Periksa apakah direktori pemantauan log ada. Jika ada, verifikasi pengaturan izinnya. |
ENCODING_CONVERT_ALARM | Konversi encoding gagal. | Periksa apakah format encoding yang dikonfigurasi sesuai dengan format encoding aktual log. |
OUTDATED_LOG_ALARM | Log sudah kedaluwarsa karena timestamp-nya lebih dari 12 jam lebih tua daripada waktu pengumpulan. Kemungkinan penyebabnya meliputi:
|
|
STAT_LIMIT_ALARM | Jumlah file di direktori yang ditentukan dalam konfigurasi pengumpulan melebihi batas. | Periksa apakah direktori pengumpulan target berisi banyak file dan subdirektori. Atur direktori root yang sesuai untuk pemantauan dan tentukan kedalaman pemantauan maksimum untuk subdirektori. Anda juga dapat mengubah parameter mem_usage_limit. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. |
DROP_DATA_ALARM | Menyimpan log ke disk lokal timeout saat proses keluar. Log yang belum disimpan akan dibuang. | Error ini biasanya terjadi karena proses pengumpulan sangat terblokir. Tingkatkan batas penggunaan CPU atau batas konkurensi pengiriman jaringan. Untuk informasi lebih lanjut, lihat Jenis jaringan Logtail, parameter startup, dan konfigurasi. |
INPUT_COLLECT_ALARM | Terjadi error selama pengumpulan dari sumber input. | Atasi error berdasarkan detail dalam pesan error. |
HTTP_LOAD_ADDRESS_ALARM | Parameter Addresses yang ditentukan dalam konfigurasi pengumpulan data HTTP tidak valid. | Periksa apakah parameter Addresses valid. |
HTTP_COLLECT_ALARM | Terjadi error selama pengumpulan data HTTP. | Atasi masalah berdasarkan detail dalam pesan error. Error ini biasanya disebabkan oleh timeout. |
FILTER_INIT_ALARM | Terjadi error selama inisialisasi filter. | Error ini biasanya disebabkan oleh ekspresi reguler yang tidak valid dalam filter. Perbaiki ekspresi tersebut berdasarkan detail dalam pesan error. |
INPUT_CANAL_ALARM | Terjadi error runtime dalam binary logging MySQL. | Atasi masalah berdasarkan detail dalam pesan error. Layanan canal mungkin restart saat konfigurasi diperbarui. Abaikan error yang disebabkan oleh restart layanan. |
CANAL_INVALID_ALARM | Status internal binary logging MySQL abnormal. | Error ini biasanya terjadi ketika perubahan skema tabel selama runtime menyebabkan ketidakkonsistenan metadata. Konfirmasi apakah skema tabel dimodifikasi saat error dilaporkan. |
MYSQL_INIT_ALARM | Terjadi error selama inisialisasi MySQL. | Atasi error berdasarkan detail dalam pesan error. |
MYSQL_CHECKPOINT_ALARM | Format checkpoint MySQL abnormal. | Konfirmasi apakah pengaturan terkait checkpoint dalam konfigurasi ini telah dimodifikasi. |
MYSQL_TIMEOUT_ALARM | Kueri MySQL timeout. | Konfirmasi bahwa server dan jaringan MySQL berfungsi normal. |
MYSQL_PARSE_ALARM | Gagal mengurai hasil kueri MySQL. | Konfirmasi bahwa format checkpoint dalam konfigurasi MySQL sesuai dengan format field yang sesuai. |
AGGREGATOR_ADD_ALARM | Gagal menambahkan data ke antrian. | Error ini menunjukkan bahwa data dikirim terlalu cepat. Abaikan error ini jika volume data aktual besar. |
ANCHOR_FIND_ALARM | Terjadi error di plugin processor_anchor. Hal ini dapat disebabkan oleh konfigurasi yang salah atau log yang tidak sesuai dengan konfigurasi. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut. Periksa konfigurasi Anda berdasarkan detail subtipe spesifik.
|
ANCHOR_JSON_ALARM | Terjadi error di plugin processor_anchor saat memperluas konten JSON yang ditentukan oleh parameter Start dan Stop. | Klik tautan error untuk melihat pesan error detail. Periksa konten yang sedang diproses dan konfigurasi terkait untuk mengidentifikasi kesalahan konfigurasi atau menemukan log yang tidak valid. |
CANAL_RUNTIME_ALARM | Terjadi error runtime di plugin binary logging. | Klik tautan error untuk melihat pesan error detail dan atasi masalah. Error ini biasanya terkait dengan instance MySQL primer yang terhubung. |
CHECKPOINT_INVALID_ALARM | Gagal mengurai checkpoint. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan kunci checkpoint, konten checkpoint (1024 byte pertama), dan pesan error spesifik. |
DIR_EXCEED_LIMIT_ALARM | Jumlah direktori yang didengarkan Logtail secara bersamaan melebihi batas. | Periksa apakah konfigurasi pengumpulan untuk logstore saat ini dan konfigurasi lain yang diterapkan ke Logtail melibatkan banyak direktori. Atur direktori root yang sesuai untuk pemantauan dan tentukan kedalaman pemantauan maksimum untuk subdirektori. |
DOCKER_FILE_MAPPING_ALARM | Logtail gagal menambahkan pemetaan file Docker dengan menjalankan perintah. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan perintah dan pesan error spesifik. |
DOCKER_FILE_MATCH_ALARM | File yang ditentukan tidak ditemukan di kontainer Docker. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan informasi kontainer dan path file yang dicari. |
DOCKER_REGEX_COMPILE_ALARM | Terjadi error di plugin service_docker_stdout. Plugin gagal mengompilasi BeginLineRegex dari konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa apakah ekspresi reguler sudah benar. |
DOCKER_STDOUT_INIT_ALARM | Plugin service_docker_stdout gagal diinisialisasi. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut.
|
DOCKER_STDOUT_START_ALARM | Ukuran stdout melebihi batas selama pengumpulan oleh plugin service_docker_stdout. | Error ini biasanya terjadi jika data stdout sudah ada selama pengumpulan pertama. Abaikan error ini. |
DOCKER_STDOUT_STAT_ALARM | Plugin service_docker_stdout tidak dapat mendeteksi stdout. | Error ini biasanya terjadi karena stdout tidak dapat diakses saat kontainer keluar. Abaikan error ini. |
FILE_READER_EXCEED_ALARM | Jumlah objek file yang dibuka Logtail secara bersamaan melebihi batas. | Error ini biasanya terjadi karena terlalu banyak file dikumpulkan secara bersamaan. Periksa apakah konfigurasi pengumpulan sudah masuk akal. |
GEOIP_ALARM | Terjadi error di plugin processor_geoip. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut.
|
HTTP_INIT_ALARM | Terjadi error di plugin metric_http. Ekspresi reguler ResponseStringMatch yang ditentukan dalam konfigurasi gagal dikompilasi. | Klik tautan error untuk melihat pesan error detail. Periksa apakah ekspresi reguler sudah benar. |
HTTP_PARSE_ALARM | Terjadi error di plugin metric_http. Plugin gagal mengambil respons HTTP. | Klik tautan error untuk melihat pesan error detail. Periksa konten konfigurasi atau server HTTP yang diminta berdasarkan pesan error spesifik. |
INIT_CHECKPOINT_ALARM | Terjadi error di plugin binary logging. Plugin gagal memuat file checkpoint. Plugin mengabaikan checkpoint dan mulai memproses dari awal. | Klik tautan error untuk melihat pesan error detail. Tentukan apakah error ini dapat diabaikan berdasarkan informasi error spesifik. |
LOAD_LOCAL_EVENT_ALARM | Logtail sedang menangani event lokal. | Peringatan ini jarang terjadi. Jika tidak disebabkan oleh operasi manual, Anda harus mengatasi masalahnya. Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan nama file, nama konfigurasi, proyek, dan logstore. |
LOG_REGEX_FIND_ALARM | Terjadi error di plugin processor_split_log_regex dan processor_split_log_string. SplitKey yang ditentukan dalam konfigurasi tidak ditemukan di log. | Klik tautan error untuk melihat pesan error detail dan periksa kesalahan konfigurasi. |
LUMBER_CONNECTION_ALARM | Terjadi error di plugin service_lumberjack. Server dimatikan saat plugin berhenti. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan informasi error spesifik. Anda biasanya dapat mengabaikan error ini. |
LUMBER_LISTEN_ALARM | Terjadi error di plugin service_lumberjack selama inisialisasi pendengar. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut.
|
LZ4_COMPRESS_FAIL_ALARM | Terjadi error saat Logtail melakukan kompresi LZ4. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan nilai baris log, proyek, kategori, dan wilayah. |
MYSQL_CHECKPOINT_ALARM | Terjadi error di plugin MySQL terkait checkpoint. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut.
|
NGINX_STATUS_COLLECT_ALARM | Terjadi error di plugin nginx_status saat mengambil status. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan URL dan informasi error spesifik. |
NGINX_STATUS_INIT_ALARM | Terjadi error di plugin nginx_status. Plugin gagal menginisialisasi dan mengurai URL yang ditentukan dalam konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa apakah URL dikonfigurasi dengan benar. |
OPEN_FILE_LIMIT_ALARM | Jumlah file yang dibuka Logtail melebihi batas, dan tidak ada file baru yang dapat dibuka. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan path file log, proyek, dan logstore. |
OPEN_LOGFILE_FAIL_ALARM | Terjadi error saat Logtail mencoba membuka file. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan path file log, proyek, dan logstore. |
PARSE_DOCKER_LINE_ALARM | Terjadi error di plugin service_docker_stdout. Plugin gagal mengurai log. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut.
|
PLUGIN_ALARM | Terjadi error selama inisialisasi plugin dan panggilan terkait. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut. Atasi masalah berdasarkan detail error spesifik.
|
PROCESSOR_INIT_ALARM | Terjadi error di plugin processor_regex. Plugin gagal mengompilasi ekspresi reguler Regex yang ditentukan dalam konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa apakah ekspresi reguler sudah benar. |
PROCESS_TOO_SLOW_ALARM | Logtail mengurai log terlalu lambat. |
|
REDIS_PARSE_ADDRESS_ALARM | Terjadi error di plugin Redis. Plugin gagal mengurai ServerUrls yang disediakan dalam konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa URL tempat error dilaporkan. |
REGEX_FIND_ALARM | Terjadi error di plugin processor_regex. Plugin tidak dapat menemukan field yang ditentukan oleh SourceKey dalam konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa konfigurasi SourceKey yang salah atau log yang tidak valid. |
REGEX_UNMATCHED_ALARM | Terjadi error di plugin processor_regex. Kegagalan kecocokan. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut. Atasi masalah berdasarkan informasi error spesifik.
|
SAME_CONFIG_ALARM | Konfigurasi dengan nama yang sama sudah ada untuk logstore. Konfigurasi yang ditemukan kemudian dibuang. | Klik tautan error untuk melihat pesan error detail. Periksa kesalahan konfigurasi berdasarkan path konfigurasi dan informasi lainnya. |
SPLIT_FIND_ALARM | Terjadi error di plugin split_char dan split_string. Plugin tidak dapat menemukan field yang ditentukan oleh SourceKey dalam konfigurasi. | Klik tautan error untuk melihat pesan error detail. Periksa konfigurasi SourceKey yang salah atau log yang tidak valid. |
SPLIT_LOG_ALARM | Terjadi error di plugin processor_split_char dan processor_split_string. Jumlah field yang diurai berbeda dari jumlah yang ditentukan dalam SplitKeys. | Klik tautan error untuk melihat pesan error detail. Periksa konfigurasi SourceKey yang salah atau log yang tidak valid. |
STAT_FILE_ALARM | Terjadi error saat mengumpulkan data dari file menggunakan objek LogFileReader. | Klik tautan error untuk melihat pesan error detail. Atasi masalah berdasarkan path file dan informasi error. |
SERVICE_SYSLOG_INIT_ALARM | Terjadi error di plugin service_syslog. Plugin gagal diinisialisasi. | Klik tautan error untuk melihat pesan error detail. Periksa apakah parameter Address dalam konfigurasi sudah benar. |
SERVICE_SYSLOG_STREAM_ALARM | Terjadi error di plugin service_syslog selama pengumpulan data melalui TCP. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut. Atasi masalah berdasarkan detail error spesifik.
|
SERVICE_SYSLOG_PACKET_ALARM | Terjadi error di plugin service_syslog selama pengumpulan data melalui UDP. | Klik tautan error untuk melihat pesan error detail. Error ini memiliki subtipe berikut. Atasi masalah berdasarkan detail error spesifik.
|
PARSE_TIME_FAIL_ALARM | Plugin gagal mengurai waktu log. | Identifikasi dan atasi masalah dengan salah satu cara berikut:
|
Pemantauan Aplikasi
Mengapa tidak ada data pemantauan setelah saya menginstal probe untuk aplikasi di kluster ACK?
Penyebab
Pemantauan aplikasi dijeda.
Agen ARMS tidak dimuat sebagaimana mestinya di pod tempat aplikasi berada.
Solusi
Periksa apakah pemantauan aplikasi dijeda.
-
Login ke Konsol ARMS. Di panel navigasi kiri, pilih .
-
Di halaman Application List, pilih wilayah Anda di bagian atas, lalu klik nama aplikasi Anda.
Jika aplikasi Anda tidak ditemukan, lanjutkan ke Langkah 2.
-
Untuk konsol baru: Di bilah navigasi atas, pilih . Di bagian Pengaturan Saklar Probe, periksa status saklar Jeda Pemantauan Aplikasi.
-
Jika tombol Pause Application Monitoring aktif, nonaktifkan lalu klik Save.
-
Jika saklar Jeda Pemantauan Aplikasi nonaktif, lanjutkan ke Langkah 2.
-
-
Untuk konsol lama: Di panel navigasi kiri, klik Application Settings, lalu klik tab Custom Configuration. Di bagian Pengaturan Saklar Agen, periksa apakah Saklar Utama Agen aktif.
-
Jika Saklar Utama Agen nonaktif, aktifkan dan klik Simpan di bagian bawah halaman.
-
Jika Saklar Utama Agen aktif, lanjutkan ke Langkah 2.
-
-
Periksa apakah probe dimuat dengan benar.
-
Login ke Konsol ACK. Di panel navigasi kiri, klik Clusters. Di halaman Kluster, klik nama kluster untuk membuka halaman detail kluster.
-
Di panel navigasi kiri, pilih .
-
Di halaman Pods, pilih namespace aplikasi Anda. Temukan pod target dan klik Edit YAML di kolom Actions.
-
Di dialog Edit YAML, periksa apakah file YAML berisi
initContainers.state: running: startedAt: '2023-01-13T08:50:46Z' hostIP: xxx.xxx.xx.196 initContainerStatuses: - containerID: >- containerd://5d6cff441916ea146f6c9568e86e749817a64f212405349b5edc580991fb3195 image: >- registry-vpc.cn-hangzhou.aliyuncs.com/ack-onepilot/ack-onepilot-init:3.0.6 imageID: >- registry-vpc.cn-hangzhou.aliyuncs.com/ack-onepilot/ack-onepilot-init@sha256:93fe036b4c3dda4d4db3bc90de1e00972199a371ada31d1818b3395ecae8a145 lastState: {} name: one-pilot-initcontainer ready: true restartCount: 0 state: terminated: containerID: >- containerd://5d6cff441916ea146f6c9568e86e749817a64f212405349b5edc580991fb3195 exitCode: 0 finishedAt: '2023-01-13T08:50:45Z' reason: Completed startedAt: '2023-01-13T08:50:31Z' phase: Running podIP: xxx.xxx.xx.241 podIPs: - ip: xxx.xxx.xx.241 qosClass: Guaranteed startTime: '2023-01-13T08:50:30Z' -
Di halaman , pilih namespace ack-onepilot. Verifikasi bahwa pod dengan awalan ack-onepilot ada dan semua pod ack-onepilot telah menyelesaikan pembaruan bergulirnya.
-
Jika pod dengan awalan ada, lanjutkan ke Langkah 6.
-
Jika pod dengan awalan tidak ada, instal
ack-onepilotdari pasar aplikasi. Untuk petunjuknya, lihat Cara menguninstall arms-pilot dan menginstal ack-onepilot.
-
-
Di halaman Workloads, buka halaman Deployments atau StatefulSets. Temukan aplikasi Anda, lalu di kolom Actions, pilih
 > Edit YAML. Di dialog Edit YAML, periksa label berikut di bawah
spec.template.metadata.labels: armsPilotAutoEnable: "on" armsPilotCreateAppName: "<your-deployment-name>" # Ganti <your-deployment-name> dengan nama aplikasi sebenarnya. armsSecAutoEnable: "on" # Jika Anda ingin menghubungkan aplikasi ke Keamanan Aplikasi, Anda harus mengonfigurasi parameter ini.-
Jika label ada, lanjutkan ke Langkah 7.
-
Jika label tidak ada, tambahkan di bawah path spec.template.metadata di dialog Edit YAML dan klik Update.
-
-
Di halaman , pilih namespace ack-onepilot. Temukan pod dengan awalan ack-onepilot, lalu di kolom Actions, pilih . Periksa log untuk error STS, yang ditunjukkan oleh pesan
"Message":"STS error".-
Jika error STS dilaporkan, otorisasi kluster aplikasi Anda dan restart pod aplikasi. Untuk petunjuknya, lihat Otorisasi Container Service for Kubernetes.
-
Jika tidak ada error STS yang dilaporkan, kirim tiket.
-
-
Di halaman , temukan pod target dan klik Edit YAML di kolom Actions. Di dialog Edit YAML, periksa apakah file YAML berisi parameter
javaagentberikut.-javaagent:/home/admin/.opt/ArmsAgent/aliyun-java-agent.jarCatatanJika Anda menggunakan agen versi sebelum 2.7.3.5, ganti
aliyun-java-agent.jardenganarms-bootstrap-1.7.0-SNAPSHOT.jar. Kami menyarankan meningkatkan agen ke versi terbaru.-
Jika tersedia, di halaman Pod, klik Terminal di sisi kanan untuk membuka halaman Command Line, jalankan perintah berikut untuk memeriksa file
.log, lalu kirim tiket.cd /home/admin/.opt/ArmsAgent/logs -
Jika parameter tidak ada, kirim tiket.
-
-
Token ARMS Addon tidak ada di kluster
Gejala
Token ARMS Addon tidak ada di kluster target.
-
Login ke Konsol ACK. Di panel navigasi kiri, klik Clusters. Di halaman Kluster, klik nama kluster untuk membuka halaman detail kluster.
-
Di panel navigasi kiri, pilih .
-
Di bagian atas halaman, pilih kube-system dari daftar drop-down Namespace untuk memeriksa apakah addon.arms.token diaktifkan.

Solusi
Berikan izin akses Container Service for Kubernetes ke sumber daya ARMS.
Mengapa data pemantauan menjadi abnormal setelah aplikasi dipindahkan ke kluster atau namespace berbeda?
Gejala
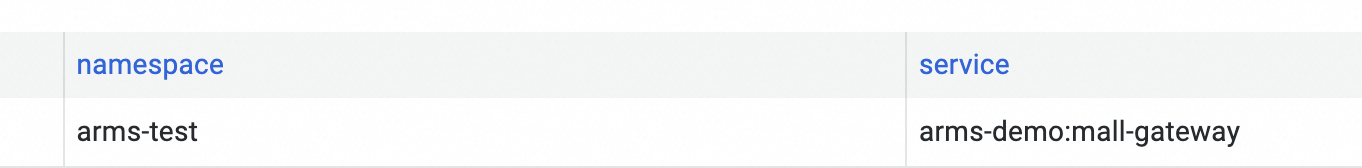
Nilai yang ditampilkan di kolom namespace pada dasbor kustom tidak diperbarui setelah Anda mengubah namespace aplikasi Anda.
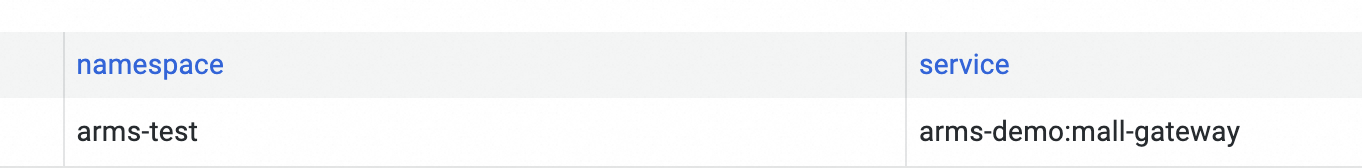
Setelah Anda mengubah kluster aplikasi, data untuk metrik rate, errors, dan duration (RED) ditampilkan normal, tetapi tidak ada data yang ditampilkan untuk metrik pemantauan kontainer, seperti CPU dan memori.
Kemungkinan penyebab
Parameter terkait kontainer, seperti Namespace dan ClusterId, dikonfigurasi saat aplikasi dibuat dan nilainya tidak dapat diperbarui secara otomatis. Jika Anda mengubah kluster atau namespace aplikasi, data terkait kontainer mungkin gagal diambil atau ditampilkan.
Solusi
Hapus aplikasi, buat ulang aplikasi, lalu laporkan data pemantauan lagi. Untuk informasi lebih lanjut, lihat Hapus aplikasi.
Metode ini menyebabkan kehilangan data historis.
Kirim tiket.
Bagaimana cara menyesuaikan path mount untuk probe Java?
Latar Belakang
Umumnya, add-on ack-onepilot menentukan path mount untuk agen Application Real-Time Monitoring Service (ARMS) untuk Java dengan menyuntikkan variabel lingkungan JAVA_TOOL_OPTIONS. Namun, Anda mungkin perlu menyesuaikan path ini untuk skenario seperti:
Manajemen konfigurasi terpusat
Kelola path mount melalui ConfigMap Kubernetes untuk memastikan konsistensi lingkungan.
Penyimpanan persisten
Simpan file agen di Persistent Volume Claim (PVC) kustom untuk memenuhi persyaratan keamanan atau O&M perusahaan.
Solusi
Untuk menyesuaikan path mount untuk agen ARMS untuk Java, persyaratan versi berikut harus dipenuhi:
ack-onepilot: V4.1.0 atau lebih baru.
Catatan rilis untuk agen Java: V4.2.2 atau lebih baru. Anda dapat Mengontrol versi agen ARMS.
Konfigurasi ini juga berlaku untuk Microservice Engine (MSE) karena integrasi ack-onepilot yang sama.
Tambahkan anotasi
disableJavaToolOptionsInjectionke workload Kubernetes, seperti deployment, yang memerlukan path mount kustom.Add-on ack-onepilot tidak akan secara otomatis mengatur path mount atau parameter JVM lainnya menggunakan variabel lingkungan
JAVA_TOOL_OPTIONS.Untuk melihat file YAML deployment, jalankan perintah berikut:
kubectl get deployment {Nama Deployment} -o yamlCatatanJika Anda tidak yakin tentang nama deployment, jalankan perintah berikut untuk mencantumkan semua deployment:
kubectl get deployments --all-namespaceKemudian, temukan yang Anda inginkan di hasilnya dan lihat file YAML-nya.
Jalankan perintah berikut untuk mengedit file YAML:
kubectl edit deployment {Nama Deployment} -o yamlDi file YAML, tambahkan label berikut ke
spec.template.metadata:labels: armsPilotAutoEnable: "on" armsPilotCreateAppName: "<your-deployment-name>" # Nama deployment Anda. disableJavaToolOptionsInjection: "true" # Jika Anda ingin menyesuaikan path mount untuk agen ARMS untuk Java, atur parameter ini ke true.
Ganti path mount default
/home/admin/.opt/AliyunJavaAgent/aliyun-java-agent.jardi skrip atau perintah startup Java Anda dengan path kustom Anda:java -javaagent:/home/admin/.opt/AliyunJavaAgent/aliyun-java-agent.jar ... ... -jar xxx.jarInformasi lain seperti wilayah pelaporan dan kunci lisensi disediakan oleh ack-onepilot melalui variabel lingkungan.
Bagaimana cara melaporkan data dari kluster ACK lintas wilayah?
Gejala
Bagaimana cara melaporkan data dari Wilayah A ke Wilayah B?
Solusi
Perbarui add-on ack-onepilot ke V4.0.0 atau lebih baru.
Tambahkan variabel lingkungan ARMS_REPORT_REGION ke aplikasi ack-onepilot-ack-onepilot di namespace ack-onepilot. Nilainya harus berupa ID wilayah tempat ARMS tersedia. Contoh: cn-hangzhou atau cn-beijing.
Restart aplikasi yang ada atau terapkan aplikasi baru untuk melaporkan data lintas wilayah.
CatatanSetelah variabel lingkungan ditambahkan, semua aplikasi yang diterapkan di kluster melaporkan data ke wilayah yang ditentukan pada langkah sebelumnya.
Bagaimana cara menguninstall arms-pilot dan menginstal ack-onepilot?
Latar Belakang
Komponen pemantauan aplikasi lawas arms-pilot tidak lagi dipelihara. Anda dapat menginstal komponen ack-onepilot yang ditingkatkan untuk memantau aplikasi Anda. ack-onepilot sepenuhnya kompatibel dengan arms-pilot, memungkinkan migrasi mulus tanpa mengubah konfigurasi aplikasi Anda. Topik ini menjelaskan cara menguninstall arms-pilot dan menginstal ack-onepilot.
Solusi
Anda harus menginstal ack-onepilot di kluster ACK V1.16 atau lebih baru. Jika kluster Anda lebih lama dari V1.16, tingkatkan kluster terlebih dahulu. Untuk informasi lebih lanjut, lihat Tingkatkan kluster secara manual.
Anda harus menguninstall arms-pilot sebelum menginstal ack-onepilot. Jika Anda memiliki keduanya ack-onepilot dan arms-pilot terinstal, agen ARMS tidak dapat dimount. Jika arms-pilot tidak sepenuhnya diuninstall, ack-onepilot tidak berfungsi karena menganggap arms-pilot masih bekerja di lingkungan tersebut.
Saat Anda menguninstall arms-pilot dan menginstal ack-onepilot, konfigurasi arms-pilot tidak dapat disinkronkan secara otomatis ke ack-onepilot. Kami menyarankan Anda mencatat konfigurasi tersebut lalu mengonfigurasi ack-onepilot secara manual.
Uninstall arms-pilot.
Login ke Konsol ACK. Di halaman Clusters, klik nama kluster.
Di panel navigasi kiri, pilih .
Di halaman Helm, temukan arms-pilot dan klik Delete di kolom Actions.
Di pesan Delete, klik OK.
Periksa apakah arms-pilot telah diuninstall.
Buka halaman detail kluster di Konsol ACK. Di panel navigasi kiri, pilih . Di halaman Deployments, pilih arms-pilot dari daftar drop-down Namespace, dan periksa apakah pod namespace tersebut dihapus seperti yang diharapkan.
CatatanJika Anda telah mengubah namespace tempat arms-pilot berada, pilih namespace baru tersebut.
Instal ack-onepilot.
Login ke Konsol ACK. Di halaman Clusters, klik nama kluster.
Di panel navigasi kiri, klik . Di halaman Add-ons, cari ack-onepilot.
Klik Install pada kartu ack-onepilot.
Catatan
Secara default, add-on ack-onepilot mendukung 1.000 pod. Untuk setiap tambahan 1.000 pod di kluster, Anda harus menambahkan 0,5 core CPU dan 512 MB memori untuk komponen tersebut.
Di dialog yang muncul, konfigurasikan parameter dan klik OK. Kami menyarankan Anda menggunakan nilai default.
Catatan
Setelah Anda menginstal ack-onepilot, Anda dapat meningkatkan, mengonfigurasi, atau menguninstallnya di halaman Add-ons.
Periksa apakah ack-onepilot telah diinstal.
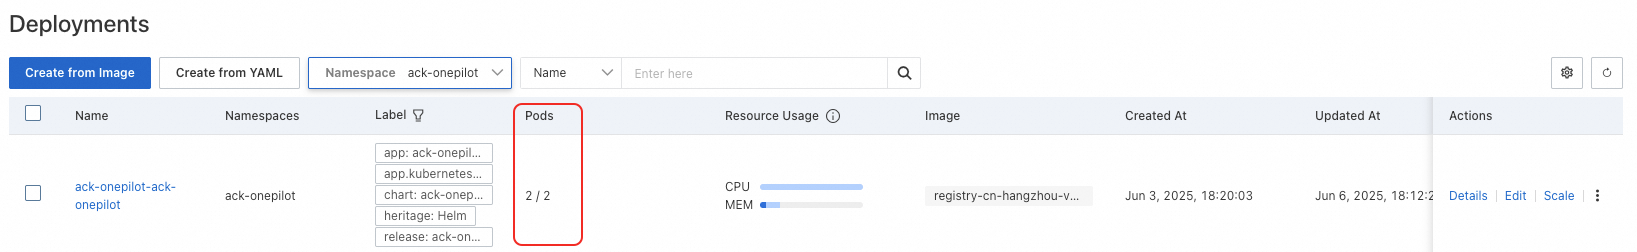
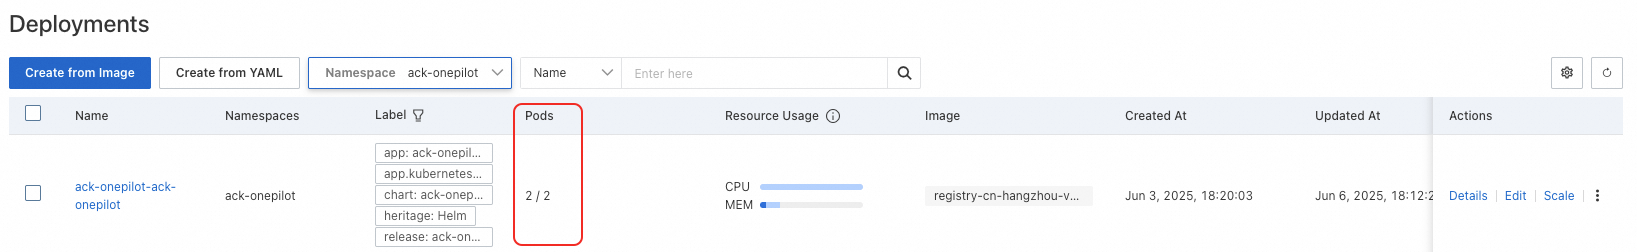
Buka halaman detail kluster di Konsol ACK. Di panel navigasi kiri, pilih . Di halaman Deployments, pilih ack-onepilot dari daftar drop-down Namespace, dan periksa apakah pod namespace tersebut berjalan seperti yang diharapkan.
Managed Service for Prometheus
Halaman pemantauan Prometheus menampilkan "No related dashboard found"
Gejala
Jika Anda melihat prompt No related monitoring dashboard found di halaman setelah mengaktifkan pemantauan Prometheus, ikuti langkah-langkah berikut untuk mengatasi masalah.
Solusi
Instal ulang add-on pemantauan Prometheus.
Instal ulang komponen:
Setelah mengonfirmasi bahwa komponen telah diuninstall, klik Install. Di dialog konfirmasi, klik OK.
Setelah instalasi selesai, kembali ke halaman Pemantauan Prometheus untuk memeriksa apakah masalah telah teratasi.
Jika masalah masih berlanjut, lanjutkan dengan langkah-langkah berikut.
Periksa integrasi instans Prometheus.
Di panel navigasi kiri Konsol ARMS, klik Integration Management.
Pada tab Integrations, periksa daftar Container Service untuk menemukan lingkungan kontainer yang namanya sama dengan kluster Anda.
Jika tidak ada lingkungan kontainer seperti itu, lihat Integrasikan layanan di konsol ARMS atau Prometheus.
Jika ada lingkungan kontainer seperti itu, klik Settings di kolom Actions lingkungan kontainer target untuk membuka halaman Settings.
Periksa apakah agen yang diinstal berjalan seperti yang diharapkan.
Mengapa data tidak ditampilkan di Managed Service for Prometheus?
Penyebab
Data mungkin tidak ditampilkan di Managed Service for Prometheus karena tugas sinkronisasi dengan layanan Prometheus Alibaba Cloud gagal—yang menyebabkan kegagalan pendaftaran sumber daya—atau karena instans Prometheus tidak disediakan dengan benar. Ikuti proses berikut untuk memeriksa dan mengatasi masalah.
Solusi
Periksa status tugas penyediaan untuk Managed Service for Prometheus.
-
Login ke Konsol ACK. Di panel navigasi kiri, klik Clusters.
-
Di halaman Clusters, klik nama kluster Anda. Di panel navigasi kiri, klik .
Di halaman Jobs, atur Namespace ke arms-prom di bagian atas halaman, lalu klik o11y-init-environment untuk memverifikasi bahwa job berhasil.
Jika tidak berhasil, kemungkinan besar disebabkan oleh kegagalan sinkronisasi dengan layanan Prometheus Alibaba Cloud dan pendaftaran sumber daya. Anda dapat melihat log pod-nya untuk menemukan alasan spesifik kegagalannya. Untuk informasi lebih lanjut, lihat Atasi exception pod.
Jika pod tersebut sudah tidak ada, lanjutkan dengan langkah-langkah berikut.
-
Instal ulang add-on pemantauan Prometheus.
Instal ulang komponen:
Setelah mengonfirmasi bahwa komponen telah diuninstall, klik Install. Di dialog konfirmasi, klik OK.
Setelah instalasi selesai, kembali ke halaman Pemantauan Prometheus untuk memeriksa apakah masalah telah teratasi.
Jika masalah masih berlanjut, lanjutkan dengan langkah-langkah berikut.
Periksa penyediaan instans Prometheus.
Di panel navigasi kiri Konsol ARMS, klik Integration Management.
Di tab Integrasi, periksa daftar Container Service untuk lingkungan kontainer dengan nama yang sama dengan kluster Anda.
Jika tidak ada lingkungan kontainer seperti itu, lihat Integrasikan layanan di konsol ARMS atau Prometheus.
Jika ada lingkungan kontainer seperti itu, klik Settings di kolom Actions lingkungan kontainer target untuk membuka halaman Settings.
Periksa apakah agen yang diinstal berjalan seperti yang diharapkan.
Managed Service for Prometheus gagal diinstal ulang dan muncul pesan error "rendered manifests contain a resource that already exists"
Gejala
Saat menguninstall dan menginstal ulang agen Prometheus, muncul pesan error berikut:
rendered manifests contain a resource that already exists. Unable to continue with install: existing resource conflict: kind: ClusterRole, namespace: , name: arms-pilot-prom-k8srendered manifests contain a resource that already exists. Unable to continue with install: existing resource conflict: kind: ClusterRole, namespace: , name: arms-pilot-prom-k8sPenyebab
Setelah menjalankan perintah untuk menguninstall agen Prometheus secara manual, sumber daya seperti role mungkin tidak terhapus.
Solusi
Jalankan perintah berikut untuk menemukan ClusterRole agen Prometheus:
kubectl get ClusterRoles --all-namespaces | grep promJalankan perintah berikut untuk menghapus ClusterRole yang ditemukan pada langkah sebelumnya:
kubectl delete ClusterRole [$Cluster_Roles] -n arms-promCatatanParameter [$Cluster_Roles] menentukan ClusterRole yang ditemukan pada langkah sebelumnya.
Jika masalah masih berlanjut setelah menghapus ClusterRole, periksa nilai kind dalam pesan error untuk memastikan tidak ada sumber daya lain selain ClusterRole. Lakukan langkah serupa untuk menghapusnya secara berurutan.
How do I view the version of the ack-arms-prometheus add-on?
Latar Belakang
Anda perlu memeriksa versi add-on ack-arms-prometheus yang diterapkan di kluster Anda dan menentukan apakah perlu diperbarui.
Solusi
Mengapa saya tidak dapat menerapkan pemantauan GPU?
Penyebab
Solusi
Bagaimana cara menguninstall ARMS-Prometheus sepenuhnya untuk menghindari kegagalan instalasi ulang?
Latar Belakang
Solusi
Terjadi error "xxx in use" saat menginstal add-on ack-arms-prometheus
Penyebab
Saat menerapkan add-on ack-arms-prometheus, muncul error "xxx in use". Hal ini kemungkinan disebabkan oleh sumber daya yang sedang digunakan atau sisa sumber daya, sehingga instalasi add-on gagal.
Solusi
Di halaman Kluster, klik nama kluster target. Di panel navigasi kiri, pilih .
Di halaman Helm, periksa apakah ack-arms-prometheus ada.
Jika ada, hapus ack-arms-prometheus dari halaman Helm dan instal ulang di halaman Add-ons. Untuk informasi lebih lanjut tentang cara menginstal ack-arms-prometheus, lihat Kelola komponen.
Jika tidak ada:
Rilis Helm ack-arms-prometheus mungkin memiliki sumber daya sisa. Uninstall ARMS Prometheus secara manual sepenuhnya.
Add-on ack-arms-prometheus gagal diinstal setelah muncul pesan "Component Not Installed"
Gejala
Saat mencoba menginstal add-on ack-arms-prometheus, muncul pesan "Component Not Installed" terlebih dahulu, dan instalasi tetap gagal pada percobaan kedua.
Solusi
Periksa apakah add-on ack-arms-prometheus telah diinstal.
Di halaman Kluster, klik nama kluster target. Di panel navigasi kiri, pilih .
Di halaman Helm, periksa apakah ack-arms-prometheus ada.
Jika ada, hapus ack-arms-prometheus dari halaman Helm dan instal ulang di halaman Add-ons. Untuk informasi lebih lanjut tentang cara menginstal ack-arms-prometheus, lihat Kelola komponen.
Jika tidak ada:
Rilis Helm ack-arms-prometheus mungkin memiliki sumber daya sisa. Uninstall ARMS Prometheus secara manual sepenuhnya.
Periksa log ack-arms-prometheus untuk error.
Di panel navigasi kiri halaman detail kluster, pilih .
Di bagian atas halaman Deployments, atur Namespace ke arms-prom lalu klik arms-prometheus-ack-arms-prometheus.
Klik tab Logs untuk memeriksa error di log.
Periksa apakah terjadi error selama instalasi agen.
Masuk ke atau Konsol ARMS. Di panel navigasi sebelah kiri, klik Integration Management.
Pada tab Integrations, periksa daftar Container Service. Di kolom Actions untuk lingkungan kontainer target, klik Settings guna membuka halaman Settings.
Pemantauan Prometheus open source
Bagaimana cara mengonfigurasi notifikasi peringatan DingTalk?
Gejala
Setelah menerapkan Prometheus open source, Anda perlu mengonfigurasinya untuk mengirim notifikasi peringatan melalui DingTalk.
Solusi
-
Dapatkan URL webhook untuk chatbot DingTalk Anda. Lihat Pemantauan Event.
-
Temukan bidang DingTalk, atur enabled menjadi true, lalu masukkan URL webhook DingTalk di bidang Token. Lihat Configure DingTalk alerts di Konfigurasi Peringatan.
Terjadi error saat menerapkan prometheus-operator
Gejala
Can't install release with errors: rpc error: code = Unknown desc = object is being deleted: customresourcedefinitions.apiextensions.k8s.io "xxxxxxxx.monitoring.coreos.com" already existsSolusi
Error ini terjadi karena CRD dari penerapan sebelumnya tidak dibersihkan. Hapus CRD tersebut, lalu terapkan ulang komponen:
kubectl delete crd prometheuses.monitoring.coreos.com
kubectl delete crd prometheusrules.monitoring.coreos.com
kubectl delete crd servicemonitors.monitoring.coreos.com
kubectl delete crd alertmanagers.monitoring.coreos.com
Peringatan email tidak berfungsi
Gejala
Setelah menerapkan Prometheus open source, notifikasi peringatan melalui email yang telah dikonfigurasi tidak dikirim.
Solusi
Peringatan email mungkin gagal jika Anda memasukkan kata sandi login pada smtp_auth_password alih-alih kode otorisasi. Pastikan alamat server SMTP mencakup nomor port.
Muncul pesan error "The cluster is inaccessible. Try again later or submit a ticket." saat saya mengklik Update YAML
Gejala
Setelah menerapkan Prometheus open source, saat mengklik Update YAML, muncul pesan error: "Kluster saat ini sementara tidak dapat diakses. Silakan coba lagi nanti atau kirim tiket untuk umpan balik."
Solusi
Hal ini terjadi ketika file konfigurasi Tiller terlalu besar sehingga menyebabkan kluster tidak dapat diakses. Kurangi ukuran file dengan menghapus komentar, lalu pasang sebagai ConfigMap. Prometheus-operator hanya mendukung pemasangan ConfigMap untuk Pod Prometheus dan Alertmanager. Lihat Pasang ConfigMap kustom ke Prometheus.
Bagaimana cara mengaktifkan fitur setelah menerapkan prometheus-operator?
Gejala
Setelah menerapkan Prometheus open source, Anda mungkin perlu melakukan konfigurasi tambahan untuk mengaktifkan fitur-fiturnya.
Solusi
Aktifkan fitur setelah menerapkan prometheus-operator. Di halaman detail kluster, pilih . Temukan ack-prometheus-operator, lalu klik Update di kolom Actions. Pilih fitur yang akan diaktifkan, konfigurasikan, kemudian klik OK.
Bagaimana cara memilih antara TSDB dan disk Alibaba Cloud?
Gejala
Saat memilih solusi penyimpanan, bagaimana cara menentukan pilihan antara TSDB dan disk Alibaba Cloud, serta mengonfigurasi kebijakan retensi data?
Solusi
TSDB tersedia di wilayah yang lebih sedikit dibandingkan disk Alibaba Cloud. Kebijakan retensi data:
## Berapa lama metrik disimpan
##
retention: 10d
Dasbor Grafana tidak ditampilkan dengan benar
Gejala
Setelah menerapkan Prometheus open source, dasbor Grafana tidak ditampilkan secara optimal.
Solusi
Di halaman detail kluster, pilih . Temukan ack-prometheus-operator, lalu klik Update pada kolom Actions. Pastikan nilai clusterVersion sesuai dengan versi kluster Anda: untuk kluster sebelum v1.16, masukkan 1.14.8-aliyun.1; untuk v1.16 atau yang lebih baru, masukkan 1.16.6-aliyun.1.
ack-prometheus-operator gagal diinstal ulang setelah namespace-nya dihapus
Penyebab
Menghapus hanya namespace dapat meninggalkan konfigurasi sisa. Bersihkan sumber daya berikut:
Solusi
-
Hapus izin RBAC.
-
Hapus ClusterRole.
kubectl delete ClusterRole ack-prometheus-operator-grafana-clusterrole kubectl delete ClusterRole ack-prometheus-operator-kube-state-metrics kubectl delete ClusterRole psp-ack-prometheus-operator-kube-state-metrics kubectl delete ClusterRole psp-ack-prometheus-operator-prometheus-node-exporter kubectl delete ClusterRole ack-prometheus-operator-operator kubectl delete ClusterRole ack-prometheus-operator-operator-psp kubectl delete ClusterRole ack-prometheus-operator-prometheus kubectl delete ClusterRole ack-prometheus-operator-prometheus-psp -
Hapus ClusterRoleBinding.
kubectl delete ClusterRoleBinding ack-prometheus-operator-grafana-clusterrolebinding
kubectl delete ClusterRoleBinding ack-prometheus-operator-kube-state-metrics
kubectl delete ClusterRoleBinding psp-ack-prometheus-operator-kube-state-metrics
kubectl delete ClusterRoleBinding psp-ack-prometheus-operator-prometheus-node-exporter
kubectl delete ClusterRoleBinding ack-prometheus-operator-operator
kubectl delete ClusterRoleBinding ack-prometheus-operator-operator-psp
kubectl delete ClusterRoleBinding ack-prometheus-operator-prometheus
kubectl delete ClusterRoleBinding ack-prometheus-operator-prometheus-psp
-
-
Hapus CRD.
kubectl delete crd alertmanagerconfigs.monitoring.coreos.com
kubectl delete crd alertmanagers.monitoring.coreos.com
kubectl delete crd podmonitors.monitoring.coreos.com
kubectl delete crd probes.monitoring.coreos.com
kubectl delete crd prometheuses.monitoring.coreos.com
kubectl delete crd prometheusrules.monitoring.coreos.com
kubectl delete crd servicemonitors.monitoring.coreos.com
kubectl delete crd thanosrulers.monitoring.coreos.com
Manajemen peringatan
Aturan peringatan gagal disinkronkan dan muncul pesan error "The Project does not exist : k8s-log-xxx"
Gejala
Di Pusat Peringatan, status sinkronisasi aturan peringatan menampilkan pesan The Project does not exist : k8s-log-xxx.
Penyebab
Sumber daya Pusat Event SLS belum dibuat.
Solusi
Di Konsol Simple Log Service, periksa apakah batas kuota telah tercapai. Untuk informasi lebih lanjut tentang sumber daya, lihat Batas sumber daya dasar.
Jika batas kuota telah tercapai, hapus proyek yang tidak diperlukan atau kirim tiket untuk mengajukan peningkatan batas kuota sumber daya proyek. Untuk informasi tentang cara menghapus proyek, lihat Kelola proyek.
Jika batas belum tercapai, lanjutkan ke langkah berikutnya.
Instal ulang add-on ack-node-problem-detector.
Penginstalan ulang komponen ini akan membuat kembali proyek default bernama k8s-log-xxxxxx.
Uninstall add-on ack-node-problem-detector.
Di halaman manajemen kluster target di Konsol Container Service for Kubernetes, pada panel navigasi kiri, pilih .
Klik tab Logs and Monitoring. Lalu, klik Uninstall pada kartu komponen ack-node-problem-detector dan klik Confirm di dialog konfirmasi.
Setelah proses uninstall selesai, instal kembali add-on ack-node-problem-detector.
Pada panel navigasi kiri, pilih
Di halaman Alert Rules, klik Start Installation. Konsol secara otomatis membuat proyek serta menginstal dan memperbarui komponen.
Di halaman Alert Rules, nonaktifkan set aturan peringatan yang sesuai. Tunggu hingga Alert Rule Status berubah menjadi Rule Disabled, lalu aktifkan kembali set aturan tersebut untuk mencoba lagi.
Aturan peringatan gagal disinkronkan dan muncul pesan error this rule have no xxx contact groups reference
Gejala
Aturan peringatan gagal disinkronkan selama konfigurasi atau penerapan, dan sistem menampilkan pesan error seperti this rule have no xxx contact groups reference. Akibatnya, notifikasi untuk aturan peringatan ini tidak dikirimkan.
Penyebab
Sinkronisasi aturan peringatan gagal dengan pesan error seperti this rule have no xxx contact groups reference.
Solusi
Anda telah membuat kontak dan menambahkannya ke kelompok kontak.
Di sebelah kanan set aturan peringatan target, klik Edit Notification Policy untuk mengonfigurasi grup kontak yang berlangganan set aturan peringatan tersebut.
Isu lainnya
Mengapa tidak ada data yang dikembalikan untuk kubectl top pod/node?
Gejala
Saat menjalankan perintah kubectl top pod atau kubectl top node di command line, tidak ada data yang dikembalikan.
Solusi
Jalankan perintah berikut untuk memeriksa apakah API Service metrics-server berjalan normal.
kubectl get apiservices | grep metrics-serverv1beta1.flowcontrol.apiserver.k8s.io Local True 24d v1beta1.metrics.k8s.io kube-system/metrics-server True 24d v1beta1.networking.k8s.io Local True 24d v1beta1.node.k8s.io Local True 24dJika hasil yang dikembalikan untuk
v1beta1.metrics.k8s.iomenunjukkanTrue, API Service metrics-server berfungsi normal.Opsi: Jika API Service metrics-server tidak normal, jalankan perintah berikut di salah satu node kluster untuk memverifikasi apakah port 443 dan 8082 metrics-server dapat diakses secara normal dalam kluster.
curl -v <metrics-server_Pod_IP>:8082/apis/metrics/v1alpha1/nodes

curl -v <metrics-server_Pod_IP>:443/apis/metrics/v1alpha1/nodes
Jika perintah tersebut mengembalikan data normal, maka port 443 dan 8082 metrics-server dapat diakses secara normal dalam kluster.
Opsi: Jika port 443 dan 8082 metrics-server tidak dapat diakses secara normal dalam kluster, restart metrics-server dengan menghapus pod-nya.
Anda dapat merestart metrics-server dengan menghapus pod-nya.
-
Masuk ke Konsol ACK. Di panel navigasi kiri, klik Clusters.
-
Di halaman Clusters, klik nama kluster Anda. Di panel navigasi kiri, klik .
Di bagian atas halaman Stateless, atur Namespace ke `kube-system`, lalu klik `metrics-server`.
Di tab Pods, pada kolom Actions untuk pod metrics-server, pilih More > Delete, lalu klik OK di dialog konfirmasi.
-
Mengapa sebagian data hilang untuk kubectl top pod/node?
Gejala
Saat menjalankan perintah kubectl top pod atau kubectl top node, sebagian data tidak ditampilkan.
Solusi
Lakukan pemeriksaan awal berikut:
Periksa apakah semua pod di node tertentu tidak memiliki data, atau hanya pod tertentu yang tidak memiliki data. Jika semua pod di node tertentu tidak memiliki data, periksa apakah terjadi deviasi zona waktu pada node tersebut. Anda dapat menggunakan perintah
datepada server NTP untuk memverifikasi zona waktu.Periksa konektivitas jaringan dari pod metrics-server ke port 10255 pada node yang bermasalah.
Apa yang harus saya lakukan jika HPA tidak dapat memperoleh data metrik?
Gejala
Saat menggunakan Horizontal Pod Autoscaler (HPA) Kubernetes, Anda mungkin mengalami situasi di mana HPA tidak dapat memperoleh data metrik.
Solusi
Lakukan pemeriksaan awal berikut:
Periksa hasil dari perintah kubectl top pod untuk pod yang relevan. Jika datanya abnormal, rujuk metode pemeriksaan pada bagian Mengapa tidak ada data yang dikembalikan untuk kubectl top pod/node? dan Mengapa sebagian data hilang untuk kubectl top pod/node?.
Mengapa HPA membuat Pod tambahan selama penyebaran bergulir?
Gejala
Selama pembaruan bergulir Kubernetes, Anda mungkin menemukan bahwa Horizontal Pod Autoscaler (HPA) secara tak terduga membuat Pod tambahan.
Solusi
Lakukan pemeriksaan awal berikut:
Periksa apakah metrics-server telah ditingkatkan ke versi terbaru. Jika versinya sudah sesuai, gunakan perintah kubectl edit deployments -n kube-system metrics-server untuk menambahkan parameter startup berikut di bagian command:
--metric-resolution=15s
--enable-hpa-rolling-update-skipped=true