Évaluez les performances de votre flux d'application avant son déploiement en production. LangStudio note les applications selon plusieurs dimensions à l'aide de modèles d'évaluation prédéfinis ou personnalisés.
Présentation
Pour évaluer un flux d'application, configurez un jeu de données d'évaluation, mappez les champs d'entrée et sélectionnez un modèle d'évaluation. Le système traite par lot chaque ligne du jeu de données via votre application, évalue chaque sortie par rapport aux champs auxiliaires et agrège les résultats.

Avant de commencer
Créez et déboguez un flux d'application. Développer un flux d'application.
-
Préparez un jeu de données d'évaluation au format JSONL et chargez-le sur OSS. Exemple :
{"history":[],"query": "Describe the perilous majesty of Mount Hua", "reference": "Mount Hua stands alone, soaring to the clouds; \nSheer cliffs cut the sky, with rugged, handsome crags. \nGreen pines and bamboo vie for beauty on the cliffs; \nMonkeys cry and eagles fly, lit by frosty swords of light. \n\nPerilous peaks like scissors, jagged swords pointing to the sky; \nNarrow paths on steep slopes, where vines are the only way. \nWind and mist intertwine, as clouds emerge from caves; \nA deep fairyland, with a heavenly ladder hard to climb. \n\nJagged ridges cross, like a surging dragon's spine; \nDangerous paths lead onward, twisting toward the heavens. \nFrom lonely pine tops, eagles strike the vast sky; \nAt the summit of Mount Hua, a majestic and heroic sight.", "contexts": ["Mount Hua is one of the Five Great Mountains of China.", "Mount Hua is famous for its precipitous cliffs."]}
{"history":[],"query": "Can you list 5 rare metals? Please rank them by global demand.", "reference": "Rare metals are metallic elements that are scarce in the Earth's crust, unevenly distributed, or difficult to mine. They play a crucial role in high-tech fields and emerging industries. The ranking of global demand can change with time and technological progress, but the following are some rare metals that are typically in high demand. This list is not necessarily ranked by absolute demand, as that can vary at different times.\n\n1. **Cobalt (Co)** - Cobalt is a key component of lithium-ion batteries, especially in electric vehicles and portable electronics. It is also used to manufacture heat-resistant alloys, hard alloys, and catalysts.\n\n2. **Neodymium (Nd)** - Neodymium is a rare-earth metal mainly used to produce strong magnets, such as high-performance permanent magnets. These magnets are widely used in computer hard drives, wind turbines, and the drive motors of electric vehicles.\n\n3. **Lithium (Li)** - Lithium is primarily used to manufacture lithium batteries. As the demand for electric vehicles and portable electronic devices increases, the demand for lithium is rising rapidly.\n\n4. **Silver (Ag)** - Although silver is not as rare as the metals listed above, its industrial demand is huge. It is mainly used in electronics, solar panels, jewelry, and currency manufacturing.\n\n5. **Ruthenium (Ru)** - Ruthenium is a rare precious metal widely used for data storage in hard disk drives and large-capacity servers. It is also used in catalysts and electrochemical cells.\n\nThe demand for these metals is influenced by many factors, such as the global economy, technological development, and policy support. Moreover, as time passes and markets change, other rare metals such as tantalum, indium, rhenium, and other rare-earth metals may also appear on the list of most in-demand rare metals.", "contexts": ["Rare metals are metals with low abundance in the Earth's crust that are complex to mine and extract.", "Lithium (Li): Used in battery manufacturing.", "Cobalt (Co): Used in high-performance alloys and battery manufacturing."]}
Fichier d'exemple : langstudio_eval_demo.jsonl
-
Créez les connexions LLM requises pour l'évaluation. Configuration des connexions.
Remarque : Certains modèles d'évaluation nécessitent un modèle LLM-as-a-Judge. Configurez les connexions LLM correspondantes avant d'utiliser ces modèles.
Facturation
L'évaluation des flux d'application utilise OSS pour le stockage des jeux de données et PAI-DLC pour l'exécution des tâches hors ligne. Ces deux ressources sont facturées. Facturation OSS. Facturation de Deep Learning Containers (DLC).
Créer une tâche d'évaluation
Après avoir débogué votre application, cliquez sur Evaluation dans le coin supérieur droit pour créer une tâche d'évaluation.

Paramètres clés :
|
Paramètre |
Description |
|
Jeu de données d'évaluation |
|
|
Fichier OSS |
Sélectionnez un fichier JSONL depuis OSS comme jeu de données d'évaluation. Le jeu de données doit contenir un champ |
|
Mappage des entrées du flux d'application |
|
|
question/chat_history |
Mappez les champs d'entrée de l'application aux colonnes du jeu de données. Remarque : La tâche d'évaluation exécute votre application pour l'inférence avant d'évaluer les résultats. Sélectionnez les champs d'entrée requis par votre application.
|
|
Configuration de l'évaluation |
|
|
Évaluation par modèle prédéfini |
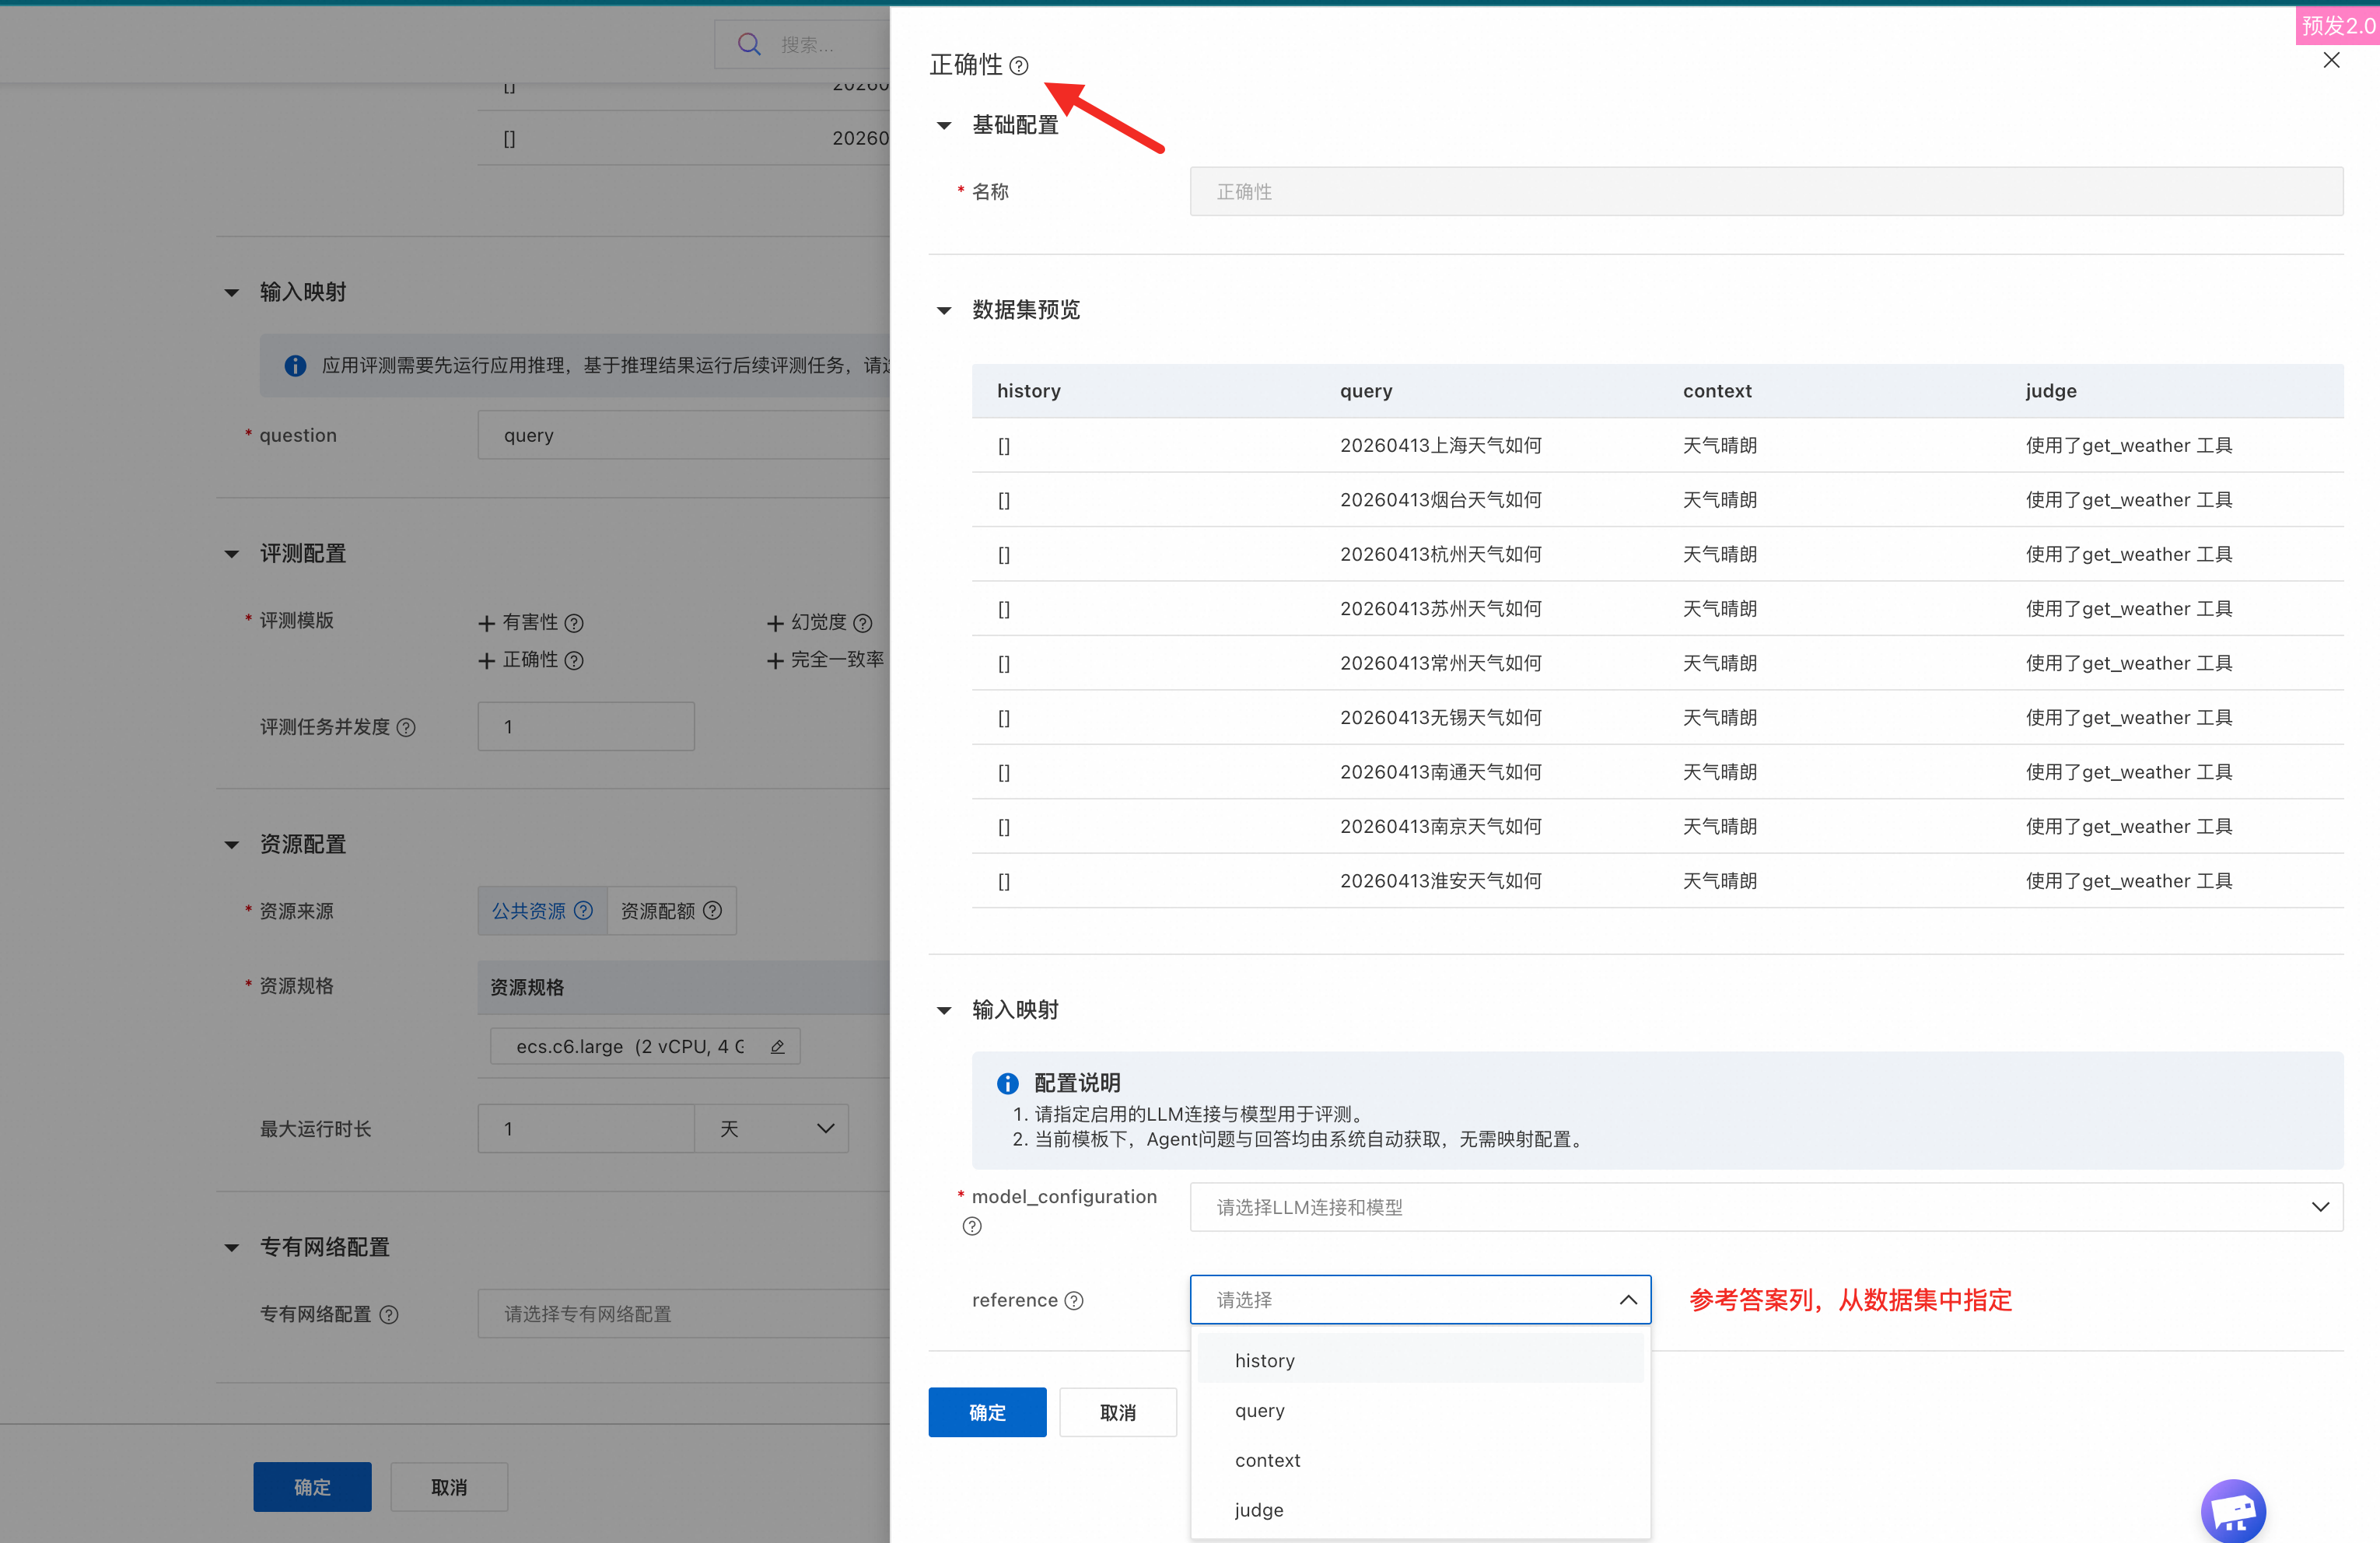
Plusieurs modèles prédéfinis sont disponibles. La sélection de plusieurs modèles agrège les résultats sur la page des détails de la tâche. L'exemple suivant utilise Answer Correctness Evaluation :
Paramètres clés :
|
|
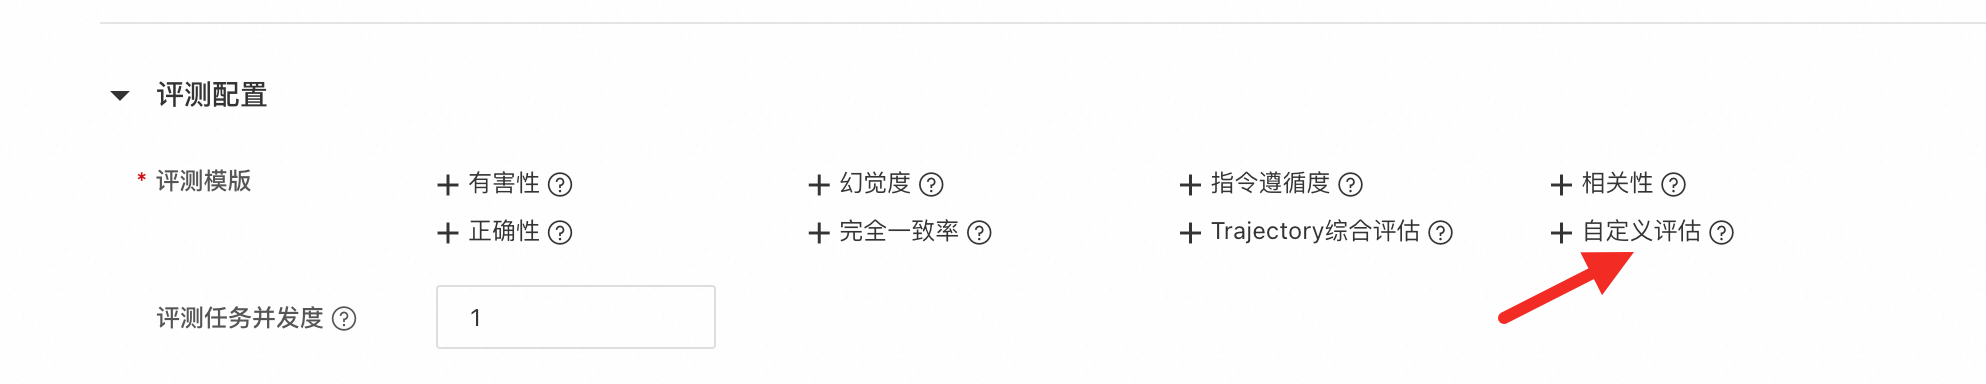
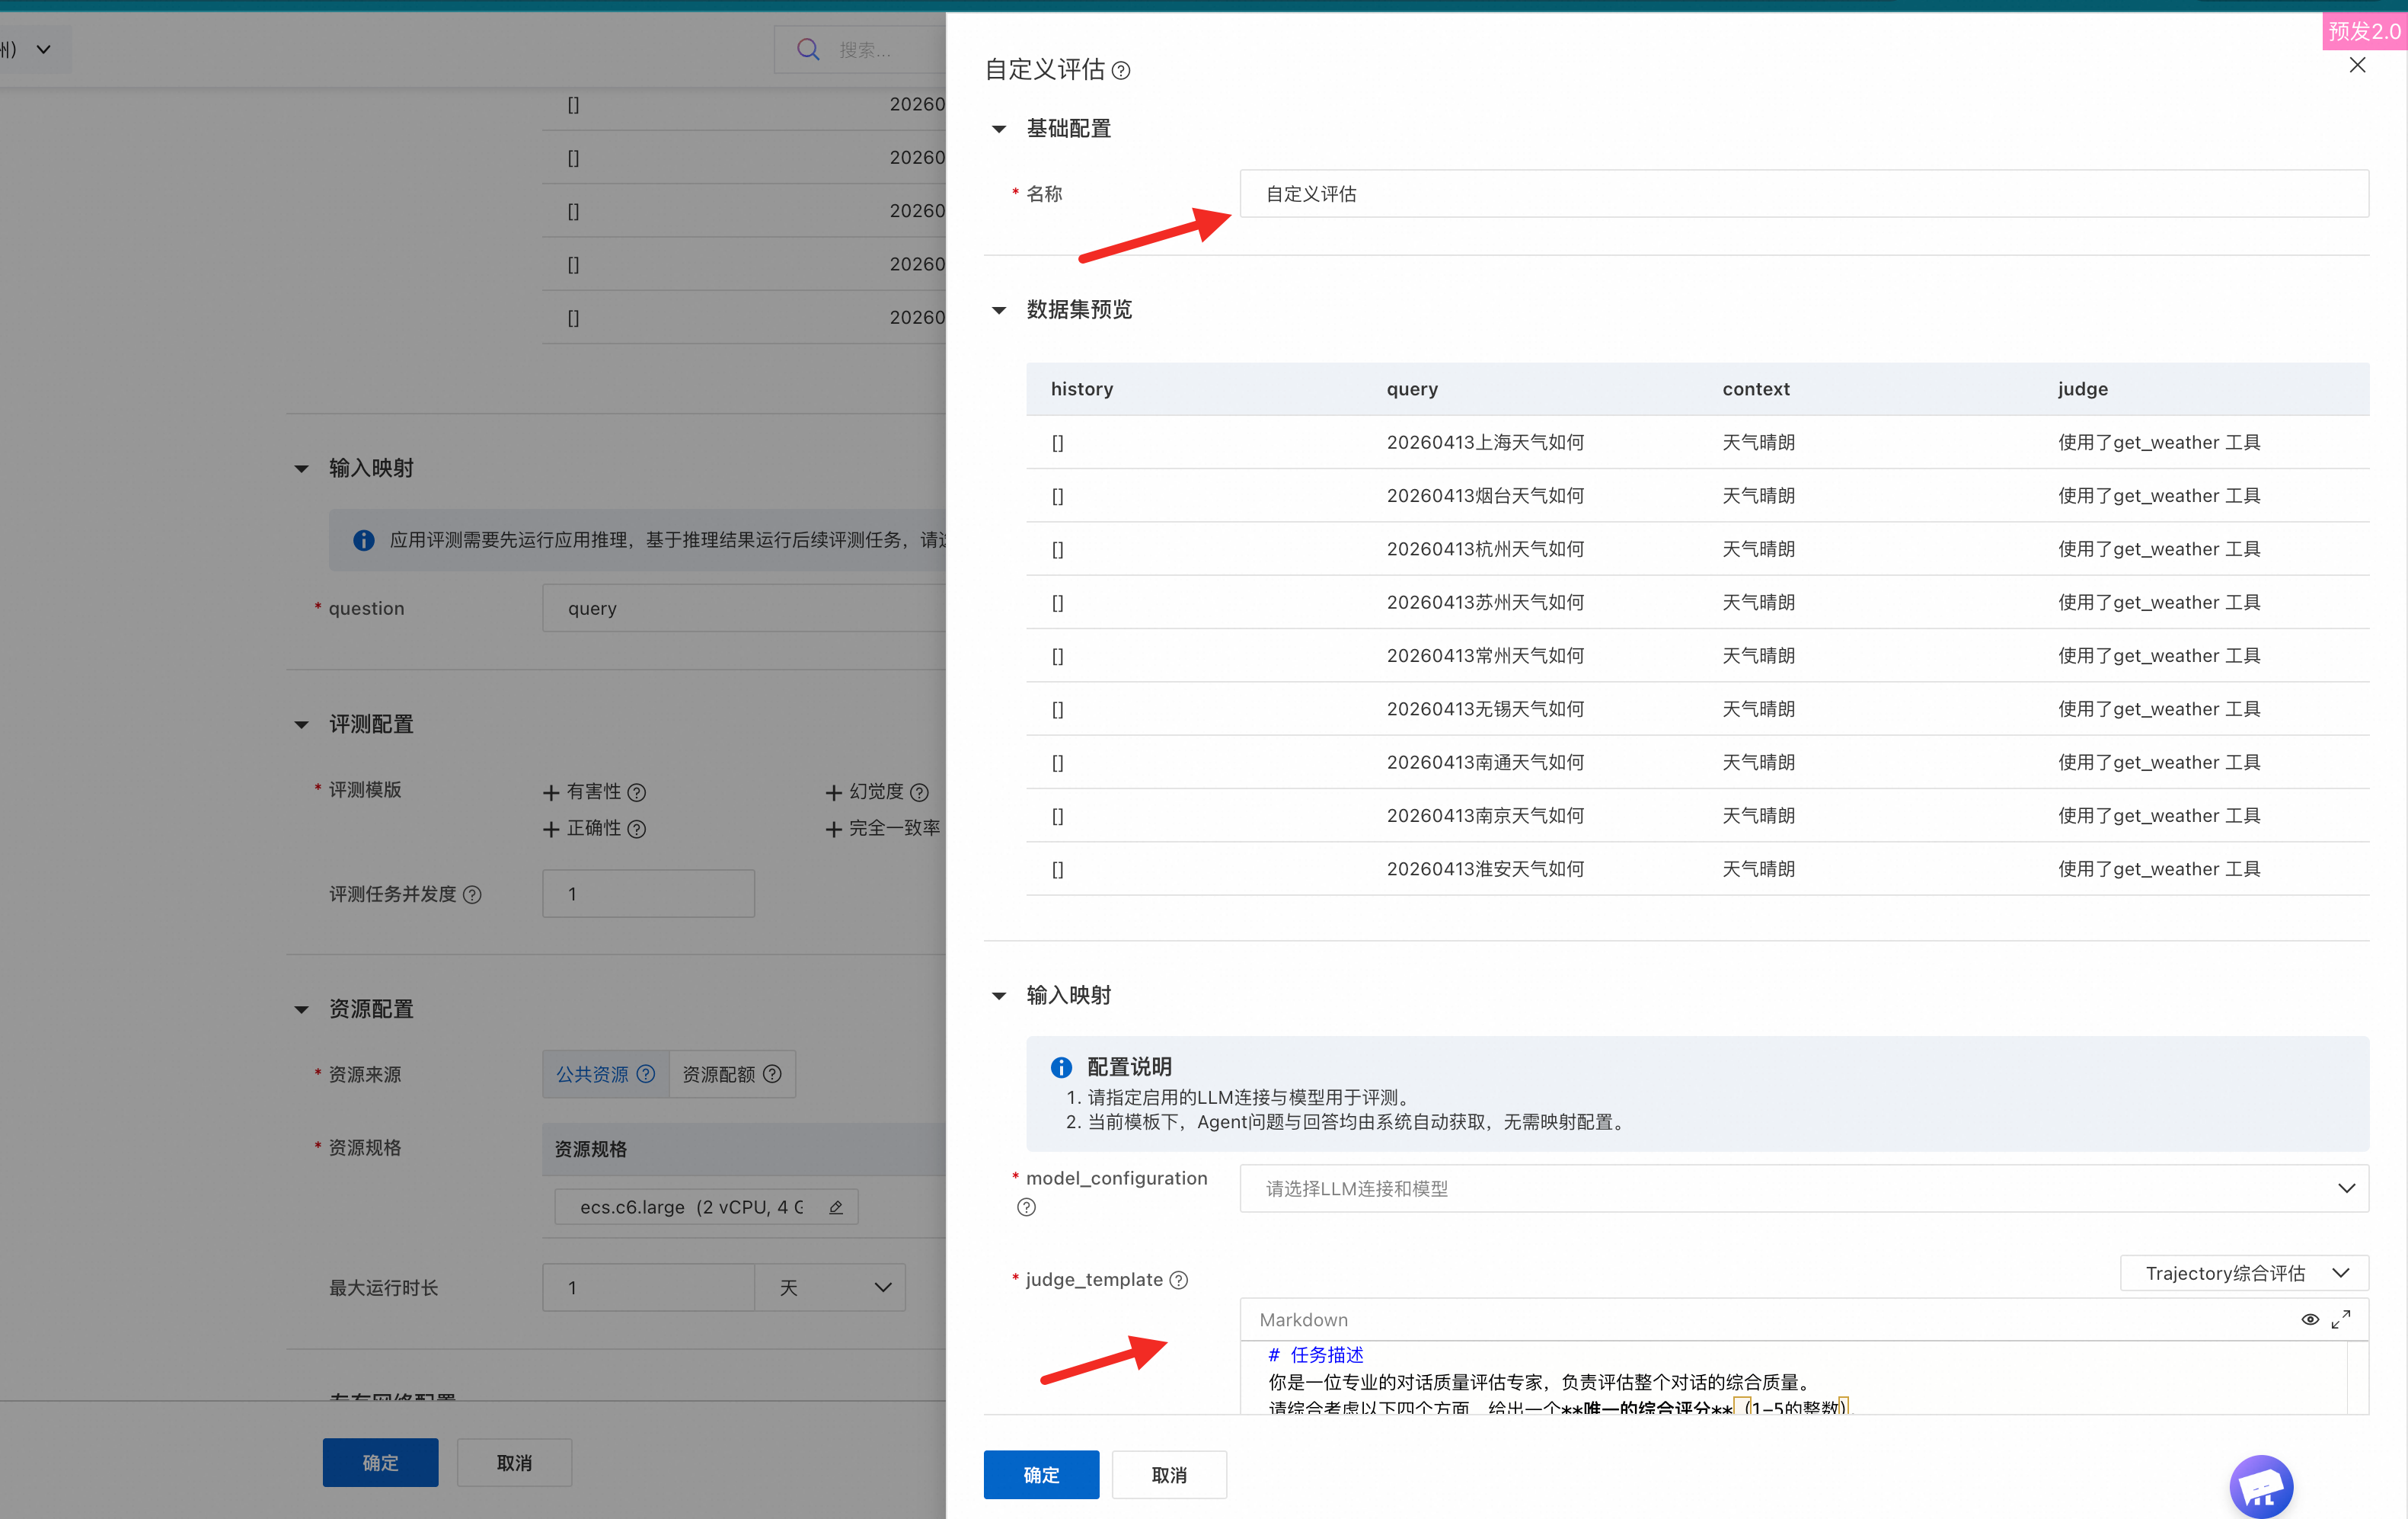
Évaluation personnalisée |
Créez une évaluation personnalisée avec un modèle d'invite défini par l'utilisateur.
|
|
Configuration des ressources : Utilisée pour planifier la tâche d'évaluation. Sélectionnez les CPU resources en fonction de la complexité de la tâche. |
|
Consulter les résultats de l'évaluation
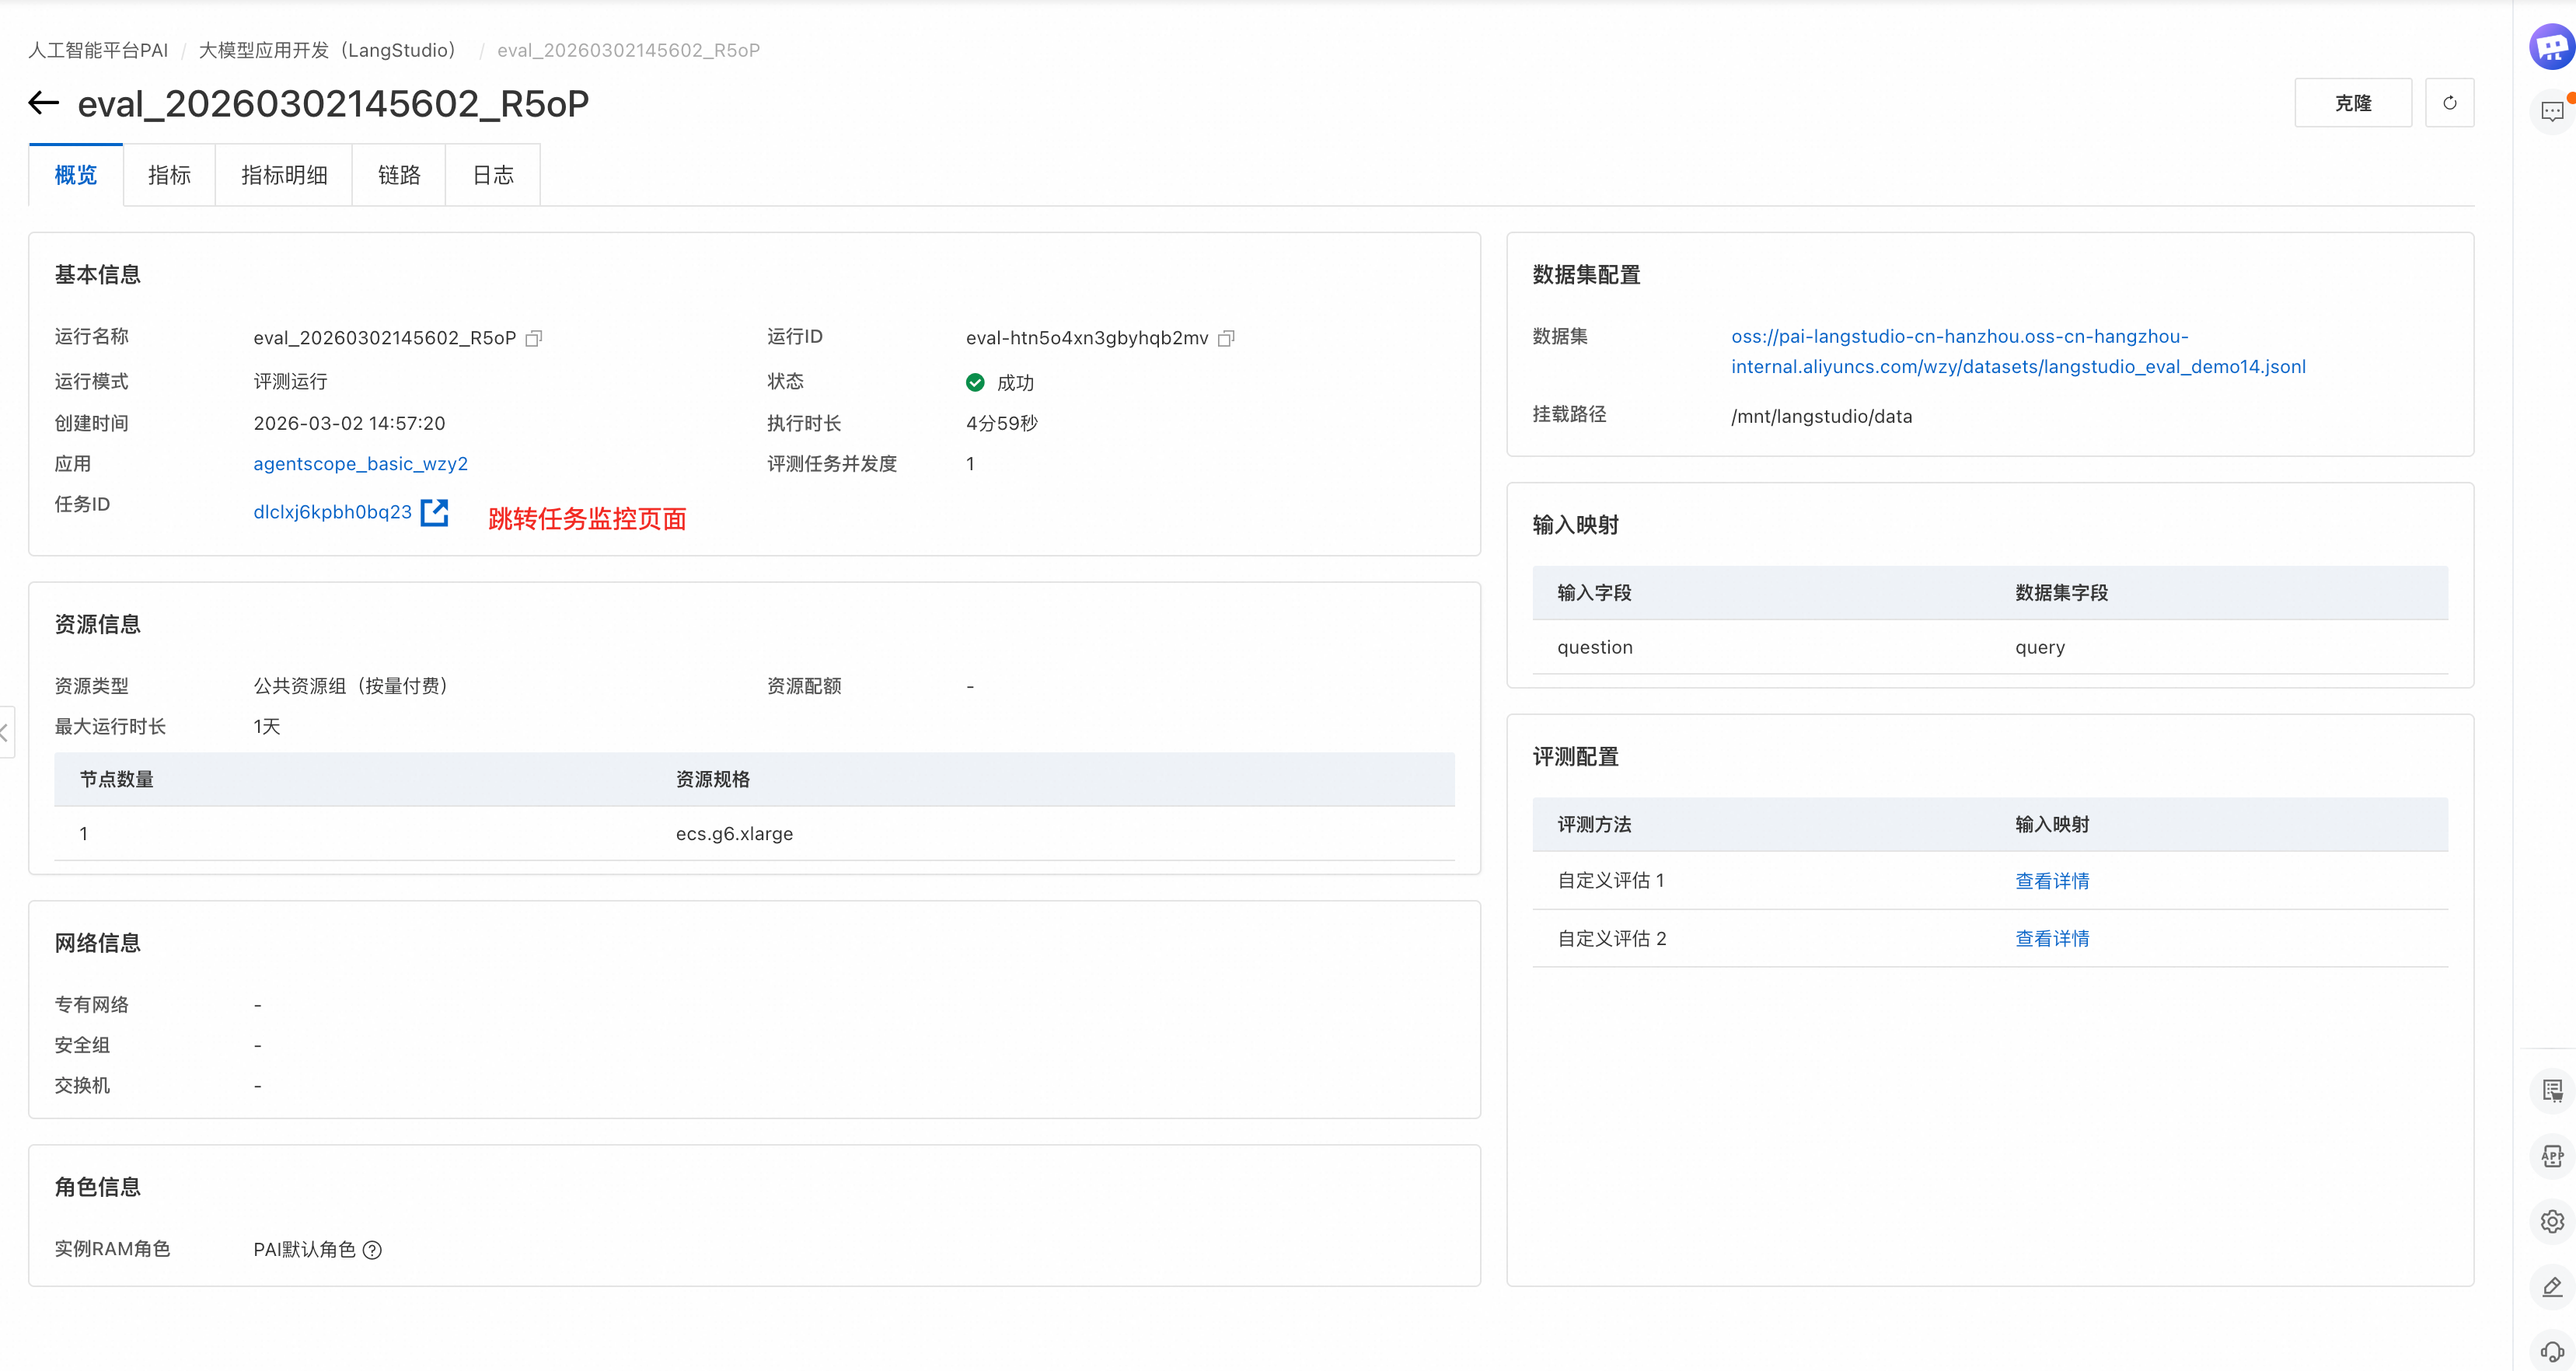
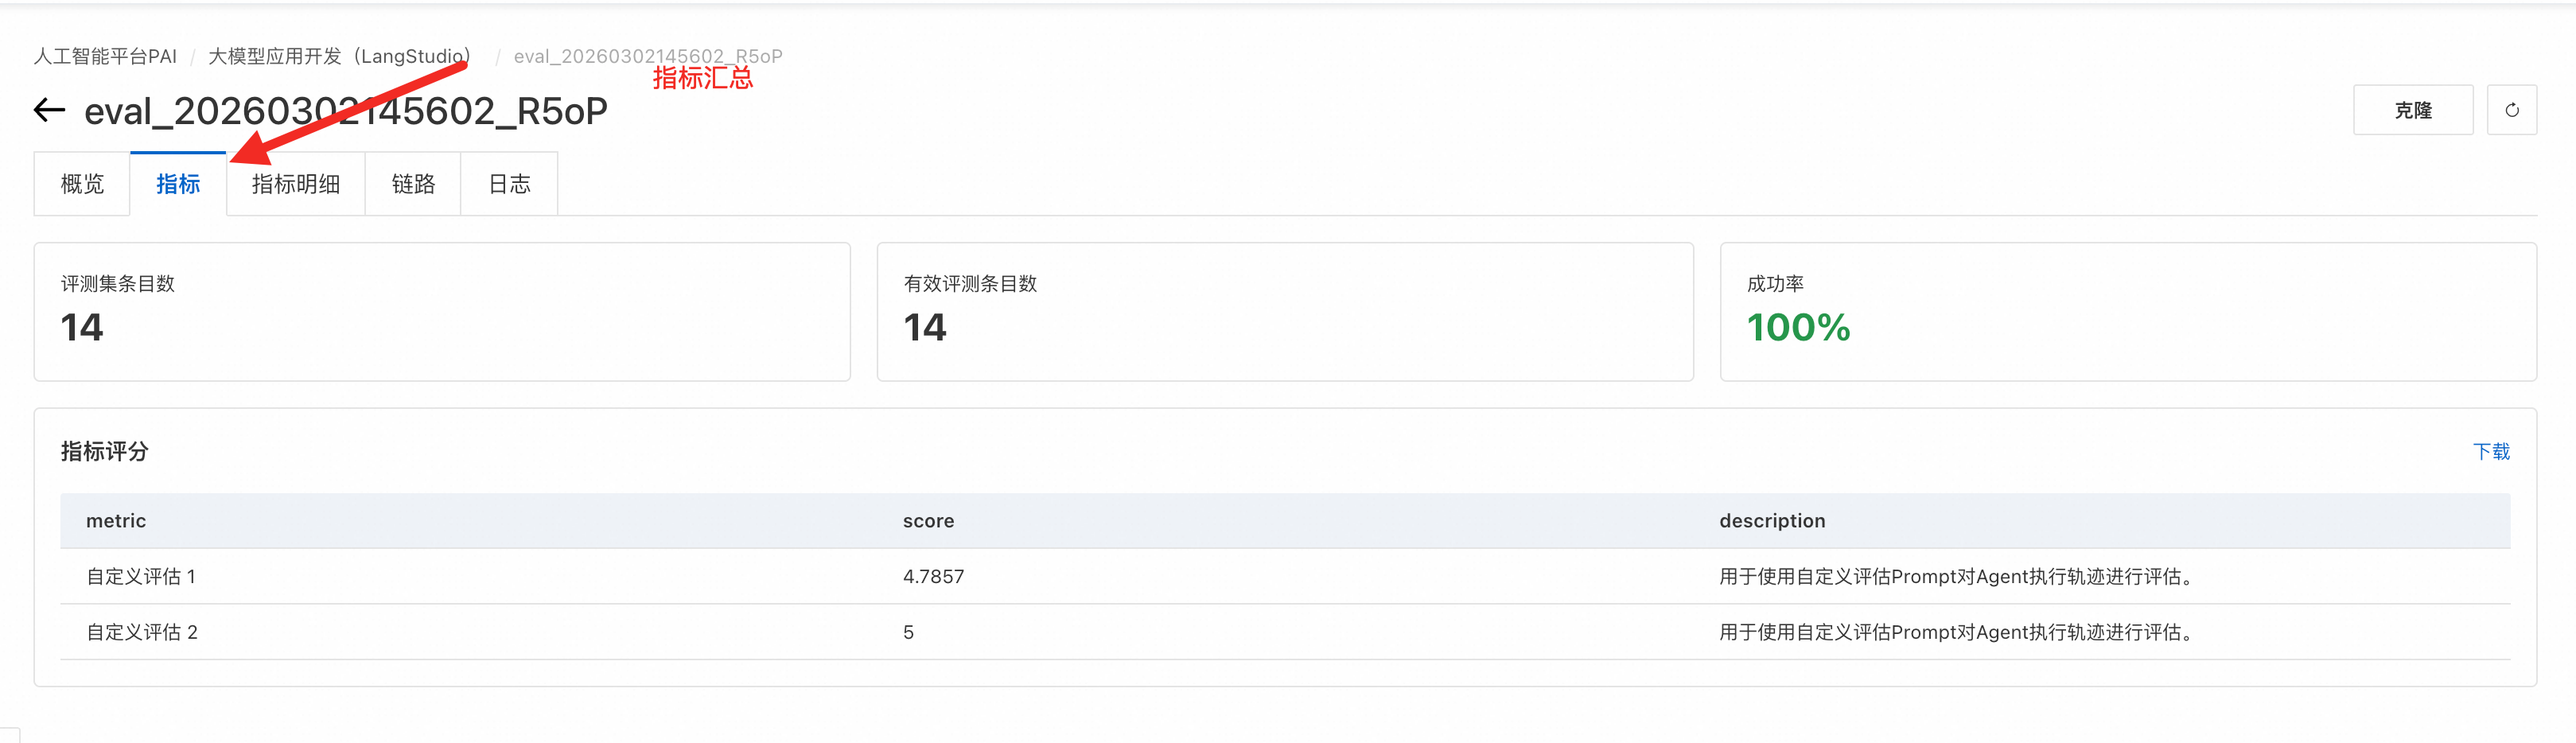
Après avoir soumis une tâche d'évaluation, LangStudio redirige vers la page Overview de la tâche. Chaque exécution comporte deux étapes : Batch Run traite chaque ligne du jeu de données via votre application, et Metric Evaluation évalue chaque sortie par rapport aux champs auxiliaires. Une fois terminée, consultez la trace, les métriques et les détails de sortie pour chaque sous-tâche.
La page Metrics affiche tous les résultats des métriques d'évaluation. Les noms des métriques sont définis dans l'Annexe : Modèles d'évaluation prédéfinis.
Annexe : Modèles d'évaluation prédéfinis
LangStudio fournit les modèles d'évaluation intégrés suivants :
|
Nom du modèle |
Description |
Type de service de modèle |
Champs d'entrée |
|
Exact Match Evaluation |
Compare la sortie de l'Agent à la référence pour détecter les correspondances exactes. Score : 0 (aucune correspondance) à 1 (correspondance parfaite). |
Aucun |
|
|
Answer Relevancy Evaluation |
Évalue la pertinence de la sortie de l'application par rapport à l'entrée à l'aide d'un juge LLM. Score : 1–5 (plus élevé = plus pertinent). |
LLM |
|
|
Answer Correctness Evaluation |
Évalue l'exactitude factuelle, la couverture des informations et la conformité du format par rapport à une référence. Score : 1–5 (plus élevé = correspondance plus proche). |
LLM |
|
|
Instruction Following Evaluation |
Évalue le respect des instructions en termes de contenu, de format et de contraintes. Score : 1–5 (plus élevé = meilleure conformité). |
LLM |
|
|
Answer Faithfulness Evaluation |
Détecte les informations fabriquées non prises en charge par le contexte ou contradictoires avec celui-ci. Score : 1–5 (plus élevé = plus fidèle). |
LLM |
|
|
Safety Evaluation |
Détecte le contenu nuisible, offensant ou inapproprié. Score : 1–5 (plus élevé = plus sûr). |
LLM |
|
|
Trajectory Evaluation |
Évalue globalement la trajectoire d'exécution de l'Agent. Score : 1–5 (plus élevé = meilleures performances). |
LLM |
|