Si vous rencontrez des problèmes de récupération incomplète des connaissances ou de contenu inexact avec la fonctionnalité de génération augmentée par récupération (RAG) dans Alibaba Cloud Model Studio, suivez les suggestions et exemples présentés dans cette rubrique pour améliorer les performances RAG.
1. Flux de travail RAG
La génération augmentée par récupération (RAG, Retrieval-Augmented Generation) est une technique qui combine la recherche d'informations avec la génération de texte. Elle permet à un modèle d'utiliser des informations pertinentes issues d'une base de connaissances externe lors de la génération de réponses.
Son flux de travail comprend plusieurs étapes clés, notamment l'analyse et le découpage, le stockage vectoriel, la récupération et le rappel, ainsi que la génération de réponses.
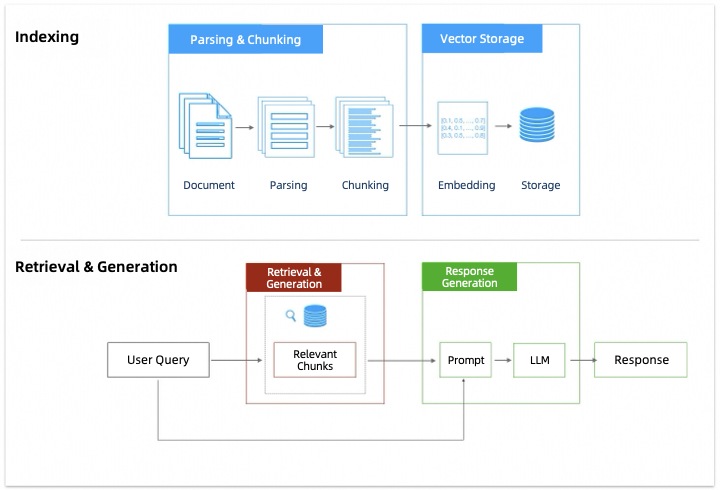
Les sections suivantes présentent les techniques permettant d'optimiser chaque étape : analyse et découpage, récupération et rappel, et génération de réponses.
2. Optimisation des performances RAG
2,1 Préparation
Tout d'abord, assurez-vous que les documents importés dans la base de connaissances Model Studio répondent aux exigences suivantes :
-
Inclure les connaissances pertinentes : Si la base de connaissances ne contient pas les informations nécessaires, le modèle risque de ne pas pouvoir répondre aux questions connexes. Pour résoudre ce problème, mettez à jour la base de connaissances et ajoutez les connaissances requises.
-
Utiliser le format Markdown (recommandé) : Les fichiers PDF ont souvent des mises en page complexes, ce qui peut entraîner une mauvaise qualité d'analyse. Convertissez d'abord les fichiers PDF dans un format textuel tel que Markdown, DOC ou DOCX. Par exemple, utilisez DashScopeParse pour convertir un fichier PDF au format Markdown, puis utilisez un modèle pour nettoyer la mise en forme. Consultez le chapitre RAG du cours ACP sur les grands modèles Alibaba Cloud.
Comment dois-je traiter les illustrations dans les documents ?
La base de connaissances ne peut pas actuellement analyser le contenu vidéo ou audio présent dans les documents.
-
Utiliser une formulation claire, une structure raisonnable et éviter les styles spéciaux : La mise en page de votre document affecte également considérablement les performances RAG. Pour plus de détails, consultez la section Comment formater les documents pour optimiser le RAG ?.
-
Faire correspondre la langue des invites : Si les invites des utilisateurs sont principalement rédigées dans une langue donnée, comme l'anglais, assurez-vous que le contenu de vos documents est rédigé dans la même langue. Si nécessaire, par exemple pour les termes techniques du document, vous pouvez utiliser deux langues ou plus.
-
Désambiguïsation des entités : Unifiez les différentes expressions désignant la même entité dans un document. Par exemple, « ML » et « Machine Learning » peuvent être normalisés en « Machine Learning ».
Vous pouvez soumettre le document à un modèle et lui demander de normaliser les termes. Si le document est long, divisez-le en plusieurs parties et traitez-les une par une.
Une fois ces étapes terminées, optimisez chaque phase de votre application RAG.
2,2 Analyse et découpage
Cette section décrit uniquement les éléments de configuration disponibles dans Model Studio pour optimiser l'étape de découpage RAG.
Dans un premier temps, la base de connaissances analyse et découpe les documents que vous importez. L'objectif principal du découpage est de réduire le bruit lors du processus de vectorisation ultérieur tout en préservant l'intégrité sémantique. Par conséquent, la stratégie de découpage que vous sélectionnez lors de la création d'une base de connaissances a un impact significatif sur les performances RAG. Si la méthode de découpage est inadaptée, elle peut entraîner les problèmes suivants :
Tronçons courts | Tronçons longs | Troncature sémantique |
|---|---|---|
|
|
|
Les tronçons courts peuvent manquer d'informations sémantiques, ce qui entraîne l'échec de la récupération. | Les tronçons longs peuvent inclure des sujets non pertinents, ce qui amène le processus de rappel à renvoyer des informations bruitées ou hors sujet. | Une troncature sémantique forcée peut entraîner une perte de contenu lors du rappel. |
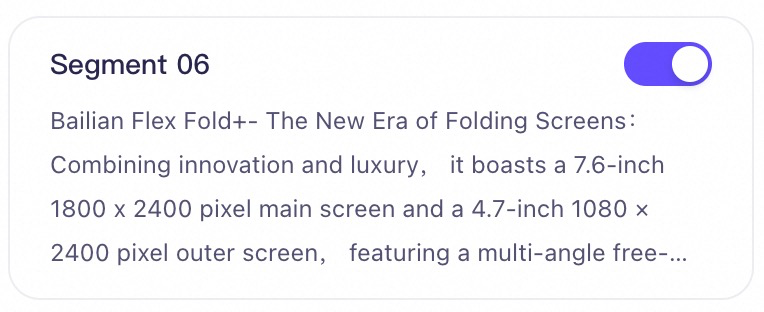
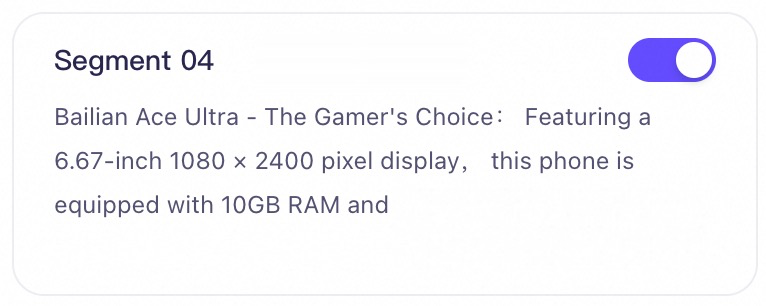
Pour obtenir les meilleurs résultats, veillez à ce que les tronçons de texte soient sémantiquement complets tout en évitant un bruit excessif. Model Studio recommande les actions suivantes :
- Lors de la création d'une base de connaissances, sélectionnez intelligent chunking comme méthode de découpage des documents.
- Après avoir importé avec succès les documents dans la base de connaissances, examinez manuellement le contenu des tronçons de texte et corrigez-le si nécessaire.
2.2.1 Découpage intelligent
Le choix de la longueur optimale des tronçons de texte pour votre base de connaissances peut s'avérer difficile, car cela dépend de plusieurs facteurs, tels que :
- Type de document : Pour la littérature professionnelle, des tronçons plus longs aident souvent à conserver davantage de contexte. Pour les publications sur les réseaux sociaux, des tronçons plus courts permettent de capturer la sémantique avec plus de précision.
- Complexité de l'invite : En général, si l'invite d'un utilisateur est complexe et spécifique, vous aurez peut-être besoin de tronçons plus longs. Dans le cas contraire, des tronçons plus courts pourraient être plus appropriés.
Ces conclusions ne s'appliquent pas nécessairement à toutes les situations. Vous devez choisir les outils adaptés et effectuer des tests répétés afin de déterminer la longueur de tronçon de texte appropriée. Par exemple, LlamaIndex propose des fonctions d'évaluation pour différentes méthodes de découpage. Toutefois, ce processus peut être complexe et prendre du temps.
Pour une solution rapide et efficace, définissez l'option Document Chunking sur Intelligent Splitting lors de la création d'une base de connaissances.
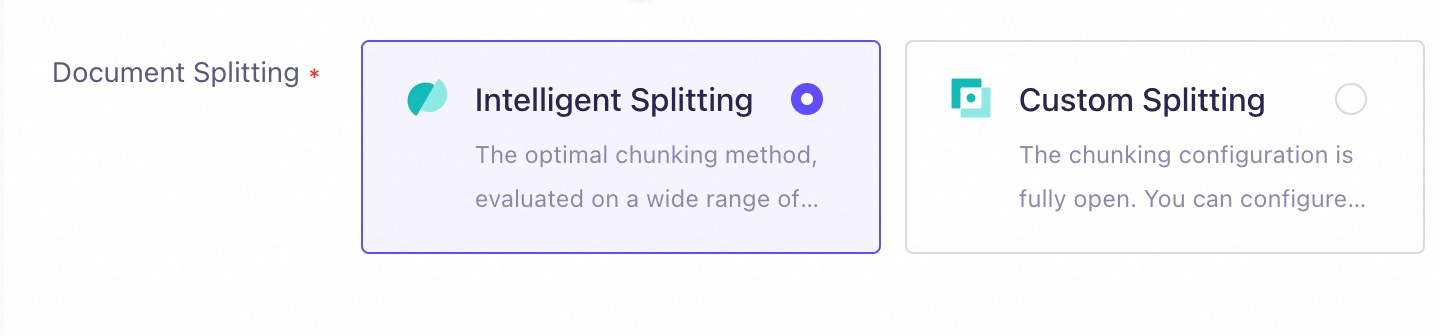
Lorsque cette stratégie est appliquée, la base de connaissances :
- Utilise d'abord des délimiteurs de phrases intégrés pour diviser le document en paragraphes.
- Sur la base des paragraphes divisés, sélectionne de manière adaptative les limites des tronçons en fonction de la pertinence sémantique (découpage sémantique), au lieu d'utiliser une longueur fixe.
Ce processus garantit l'intégrité sémantique de chaque partie du document et évite les divisions inutiles. Cette stratégie s'applique à tous les documents de cette base de connaissances, y compris ceux importés ultérieurement.
2.2.2 Correction du contenu des tronçons
Bien entendu, lors du processus réel de découpage, des divisions inattendues ou d'autres problèmes peuvent toujours survenir (par exemple, les espaces dans le texte sont parfois analysés sous la forme %20 après le découpage).
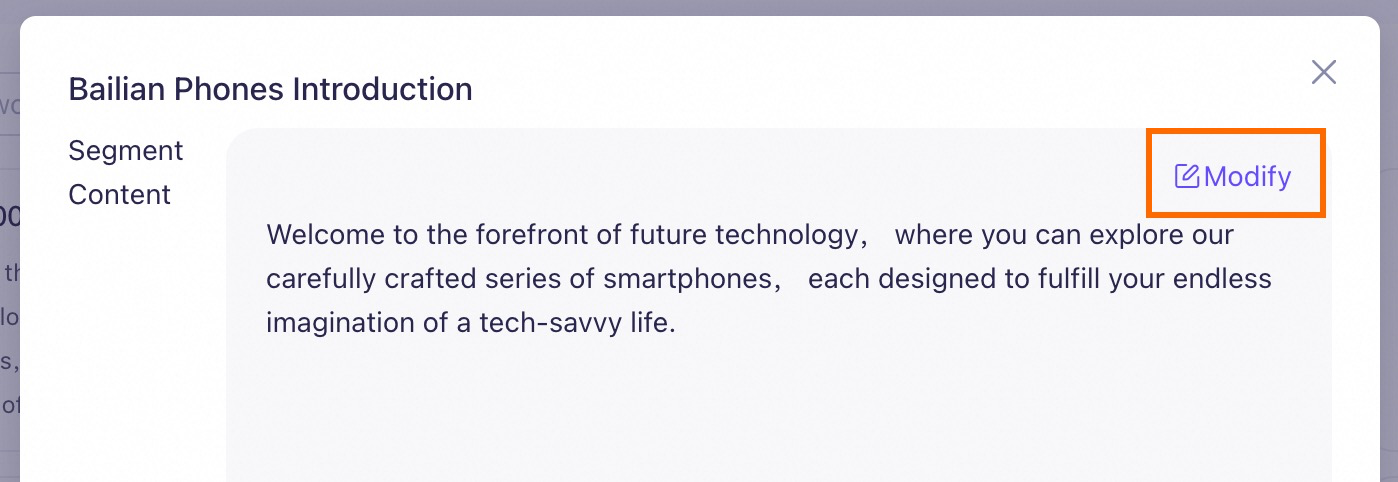
Par conséquent, Model Studio recommande de vérifier manuellement l'intégrité sémantique et l'exactitude du contenu des tronçons après l'importation d'un document. Si vous constatez des tronçons inattendus ou d'autres erreurs d'analyse, vous pouvez modifier directement les tronçons de texte pour les corriger. Après enregistrement, le contenu original du tronçon de texte devient invalide et le nouveau contenu est utilisé pour la récupération dans la base de connaissances.
Notez que cette action modifie uniquement les tronçons de texte dans la base de connaissances, et non le document original ou la table de données dans votre gestion des données (stockage temporaire). Par conséquent, si vous réimportez le document, vous devrez effectuer à nouveau la vérification et la correction manuelles.
2,3 Récupération et rappel
Cette section décrit uniquement les éléments de configuration disponibles dans Model Studio pour optimiser l'étape de récupération et de rappel.
Le principal défi lors de l'étape de récupération et de rappel consiste à trouver les tronçons de texte les plus pertinents dans la base de connaissances contenant la réponse.
| Type de problème | Stratégie d'amélioration |
|---|---|
Dans les scénarios de conversation multi-tours, l'invite de l'utilisateur peut être incomplète ou ambiguë. | Activez la réécriture des conversations multi-tours. La base de connaissances réécrit automatiquement l'invite de l'utilisateur pour la rendre plus complète, améliorant ainsi la correspondance des connaissances. |
La base de connaissances contient des documents de plusieurs catégories. Lorsqu'une recherche se concentre sur la catégorie A, les résultats de rappel incluent également des tronçons de texte d'autres catégories, telles que la catégorie B. | Ajoutez des tags aux documents. Lors de la récupération, la base de connaissances filtre d'abord les documents pertinents en fonction des tags avant d'effectuer la recherche.
|
La base de connaissances contient plusieurs documents ayant des structures similaires, par exemple, ils comportent tous une section « Feature Overview ». Vous souhaitez effectuer une recherche dans la section « Feature Overview » du document A, mais les résultats de rappel incluent des informations provenant d'autres documents similaires. | Utilisez l'extraction de métadonnées. La base de connaissances effectue une recherche structurée avec les métadonnées avant la récupération vectorielle afin de trouver précisément le document cible et d'en extraire les informations pertinentes.
|
Les résultats de rappel sont incomplets et n'incluent pas tous les tronçons de texte pertinents. | Abaissez le seuil de similarité et augmentez le nombre de tronçons rappelés afin de récupérer les informations précédemment omises. |
Les résultats de rappel contiennent un grand nombre de tronçons de texte non pertinents. | Augmentez le seuil de similarité pour exclure les informations présentant une faible similarité avec l'invite de l'utilisateur. |
2.3.1 Réécriture des conversations multi-tours
Lors d'une conversation multi-tours, un utilisateur peut poser une question avec une invite courte, telle que « Model Studio Phone X1 ». Cela peut empêcher le système RAG de disposer du contexte nécessaire lors de la récupération pour les raisons suivantes :
-
Un produit téléphonique possède souvent plusieurs générations vendues simultanément.
-
Pour une même génération de produit, le fabricant propose généralement plusieurs options de stockage, telles que 128 Go et 256 Go.
...
Ces informations clés ont pu être fournies lors des tours de conversation précédents. Leur utilisation efficace aide le système RAG à récupérer des informations plus précises.
Pour remédier à cela, vous pouvez utiliser la fonctionnalité Multi-round Conversation Rewriting dans Model Studio. Le système réécrit automatiquement l'invite de l'utilisateur sous une forme plus complète en se basant sur l'historique de la conversation.
Par exemple, l'utilisateur demande :
Model Studio Phone X1.
Avec la réécriture des conversations multi-tours activée, le système réécrit l'invite de l'utilisateur en fonction de son historique de conversation avant la récupération (exemple uniquement) :
Provide all available versions of Model Studio Phone X1 in the product library and their specific parameters.
Cette invite réécrite aide le système RAG à mieux comprendre l'intention de l'utilisateur et à fournir une réponse plus précise.
La figure suivante montre comment activer la fonctionnalité de réécriture des conversations multi-tours. Cette fonctionnalité est également activée lorsque vous sélectionnez la Recommended Configuration.
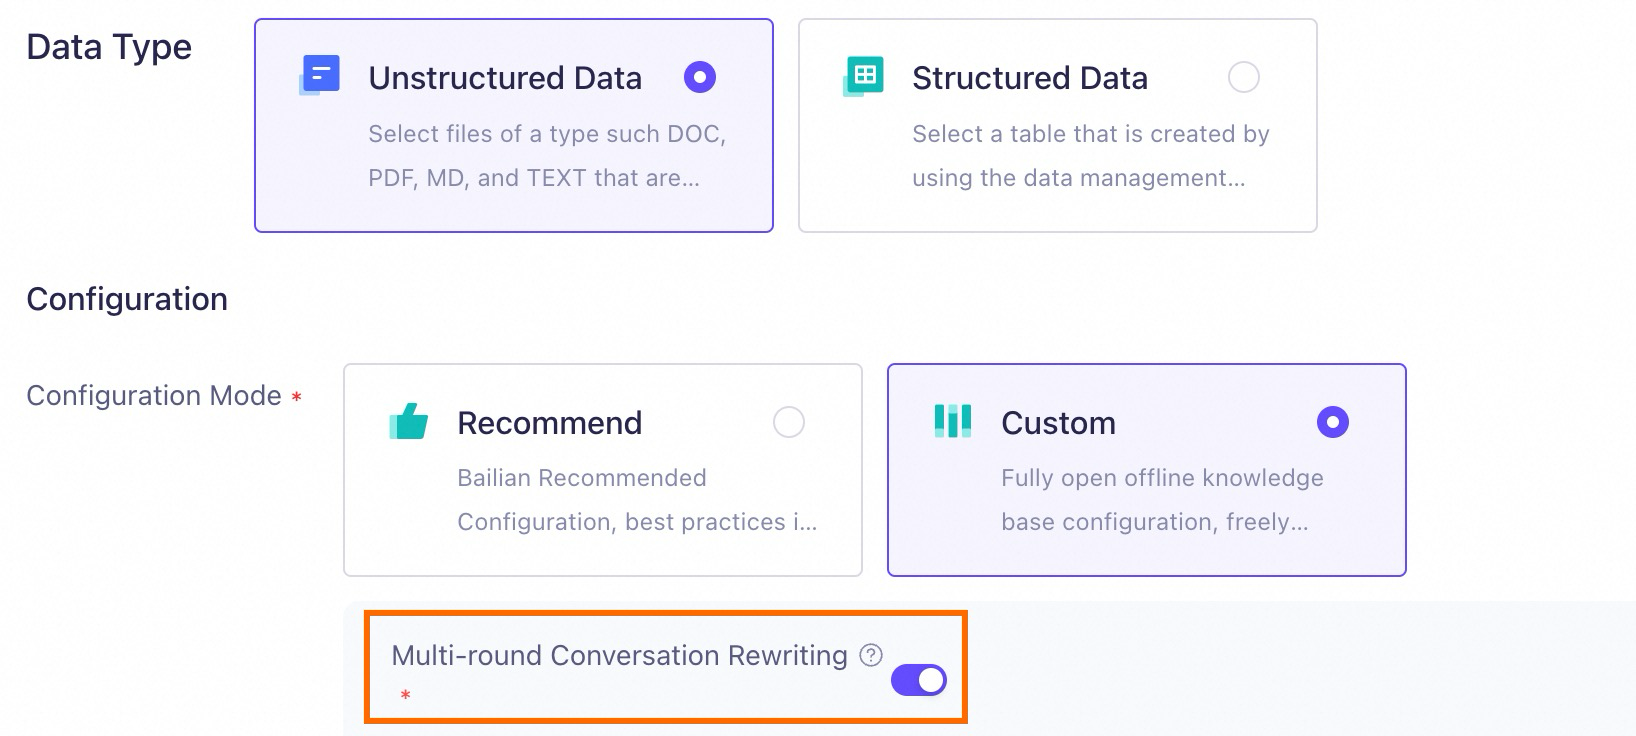
Notez que la fonctionnalité de réécriture des conversations multi-tours est liée à la base de connaissances. Une fois activée, elle s'applique uniquement aux requêtes relatives à la base de connaissances actuelle. Ce paramètre ne peut pas être modifié ultérieurement ; vous devez recréer la base de connaissances pour l'activer.
2.3.2 Filtrage par tags
Cette section s'applique uniquement aux bases de connaissances de recherche documentaire .
Lorsque vous utilisez une application musicale, vous pouvez filtrer les chansons par artiste pour trouver rapidement toutes les chansons de cet artiste.
De la même manière, l'ajout de tags à vos documents non structurés introduit des informations structurées supplémentaires. Lors de la récupération depuis la base de connaissances, l'application peut d'abord filtrer les documents en fonction des tags, ce qui améliore la précision et l'efficacité de la récupération.
Model Studio prend en charge les deux méthodes suivantes pour définir des tags :
-
Définir des tags lors du téléchargement des documents : Pour les étapes dans la console, consultez la section Import data.
-
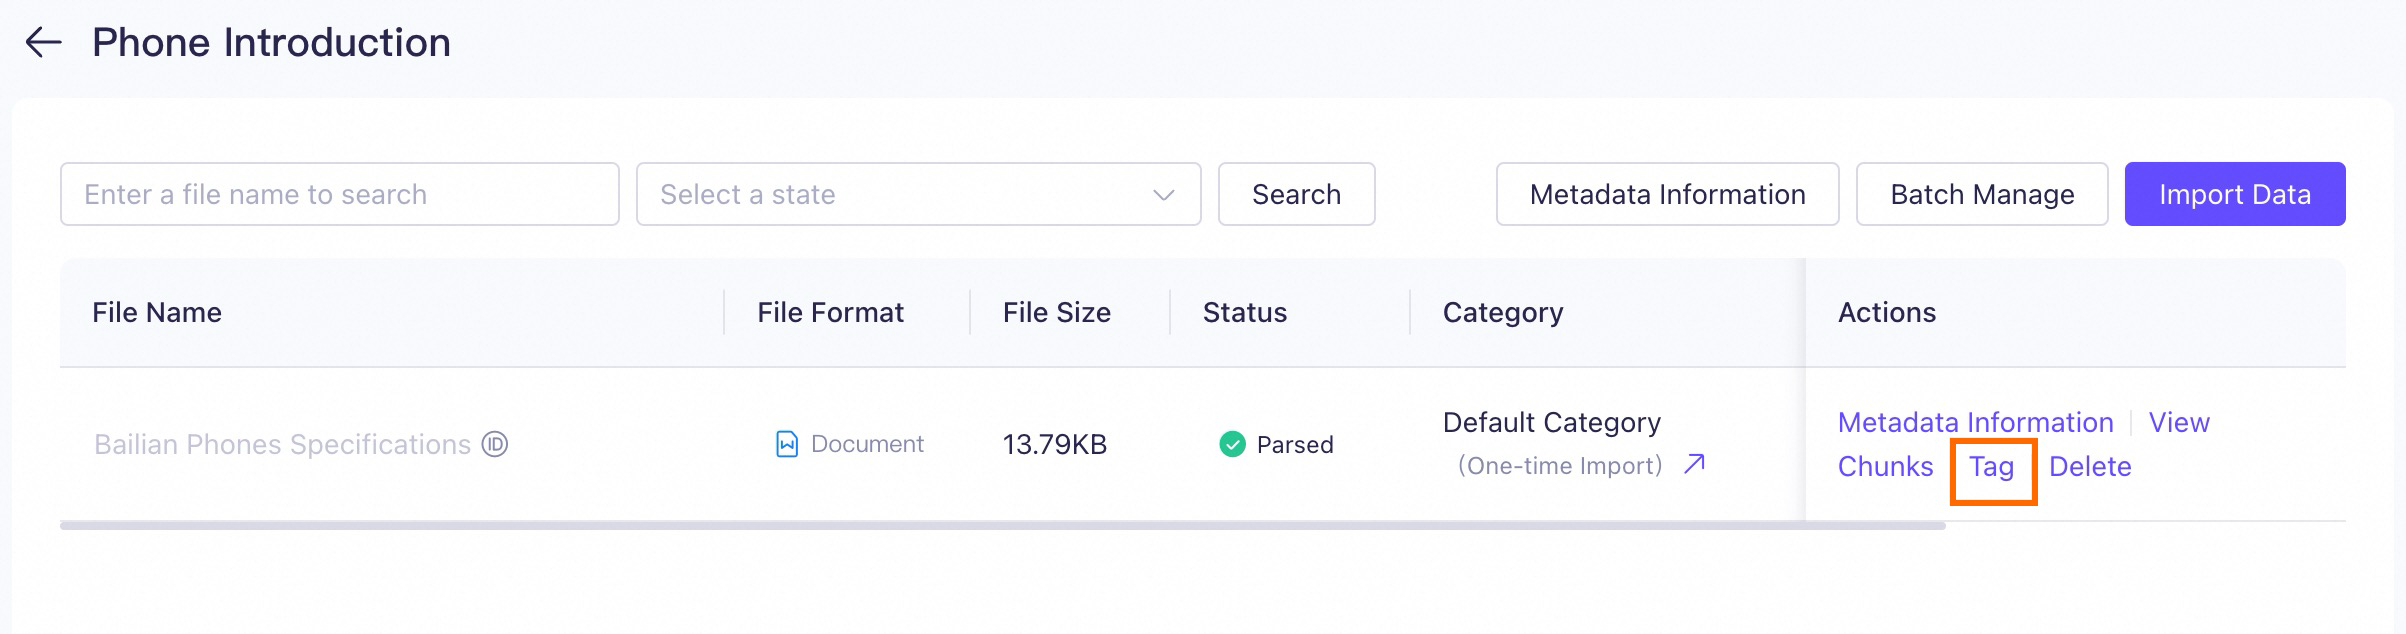
Modifier les tags sur la page Data Management : Pour les documents téléchargés, cliquez sur Tag à droite du document pour modifier ses tags .
Model Studio prend en charge les deux méthodes suivantes pour utiliser les tags :
-
Lorsque vous appelez une application Model Studio via une API, vous pouvez spécifier des tags dans le paramètre de requête
tags. -
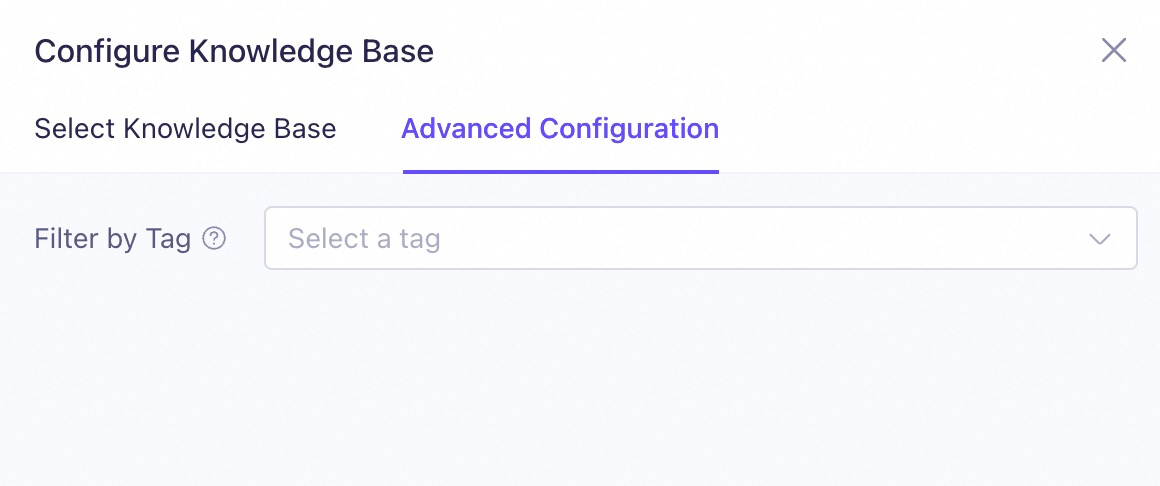
Définissez des tags lors de la modification d'une application dans la console. Toutefois, cette méthode s'applique uniquement aux agent applications.
Notez que ce paramètre s'applique à toutes les questions et réponses utilisateur ultérieures pour cette agent application.
2.3.3 Extraction de métadonnées
Cette section s'applique uniquement aux bases de connaissances de recherche documentaire .
L'intégration de métadonnées dans les tronçons de texte peut efficacement enrichir le contexte de chaque tronçon. Dans des scénarios spécifiques, cette méthode peut améliorer considérablement les performances RAG des bases de connaissances de recherche documentaire .
Prenons le scénario suivant :
Une base de connaissances contient de nombreux manuels de produits téléphoniques. Les noms des documents correspondent aux modèles de téléphone (tels que Model Studio X1 et Model Studio Zephyr Z9), et tous les documents incluent un chapitre « Feature Overview ».Si les métadonnées ne sont pas activées pour cette base de connaissances, un utilisateur peut saisir l'invite suivante pour la récupération :
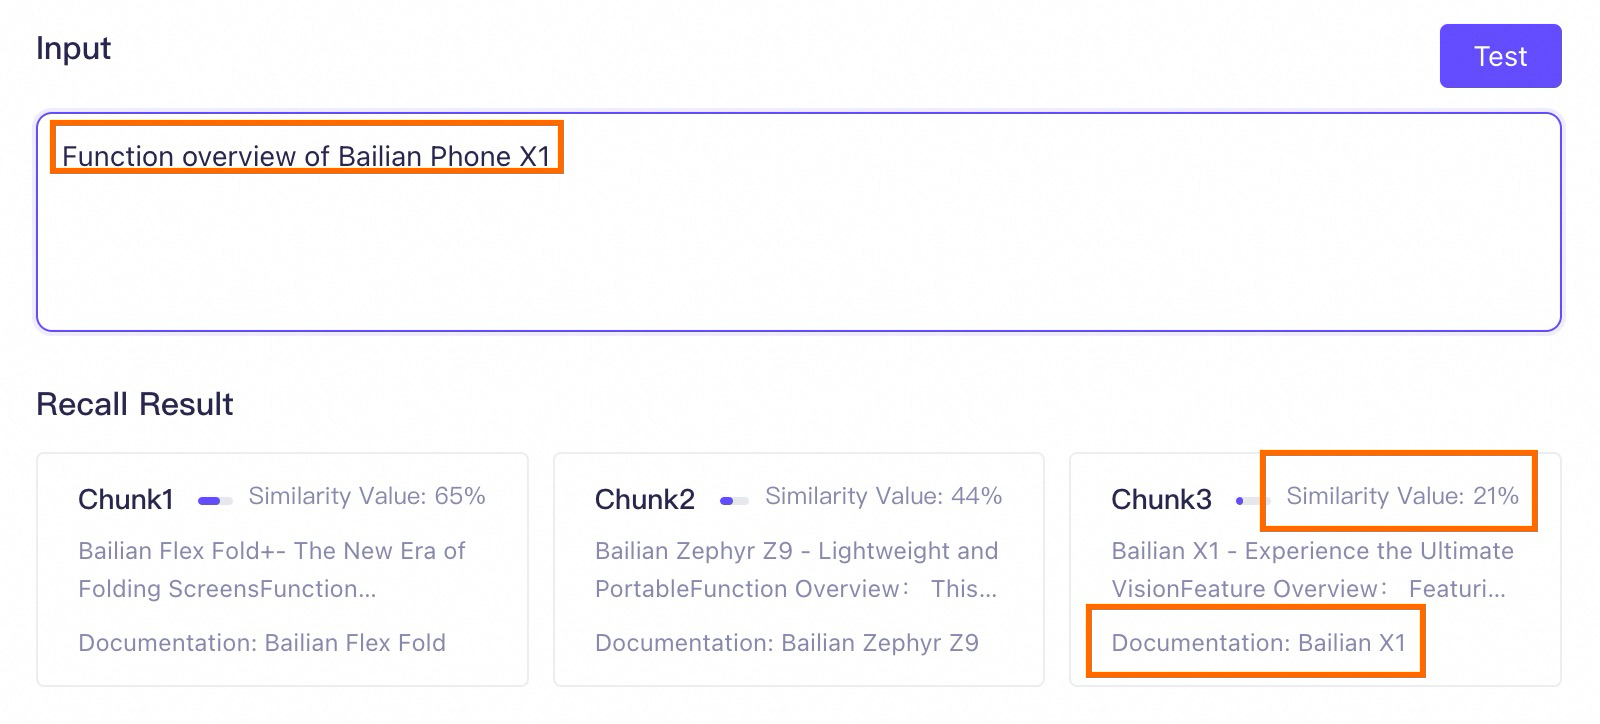
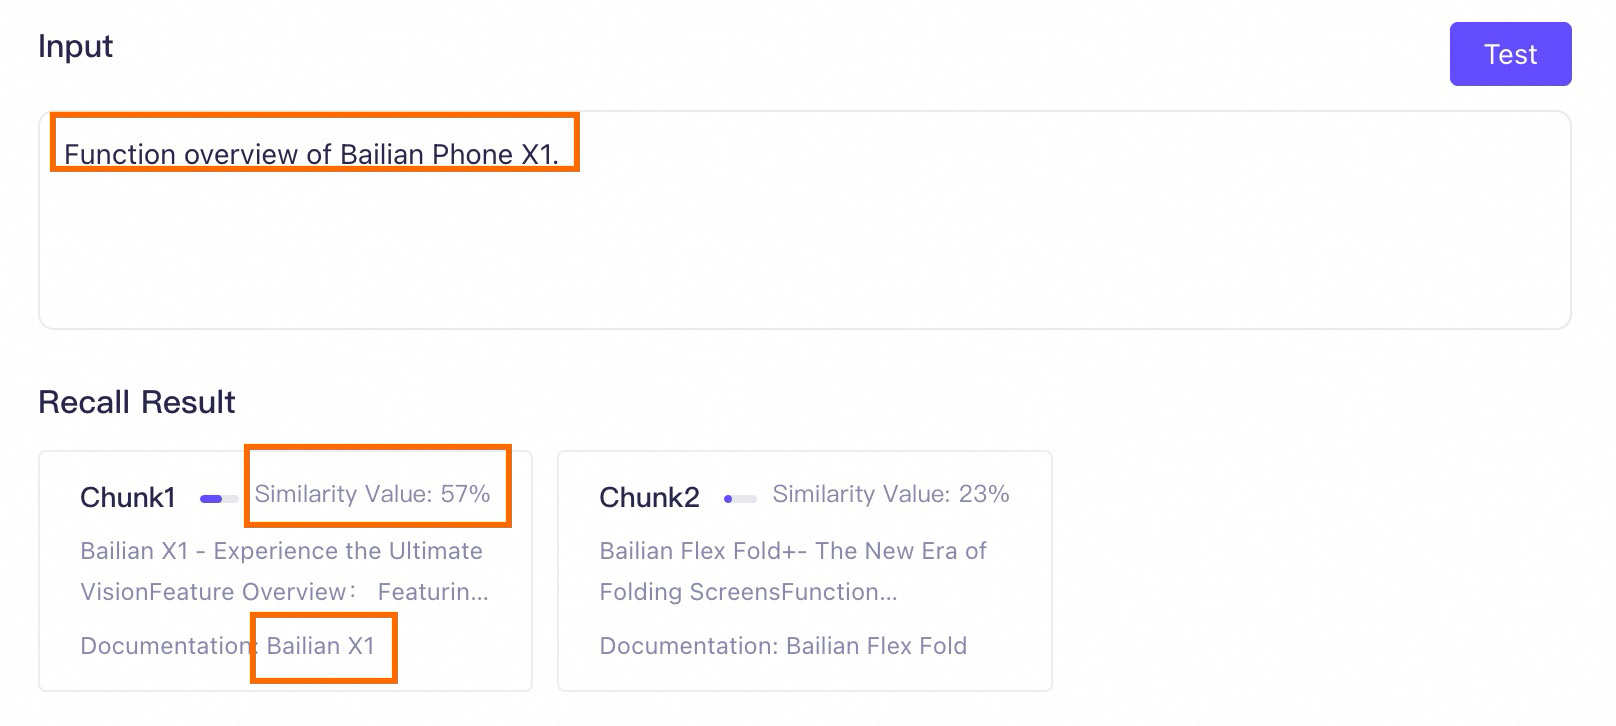
Feature overview of Model Studio Phone X1.
Un test de récupération révèle les tronçons rappelés. Étant donné que tous les documents contiennent « Feature Overview », la base de connaissances rappelle certains tronçons de texte qui ne sont pas liés à l'entité de la requête (Model Studio Phone X1) mais qui sont similaires à l'invite, tels que le tronçon 1 et le tronçon 2 dans la figure. Leur classement est même supérieur à celui du tronçon de texte requis, ce qui nuit aux performances RAG.
Les résultats du test de récupération garantissent le classement, mais le score de similarité absolu est fourni à titre indicatif uniquement. Lorsque la différence entre les valeurs absolues est faible (inférieure à 5 %), la probabilité de rappel peut être considérée comme identique.
Ensuite, définissez le nom du téléphone comme métadonnée en suivant les étapes décrites dans la section metadata extraction. Cela attache les informations correspondantes sur le nom du téléphone aux tronçons de texte de chaque document. Ensuite, exécutez le même test à des fins de comparaison.
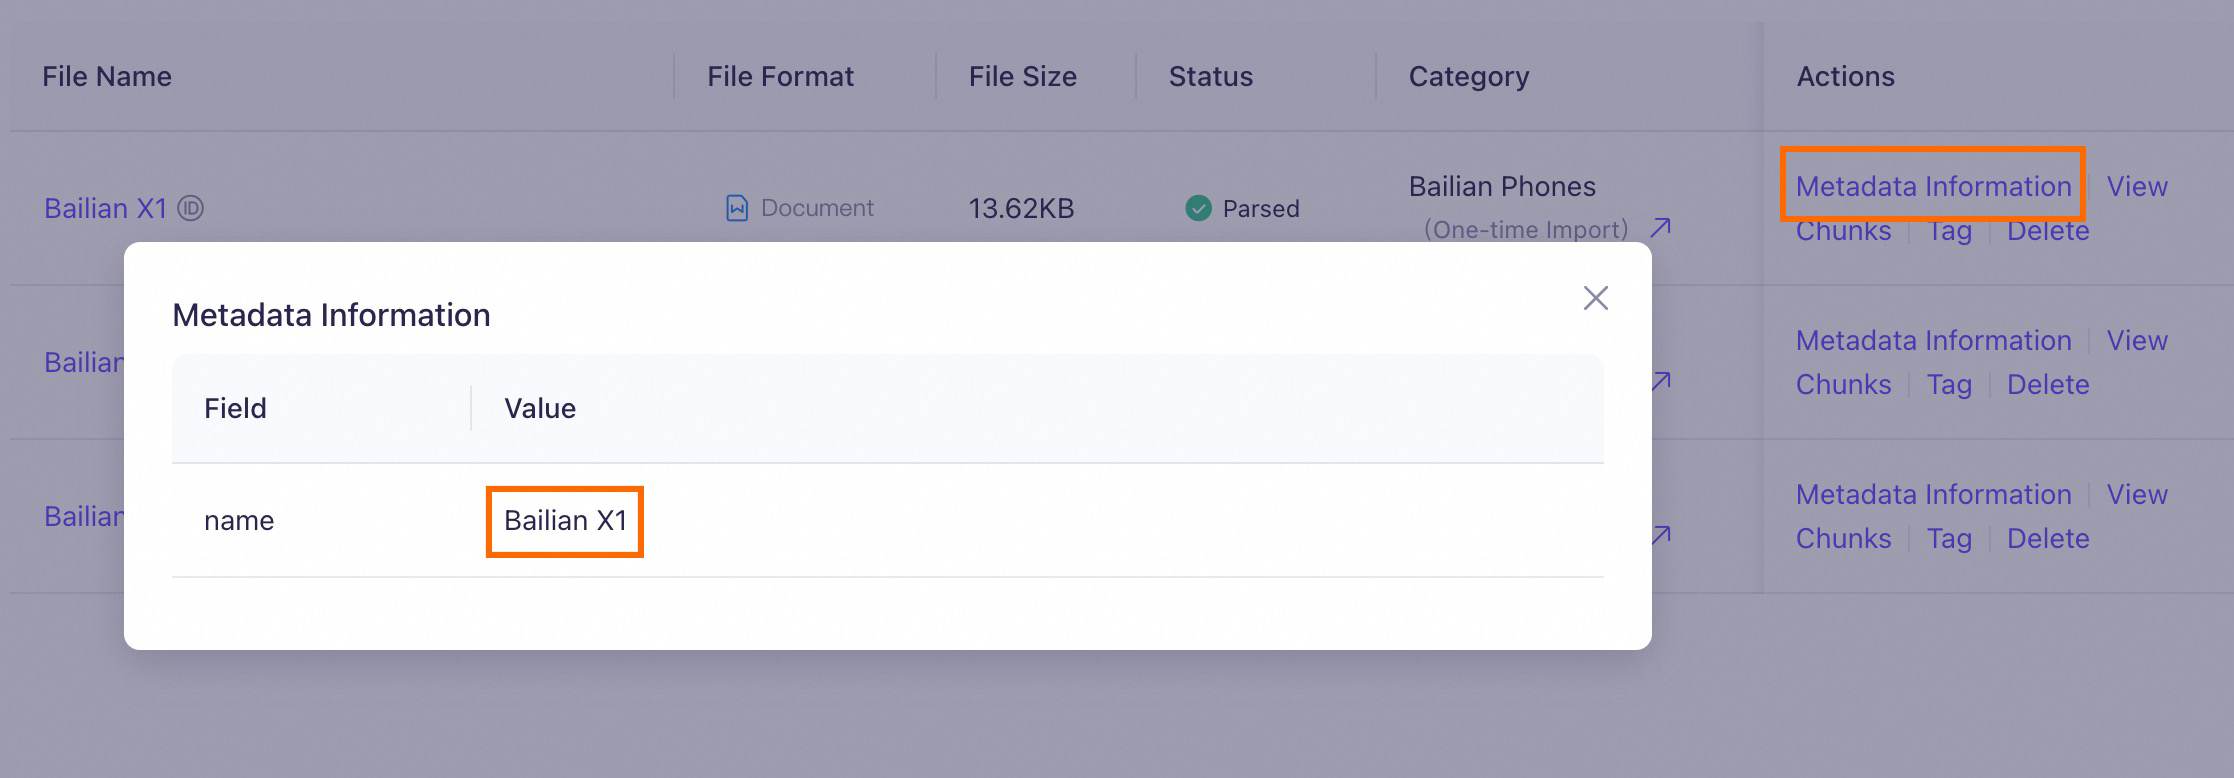
À ce stade, la base de connaissances ajoute une couche de recherche structurée avant la recherche vectorielle. Le processus complet est le suivant :
- Extrayez les métadonnées {"key": "name", "value": "Model Studio Phone X1"} de l'invite.
- Sur la base des métadonnées extraites, trouvez tous les tronçons de texte contenant les métadonnées « Model Studio Phone X1 ».
- Ensuite, effectuez une recherche vectorielle (sémantique) pour trouver les tronçons de texte les plus pertinents.
Après l'activation des métadonnées, la base de connaissances peut désormais trouver avec précision le tronçon de texte lié à « Model Studio Phone X1 » et contenant « Feature Overview ».
Une autre application courante des métadonnées consiste à intégrer des informations de date dans les tronçons de texte pour filtrer le contenu récent. Consultez la section metadata extraction.
2.3.4 Seuil de similarité
Lorsque la base de connaissances trouve des tronçons de texte liés à l'invite de l'utilisateur, elle les envoie d'abord au modèle Rank (configuré dans Custom parameter settings lors de la création de la base de connaissances) pour les reclasser. Le seuil de similarité est ensuite utilisé pour filtrer les tronçons de texte reclassés. Seuls les tronçons de texte dont le score de similarité dépasse ce seuil peuvent être fournis au modèle.
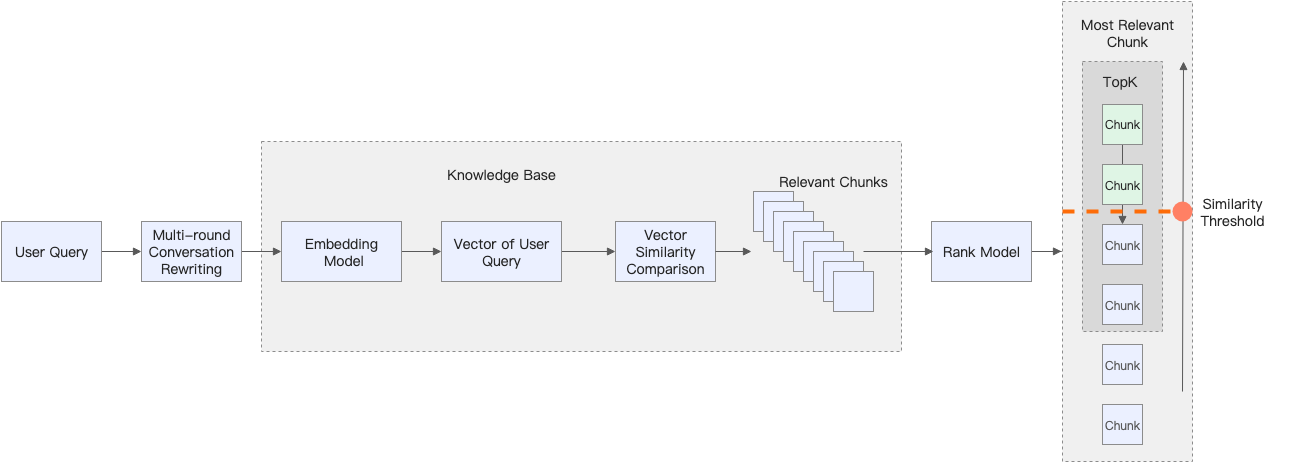
L'abaissement de ce seuil peut permettre de rappeler davantage de tronçons de texte, mais il peut aussi entraîner le rappel de tronçons moins pertinents. L'augmentation de ce seuil peut réduire le nombre de tronçons de texte rappelés.
Si le seuil est défini trop haut, la base de connaissances risque d'ignorer tous les tronçons de texte pertinents. Cela limite la capacité du modèle à obtenir suffisamment d'informations contextuelles pour générer une réponse.
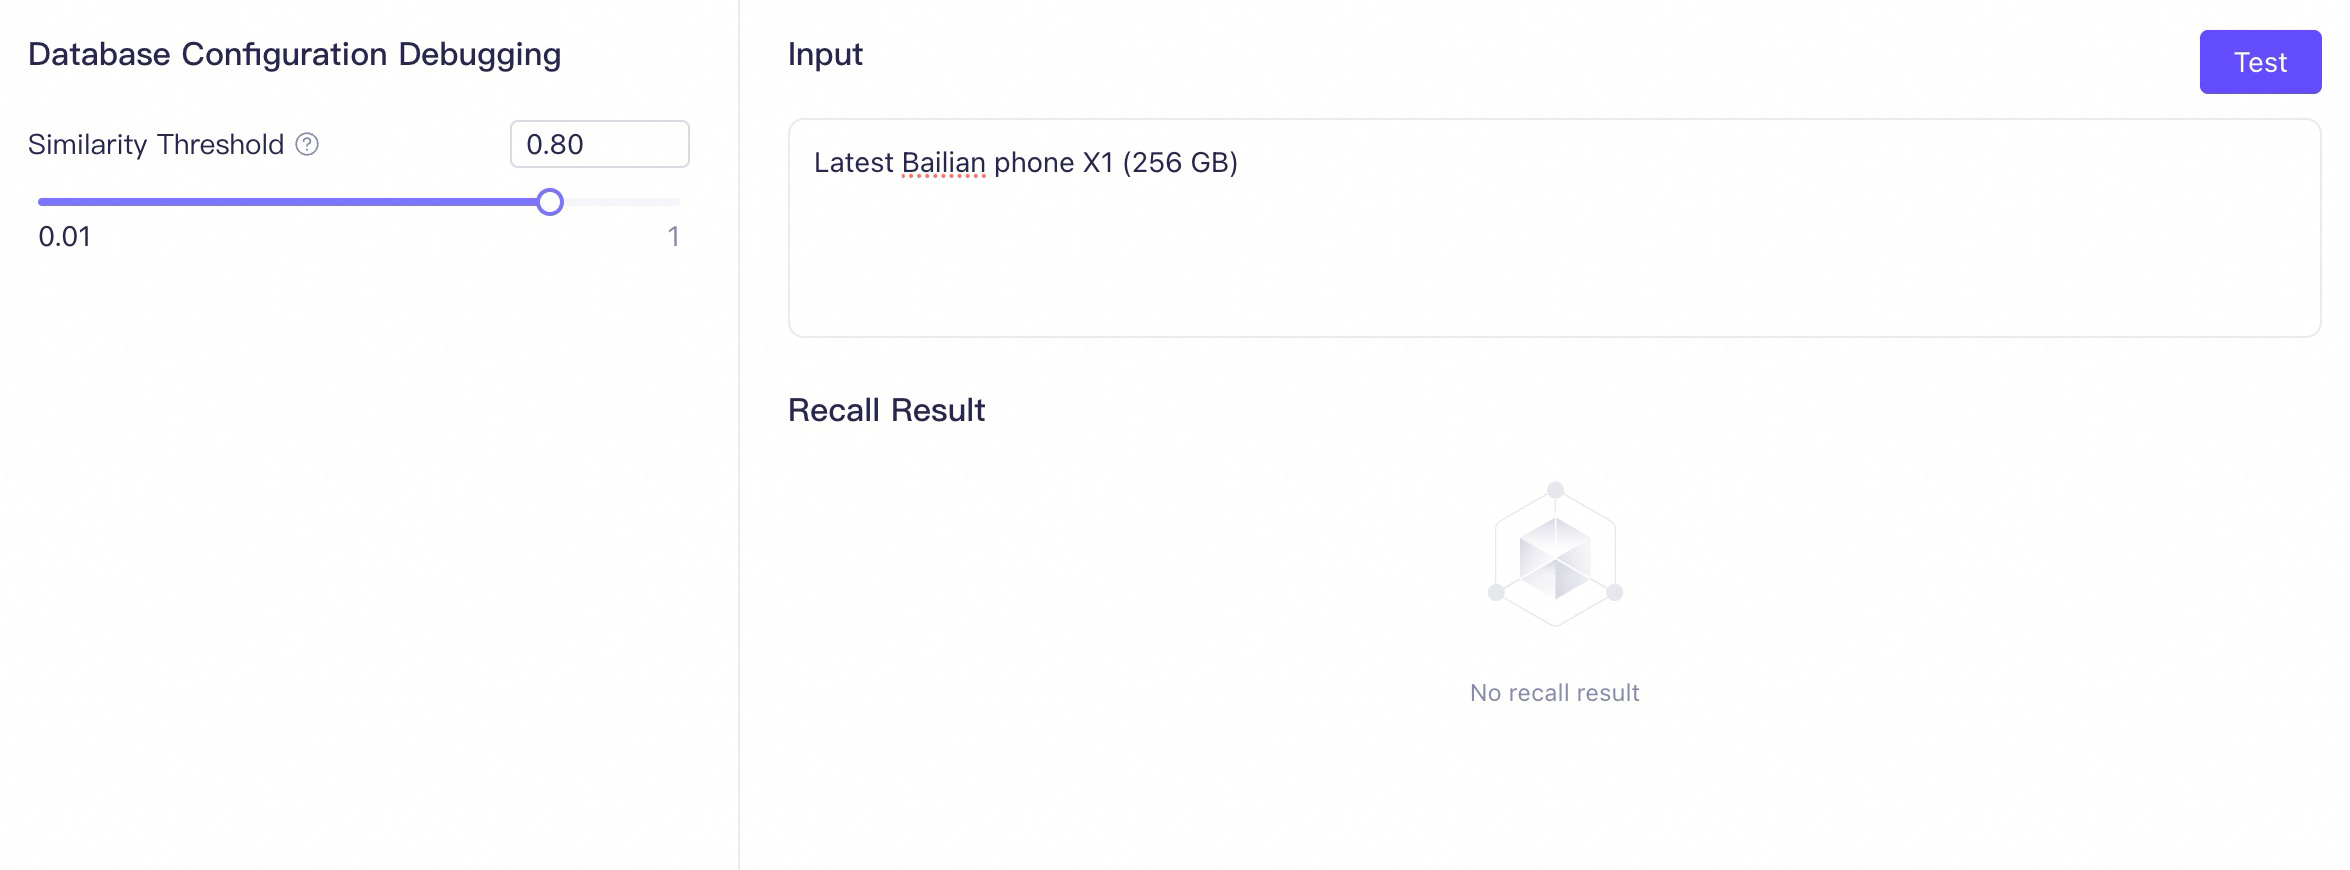
Le seuil optimal dépend de votre scénario. Vous devez tester différents seuils de similarité via des tests de récupération, observer les résultats de rappel et trouver la solution qui correspond le mieux à vos besoins.
| Étapes recommandées pour les tests de récupération | |
|  |
2.3.5 Nombre de blocs rappelés
Le nombre de blocs rappelés correspond à la valeur K dans la stratégie de rappel multicanaux. Après le filtrage basé sur le seuil de similarité, si le nombre de blocs de texte dépasse K, le système sélectionne les K blocs de texte présentant les scores de similarité les plus élevés pour les fournir au modèle. Par conséquent, une valeur K inappropriée peut entraîner l'omission de blocs de texte pertinents par le RAG, ce qui affecte la capacité du modèle à générer une réponse complète.
Par exemple, un utilisateur récupère des informations avec l'invite suivante :
What are the advantages of the Model Studio X1 phone?
Il existe 7 blocs de texte dans la base de connaissances cible qui sont pertinents par rapport à l'invite de l'utilisateur et devraient être renvoyés (marqués en vert à gauche). Toutefois, comme ce nombre dépasse le nombre maximal de blocs rappelés actuellement défini (K), les blocs de texte contenant l'avantage 5 (autonomie ultra-longue) et l'avantage 6 (photos nettes) sont ignorés et ne sont pas fournis au modèle.

Étant donné que le RAG ne peut pas déterminer combien de blocs de texte sont nécessaires pour fournir une réponse « complète », le modèle générera une réponse basée sur les blocs fournis, même s'ils sont incomplets.
De nombreuses expériences montrent que dans des scénarios tels que « Lister... », « Résumer... » et « Comparer X et Y... », il est plus efficace de fournir davantage de blocs de texte de haute qualité (par exemple, K=20) au modèle que de se limiter aux 10 ou 5 premiers. Bien que cela puisse introduire du bruit, si la qualité des blocs de texte est élevée, un modèle performant peut généralement le gérer.
Vous pouvez ajuster le Number of Recalled Chunks lors de la modification d'une application dans Alibaba Cloud Model Studio.
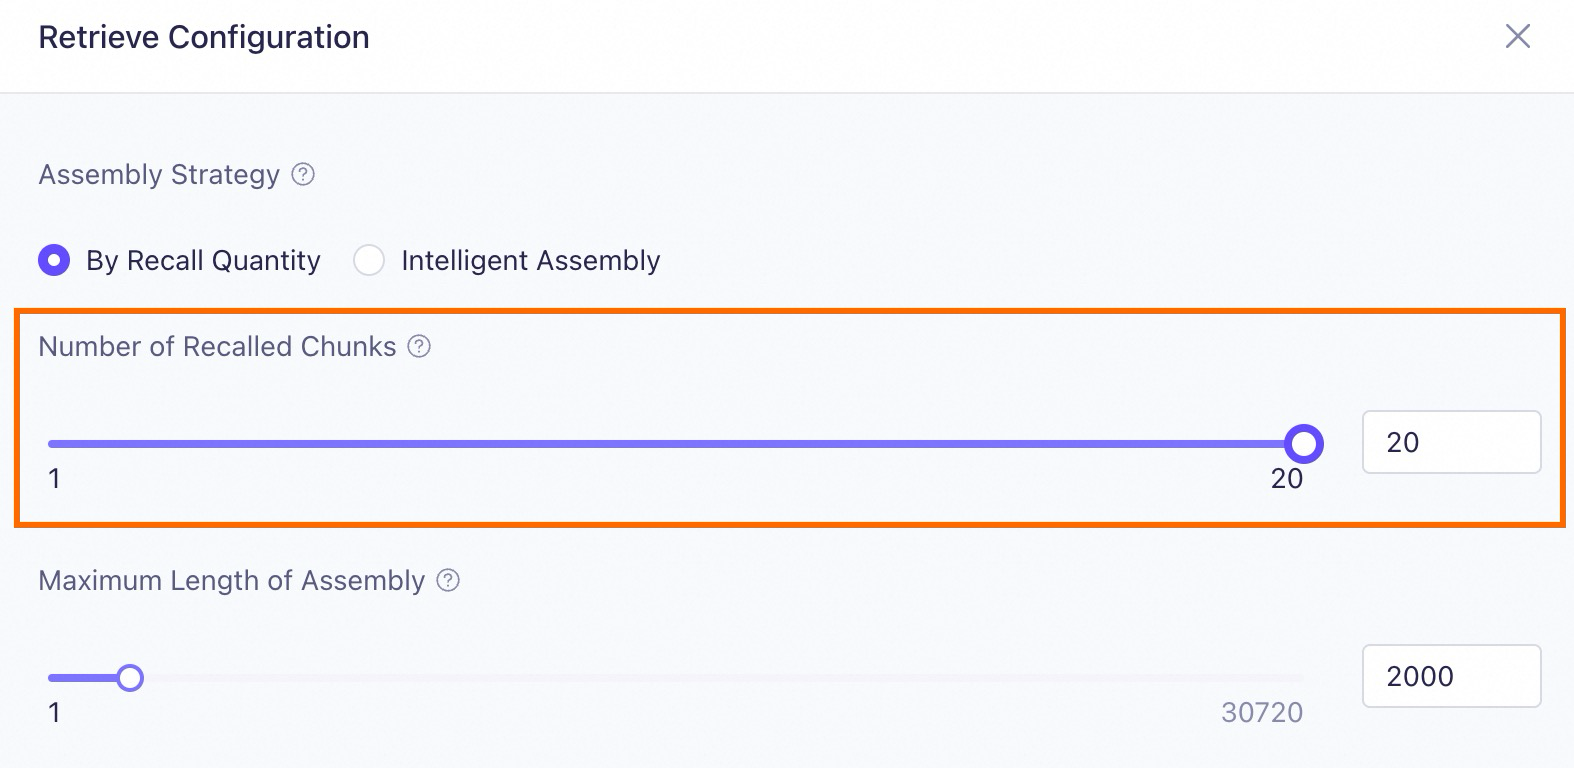
Cependant, un nombre plus élevé de blocs rappelés n'est pas toujours préférable. Parfois, après l'assemblage des blocs de texte rappelés, leur longueur totale peut dépasser la limite de longueur d'entrée du modèle, entraînant une troncature et affectant négativement les performances du RAG.
Sélectionnez Intelligent Assembly. Cette stratégie rappelle autant de blocs de texte pertinents que possible sans dépasser la longueur d'entrée maximale du modèle.
2,4 Génération de réponses
Cette rubrique décrit uniquement les éléments de configuration qu'Alibaba Cloud Model Studio prend en charge pour l'optimisation lors de l'étape de génération de réponses.
À ce stade, le modèle peut générer la réponse finale en se basant sur l'invite de l'utilisateur et le contenu récupéré depuis la base de connaissances. Toutefois, le résultat renvoyé peut encore ne pas répondre à vos attentes.
Type de problème | Stratégie d'amélioration |
|---|---|
Le modèle ne comprend pas la relation entre les connaissances et l'invite de l'utilisateur. La réponse semble être constituée de morceaux de texte disparates assemblés. | Sélectionnez un modèle adapté pour comprendre efficacement la relation entre les connaissances et l'invite de l'utilisateur. |
Le résultat renvoyé ne suit pas les instructions ou n'est pas exhaustif. | |
Le résultat renvoyé n'est pas assez précis. Il contient les connaissances générales propres au modèle et ne s'appuie pas entièrement sur la base de connaissances. | Activez le rejet pour limiter les réponses aux seules connaissances récupérées depuis la base de connaissances. |
Pour des invites similaires, vous souhaitez que les résultats soient soit cohérents, soit variés. |
2.4.1 Sélection du modèle
Les différents grands modèles présentent des capacités variables dans des domaines tels que le respect des instructions, la prise en charge des langues, la gestion de textes longs et la compréhension des connaissances. Cela peut conduire à la situation suivante :
Le Model A n'a pas réussi à comprendre efficacement la relation entre les connaissances récupérées et l'invite, et la réponse générée ne pouvait pas traiter avec précision l'invite de l'utilisateur. Le passage au Model B, qui dispose de plus de paramètres ou de capacités spécialisées plus puissantes, peut résoudre ce problème.
Vous pouvez Select Model lors de la modification d'une application dans Alibaba Cloud Model Studio, en fonction de vos besoins réels.
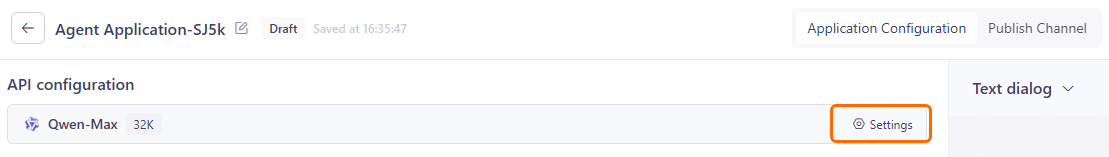
Lorsque vous modifiez une application Alibaba Cloud Model Studio, vous pouvez Select Model en fonction de vos besoins réels. Sélectionnez un modèle commercial de la famille Qwen, tel que Qwen-Max et Qwen-Plus. Ces grands modèles commerciaux disposent des dernières capacités et améliorations par rapport à leurs versions open source.
- Pour les requêtes d'informations simples et la synthèse, les grands modèles avec un petit nombre de paramètres suffisent, tels que
Qwen-Turbo. - Si vous souhaitez que le RAG effectue un raisonnement logique plus complexe, sélectionnez un grand modèle avec plus de paramètres et des capacités de raisonnement plus puissantes, tel que
Qwen-Max. - Si votre requête nécessite de référencer de nombreux extraits de documents, vous devez sélectionner un grand modèle avec une longueur de contexte plus importante, tel que
Qwen-Plus. - Si vous construisez une application RAG pour un domaine spécialisé, tel que le domaine juridique, utilisez un modèle entraîné spécifiquement pour ce domaine, tel que
Qwen-Legal.
2.4.2 Optimisation du modèle d'invite
Vous pouvez influencer le comportement d'un modèle et améliorer les performances du RAG en concevant l'invite qui guide l'utilisation des connaissances récupérées.
Voici trois méthodes d'optimisation courantes :
Méthode 1 : Contraintes sur le contenu de sortieVous pouvez fournir des informations contextuelles, des instructions et le format de sortie attendu dans le modèle d'invite pour guider le modèle. Par exemple, vous pouvez ajouter l'instruction de sortie suivante :
If the information provided is not sufficient to answer the question, state clearly, "Based on the existing information, I cannot answer this question." Do not invent an answer.
Cela réduit la probabilité d'hallucinations du modèle.
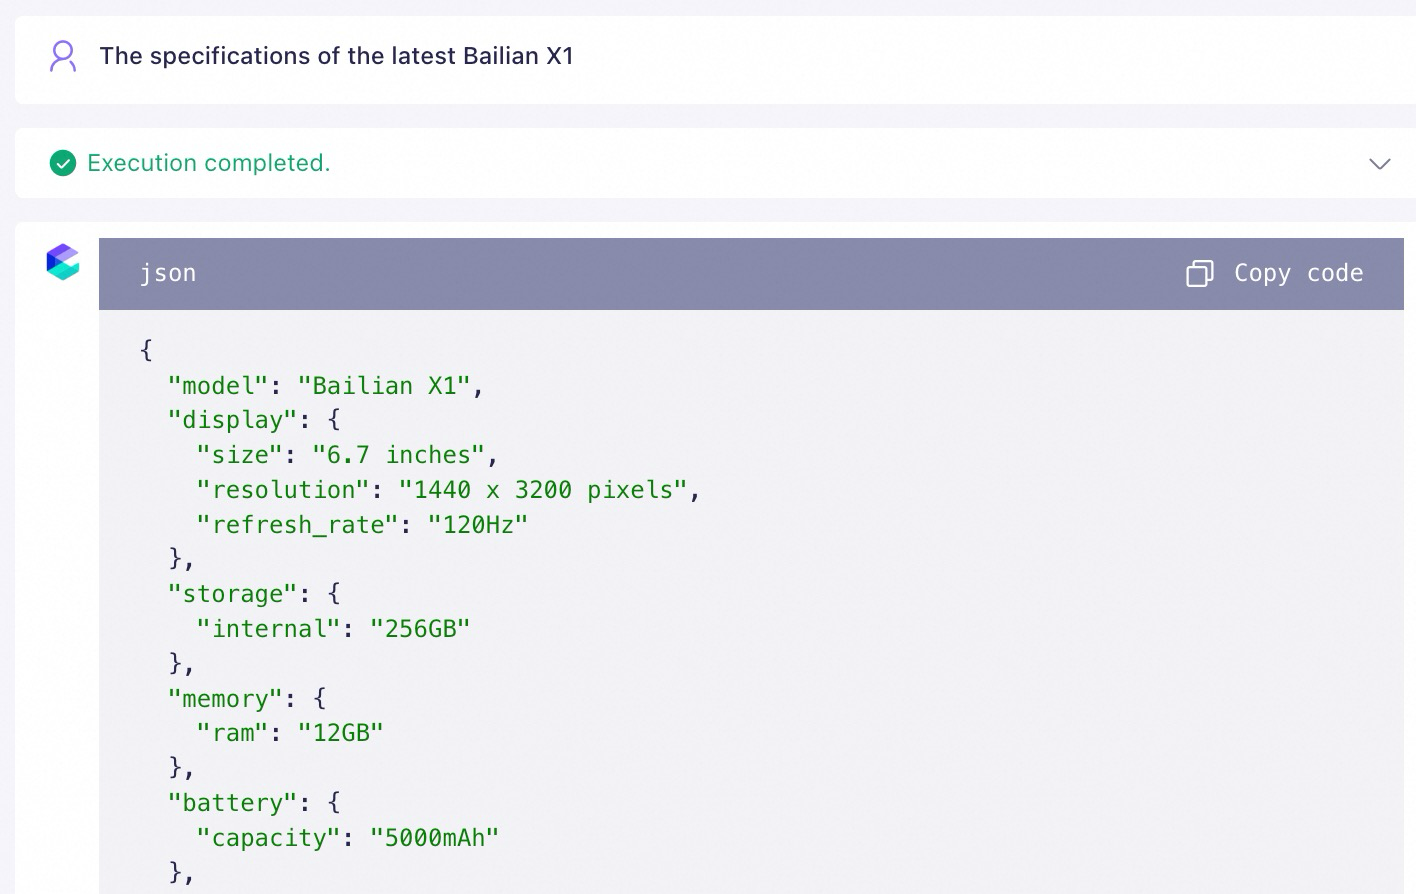
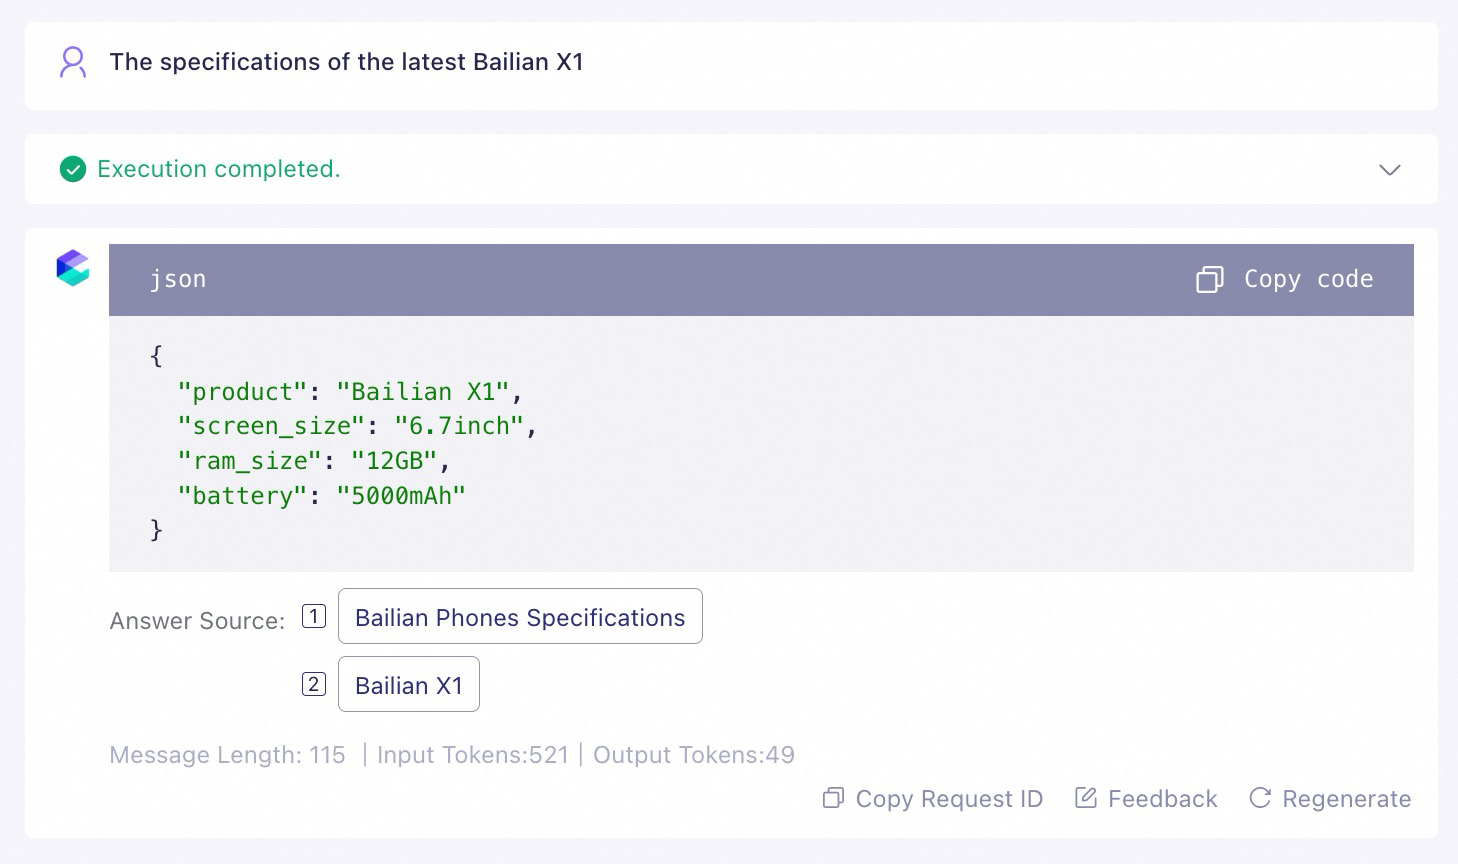
Méthode 2 : Ajout d'exemplesUtilisez la méthode few-shot prompting pour ajouter des exemples de questions-réponses à l'invite afin que le modèle les imite. Cela guide le modèle pour qu'il utilise correctement les connaissances récupérées. L'exemple suivant utilise Qwen-Plus.
| Modèle d'invite | Résultat |
|---|---|
|  |
|  |
Si les blocs de texte récupérés sont mélangés aléatoirement dans un modèle d'invite, il est difficile pour un grand modèle de comprendre la structure globale de l'invite. Séparez clairement l'invite de la variable ${documents}.
De plus, pour garantir les meilleurs résultats, assurez-vous que la variable ${documents} n'apparaît qu'une seule fois dans votre modèle d'invite. Reportez-vous à l'exemple correct ci-dessous à gauche.
# Role
You are a customer service representative, focusing on analyzing and solving user problems and providing accurate solutions by retrieving from the knowledge base.

# Requirements
**Return the result directly**: Please provide a direct result based on the user's prompt and the content in the knowledge base, without
inference.
**Do not include specific contact information in the returned result**: The returned result should only include a summary of the user's prompt, the
names of relevant on-duty personnel, and their responsibilities.
**Default contact**: If no relevant on-duty personnel can be found, please return "On-duty representative today: Model Studio Customer Service 01".

# Knowledge base
Please remember the following materials, they may be helpful in answering the question.
${documents}
# Role
You are a customer service representative, focusing on analyzing and solving user problems and providing accurate solutions by retrieving from the knowledge base.
Please use the information in ${documents} to assist in answering.

# Requirements
**Return the result directly**: Please provide a direct result based on the user's prompt and the content in the knowledge base, without
inference.
**Do not include specific contact information in the returned result**: The returned result should only include a summary of the user's prompt, the
names of relevant on-duty personnel, and their responsibilities.
**Default contact**: If no relevant on-duty personnel can be found, please return "On-duty representative today: Model Studio Customer Service 01".

# Knowledge base
Please remember the following materials, they may be helpful in answering the question.
${documents}
Pour en savoir plus sur les méthodes d'optimisation des invites, consultez la rubrique Prompt engineering.
2.4.3 Rejet
Si vous souhaitez que les résultats renvoyés par votre application Alibaba Cloud Model Studio soient strictement basés sur les connaissances récupérées depuis la base de connaissances, et exclure l'influence des connaissances générales propres au modèle, vous pouvez définir la portée de la réponse sur Knowledge Base Only lors de la modification de l'application.
Dans les cas où aucune connaissance pertinente n'est trouvée dans la base de connaissances, vous pouvez également définir une réponse automatique fixe.
Portée de la réponse : Knowledge Base + LLM Knowledge | Portée de la réponse : Knowledge Base Only |
|
|
Le résultat renvoyé par l'application Alibaba Cloud Model Studio sera une combinaison des connaissances récupérées depuis la base de connaissances et des connaissances générales propres au modèle. | Le résultat renvoyé par l'application Alibaba Cloud Model Studio sera strictement basé sur les connaissances récupérées depuis la base de connaissances. |


Pour déterminer la portée des connaissances, choisissez la méthode Search Threshold + LLM Judgement. Cette stratégie filtre d'abord les blocs de texte potentiels à l'aide d'un seuil de similarité. Ensuite, un modèle agit comme arbitre, en utilisant l'Judgment Prompt que vous avez défini pour effectuer une analyse approfondie de la pertinence. Cela améliore encore la précision du jugement.
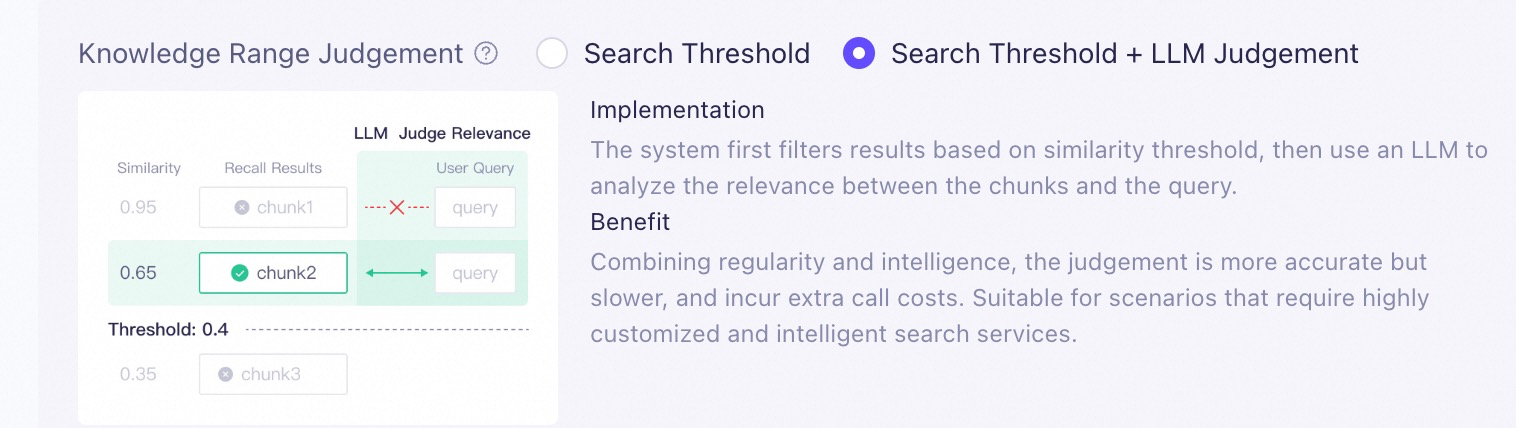
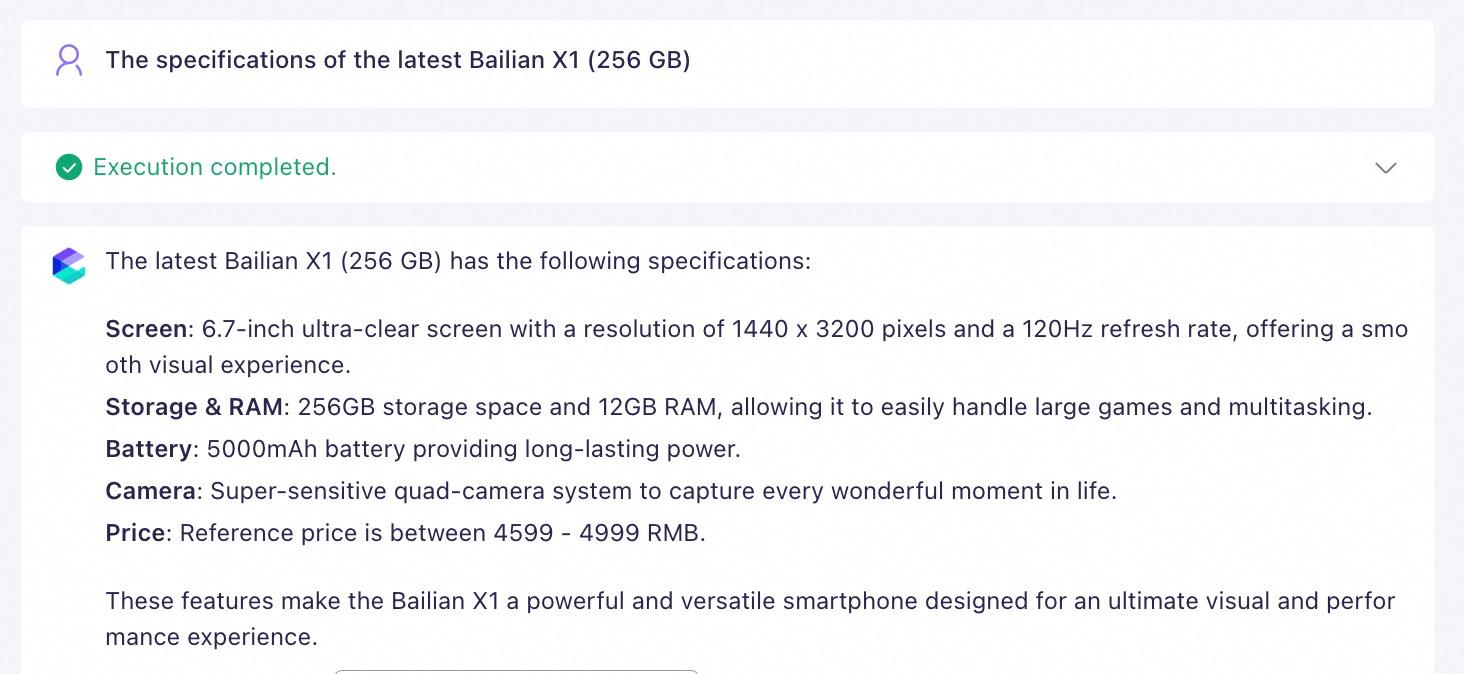
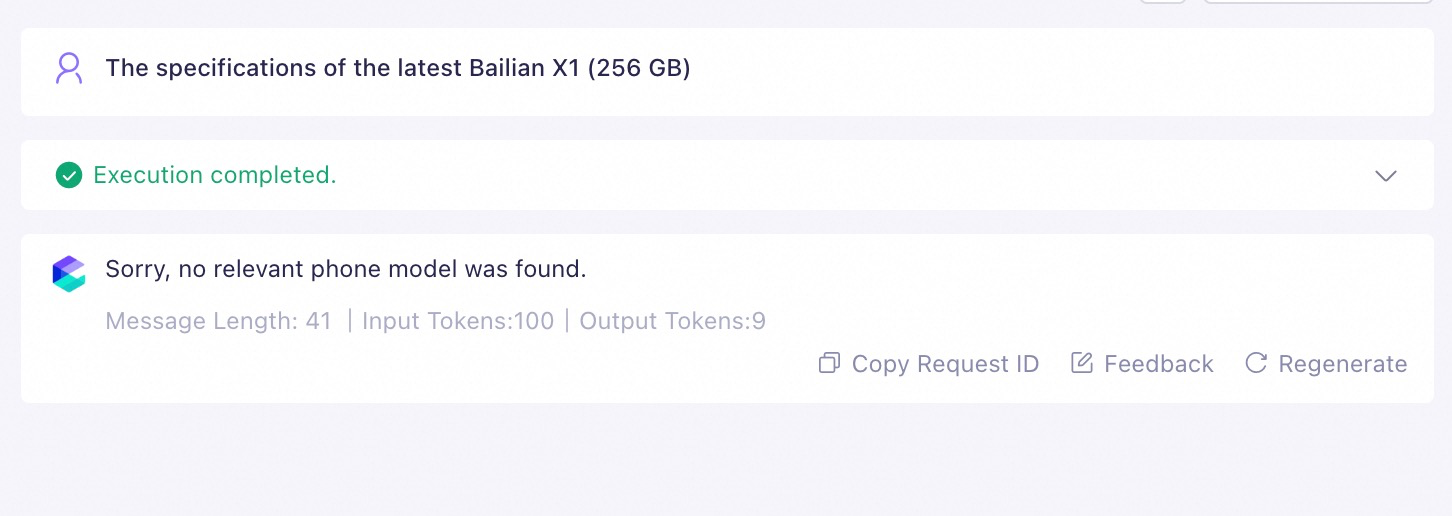
Voici un exemple d'invite de détermination à titre de référence. De plus, lorsqu'aucune connaissance pertinente n'est trouvée dans la base de connaissances, définissez une réponse fixe : Sorry, no relevant phone models were found.
# Judgment rules:
- The premise for a match between the question and the document is that the entity involved in the question is exactly the same as the entity described in the document.
- The question is not mentioned at all in the document.
Requête réussie | Requête infructueuse |
|---|---|
|
|
2.4.4 Paramètres du modèle
Pour contrôler si le modèle fournit des réponses cohérentes ou variées à des invites similaires, vous pouvez modifier les Configure Parameters afin d'ajuster les paramètres du modèle lors de la modification de l'application.
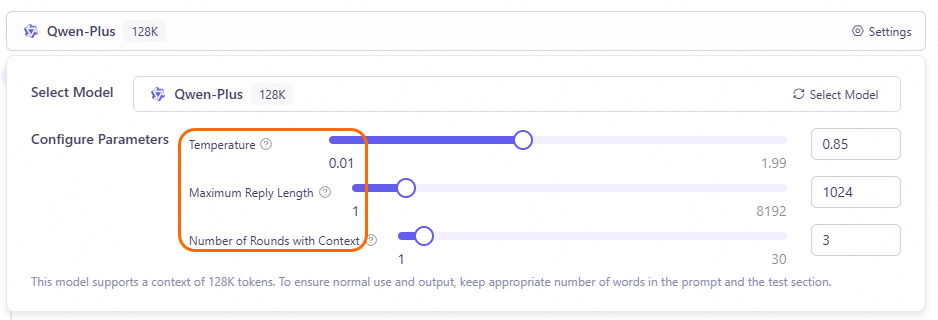
Le paramètre temperature illustré ci-dessus contrôle le caractère aléatoire du contenu généré par le modèle. Plus la température est élevée, plus le texte généré est diversifié ; inversement, le texte est plus déterministe.
- Un texte diversifié convient à la rédaction créative (comme les romans et les publicités), au brainstorming et aux scénarios d'applications de chat.
- Un texte déterministe convient aux scénarios avec des réponses claires (comme l'analyse de problèmes, les questions à choix multiples et la recherche de faits) ou nécessitant une formulation précise (comme les documents techniques, les textes juridiques, les articles de presse et les publications académiques).
Les deux autres paramètres sont les suivants :
Maximum response length : ce paramètre contrôle le nombre maximal de jetons générés par le modèle. Vous pouvez augmenter cette valeur pour générer des descriptions détaillées ou la diminuer pour générer des réponses courtes.
Number of context turns : ce paramètre contrôle le nombre de tours de conversation historiques auxquels le modèle se réfère. Lorsqu'il est défini sur 1, le modèle ne tient pas compte des informations de conversation historiques lors de la réponse.
3. FAQ
Comment formater les documents pour optimiser le RAG ?
- Utilisez des niveaux de titres clairs. Assurez-vous que le contenu sous chaque titre est clair et autonome.
- Évitez les filigranes.
- Évitez d'imbriquer des niveaux de liste sous un élément au milieu d'une liste.
- Évitez autant que possible les tableaux et les images, car les tableaux complexes peuvent affecter la qualité de l'analyse.
Le titre de niveau 1 est « IV. Prize usage rules: », et le contenu inclut « Prize 1:... » et « Prize 2:... ».
 Problème après traitement
« Prize 2:... » est analysé comme un sous-titre de « Prize 1:... ». Définissez « Prize 1:... » et « Prize 2:... » comme des titres numérotés de niveau 2 dans le document.
Filigranes dans un document : exempleDocument originalLe document contient un filigrane et comprend trois éléments au total.
 Problème après traitement
Le troisième élément est divisé en un seul bloc. Cependant, comme le filigrane est reconnu comme du texte, des mots supplémentaires tels que « Government Gazette » apparaissent après « (V) Grade 11 farmland: CNY 120,000/acre ». Comme le filigrane « Government Gazette » apparaît tôt dans le texte, il peut également perturber l'ordre des éléments (I) à (V), le transformant en (I), (V), (III), (IV), (II).
Listes imbriquées sous un élément intermédiaire : exempleDocument originalSous le titre de niveau 1 « Activity rules » se trouve une liste ordonnée. Le troisième élément, « Activity introduction », inclut une autre liste (éléments a et b).
 Problème après traitement
Étant donné que le troisième élément contient une liste imbriquée, « Activity introduction » peut être interprété à tort comme un titre de niveau 2, et tout le contenu suivant est regroupé sous celui-ci. Évitez d'imbriquer des listes. Si nécessaire, placez la liste imbriquée à la fin de la liste parente.
Bon exemple- Le contenu sous chaque titre est clair et relativement indépendant.
- Aucun filigrane.
- Une liste apparaît sous le titre, mais elle ne contient pas de listes imbriquées.
- Aucun tableau ni image.