Pour prendre en charge l'architecture intégrée de stockage et de traitement complet et incrémentiel, les tables Delta proposent un format de données de table unifié. Elles prennent en charge toutes les fonctionnalités des tables standard MaxCompute et conviennent aux nouveaux scénarios impliquant un traitement incrémentiel, tels que les requêtes de voyage dans le temps (time travel) et les opérations UPSERT. Cette rubrique décrit le format des données de table des tables Delta.
Principales propriétés de table des tables Delta
Seules les tables Delta dotées d'une clé primaire sont prises en charge. Pour créer une table Delta avec une clé primaire via une instruction CREATE TABLE, configurez les propriétés clés suivantes : primary key et tblproperties ("transactional"="true").
primary key: Une fois cette propriété configurée, vous pouvez importer des données efficacement en mode UPSERT. Les lignes partageant la même clé primaire sont fusionnées en une seule après une requête basée sur un snapshot ou l'opération de compaction ; seul l'état le plus récent est conservé.
tblproperties ("transactional"="true") : La propriété transactionnelle garantit les caractéristiques ACID (atomicité, cohérence, isolation et durabilité), assurant l'isolation des snapshots et le contrôle des accès concurrents en lecture/écriture. Un champ de propriété transactionnelle est ajouté à chaque ligne écrite. Par exemple, un champ d'horodatage permet de récupérer les enregistrements de la version de données requise lors des requêtes de voyage dans le temps.
Vous pouvez également configurer d'autres propriétés importantes. Définissez par exemple la propriété write.bucket.num pour spécifier le degré de parallélisme d'écriture, et la propriété acid.data.retain.hours pour indiquer la plage de temps valide pour l'interrogation des données historiques. Pour plus d'informations, consultez la section Paramètres des tables Delta.
Formats de fichiers pris en charge par les tables Delta
Les tables Delta prennent en charge plusieurs formats de fichiers, garantissant une haute efficacité tant pour les scénarios de lecture/écriture complets que pour les scénarios incrémentiels en quasi-temps réel. Les formats pris en charge incluent les fichiers de base et les fichiers delta.
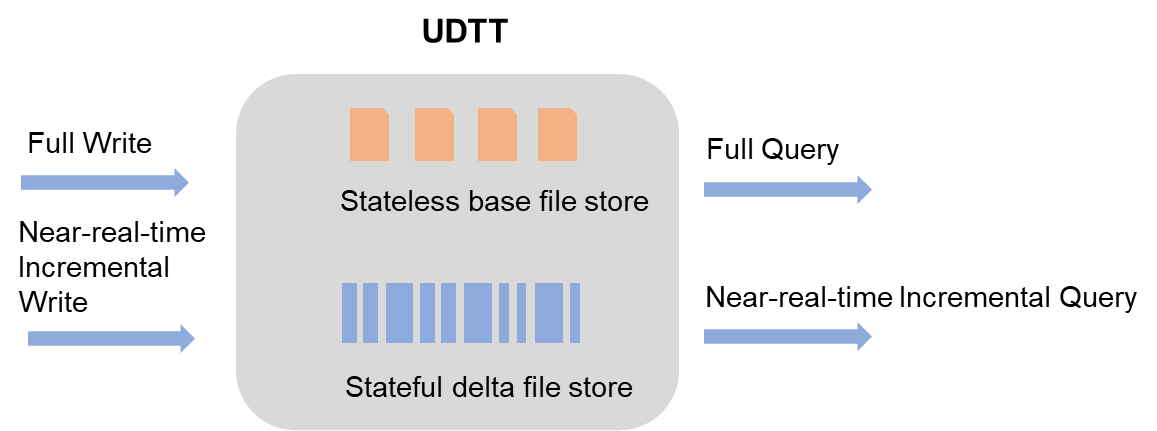
Description des fichiers de base et des fichiers delta :
Fichier delta : fichier généré à chaque validation de transaction lors d'écritures en mode UPDATE ou DELETE. Il stocke l'état historique intermédiaire de chaque ligne pour répondre aux exigences de lecture/écriture incrémentielles en quasi-temps réel. Un fichier delta est également généré à chaque opération de clustering. Les fichiers delta utilisent un stockage orienté colonnes avec compression.
Fichier de base : fichier généré après l'opération de compaction des fichiers delta. L'état historique intermédiaire y est supprimé ; une seule ligne est conservée pour les enregistrements partageant la même clé primaire. Les fichiers de base utilisent un stockage orienté colonnes avec compression pour optimiser les requêtes sur l'intégralité des données.
Lors de l'interrogation des données d'une table Transaction Table 2.0, tenez compte des points suivants :
MaxCompute identifie le fichier de base le plus récent à chaque requête basée sur un snapshot. Il recherche ensuite tous les fichiers delta écrits après la génération de ce fichier de base et fusionne leurs données. Le mode de requête est donc Merge On Read (MOR). Pour plus d'informations, consultez la section Requêtes de voyage dans le temps et requêtes incrémentielles.
Tous les fichiers de données sont triés selon la valeur de la colonne de clé primaire. Cela améliore l'efficacité de la fusion et optimise les requêtes avec saut de données (data skipping). Le stockage orienté colonnes avec compression réduit le volume de données stockées, diminue les coûts et améliore l'efficacité des E/S.
Buckets
Pour améliorer encore l'efficacité des lectures et écritures, les tables Delta permettent de partitionner le stockage selon la colonne d'index de bucket. Par défaut, cette colonne réutilise les données de la clé primaire. Configurez la propriété write.bucket.num pour spécifier le nombre de buckets. Les données écrites dans la même table ou partition sont ainsi réparties selon la valeur de la clé primaire. Les enregistrements partageant la même clé primaire résident dans le même bucket.
L'importation incrémentielle en quasi-temps réel prend en charge une forte concurrence grâce au scaling horizontal du nombre de buckets. Évaluez et spécifiez un nombre raisonnable de buckets en fonction du trafic d'écriture et de la taille totale des données. Un nombre excessif de buckets génère trop de petits fichiers, ce qui nuit à l'efficacité des E/S et à la stabilité du stockage. Un nombre insuffisant risque de ne pas satisfaire les exigences d'importation à haut débit et haute vitesse.
Cette fonctionnalité améliore également l'efficacité des requêtes. Si le filtre s'applique à la colonne d'index de bucket, l'élagage de bucket (bucket pruning) réduit efficacement le volume de données interrogées. Si la colonne clé d'une clause GROUP BY ou d'une jointure JOIN correspond à la colonne d'index de bucket, vous pouvez effectuer directement des jointures locales ou des regroupements GROUP BY. Cela réduit le brassage de données (shuffling), économise les ressources de calcul et améliore les performances.
Les opérations d'optimisation, telles que le clustering et la compaction des petits fichiers, s'exécutent en parallèle par bucket, améliorant l'efficacité et réduisant le temps de traitement.
Types d'enregistrement
Seuls les enregistrements de type UPSERT et DELETE peuvent être écrits et stockés. Le type UPSERT englobe deux sémantiques implicites : INSERT et UPDATE. Si l'enregistrement n'existait pas auparavant, le type est INSERT. S'il existe déjà, le type est UPDATE.