Les tables Delta dans MaxCompute permettent l'importation de données en quasi-temps réel à la minute près. En cas de volume d'écriture élevé, cette approche génère de nombreux petits fichiers incrémentiels et accumule des états intermédiaires redondants issus des opérations UPDATE et DELETE. Pour résoudre automatiquement ces problèmes, MaxCompute exécute trois services en arrière-plan : le clustering, la compaction et la récupération d'espace disque (data reclamation).
Fonctionnement
Chaque service cible une couche différente du problème d'organisation des données :
|
Service |
Problème résolu |
Déclencheur |
|
Clustering |
Accumulation de petits DeltaFiles qui augmentent les coûts de stockage, la charge d'E/S et la fréquence des mises à jour des métadonnées |
Automatique, selon l'état du système |
|
Compaction |
Enregistrements intermédiaires redondants issus des opérations UPDATE et DELETE, qui gonflent le stockage et ralentissent les requêtes sur l'instantané complet |
Fréquence déterminée par les besoins métier et les caractéristiques des données |
|
Data reclamation |
Versions historiques des données qui s'accumulent au-delà de leur durée d'utilité |
Automatique via la politique de rétention ; manuel via |
Ces trois services interagissent avec le Meta Service, qui garantit la sécurité transactionnelle de toutes les opérations : détection des conflits, coordination des mises à jour des métadonnées et récupération des anciens fichiers.
Clustering
Le clustering est exécuté par le service de stockage interne de MaxCompute. Il fusionne les petits DeltaFiles sans modifier aucun état intermédiaire historique : l'historique intermédiaire d'aucun enregistrement n'est éliminé.
Fonctionnement du clustering
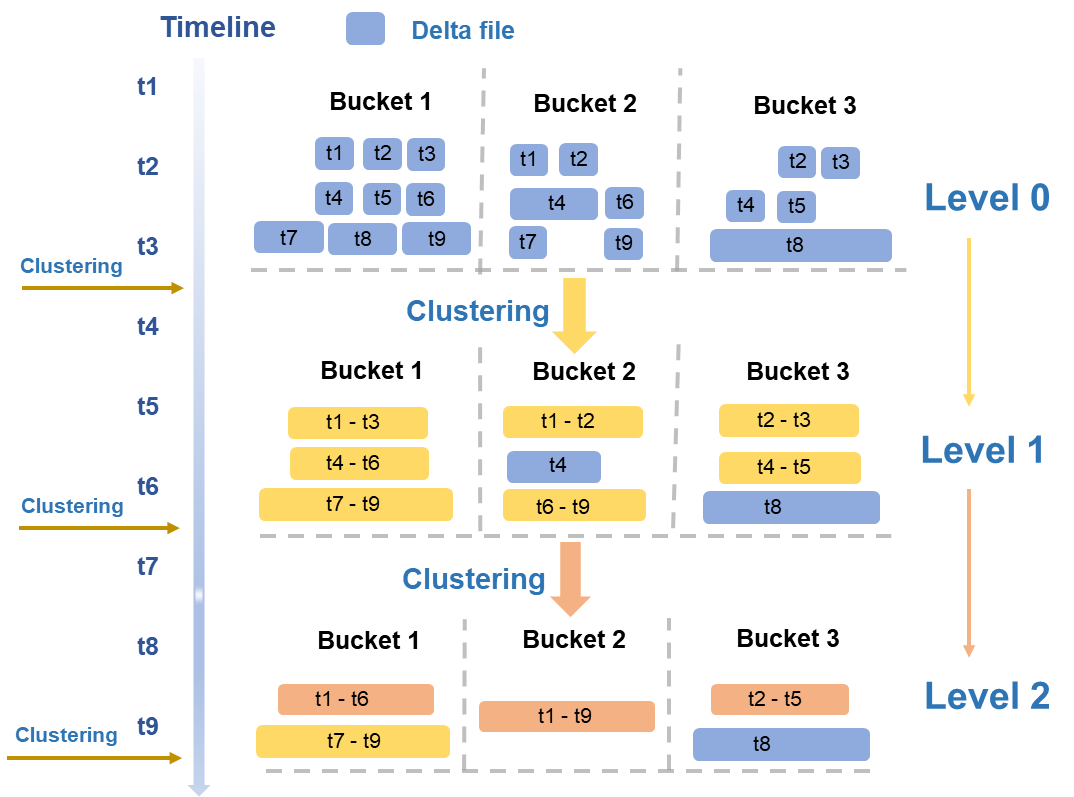
Le clustering utilise une stratégie de fusion hiérarchique basée sur les modèles de lecture/écriture typiques. Les fichiers sont évalués périodiquement selon plusieurs dimensions, notamment leur taille et leur quantité, puis fusionnés par niveaux :
Niveau 0 vers niveau 1 : Les plus petits DeltaFiles issus des écritures initiales (en bleu sur la figure) sont fusionnés pour former des DeltaFiles de taille moyenne (en jaune).
Niveau 1 vers niveau 2 : Lorsque les DeltaFiles de taille moyenne atteignent une échelle suffisante, une fusion de niveau supérieur est déclenchée pour produire des fichiers plus volumineux et optimisés (en orange).
Après la fusion, les coûts de stockage diminuent, la charge d'E/S baisse et la fréquence des mises à jour des métadonnées est réduite. Cela résout directement les problèmes d'accumulation de petits fichiers qui surviennent lors d'écritures incrémentielles à haut débit.
Contrôles de l'amplification en lecture/écriture
Chaque opération de clustering lit et écrit des données au moins une fois, ce qui consomme des ressources de calcul et d'E/S. Trois mécanismes limitent l'amplification inutile :
Isolation des fichiers volumineux : Les fichiers dépassant un seuil de taille (comme le fichier T8 dans Bucket3 sur la figure) sont exclus de la fusion.
Limitation de la plage temporelle : Les fichiers couvrant une grande plage temporelle ne sont pas fusionnés. Cela empêche les fonctionnalités Time Travel et les requêtes incrémentielles de lire de grands volumes de données historiques en dehors de la plage de requête.
Déclenchement automatique : Le moteur MaxCompute évalue l'état du système et déclenche automatiquement le clustering. Aucune intervention manuelle n'est requise.
Concurrence et sécurité transactionnelle
Étant donné que les données sont partitionnées et stockées par BucketIndex, le clustering s'exécute simultanément au niveau des buckets, ce qui réduit considérablement le temps d'exécution total.
Après chaque exécution, le clustering transmet au Meta Service les informations concernant les nouveaux et les anciens fichiers de données. Le Meta Service détecte les conflits transactionnels, coordonne la mise à jour transparente des métadonnées pour les nouveaux et anciens fichiers, et récupère les anciens fichiers de données.
Compaction
Les tables Delta prennent en charge les opérations UPDATE et DELETE, mais celles-ci ne modifient pas les enregistrements sur place. Chaque opération écrit plutôt un nouvel enregistrement qui marque l'état précédent de l'ancien enregistrement. Avec le temps, cela entraîne :
Redondance des données : Les enregistrements intermédiaires s'accumulent, augmentant les coûts de stockage et de calcul.
Baisse de l'efficacité des requêtes : Les requêtes sur l'instantané complet doivent traiter davantage d'enregistrements pour déterminer l'état actuel.
La compaction fusionne certains BaseFiles et DeltaFiles, combine tous les enregistrements partageant la même clé primaire et ne conserve que le dernier état. Le résultat est un nouveau BaseFile contenant uniquement des données INSERT : tous les états intermédiaires UPDATE et DELETE sont éliminés.
Fonctionnement de la compaction
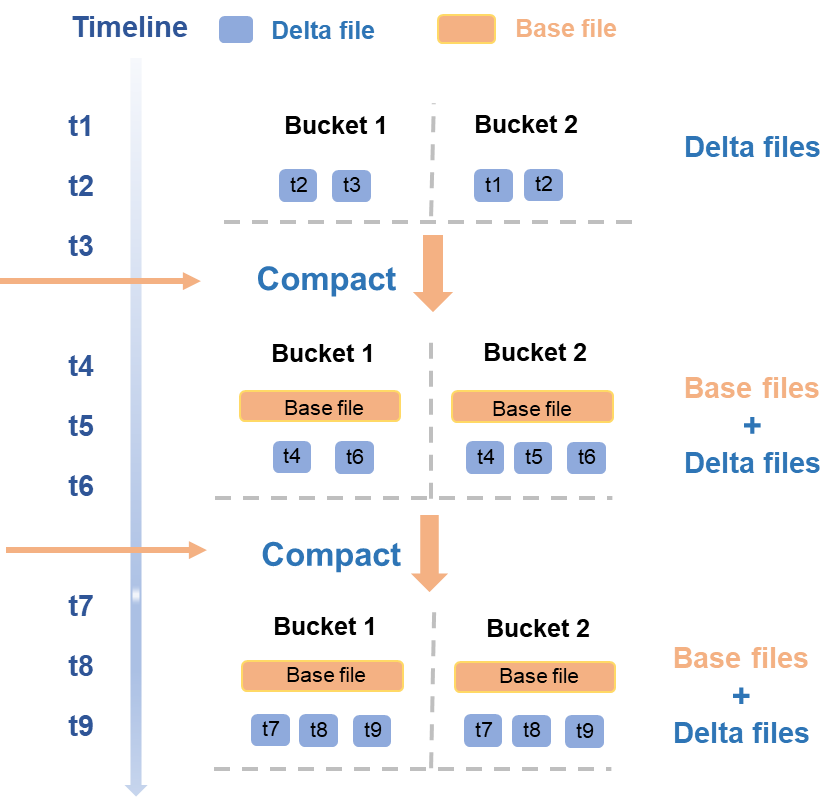
La compaction s'exécute simultanément au niveau des buckets et suit une chronologie des opérations déclenchées :
De t1 à t3, un nouveau lot de DeltaFiles est écrit. Cela déclenche une compaction qui fusionne ces DeltaFiles en un nouveau BaseFile pour chaque bucket.
À t4 et t6, un autre lot de DeltaFiles est écrit. La compaction suivante fusionne le BaseFile existant avec les nouveaux DeltaFiles pour produire un BaseFile mis à jour.
Comme pour le clustering, la compaction interagit avec le Meta Service après chaque exécution : le Meta Service détecte les conflits transactionnels, met à jour atomiquement les métadonnées des nouveaux et anciens fichiers, et récupère les anciens fichiers de données.
Choix de la fréquence de compaction
La compaction réduit les coûts de stockage et de calcul en éliminant les états intermédiaires des enregistrements, ce qui accélère directement les requêtes sur l'instantané complet. Toutefois, une exécution fréquente a un coût :
Chaque exécution nécessite d'importantes ressources de calcul et d'E/S.
Le nouveau BaseFile requiert un stockage supplémentaire.
Les DeltaFiles historiques nécessaires à la fonctionnalité Time Travel ne peuvent pas être supprimés immédiatement ; ils continuent donc d'engendrer des coûts de stockage jusqu'à l'expiration de la période de rétention.
Définissez la fréquence de compaction en fonction de l'intensité des opérations UPDATE et DELETE dans votre charge de travail :
|
Modèle de charge de travail |
Approche recommandée |
|
Opérations UPDATE/DELETE fréquentes avec une forte exigence de vitesse pour les requêtes sur l'instantané complet |
Augmentez la fréquence de compaction |
|
Taux faible d'opérations UPDATE/DELETE ou requêtes sur l'instantané complet peu fréquentes |
Exécutez la compaction moins fréquemment pour réduire la consommation de ressources |
Data reclamation
Les tables Delta conservent les versions historiques des données pour prendre en charge les fonctionnalités Time Travel et les requêtes incrémentielles. La data reclamation supprime les versions qui ne sont plus nécessaires.
Recommandé : configurer une politique de rétention
Définissez la période de rétention des données à l'aide de la propriété de table acid.data.retain.hours. Les données historiques plus anciennes que cette valeur sont automatiquement récupérées. Après la récupération, cette version ne peut plus être interrogée via Time Travel. Les données récupérées se composent principalement de journaux d'opérations et de fichiers de données.
Si une table Delta reçoit continuellement de nouveaux DeltaFiles, aucun DeltaFile ne peut être supprimé, car d'autres DeltaFiles peuvent avoir des dépendances d'état vis-à-vis de ceux-ci. Après une opération COMPACTION ou InsertOverwrite, les fichiers générés par la suite ne dépendent plus des DeltaFiles précédents et peuvent être récupérés une fois la période de requête Time Travel expirée.
Optionnel : forcer un nettoyage anticipé
Dans des scénarios particuliers, utilisez la commande PURGE pour déclencher manuellement un nettoyage forcé des données historiques.
Sauvegarde automatique
Si la compaction n'est pas exécutée pendant une période prolongée, les données historiques peuvent croître sans limite, bloquant finalement la récupération. Pour éviter cela, le moteur MaxCompute exécute périodiquement une compaction automatique sur les BaseFiles ou DeltaFiles plus anciens que la période de rétention Time Travel configurée. Cela garantit le bon fonctionnement du mécanisme de récupération.