Lorsque votre pipeline de données connecte des bases de données, des systèmes de journalisation ou des files d'attente de messages à MaxCompute, les chargements par lots introduisent une latence qui rend les données récentes indisponibles pour les requêtes. L'écriture incrémentale en quasi temps réel résout ce problème en écrivant continuellement les lignes entrantes dans une table delta à des intervalles de l'ordre de la minute. Les données validées sont ainsi immédiatement interrogeables, sans attendre un cycle de chargement complet.
Choisir un mode d'écriture
|
Mode d'écriture |
Latence |
Cas d'utilisation |
|
Écriture incrémentale en quasi temps réel |
De l'ordre de la minute |
Flux de données continus ; nécessite une faible latence et une tolérance aux pannes |
|
Écriture complète des données |
Plus élevée |
Chargements par lots périodiques ; l'ensemble du jeu de données est remplacé en une seule fois |
Fonctionnement
MaxCompute met à disposition un plug-in de connecteur Flink open source qui s'intègre à Data Integration de DataWorks et à d'autres outils d'importation de données pour prendre en charge les écritures incrémentales en quasi temps réel.
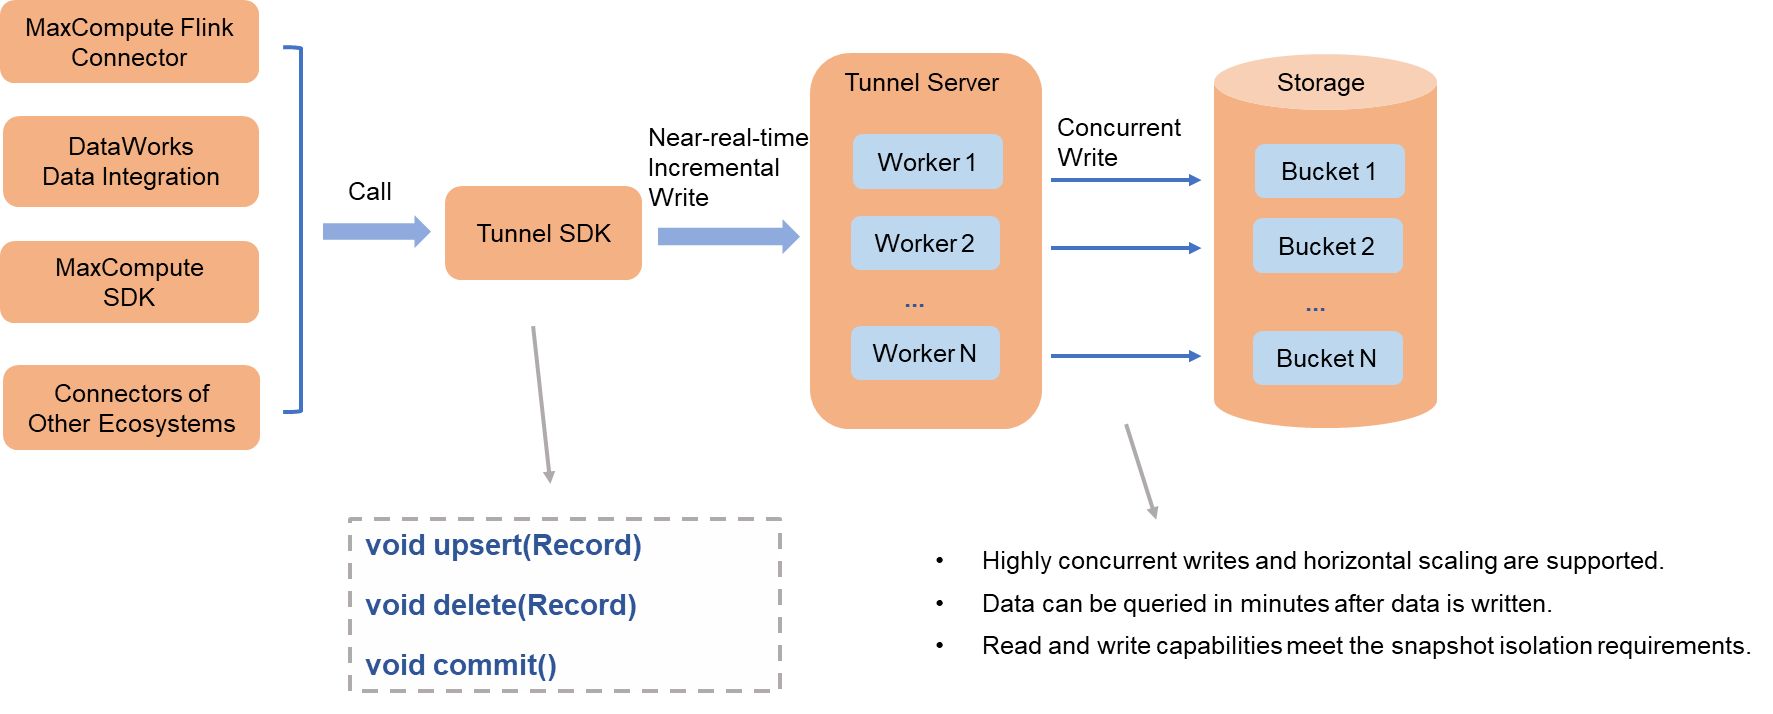
La figure précédente illustre le traitement des données métier.
Le flux de données fonctionne comme suit :
Un outil d'importation de données utilise le client SDK du service Tunnel de MaxCompute pour écrire les données simultanément sur le serveur Tunnel, à des intervalles de l'ordre de la minute.
Le serveur Tunnel répartit les écritures sur plusieurs nœuds de travail. Ces nœuds écrivent les données en parallèle dans les fichiers de chaque compartiment (bucket).
Lorsque l'outil d'importation appelle l'interface de validation (commit), toutes les données écrites jusqu'à cet instant sont validées de manière atomique dans la table delta et deviennent immédiatement interrogeables.
Contrôle de la concurrence
Définissez le paramètre write.bucket.num pour contrôler la concurrence d'écriture. Un nombre plus élevé de compartiments augmente le débit d'écriture. Pour plus de détails sur l'impact des compartiments sur les performances, consultez la rubrique Format des données de table.
Opérations prises en charge
L'interface d'écriture du SDK Tunnel prend en charge les opérations suivantes :
|
Opération |
Description |
|
UPSERT |
Insérer une nouvelle ligne ou mettre à jour une ligne existante |
|
DELETE |
Supprimer une ligne de la table delta |
Sémantique de validation et tolérance aux pannes
Chaque appel à l'interface de validation entraîne la validation atomique de toutes les données écrites avant l'appel. Les données validées satisfont à l'isolation des instantanés en lecture/écriture.
En cas de succès : Les données validées sont immédiatement interrogeables et satisfont à l'isolation des instantanés en lecture/écriture.
En cas d'échec : Si l'appel échoue, vous pouvez réessayer d'écrire les données. Si l'échec n'est pas causé par une erreur irrécupérable, telle qu'une corruption de données, la nouvelle tentative peut aboutir sans qu'il soit nécessaire de réécrire les données. Dans le cas contraire, vous devez réécrire et revalider les données.
|
Type d'échec |
Action de récupération |
|
Non irrécupérable (par exemple, non causé par une corruption de données) |
Réessayez directement la validation — aucune réécriture des données n'est nécessaire |
|
Irrécupérable (par exemple, corruption de données ou erreur permanente) |
Réécrivez les données et revalidez-les |
Étapes suivantes
Format des données de table — découvrez comment les compartiments affectent les performances d'écriture
Plug-in de connecteur Flink — configurez le connecteur open source pour les écritures incrémentales