Le traitement des données relatives au comportement des utilisateurs s'avère complexe en raison de leur volume élevé et de la diversité de leurs formats. Les modèles traditionnels de tables larges offrent des performances de requête efficaces, mais au prix d'une forte redondance des données, d'une augmentation des coûts de stockage et de cycles de maintenance lents. Cette rubrique explique comment utiliser Realtime Compute for Apache Flink, ApsaraDB for MongoDB et Hologres pour mettre en place un pipeline de table large en temps réel qui répond à ces compromis.
Fonctionnement
Realtime Compute for Apache Flink gère le traitement des flux de données. ApsaraDB for MongoDB stocke les tables de faits et de dimension sous forme de base de données NoSQL orientée documents, offrant une flexibilité de schéma et un débit lecture/écriture élevé. Hologres sert d'entrepôt de données analytiques : les données sont interrogables immédiatement après leur écriture.
Le pipeline utilise deux tâches Flink connectées par un topic Kafka :
Tâche 1 lit le flux CDC (Change Data Capture) depuis MongoDB. Lorsque la table de faits (
game_sales) change, ses clés primaires (PK) sont transmises directement à Kafka. Lorsqu'une table de dimension change, une jointure de recherche identifie les enregistrements concernés dans la table de faits et envoie leurs PK à Kafka.Tâche 2 consomme les PK depuis Kafka, effectue des jointures de recherche sur les tables de faits et de dimension MongoDB pour reconstruire l'enregistrement complet de la table large, puis upserte le résultat dans Hologres.

Avantages :
Débit d'écriture élevé : ApsaraDB for MongoDB gère les lectures et écritures hautement concurrentes dans des clusters fragmentés, adaptant les performances et le stockage pour accueillir de grands volumes de mises à jour fréquentes.
Propagation efficace des modifications : Seules les PK des enregistrements concernés sont transférées vers Kafka, et non les lignes complètes. Cela minimise le retraitement, quel que soit le volume total de données.
Requête en temps réel : Hologres prend en charge les upserts à faible latence et rend les données immédiatement interrogables après chaque écriture.
Mise en pratique
À la fin de cette rubrique, vous disposerez d'un pipeline actif où les modifications apportées à MongoDB — tant dans la table de faits que dans les tables de dimension — se propagent automatiquement vers une table large Hologres et deviennent immédiatement interrogables.

Le pipeline joint trois collections MongoDB en une seule table large Hologres :
game_sales
<table> <thead> <tr> <td><p>sale_id</p></td> <td><p>game_id</p></td> <td><p>platform_id</p></td> <td><p>sale_date</p></td> <td><p>units_sold</p></td> <td><p>sale_amt</p></td> <td><p>status</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
game_dimension
<table> <thead> <tr> <td><p>game_id</p></td> <td><p>game_name</p></td> <td><p>release_date</p></td> <td><p>developer</p></td> <td><p>publisher</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
platform_dimension
<table> <thead> <tr> <td><p>platform_id</p></td> <td><p>platform_name</p></td> <td><p>type</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody></tbody> </table>
game_sales_details
<table> <thead> <tr> <td><p>sale_id</p></td> <td><p>game_id</p></td> <td><p>platform_id</p></td> <td><p>sale_date</p></td> <td><p>units_sold</p></td> <td><p>sale_amt</p></td> <td><p>status</p></td> </tr> </thead> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <colgroup></colgroup> <tbody> <tr> <td><p>game_name</p></td> <td><p>release_date</p></td> <td><p>developer</p></td> <td><p>publisher</p></td> <td><p>platform_name</p></td> <td><p>type</p></td> <td><p></p></td> </tr> </tbody> </table>
Flux de propagation des modifications
Chaque modification traverse quatre étapes :
Capture : Détectez les modifications en temps réel provenant des tables de dimension MongoDB.
Propagation : Lorsqu'une table de dimension change, la Tâche 1 effectue une jointure de recherche (par exemple, sur
game_id) pour trouver les lignes affectées dans la table de faits et extrait leurs PK (par exemple,sale_id).Déclenchement : Envoyez les PK à Kafka pour notifier la Tâche 2 des actualisations en attente.
Upsert : La Tâche 2 récupère les dernières données, reconstruit la ligne de la table large et l'upserte dans Hologres.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un espace de travail Realtime Compute for Apache Flink exécutant VVR 8.0.5 ou version ultérieure. Pour plus d'informations, consultez Activer Realtime Compute for Apache Flink.
Une instance ApsaraDB for MongoDB exécutant la version 4.0 ou ultérieure. Pour plus d'informations, consultez Créer une instance de cluster fragmenté.
Une instance dédiée Hologres exécutant la version 1.3 ou ultérieure. Pour plus d'informations, consultez Acheter une instance Hologres.
Une instance ApsaraMQ for Kafka. Pour plus d'informations, consultez Déployer une instance ApsaraMQ for Kafka.
Les quatre instances doivent se trouver dans le même Virtual Private Cloud (VPC). Si elles résident dans des VPC différents, établissez une connectivité inter-VPC ou activez l'accès Internet pour Realtime Compute for Apache Flink. Pour plus d'informations, consultez Comment Realtime Compute for Apache Flink accède-t-il à un service via des VPC ? et Comment Realtime Compute for Apache Flink accède-t-il à Internet ?
Des permissions RAM user ou RAM role pour les ressources concernées.
Étape 1 : Préparer les données
Créer des collections MongoDB
Ajoutez le bloc CIDR de votre espace de travail Flink à la liste d'autorisation MongoDB. Pour plus de détails, consultez Configurer une liste d'autorisation pour une instance et Comment configurer une liste d'autorisation ?
-
Dans l'éditeur SQL de la console Data Management (DMS), créez la base de données
mongo_test:use mongo_test; -
Créez les collections
game_sales,game_dimensionetplatform_dimensionet insérez des exemples de données :// Game sales table (status: 1 = active, 0 = logically deleted) db.game_sales.insert( [ {sale_id:0,game_id:101,platform_id:1,"sale_date":"2024-01-01",units_sold:500,sale_amt:2500,status:1}, ] ); // Game dimension table db.game_dimension.insert( [ {game_id:101,"game_name":"SpaceInvaders","release_date":"2023-06-15","developer":"DevCorp","publisher":"PubInc"}, {game_id:102,"game_name":"PuzzleQuest","release_date":"2023-07-20","developer":"PuzzleDev","publisher":"QuestPub"}, {game_id:103,"game_name":"RacingFever","release_date":"2023-08-10","developer":"SpeedCo","publisher":"RaceLtd"}, {game_id:104,"game_name":"AdventureLand","release_date":"2023-09-05","developer":"Adventure","publisher":"LandCo"}, ] ); // Platform dimension table db.platform_dimension.insert( [ {platform_id:1,"platform_name":"PCGaming","type":"PC"}, {platform_id:2,"platform_name":"PlayStation","type":"Console"}, {platform_id:3,"platform_name":"Mobile","type":"Mobile"} ] ); -
Vérifiez les insertions :
db.game_sales.find();
db.game_dimension.find();
db.platform_dimension.find();
Créer la table Hologres
Connectez-vous à la console Hologres, cliquez sur Instances dans le volet de navigation de gauche, puis sélectionnez votre instance Hologres. Dans le coin supérieur droit, cliquez sur Connect to Instance.
-
Dans la barre de navigation supérieure, cliquez sur Metadata Management > Create Database. Saisissez
testdans le champ Database Name, définissez Policy sur SPM et cliquez sur OK. Pour plus d'informations, consultez Créer une base de données.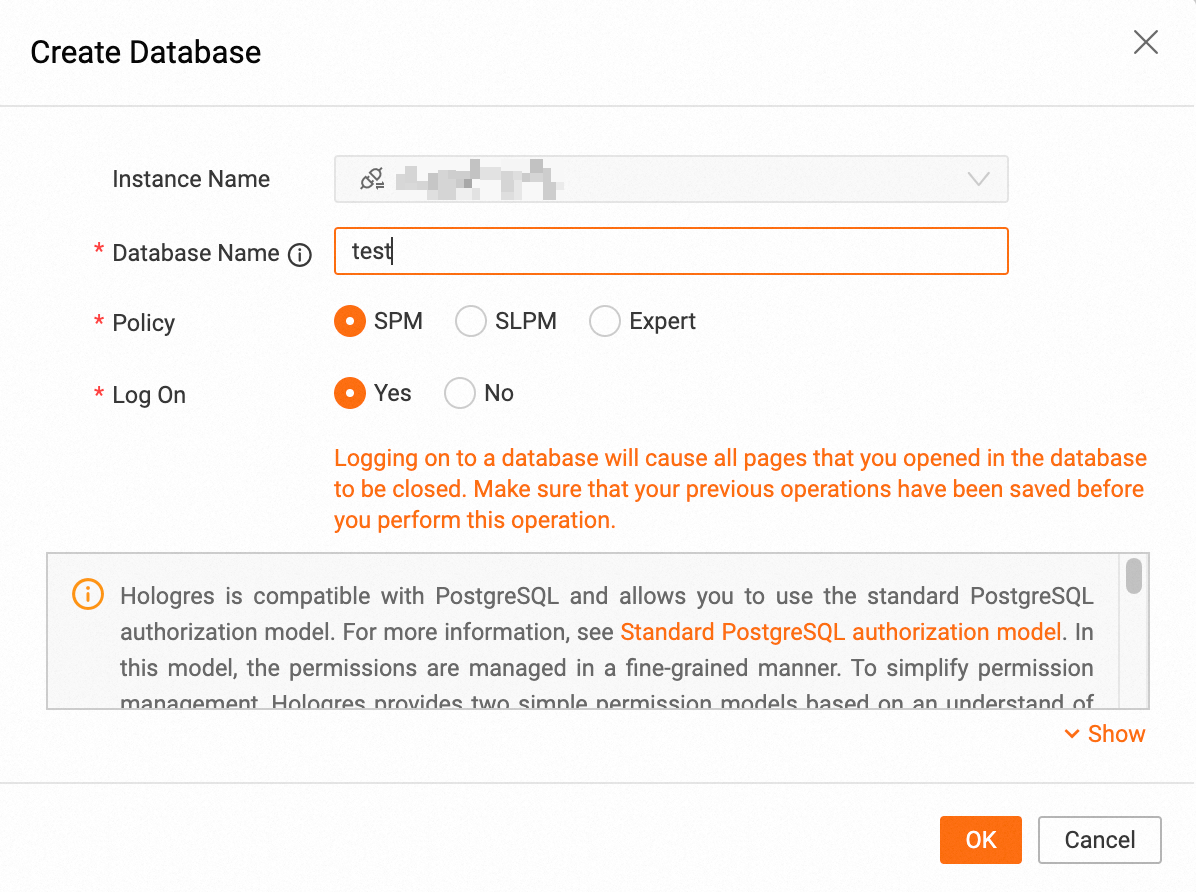
-
Dans la barre de navigation supérieure, cliquez sur SQL Editor. Cliquez sur l'icône SQL pour créer une nouvelle requête SQL, sélectionnez l'instance et la base de données cibles, puis exécutez l'instruction suivante pour créer la table large
game_sales_details:CREATE TABLE game_sales_details( sale_id INT not null primary key, game_id INT, platform_id INT, sale_date VARCHAR(50), units_sold INT, sale_amt INT, status INT, game_name VARCHAR(50), release_date VARCHAR(50), developer VARCHAR(50), publisher VARCHAR(50), platform_name VARCHAR(50), type VARCHAR(50) );
Créer le topic Kafka
Connectez-vous à la console ApsaraMQ for Kafka. Cliquez sur Instances dans le volet de navigation de gauche, puis sélectionnez votre instance.
Dans le volet de navigation de gauche, cliquez sur Whitelist Management et ajoutez le bloc CIDR de votre espace de travail Flink.
Dans le volet de navigation de gauche, cliquez sur Topics > Create Topic. Dans le volet de droite, saisissez
game_sales_factdans le champ Name, entrez une description et conservez les valeurs par défaut pour tous les autres champs. Cliquez sur OK.
Étape 2 : Créer des tâches de flux
Tâche 1 : Écrire les clés primaires dans Kafka
La Tâche 1 surveille les trois collections MongoDB. Lorsque game_sales change, sale_id est transmis directement à Kafka. Lorsqu'une table de dimension change, une jointure de recherche sur game_sales récupère les valeurs sale_id concernées, qui sont ensuite transmises à Kafka.
Le connecteur MongoDB joue deux rôles dans ce pipeline. Dans la Tâche 1, il agit comme source CDC, lisant le flux de modifications MongoDB. Dans la Tâche 2, il sert de source de recherche, récupérant l'état actuel de chaque document par clé primaire. Les deux rôles utilisent la même configuration de connecteur.

Connectez-vous à la console Realtime Compute for Apache Flink.
Dans la colonne Actions de votre espace de travail, cliquez sur Console.
Dans le menu de navigation de gauche, cliquez sur Development > ETL.
Cliquez sur New Blank Stream Draft.
Dans la boîte de dialogue New Draft, saisissez
dwd_mongo_kafkadans le champ Name, sélectionnez une version du moteur et cliquez sur Create.-
Copiez le code SQL suivant dans l'éditeur. Chacune des trois instructions
INSERTcapture indépendamment les modifications d'une collection MongoDB et transmet les valeurssale_idconcernées au récepteur Kafka. Cela garantit que Hologres est mis à jour avec précision et en temps réel dès qu'une table change. Stockez les valeurs sensibles telles que les chaînes de connexion et les mots de passe en tant que variables plutôt que de les coder en dur. Pour plus d'informations, consultez Gérer les variables.Heure **État game_dimensionpourgame_id = 101**T1 game_name = "SpaceInvaders"T2 Mis à jour vers game_name = "SpaceInvaders_v2"-- Source: game_sales (CDC stream) CREATE TEMPORARY TABLE game_sales ( `_id` STRING, -- MongoDB auto-generated ID sale_id INT, -- Sales ID PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_sales' ); -- Source: game_dimension (CDC stream) CREATE TEMPORARY TABLE game_dimension ( `_id` STRING, game_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_dimension' ); -- Source: platform_dimension (CDC stream) CREATE TEMPORARY TABLE platform_dimension ( `_id` STRING, platform_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'platform_dimension' ); -- Lookup source: game_sales (used for dimension-change joins) CREATE TEMPORARY TABLE game_sales_dim ( `_id` STRING, sale_id INT, game_id INT, platform_id INT, PRIMARY KEY (_id) NOT ENFORCED ) WITH ( 'connector' = 'mongodb', 'uri' = '${secret_values.MongoDB-URI}', 'database' = 'mongo_test', 'collection' = 'game_sales' ); -- Sink: Kafka topic that stores affected PKs CREATE TEMPORARY TABLE game_sales_fact ( sale_id INT, PRIMARY KEY (sale_id) NOT ENFORCED ) WITH ( 'connector' = 'upsert-kafka', 'properties.bootstrap.servers' = '${secret_values.Kafka-hosts}', 'topic' = 'game_sales_fact', 'key.format' = 'json', 'value.format' = 'json', 'properties.enable.idempotence' = 'false' -- Required when writing to ApsaraMQ for Kafka ); BEGIN STATEMENT SET; -- Stream PKs from game_sales changes INSERT INTO game_sales_fact (sale_id) SELECT sale_id FROM game_sales; -- Stream PKs of game_sales rows affected by game_dimension changes INSERT INTO game_sales_fact (sale_id) SELECT gs.sale_id FROM game_dimension AS gd JOIN game_sales_dim FOR SYSTEM_TIME AS OF PROCTIME() AS gs ON gd.game_id = gs.game_id; -- Stream PKs of game_sales rows affected by platform_dimension changes INSERT INTO game_sales_fact (sale_id) SELECT gs.sale_id FROM platform_dimension AS pd JOIN game_sales_dim FOR SYSTEM_TIME AS OF PROCTIME() AS gs ON pd.platform_id = gs.platform_id; END;À propos des jointures de recherche La clause
FOR SYSTEM_TIME AS OF PROCTIME()définit une jointure de recherche (un type de jointure temporelle). Au moment du traitement d'une ligne source, la jointure récupère la ligne correspondante de la table de dimension depuis MongoDB et fige cet instantané pour le résultat de la jointure. Si la table de dimension est mise à jour ultérieurement, les lignes déjà traitées ne sont pas affectées. Par exemple : Une lignegame_salestraitée à T1 se joint à"SpaceInvaders". Une ligne traitée à T2 se joint à"SpaceInvaders_v2". La condition de jointure estgd.game_id = gs.game_idetpd.platform_id = gs.platform_id. Pour plus d'informations, consultez Instructions JOIN pour les tables de dimension et Choisir Kafka, Upsert Kafka ou le catalogue Kafka JSON. Dans le coin supérieur droit, cliquez sur Deploy. Dans la boîte de dialogue, cliquez sur Confirm. Pour plus d'informations, consultez Déployer une tâche.
Tâche 2 : Reconstruire la table large et upserter dans Hologres
La Tâche 2 consomme les valeurs sale_id depuis le topic Kafka game_sales_fact, effectue des jointures de recherche sur les tables de faits et de dimension MongoDB, puis upserte les lignes résultantes de la table large dans Hologres.

Suivez les étapes de la section Tâche 1 pour créer un nouveau brouillon nommé dws_kafka_mongo_holo et le déployer avec le code SQL suivant :
-- Source: Kafka topic that provides affected PKs
CREATE TEMPORARY TABLE game_sales_fact
(
  sale_id  INT,
  PRIMARY KEY (sale_id) NOT ENFORCED
)
WITH (
  'connector' = 'upsert-kafka',
  'properties.bootstrap.servers' = '${secret_values.Kafka-hosts}',
  'topic' = 'game_sales_fact',
  'key.format' = 'json',
  'value.format' = 'json',
  'properties.group.id' = 'game_sales_fact',
  'properties.auto.offset.reset' = 'earliest'
);

-- Lookup source: game_sales fact table
CREATE TEMPORARY TABLE game_sales
(
  `_id`       STRING,
  sale_id     INT,
  game_id     INT,
  platform_id INT,
  sale_date   STRING,
  units_sold  INT,
  sale_amt    INT,
  status      INT,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'game_sales'
);

-- Lookup source: game_dimension
CREATE TEMPORARY TABLE game_dimension
(
  `_id`        STRING,
  game_id      INT,
  game_name    STRING,
  release_date STRING,
  developer    STRING,
  publisher    STRING,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'game_dimension'
);

-- Lookup source: platform_dimension
CREATE TEMPORARY TABLE platform_dimension
(
  `_id`          STRING,
  platform_id    INT,
  platform_name  STRING,
  type           STRING,
  PRIMARY KEY (_id) NOT ENFORCED
)
WITH (
  'connector' = 'mongodb',
  'uri' = '${secret_values.MongoDB-URI}',
  'database' = 'mongo_test',
  'collection' = 'platform_dimension'
);

-- Sink: Hologres wide table
CREATE TEMPORARY TABLE IF NOT EXISTS game_sales_details
(
  sale_id       INT,
  game_id       INT,
  platform_id   INT,
  sale_date     STRING,
  units_sold    INT,
  sale_amt      INT,
  status        INT,
  game_name     STRING,
  release_date  STRING,
  developer     STRING,
  publisher     STRING,
  platform_name STRING,
  type          STRING,
  PRIMARY KEY (sale_id) NOT ENFORCED
)
WITH (
  'connector' = 'hologres',
  'dbname' = 'test',
  'tablename' = 'public.game_sales_details',
  'username' = '${secret_values.AccessKeyID}',
  'password' = '${secret_values.AccessKeySecret}',
  'endpoint' = '${secret_values.Hologres-endpoint}',
  'sink.delete-strategy' = 'IGNORE_DELETE',       -- Insert or update only; never delete rows
  'sink.on-conflict-action' = 'INSERT_OR_UPDATE',  -- Enable partial column updates
  'sink.partial-insert.enabled' = 'true'
);

INSERT INTO game_sales_details (
  sale_id, game_id, platform_id, sale_date, units_sold, sale_amt, status,
  game_name, release_date, developer, publisher, platform_name, type
)
SELECT
  gsf.sale_id,
  gs.game_id,
  gs.platform_id,
  gs.sale_date,
  gs.units_sold,
  gs.sale_amt,
  gs.status,
  gd.game_name,
  gd.release_date,
  gd.developer,
  gd.publisher,
  pd.platform_name,
  pd.type
FROM game_sales_fact AS gsf
JOIN game_sales FOR SYSTEM_TIME AS OF PROCTIME() AS gs
  ON gsf.sale_id = gs.sale_id
JOIN game_dimension FOR SYSTEM_TIME AS OF PROCTIME() AS gd
  ON gs.game_id = gd.game_id
JOIN platform_dimension FOR SYSTEM_TIME AS OF PROCTIME() AS pd
  ON gs.platform_id = pd.platform_id;
Étape 3 : Démarrer les tâches
Dans la console Development, sélectionnez O&M > Deployments et démarrez les deux déploiements de tâches.
-
Une fois que les deux tâches ont atteint l'état Running, accédez à HoloWeb et interrogez la table
game_sales_details:SELECT * FROM game_sales_details;La ligne initiale amorcée à l'étape 1 apparaît dans le résultat.

Étape 4 : Mettre à jour et interroger les données
Les modifications apportées à game_sales et aux tables de dimension dans MongoDB se propagent automatiquement vers Hologres. Les exemples suivants illustrent chaque type de mise à jour.
Mises à jour de la table de faits
-
Insérez cinq lignes supplémentaires dans
game_sales:db.game_sales.insert( [ {sale_id:1,game_id:101,platform_id:1,"sale_date":"2024-01-01",units_sold:500,sale_amt:2500,status:1}, {sale_id:2,game_id:102,platform_id:2,"sale_date":"2024-08-02",units_sold:400,sale_amt:2000,status:1}, {sale_id:3,game_id:103,platform_id:1,"sale_date":"2024-08-03",units_sold:300,sale_amt:1500,status:1}, {sale_id:4,game_id:101,platform_id:3,"sale_date":"2024-08-04",units_sold:200,sale_amt:1000,status:1}, {sale_id:5,game_id:104,platform_id:2,"sale_date":"2024-08-05",units_sold:100,sale_amt:3000,status:1} ] );Interrogez
game_sales_detailsdans Hologres. Cinq nouvelles lignes apparaissent.
-
Mettez à jour
sale_datede2024-01-01à2024-08-01:db.game_sales.updateMany({"sale_date": "2024-01-01"}, {$set: {"sale_date": "2024-08-01"}});Interrogez
game_sales_details. La colonnesale_datereflète la nouvelle valeur.
-
Supprimez logiquement la ligne où
sale_id = 5en définissantstatussur0:db.game_sales.updateMany({"sale_id": 5}, {$set: {"status": 0}});Interrogez
game_sales_details. La colonnestatuspoursale_id = 5passe à0.
Mises à jour des tables de dimension
-
Ajoutez de nouveaux jeux et plates-formes aux tables de dimension :
// New games
db.game_dimension.insert(
  [
{game_id:105,"game_name":"HSHWK","release_date":"2024-08-20","developer":"GameSC","publisher":"GameSC"},
{game_id:106,"game_name":"HPBUBG","release_date":"2018-01-01","developer":"BLUE","publisher":"KK"}
  ]
);

// New platforms
db.platform_dimension.insert(
  [
{platform_id:4,"platform_name":"Steam","type":"PC"},
{platform_id:5,"platform_name":"Epic","type":"PC"}
  ]
);
L'insertion dans les tables de dimension seule ne déclenche pas la synchronisation — le pipeline est piloté par les modifications apportées à
game_sales. Insérez les enregistrements de vente correspondants pour déclencher la mise à jour de la table large :db.game_sales.insert( [ {sale_id:6,game_id:105,platform_id:4,"sale_date":"2024-09-01",units_sold:400,sale_amt:2000,status:1}, {sale_id:7,game_id:106,platform_id:1,"sale_date":"2024-09-01",units_sold:300,sale_amt:1500,status:1} ] );Interrogez
game_sales_details. Deux nouvelles lignes apparaissent avec les données de dimension enrichies.
-
Mettez à jour les données de dimension dans MongoDB :
// Update release date
db.game_dimension.updateMany({"release_date": "2018-01-01"}, {$set: {"release_date": "2024-01-01"}});

// Update platform type
db.platform_dimension.updateMany({"type": "PC"}, {$set: {"type": "Swich"}});
Les champs mis à jour se propagent aux lignes correspondantes dans Hologres.
