Foire aux questions concernant les connecteurs CDC dans Realtime Compute for Apache Flink, couvrant MySQL CDC, MongoDB CDC et PostgreSQL CDC.
Index rapide
Identifiez votre problème selon le symptôme :
Symptôme | Section |
Le connecteur s'arrête après le chargement complet des données et ne passe jamais en mode incrémentiel | MySQL CDC : transition du mode complet vers le mode incrémentiel |
Données incrémentielles manquantes pour une table spécifique | MySQL CDC : synchronisation des données incrémentielles absente |
Décalage de 8 heures sur les champs d'horodatage | |
Charge élevée de la base de données due à plusieurs déploiements CDC | |
Bande passante anormalement élevée suite à une petite mise à jour | |
Échec du déploiement au redémarrage ; journaux binaires purgés | |
Échec du déploiement au redémarrage ; erreur SSL | |
Journaux WAL non libérés ; utilisation élevée du disque | |
Données TOAST manquantes lors des mises à jour | |
Le connecteur MongoDB ne peut pas reprendre après un redémarrage | |
Échec de l'authentification malgré des identifiants corrects | |
Emplacement de réplication toujours actif après la fin du déploiement | |
Le champ |
Généralités
Puis-je configurer le déploiement pour qu'il soit annulé plutôt que redémarré en cas d'échec ?
Définissez une stratégie de redémarrage dans la configuration du déploiement. L'exemple suivant limite les tentatives de redémarrage à deux avec un intervalle de 10 secondes, puis annule le déploiement si les deux tentatives échouent.
restart-strategy: fixed-delay
restart-strategy.fixed-delay.attempts: 2
restart-strategy.fixed-delay.delay: 10 s
Les tables source MySQL CDC et Hologres CDC ne prennent pas en charge les fonctions de fenêtrage. Comment implémenter une agrégation à la minute ?
Utilisez DATE_FORMAT pour convertir les horodatages en chaînes de caractères à la minute, puis appliquez un GROUP BY sur ces chaînes. L'exemple suivant calcule le nombre de commandes et le chiffre d'affaires par magasin chaque minute :
SELECT
    shop_id,
    DATE_FORMAT(order_ts, 'yyyy-MM-dd HH:mm') AS window,
    COUNT(*) AS order_count,
    SUM(price) AS amount
FROM order_mysql_cdc
GROUP BY shop_id, window
Une table MySQL CDC peut-elle être utilisée comme table de dimension ou table de destination ?
Non. Une table MySQL CDC ne peut servir que de table source : elle lit les données complètes et incrémentielles depuis MySQL. Utilisez une table MySQL standard (non CDC) pour les cas d'utilisation de dimension ou de destination.
MySQL CDC
Pourquoi le connecteur MySQL CDC s'arrête-t-il après la lecture des données complètes sans passer en mode incrémentiel ?
Ce problème a généralement l'une des quatre causes suivantes :
Instances ApsaraDB RDS for MySQL V5.6 secondaires ou en lecture seule : Ces instances n'écrivent pas de données dans les fichiers de journaux binaires, ce qui empêche le connecteur de lire des données incrémentielles. Utilisez une instance capable d'écriture ou migrez vers une version ultérieure à la V5.6.
Compression des transactions de journaux binaires activée : Les tables source MySQL CDC ne prennent pas en charge la compression des transactions de journaux binaires. Désactivez cette fonctionnalité sur vos clusters MySQL autogérés.
Erreur d'épuisement de la mémoire (OOM) lors de la lecture des données complètes : Si le dernier fragment est trop volumineux, une erreur OOM suspend le déploiement après le basculement. Augmentez le parallélisme pour accélérer la lecture des données complètes.
Intervalle de point de contrôle trop long : Une fois que toutes les sous-tâches parallèles ont terminé la lecture des données complètes, le connecteur attend un point de contrôle avant de passer en mode incrémentiel. Un intervalle de 20 minutes entraîne donc un délai de 20 minutes. Définissez un intervalle de point de contrôle plus court selon vos besoins.
Comment confirmer que la synchronisation complète des données est terminée ?
Deux méthodes sont disponibles :
Métrique
currentEmitEventTimeLag: Dans l'onglet Metrics de la page Deployments, vérifiez cette métrique. Une valeur ≤ 0 indique que la synchronisation complète est toujours en cours ; une valeur > 0 signifie que le connecteur a terminé la synchronisation complète et a commencé à lire les données du journal binaire.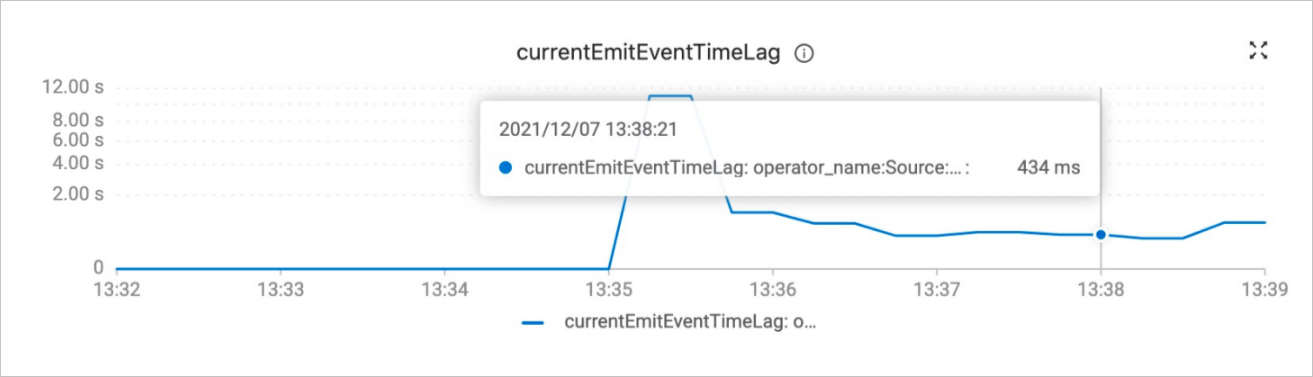
Journal TaskManager : Recherchez
BinlogSplitReader is createddans les journaux TaskManager. Ce message confirme que la lecture des données complètes est achevée.4123 2022-01-12 05:12:52,157 [pool-6757-thread-1] INFO io.debezium.jdbc.JdbcConnection [] - Connection gracefully close... 4124 2022-01-12 05:12:52,158 [Source: TableSourceScan(table=[[vvp, default, ods_ex_trade_detail_spot_mysql_cdc ... with job vertex id 6698b6cdb93164bb0e3bb97f2a17fcd7 (1/4)#0] INFO org.apache.flink.connector.base.source.reader.SourceReaderBase [] - Adding split(s) to reader: [MySqlBinlogSplit{splitId='binlog-split', offset={ts_sec=0, file=mysql-bin.008066, pos=459422339, gtids=c32c3579-5c0d-11ec-889a-00163e368abf:1-311125098, row=0, event=0}, endOffset={ts_sec=0, file=, pos=-9223372036854775808, row=0, event=0}}] 4125 2022-01-12 05:12:52,158 [Source Data Fetcher for Source: TableSourceScan(table=[[vvp, default, ods_ex_trade_detail_spot_mysql_cdc ... with job vertex id 6698b6cdb93164bb0e3bb97f2a17fcd7 (1/4)#0] INFO org.apache.flink.connector.base.source.reader.fetcher.SplitFetcher [] - Starting split fetcher_138? 4126 2022-01-12 05:12:52,159 [Source Data Fetcher for Source: TableSourceScan(table=[[vvp, default, ods_ex_trade_detail_spot_mysql_cdc ... with job vertex id 6698b6cdb93164bb0e3bb97f2a17fcd7 (1/4)#0] INFO com.ververica.cdc.connectors.mysql.source.reader.MySqlSplitReader [] - BinlogSplitReader is created. 4127 2022-01-12 05:12:56,853 [Source Data Fetcher for Source: TableSourceScan(table=[[vvp, default, ods_ex_trade_detail_spot_mysql_cdc ... with job vertex id 6698b6cdb93164bb0e3bb97f2a17fcd7 (1/4)#0] WARN io.debezium.relational.history.DatabaseHistoryMetrics [] - Unable to register the MBean 'debezium.mysql:type=connector-metrics,context=schema-history,server=mysql_binlog_source': debezium.mysql:type=connector-metrics, context=schema-history,server=mysql_binlog_source 4128 2022-01-12 05:12:56,860 [Source Data Fetcher for Source: TableSourceScan(table=[[vvp, default, ods_ex_trade_detail_spot_mysql_cdc ... with jobLa ligne 4126 affiche
BinlogSplitReader is created, ce qui indique que la lecture des données complètes est terminée et que le déploiement est passé à la lecture incrémentielle du journal binaire. L'avertissement WARN de la ligne 4127 (Unable to register the MBean) est normal et n'affecte pas la synchronisation des données.
La position de démarrage change-t-elle lors du redémarrage d'un déploiement ?
Cela dépend de la Starting Strategy sélectionnée dans la boîte de dialogue Deployment Starting Configuration :
NONE : Le connecteur relit les données à partir de la position de démarrage configurée.
Latest State : Le connecteur reprend à la position du journal binaire où le déploiement a été annulé pour la dernière fois.
Par exemple, si le déploiement était configuré pour démarrer à {file=mysql-bin.01, position=40} mais a été annulé à la position 210, Latest State reprend à 210 tandis que NONE redémarre depuis 40.
Assurez-vous que le fichier de journal binaire requis existe toujours sur le serveur avant de redémarrer. S'il a expiré et a été supprimé, le redémarrage échouera.
Comment fonctionne le connecteur MySQL CDC et quel est son impact sur la base de données ?
Lorsque scan.startup.mode est défini sur initial (valeur par défaut), le connecteur :
Se connecte via JDBC et exécute une instruction
SELECTpour lire les données complètes, tout en enregistrant la position actuelle du journal binaire.Après la lecture des données complètes, il bascule vers le client binlog pour lire les modifications incrémentielles à partir de la position enregistrée.
La lecture des données complètes augmente la charge des requêtes en raison de l'instruction SELECT . Pendant la lecture incrémentielle, chaque table source maintient une connexion binlog. Si vous disposez de nombreuses tables source, vérifiez la limite de connexions :
show variables like '%max_connections%';Comment ignorer la phase d'instantané et lire uniquement les données de modification ?
Définissez scan.startup.mode dans la clause WITH sur l'une des valeurs suivantes : earliest-offset, latest-offset, specific-offset ou timestamp. Pour plus de détails, consultez la section « Paramètres de la clause WITH » dans Créer une table source MySQL CDC.
Comment MySQL CDC localise-t-il la position du journal binaire lorsque scan.startup.mode = timestamp ?
Avec le mode de démarrage timestamp, MySQL CDC détermine la position de consommation initiale comme suit :
Analyse tous les fichiers de journaux binaires et trouve le premier fichier dont l'heure de dernière modification est supérieure ou égale à l'horodatage spécifié.
Lit les événements du journal binaire depuis le début de ce fichier.
Ignore les événements dont l'horodatage est antérieur à l'horodatage spécifié.
Commence la consommation à partir du premier événement dont l'horodatage est supérieur ou égal à l'horodatage spécifié.
Cas limites :
Si l'horodatage spécifié se situe dans le futur, la consommation commence à partir de la dernière position disponible, ce qui équivaut à
latest-offset.Si le journal binaire correspondant à l'horodatage spécifié a déjà été purgé, la consommation commence à partir de la première position disponible, ce qui équivaut à
earliest-offset.
Comment le connecteur gère-t-il les tables MySQL fragmentées (shardées) ?
Utilisez le paramètre table-name avec une expression régulière pour faire correspondre tous les fragments. Par exemple, pour surveiller toutes les tables ayant le préfixe user_ :
'table-name' = 'user_.*'Si toutes les tables des différents fragments partagent le même schéma, utilisez plutôt database-name avec une expression régulière.
Que faire si les virgules dans l'expression régulière table-name provoquent des erreurs d'analyse ?
Debezium utilise les virgules comme délimiteurs, ce qui fait échouer un modèle tel que t_process_wi_history_\d{1,2}.
13-vvr-4.0.13-1-SNAPSHOT.jar:1.13-vvr-4.0.13-1-SNAPSHOT]
Caused by: java.util.regex.PatternSyntaxException: Unclosed counted closure near index 35
zhangtest.t_process_wi_history_\d{1
	at java.util.regex.Pattern.error(Pattern.java:1969) ~[?:1.8.0_302]
	at java.util.regex.Pattern.closure(Pattern.java:3155) ~[?:1.8.0_302]
Utilisez plutôt l'alternance :
'table-name' = '(t_process_wi_history_\d{1}|t_process_wi_history_\d{2})'Plusieurs déploiements MySQL CDC entraînent une charge élevée de la base de données. Que puis-je faire ?
Deux approches sont possibles :
Déléguer à Kafka : Synchronisez la table source MySQL CDC vers une table de destination ApsaraMQ for Kafka. Les autres déploiements consomment ensuite depuis Kafka au lieu de lire directement les journaux binaires. Consultez Synchroniser les données de toutes les tables d'une base de données MySQL vers Kafka.
Fusionner les déploiements avec un ID de serveur partagé : Si plusieurs déploiements
CREATE TABLE ASpartagent la même configuration, attribuez-leur le même ID de serveur pour réutiliser la source de données. Consultez Exemple 4 : exécution de plusieurs instructions CREATE TABLE AS.
Une petite mise à jour provoque une utilisation anormalement élevée de la bande passante. Pourquoi ?
Les fichiers de journaux binaires contiennent les modifications de toutes les bases de données et tables de l'instance MySQL, et pas seulement celles surveillées par votre déploiement. Si votre instance comporte trois tables, le journal binaire transporte les modifications des trois, même si votre déploiement n'en suit qu'une seule.
Pour résoudre ce problème, réutilisez la table source MySQL CDC afin que plusieurs déploiements partagent une seule connexion binlog. Consultez la section « Activation de la réutilisation d'une table source MySQL CDC » dans Connecteur MySQL.
Les champs d'horodatage affichent un décalage de 8 heures par rapport au fuseau horaire du serveur MySQL. Pourquoi ?
Deux causes sont possibles :
Le paramètre
server-time-zonedu déploiement CDC ne correspond pas au fuseau horaire réel du serveur MySQL. Mettez à jourserver-time-zonepour qu'il corresponde.Un désérialiseur personnalisé (
MyDeserializer implements DebeziumDeserializationSchema) ne définit passerverTimeZone. DéfinissezserverTimeZoneen fonction de la manière dontRowDataDebeziumDeserializeSchemaanalyse les donnéesTIMESTAMP:private TimestampData convertToTimestamp(Object dbzObj, Schema schema) { if (dbzObj instanceof Long) { switch (schema.name()) { case Timestamp.SCHEMA_NAME: return TimestampData.fromEpochMillis((Long) dbzObj); case MicroTimestamp.SCHEMA_NAME: long micro = (long) dbzObj; return TimestampData.fromEpochMillis(micro / 1000, (int) (micro % 1000 * 1000)); case NanoTimestamp.SCHEMA_NAME: long nano = (long) dbzObj; return TimestampData.fromEpochMillis(nano / 1000_000, (int) (nano % 1000_000)); } } LocalDateTime localDateTime = TemporalConversions.toLocalDateTime(dbzObj, serverTimeZone); return TimestampData.fromLocalDateTime(localDateTime); }
Le connecteur MySQL CDC peut-il écouter les bases de données secondaires ?
Oui. Ajoutez les éléments suivants à la configuration de la base de données secondaire afin que les données synchronisées depuis la primaire soient écrites dans le journal binaire de la secondaire :
log-slave-updates = 1Si le mode Global Transaction Identifier (GTID) est activé sur la primaire, activez-le également sur la secondaire :
gtid_mode = on
enforce_gtid_consistency = on
Comment capturer les événements DDL ?
Utilisez l'API DataStream avec MySqlSource et définissez includeSchemaChanges(true) :
MySqlSource<xxx> mySqlSource =
    MySqlSource.<xxx>builder()
        .hostname(...)
        .port(...)
        .databaseList("<databaseName>")
        .tableList("<databaseName>.<tableName>")
        .username(...)
        .password(...)
        .serverId(...)
        .deserializer(...)
        .includeSchemaChanges(true) // Capture DDL events
        .build();
// Add downstream processing logic
MySQL CDC prend-il en charge la synchronisation de toutes les tables d'une base de données en une seule fois ?
Oui. Utilisez l'instruction CREATE TABLE AS ou CREATE DATABASE AS. Consultez Instruction CREATE TABLE AS ou Instruction CREATE DATABASE AS.
Les instances ApsaraDB RDS for MySQL V5.6 n'écrivent pas les modifications incrémentielles dans les fichiers de journaux binaires, ce qui empêche le connecteur de lire les données incrémentielles depuis ces instances.
Les données incrémentielles d'une table spécifique ne sont pas synchronisées. Pourquoi ?
Un filtre de journal binaire sur le serveur MySQL exclut peut-être cette base de données. Exécutez la commande suivante pour vérifier :
show master status;Vérifiez les colonnes Binlog_Ignore_DB et Binlog_Do_DB dans la sortie :
+------------------+----------+--------------+------------------+----------------------+
| File             | Position | Binlog_Do_DB | Binlog_Ignore_DB |  Executed_Gtid_Set   |
+------------------+----------+--------------+------------------+----------------------+
| mysql-bin.000006 |     4594 |              |                  | xxx:1-15             |
+------------------+----------+--------------+------------------+----------------------+
Comment configurer tableList lors de l'utilisation de l'API DataStream pour MySQL CDC ?
La valeur de tableList doit inclure à la fois le nom de la base de données et le nom de la table, au format yourDatabaseName.yourTableName.
MongoDB CDC
Le connecteur peut-il reprendre depuis un point de contrôle si le déploiement échoue pendant la lecture des données complètes ?
Oui. Définissez 'scan.incremental.snapshot.enabled' = 'true' dans la clause WITH pour activer la récupération basée sur les points de contrôle pendant la lecture des données complètes.
MongoDB CDC prend-il en charge la lecture exclusive des données incrémentielles ?
Par défaut, le connecteur lit à la fois les données complètes et incrémentielles. Pour ignorer les données complètes et ne lire que les modifications incrémentielles, définissez 'scan.startup.mode' = 'latest-offset' dans la clause WITH.
Puis-je m'abonner uniquement à des collections spécifiques ?
Non. Le connecteur s'abonne au niveau de la base de données. Définissez 'database' = 'mgdb' et 'collection' = '' dans la clause WITH pour vous abonner à toutes les collections de la base de données.
MongoDB CDC prend-il en charge la lecture concurrente ?
Oui, pendant la phase d'instantané initial. Définissez scan.incremental.snapshot.enabled sur true pour activer la lecture concurrente.
Quelles versions de MongoDB sont prises en charge ?
MongoDB 3.6 et versions ultérieures (les flux de modifications ont été introduits dans la version 3.6). MongoDB 4.0 ou version ultérieure est recommandé. Sur les versions antérieures à la 3,6, le connecteur renvoie l'erreur "Unrecognized pipeline stage name: '$changeStream'".
Quelles architectures MongoDB sont prises en charge ?
Le connecteur nécessite un ensemble de réplicas ou un cluster fragmenté : les flux de modifications ne fonctionnent que dans ces modes. Pour les tests locaux, convertissez MongoDB en un ensemble de réplicas à nœud unique en utilisant rs.initiate(). Sans cela, le connecteur renvoie "The $changestage is only supported on replica sets".
MongoDB CDC prend-il en charge les paramètres Debezium ?
Non. Le connecteur MongoDB CDC est développé indépendamment dans Flink CDC et ne dépend pas de Debezium.
L'authentification échoue alors que les identifiants sont corrects. Pourquoi ?
Les identifiants utilisateur sont limités à une base de données spécifique. Ajoutez 'connection.options' = 'authSource=<database_the_user_belongs_to>' à la clause WITH.
Le connecteur peut-il reprendre depuis un point de contrôle après un redémarrage du déploiement ?
Oui. Les points de contrôle stockent les jetons de reprise pour les flux de modifications. Lors du redémarrage du déploiement, le connecteur lit le jeton de reprise et continue à partir de la position correspondante dans la collection oplog.rs.
Si le jeton de reprise n'existe plus dans oplog.rs — une collection à capacité fixe qui tourne lorsqu'elle est pleine — augmentez la taille de l'oplog pour éviter une rotation prématurée. Consultez Modifier la taille de l'Oplog des membres d'un ensemble de réplicas autogéré.
MongoDB CDC prend-il en charge les messages UPDATE_BEFORE (images avant mise à jour) ?
Cela dépend de la version de MongoDB :
MongoDB 6.0 et versions ultérieures avec activation de l'image avant/après : Définissez
'scan.full-changelog' = 'true'.MongoDBSourcegénère directement des messagesUPDATE_BEFORE.MongoDB antérieur à 6,0 : La collection
oplog.rsinclut les typesINSERT,UPDATE,REPLACEetDELETE, mais pasUPDATE_BEFORE. Lors de l'utilisation deMongoDBTableSourceen mode SQL, le planificateur Flink applique automatiquement l'opérateurChangelogNormalizepour générer des messagesUPDATE_BEFORE; toutefois, cet opérateur stocke tous les états clés et ajoute une surcharge. Si vous utilisez l'API DataStream avecMongoDBSource(sans l'optimisation du planificateur Flink),ChangelogNormalizen'est pas appliqué automatiquement. Gérez l'état vous-même ou utilisezMongoDBTableSourceet convertissez-le en flux de journal des modifications :tEnv.executeSql("CREATE TABLE orders ( ... ) WITH ( 'connector'='mongodb-cdc', ... )"); Table table = tEnv.from("orders").select($("*")); tEnv.toChangelogStream(table) .print() .setParallelism(1); env.execute();
PostgreSQL CDC
Comment filtrer les valeurs de date invalides ?
Ajoutez l'un des éléments suivants à la clause WITH :
'debezium.event.deserialization.failure.handling.mode' = 'warn': Ignore les enregistrements invalides et les consigne en tant qu'avertissements.'debezium.event.deserialization.failure.handling.mode' = 'ignore': Ignore silencieusement les enregistrements invalides.
Les données TOAST sont manquantes lors des mises à jour. Pourquoi ?
Le comportement dépend du paramètre REPLICA IDENTITY de la table :
REPLICA IDENTITY FULL: Les valeurs des colonnes TOAST apparaissent dans les champsbeforeetafterdes événements de modification, comme toute autre colonne.REPLICA IDENTITY DEFAULT(valeur par défaut) : Les colonnes TOAST inchangées sont omises des événementsUPDATE. Lorsque'debezium.schema.refresh.mode' = 'columns_diff_exclude_unchanged_toast'est utilisé, le pluginwal2jsonomet les données TOAST inchangées ; ces colonnes n'apparaissent donc dans les journaux WAL que si l'identité de réplica est définie surFULL.
Pour corriger l'absence de données TOAST, définissez l'identité de réplica sur FULL :
ALTER TABLE your_table_name REPLICA IDENTITY FULL;Les journaux WAL ne sont pas libérés et l'utilisation du disque est élevée. Pourquoi ?
Le connecteur PostgreSQL CDC met à jour le numéro de séquence de journal (LSN) dans les emplacements de réplication uniquement lorsqu'un point de contrôle Flink est terminé. Si l'utilisation du disque est élevée, vérifiez :
Si la création de points de contrôle est activée pour le déploiement.
Si un emplacement de réplication est inutilisé ou présente un retard de synchronisation important.
Que se passe-t-il lorsque la précision DECIMAL dépasse la précision déclarée de la colonne ?
La valeur est renvoyée sous forme de null. Pour conserver la valeur d'origine, définissez 'debezium.decimal.handling.mode' = 'string' afin de lire les données DECIMAL sous forme de chaînes.
Comment configurer tableList lors de l'utilisation de l'API DataStream pour PostgreSQL CDC ?
La valeur de tableList doit inclure à la fois le nom du schéma et le nom de la table, au format my_schema.my_table.
Packages et dépendances
Pourquoi ne puis-je pas télécharger flink-sql-connector-mysql-cdc-2.2-SNAPSHOT.jar ?
Les versions SNAPSHOT correspondent aux branches de développement et ne sont pas publiées dans le dépôt central Maven. Compilez à partir du code source pour utiliser une version SNAPSHOT, ou utilisez une version stable telle que flink-sql-connector-mysql-cdc-2.1.0.jar, disponible dans le dépôt central Maven.
Quelle est la différence entre flink-sql-connector-xxx.jar et flink-connector-xxx.jar ?
flink-sql-connector-xxx: Un JAR fat qui inclut le code du connecteur et toutes les dépendances ombragées. Ajoutez-le au répertoirelibpour les déploiements SQL.flink-connector-xxx: Contient uniquement le code du connecteur, sans dépendances. Utilisez-le pour les déploiements DataStream et gérez vous-même les dépendances tierces, y compris la résolution des conflits avec les opérationsexcludeetshade.
Pourquoi ne puis-je pas trouver de package de connecteur Flink CDC 2.x dans le dépôt Maven ?
À partir de Flink CDC 2.0.0, l'ID de groupe est passé de com.alibaba.ververica à com.ververica. Le chemin Maven pour les packages 2.x est /com/ververica/.
Les champs numériques sont renvoyés sous forme de chaînes lors de l'utilisation de JsonDebeziumDeserializationSchema. Comment corriger cela ?
Configurez les propriétés de gestion numérique de Debezium lors de la construction de la source :
Properties properties = new Properties();
properties.setProperty("bigint.unsigned.handling.mode", "long");
properties.setProperty("decimal.handling.mode", "double");

MySqlSource.<String>builder()
    .hostname(config.getHostname())
    // ...
    .debeziumProperties(properties);
Pour plus de détails sur la conversion des types numériques par Debezium, consultez Connecteur Debezium pour MySQL.
Messages d'erreur
« Replication slot 'xxxx' is active »
Après la fin d'un déploiement PostgreSQL CDC, son emplacement de réplication peut ne pas être libéré automatiquement. Libérez-le manuellement :
select pg_drop_replication_slot('rep_slot');Si l'emplacement est détenu par un processus actif, terminez d'abord le processus :
select pg_terminate_backend(162564);
select pg_drop_replication_slot('rep_slot');
Vous pouvez également ajouter 'debezium.slot.drop.on.stop' = 'true' à la configuration de la source PostgreSQL pour supprimer automatiquement l'emplacement lorsque le déploiement est annulé.
L'activation du nettoyage automatique des emplacements entraîne la récupération des journaux WAL. Au redémarrage du déploiement, des données seront perdues et la sémantique « au moins une fois » ne pourra pas être garantie.
« binlog probably contains events generated with statement or mixed based replication format »
Les tables source MySQL CDC ne prennent en charge que les journaux binaires au format ROW. Si le format est STATEMENT ou MIXED, le connecteur échoue.
Vérifiez le format actuel :
show variables like "binlog_format";
-- To check the global setting:
show global variables like "binlog_format";
Modifiez le format pour ROW. Consultez Définir le format du journal binaire.
Redémarrez le déploiement.
« Encountered change event for table xxx.xxx whose schema isn't known to this connector »
Trois causes courantes :
Autorisations manquantes : Le compte n'a pas accès à toutes les bases de données utilisées dans le déploiement. Accordez les autorisations requises. Consultez Configurer une base de données MySQL.
debezium.snapshot.modedéfini surnever: La lecture depuis le début des journaux binaires signifie que le schéma de table enregistré peut ne pas correspondre au schéma actuel. Évitez ce paramètre. Pour tolérer les incompatibilités de schéma, ajoutez'debezium.inconsistent.schema.handling.mode' = 'warn'.Syntaxe DDL non prise en charge : Debezium ne peut pas interpréter certaines expressions telles que
DEFAULT (now()). Vérifiez le journal WARN deio.debezium.connector.mysql.MySqlSchemapour identifier l'instruction problématique.
« The connector is trying to read binlog starting at GTIDs ..., but this is no longer available on the server »
Le fichier de journal binaire requis par le connecteur a été supprimé. Causes courantes et solutions :
<table> <thead> <tr> <th><b>Cause</b></th> <th><b>Solution</b></th> </tr> </thead> <tbody> <tr> <td>Période de rétention des journaux binaires trop courte</td> <td>Augmentez la période de rétention, par exemple à 7 jours : <code>set global expire_logs_days=7;</code></td> </tr> <tr> <td>Consommation des journaux binaires trop lente par le déploiement (contre-pression au niveau d'un opérateur en aval)</td> <td>Optimisez la configuration des ressources pour réduire la contre-pression</td> </tr> <tr> <td>ApsaraDB RDS for MySQL : journaux conservés pendant au maximum 18 heures et jusqu'à 30 % du stockage</td> <td>Ajustez la politique d'expiration des journaux binaires pour RDS</td> </tr> <tr> <td>Instance ApsaraDB RDS for MySQL en lecture seule : journal binaire local conservé pendant un minimum de 10 secondes avant le téléchargement vers Object Storage Service (OSS)</td> <td>Évitez d'utiliser des instances en lecture seule (nom d'hôte commençant par <code>rr</code>) pour CDC ; utilisez des instances standard (nom d'hôte commençant par <code>rm</code>)</td> </tr> <tr> <td>Migration interne des données sur l'instance RDS</td> <td>Redémarrez le déploiement pour relire les données</td> </tr> </tbody> </table>
« EventDataDeserializationException: Failed to deserialize data of EventHeaderV4 »
Le serveur MySQL a fermé une connexion binlog inactive. Le paramètre net_write_timeout contrôle ce délai d'attente (par défaut : 60 secondes). Les connexions inactives en raison d'une contre-pression ou de problèmes réseau sont déconnectées.
Ajoutez
'debezium.connect.keep.alive.interval.ms' = '40000'à la configuration de la table source MySQL CDC, ou augmenteznet_write_timeoutsur la base de données. Consultez Optimiser les paramètres de l'instance.Si l'erreur est causée par une contre-pression, ajustez la configuration des ressources du déploiement.
Ververica Runtime (VVR) 8.0.7 et versions ultérieures réessaient automatiquement en cas d'erreurs causées par une contre-pression.
« The slave is connecting using CHANGE MASTER TO MASTER_AUTO_POSITION = 1, but the master has purged binary logs »
La lecture des données complètes a pris tellement de temps que la position GTID enregistrée au début de la synchronisation complète a été supprimée du serveur lorsque le connecteur est passé à la lecture incrémentielle.
Augmentez la période de rétention des journaux binaires ou la taille maximale des fichiers :
mysql> show variables like 'expire_logs_days';
mysql> set global expire_logs_days=7;
« The 'before' field of UPDATE/DELETE message is null »
Le paramètre REPLICA IDENTITY de la table PostgreSQL n'est pas défini sur FULL. Exécutez :
ALTER TABLE yourTableName REPLICA IDENTITY FULL;Si l'erreur persiste après le redémarrage du déploiement, ajoutez l'instruction au code du déploiement.
« Can't find any matched tables, please check your configured database-name and table-name »
Deux causes sont possibles :
Le nom de la table n'existe pas dans la base de données. Vérifiez le nom de table configuré.
Le compte manque d'autorisations sur certaines bases de données du déploiement. Accordez les autorisations requises sur toutes les bases de données.
« The primary key is necessary when enable 'scan.incremental.snapshot.enabled' »
Cette erreur se produit dans VVR 4.0.x lorsqu'une table source MySQL CDC est créée sans clé primaire dans la clause WITH du DDL. Ajoutez la définition de la clé primaire à l'instruction DDL.
« java.io.EOFException: SSL peer shut down incorrectly » {#javaioeofe-xception-ssl-peer-shut-down-incorrectly}
MySQL 8.0.27 active les connexions SSL par défaut, mais le pilote JDBC ne peut pas se connecter via SSL avec la configuration par défaut.
Si vous utilisez VVR 6.0.2 ou version ultérieure, ajoutez
'jdbc.properties.useSSL' = 'false'à la clauseWITH.Si la table est utilisée uniquement comme table de dimension, définissez le connecteur sur
rdset ajoutezcharacterEncoding=utf-8&useSSL=falseà l'URL :'url' = 'jdbc:mysql://***.***.***.***:3306/test?characterEncoding=utf-8&useSSL=false'
« A slave with the same server_uuid/server_id as this slave has connected to the master »
Chaque sous-tâche parallèle d'une table source MySQL CDC doit avoir un ID de serveur unique. Si des sous-tâches parallèles au sein du même déploiement — ou entre plusieurs déploiements — partagent le même ID de serveur, cette erreur se produit.
Spécifiez un ID de serveur globalement unique pour chaque sous-tâche parallèle. Pour plus de détails, consultez la section « Précautions » dans Créer une table source MySQL CDC.
« NullPointerException » après l'ajout d'une colonne pendant la lecture des données complètes
Le déploiement enregistre le schéma de la table au démarrage et le stocke dans les points de contrôle. L'ajout d'une colonne pendant la lecture des données complètes provoque une incompatibilité de schéma, ce qui déclenche une NullPointerException.
Annulez le déploiement, supprimez la table en aval et redémarrez le déploiement sans état.
« Mysql8,0 Public Key Retrieval is not allowed »
L'utilisateur MySQL est configuré avec l'authentification par mot de passe SHA256, qui nécessite TLS. Basculez l'utilisateur vers l'authentification par mot de passe natif :
ALTER USER 'username'@'localhost' IDENTIFIED WITH mysql_native_password BY 'password';
FLUSH PRIVILEGES;
« sub account not auth permission »
Lors de l'utilisation d'ApsaraDB RDS for MySQL comme source CDC, l'utilisateur RAM ne dispose pas de l'autorisation de télécharger les fichiers de journaux binaires depuis Object Storage Service (OSS). Accordez les autorisations nécessaires. Consultez Autoriser un utilisateur RAM avec des autorisations en lecture seule pour télécharger des fichiers de sauvegarde.
« DELETE command denied to user 'userName'@'\.\.\.\' for table 'table_name' »
Lorsqu'une clause WHERE filtre les flux de données CDC, Realtime Compute for Apache Flink émet à la fois un enregistrement BEFORE UPDATE et un enregistrement AFTER UPDATE pour chaque opération UPDATE. La destination en aval traite l'enregistrement BEFORE UPDATE comme une opération DELETE. Accordez l'autorisation DELETE à l'utilisateur de base de données effectuant des opérations sur la table de résultats.