Découvrez comment construire un data lakehouse en temps réel à l'aide de Realtime Compute for Apache Flink, d'Apache Paimon et de StarRocks.
Contexte
Avec la digitalisation croissante des entreprises, la demande de données actualisées ne cesse d'augmenter. La méthode traditionnelle de construction d'un entrepôt de données hors ligne repose sur la planification de tâches par lots pour fusionner périodiquement les nouvelles données dans des structures en couches, telles que ODS, DWD, DWS et ADS. Cette approche présente toutefois deux inconvénients majeurs : une latence élevée et des coûts importants. Les tâches hors ligne sont généralement planifiées toutes les heures, voire quotidiennement, ce qui signifie que les consommateurs en aval n'ont accès qu'à des données datant d'au moins une heure ou d'une journée. De plus, les mises à jour nécessitent souvent le remplacement complet des partitions. Ce processus inefficace relit l'intégralité des données originales d'une partition pour y intégrer les nouvelles modifications.
La construction d'un data lakehouse en temps réel avec Realtime Compute for Apache Flink et Apache Paimon résout les problèmes de latence et de coût associés aux entrepôts de données hors ligne traditionnels. Les capacités de traitement en temps réel de Flink permettent un flux continu de données entre les différentes couches de l'entrepôt. Parallèlement, les fonctionnalités de mise à jour efficaces de Paimon transmettent les modifications de données aux consommateurs en aval avec une latence de seulement quelques minutes. Par conséquent, le data lakehouse en temps réel offre des avantages significatifs en termes de faible latence et de rentabilité.
Pour plus d'informations sur Apache Paimon, consultez ses Fonctionnalités ainsi que le site web officiel d'Apache Paimon.
Architecture et avantages
Architecture
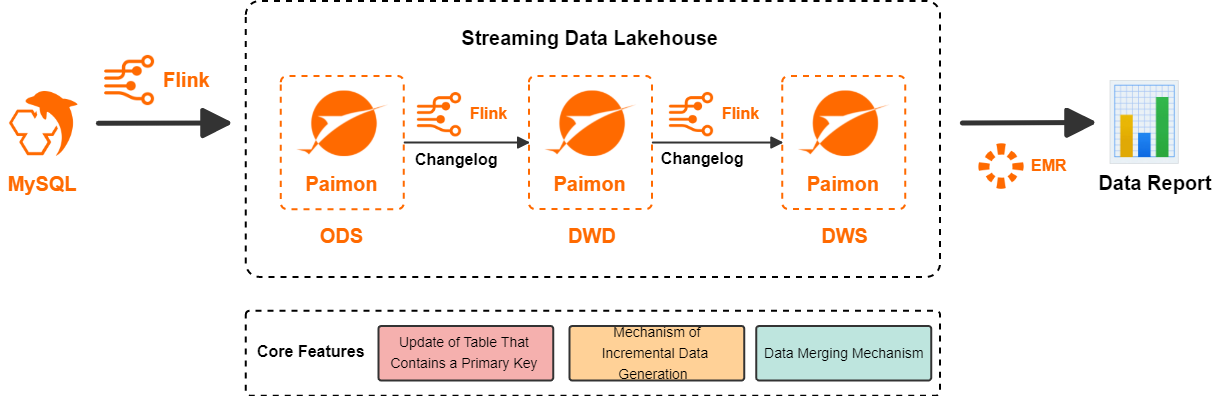
Realtime Compute for Apache Flink est un moteur de traitement de flux puissant qui traite efficacement d'importants volumes de données en temps réel. Paimon est un format de stockage de lac de données unifié pour le traitement en flux et par lots, prenant en charge les mises à jour à haut débit et les requêtes à faible latence. Paimon s'intègre profondément à Flink pour fournir une solution de data lakehouse en temps réel tout-en-un. L'illustration suivante présente l'architecture permettant de construire un data lakehouse en temps réel à l'aide de Flink et de Paimon.
Flink écrit les données provenant des sources de données vers Paimon, créant ainsi la couche ODS.
Flink s'abonne au journal des modifications (changelog) de la couche ODS, transforme les données et les réécrit dans Paimon en tant que couche DWD.
Flink s'abonne au journal des modifications de la couche DWD, transforme les données et les réécrit dans Paimon en tant que couche DWS.
Enfin, StarRocks dans E-MapReduce lit la table externe Paimon pour répondre aux requêtes des applications.
Avantages
Cette solution offre les avantages suivants :
Chaque couche de données dans Paimon propage les modifications aux systèmes en aval en quelques minutes. Cela réduit la latence d'un entrepôt de données hors ligne traditionnel, qui passe de plusieurs heures, voire jours, à quelques minutes.
Chaque couche de données dans Paimon ingère directement les données modifiées sans remplacer les partitions. Cela réduit considérablement les coûts liés aux mises à jour et aux corrections de données dans un entrepôt de données hors ligne traditionnel, tout en résolvant les défis associés à l'interrogation, à la mise à jour et à la correction des données dans les couches intermédiaires.
La solution se caractérise par un modèle unifié et une architecture simplifiée. La logique du pipeline ETL est implémentée à l'aide de Flink SQL. Les données des couches ODS, DWD et DWS sont stockées dans Paimon. Cela réduit la complexité architecturale et améliore l'efficacité du traitement des données.
Cette solution s'appuie sur trois capacités fondamentales de Paimon, détaillées dans le tableau suivant.
|
Capacité fondamentale |
Description |
|
Mises à jour des tables à clé primaire |
Paimon utilise en interne une structure de données LSM tree pour permettre des mises à jour de données efficaces. Pour plus d'informations sur les tables à clé primaire Paimon et leurs structures de données sous-jacentes, consultez Primary Key Table et File Layouts. |
|
Changelog Producer |
Paimon peut générer des données incrémentielles complètes pour tout flux de données d'entrée, où chaque enregistrement |
|
Merge Engine |
Lorsqu'une table à clé primaire Paimon reçoit plusieurs enregistrements partageant la même clé primaire, le Merge Engine fusionne ces enregistrements en un seul afin de maintenir l'unicité des clés. Paimon prend en charge une large gamme de comportements de fusion, tels que |
Cas d'utilisation
Cet article utilise une plateforme de commerce électronique comme exemple pour illustrer la construction d'un data lakehouse en temps réel. Cette solution traite et nettoie les données pour prendre en charge les requêtes des applications en amont. Grâce à la stratification des données, cette solution permet la réutilisation des données dans plusieurs scénarios métier, tels que les tableaux de bord transactionnels, l'analyse des données comportementales, les tags de profil utilisateur et les recommandations personnalisées.
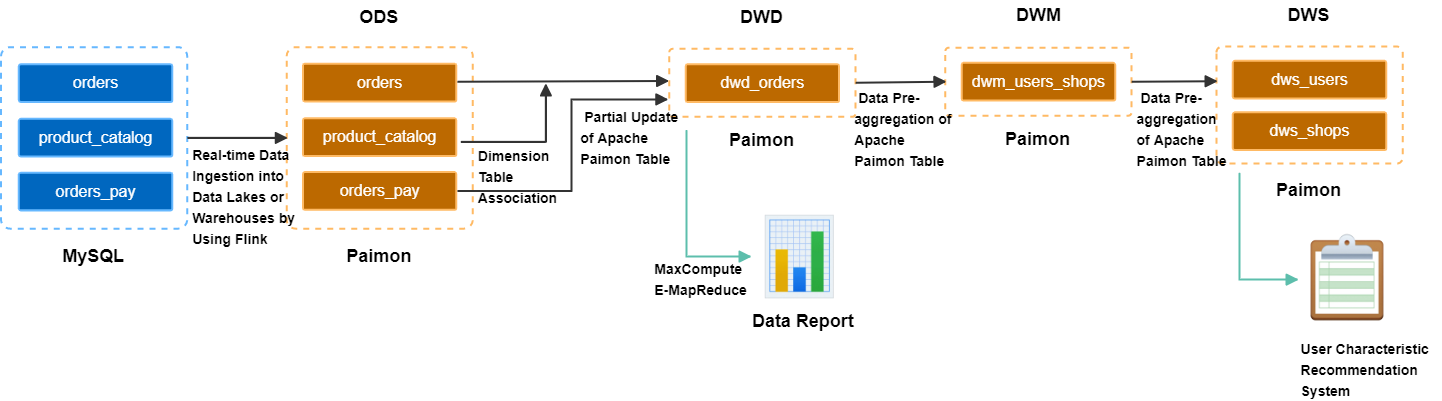
Construction de la couche ODS : ingestion en temps réel depuis la base de données métier. Flink ingère en temps réel trois tables métier de MySQL,
orders,orders_payetproduct_catalog, dans OSS. Ces données, stockées au format Paimon, constituent la couche ODS.Construction de la couche DWD : table large thématique. Les tables
orders,product_catalogetorders_paysont jointes à l'aide du mécanisme de fusion de mise à jour partielle de Paimon, créant ainsi une table large thématique pour la couche DWD et un journal des modifications avec une latence de l'ordre de la minute.Construction de la couche DWS : calcul des métriques. Flink consomme le journal des modifications de la table large en temps réel. Il utilise le mécanisme de fusion de pré-agrégation de Paimon pour créer une table d'agrégation intermédiaire,
dwm_users_shops. Ce processus génère finalement deux tables pour la couche DWS :dws_userspour les métriques d'agrégation par utilisateur etdws_shopspour les métriques d'agrégation par boutique.
Prérequis
Activez Data Lake Formation (DLF). Nous vous recommandons d'utiliser DLF 2.5 comme service de stockage. Pour plus d'informations, consultez Prise en main de DLF.
Créez un espace de travail Realtime Compute for Apache Flink. Pour plus d'informations, consultez Créer un espace de travail.
Créez une instance Serverless StarRocks. Pour plus d'informations, consultez Prise en main d'une instance Serverless StarRocks.
Votre instance StarRocks, DLF et votre espace de travail Flink doivent se trouver dans la même région.
Limites
Cette solution de data lakehouse en temps réel nécessite Ververica Runtime (VVR) version 11.1.0 ou ultérieure.
Construire un data lakehouse en temps réel
Préparer la source de données MySQL CDC****
Ce tutoriel utilise ApsaraDB RDS for MySQL comme exemple. Vous allez créer une base de données nommée order_dw et trois tables contenant des exemples de données.
-
(Obsolète. Redirection vers l'étape 1.) Créer une instance ApsaraDB RDS for MySQL.
ImportantAssurez-vous que l'instance ApsaraDB RDS for MySQL et votre espace de travail Realtime Compute for Apache Flink se trouvent dans le même VPC. S'ils se trouvent dans des VPC différents, consultez Comment accéder à d'autres services via des VPC ?
-
(Obsolète. Redirection vers l'étape 1.) Créer une base de données et un compte.
Créez une base de données nommée order_dw. Ensuite, créez un compte privilégié ou un compte standard disposant des autorisations de lecture et d'écriture pour la base de données order_dw.
Créez trois tables et insérez-y des données.
CREATE TABLE `orders` (
  order_id bigint not null primary key,
  user_id varchar(50) not null,
  shop_id bigint not null,
  product_id bigint not null,
  buy_fee bigint not null,
  create_time timestamp not null,
  update_time timestamp not null default now(),
  state int not null
);
CREATE TABLE `orders_pay` (
  pay_id bigint not null primary key,
  order_id bigint not null,
  pay_platform int not null,
  create_time timestamp not null
);
CREATE TABLE `product_catalog` (
  product_id bigint not null primary key,
  catalog_name varchar(50) not null
);
-- Prepare data
INSERT INTO product_catalog VALUES(1, 'phone_aaa'),(2, 'phone_bbb'),(3, 'phone_ccc'),(4, 'phone_ddd'),(5, 'phone_eee');
INSERT INTO orders VALUES
(100001, 'user_001', 12345, 1, 5000, '2023-02-15 16:40:56', '2023-02-15 18:42:56', 1),
(100002, 'user_002', 12346, 2, 4000, '2023-02-15 15:40:56', '2023-02-15 18:42:56', 1),
(100003, 'user_003', 12347, 3, 3000, '2023-02-15 14:40:56', '2023-02-15 18:42:56', 1),
(100004, 'user_001', 12347, 4, 2000, '2023-02-15 13:40:56', '2023-02-15 18:42:56', 1),
(100005, 'user_002', 12348, 5, 1000, '2023-02-15 12:40:56', '2023-02-15 18:42:56', 1),
(100006, 'user_001', 12348, 1, 1000, '2023-02-15 11:40:56', '2023-02-15 18:42:56', 1),
(100007, 'user_003', 12347, 4, 2000, '2023-02-15 10:40:56', '2023-02-15 18:42:56', 1);
INSERT INTO orders_pay VALUES
(2001, 100001, 1, '2023-02-15 17:40:56'),
(2002, 100002, 1, '2023-02-15 17:40:56'),
(2003, 100003, 0, '2023-02-15 17:40:56'),
(2004, 100004, 0, '2023-02-15 17:40:56'),
(2005, 100005, 0, '2023-02-15 18:40:56'),
(2006, 100006, 0, '2023-02-15 18:40:56'),
(2007, 100007, 0, '2023-02-15 18:40:56');
Gérer les métadonnées
Dans cette section, vous allez créer un catalogue Paimon et l'utiliser pour construire chaque couche de données du data lakehouse.
Créer un catalogue Paimon
Connectez-vous à la console Realtime Compute for Apache Flink.
Dans le volet de navigation de gauche, accédez à Metadata Management et cliquez sur Create Catalog.
Sous l'onglet Built-in Catalog, cliquez sur Apache Paimon, puis sur Next.
-
Configurez les paramètres suivants, sélectionnez DLF comme type de stockage et cliquez sur OK.
Paramètre
Description
Obligatoire
Notes
metastore
Le type de metastore.
Oui
Dans cet exemple, sélectionnez DLF.
catalog name
Le nom du catalogue de données DLF.
ImportantSi vous utilisez un utilisateur RAM ou un rôle RAM, assurez-vous que celui-ci dispose des autorisations nécessaires pour lire et écrire des données dans DLF. Pour plus d'informations, consultez Gérer les autorisations de données.
Oui
Nous vous recommandons d'utiliser DLF 2.5. Cette version élimine la nécessité de saisir des informations telles qu'une paire AccessKey et vous permet de sélectionner rapidement un catalogue de données DLF existant. Pour savoir comment créer un catalogue de données, consultez Catalogue de données.
Après avoir créé un catalogue de données nommé paimoncatalog, sélectionnez-le dans la liste.
-
Dans le catalogue de données, créez une base de données nommée order_dw pour synchroniser toutes les tables de la base de données MySQL order_dw.
Dans le volet de navigation de gauche, choisissez , puis cliquez sur New pour ouvrir une fenêtre de requête temporaire.
-- Use the paimoncatalog data source
USE CATALOG paimoncatalog;
-- Create the order_dw database
CREATE DATABASE order_dw;
Le message retourné
The following statement has been executed successfully!indique que la base de données a été créée avec succès.
Pour plus d'informations sur l'utilisation des catalogues Paimon, consultez Gérer les catalogues Paimon.
Créer un catalogue MySQL
Sur la page Metadata Management, cliquez sur Create Catalog.
Sous l'onglet Built-in Catalog, cliquez sur MySQL, puis sur Next.
-
Configurez les paramètres suivants et cliquez sur OK pour créer un catalogue MySQL nommé mysqlcatalog.
Paramètre
Description
Obligatoire
Notes
catalog name
Le nom du catalogue.
Oui
Saisissez un nom personnalisé. Ce tutoriel utilise mysqlcatalog.
hostname
L'adresse IP ou le nom d'hôte de la base de données MySQL.
Oui
Pour plus d'informations, consultez Afficher et gérer les points de terminaison et les ports de connexion des instances. Étant donné que l'instance ApsaraDB RDS for MySQL et l'espace de travail Realtime Compute for Apache Flink se trouvent dans le même VPC, saisissez le point de terminaison interne.
port
Le numéro de port du service de base de données MySQL. La valeur par défaut est 3306.
Non
Pour plus d'informations, consultez Afficher et gérer les points de terminaison et les ports de connexion des instances.
default-database
Le nom de la base de données MySQL par défaut.
Oui
Saisissez le nom de la base de données à synchroniser, soit order_dw dans ce tutoriel.
username
Le nom d'utilisateur pour le service de base de données MySQL.
Oui
Utilisez le compte créé dans Préparer la source de données MySQL CDC.
password
Le mot de passe pour le service de base de données MySQL.
Oui
Utilisez le mot de passe du compte créé dans Préparer la source de données MySQL CDC.
Construire la couche ODS : ingestion en temps réel
Construisez la couche ODS en une seule étape à l'aide d'une tâche d'ingestion de données Flink CDC au format YAML pour synchroniser les données de MySQL vers Paimon.
-
Créez et démarrez la tâche d'ingestion de données YAML.
Dans la console Realtime Compute for Apache Flink, accédez à la page et créez un projet YAML vierge nommé ods.
-
Copiez le code suivant dans l'éditeur et mettez à jour les paramètres tels que le nom d'utilisateur et le mot de passe.
source:
  type: mysql
  name: MySQL Source
  hostname: rm-bp1e********566g.mysql.rds.aliyuncs.com
  port: 3306
  username: ${secret_values.username}
  password: ${secret_values.password}
  tables: order_dw.\.*  # Use a regular expression to read all tables in the order_dw database.
  # (Optional) Synchronize data from newly created tables during the incremental phase.
  scan.binlog.newly-added-table.enabled: true
  # (Optional) Synchronize table and field comments.
  include-comments.enabled: true
  # (Optional) Prioritize the distribution of unbounded chunks to prevent potential TaskManager OutOfMemory issues.
  scan.incremental.snapshot.unbounded-chunk-first.enabled: true
  # (Optional) Enable parsing filters to accelerate reads.
  scan.only.deserialize.captured.tables.changelog.enabled: true
sink:
  type: paimon
  name: Paimon Sink
  catalog.properties.metastore: rest
  catalog.properties.uri: http://cn-beijing-vpc.dlf.aliyuncs.com
  catalog.properties.warehouse: paimoncatalog
  catalog.properties.token.provider: dlf
pipeline:
  name: MySQL to Paimon Pipeline
Paramètre
Description
Obligatoire
Exemple
catalog.properties.metastoreLe type de metastore. Définissez cette valeur sur rest.
Oui
rest
catalog.properties.token.providerLe fournisseur de jetons. Définissez cette valeur sur DLF.
Oui
DLF
catalog.properties.uriL'URI d'accès au serveur DLF Rest Catalog est
http://[region-id]-vpc.dlf.aliyuncs.com. Pour plus d'informations sur l'ID de région, consultez Points de terminaison de service.Oui
http://cn-beijing-vpc.dlf.aliyuncs.com
catalog.properties.warehouseLe nom du catalogue DLF.
Oui
paimoncatalog
hostnameL'adresse IP ou le nom d'hôte de la base de données MySQL. Pour plus d'informations, consultez Afficher et gérer les points de terminaison et les ports de connexion des instances. Étant donné que l'instance ApsaraDB RDS for MySQL et l'espace de travail Realtime Compute for Apache Flink se trouvent dans le même VPC, saisissez le point de terminaison interne.
Oui
rm-bp1e****566g.mysql.rds.aliyuncs.com
usernameLe nom d'utilisateur pour la base de données MySQL. Nous vous recommandons d'utiliser la gestion des secrets. Pour plus d'informations, consultez Gérer les variables.
Oui
${secret_values.username}
passwordLe mot de passe pour la base de données MySQL. Nous vous recommandons d'utiliser la gestion des secrets. Pour plus d'informations, consultez Gérer les variables.
Oui
${secret_values.password}
Pour optimiser les performances d'écriture de Paimon, consultez Optimisation des performances de Paimon.
Dans le coin supérieur droit, cliquez sur Deploy.
Dans , cliquez sur Start dans la colonne Actions de la tâche ODS nouvellement déployée, et sélectionnez stateless start pour démarrer la tâche. Pour plus d'informations sur les configurations de démarrage des tâches, consultez Démarrage des tâches.
-
Consultez les données des trois tables synchronisées de MySQL vers Paimon.
Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
SELECT * FROM paimoncatalog.order_dw.orders ORDER BY order_id;Après l'exécution de la requête, celle-ci renvoie sept enregistrements de commande de la table orders. Le résultat inclut les colonnes order_id (100001 à 100007), user_id, shop_id, product_id, buy_fee (1000 à 5000), create_time, update_time et state. La valeur de state est 1 pour tous les enregistrements.
Construire la couche DWD : table large thématique
-
Créez la table large dwd_orders
Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
CREATE TABLE paimoncatalog.order_dw.dwd_orders (
    order_id BIGINT,
    order_user_id STRING,
    order_shop_id BIGINT,
    order_product_id BIGINT,
    order_product_catalog_name STRING,
    order_fee BIGINT,
    order_create_time TIMESTAMP,
    order_update_time TIMESTAMP,
    order_state INT,
    pay_id BIGINT,
    pay_platform INT COMMENT 'platform 0: phone, 1: pc',
    pay_create_time TIMESTAMP,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'merge-engine' = 'partial-update', -- Use the partial-update merge engine to generate the wide table
    'changelog-producer' = 'lookup' -- Use the lookup changelog producer to generate changelogs with low latency
);
Le message
The following statement has been executed successfully!indique une création réussie. -
Consommer les données de modification ODS
Dans la console Realtime Compute for Apache Flink, accédez à la page . Créez une nouvelle tâche de streaming SQL nommée dwd, copiez le code suivant dans l'éditeur SQL, cliquez sur Deploy, puis démarrez la tâche en utilisant Stateless Start.
Cette tâche SQL joint la table orders à la table product_catalog via une jointure de table de dimension. Elle écrit ensuite le résultat dans la table dwd_orders ainsi que les données de la table orders_pay. Le mécanisme de fusion de mise à jour partielle de Paimon joint les enregistrements des tables orders et orders_pay ayant le même order_id.
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- Paimon does not currently support multiple INSERT statements into the same table within a single job. Therefore, UNION ALL is used here. INSERT INTO paimoncatalog.order_dw.dwd_orders SELECT o.order_id, o.user_id, o.shop_id, o.product_id, dim.catalog_name, o.buy_fee, o.create_time, o.update_time, o.state, NULL, NULL, NULL FROM paimoncatalog.order_dw.orders o LEFT JOIN paimoncatalog.order_dw.product_catalog FOR SYSTEM_TIME AS OF proctime() AS dim ON o.product_id = dim.product_id UNION ALL SELECT order_id, NULL, NULL, NULL, NULL, NULL, NULL, NULL, NULL, pay_id, pay_platform, create_time FROM paimoncatalog.order_dw.orders_pay; -
Afficher les données dans dwd_orders
Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
SELECT * FROM paimoncatalog.order_dw.dwd_orders ORDER BY order_id;Une fois la requête exécutée avec succès, elle renvoie sept enregistrements de commande de la table large
dwd_orders. Le résultat comprend huit champs :order_id,order_user_id,order_shop_id,order_product_id,order_product_catalog_name,order_fee,order_create_timeetorder_update_time. L'order_idvarie de 100001 à 100007, les frais de commande vont de 1000 à 5000 et toutes les dates de création sont le 15/02/2023.
Construire la couche DWS : calcul des métriques
-
Créez les tables d'agrégation de la couche DWS dws_users et dws_shops.
Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
-- User dimension aggregate table.
CREATE TABLE paimoncatalog.order_dw.dws_users (
    user_id STRING,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT 'Total amount paid on the current day',
    PRIMARY KEY (user_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- Use the aggregation merge engine to generate the aggregate table.
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum' -- Aggregate the result by summing the data in paid_buy_fee_sum.
    -- Because the dws_users table is not consumed by downstream streaming jobs, you do not need to specify a changelog producer.
);
-- Shop dimension aggregate table.
CREATE TABLE paimoncatalog.order_dw.dws_shops (
    shop_id BIGINT,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT 'Total amount paid on the current day',
    uv BIGINT COMMENT 'Total number of distinct purchasing users on the current day',
    pv BIGINT COMMENT 'Total number of purchases by users on the current day',
    PRIMARY KEY (shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- Use the aggregation merge engine to generate the aggregate table.
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum', -- Aggregate the result by summing the data in paid_buy_fee_sum.
    'fields.uv.aggregate-function' = 'sum', -- Aggregate the result by summing the data in uv.
    'fields.pv.aggregate-function' = 'sum' -- Aggregate the result by summing the data in pv.
    -- Because the dws_shops table is not consumed by downstream streaming jobs, you do not need to specify a changelog producer.
);
-- To calculate both user- and shop-dimension aggregate tables simultaneously, create an intermediate table with a primary key of user and shop.
CREATE TABLE paimoncatalog.order_dw.dwm_users_shops (
    user_id STRING,
    shop_id BIGINT,
    ds STRING,
    paid_buy_fee_sum BIGINT COMMENT 'Total amount a user paid in a shop on the current day',
    pv BIGINT COMMENT 'Number of times a user purchased from a shop on the current day',
    PRIMARY KEY (user_id, shop_id, ds) NOT ENFORCED
) WITH (
    'merge-engine' = 'aggregation', -- Use the aggregation merge engine to generate the aggregate table.
    'fields.paid_buy_fee_sum.aggregate-function' = 'sum', -- Aggregate the result by summing the data in paid_buy_fee_sum.
    'fields.pv.aggregate-function' = 'sum', -- Aggregate the result by summing the data in pv.
    'changelog-producer' = 'lookup', -- Use the lookup changelog producer to generate changelogs with low latency.
    -- Intermediate tables in the DWM layer are not typically queried directly by upstream applications, so they can be optimized for write performance.
    'file.format' = 'avro', -- Using the Avro row-based storage format provides more efficient write performance.
    'metadata.stats-mode' = 'none' -- Omitting statistics increases the cost of OLAP queries (with no impact on continuous stream processing) but improves write performance.
);
Le message
The following statement has been executed successfully!indique que la création a réussi. -
Consommer les données de modification de la table dwd_orders de la couche DWD.
Dans la console Realtime Compute for Apache Flink, accédez à la page , créez une nouvelle tâche de streaming SQL nommée dwm. Copiez le code suivant dans l'éditeur SQL, cliquez sur Deploy, puis démarrez la tâche en utilisant Stateless Start.
Cette tâche SQL écrit les données de la table dwd_orders dans la table dwm_users_shops. Le mécanisme de fusion de pré-agrégation des données de Paimon additionne automatiquement order_fee pour calculer le montant total dépensé par un utilisateur dans une boutique. Il additionne également la valeur 1 pour calculer le nombre de fois qu'un utilisateur a effectué un achat dans cette boutique.
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; INSERT INTO paimoncatalog.order_dw.dwm_users_shops SELECT order_user_id, order_shop_id, DATE_FORMAT (pay_create_time, 'yyyyMMdd') as ds, order_fee, 1 -- One input record represents one purchase FROM paimoncatalog.order_dw.dwd_orders WHERE pay_id IS NOT NULL AND order_fee IS NOT NULL; -
Consommer en temps réel les données de modification de la table dwm_users_shops de la couche DWM.
Dans la console Realtime Compute for Apache Flink, accédez à la page . Créez une nouvelle tâche de streaming SQL nommée dws. Copiez le code suivant dans l'éditeur SQL, cliquez sur Deploy, puis démarrez la tâche en utilisant Stateless Start.
Cette tâche SQL écrit les données de la table dwm_users_shops dans les tables dws_users et dws_shops. Le mécanisme de fusion de pré-agrégation des données de Paimon est utilisé pour calculer les dépenses totales de chaque utilisateur (paid_buy_fee_sum) dans la table dws_users. Dans la table dws_shops, il calcule le chiffre d'affaires total de la boutique (paid_buy_fee_sum), le nombre d'utilisateurs acheteurs (en additionnant 1) et le nombre total d'achats (pv).
SET 'execution.checkpointing.max-concurrent-checkpoints' = '3'; SET 'table.exec.sink.upsert-materialize' = 'NONE'; SET 'execution.checkpointing.interval' = '10s'; SET 'execution.checkpointing.min-pause' = '10s'; -- Unlike the DWD job, each INSERT statement here writes to a different Paimon table, so they can be included in the same job. BEGIN STATEMENT SET; INSERT INTO paimoncatalog.order_dw.dws_users SELECT user_id, ds, paid_buy_fee_sum FROM paimoncatalog.order_dw.dwm_users_shops; -- The primary key is the shop ID. Data for popular shops might be much larger than for others. -- Therefore, use local merge to pre-aggregate data in memory before writing to Paimon to mitigate data skew. INSERT INTO paimoncatalog.order_dw.dws_shops /*+ OPTIONS('local-merge-buffer-size' = '64mb') */ SELECT shop_id, ds, paid_buy_fee_sum, 1, -- One input record represents all of a user's purchases at this shop pv FROM paimoncatalog.order_dw.dwm_users_shops; END; -
Consultez les données des tables dws_users et dws_shops.
Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
--View the data in the dws_users table
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;
Après l'exécution de la requête, la table dws_users renvoie trois enregistrements avec les colonnes suivantes :
user_id,dsetpaid_buy_fee_sum. Les enregistrements sont :user_001/ 20230215 / 8000,user_002/ 20230215 / 5000 etuser_003/ 20230215 / 5000.--View the data in the dws_shops table SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;Après avoir interrogé la table dws_shops, le résultat contient quatre lignes et cinq colonnes :
shop_id,ds,paid_buy_fee_sum,uvetpv. Les shop_ids vont de 12345 à 12348, ds est 20230215 pour tous les enregistrements, les valeurs paid_buy_fee_sum sont 5000, 4000, 7000 et 2000, les valeurs uv sont 1, 1, 2 et 2, et les valeurs pv sont respectivement 1, 1, 3 et 2.
Capturer les modifications de la base de données métier
Après avoir construit le data lakehouse en temps réel, testez sa capacité à capturer les modifications de la base de données métier.
-
Insérez les données suivantes dans la base de données order_dw de MySQL.
INSERT INTO orders VALUES (100008, 'user_001', 12345, 3, 3000, '2023-02-15 17:40:56', '2023-02-15 18:42:56', 1), (100009, 'user_002', 12348, 4, 1000, '2023-02-15 18:40:56', '2023-02-15 19:42:56', 1), (100010, 'user_003', 12348, 2, 2000, '2023-02-15 19:40:56', '2023-02-15 20:42:56', 1); INSERT INTO orders_pay VALUES (2008, 100008, 1, '2023-02-15 18:40:56'), (2009, 100009, 1, '2023-02-15 19:40:56'), (2010, 100010, 0, '2023-02-15 20:40:56'); -
Consultez les données des tables dws_users et dws_shops. Dans la console Realtime Compute for Apache Flink, accédez à la page . Sous l'onglet Query Editor, copiez le code suivant dans l'éditeur, sélectionnez l'instruction, puis cliquez sur Run dans le coin supérieur droit.
-
Table dws_users
SELECT * FROM paimoncatalog.order_dw.dws_users ORDER BY user_id;La requête renvoie trois lignes avec les colonnes suivantes :
user_id,dsetpaid_buy_fee_sum. Les enregistrements sont :user_001/ 20230215 / 11000,user_002/ 20230215 / 6000 etuser_003/ 20230215 / 7000. -
Table dws_shops
SELECT * FROM paimoncatalog.order_dw.dws_shops ORDER BY shop_id;La requête renvoie quatre lignes avec cinq colonnes :
shop_id,ds,paid_buy_fee_sum,uvetpv. Les shop_ids sont 12345, 12346, 12347 et 12348, ds est 20230215 pour tous les enregistrements, les valeurs paid_buy_fee_sum sont 8000, 4000, 7000 et 5000, les valeurs uv sont 1, 1, 2 et 3, et les valeurs pv sont respectivement 2, 1, 3 et 4.
-
Utiliser le data lakehouse en temps réel
La section précédente a démontré comment créer un catalogue Paimon et écrire dans des tables Paimon dans Flink. Cette section présente quelques cas d'utilisation simples d'analyse de données à l'aide de StarRocks après la configuration du data lakehouse en temps réel.
Connecter StarRocks à DLF
Pour plus d'informations, consultez Accéder à DLF depuis Serverless StarRocks.
Requête de classement
La requête StarRocks suivante analyse la table d'agrégation de la couche DWS pour récupérer les trois boutiques ayant réalisé le plus grand chiffre d'affaires le 15 février 2023.
SELECT ROW_NUMBER() OVER (ORDER BY paid_buy_fee_sum DESC) AS rn, shop_id, paid_buy_fee_sum
FROM paimoncatalog.order_dw.dws_shops
WHERE ds = '20230215'
ORDER BY rn LIMIT 3;
La requête renvoie trois lignes : rn=1 correspond à shop_id=12345 et paid_buy_fee_sum=8000.00 ; rn=2 correspond à shop_id=12347 et paid_buy_fee_sum=7000.00 ; et rn=3 correspond à shop_id=12348 et paid_buy_fee_sum=5000.00.
Requête de détail
La requête StarRocks suivante analyse la table large de la couche DWD pour récupérer les détails des commandes d'un client spécifique ayant utilisé une plateforme de paiement particulière en février 2023.
SELECT * FROM paimoncatalog.order_dw.dwd_orders
WHERE order_create_time >= '2023-02-01 00:00:00' AND order_create_time < '2023-03-01 00:00:00'
AND order_user_id = 'user_001'
AND pay_platform = 0
ORDER BY order_create_time;;
La requête renvoie le résultat suivant.
   order_id  order_user_id  order_shop_id  order_product_id  order_product_catalog_name  order_fee
0  100006    user_001       12348          1                 phone_aaa                   1000
1  100004    user_001       12347          4                 phone_ddd                   2000
Rapport de données
La requête StarRocks suivante analyse la table large de la couche DWD pour générer un rapport sur le nombre total de commandes et le montant total des commandes pour chaque date et catégorie de produit en février 2023.
SELECT
  order_create_time AS order_create_date,
  order_product_catalog_name,
  COUNT(*),
  SUM(order_fee)
FROM
  paimoncatalog.order_dw.dwd_orders
WHERE
  order_create_time >= '2023-02-01 00:00:00'  and order_create_time < '2023-03-01 00:00:00'
GROUP BY
  order_create_date, order_product_catalog_name
ORDER BY
  order_create_date, order_product_catalog_name;
La requête renvoie neuf enregistrements, affichant les données horaires des commandes de 10:40:56 à 18:40:56 le 15 février 2023. Les catégories de produits incluent phone_ddd, phone_aaa, phone_eee, phone_ccc et phone_bbb. Chaque enregistrement a un count(*) de 1, et les valeurs sum(order_fee) sont respectivement 2000, 1000, 1000, 2000, 3000, 4000, 5000, 3000 et 1000.
Références
Pour construire un lac de données hors ligne Paimon à l'aide du traitement par lots Flink, consultez Traitement par lots Flink.