Le diagnostic SQL d'AnalyticDB for MySQL collecte les statistiques d'exécution aux niveaux de la requête, de l'étape et de l'opérateur, puis affiche des suggestions d'optimisation. Cette rubrique décrit les trois types de résultats de diagnostic au niveau de l'étape et explique comment y remédier.
Pour savoir comment afficher les résultats du diagnostic au niveau de l'étape, consultez
.
Types de résultats de diagnostic
Diffusion de grandes quantités de données
Signification
La diffusion (broadcast) transmet les données d'une étape en amont vers une étape en aval. Lorsqu'une étape diffuse un volume important de données, la requête peut consommer une quantité excessive de mémoire. Pour plus d'informations sur la diffusion et les autres types de sortie de données, consultez Data output types.
Impact sur les performances
Les données diffusées constituent la table de droite dans une jointure et sont chargées dans une table de hachage en mémoire. Plus le volume de données diffusées est important, plus la consommation de mémoire est élevée.
Actions recommandées
Déterminez d'abord si la diffusion est appropriée pour votre requête :
-
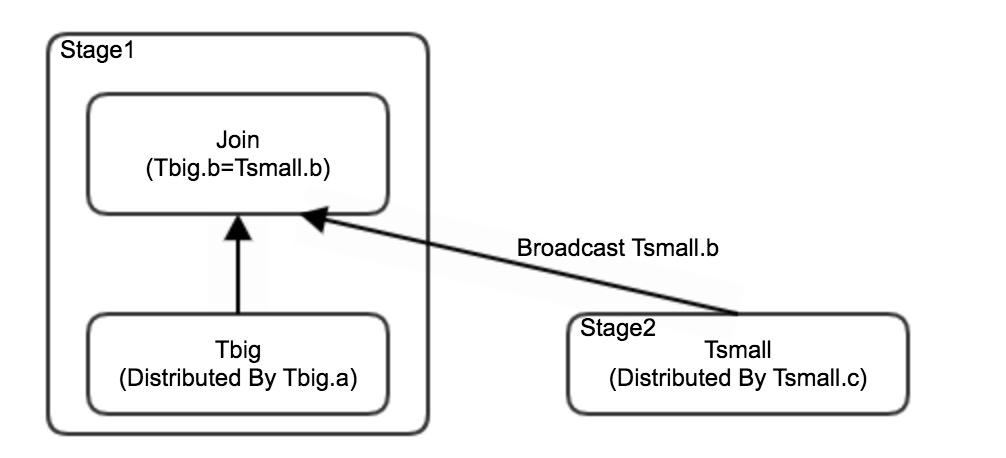
La diffusion est souvent le bon choix lorsque la table de droite est petite. Elle évite la redistribution des données pour la table de gauche, plus volumineuse, et réduit les connexions réseau entre les nœuds. L'exemple suivant illustre cette situation. Supposons qu'un déséquilibre important des données existe dans la colonne
bdeTsmall, tandis queTbigest uniformément répartie sur les nœuds de stockage selon la colonnea. Sans diffusion, la redistribution deTbigentraîne un traitement à longue traîne, ce qui retarde également l'étape de jointure en aval. La diffusion deTsmallsupprime entièrement l'étape de redistribution, résolvant ainsi le problème de longue traîne.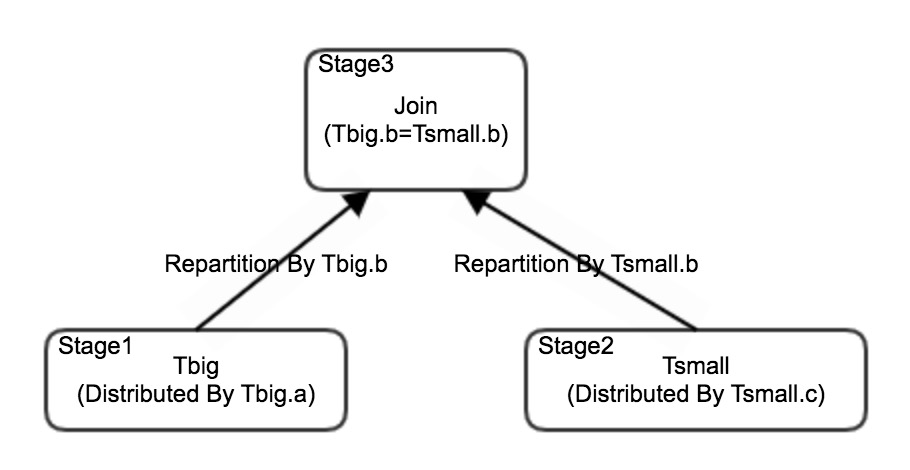
La diffusion peut être inappropriée lorsque les statistiques sont obsolètes. Des statistiques de table périmées amènent l'optimiseur à estimer incorrectement la taille de la table, ce qui conduit à la diffusion involontaire d'une table volumineuse. Dans ce cas, ajoutez l'indication
JOIN_DISTRIBUTION_TYPE=repartitionedpour désactiver la diffusion et basculer vers la redistribution des données.
Déséquilibre des données en entrée de l'étape
Signification
Les données d'entrée de cette étape sont inégalement réparties entre les nœuds. Un ou plusieurs nœuds reçoivent nettement plus de données que les autres.
Impact sur les performances
Le déséquilibre des entrées crée un goulot d'étranglement : le nœud surchargé met plus de temps à terminer son travail, tandis que les autres nœuds restent inactifs. Le temps d'exécution total de l'étape dépend du nœud le plus lent.
Actions recommandées
Identifiez la cause du déséquilibre :
Déséquilibre issu d'une analyse de table — La colonne de distribution choisie lors de la création de la table produit une répartition inégale des données. Vérifiez et modifiez la colonne de distribution. Pour obtenir des conseils, consultez Distribution field skew diagnosis.
Déséquilibre issu du transfert réseau — L'étape en amont produit des données déséquilibrées, qui sont ensuite redistribuées de manière inégale vers cette étape. Vérifiez si l'étape en amont présente un résultat de diagnostic « Data skew in stage output » et corrigez le problème à ce niveau en priorité.
Déséquilibre des données en sortie de l'étape
Signification
Les données de sortie de cette étape sont inégalement réparties entre les nœuds avant d'être transmises à l'étape en aval.
Impact sur les performances
Un déséquilibre en sortie entraîne des temps de traitement inégaux entre les nœuds, créant un effet de longue traîne. Si l'étape en aval effectue des opérations complexes, le nœud le plus lent prolonge le temps d'exécution global de la requête.
Actions recommandées
Examinez les colonnes affichées dans les résultats du diagnostic pour détecter des motifs de déséquilibre. Une cause fréquente est la présence d'une proportion élevée de valeurs nulles dans une colonne de distribution.