La fonctionnalité de diagnostic SQL d'AnalyticDB for MySQL représente le plan d'exécution d'une requête SQL sous forme d'arborescence visuelle. Un plan d'exécution se compose de deux niveaux : le niveau des étapes (stage) et le niveau des opérateurs. Cette rubrique explique comment exploiter ces arborescences aux deux niveaux pour analyser les performances des requêtes.
Arborescence du plan d'exécution au niveau des étapes
L'arborescence du plan d'exécution au niveau des étapes comprend plusieurs nœuds d'étape, où les données circulent de bas en haut. Le processus débute par les étapes contenant des opérateurs de lecture qui analysent les données. Les données transitent ensuite par des étapes intermédiaires avant que le nœud racine, situé au sommet, ne renvoie les résultats de la requête au client.
L'arborescence du plan d'exécution au niveau des étapes fournit les informations suivantes :
-
Informations de base
Chaque rectangle du diagramme représente une étape. Il contient des informations telles que l'ID de l'étape, le type de sortie des données, ainsi que la durée ou l'utilisation de la mémoire. L'utilisation de la mémoire s'affiche lorsque vous triez le plan en sélectionnant By Memory.
RemarqueUne icône d'avertissement rouge sur une étape dans l'arborescence du plan d'exécution indique qu'il est possible d'optimiser cette étape.
-
Nombre de lignes en sortie
Le nombre affiché sur la ligne reliant deux étapes adjacentes représente le nombre de lignes que l'étape amont transmet à l'étape aval. Plus le nombre de lignes transmises est élevé, plus la ligne de connexion est épaisse.
-
Méthode de sortie des données
Il s'agit de la méthode utilisée pour transférer les données entre les étapes amont et aval. AnalyticDB for MySQL prend en charge les méthodes de sortie de données suivantes.
|
**Méthode de sortie**
|
**Description**
| | --- | --- | |
**Broadcast**
|
Copie les données de chaque nœud de calcul d'une étape amont vers tous les nœuds de calcul de l'étape aval.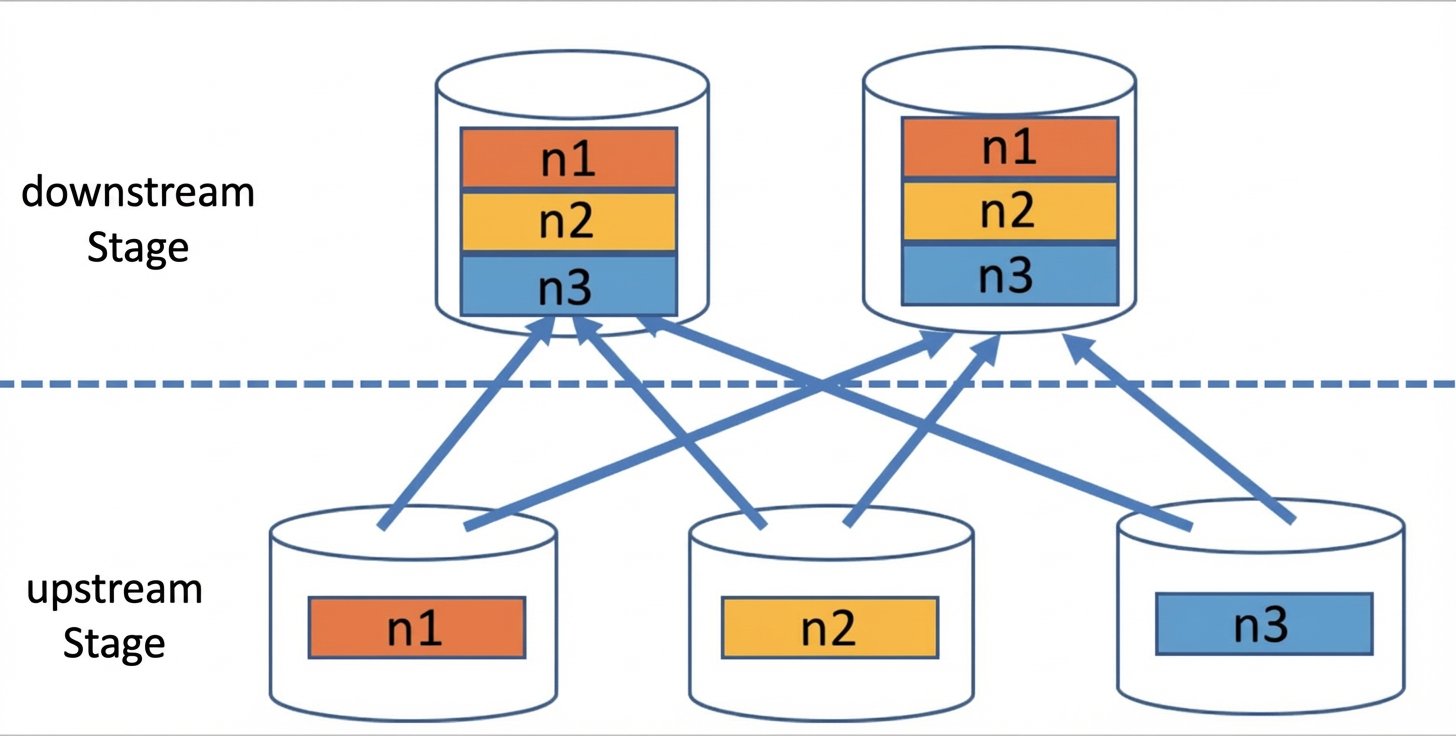 
| |
**Repartition**
|
Partitionne les données de chaque nœud de calcul d'une étape amont selon des règles spécifiques, puis les distribue aux nœuds de calcul spécifiés dans l'étape aval.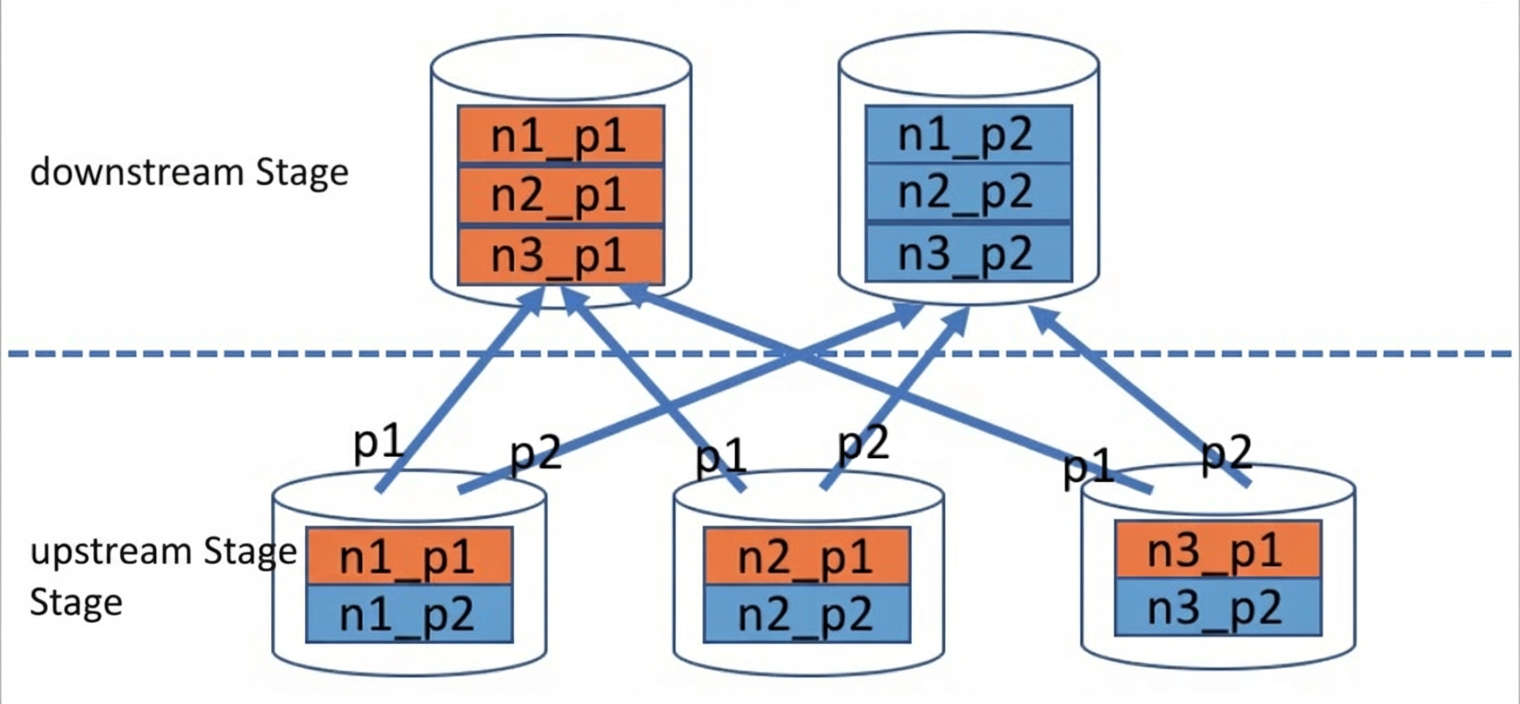 
| |
**Gather**
|
Envoie les données de chaque nœud de calcul d'une étape amont vers un seul nœud de calcul spécifique dans l'étape aval.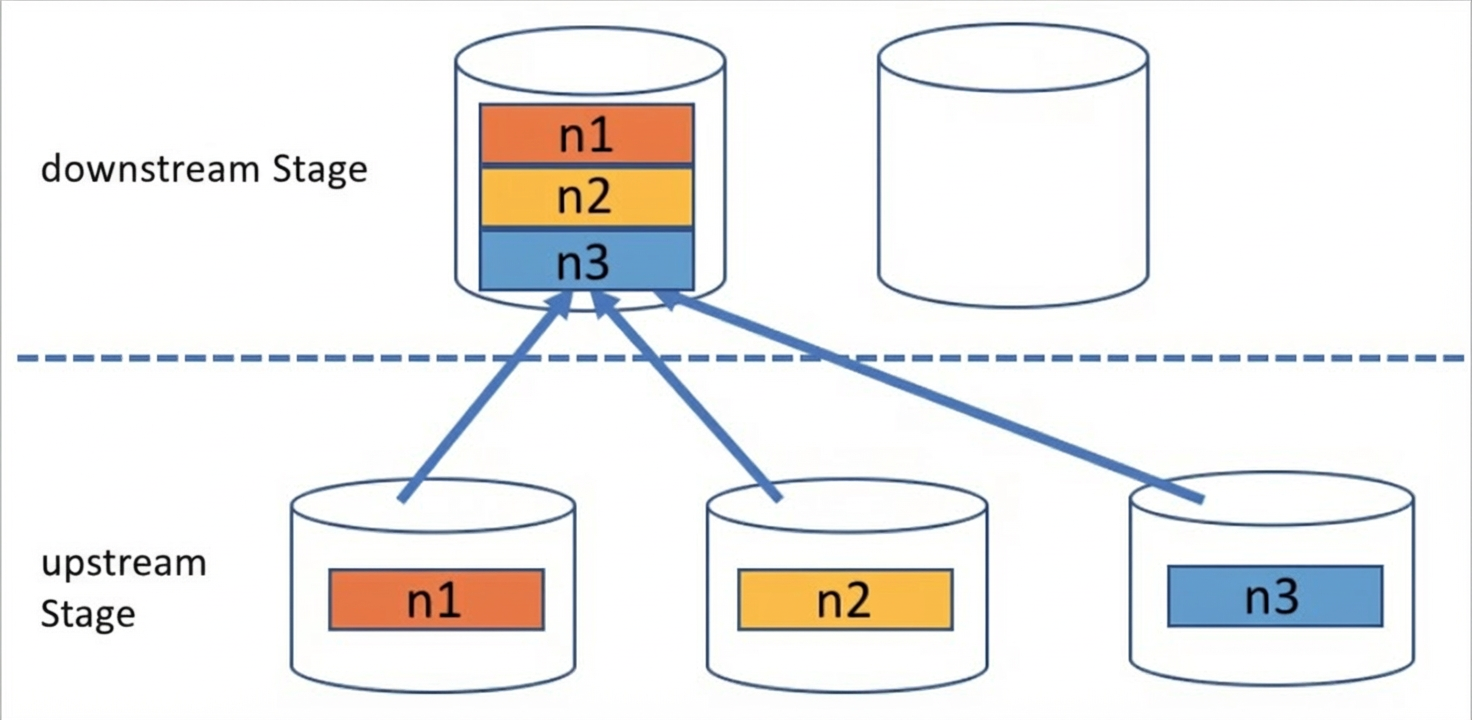 
| -
10 principales étapes par utilisation de la mémoire ou durée d'exécution
L'onglet Top 10 Nodes in Descending Order by Duration or Memory situé à droite de l'arborescence du plan d'exécution répertorie les ID et les pourcentages correspondants des 10 étapes représentant la plus grande part de la durée totale de la requête ou de l'utilisation totale de la mémoire.
RemarquePar défaut, les étapes sont triées By Duration. Vous pouvez également sélectionner By Memory dans le coin supérieur droit de l'arborescence du plan d'exécution.
L'onglet Top 10 Nodes in Descending Order by Duration or Memory n'affiche pas les étapes dont l'utilisation de la mémoire ou la durée d'exécution représente moins de 1 % du total.
En raison des différences entre les méthodes statistiques, la somme des pourcentages de durée ou de mémoire pour toutes les étapes d'une requête peut ne pas atteindre 100 %.
-
Diagnostic Results
Cliquez sur une étape, telle que Stage[1], dans l'arborescence du plan d'exécution pour afficher ses détails dans le volet Diagnostic Results à droite. Celui-ci inclut deux types de diagnostics :
Diagnostics d'étape : Fournit une description détaillée des résultats du diagnostic pour l'étape cible, y compris les problèmes identifiés tels qu'une diffusion de données volumineuse ou un déséquilibre des données (data skew), ainsi que les recommandations d'optimisation correspondantes.
Diagnostics d'opérateur : Affiche uniquement les noms des opérateurs problématiques au sein de l'étape actuelle et un bref aperçu des problèmes. Pour obtenir des descriptions détaillées et des solutions d'optimisation, consultez l'arborescence du plan d'exécution au niveau des opérateurs. Pour plus d'informations, voir Arborescence du plan d'exécution au niveau des opérateurs.
Pour plus d'informations sur les résultats du diagnostic d'une étape, consultez la rubrique Résultats du diagnostic au niveau de l'étape.
-
Statistics
Sous le volet Diagnostic Results, la section Statistics affiche les métriques pour l'étape cible.
Métrique
Description
Peak Memory
La mémoire maximale consommée par l'étape. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la consommation réelle de mémoire.
Cumulative Duration
La somme des temps d'exécution de tous les opérateurs au sein de l'étape, agrégée sur tous les nœuds de calcul et threads. Le système sélectionne automatiquement l'unité (ms, s, min ou h) en fonction de la durée réelle.
RemarqueCette durée cumulative ne peut pas être comparée directement à la durée totale de la requête.
Output Rows
Le nombre de lignes produites en sortie par l'étape.
Amount of Output Data
La taille des données produites en sortie par l'étape. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la taille réelle des données.
Input Rows
Le nombre de lignes reçues en entrée par l'étape.
Amount of Input Data
La taille des données reçues en entrée par l'étape. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la taille réelle des données.
Scanned Rows
Le nombre de lignes analysées par l'étape.
RemarqueCette métrique est disponible uniquement si l'étape contient un opérateur de lecture (scan).
Scan Size
La taille des données analysées par l'étape. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la taille réelle des données.
RemarqueCette métrique est disponible uniquement si l'étape contient un opérateur de lecture (scan).
Arborescence du plan d'exécution au niveau des opérateurs
Le plan d'exécution au niveau des opérateurs se compose de plusieurs opérateurs. Chaque rectangle du diagramme représente un opérateur et les données circulent de bas en haut. Le processus commence par les opérateurs situés à la base de l'arborescence, tels que TableScan et RemoteSource, qui analysent les données ou les reçoivent via le réseau. Les données transitent ensuite par des opérateurs intermédiaires. Enfin, un opérateur racine, tel que StageOutput ou Output, situé au sommet, envoie les données à une étape aval ou renvoie le résultat final de la requête au client.
Pour afficher l'arborescence du plan d'exécution au niveau des opérateurs, survolez une étape et cliquez sur View Stage Plans dans la fenêtre contextuelle pour accéder à la page des détails du plan de cette étape.
L'arborescence du plan d'exécution au niveau des opérateurs fournit les informations suivantes :
Une icône d'avertissement rouge sur un opérateur dans l'arborescence du plan d'exécution indique qu'il est possible d'optimiser cet opérateur.
-
Informations de base
Chaque rectangle du diagramme représente un opérateur. Il contient le nom et l'ID de l'opérateur, les propriétés de l'opérateur (telles que les conditions de jointure et l'algorithme pour un opérateur
Join), ainsi que la durée ou l'utilisation de la mémoire. L'utilisation de la mémoire s'affiche lorsque vous triez le plan en sélectionnant By Memory. -
Nombre de lignes en sortie
Le nombre affiché sur la ligne reliant deux opérateurs adjacents représente le nombre de lignes que l'opérateur amont transmet à l'opérateur aval. Plus le nombre de lignes transmises est élevé, plus la ligne de connexion est épaisse.
-
10 principaux opérateurs par utilisation de la mémoire ou durée d'exécution
L'onglet Top 10 Nodes in Descending Order by Duration or Memory situé à droite de l'arborescence du plan d'exécution affiche les ID et les ratios correspondants des 10 opérateurs représentant le plus grand pourcentage de la durée totale de la requête ou de l'utilisation totale de la mémoire.
RemarquePar défaut, les opérateurs sont triés By Duration. Vous pouvez également sélectionner By Memory dans le coin supérieur droit de l'arborescence du plan d'exécution.
L'onglet Top 10 Nodes in Descending Order by Duration or Memory n'affiche pas les opérateurs dont l'utilisation de la mémoire ou la durée d'exécution représente moins de 1 % du total.
En raison des différences entre les méthodes statistiques, la somme des pourcentages de durée ou de mémoire pour tous les opérateurs d'une étape peut ne pas atteindre 100 %.
-
Diagnostic Results
Cliquez sur un opérateur, tel que Join[36148], dans l'arborescence du plan d'exécution pour afficher ses détails dans le volet Diagnostic Results à droite. Les détails incluent les problèmes identifiés, tels qu'une explosion de données ou une table de droite trop volumineuse lors d'une jointure, ainsi que les recommandations d'optimisation correspondantes. Pour plus d'informations sur les diagnostics d'opérateurs, consultez la rubrique Résultats du diagnostic au niveau de l'opérateur.
-
Statistics
Sous le volet Diagnostic Results, la section Statistics affiche les métriques pour l'opérateur cible.
Métrique
Description
Peak Memory
La mémoire maximale consommée par l'opérateur. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la consommation réelle de mémoire.
Time Consumed
La durée moyenne de l'opérateur pour un niveau de concurrence donné. Le système sélectionne automatiquement l'unité (ms, s, min ou h) en fonction de la durée réelle.
RemarqueCette durée peut être comparée à la durée totale de la requête.
Output Rows
Le nombre de lignes produites en sortie par l'opérateur.
Amount of Output Data
La taille des données produites en sortie par l'opérateur. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la taille réelle des données.
Input Rows
Le nombre de lignes reçues en entrée par l'opérateur.
Amount of Input Data
La taille des données reçues en entrée par l'opérateur. Le système sélectionne automatiquement l'unité (octets, Ko, Mo, Go ou To) en fonction de la taille réelle des données.
Builder Statistics
Comprend des informations sur le constructeur (builder), telles que son type, la mémoire maximale, la durée, les lignes d'entrée/sortie et le volume de données. Les types de constructeurs suivants sont disponibles :
-
HashBuilder: Utilisé pour construire une table de hachage pour les calculs de jointure par hachage. -
SetBuilder: Utilisé pour construire une structure d'ensemble pour les calculs de semi-jointure. -
NestLoopBuilder: Utilisé pour effectuer des calculs de jointure par boucles imbriquées.
RemarqueCette métrique est disponible uniquement pour les opérateurs de jointure.
Properties
Les propriétés varient selon le type d'opérateur. Par exemple, les propriétés d'un opérateur de jointure incluent le type et la méthode de jointure. Pour plus d'informations, consultez la rubrique Opérateurs.
-