Despliegue LoongCollector en modo DaemonSet y cree una configuración de recopilación en la consola de SLS para centralizar la recopilación de registros de contenedores de Kubernetes. Esto le permite habilitar el procesamiento estructurado y facilitar las consultas y los análisis.
Requisitos
-
Entorno de ejecución
Es compatible con Container Service for Kubernetes (ACK), tanto en sus ediciones administradas como dedicadas, y con clústeres de Kubernetes autoadministrados.
Kubernetes 1.10.0 o posterior, que admita
Mount propagation: HostToContainer.-
Entorno de ejecución de contenedores (solo Docker y Containerd)
-
Docker:
Requiere acceso a docker.sock.
La recopilación de la salida estándar solo admite el controlador de registros JSON.
Solo es compatible con los controladores de almacenamiento overlay y overlay2. Si necesita usar otro tipo de controlador de almacenamiento, monte manualmente el directorio de registros.
Containerd: requiere acceso a containerd.sock.
-
-
Requisitos de recursos: LoongCollector (Logtail) se ejecuta con la clase de prioridad alta system-cluster-critical. Si lo despliega en un clúster con recursos limitados, podría expulsar los Pods existentes.
CPU: reserve como mínimo 0.1 núcleos.
Memoria: reserve como mínimo 150 MB para el componente de recopilación y 100 MB para el componente del controlador.
El consumo real depende de la tasa de recopilación, la cantidad de directorios y archivos supervisados, y la congestión de envío. Mantenga el uso de recursos por debajo del 80 % de los límites especificados.
-
Requisitos de permisos: para realizar el despliegue, la cuenta de Alibaba Cloud o el usuario de RAM debe contar con el permiso
AliyunLogFullAccess.Para crear políticas personalizadas con permisos detallados, copie los permisos de la política del sistema AliyunCSManagedLogRolePolicy y asígnelos al usuario o rol de RAM correspondiente.
Configuración de recopilación
-
Install LoongCollector: despliegue LoongCollector en modo DaemonSet. De esta forma, se garantiza que un contenedor de recopilación se ejecute en cada nodo del clúster para recopilar los registros de todos los contenedores de ese nodo.
Si utiliza el patrón Sidecar, consulte Collect text logs from Kubernetes pods (Sidecar pattern) .
Create a Logstore: un logstore almacena los registros recopilados.
-
Create and configure log collection rules
Global and input configuration: defina el nombre de la configuración de recopilación y especifique el origen y el alcance de la recopilación de registros.
-
Log processing and structuring: configure las reglas de procesamiento según el formato de los registros.
Registros multilínea: gestione las entradas de registro que abarcan varias líneas, como las pilas de excepciones de Java o los tracebacks de Python. Para ello, defina una expresión regular de primera línea que identifique el inicio de cada entrada.
Análisis sintáctico estructurado: configure complementos de análisis, como expresiones regulares, delimitadores o el modo NGINX, para extraer cadenas sin procesar y convertirlas en pares clave-valor estructurados. Esto facilita las consultas y los análisis.
Log filtering: configure listas negras de recopilación y reglas de filtrado de contenido para descartar los datos de registro no deseados. Así se reduce la transmisión y el almacenamiento de datos redundantes.
Log categorization: configure temas y etiquetas de registro para distinguir los registros provenientes de distintos servicios, contenedores u orígenes de ruta.
Query and analysis configuration: el índice de texto completo se habilita de forma predeterminada para las búsquedas por palabras clave. Si necesita consultas precisas y análisis de campos estructurados, habilite los índices de campo para mejorar la eficiencia de búsqueda.
Verification and troubleshooting: una vez que termine la configuración, compruebe que los registros se recopilen correctamente. Si se presentan problemas como errores de recopilación de datos, fallos de latido o errores de análisis sintáctico, consulte Troubleshooting FAQ.
Paso 1: Instalar LoongCollector
LoongCollector es el agente de recopilación de registros de nueva generación de Simple Log Service y el sucesor de Logtail. Ambos agentes no pueden coexistir. Para instalar Logtail, consulte Install, run, upgrade, and uninstall Logtail .
Instale LoongCollector con uno de los métodos a continuación. Para conocer los detalles de los parámetros, consulte Installation and configuration. Si ya instaló LoongCollector o Logtail, vaya directamente a Step 2: Create a logstore.
Cambiar la hora del host mientras LoongCollector (Logtail) está en ejecución puede provocar duplicidad en la recopilación o pérdida de datos.
Clúster de ACK
Instale LoongCollector desde la consola de Container Service for Kubernetes. De forma predeterminada, los registros se envían a un Project de Simple Log Service dentro de la cuenta de Alibaba Cloud actual.
Inicie sesión en la consola de ACK. En el panel de navegación izquierdo, haga clic en Clusters.
Haga clic en el nombre del clúster de destino.
En el panel de navegación izquierdo, haga clic en Add-ons.
-
En la pestaña , busque LoongCollector y haga clic en Install.
NotaCuando crea un clúster, puede seleccionar Enable Log Service en la página Component Configurations. Ahí tiene la opción de elegir Create Project o Select Project. Al instalar LoongCollector en un clúster existente, el cuadro de diálogo de instalación permite especificar un nombre de Project mediante el parámetro
projectName. Si deja este campo vacío, se usa el valor predeterminadok8s-log-{cluster_id}.Una vez finalizada la instalación, Simple Log Service crea automáticamente los siguientes recursos en la cuenta actual. Puede consultarlos en la consola de Simple Log Service.
Tipo de recurso
Nombre del recurso
Descripción
Project
k8s-log-${cluster_id}Aísla los registros de distintos servicios.
Para gestionar los registros con mayor flexibilidad, Create a Project.
Grupo de máquinas
k8s-group-${cluster_id}Conjunto de nodos de recopilación de registros. Las direcciones IP de los nodos de Kubernetes cambian de forma dinámica cuando el clúster escala horizontalmente, por lo que identificar un grupo de máquinas por su dirección IP puede provocar fallos de latido. Por esta razón, los grupos de máquinas en entornos de Kubernetes utilizan un identificador personalizado. Para más información, consulte Guide to associating machine groups with collection configurations.
ImportanteEl componente LoongCollector no crea ningún logstore llamado config-operation-log. Si dicho logstore ya existe, LoongCollector no escribe registros en él.
Clúster autoadministrado
-
Conéctese al clúster de Kubernetes y ejecute el comando correspondiente a su región:
Regiones de China
wget https://aliyun-observability-release-cn-shanghai.oss-cn-shanghai.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.shRegiones fuera de China
wget https://aliyun-observability-release-ap-southeast-1.oss-ap-southeast-1.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.sh -
Vaya al directorio
loongcollector-custom-k8s-packagey modifique el archivo de configuración./loongcollector/values.yaml.# ===================== Required Information ===================== # The name of the Project to which logs from this cluster are sent. Example: k8s-log-custom-sd89ehdq projectName: "" # The region where the Project is located. Example: cn-shanghai region: "" # The UID of the Alibaba Cloud account that owns the Project. Enclose the UID in quotation marks (""). Example: "123456789" aliUid: "" # The network type. Valid values: Internet and Intranet. Default value: Internet. net: Internet # The AccessKey ID and AccessKey secret of the Alibaba Cloud account or RAM user. The account or RAM user must have the AliyunLogFullAccess system policy permission. accessKeyID: "" accessKeySecret: "" # A custom cluster ID. The ID can contain only uppercase letters, lowercase letters, digits, and hyphens (-). clusterID: "" -
Desde el directorio
loongcollector-custom-k8s-package, ejecute el siguiente comando para instalar LoongCollector y sus dependencias:bash k8s-custom-install.sh install -
Una vez terminada la instalación, compruebe que los componentes estén en ejecución.
Si algún pod no inicia, revise las configuraciones del archivo values.yaml y asegúrese de que las imágenes necesarias se hayan descargado.
# Check the pod status
kubectl get po -n kube-system | grep loongcollector-ds
Simple Log Service también crea automáticamente los siguientes recursos. Puede consultarlos en la consola de Simple Log Service.
Tipo de recurso
Nombre del recurso
Descripción
Project
El valor de
projectNameque especificó en el archivo values.yamlAísla los registros de distintos servicios.
Para gestionar los registros con mayor flexibilidad, Create a Project.
Grupo de máquinas
k8s-group-${cluster_id}Conjunto de nodos de recopilación de registros. Las direcciones IP de los nodos de Kubernetes cambian de forma dinámica cuando el clúster escala horizontalmente, por lo que identificar un grupo de máquinas por su dirección IP puede provocar fallos de latido. Por esta razón, los grupos de máquinas en entornos de Kubernetes utilizan un identificador personalizado. Para más información, consulte Guide to associating machine groups with collection configurations.
ImportanteEl componente LoongCollector no crea ningún logstore llamado config-operation-log. Si dicho logstore ya existe, LoongCollector no escribe registros en él.
Paso 2: Crear un logstore
Un logstore es la unidad básica de almacenamiento de registros en SLS.
Inicie sesión en la consola de Simple Log Service y haga clic en el nombre del proyecto de destino.
-
En el panel de navegación izquierdo, seleccione
 , haga clic en + y cree un logstore:
Logstore Name: introduzca un nombre único dentro del proyecto. Este nombre no se puede modificar después de la creación.
Logstore Type: seleccione Standard o Query según la comparación de funciones.
-
Billing Mode:
Pay-by-feature (Cannot Be Changed): se le factura de manera independiente por cada recurso, como el almacenamiento, los índices y las operaciones de lectura y escritura. Esta modalidad resulta adecuada para casos de uso a pequeña escala o cuando no se tiene certeza sobre el uso de las funciones.
Pay-by-ingested-data: solo se le cobra por el volumen de datos sin procesar que escriba. Incluye 30 días de almacenamiento gratuito y funciones sin costo adicional, como la transformación y entrega de datos. Es ideal para escenarios empresariales donde el periodo de retención se acerca a los 30 días o la canalización de procesamiento de datos es compleja.
Data Retention Period: número de días durante los cuales se conservan los registros. El valor puede ir de 1 a 3650. Un valor de 3650 indica retención permanente. El valor predeterminado es de 30 días.
Mantenga los valores predeterminados en el resto de los ajustes y haga clic en OK. Manage a logstore.
Paso 3: Configurar una regla de recopilación de registros
Defina qué registros recopilar, cómo analizarlos sintácticamente y cómo filtrar el contenido. Después, aplique la configuración a un grupo de máquinas.
En la página del logstore
 , haga clic en el icono
 situado antes del nombre del logstore de destino para expandirlo.
-
Haga clic en el icono
 junto a Import Data. En el cuadro de diálogo Quick Data Import, seleccione una plantilla según el origen de los registros y haga clic en Integrate Now:
-
Para la salida estándar del contenedor, seleccione K8s-Standard Output-New.
Existen dos plantillas, una nueva y una antigua, para recopilar la salida estándar del contenedor. Se recomienda usar la versión nueva. Para comparar ambas versiones, consulte Appendix: Comparison of new and old container standard output versions .
Para los registros de texto del clúster, seleccione Kubernetes-File.
-
-
En la sección Machine Group Configurations, complete la configuración y haga clic en Next:
Scenario: Seleccione Docker Containers.
Método de despliegue: Seleccione ACK DaemonSet o Self-managed Cluster in DaemonSet Mode.
En la lista Source Machine Group, mueva el grupo de máquinas creado por el sistema
k8s-group-${cluster_id}a la lista Applied Machine Group.
En la página Logtail Configuration, configure los siguientes parámetros y haga clic en Next.
1. Configuración global y de entrada
En este paso, defina el nombre, el origen de los registros y el alcance de su configuración de recopilación.
Salida estándar del contenedor
Global Configurations
-
Configuration Name: Introduzca un nombre personalizado para la configuración de recopilación. El nombre debe ser único dentro del proyecto y no se puede modificar después de crearlo. Reglas de nomenclatura:
Solo puede contener letras minúsculas, dígitos, guiones (-) y guiones bajos (_).
Debe comenzar y terminar con una letra minúscula o un dígito.
Configuración de entrada
-
Active los interruptores Stdout and Stderr o Standard Error, o ambos. De forma predeterminada, ambos están habilitados.
ImportanteSe recomienda no habilitar la salida estándar y el error estándar al mismo tiempo, ya que esto puede provocar que los registros se recopilen fuera de orden.
Registros de texto del clúster
Global Configurations:
-
Configuration Name: Introduzca un nombre personalizado para la configuración de recopilación. El nombre debe ser único dentro del proyecto y no se puede modificar después de crearlo. Reglas de nomenclatura:
Solo puede contener letras minúsculas, dígitos, guiones (-) y guiones bajos (_).
Debe comenzar y terminar con una letra minúscula o un dígito.
Input Configurations:
-
File Path Type:
Path in Container: Recopila archivos de registro desde el interior de un contenedor.
Host Path: Recopila registros de servicios locales en la máquina host.
-
File Path: La ruta absoluta para la recopilación de registros.
Linux: Debe comenzar con una barra diagonal (/), como
/data/mylogs/**/*.log. Esta ruta indica todos los archivos que terminan en .log dentro del directorio/data/mylogsy sus subdirectorios.Windows: Debe comenzar con una letra de unidad, como
C:\Program Files\Intel\**\*.log.
-
Maximum Directory Monitoring Depth: La profundidad máxima de directorios que puede coincidir con el comodín
**en File Path. El valor predeterminado es 0 (solo el directorio actual) y el rango válido es de 0 a 1000.Se recomienda establecer este valor en 0 y configurar la ruta hacia el directorio que contiene los archivos de registro.
2. Procesamiento y estructuración de registros
Configure reglas de procesamiento para convertir los registros sin procesar en datos estructurados y consultables. Agregue una muestra de registro antes de configurar las reglas.
En la página Logtail Configuration, dentro del área Processor Configurations, haga clic en Add Sample Log e introduzca el contenido del registro que desea recopilar. El sistema usa la muestra para identificar el formato del registro y ayudar a generar expresiones regulares y reglas de análisis sintáctico, lo cual simplifica el proceso de configuración.
Escenario 1: Procesar registros multilínea
Los registros como los seguimientos de pila de Java y los objetos JSON suelen abarcar varias líneas. De forma predeterminada, estos se dividen en registros incompletos. Habilite el modo multilínea y configure una expresión regular de primera línea para combinar las líneas consecutivas en registros completos.
Ejemplo:
|
Registro sin procesar |
En el modo predeterminado, cada línea se trata como un registro independiente. Esto fragmenta el seguimiento de pila y pierde contexto. |
Con el modo multilínea habilitado, una expresión regular de primera línea identifica un registro completo y conserva su estructura semántica. |
|
|
|
|


Procedimiento: En la página Logtail Configuration, dentro del área Processor Configurations, habilite Multi-line Mode.
-
Type: Seleccione Custom o Multi-line JSON.
-
Custom: Si el formato del registro sin procesar no es fijo, debe configurar Regex to Match First Line para identificar la línea inicial de cada entrada de registro.
-
Regex to Match First Line: Puede generar esta expresión automáticamente o introducirla de forma manual. La expresión debe coincidir con una línea completa de datos. Para el ejemplo anterior, la expresión regular de coincidencia es
\[\d+-\d+-\w+:\d+:\d+,\d+]\s\[\w+]\s.*.Generación automática: Haga clic en Auto-generate Regular Expression. En el cuadro de texto Log Sample, seleccione el contenido del registro que desea extraer y haga clic en Generate Regex.
Entrada manual: Haga clic en Manually Enter Regular Expression. Después de introducir la expresión, haga clic en Validate.
-
Multi-line JSON: Seleccione esta opción cuando los registros sin procesar estén en formato JSON estándar. LoongCollector gestiona automáticamente los saltos de línea dentro de entradas JSON individuales.
-
-
Processing Method If Splitting Fails:
Discard: Si un segmento de texto no coincide con la expresión regular de primera línea, se descarta.
Retain Single Line: El texto que no coincide se divide y se conserva según el modo original de una sola línea.
Escenario 2: Estructurar registros
Cuando los registros sin procesar son texto no estructurado (por ejemplo, registros de acceso de Nginx), las consultas directas resultan ineficientes. LoongCollector proporciona plugins de análisis sintáctico que convierten los registros sin procesar en pares clave-valor estructurados para facilitar el análisis, el monitoreo y las alertas.
Ejemplo:
Registro sin procesar | Registro después del análisis sintáctico estructurado |
| |
Procedimiento: En el área Processor Configurations de la página Logtail Configuration:
Agregar un plugin de análisis sintáctico: Haga clic en Add Processor y configure un regex, delimiter, or JSON parsing plugin según el formato de sus registros. Para este ejemplo de NGINX, seleccione .
-
NGINX Log Configuration: Copie toda la definición
log_formatdel archivo de configuración de su servidor Nginx (nginx.conf) y péguela en este cuadro de texto.Ejemplo:
log_format main '$remote_addr - $remote_user [$time_local] "$request" ''$request_time $request_length ''$status $body_bytes_sent "$http_referer" ''"$http_user_agent"';ImportanteLa definición de formato aquí debe coincidir exactamente con el formato que genera los registros en el servidor; de lo contrario, el análisis sintáctico fallará con errores.
-
Parámetros comunes: Los siguientes parámetros son comunes a varios plugins de análisis sintáctico de datos y funcionan de la misma manera.
Campo original: Especifica el campo de origen que se va a analizar sintácticamente. El valor predeterminado es
content, que corresponde a toda la entrada de registro recopilada.Conservar el campo original si falla: Recomendado. Si el análisis sintáctico de un registro falla (por ejemplo, debido a una discrepancia de formato), esta opción conserva el contenido original del registro en el campo original especificado.
Conservar el campo original si tiene éxito: Cuando se selecciona, el contenido original del registro se conserva incluso después de un análisis sintáctico correcto.
3. Filtrado de registros
Recopilar registros de poco valor o irrelevantes, como los de nivel DEBUG o INFO, desperdicia almacenamiento, aumenta los costos, afecta el rendimiento de las consultas y puede introducir riesgos de seguridad. Implemente políticas de filtrado detalladas para lograr una recopilación de registros eficiente y segura.
Filtrado de contenido
Filtre los registros según el contenido de los campos. Por ejemplo, recopile solo los registros cuyo nivel sea WARNING o ERROR.
Ejemplo:
Registros sin procesar | Recopilar solo registros |
| |
Procedimiento: En el área Processor Configurations de la página Logtail Configuration:
Haga clic en Add Processor y seleccione .
Field Name: El campo del registro que se usará para filtrar.
Field Value: La expresión regular para el filtrado. Solo se admite la coincidencia de texto completo; no se admiten coincidencias parciales de palabras clave.
Lista negra de recopilación
Use una lista negra para excluir directorios o archivos específicos y evitar que se carguen registros irrelevantes o confidenciales.
Procedimiento: En la página Logtail Configuration, vaya al área , habilite Collection Blacklist y haga clic en Add.
Admite coincidencias exactas y con comodines para directorios y nombres de archivo. Los únicos comodines compatibles son el asterisco (*) y el signo de interrogación (?).
-
File Path Blacklist: Las rutas de archivo que se van a ignorar. Ejemplos:
/home/admin/private*.log: Ignora todos los archivos del directorio/home/admin/que comienzan con "private" y terminan con ".log"./home/admin/private*/*_inner.log: Ignora los archivos que terminan con "_inner.log" ubicados en subdirectorios que comienzan con "private" dentro del directorio/home/admin/.
-
File Blacklist: Los nombres de archivo que se van a ignorar durante la recopilación. Ejemplo:
app_inner.log: Ignora todos los archivos llamadosapp_inner.log.
-
Directory Blacklist: La ruta del directorio no puede terminar con una barra diagonal (/). Ejemplos:
/home/admin/dir1/: La lista negra de directorios no surtirá efecto./home/admin/dir*: Ignora todos los archivos dentro de los subdirectorios de/home/admin/que comienzan con "dir"./home/admin/*/dir: Ignora todos los archivos en cualquier subdirectorio de segundo nivel llamado "dir" dentro de/home/admin/. Por ejemplo, se ignoran los archivos de/home/admin/a/dir, pero se recopilan los de/home/admin/a/b/dir.
Filtrado de contenedores
Establezca condiciones de recopilación basadas en metadatos del contenedor, como variables de entorno, etiquetas de Pod, Namespaces y nombres de contenedor, para controlar con precisión qué registros de contenedores se recopilan.
Procedimiento: En el área Input Configurations de la página Logtail Configuration, habilite Container Filtering y haga clic en Add.
Varias condiciones se combinan con un operador lógico "AND". Todas las coincidencias de expresiones regulares se basan en el motor RE2 de Go, el cual tiene limitaciones en comparación con motores como PCRE. Asegúrese de que sus expresiones cumplan con Appendix: Regular Expression Usage Limits (Container Filtering) .
Lista negra/lista blanca de variables de entorno: Filtra los contenedores según sus variables de entorno.
Lista negra/lista blanca de etiquetas de Pod de K8s: Filtra los Pods según sus etiquetas.
Coincidencia de expresión regular de nombre de Pod de K8s: Recopila registros de los Pods cuyos nombres coinciden con la expresión regular especificada.
Coincidencia de expresión regular de Namespace de K8s: Selecciona los contenedores para la recopilación según el nombre del Namespace.
Coincidencia de expresión regular de nombre de contenedor de K8s: Recopila registros de los contenedores cuyos nombres coinciden con la expresión regular especificada.
Lista negra/lista blanca de etiquetas de contenedor: Recopila registros de los contenedores con etiquetas coincidentes. Está diseñada para escenarios de Docker y no se recomienda para escenarios de K8s.
4. Categorización de registros
En escenarios donde varias aplicaciones comparten un formato de registro, resulta difícil distinguir el origen. Configure temas y etiquetas de registro para habilitar la asociación de contexto automatizada y la categorización lógica.
Temas de registro
Cuando varias aplicaciones o instancias comparten un formato de registro pero tienen rutas distintas (por ejemplo, /apps/app-A/run.log y /apps/app-B/run.log), distinguir el origen es complicado. Para resolverlo, genere un tema de registro basado en el grupo de máquinas, un nombre personalizado o la extracción de la ruta de archivo. Así podrá diferenciar los registros de diversos orígenes de negocio o rutas.
Procedimiento: Vaya a y seleccione un método de generación de temas entre las tres opciones siguientes:
Tema de grupo de máquinas: Cuando una configuración de recopilación se aplica a varios grupos de máquinas, LoongCollector usa automáticamente el nombre del grupo de máquinas como valor del campo
__topic__. Este método es adecuado para escenarios donde los registros se categorizan por clúster de hosts.Custom: El formato es
customized://<custom_topic_name>, por ejemplo,customized://app-login. Resulta útil para escenarios de temas estáticos con identificadores de negocio fijos.-
Extracción de ruta de archivo: Extrae información clave de la ruta completa del archivo de registro para marcar dinámicamente el origen del registro. Más indicado para situaciones donde varios usuarios o aplicaciones comparten el mismo nombre de archivo de registro, pero tienen rutas diferentes.
Cuando varios usuarios o servicios escriben registros en distintos directorios de nivel superior con subrutas y nombres de archivo idénticos, no se puede distinguir el origen solo por el nombre del archivo. Por ejemplo:
/data/logs
├── userA
│   └── serviceA
│       └── service.log
├── userB
│   └── serviceA
│       └── service.log
└── userC
    └── serviceA
        └── service.log
En este caso, configure la extracción de ruta de archivo y use una expresión regular para extraer información clave de la ruta completa. El resultado coincidente se carga al logstore como el tema del registro.
Regla de extracción: Grupos de captura de expresiones regulares
Al configurar una expresión regular, el sistema determina automáticamente el formato del campo de salida según la cantidad y el nombre de los grupos de captura, de la siguiente manera:
En la expresión regular de una ruta de archivo, las barras diagonales (/) deben escaparse.
Tipo de grupo de captura
Escenario
Campo generado
Ejemplo de expresión regular
Ruta de ejemplo
Campo generado
Grupo de captura único (un
(.*?))Se requiere una sola dimensión para distinguir los orígenes (por ejemplo, nombre de usuario o entorno).
Genera un campo
__topic__.\/logs\/(.*?)\/app\.log/logs/userA/app.log__topic__:userAVarios grupos de captura sin nombre (varios
(.*?))Se requieren varias dimensiones, pero sin etiquetas semánticas.
Genera campos Tag con el formato
__tag__:__topic_{i}__:value, donde{i}es el índice del grupo de captura.\/logs\/(.*?)\/(.*?)\/app\.log/logs/userA/svcA/app.log__tag__:__topic_1__:userA;__tag__:__topic_2__:svcAVarios grupos de captura con nombre (con
(?P<name>.*?))Se requieren varias dimensiones con nombres de campo semánticos claros para facilitar las consultas y el análisis.
Genera campos Tag con el formato
__tag__:{name}:value.\/logs\/(?P<user>.*?)\/(?P<service>.*?)\/app\.log/logs/userA/svcA/app.log__tag__:user:userA;__tag__:service:svcA
Etiquetado de registros
Habilite la función de enriquecimiento de etiquetas de registro para extraer información clave de las variables de entorno del contenedor o de las etiquetas de Pod de Kubernetes y adjuntarla como Tags. Esto permite agrupar los registros de forma detallada.
Procedimiento: En la página Logtail Configuration, dentro del área Input Configurations, habilite Log Tag Enrichment y haga clic en Add.
-
Environment Variables: Configure un nombre de variable de entorno y una clave de Tag. El valor de la variable de entorno se almacenará como el valor del Tag.
Nombre de la variable de entorno: El nombre de la variable de entorno que se va a extraer.
Clave del Tag: La clave para el nuevo Tag.
-
Pod Labels: Configure una clave de etiqueta de Pod y una clave de Tag. El valor de la etiqueta del Pod se almacenará como el valor del Tag.
Clave de etiqueta de Pod: La clave de la etiqueta de Pod de Kubernetes que se va a extraer.
Clave del Tag: La clave para el nuevo Tag.
5. Configuración de salida
De forma predeterminada, todos los registros se envían al logstore actual con compresión lz4. Para distribuir registros del mismo origen a distintos logstores, siga los pasos a continuación.
Distribución dinámica a múltiples destinos
La distribución dinámica a múltiples destinos solo está disponible para LoongCollector 3.0.0 y versiones posteriores. Logtail no es compatible con esta función.
Puede configurar un máximo de cinco destinos de salida.
Después de configurar varios destinos de salida, esta configuración de recopilación dejará de aparecer en la lista de configuraciones de recopilación del logstore actual. Para consultar, modificar o eliminar la configuración, consulte How do I manage multi-destination distribution configurations?.
Procedimiento: En la página Logtail Configuration, dentro del área Output Configurations:
Haga clic en
 para expandir la configuración de salida.
-
Haga clic en Add Output Targets y complete la siguiente configuración:
Logstores: Seleccione el logstore de destino.
Compression Method: Admite lz4 y zstd.
-
Route Settings: Enruta los registros según los campos Tag. Los registros que coinciden con la configuración de enrutamiento se envían al logstore de destino. Si deja este campo vacío, todos los registros recopilados se enviarán al logstore de destino.
-
Tag Name: La clave de Tag que se usa para el enrutamiento. Introduzca la clave directamente (por ejemplo,
__path__) sin el prefijo__tag__:. Los campos Tag se dividen en dos categorías:Los Tags se explican en Manage LoongCollector Collection Tags .
Relacionados con el agente: Los genera el agente de recopilación y son independientes de cualquier plugin. Algunos ejemplos son
__hostname__y__user_defined_id__.Relacionados con el plugin de entrada: Los proporcionan y enriquecen los plugins de entrada. Algunos ejemplos son
__path__de la recopilación de archivos, y_pod_name_o_container_name_de la recopilación de K8s.
Tag Value: Los registros cuyo valor de Tag coincida con esta configuración se enviarán al logstore de destino.
Discard this tag?: Si se habilita, este campo Tag no se incluirá en los registros cargados.
-
Paso 4: Consulta y análisis
Después de configurar el procesamiento de registros y los plugins, haga clic en Next para ir a la página Query and Analysis Configurations:
De forma predeterminada, el sistema habilita full-text index, lo que le permite buscar contenido de registros sin procesar por palabra clave.
Para consultar datos por campos específicos, haga clic en Automatic Index Generation después de que se cargue Preview Data. Log Service genera un field index basado en la primera entrada de registro de los datos de vista previa.
Una vez completada la configuración, haga clic en Next para finalizar el proceso de recopilación.
Paso 5: Validar y solucionar problemas
Después de crear y aplicar una configuración de recopilación a un grupo de máquinas, el sistema la despliega automáticamente y comienza a recopilar los registros incrementales.
Consultar los registros recopilados
Compruebe que el archivo de registro tenga contenido nuevo: LoongCollector solo recopila registros incrementales. Ejecute
tail -f /path/to/your/log/filey active operaciones de negocio para asegurarse de que se escriban registros nuevos.-
Buscar registros: Vaya a la página Search & Analyze del logstore de destino. Haga clic en Search & Analyze. El intervalo de tiempo predeterminado corresponde a los últimos 15 minutos. Compruebe si se ingirieron registros nuevos. Cada registro de texto de contenedor recopilado incluye de forma predeterminada los siguientes campos:
Parámetro
Descripción
__tag__:__hostname__El nombre del host del contenedor.
__tag__:__path__La ruta del archivo de registro dentro del contenedor.
__tag__:_container_ip_La dirección IP del contenedor.
__tag__:_image_name_El nombre de la imagen que utiliza el contenedor.
__tag__:_pod_name_El nombre del Pod.
__tag__:_namespace_El namespace del Pod.
__tag__:_pod_uid_El identificador único (UID) del Pod.
Consultar los nodos históricos de un Pod
Si un Pod cambió de nodo o se reinició, puede consultar los registros de eventos de Kubernetes de su clúster ACK en Simple Log Service. Así encontrará los nodos donde se ejecutó anteriormente.
Inicie sesión en la consola de Simple Log Service y busque el proyecto
k8s-log-{cluster_id}en la lista de proyectos.Haga clic en el LogStore k8s-event para ir a la página de consulta y análisis.
En el cuadro de búsqueda, introduzca una instrucción de consulta que filtre por nombre de Pod. Por ejemplo,
pod_name: my-pod. Después, haga clic en Search & Analyze.En los resultados devueltos, compruebe el valor del campo
hostname. Este valor corresponde al nombre de host del nodo donde se ejecutó el Pod.
En el LogStore k8s-event, los nombres de los campos son pod_name y hostname, sin el prefijo __tag__:. El formato con el prefijo __tag__: aplica únicamente a la salida estándar (stdout) de los contenedores y a la recopilación de registros de texto, no a los registros de eventos de Kubernetes.
Solucionar problemas comunes
Fallo de latido del grupo de máquinas
-
Compruebe el identificador de usuario: Si su servidor no es una instancia ECS, o si la instancia ECS y el proyecto pertenecen a cuentas de Alibaba Cloud distintas, asegúrese de que exista el identificador de usuario correcto en el directorio especificado.
En Linux, ejecute el comando
cd /etc/ilogtail/users/ && touch <uid>para crear un archivo de identificador de usuario.En Windows, vaya al directorio
C:\LogtailData\users\y cree un archivo vacío llamado<uid>.
El identificador de usuario está configurado correctamente si la ruta especificada contiene un archivo cuyo nombre coincide con el ID de la cuenta de Alibaba Cloud del proyecto actual.
-
Compruebe el identificador del grupo de máquinas: Si utiliza un identificador personalizado para un grupo de máquinas, verifique que el archivo
user_defined_idexista en el directorio especificado. Si existe, compruebe que su contenido coincida con el identificador personalizado configurado para el grupo de máquinas.-
Linux:
# Configure the custom identifier. If the directory does not exist, create it manually.
echo "user-defined-1" > /etc/ilogtail/user_defined_id
Windows: En el directorio
C:\LogtailData, cree un archivo llamadouser_defined_idy escriba el identificador personalizado en él. Si el directorio no existe, créelo manualmente.
-
Si tanto el identificador de usuario como el del grupo de máquinas están configurados correctamente, consulte Troubleshooting LoongCollector (Logtail) machine groups para continuar con la solución de problemas.
Errores de recopilación o de formato en los registros
Este problema suele presentarse cuando la conexión de red y la configuración básica son correctas, pero el contenido del registro no coincide con las reglas de análisis. Para diagnosticarlo, consulte el mensaje de error específico:
En la página Logtail Configuration, haga clic en el nombre de la configuración de LoongCollector (Logtail) que presenta errores de recopilación. En la pestaña Log Collection Error, haga clic en Select Time Range para establecer el tiempo de consulta.
En la sección , revise el tipo de alerta del registro de error y consulte Common error types for data collection para encontrar la solución correspondiente.
Siguientes pasos
Data visualization: Use paneles de visualización para monitorear las tendencias de las métricas clave.
Data anomaly alerting: Establezca políticas de alertas para detectar anomalías en los datos en tiempo real.
Solución de problemas en la recopilación de registros de contenedores
Compruebe que se estén generando registros nuevos en el archivo de registro de destino. Logtail no recopila datos hasta que aparecen registros nuevos.
Preguntas frecuentes
Gestionar configuraciones de distribución a múltiples destinos
Dado que las configuraciones de distribución a múltiples destinos aplican a varios logstores, debe gestionarlas desde la página de administración a nivel de proyecto:
Inicie sesión en la consola de Simple Log Service y haga clic en el nombre del proyecto de destino.
-
En la página del proyecto, dentro del panel de navegación izquierdo, haga clic en
 .Nota
Esta página gestiona todas las configuraciones de recopilación del proyecto, incluidas las de logstores que se eliminaron por accidente.
Enviar registros de ACK a un proyecto de otra cuenta
Puede enviar registros de contenedores a un proyecto de Simple Log Service (SLS) en otra cuenta de Alibaba Cloud. Para lograrlo, instale manualmente el componente LoongCollector (Logtail) en el clúster ACK y configúrelo con el ID de la cuenta de Alibaba Cloud de destino o con una credencial de acceso (AccessKey).
Descripción del escenario: Si necesita recopilar datos de registro en un proyecto de SLS de otra cuenta por motivos organizativos, de permisos o de monitoreo, instale LoongCollector (Logtail) manualmente para habilitar la recopilación entre cuentas.
Procedimiento: Siga estos pasos para instalar LoongCollector de forma manual. Para obtener información sobre cómo instalar Logtail, consulte Install and configure Logtail.
-
Conéctese al clúster de Kubernetes y ejecute el comando correspondiente a su región:
Regiones de China
wget https://aliyun-observability-release-cn-shanghai.oss-cn-shanghai.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.shRegiones fuera de China
wget https://aliyun-observability-release-ap-southeast-1.oss-ap-southeast-1.aliyuncs.com/loongcollector/k8s-custom-pkg/3.0.12/loongcollector-custom-k8s-package.tgz; tar xvf loongcollector-custom-k8s-package.tgz; chmod 744 ./loongcollector-custom-k8s-package/k8s-custom-install.sh -
Vaya al directorio
loongcollector-custom-k8s-packagey modifique el archivo de configuración./loongcollector/values.yaml.# ===================== Required Information ===================== # The name of the Project to which logs from this cluster are sent. Example: k8s-log-custom-sd89ehdq projectName: "" # The region where the Project is located. Example: cn-shanghai region: "" # The UID of the Alibaba Cloud account that owns the Project. Enclose the UID in quotation marks (""). Example: "123456789" aliUid: "" # The network type. Valid values: Internet and Intranet. Default value: Internet. net: Internet # The AccessKey ID and AccessKey secret of the Alibaba Cloud account or RAM user. The account or RAM user must have the AliyunLogFullAccess system policy permission. accessKeyID: "" accessKeySecret: "" # A custom cluster ID. The ID can contain only uppercase letters, lowercase letters, digits, and hyphens (-). clusterID: "" -
En el directorio
loongcollector-custom-k8s-package, ejecute el siguiente comando para instalar LoongCollector y sus dependencias:bash k8s-custom-install.sh install -
Una vez finalizada la instalación, compruebe que los componentes se estén ejecutando.
Si un Pod no inicia, verifique las configuraciones del archivo values.yaml y asegúrese de que se hayan descargado las imágenes obligatorias.
# Check the pod status
kubectl get po -n kube-system | grep loongcollector-ds
Simple Log Service también crea automáticamente los siguientes recursos. Puede consultarlos en la consola de Simple Log Service.
Tipo de recurso
Nombre del recurso
Descripción
Project
El valor de
projectNameque especificó en el archivo values.yamlAísla los registros de distintos servicios.
Para una gestión flexible de los registros, Create a Project.
Grupo de máquinas
k8s-group-${cluster_id}Un conjunto de nodos de recopilación de registros. Las direcciones IP de los nodos de Kubernetes cambian dinámicamente conforme el clúster escala horizontalmente, por lo que identificar un grupo de máquinas por su dirección IP puede provocar fallos de latido. Por esta razón, los grupos de máquinas en escenarios de Kubernetes utilizan un identificador personalizado. Para obtener más información, consulte Guide to associating machine groups with collection configurations.
ImportanteEl componente LoongCollector no crea un logstore llamado config-operation-log. Si este logstore ya existe, LoongCollector no escribirá registros en él.
Usar varias configuraciones para el mismo origen
De forma predeterminada, para evitar la duplicación de datos, Simple Log Service (SLS) permite que solo una configuración de recopilación obtenga registros de cada origen:
Un archivo de registro de texto solo puede coincidir con una configuración de recopilación de Logtail.
-
Salida estándar (stdout) de un contenedor:
Si utiliza la versión nueva de la plantilla de salida estándar, de forma predeterminada solo una configuración de recopilación puede obtener la stdout.
Si utiliza la versión anterior de la plantilla de salida estándar, no se requiere configuración adicional y se admiten varias recopilaciones de forma predeterminada.
Inicie sesión en la consola de Simple Log Service y vaya al proyecto de destino.
En el panel de navegación izquierdo, elija
Logstores y busque el logstore de destino.Haga clic en el ícono
junto a su nombre para expandir el logstore.Haga clic en Logtail Configuration. En la lista de configuraciones, busque la configuración de Logtail de destino y haga clic en Manage Logtail Configuration en la columna Actions.
-
En la página de configuración de Logtail, haga clic en Edit y desplácese hasta la sección Input Configurations:
Para recopilar registros de archivos de texto, habilite Allow File to Be Collected for Multiple Times.
Para recopilar la salida estándar del contenedor, habilite Allow Collection by Different Logtail Configurations.
Error de dependencia al desinstalar loongcollector
Problema: Al intentar desinstalar el componente loongcollector (logtail-ds) en Container Service for Kubernetes (ACK), recibe un error que indica que no se cumplen las dependencias del componente.
Dependencies of addons are not met: terway-eniip depends on logtail-ds(>0.0) whose version is v3.x.x.x-aliyun or will be v3.x.x.x-aliyun.
Causa: El plugin de red terway-eniip tiene habilitada la recopilación de registros, lo cual genera una dependencia con el componente loongcollector (logtail-ds). Por lo tanto, ACK no permite desinstalar loongcollector (logtail-ds) hasta que elimine esta dependencia.
Solución: Siga estos pasos para quitar la dependencia y después desinstalar el componente:
Inicie sesión en la consola de ACK.
En la lista de clústeres, haga clic en el nombre del clúster de destino para ir a su página de detalles.
En el panel de navegación izquierdo, haga clic en Add-ons.
En la lista de complementos, busque el componente
terway-eniipy haga clic en .En el cuadro de diálogo que aparece, haga clic en OK.
Una vez que la configuración surta efecto, intente desinstalar nuevamente el componente loongcollector (logtail-ds).
Última entrada de registro retrasada o truncada
Causa: El truncamiento de registros suele ocurrir cuando a un archivo le falta el salto de línea final, o cuando una entrada multilínea (como una pila de excepciones) no se ha escrito por completo. Como el recolector no puede determinar si la entrada está completa, la última podría dividirse o retrasarse. La forma de manejar esto depende de su versión de LoongCollector (Logtail):
Versiones anteriores a la 1.8: Si la última línea de un registro carece de salto de línea (retorno de carro), o si un bloque multilínea está incompleto, el recolector espera a la siguiente operación de escritura para activar la salida. Esto puede retrasar significativamente la última entrada hasta que se escriba un nuevo registro.
-
Versión 1.8 y posteriores: Estas versiones introducen un mecanismo de vaciado por tiempo de espera para evitar que los registros se queden atascados. Cuando se detecta una línea incompleta, el sistema inicia un temporizador. Al expirar el tiempo de espera, el contenido actual se envía automáticamente para garantizar que el registro se recopile.
Tiempo de espera predeterminado: 60 segundos (garantiza la integridad de los datos en la mayoría de los escenarios).
Puede ajustar este valor según sus necesidades. Sin embargo, se recomienda no establecerlo en 0, ya que podría causar el truncamiento de registros o la pérdida parcial de datos.
Solución:
Puede ampliar el tiempo de espera para asegurar que se escriba una entrada de registro completa antes de recopilarla:
Inicie sesión en la consola de Simple Log Service y vaya al proyecto de destino.
En el panel de navegación izquierdo, elija
 Logstores y busque el logstore de destino.
Haga clic en el ícono
 junto a su nombre para expandir el logstore.
Haga clic en Logtail Configuration. En la lista de configuraciones, busque la configuración de Logtail de destino y haga clic en Manage Logtail Configuration en la columna Actions.
-
En la página de configuración de Logtail, haga clic en Edit.
-
Vaya a y agregue la siguiente configuración JSON para personalizar el tiempo de espera.
{
  "FlushTimeoutSecs": 1
}
Valor predeterminado: Lo determina el parámetro de inicio
default_reader_flush_timeout, que normalmente es de unos pocos segundos.Unidad: Segundos.
Valor recomendado: ≥ 1 segundo. Se recomienda no establecerlo en 0, ya que podría causar el truncamiento de registros o la pérdida parcial de datos.
-
Una vez completada la configuración, haga clic en OK.
Conmutación por error y recuperación de red de LoongCollector
Si LoongCollector (Logtail) detecta un problema de conectividad en la red interna, como un fallo o un tiempo de espera agotado, cambia automáticamente a la red pública. Este mecanismo de conmutación por error garantiza una recopilación confiable de registros y evita acumulaciones o pérdida de datos.
LoongCollector: Vuelve automáticamente a la red interna una vez que se recupera la conectividad.
Logtail: No vuelve de forma automática. Debe reiniciarlo para restablecer la comunicación por la red interna.
Apéndice: procesadores nativos
En la página Logtail Configuration, dentro del área Processor Configurations, es posible agregar plugins de procesamiento para estructurar los registros sin procesar. Para agregar un plugin de procesamiento a una configuración de recopilación existente, siga estos pasos:
En el panel de navegación izquierdo, elija
 Logstores y busque el logstore de destino.
Haga clic en
 , a la izquierda del nombre, para expandir el logstore.
Haga clic en Logtail Configuration. En la lista de configuraciones, busque la configuración de Logtail deseada y haga clic en Manage Logtail Configuration en la columna Actions.
En la página de configuración de Logtail, haga clic en Edit.
Esta sección presenta únicamente los plugins de procesamiento más comunes, que cubren los escenarios habituales de procesamiento de registros. Para conocer más funciones, consulte Extension processing plug-ins .
Reglas para combinar plugins (aplica a LoongCollector / Logtail 2.0 y versiones posteriores):
Los plugins de procesamiento nativos y de extensión se pueden usar de forma independiente o combinada, según sea necesario.
Se recomienda utilizar primero los plugins de procesamiento nativos, ya que ofrecen mejor rendimiento y mayor estabilidad.
Cuando las funciones nativas no cubren los requisitos del negocio, agregue plugins de procesamiento de extensión después de los nativos configurados para complementar el procesamiento.
Restricción de orden:
Todos los plugins se ejecutan de manera secuencial en el orden en que se configuran, lo que forma una cadena de procesamiento. Nota: todos los plugins de procesamiento nativos deben ir antes que cualquier plugin de procesamiento de extensión. Una vez que agrega un plugin de extensión, ya no puede agregar más plugins nativos.
Análisis con expresiones regulares
Este procesador utiliza una expresión regular para analizar los registros y convertirlos en pares clave-valor. Después, cada campo extraído se puede consultar y analizar de forma independiente.
Ejemplo:
Registro sin procesar | Resultado analizado |
| |
Pasos: En la página Logtail Configuration, dentro del área Processor Configurations, haga clic en Add Processor y seleccione :
-
Regular Expression: coincide con las entradas de registro. Se genera automáticamente o se introduce de forma manual.
-
Para generar una expresión regular de forma automática:
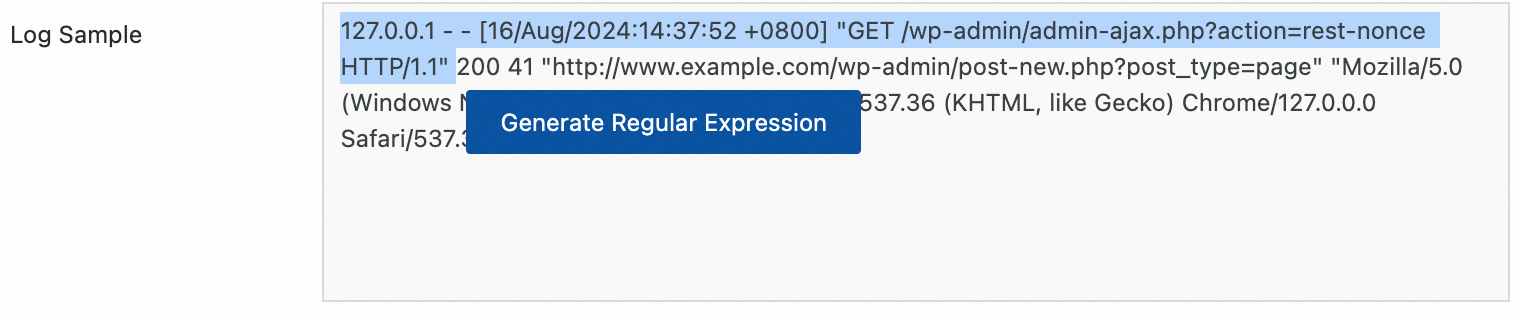
Haga clic en Generate Regular Expression.
En el cuadro Log Sample, resalte el contenido que desea extraer.
-
Haga clic en Generate.
Introduzca manualmente una expresión regular basada en el formato de sus registros.
Después de configurar la expresión, haga clic en Validate para comprobar si analiza correctamente la muestra de registro.
-
Extracted Field: asigne un nombre (clave) al contenido extraído (valor).
Para obtener información sobre otros parámetros, consulte la descripción de los parámetros de configuración comunes en Scenario 2: Structured logs.
Análisis por delimitador
Este procesador utiliza un delimitador para analizar los registros y convertirlos en pares clave-valor. Admite delimitadores de uno o varios caracteres.
Ejemplo:
Registro sin procesar | División de un campo con el carácter especificado |
| |
Procedimiento: En la página Logtail Configuration, dentro del área Processor Configurations, haga clic en Add Processor y seleccione :
-
Delimiter: carácter que separa los campos en el registro.
Por ejemplo, para un archivo CSV, seleccione Custom e introduzca una coma (,).
Quote: carácter que encierra el valor de un campo. Resulta necesario cuando el valor podría contener el delimitador, ya que evita divisiones incorrectas.
-
Extracted Field: asigne un nombre de campo (Key) a cada columna en orden secuencial. Los nombres de campo deben cumplir las siguientes reglas:
Solo pueden contener letras, dígitos y guiones bajos (_).
Deben comenzar con una letra o un guion bajo (_).
Longitud máxima: 128 bytes.
Para obtener información sobre otros parámetros, consulte la descripción de los parámetros de configuración comunes en Scenario 2: Structured logs.
Análisis JSON estándar
Este procesador convierte en pares clave-valor una entrada de registro que corresponde a un objeto JSON.
Ejemplo:
Registro sin procesar | Resultado analizado |
| |
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, haga clic en Add Processor y seleccione :
Original Field: el valor predeterminado es
content. Este campo almacena el contenido del registro sin procesar que se va a analizar.Para obtener información sobre otros parámetros, consulte la descripción de los parámetros de configuración comunes en Scenario 2: Structured logs.
Análisis JSON anidado
Este procesador expande un objeto JSON anidado en pares clave-valor. La expansión se controla mediante el ajuste JSON expansion depth.
Ejemplo:
Registro sin procesar | Resultado (profundidad: 0) | Resultado (profundidad: 1) |
| | |
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, haga clic en Add Processor y seleccione :
Original Field: nombre del campo original que se va a expandir, como
content.JSON Expansion Depth: número de niveles que se expanden dentro del objeto JSON. El valor
0expande todos los niveles (predeterminado),1expande solo el nivel superior, y así sucesivamente.Character to Concatenate Expanded Keys: carácter que une las claves de los objetos anidados. De forma predeterminada, es un guion bajo (
_).Name Prefix of Expanded Keys: prefijo que se agrega al nombre de cada clave expandida.
-
Expand Array: habilite esta opción para expandir una matriz en pares clave-valor indexados.
Por ejemplo,
{"k":["a","b"]}se expande a{"k[0]":"a","k[1]":"b"}.Para cambiar el nombre de un campo expandido (por ejemplo, de
prefix_s_key_k1anew_field_name), agregue un procesador Rename Fields después de este. Para obtener información sobre otros parámetros, consulte la descripción de los parámetros de configuración comunes en Scenario 2: Structured logs.
Análisis de matrices JSON
Utilice la función json_extract function para extraer un objeto JSON de una matriz JSON.
Ejemplo:
Registro sin procesar | Resultado analizado |
| |
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, establezca Processing Method en SPL. A continuación, configure la instrucción SPL para usar la función json_extract y extraer los objetos JSON de la matriz.
Ejemplo: extraiga los elementos de una matriz JSON desde el campo de registro content y almacene los resultados en los nuevos campos json1 y json2, respectivamente.
* | extend json1 = json_extract(content, '$[0]'), json2 = json_extract(content, '$[1]')Análisis de registros de Apache
Este procesador convierte los registros de acceso de Apache en pares clave-valor, con base en la directiva LogFormat de Apache.
Ejemplo:
Registro sin procesar | Análisis con el formato de registro común de Apache |
| |
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, haga clic en Add Processor y seleccione :
Log Format: combined
-
APACHE LogFormat Configuration: el sistema llena este campo automáticamente según el Log Format seleccionado.
ImportanteCompruebe que el contenido generado automáticamente coincida exactamente con la directiva LogFormat definida en el archivo de configuración de Apache del servidor, ubicado normalmente en
/etc/apache2/apache2.conf. Para el resto de los parámetros, consulte la descripción de los parámetros de configuración comunes en Scenario 2: Structured Log.
Enmascaramiento de datos
Permite ocultar datos confidenciales en los registros.
Ejemplo:
Registro sin procesar | Resultado enmascarado |
| |
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, haga clic en Add Processor y seleccione :
Original Field: campo de origen que contiene el contenido por enmascarar.
-
Data Masking Method:
const: reemplaza el contenido confidencial con una cadena específica.
md5: sustituye el contenido confidencial por su valor de hash MD5.
Replacement String: cadena utilizada para el enmascaramiento. Es obligatoria cuando Data Masking Method está establecido en const.
Content Expression that Precedes Replaced Content: expresión regular con sintaxis RE2 que localiza el contenido inmediatamente anterior a los datos confidenciales.
Content Expression to Match Replaced Content: expresión regular con sintaxis RE2 que coincide con los datos confidenciales que desea reemplazar.
Análisis de tiempo
Analiza el campo de tiempo del registro y establece el resultado como el campo __time__ del registro.
Ejemplo:
Registro sin procesar | Resultado analizado |
|
|
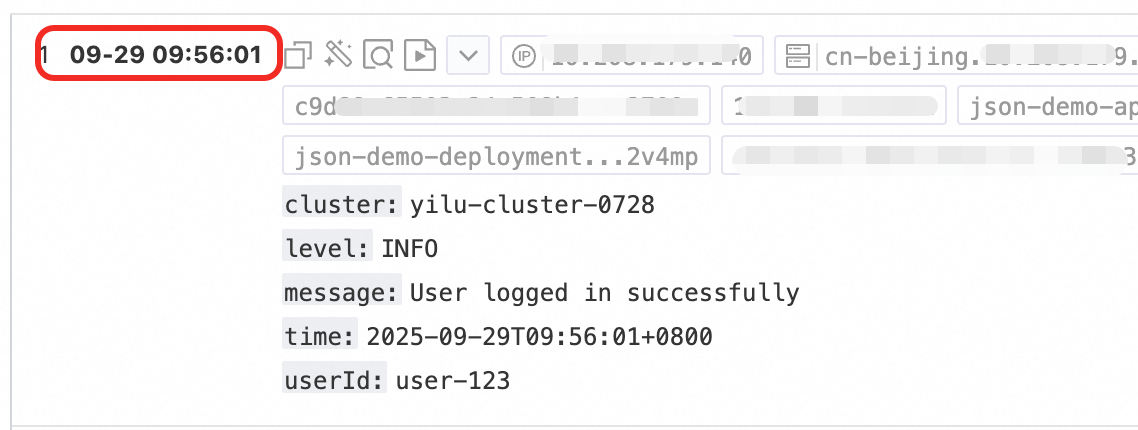
Procedimiento: En la página Logtail Configuration, dentro de la sección Processor Configurations, haga clic en Add Processor y seleccione :
Original Field: campo de origen que contiene la cadena de tiempo por analizar.
Time Format: el time format correspondiente a la cadena de tiempo de los registros.
Time Zone: zona horaria del campo de tiempo del registro. Si no se especifica, se usa de forma predeterminada la zona horaria de la máquina donde se ejecuta LoongCollector (Logtail).
Apéndice: limitaciones de las expresiones regulares (filtrado de contenedores)
Las expresiones regulares para el filtrado de contenedores utilizan el motor Go RE2. En comparación con otros motores como PCRE, el motor RE2 tiene varias limitaciones de sintaxis. Tenga en cuenta lo siguiente al escribir expresiones regulares:
1. Diferencias en la sintaxis de grupos con nombre
Go emplea la sintaxis (?P<name>...) para definir un grupo con nombre y no admite la sintaxis (?<name>...) de PCRE.
Correcto:
(?P<year>\d{4})Incorrecto:
(?<year>\d{4})
2. Funciones de expresiones regulares no admitidas
El motor RE2 no admite las siguientes funciones comunes pero complejas de las expresiones regulares. Evite utilizarlas:
Asertos (assertions):
(?=...),(?!...),(?<=...)y(?<!...)Expresiones condicionales:
(?(condition)true|false)Coincidencia recursiva:
(?R)y(?0)Referencias a subprogramas:
(?&name)y(?P>name)Grupos atómicos:
(?>...)
3. Recomendaciones
Utilice una herramienta como Regex101 para depurar las expresiones regulares. Para garantizar la compatibilidad, seleccione el modo Golang (RE2) durante la validación. Si utiliza alguna sintaxis no admitida, el plugin no podrá analizar ni hacer coincidir la expresión.
Apéndice: comparación de versiones de la salida estándar de contenedores
Para mejorar la eficiencia del almacenamiento y la consistencia de la recopilación, se actualizó el formato de metadatos de los registros de la salida estándar de contenedores. El nuevo formato consolida los metadatos bajo el campo __tag__, lo cual optimiza el almacenamiento y estandariza el formato.
Ventajas principales de la nueva salida estándar
Mejora significativa del rendimiento
Al estar refactorizada en C++, la nueva versión ofrece una mejora de rendimiento del 180 % al 300 % respecto a la implementación anterior en Go.
Admite el procesamiento de datos con plugins nativos y el procesamiento paralelo multihilo, lo que aprovecha al máximo los recursos del sistema.
Permite combinar de forma flexible plugins nativos y plugins de Go para cubrir las necesidades de escenarios complejos.
Mayor confiabilidad
Incorpora una cola de rotación para los registros de salida estándar y unifica el mecanismo de recopilación de registros con el de archivos. Esto garantiza alta confiabilidad cuando los registros de salida estándar rotan rápidamente.
Menor consumo de recursos
El uso de CPU se reduce entre un 20 % y un 25 %.
El uso de memoria disminuye entre un 20 % y un 25 %.
Mayor consistencia en operaciones y mantenimiento
Configuración de parámetros unificada: los parámetros de configuración del nuevo plugin de recopilación de salida estándar coinciden con los del plugin de recopilación de archivos.
Gestión de metadatos unificada: el nombre de los campos de metadatos del contenedor y la ubicación de almacenamiento de etiquetas se alinean con el escenario de recopilación de archivos. Así, el lado del consumidor mantiene un solo conjunto de lógica de procesamiento.
Comparación de funciones entre la versión nueva y la anterior
|
Función |
Versión anterior |
Nueva versión |
|
Método de almacenamiento |
Los metadatos se integran en el contenido del registro como campos normales. |
Los metadatos se consolidan bajo la etiqueta |
|
Eficiencia de almacenamiento |
Cada entrada de registro lleva una copia completa de los metadatos, lo que consume más espacio de almacenamiento. |
Varias entradas de registro en el mismo contexto pueden reutilizar los metadatos, lo que ahorra costos de almacenamiento. |
|
Consistencia de formato |
El formato no coincide con el de la recopilación de archivos de contenedores. |
El nombre de los campos y la estructura de almacenamiento se alinean por completo con la recopilación de archivos de contenedores, lo que brinda una experiencia unificada. |
|
Método de acceso en consultas |
Los metadatos se consultan directamente por el nombre del campo, como |
Es necesario acceder al par clave-valor correspondiente mediante |
Asignación de campos de metadatos del contenedor
|
Nombre de campo anterior |
Nuevo nombre de campo |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
En la nueva versión, todos los campos de metadatos se almacenan en la sección de etiquetas del registro con el formato __tag__:<key>, en lugar de integrarse en el contenido del registro.
Impacto de la nueva versión en los usuarios
Adaptación del lado del consumidor: dado que la ubicación de almacenamiento cambia del contenido a la etiqueta, debe ajustar la lógica de consumo de registros en consecuencia. Por ejemplo, al ejecutar una consulta, acceda a los campos mediante
__tag__.Compatibilidad con SQL: las consultas SQL ya son compatibles automáticamente con ambas versiones, por lo que no necesita modificar sus instrucciones para procesar registros de cualquiera de ellas.
Más información
Parámetros globales
Parámetros de entrada
Parámetros del procesador
Parámetro | Descripción |
Ejemplo de registro | Un ejemplo del registro que desea recopilar. Utilice un registro de su caso de uso real. Este ejemplo le ayuda a configurar los parámetros de procesamiento con mayor facilidad. Puede agregar varios ejemplos. La longitud total no puede superar los 1500 caracteres. |
Modo multilínea |
|
Modo de procesamiento | Processors, que incluye el Native Processor y el Extended Processor. Para obtener más información sobre los procesadores, consulte Use native and extended processors. Importante Para conocer las limitaciones de uso de los procesadores, consulte los mensajes de la consola.
|