Obtenga información sobre los endpoints de WebSocket, la autenticación, los flujos de interacción en tiempo real y de inferencia, y los eventos específicos del modelo.
Requisitos previos
- Active el modelo o la aplicación objetivo y confirme sus regiones compatibles.
- Obtenga una clave de API para la región y el espacio de trabajo que utilizará. Consulte Autenticación por token.
- Obtenga su ID de espacio de trabajo si utiliza un dominio específico del espacio de trabajo.
Para la selección de protocolo y los modelos compatibles, consulte la Descripción general de la API en tiempo real.
Encabezados de la solicitud
Configure Authorization en la solicitud de protocolo de enlace de WebSocket. Utilice otros encabezados tal como se describe en la referencia de parámetros del modelo objetivo.
Header | Obligatorio | Descripción |
|---|---|---|
Authorization | Sí | Pase la clave de API como |
user-agent | No | Identifica al cliente. |
X-DashScope-WorkSpace | Específico del modelo | Especifica un ID de espacio de trabajo. Consulte la referencia de encabezados específica del modelo para su uso. |
X-DashScope-DataInspection | Específico del modelo | Configura la inspección de datos. Consulte la referencia de encabezados específica del modelo para conocer los valores admitidos y su aplicabilidad. |
Endpoints
Utilice wss:// y seleccione la ruta de la API y la ubicación del model-name para su modelo objetivo. La siguiente tabla enumera los métodos de conexión por modelo. Para conocer los modelos y regiones compatibles, consulte la documentación del modelo correspondiente.
Familia de modelos | Ruta de la API | Ubicación del nombre del modelo |
|---|---|---|
Qwen-Omni-Realtime | /api-ws/v1/realtime | Parámetro de consulta de URL |
Qwen-Audio-TTS/CosyVoice | /api-ws/v1/inference |
|
Qwen-TTS-Realtime | /api-ws/v1/realtime | Parámetro de consulta de URL |
Qwen-Audio-ASR/Fun-ASR/Paraformer | /api-ws/v1/inference |
|
Qwen-ASR-Realtime | /api-ws/v1/realtime | Parámetro de consulta de URL |
Qwen-Audio-Realtime | /api-ws/v1/realtime | Parámetro de consulta de URL |
Qwen-LiveTranslate-Realtime | /api-ws/v1/realtime | Parámetro de consulta de URL |
Dominios específicos del espacio de trabajo:
Región | Dominio específico del espacio de trabajo |
|---|---|
China (Beijing) | {WorkspaceId}.cn-beijing.maas.aliyuncs.com |
Singapur | {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com |
Reemplace {WorkspaceId} con su ID de espacio de trabajo. Ejemplos:
wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen3.8-omni-flash-realtime
wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/inference
Qwen-TTS-Realtime también admite los dominios públicos dashscope.aliyuncs.com para Pekín y dashscope-intl.aliyuncs.com para Singapur, con la misma ruta /api-ws/v1/realtime. La clave de API debe coincidir con la región.
Flujos de interacción comunes
/api-ws/v1/realtime utiliza un protocolo basado en sesiones, mientras que /api-ws/v1/inference utiliza un protocolo basado en tareas.
Protocolo Realtime
Después de conectarse, el cliente configura la sesión con session.update y espera a session.updated antes de enviar la entrada. El modelo objetivo determina cómo confirmar la entrada, activar una respuesta y finalizar la sesión.
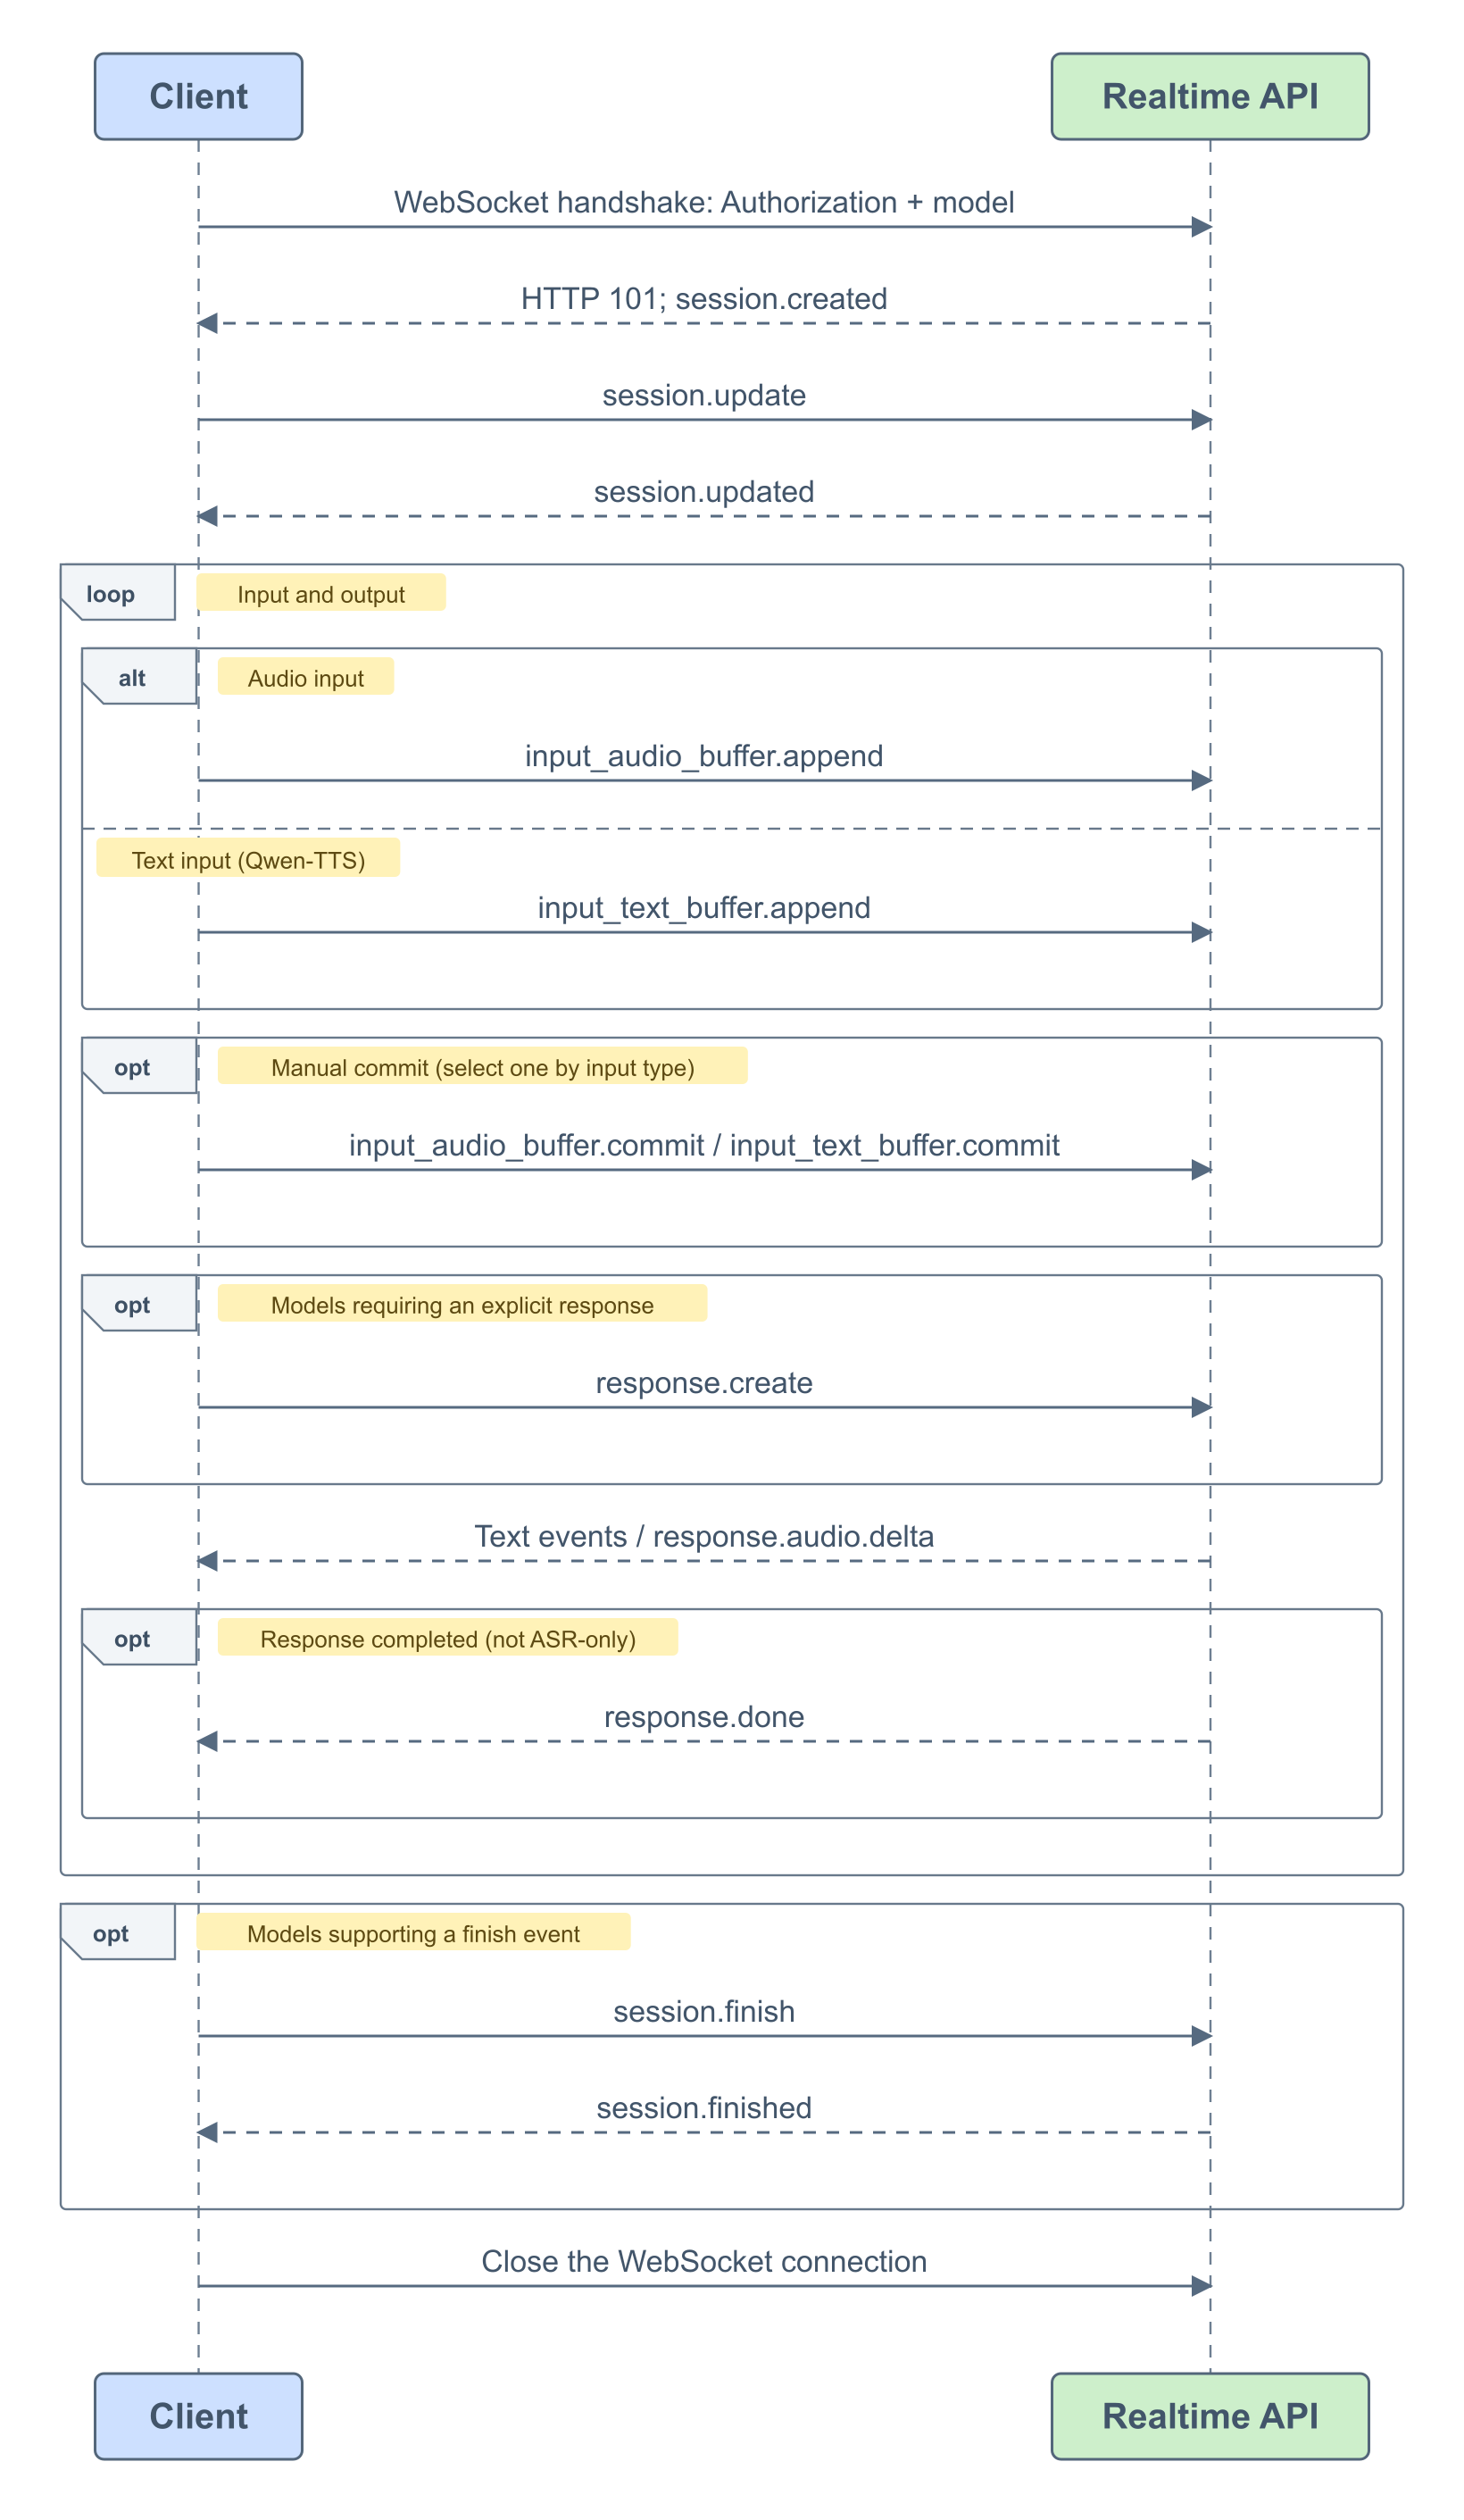
- Conectar: Especifique el modelo en el parámetro de consulta
modelde la URL e incluya la clave de API en los encabezados de la solicitud. Después de un protocolo de enlace exitoso, el servidor envíasession.created. - Configurar la sesión: Envíe
session.updatepara configurar formatos de audio compatibles, modalidades de salida, voces o parámetros de detección de voz, y luego espere asession.updated. Consulte la referencia de eventos de cliente específica del modelo para conocer los parámetros de sesión admitidos. - Enviar entrada: Envíe audio codificado en Base64 con
input_audio_buffer.append. Para Qwen-TTS, envíe texto coninput_text_buffer.append. Los modelos que admiten entrada de imágenes utilizaninput_image_buffer.append; siga los requisitos de sincronización de imágenes y audio del modelo. - Confirmar y recibir resultados: En los modos automáticos, el servidor activa el procesamiento. En los modos manuales, envíe
input_audio_buffer.commitoinput_text_buffer.commitsegún el tipo de entrada. Si también se requiereresponse.createy qué eventos de resultado manejar depende del modelo. Consulte la comparación a continuación. - Finalizar la sesión: Para modelos que admiten un evento de finalización, envíe
session.finishy espere asession.finishedy a los resultados restantes. Para otros modelos, cierre el WebSocket después de recibir los resultados.response.donemarca el final de una respuesta, no de la conexión. Para modelos exclusivos de ASR, los eventos de finalización de transcripción marcan el fin del reconocimiento.
Protocolo de inferencia
El cliente envía run-task y espera a task-started antes de transmitir la entrada. El reconocimiento de voz utiliza tramas de audio binarias; la síntesis de voz envía texto con continue-task. Cuando finalice la entrada, envíe finish-task y espere a task-finished.
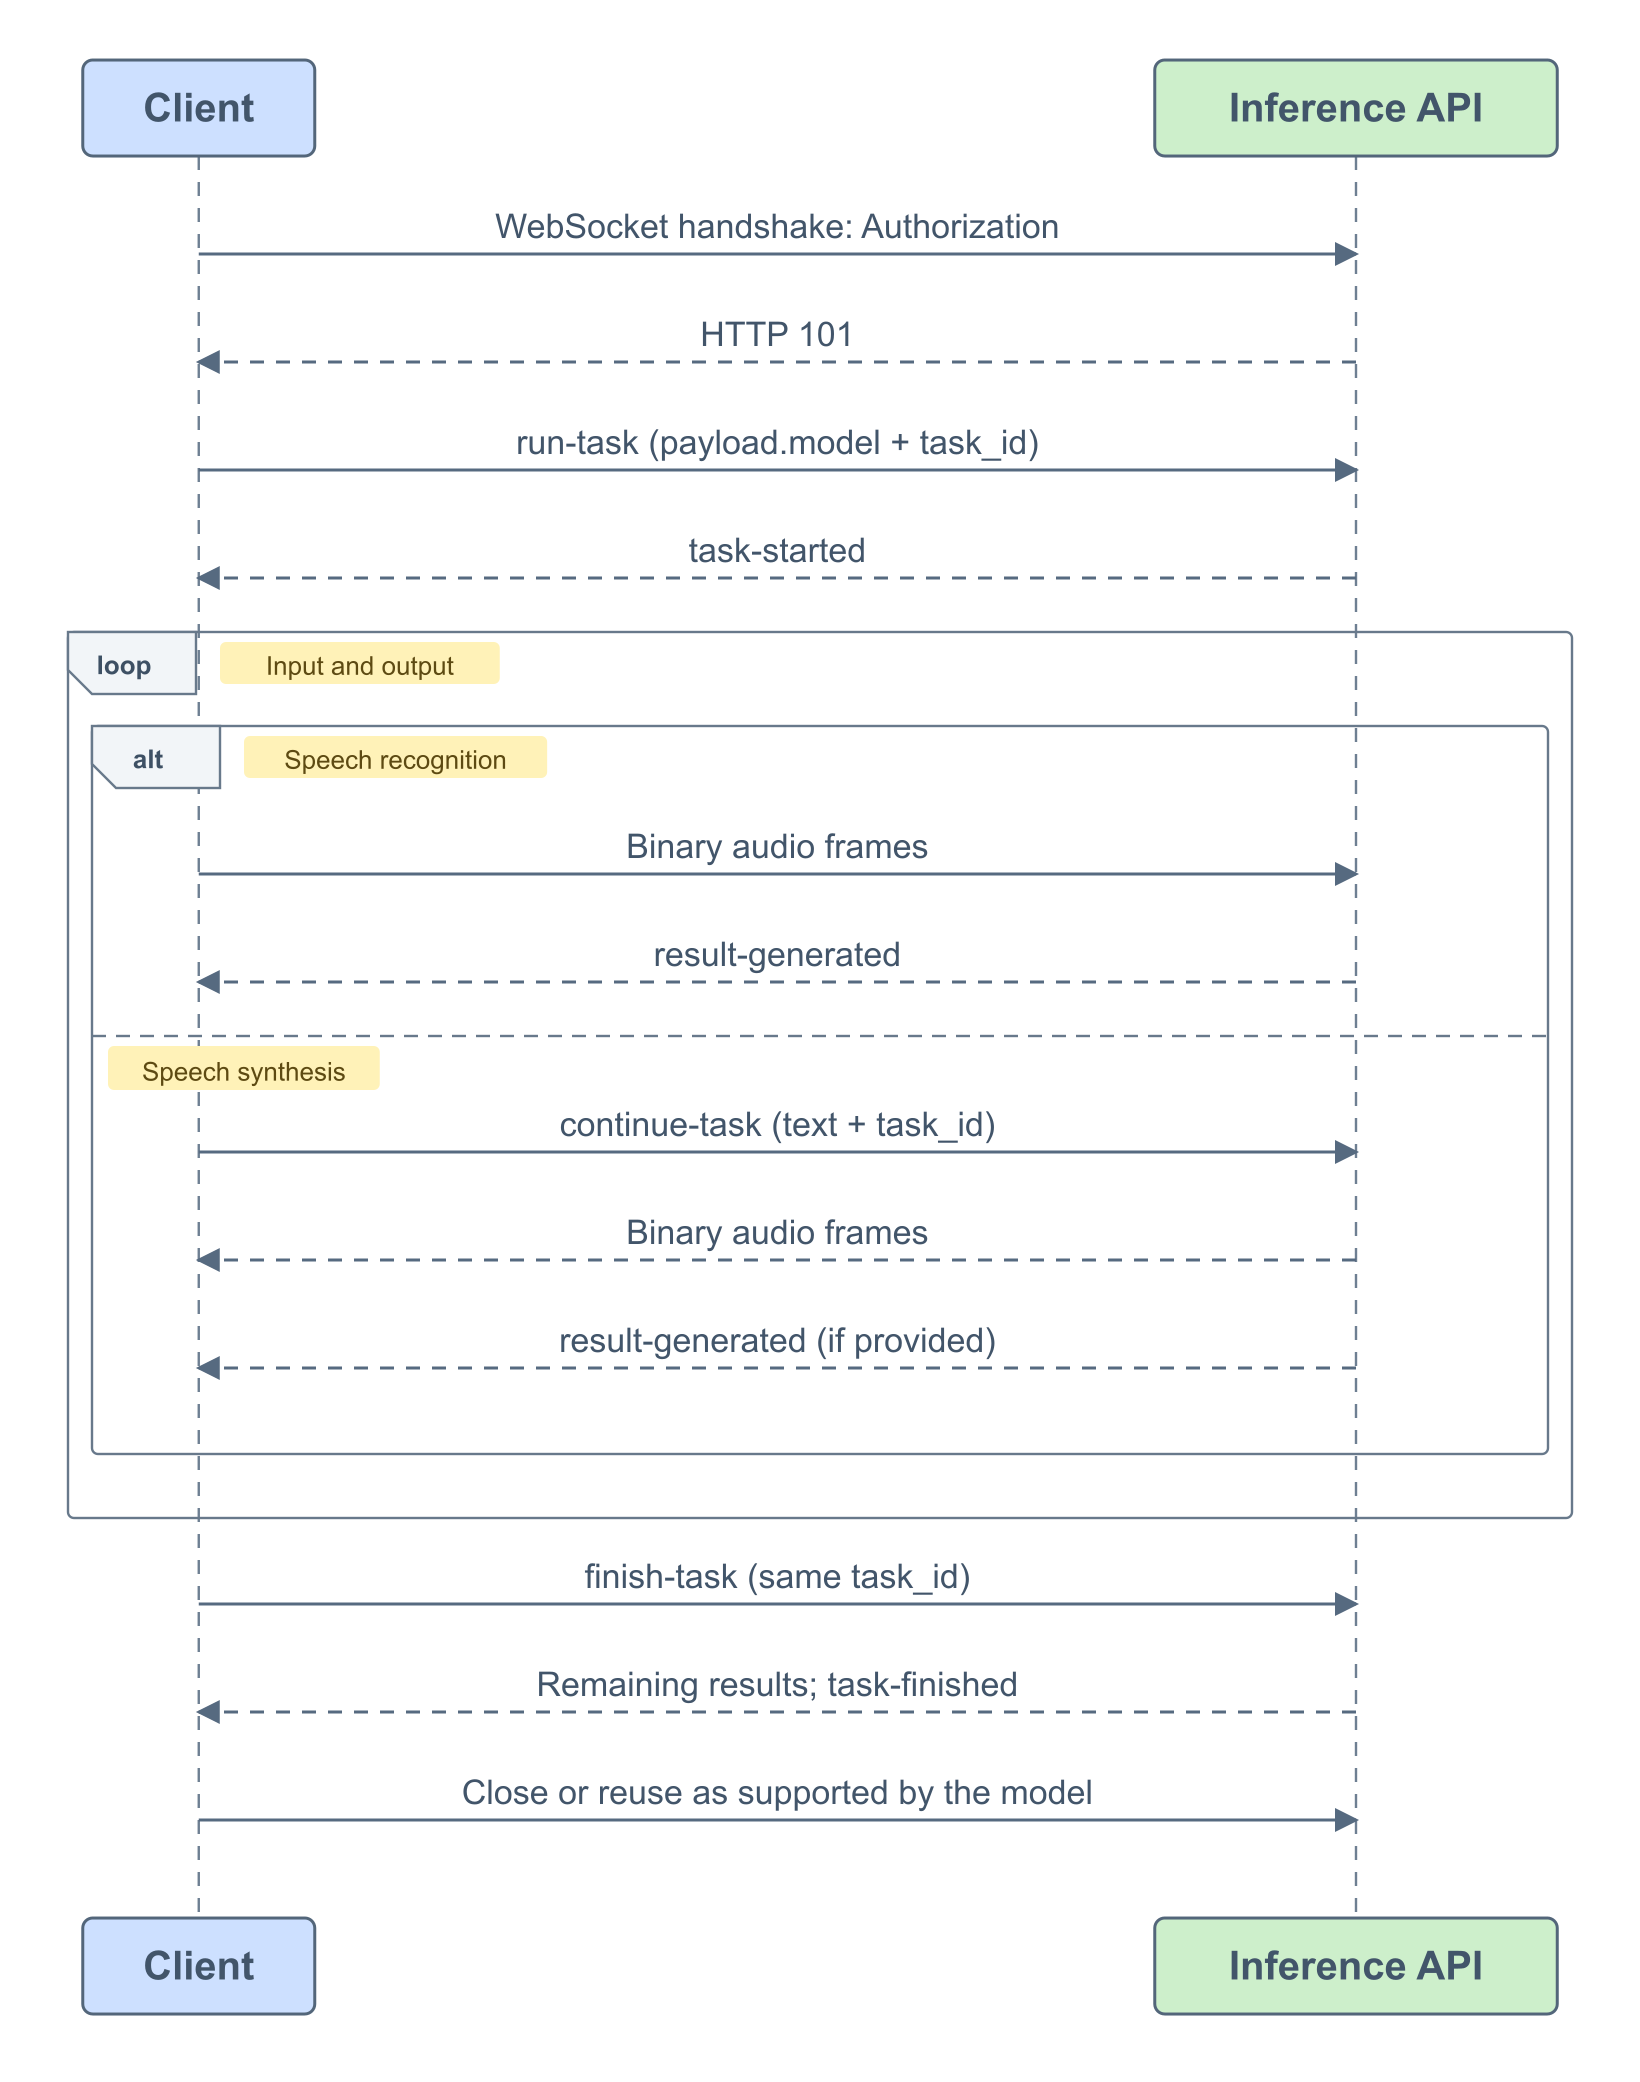
- Conectar: Use
/api-ws/v1/inferencee incluya la clave de API en los encabezados de la solicitud. - Iniciar una tarea: Envíe
run-task, especificando el modelo enpayload.modely parámetros como el formato de entrada. Genere unheader.task_idúnico y espere atask-started. - Enviar entrada y recibir resultados:
- Reconocimiento de voz: Envíe tramas de audio binarias y reciba los resultados de reconocimiento a través de
result-generated. - Síntesis de voz: Envíe texto en
payload.input.textdecontinue-tasky reciba tramas de audio binarias. El modelo también puede devolver información como marcas de tiempo a través deresult-generated.
- Reconocimiento de voz: Envíe tramas de audio binarias y reciba los resultados de reconocimiento a través de
- Finalizar la tarea: Después de enviar
finish-task, continúe recibiendo los resultados restantes hasta que lleguetask-finished. Todos los eventosrun-task,continue-taskyfinish-taskpara la misma tarea deben usar el mismoheader.task_id. Luego cierre la conexión o reutilícela según lo admita el modelo.
Diferencias entre modelos
Modelos Realtime
La siguiente tabla resume los disparadores de entrada y la finalización de la sesión. Para todos los tipos de VAD compatibles, formatos de audio y otros valores de parámetros, consulte las referencias de eventos específicas del modelo.
Modelo | Activación de entrada y respuesta | Finalización |
|---|---|---|
Qwen3.8-Omni / Qwen3.5-Omni | Los modos VAD activan las respuestas automáticamente. En el modo Manual, envíe | Cierre la conexión después de recibir los resultados. |
Qwen-TTS-Realtime |
| session.finish → session.finished |
Qwen-ASR-Realtime | El modo VAD procesa la entrada automáticamente. En el modo Manual, envíe | session.finish → session.finished |
Qwen-Audio-Realtime | Los modos automáticos detectan los turnos en el servidor. En el modo Manual, envíe | Cierre la conexión después de recibir los resultados. |
Qwen3.8-LiveTranslate | Configure las modalidades de salida con | session.finish → session.finished |
Qwen3.5-LiveTranslate | Configure la sesión con | session.finish → session.finished |
Los principales eventos de salida se enumeran a continuación. Los eventos devueltos dependen de las modalidades de salida configuradas.
Modelo | Eventos de salida principales |
|---|---|
Qwen-Omni-Realtime |
|
Qwen-TTS-Realtime |
|
Qwen-ASR-Realtime |
|
Qwen-Audio-Realtime |
|
Qwen3.8-LiveTranslate |
|
Qwen3.5-LiveTranslate |
|
NotaLos nombres de los eventos de traducción dependen de la versión del modelo: Qwen3.8-LiveTranslate usa .delta, mientras que Qwen3.5-LiveTranslate usa .text. Por ejemplo, las transcripciones de audio traducidas usan response.audio_transcript.delta y response.audio_transcript.text, respectivamente.
Modelos de inferencia
Qwen-Audio-TTS/CosyVoice utiliza el flujo de tareas run-task → task-started → continue-task → finish-task → task-finished. El reconocimiento de voz de Qwen-Audio-ASR/Fun-ASR/Paraformer envía tramas de audio binarias después de task-started. Ambos tipos reportan errores de tarea a través de task-failed.
Guías de integración específicas del modelo
Omni en tiempo real
Síntesis de voz en tiempo real
Qwen-Audio-TTS
CosyVoice
Qwen-TTS-Realtime
Sambert
Reconocimiento de voz en tiempo real
Qwen-Audio-3.1-ASR-Flash-Message
Qwen-Audio-ASR-Streaming
Fun-ASR-Realtime
Qwen-ASR-Realtime
Paraformer
Conversación de voz en tiempo real
Qwen-Audio-Realtime
Traducción de audio y video en tiempo real
Qwen-Livetranslate-Realtime
Manejo de errores
- Fallo en el protocolo de enlace: Utilice el estado HTTP y el mensaje de error para verificar el endpoint, la clave de API, el espacio de trabajo y los permisos del modelo. Para 401/403, verifique primero la autenticación.
- Modelo no disponible o no activado: Verifique el nombre del modelo, la activación del servicio y la región.
- Errores en tiempo real: Maneje los eventos
errory lea su tipo y mensaje. Ajuste el tipo de evento o los parámetros en la solicitud según el mensaje de error. - Errores de inferencia: Un evento
task-failedindica que la tarea ha fallado. Leaheader.error_codeyheader.error_messagepara conocer la causa.
Después de corregir la configuración o manejar una interrupción de red, vuelva a conectarse y configure una nueva sesión o inicie una nueva tarea según lo requiera el protocolo. Consulte Códigos de error.