La API Realtime de Qwen-Audio proporciona capacidades de conversación de voz en tiempo real a través del protocolo WebSocket. Los clientes interactúan con el servidor enviando y recibiendo eventos JSON. La API admite entrada de audio, entrada de texto, detección de actividad de voz (VAD) y salida de audio y texto en flujo continuo.
Guía del usuario: Chat de audio en tiempo real (Qwen-Audio-Realtime). Para descripciones detalladas de los eventos del cliente y del servidor, consulte Eventos del cliente y Eventos del servidor.
ImportanteAlibaba Cloud Model Studio ha lanzado dominios específicos de espacio de trabajo para las regiones de China (Beijing) y Singapur. Los nuevos dominios dedicados ofrecen un rendimiento superior y una mayor estabilidad para las solicitudes de inferencia. Recomendamos migrar a los nuevos dominios:
- China (Pekín): de
dashscope.aliyuncs.coma{WorkspaceId}.cn-beijing.maas.aliyuncs.com - Singapur: de
dashscope-intl.aliyuncs.coma{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com
Reemplace {WorkspaceId} con su ID de espacio de trabajo real. Los dominios existentes permanecen totalmente funcionales.
Endpoint de servicio
La URL de WebSocket es fija, como se indica a continuación. Especifique el nombre del modelo utilizando el parámetro de consulta model (reemplace <model_name> con el nombre real del modelo):
Singapore
wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime?model=<model_name>
Reemplace {WorkspaceId} (incluidas las llaves) con su ID de espacio de trabajo real.
China (Beijing)
wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/realtime?model=<model_name>
Reemplace {WorkspaceId} (incluidas las llaves) con su ID de espacio de trabajo real.
ImportanteUtilice el protocolo wss://. Configure Authorization en el encabezado de la solicitud. Pase el nombre del modelo en el parámetro de consulta URL model.
Encabezados de solicitud
Incluya los siguientes encabezados en su solicitud:
Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
Authorization | string | Sí | Token de autenticación en el formato |
user-agent | string | No | Identificador del cliente para el seguimiento de solicitudes en el lado del servidor. |
X-DashScope-WorkSpace | string | No | ID del espacio de trabajo de Alibaba Cloud Model Studio. |
ImportanteLa autorización se verifica durante el protocolo de enlace de WebSocket. Si la clave API no es válida o falta, el protocolo de enlace falla con un error HTTP 401/403.
Conceptos clave
- Sesión: Una única conexión WebSocket corresponde a una sesión, la cual mantiene la configuración y el contexto de la conversación.
- Elemento de conversación: Un mensaje individual en una conversación, mantenido en secuencia.
- Respuesta: La salida generada por una única inferencia del modelo, que contiene uno o más elementos de salida. Un elemento de salida puede ser un mensaje del asistente o una llamada a función.
- Llamada a función: Un elemento de salida que produce el modelo cuando necesita que el cliente ejecute una función de herramienta. Después de que el cliente ejecuta la herramienta, envía el resultado de vuelta en
function_call_outputy activa la siguiente inferencia conresponse.create. - Detección de turnos: Controla cuándo activar la inferencia del modelo.
Modos de interacción
La API Realtime de Qwen-Audio admite tres modos de interacción, configurados mediante el parámetro turn_detection.type del evento session.update:
Modo | turn_detection.type | Descripción | Casos de uso |
|---|---|---|---|
server_vad |
| El VAD del lado del servidor detecta el inicio y el final del habla, y activa automáticamente la inferencia. | Conversación con manos libres, asistentes de voz |
smart_turn |
| Detección inteligente de turnos que combina análisis acústico y semántico para determinar los límites de los turnos, no solo señales de voz. Los sonidos no semánticos (como "eh" y "ah") no activan un turno ni interrumpen la reproducción. | Conversación natural de baja latencia, interrupción de alta calidad |
push-to-talk |
| El cliente envía audio manualmente y activa la inferencia. | Push-to-talk, control preciso |
Flujo de interacción
Para descripciones detalladas de los eventos del cliente y del servidor, consulte Eventos del cliente y Eventos del servidor.
Modo server_vad
El servidor realiza la detección de actividad de voz en el audio entrante y activa automáticamente la inferencia tras detectar el final del habla.
Cómo habilitar: Establezca turn_detection.type del evento session.update en server_vad.
Turno de conversación completo
El siguiente diagrama ilustra la secuencia típica de interacción en el modo server_vad:
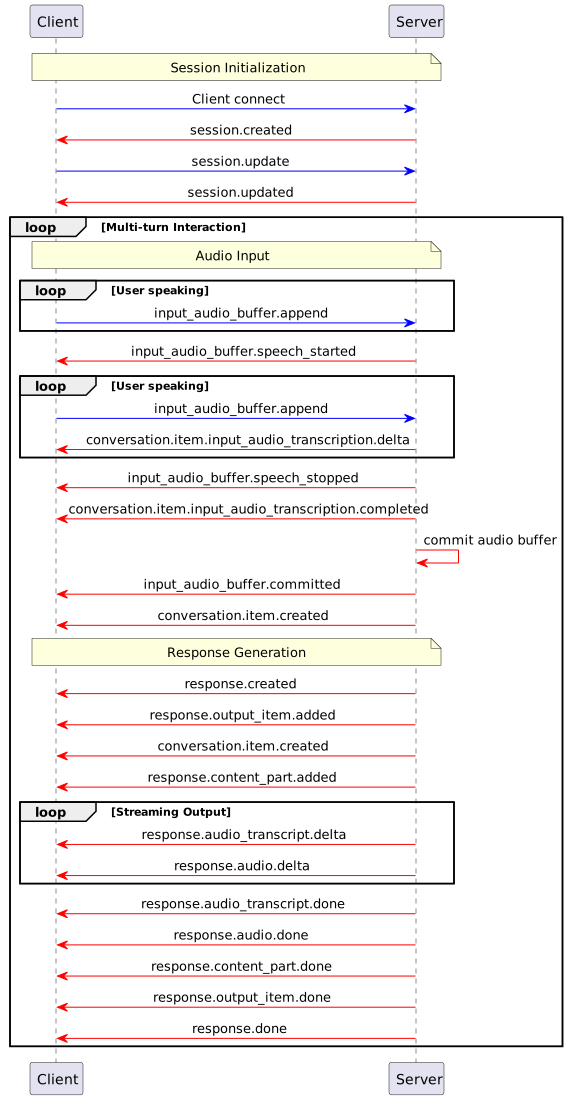
La interacción se desarrolla de la siguiente manera:
- El cliente establece una conexión WebSocket y el servidor devuelve un evento
session.created. - El cliente envía
session.updatepara configurar los parámetros de la sesión, y el servidor devuelvesession.updated. - El cliente envía continuamente
input_audio_buffer.appendpara transmitir datos de audio en flujo continuo. - El servidor detecta el inicio del habla y devuelve
input_audio_buffer.speech_started. También transmite deltas de transcripción ASR medianteconversation.item.input_audio_transcription.delta. - El servidor detecta el final del habla y devuelve
input_audio_buffer.speech_stopped,input_audio_buffer.committedyconversation.item.created. - El servidor genera automáticamente una respuesta, transmitiendo deltas de texto y audio en flujo continuo (
response.audio_transcript.delta,response.audio.delta), y finalmente devuelveresponse.done.
Interrupción del usuario
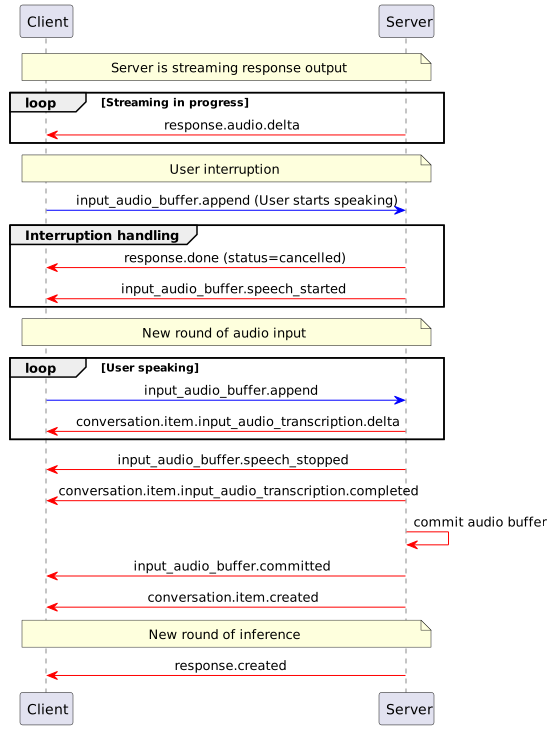
Si el VAD detecta que el usuario comienza a hablar mientras el modelo reproduce una respuesta, el servidor cancela la respuesta actual (devuelve response.done con estado cancelled) y luego inicia una nueva ronda de entrada de voz y respuesta. El siguiente diagrama ilustra la secuencia de interacción de interrupción por parte del usuario:
Modo smart_turn
El modo smart_turn detecta el final del habla combinando percepción acústica y comprensión semántica, filtrando respuestas de retroalimentación, ruido de fondo y otros sonidos no semánticos. Los sonidos no semánticos se transmiten como eventos conversation.item.ambient_audio_transcription.delta sin activar un turno de conversación.
Cómo habilitar: Establezca turn_detection.type del evento session.update en smart_turn.
Turno de conversación completo
El siguiente diagrama ilustra la secuencia típica de interacción en el modo smart_turn:
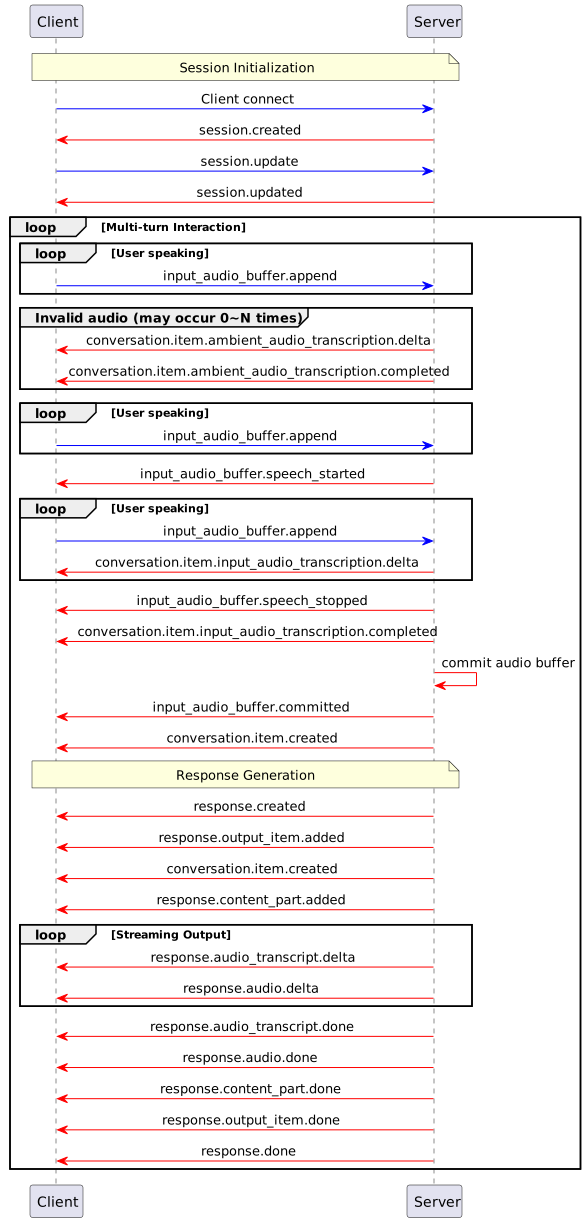
Diferencias clave con respecto al modo server_vad:
- Los sonidos no semánticos ("eh", "ah", etc.) no activan la inferencia. En su lugar, se devuelven a través de eventos
ambient_audio_transcription. - El habla validada previamente puede revocarse (
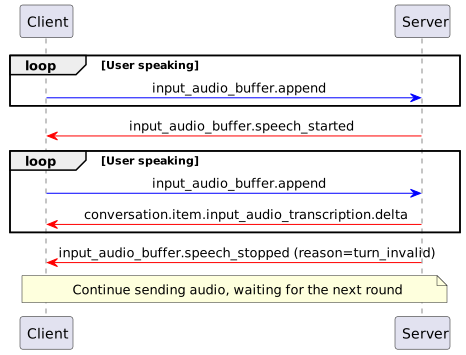
input_audio_buffer.speech_stoppeddevuelvereason=turn_invalid), en cuyo caso no se activa la inferencia. - Mientras espera la siguiente entrada del usuario, el cliente puede enviar explícitamente
response.createpara activar la inferencia.
Interrupción del usuario
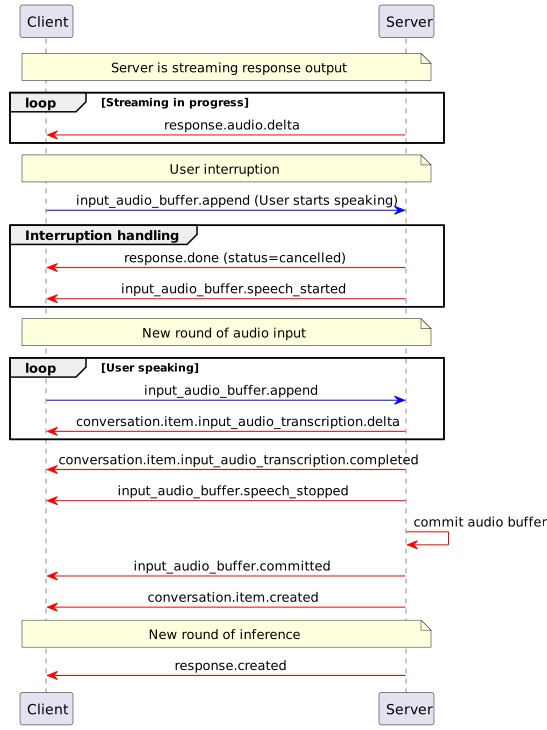
El manejo de interrupciones es prácticamente el mismo que en el modo server_vad. El siguiente diagrama ilustra la secuencia de interacción de interrupción por parte del usuario:
Turno no válido
El habla validada previamente puede revocarse (input_audio_buffer.speech_stopped devuelve reason=turn_invalid), en cuyo caso no se activa la inferencia. El cliente debe continuar enviando audio y esperar al siguiente habla válida. El siguiente diagrama ilustra la secuencia de interacción de turno no válido:
Flujo de configuración de mejora del hablante
En el modo smart_turn, cuando voiceprint_audio_urls se incluye en el primer session.update, el servidor realiza el registro de impresión de voz de forma asíncrona (cargando las características de audio del hablante objetivo) y notifica al cliente el progreso del registro mediante eventos. Un registro de impresión de voz fallido no bloquea el flujo normal de la conversación.
La secuencia de interacción para el registro de impresión de voz es la siguiente:
-
El cliente envía
session.updatecon las URL de audio de impresión de voz enturn_detection.voiceprint_audio_urls. El servidor devuelvesession.created. -
El servidor inicia inmediatamente el registro de impresión de voz de forma asíncrona y envía
voiceprint_audio_list.in_progressantes de devolversession.updated. Este evento lleva elitem_idque identifica de forma única la tarea de registro. -
El servidor devuelve
session.updatedpara confirmar que la configuración de la sesión ha surtido efecto. -
Una vez completado el registro, el servidor envía un evento terminal (el
item_idcoincide con el del paso 2):- Registro exitoso:
voiceprint_audio_list.completed. - Registro fallido:
voiceprint_audio_list.failed, con un camporeasonque describe el fallo (por ejemplo, no se pudo descargar la URL de audio).
- Registro exitoso:
Notavoiceprint_audio_urls solo es configurable en el primer session.update evento. El campo se ignora en llamadas posteriores de session.update.
Modo push-to-talk
El cliente controla manualmente el envío de audio y la activación de la inferencia. Utilice este modo cuando necesite un control preciso sobre cuándo se envía el audio y comienza la inferencia.
Cómo habilitar: Establezca turn_detection del evento session.update en null.
Turno de conversación completo
El siguiente diagrama ilustra la secuencia típica de interacción en el modo push-to-talk:
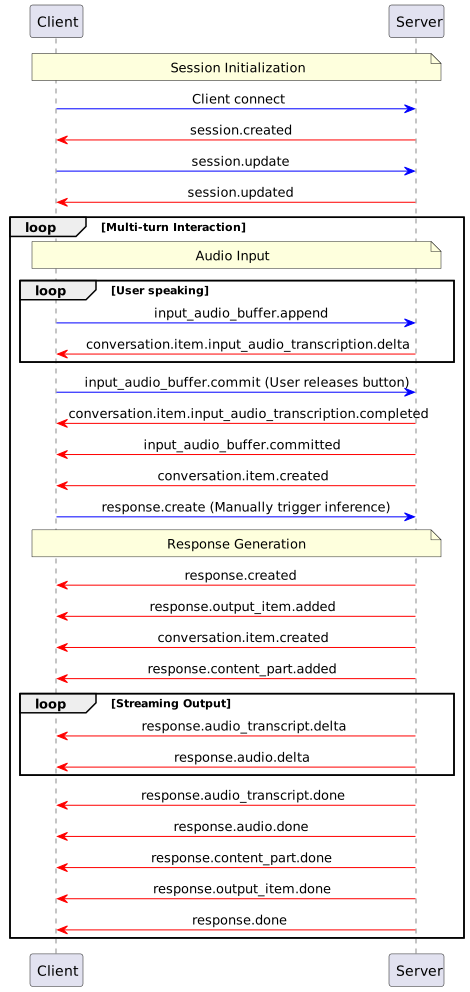
La interacción se desarrolla de la siguiente manera:
- El cliente envía continuamente
input_audio_buffer.appendpara transmitir datos de audio en flujo continuo. - Después de que el usuario termina de hablar, el cliente envía
input_audio_buffer.commitpara confirmar el búfer. - El cliente envía
response.createpara activar manualmente la inferencia. - El servidor genera una respuesta, transmitiendo texto y audio en flujo continuo.
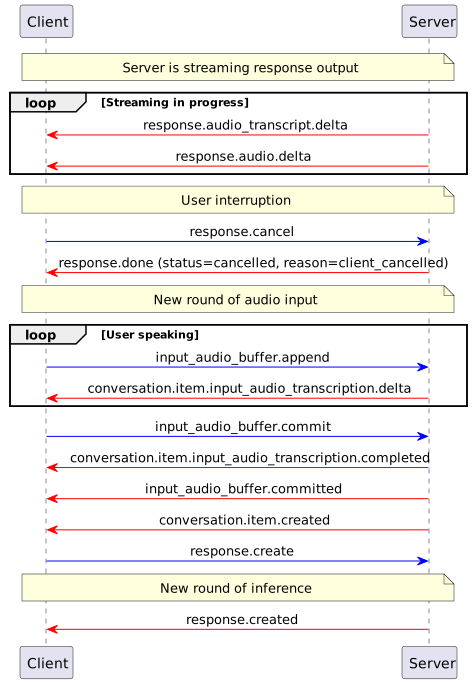
Interrupción del usuario
El cliente envía response.cancel para cancelar la respuesta actual, y el servidor devuelve response.done (con estado cancelled y motivo client_cancelled). El siguiente diagrama ilustra la secuencia de interacción de interrupción por parte del usuario:
Restricciones operativas del modo
Operación | push-to-talk | server_vad | smart_turn |
|---|---|---|---|
session.update | Todos los parámetros se pueden cambiar en el estado IDLE; algunos están restringidos en el estado no IDLE | Todos los parámetros se pueden cambiar en el estado IDLE; algunos están restringidos en el estado no IDLE | Todos los parámetros se pueden cambiar en el estado IDLE; algunos están restringidos en el estado no IDLE |
input_audio_buffer.append | Permitido | Permitido | Permitido |
input_audio_buffer.commit | Permitido | Ignorado | Ignorado |
input_audio_buffer.clear | Permitido | Ignorado | Ignorado |
response.create | Permitido. El audio debe confirmarse primero mediante | Permitido cuando no se está generando ninguna respuesta; no permitido mientras se genera una respuesta | Permitido mientras se espera la siguiente entrada del usuario; no permitido durante un turno activo (desde |
response.cancel | Permitido (durante la inferencia) | Permitido (durante la inferencia) | Permitido (durante la inferencia) |
conversation.item.create/delete/retrieve | Permitido | Permitido | Permitido |
Notaturn_detection y input_audio_format solo se pueden cambiar antes de enviar el primer audio (estado IDLE).
Manejo de errores
Tipo | Comportamiento | Ejemplos |
|---|---|---|
Error del cliente ( | La conexión permanece abierta; el cliente recibe un evento de error | Parámetros no válidos, estado no permitido, item_id duplicado |
Error del servidor ( | Conexión terminada | Fallo de conexión LLM, fallo de almacenamiento |