Puede utilizar el ajuste fino de modelos en Alibaba Cloud Model Studio si el rendimiento de un modelo no cumple con sus expectativas después de haber probado métodos de optimización como ingeniería de indicaciones y llamadas a complementos. Como estrategia central para mejorar el rendimiento del modelo, el ajuste fino puede mejorar significativamente las capacidades del modelo en industrias o escenarios empresariales específicos, alinear sus salidas con las preferencias humanas y reducir la latencia de salida. El ajuste fino de modelos incluye tres métodos de entrenamiento: ajuste fino supervisado (SFT), preentrenamiento continuo (CPT) y optimización directa de preferencias (DPO).
Introducción al ajuste fino de modelos
El ajuste fino de modelos es un método importante para optimizar el rendimiento del modelo. Puede:
- Mejorar el rendimiento del modelo en industrias específicas o para necesidades comerciales específicas
- Reducir la latencia de salida del modelo
- Suprimir la alucinación del modelo
- Alinear el modelo con valores o preferencias humanas
- Reemplazar modelos más grandes con modelos ligeros ajustados
Durante el proceso de ajuste fino, el modelo aprende características específicas del negocio o del escenario a partir de los datos de entrenamiento, como conocimiento, tono, estilos de expresión y autoconciencia. Debido a que el modelo ya ha aprendido muchos ejemplos para industrias o escenarios específicos durante el entrenamiento, su rendimiento con indicaciones de uno o cero disparos después del entrenamiento es mejor que su rendimiento con pocos disparos antes del entrenamiento. Esto ahorra tokens de entrada y reduce la latencia de salida del modelo.
Proceso de ajuste fino del modelo

Para obtener más información, consulte:
Modelos compatibles
Modelos admitidos
Singapore
Generación de texto
Modelo | Código de modelo | Entrenamiento de parámetros completos SFT | Entrenamiento eficiente SFT |
|---|---|---|---|
Qwen3.8-27B | qwen3.8-27b | ✓ | ✓ |
Qwen3.6-27B | qwen3.6-27b | ✓ | ✓ |
Qwen3.5-27B | qwen3.5-27b | ✓ | ✓ |
Qwen3.5-9B | qwen3.5-9b | ✓ | ✓ |
Qwen3-14B | qwen3-14b | × | ✓ |
Comprensión visual (Qwen-VL)
Nombre del modelo | Código de modelo | SFT Entrenamiento de parámetros completos | SFT Entrenamiento eficiente |
|---|---|---|---|
- | - | - | - |
Norte de China 2 (Beijing)
Generación de texto
Servicio de modelo | Código de modelo | CPT Entrenamiento de parámetros completos | SFT Entrenamiento de parámetros completos | SFT Entrenamiento eficiente | DPO Entrenamiento de parámetros completos | DPO Entrenamiento eficiente |
|---|---|---|---|---|---|---|
Qwen3.8-27B | qwen3.8-27b | × | ✓ | ✓ | × | × |
Qwen3.7-Plus-2026-05-26 | qwen3.7-plus-2026-05-26 | × | ✓ | × | × | × |
Qwen3.6-27B | qwen3.6-27b | × | ✓ | ✓ | × | × |
Qwen3.6-Flash-2026-04-16 | qwen3.6-flash-2026-04-16 | × | ✓ | × | × | × |
Qwen3.6-Plus-2026-04-02 | qwen3.6-plus-2026-04-02 | ✓ | ✓ | × | × | × |
Qwen3.5-27B | qwen3.5-27b | × | ✓ | ✓ | × | × |
Qwen3.5-9B | qwen3.5-9b | × | ✓ | ✓ | × | × |
Qwen3.5-4B | qwen3.5-4b | × | ✓ | ✓ | × | × |
Qwen3.5-Flash-2026-02-23 | qwen3.5-flash-2026-02-23 | × | ✓ | × | × | × |
Qwen3.5-Plus-2026-02-15 | qwen3.5-plus-2026-02-15 | × | ✓ | × | × | × |
Qwen3-32B | qwen3-32b | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen3-30B-A3B-Instruct-2507 | qwen3-30b-a3b-instruct-2507 | ✓ | ✓ | ✓ | × | × |
Qwen3-14B | qwen3-14b | × | ✓ | ✓ | ✓ | ✓ |
Qwen3-8B | qwen3-8b | × | ✓ | ✓ | ✓ | ✓ |
Qwen3-4B-Instruct-2507 | qwen3-4b-instruct-2507 | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen3-1.7B | qwen3-1.7b | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen3-0.6B | qwen3-0.6b | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen2.5-72B-Instruct | qwen2.5-72b-instruct | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen2.5-32B-Instruct | qwen2.5-32b-instruct | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen2.5-14B-Instruct | qwen2.5-14b-instruct | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen2.5-7B-Instruct | qwen2.5-7b-instruct | ✓ | ✓ | ✓ | ✓ | ✓ |
Qwen-Plus-Character-2025-11-06 | qwen-plus-character-2025-11-06 | × | ✓ | ✓ | ✓ | ✓ |
Comprensión visual (Qwen-VL)
Servicio de modelo | Código de modelo | CPT Entrenamiento de parámetros completos | SFT Entrenamiento de parámetros completos | SFT Entrenamiento eficiente | DPO Entrenamiento de parámetros completos | DPO Entrenamiento eficiente |
|---|---|---|---|---|---|---|
Qwen3-VL-8B-Instruct | qwen3-vl-8b-instruct | × | ✓ | ✓ | × | × |
Qwen3-VL-8B-Thinking | qwen3-vl-8b-thinking | × | ✓ | ✓ | × | × |
Qwen3-VL-4B-Instruct | qwen3-vl-4b-instruct | × | ✓ | ✓ | × | × |
Qwen2.5-VL-72B-Instruct | qwen2.5-vl-72b-instruct | × | ✓ | ✓ | × | × |
Qwen2.5-VL-32B-Instruct | qwen2.5-vl-32b-instruct | × | ✓ | ✓ | × | × |
Qwen2.5-VL-7B-Instruct | qwen2.5-vl-7b-instruct | × | ✓ | ✓ | × | × |
Comparación de métodos de ajuste
Función | CPT (Preentrenamiento continuo) | SFT (Ajuste fino supervisado) | DPO (Optimización directa de preferencias) |
|---|---|---|---|
Resumen | Complementa el conocimiento (Inyecta conocimiento de dominio) | Aprende a realizar tareas (Sigue instrucciones) | Realiza mejor las tareas (Se alinea con las preferencias humanas) |
Datos de entrada | Más de 10 millones de tokens Texto de dominio no etiquetado | Más de 1,000 entradas Pares de "pregunta-respuesta" de alta calidad | Más de 100 conjuntos Pares de respuestas "mejor-peor" para la misma instrucción |
Objetivo principal | Adaptación al dominio. Aprende vocabulario especializado y hechos. | Enseña al modelo formatos de conversación y capacidades de ejecución de tareas. | Hace que las salidas del modelo se alineen mejor con los valores y preferencias humanas. |
Método de aprendizaje | Aprendizaje autosupervisado (Predice la siguiente palabra) | Aprendizaje supervisado (Imita la verdad fundamental) | Aprendizaje directo de preferencias (Aumenta la probabilidad de buenas respuestas y disminuye la probabilidad de malas respuestas) |
Etapa del modelo | Generalmente antes de SFT | Después de CPT y antes de DPO | Generalmente después de SFT, como paso final para la alineación. |
Comparación de patrones de entrenamiento
Entrenamiento de parámetros completos | Entrenamiento eficiente (LoRA, recomendado) | |
|---|---|---|
Escenarios | • El modelo necesita adquirir nuevas capacidades • Lograr un rendimiento global óptimo. | • Optimizar el rendimiento del modelo para escenarios específicos. • Para escenarios sensibles a los costos y al tiempo. |
Tiempo de entrenamiento | Más largo, con una convergencia más lenta. | Más corto, con una convergencia más rápida. |
Facturación
| Método de facturación | Pago por uso basado en la cantidad de datos de entrenamiento |
| Fórmula de facturación | Tarifa de entrenamiento del modelo = (Total de tokens en datos de entrenamiento + Total de tokens en datos de entrenamiento mixtos) × Número de épocas × Precio unitario de entrenamiento (Unidad mínima de facturación: 1 token)
|
Antes de ajustar finamente un modelo
-
Aunque el ajuste fino de modelos de generación de texto puede lograr excelentes resultados en escenarios comerciales específicos, tiene las siguientes limitaciones:
- Consumo de tiempo: Esto incluye la creación de un conjunto de datos CPT a gran escala (al menos 50 millones de tokens), la construcción de un conjunto de datos SFT efectivo (1,000+ entradas), la recopilación de suficientes casos erróneos (100+) para construir un conjunto de datos DPO efectivo, y la lentitud de las iteraciones de optimización del modelo.
- Alto costo: Un modelo ajustado solo se puede utilizar después de su implementación, y la facturación de implementación del modelo es elevada.
-
Alibaba Cloud Model Studio recomienda que primero intente utilizar Ingeniería de Prompts o Llamada a Funciones para personalizar su aplicación. El ajuste fino del modelo suele ser el "último recurso" para mejorar el rendimiento del modelo. Esto se debe a que:
- En muchas tareas, un modelo puede tener inicialmente un rendimiento deficiente, pero aplicar las técnicas de prompt correctas puede mejorar los resultados sin necesidad de ajustar el modelo.
- Optimizar iterativamente los prompts y los complementos es más ágil y rentable que las iteraciones de ajuste fino del modelo, ya que el ajuste fino puede requerir volver a recopilar, limpiar y optimizar datos, recolectar casos erróneos y realizar encuestas a clientes.
- Incluso si finalmente decide realizar el ajuste fino del modelo, el trabajo inicial en ingeniería de prompts y optimización de complementos no se desperdiciará. Este trabajo preliminar se puede reutilizar completamente al construir el conjunto de datos de ajuste fino.
Introducción
Ajustar finamente un modelo mediante la consola
-
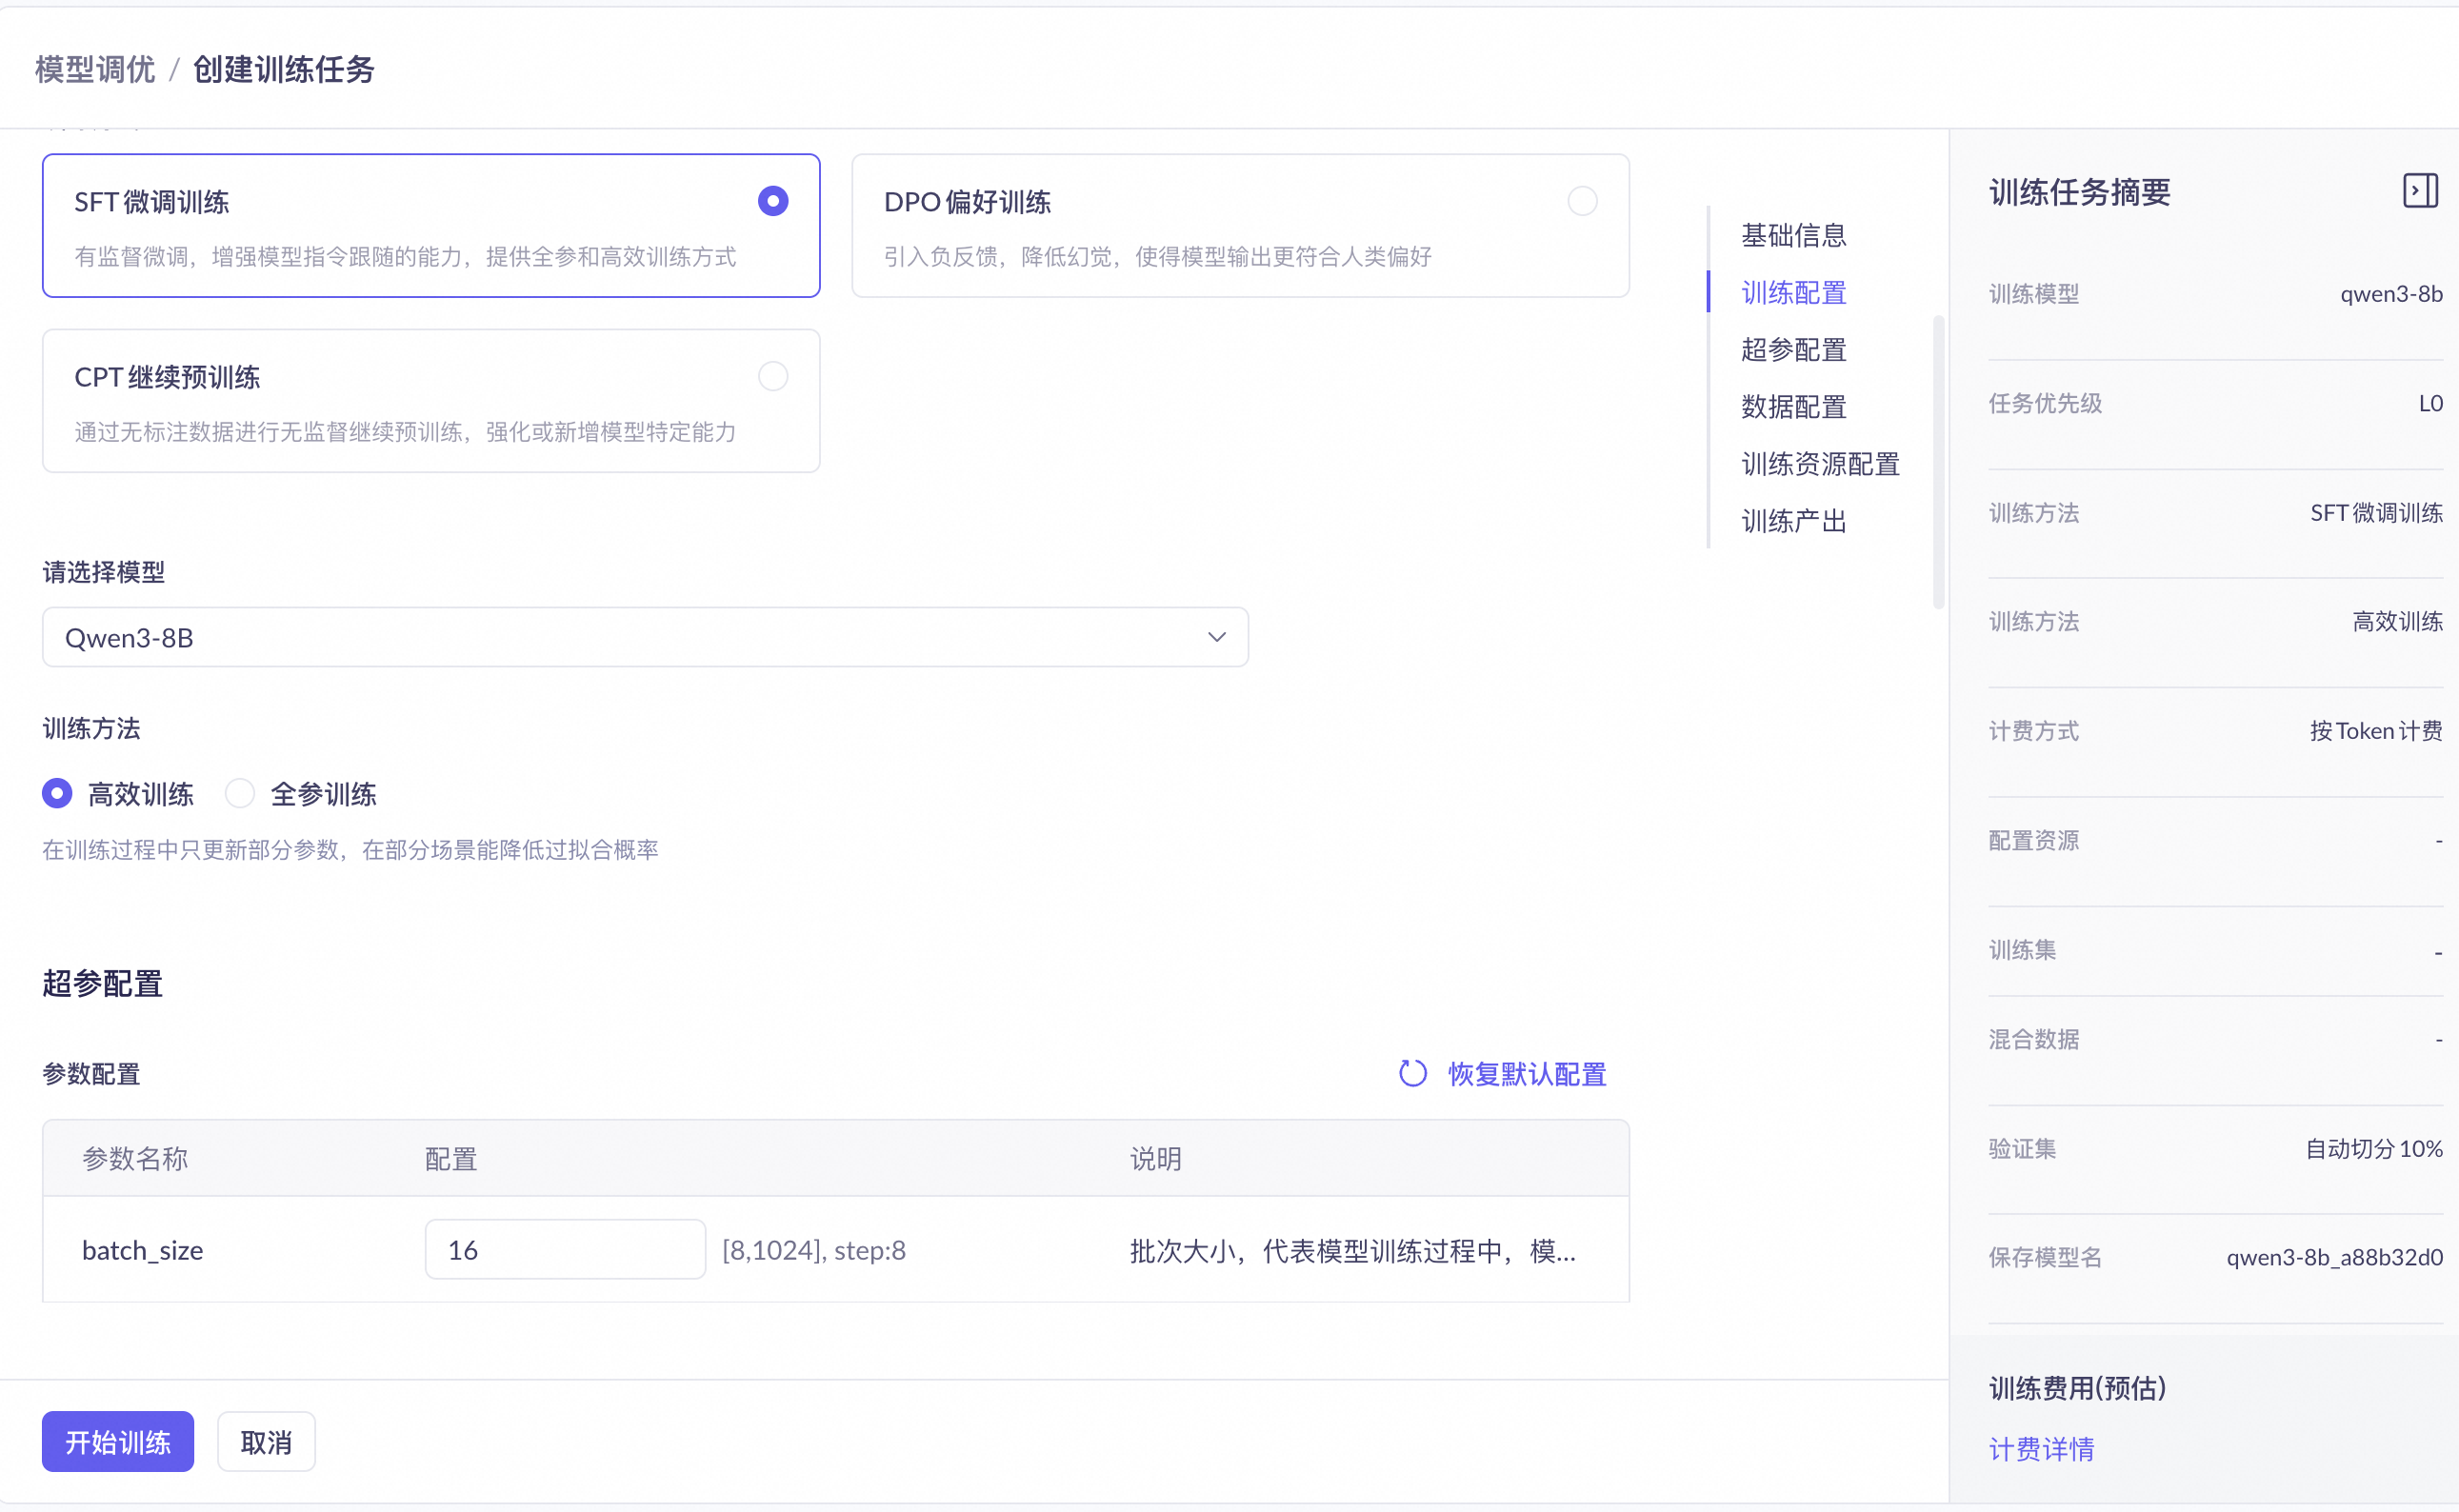
Inicie sesión en la consola de Model Studio. En el panel de navegación izquierdo, elija Model Training > Model Fine-tuning y luego haga clic en Create Training Task.
-
En la sección Training Configuration, complete la siguiente configuración:
- Método de entrenamiento: Seleccione Supervised Fine-tuning (SFT).
- Seleccionar un modelo: Seleccione Qwen3-8B.
- Método de entrenamiento (se muestra después de seleccionar un modelo): Seleccione Efficient Training.
Esta combinación requiere poco tiempo de entrenamiento y pocos registros de datos.
-
En la sección Configuración de hiperparámetros, mantenga las Configuraciones de parámetros predeterminadas. Model Studio proporciona configuraciones recomendadas para los hiperparámetros de ajuste fino.
-
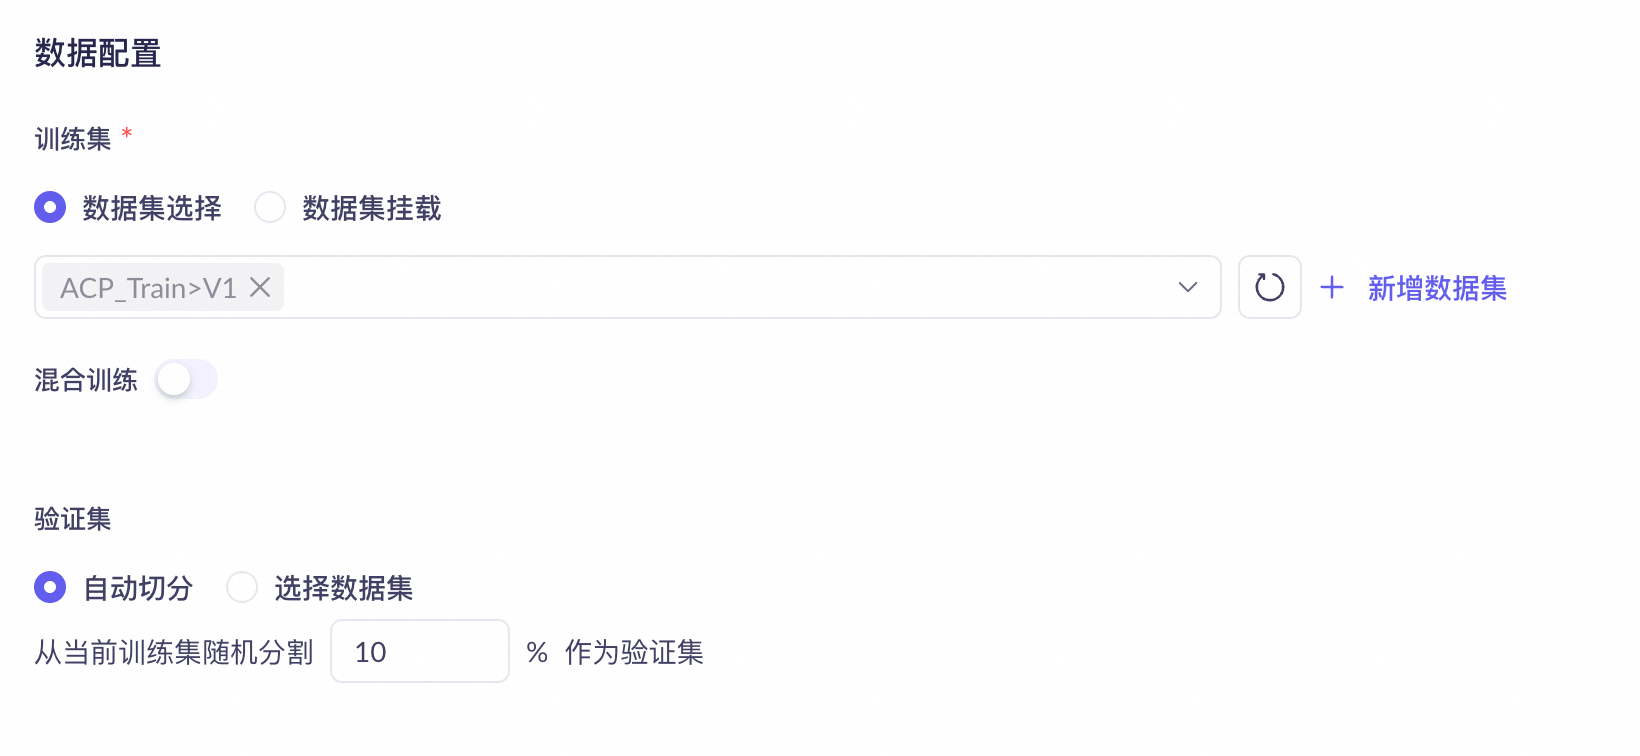
En la sección Data Configuration, complete la siguiente configuración:
- Conjunto de entrenamiento: Seleccione un conjunto de datos de ajuste fino cargado. Muestra de datos: SFT-ChatML_format_example.jsonl.
- Entrenamiento mixto: Manténgalo desactivado.
- Validation Set: Seleccione Automatic Split para dividir 10% del conjunto de entrenamiento como conjunto de validación.
-
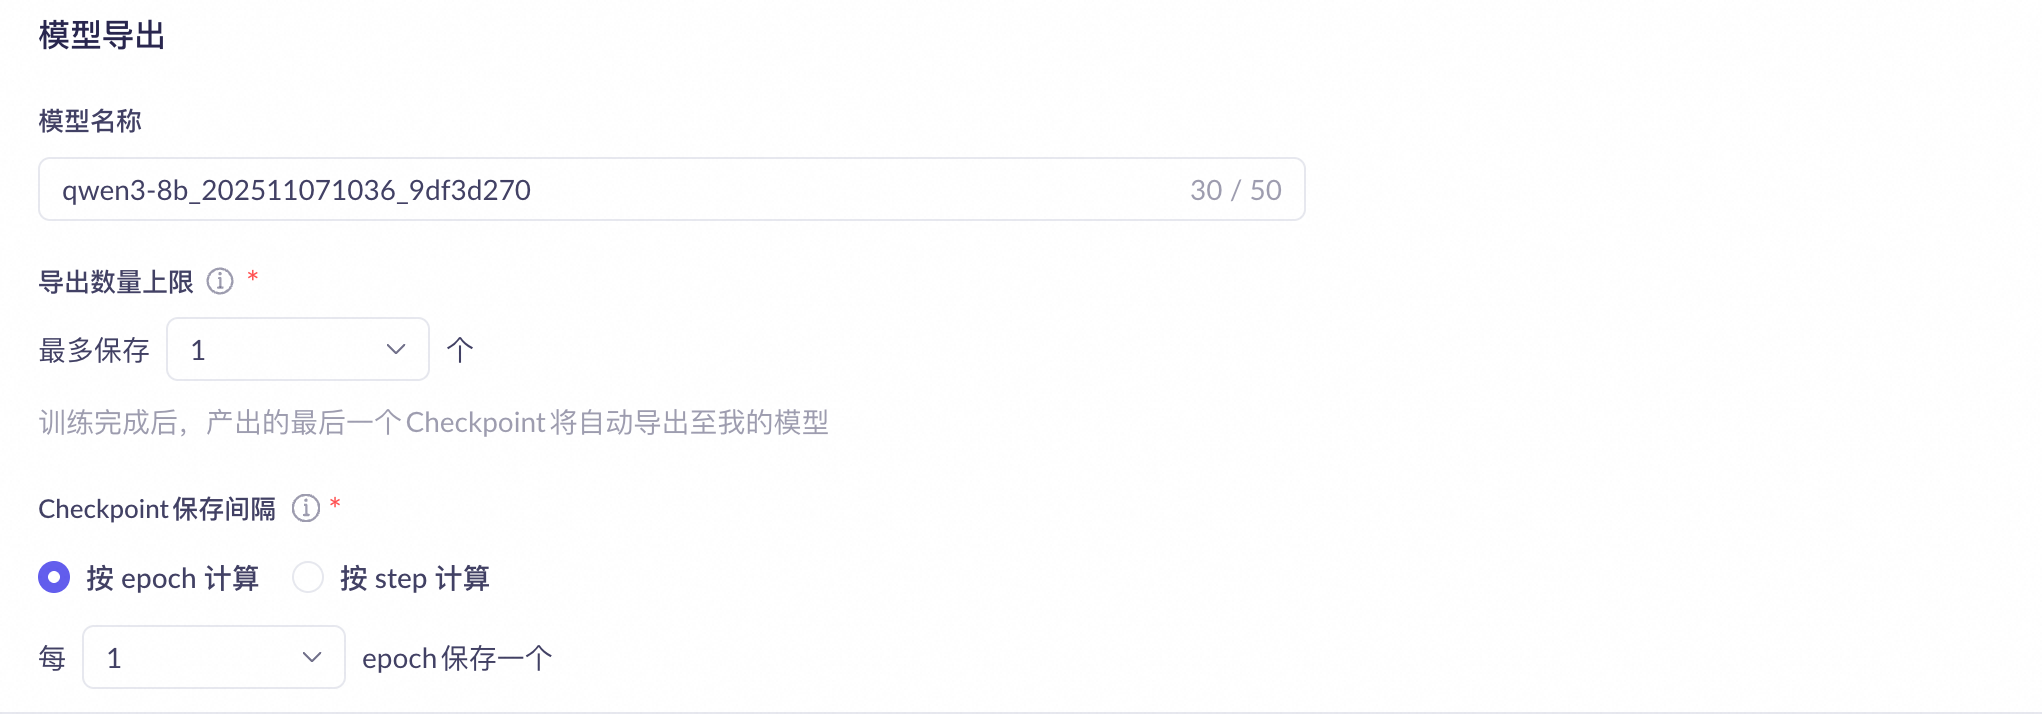
En la sección Salida de entrenamiento, configure cómo se guardan las instantáneas de parámetros del modelo (puntos de control). Mantenga los valores predeterminados para las siguientes configuraciones:
- Nombre del modelo: Una vez completado el entrenamiento, el último punto de control se publica automáticamente en My Models con este nombre.
- Hasta: Establece el número de modelos que exporta finalmente la tarea de entrenamiento.
- Intervalo de guardado de puntos de control: Puede seleccionar Calculated by epoch o Calculated by step.
NotaUna vez completado el ajuste fino, debe exportar una instantánea de parámetros antes de poder implementar el modelo en Model Studio basándose en dicha instantánea. Las instantáneas de parámetros exportadas se guardan en almacenamiento en la nube y no se pueden acceder ni descargar.
-
Haga clic en Start Training y espere a que finalice el entrenamiento del modelo.
-
Elija Model Inference > Dedicated Deployment para implementar el modelo personalizado entrenado. Una vez completada la implementación, puede evaluar el modelo ajustado. Para obtener más información, consulte Introducción a la implementación dedicada.
Proceso típico de ajuste fino
Los tres métodos de ajuste fino proporcionados por Model Studio no son mutuamente excluyentes, sino progresivos y complementarios.
CPT (optional) → SFT → DPO (optional)
-
CPT (preentrenamiento continuo): Complementa el conocimiento (los modelos generales tienen un conocimiento amplio pero superficial, que podría no cumplir con los requisitos de profundidad y precisión de los campos profesionales).
- Modelo financiero:
Learns financial terms - Modelo médico:
Memorizes drug pathology - Modelo legal:
Understands legal articles and precedents
- Modelo financiero:
-
SFT (ajuste fino supervisado) - Aprende cómo realizar tareas
- Bot de servicio al cliente:
Learns customer service procedures - Asistente de código:
Learns programming paradigms - Llamada a herramientas (Agente):
Learns to use MCP
- Bot de servicio al cliente:
-
DPO (optimización directa de preferencias) - Realiza tareas mejor
- Seguridad y responsabilidad:
Rejects harmful suggestions - Concisión y eficacia:
Provides concise answers - Objetividad y neutralidad:
Evaluates fairly and objectively
- Seguridad y responsabilidad:
Formato de datos de ajuste fino
Conjunto de entrenamiento SFT
Los datos de entrenamiento en formato SFT ChatML (Chat Markup Language) admiten conversaciones de múltiples turnos y varias configuraciones de roles.
Los parámetros
nameyweightde OpenAI no son compatibles. Se entrenarán todas las salidas del asistente.
# A single line of training data (in JSON format) has the following typical structure when expanded:
{"messages": [
  {"role": "system", "content": "System input 1"},
  {"role": "user", "content": "User input 1"},
  {"role": "assistant", "content": "Expected model output 1"},
  {"role": "user", "content": "User input 2"},
  {"role": "assistant", "content": "Expected model output 2"}
  ...
]}
Para obtener información sobre las diferencias entre system, user y assistant, consulte Descripción general. Conjuntos de datos de entrenamiento de ejemplo: SFT-ChatML_format_example.jsonl, SFT-ChatML_format_example.xlsx. Los formatos XLS y XLSX solo admiten conversaciones de un solo turno.
Todas las líneas del asistente en una sola entrada de datos de entrenamiento admiten el parámetro "loss_weight", que establece la importancia relativa de esa línea durante el entrenamiento. (Rango: de 0.0 a 1.0. Un valor mayor indica mayor importancia.)
Este parámetro está disponible en vista previa por invitación. Para utilizarlo, póngase en contacto con su gerente de cuenta.
 {"role": "assistant", "content": "Expected model output 1", "loss_weight": 1.0},
 {"role": "assistant", "content": "Expected model output 2", "loss_weight": 0.5}
Consejos para la creación de conjuntos de datos
Requisitos de tamaño del conjunto de datos
Para CPT, el conjunto de datos requiere al menos 50 millones de tokens de datos de preentrenamiento de alta calidad. Para SFT, el conjunto de datos requiere al menos 1,000 entradas de datos de ajuste fino de alta calidad. Para DPO, el conjunto de datos generalmente requiere cientos de entradas de datos de preferencia humana. Si los resultados de la evaluación del modelo después del ajuste fino de datos no son satisfactorios, la forma más sencilla de mejorar es recopilar más datos para el entrenamiento.
Si carece de datos, recomendamos construir una aplicación de agente y utilizar un índice de base de conocimientos para mejorar las capacidades del modelo. En muchos escenarios empresariales complejos, también puede utilizar una combinación de ajuste fino del modelo y recuperación de base de conocimientos.
Por ejemplo, en un escenario de atención al cliente, puede utilizar el ajuste fino del modelo para abordar problemas relacionados con el tono, los estilos de expresión y la autoconciencia del agente de servicio al cliente. El conocimiento profesional relacionado con el escenario se puede introducir dinámicamente en el contexto del modelo mediante una base de conocimientos.
Alibaba Cloud Model Studio recomienda que primero construya y pruebe una aplicación de generación aumentada por recuperación (RAG). Después de recopilar suficientes datos de la aplicación, puede utilizar el ajuste fino del modelo para mejorar aún más su rendimiento.
También puede utilizar las siguientes estrategias para ampliar su conjunto de datos:
- Utilice un modelo de lenguaje grande (LLM) para simular la generación de contenido para escenarios empresariales específicos y ayudarle a generar más datos para el ajuste fino. (Recomendamos seleccionar un modelo más grande y de alto rendimiento para la generación.)
- Adquiera más datos a través de diversos métodos, como la recopilación desde escenarios de aplicación, rastreo web, redes sociales y foros en línea, conjuntos de datos públicos, socios y recursos de la industria, y contribuciones de usuarios.
Diversidad y equilibrio de datos
Los requisitos para el ajuste fino del modelo varían según el escenario. Por ejemplo, la especialización es crítica para escenarios empresariales específicos, mientras que la versatilidad es más importante para escenarios de preguntas y respuestas. Debe diseñar casos de uso de datos basándose en los módulos empresariales o escenarios de uso de los que el modelo es responsable. Por lo tanto, la eficacia del entrenamiento depende no solo del volumen de datos, sino también de la especialización y diversidad de los datos para el escenario específico.
Por ejemplo, en un escenario de conversación inteligente con IA, un conjunto de datos profesional y diverso debe incluir los siguientes escenarios empresariales:
Negocio específico | Escenarios/negocios diversos |
|---|---|
Servicio al cliente de comercio electrónico | Envío de promociones, consulta preventa, orientación durante la venta, servicio posventa, seguimiento posventa, gestión de quejas, etc. |
Servicios financieros | Consulta de préstamos, asesoramiento en inversiones y gestión patrimonial, servicios de tarjetas de crédito, gestión de cuentas bancarias, etc. |
Atención médica en línea | Consulta de síntomas, registro de citas, instrucciones de visita, consulta de información sobre medicamentos, consejos de salud, etc. |
Secretario de IA | Información de TI, información administrativa, información de recursos humanos, consultas sobre beneficios para empleados, consultas del calendario de la empresa, etc. |
Asistente de viajes | Planificación de viajes, guías de entrada y salida, consulta de seguros de viaje, introducciones a las costumbres y cultura del destino, etc. |
Asesor legal corporativo | Revisión de contratos, protección de propiedad intelectual, verificaciones de cumplimiento, preguntas y respuestas sobre derecho laboral, consulta de transacciones transfronterizas, análisis legal de casos individuales, etc. |
También es importante tener en cuenta que la cantidad de datos para cada escenario o negocio debe ser relativamente equilibrada, y la proporción de datos debe coincidir con la proporción real del escenario. Esto evita tener demasiados datos de un solo tipo, lo cual podría causar que el modelo se sesgue hacia el aprendizaje de esas características y afecte su capacidad de generalización.
División de los conjuntos de entrenamiento y validación
Puede realizar el ajuste fino del modelo en la consola.
- Dividir automáticamente un conjunto de datos de entrenamiento completo y muestrear aleatoriamente una pequeña cantidad de datos para formar un conjunto de validación.
- Elija cargar un conjunto de datos por separado.
La consola muestra la pérdida del conjunto de validación y la precisión de tokens en tiempo real durante el entrenamiento.
La página Configuración de datos también incluye un interruptor de Entrenamiento mixto (desactivado por defecto). Cuando se selecciona División automática, 10% del conjunto de entrenamiento se divide aleatoriamente como conjunto de validación por defecto.
FAQ
¿Puedo ajustar finamente mi propio modelo?
Model Studio no admite el ajuste fino, la carga de sus propios modelos ni la exportación de modelos descargados.