puede obtener un servicio de inferencia independiente con recursos dedicados mediante el despliegue para satisfacer sus necesidades comerciales de diferentes niveles de rendimiento, como alta concurrencia y baja latencia.
Métodos de facturación
Antes de la implementación, puede ver el costo horario estimado de diferentes modelos en la consola de Dedicated Deployment.
NotaEl método de facturación no se puede cambiar después de crear el servicio. Para cambiarlo, debe desconectar el modelo implementado y luego volver a implementarlo.
Rendimiento aprovisionado (PTU, Unidad de rendimiento aprovisionado) (Alto rendimiento; alto desempeño) | Unidad de modelo (Métricas de rendimiento personalizadas; aislamiento de recursos) | Uso basado en tokens (Pago por uso después del ajuste fino/validación del efecto) | |||
|---|---|---|---|---|---|
Definición | Un método de implementación de modelos que reserva recursos de la plataforma para garantizar una capacidad de rendimiento TPM específica; sin limitación de tasa dentro de la cuota garantizada. | Un método de implementación de modelos que configura la potencia de cómputo según la duración de uso y el número de unidades de modelo, con recursos dedicados. | Un método de implementación de modelos que utiliza los tokens de entrada y los tokens de salida generados por llamada como base para la medición del uso. | ||
Ventajas |
|
| Sin cargo cuando no está en uso. | ||
Modelos compatibles | Algunos modelos preconfigurados | Algunos modelos preconfigurados y todos los modelos ajustados finamente | Algunos modelos ajustados finamente con LoRA | ||
Casos de uso |
|
| Validación del efecto del modelo ajustado finamente | ||
Diagrama de facturación |
|
|
| ||
Método de facturación | Por duración de uso y rendimiento aprovisionado Pago por uso, paquete diario | Por duración de uso y número de unidades de modelo Pago por uso, paquete mensual | Por uso de tokens del modelo Pago por uso | ||
Método de escalado | Aumento/disminución de autoservicio del rendimiento | Aumento/disminución de autoservicio de unidades de modelo | Envíe una solicitud en la consola y espere la revisión manual. | ||
Restricciones del producto |
| Después de una compra prepago, si cancela anticipadamente dentro del primer mes, el precio unitario diario (≈ precio unitario mensual / 30) se facturará a 1.2 veces |
| ||
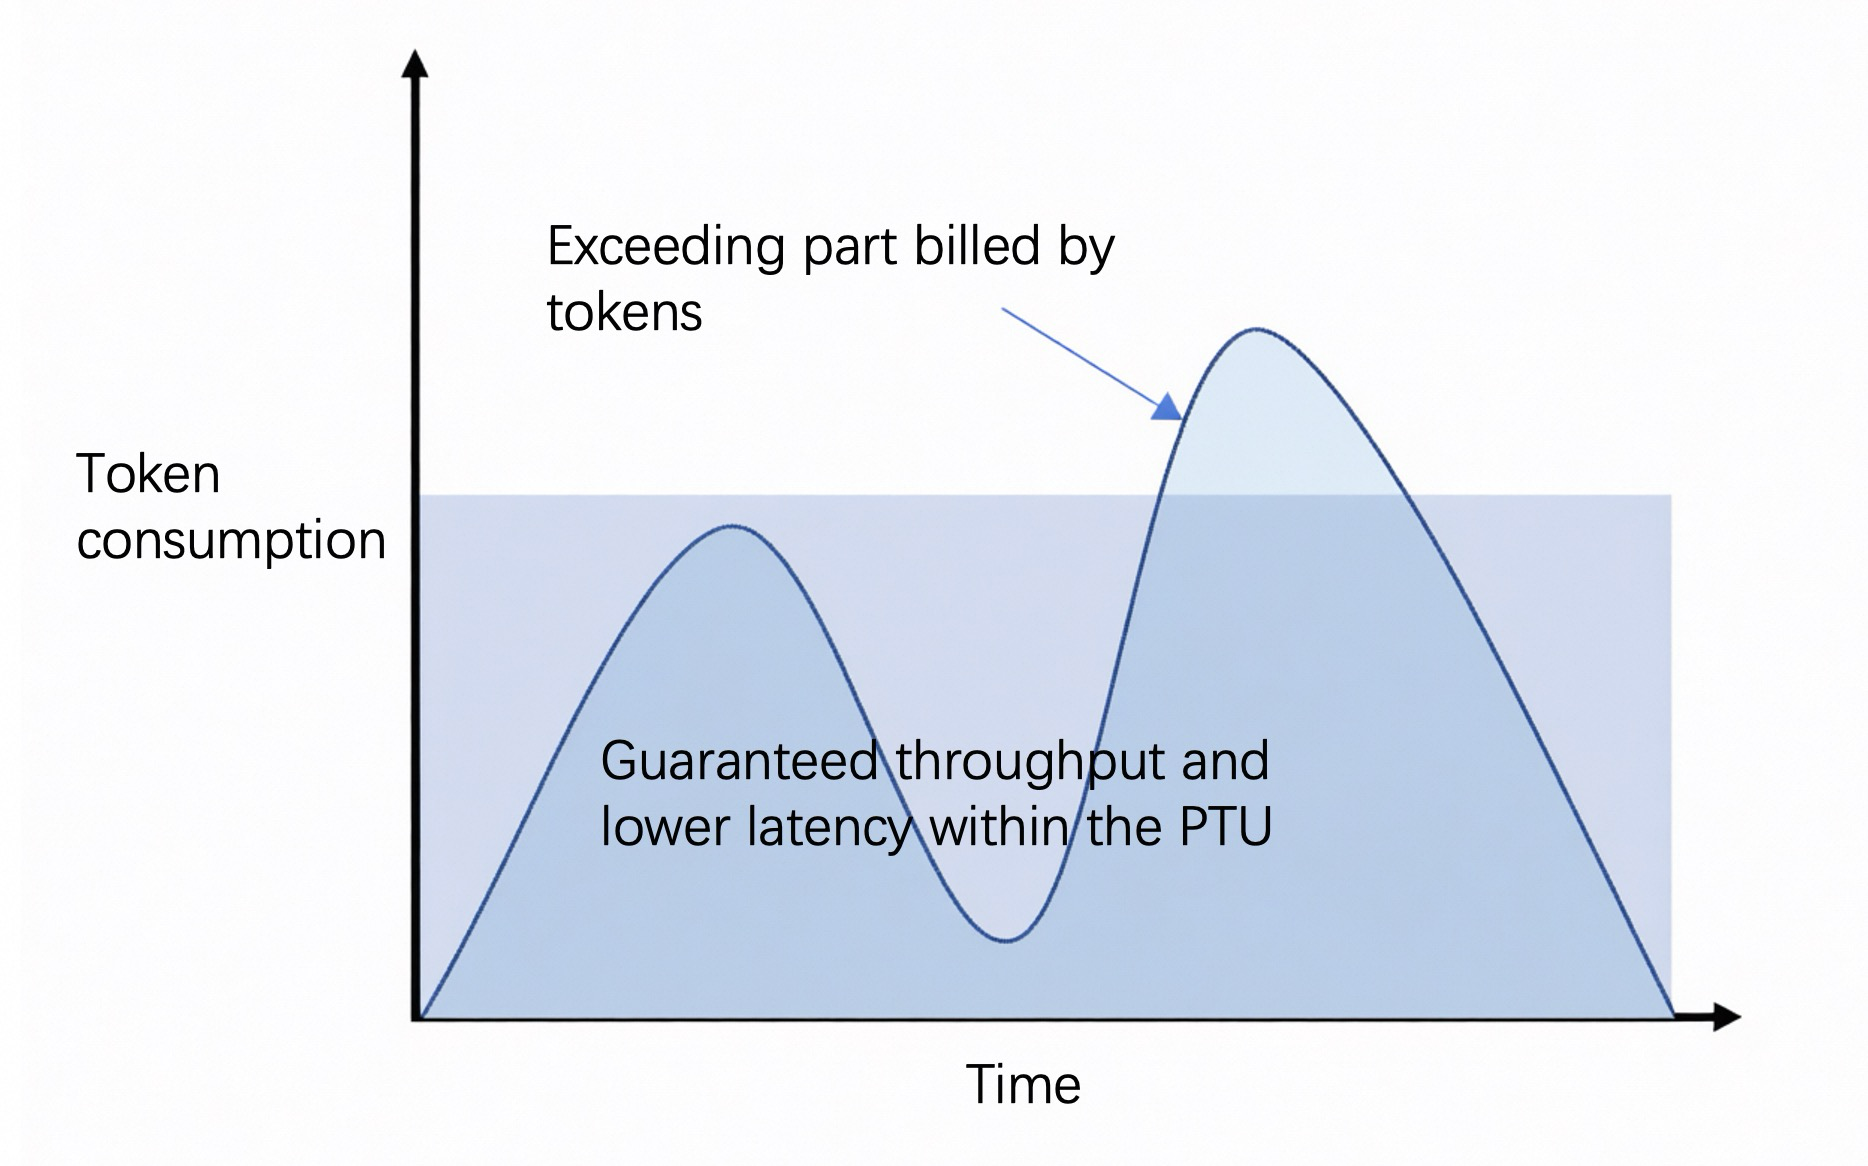
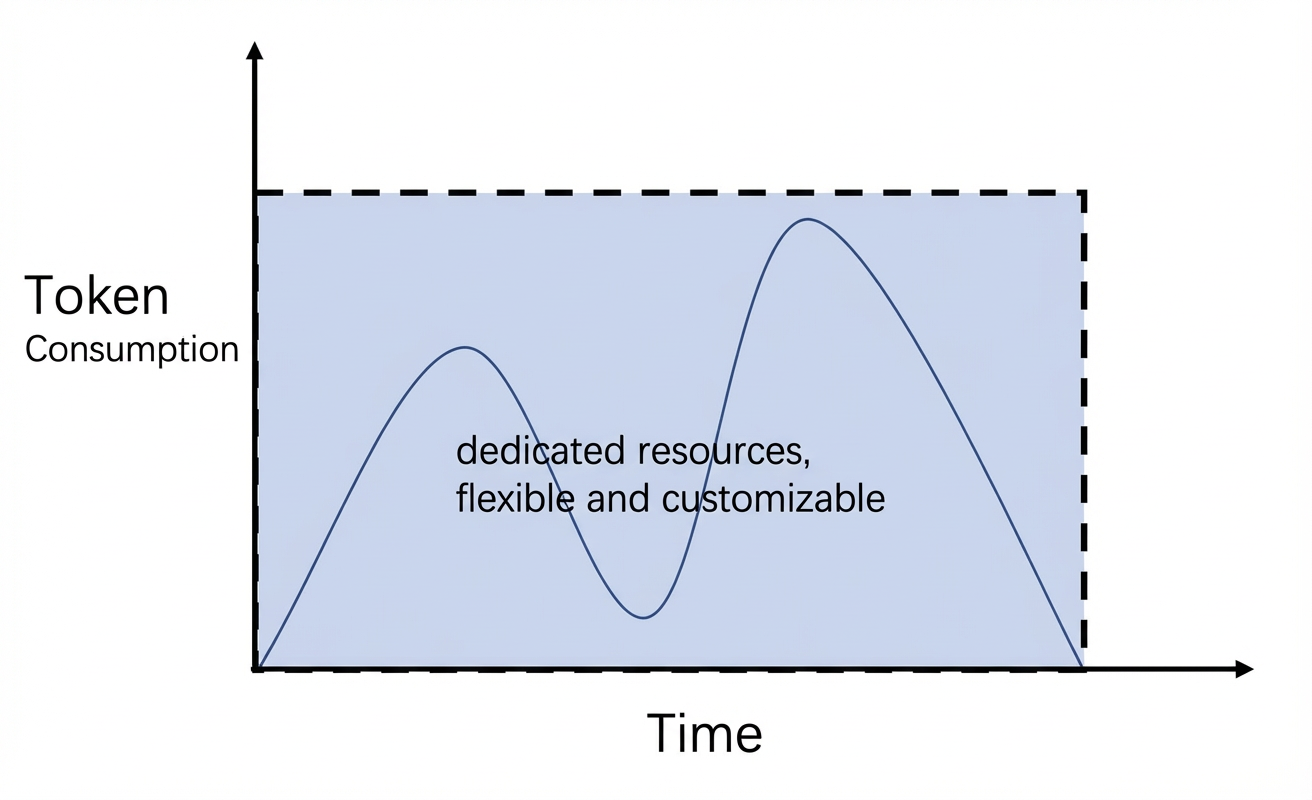
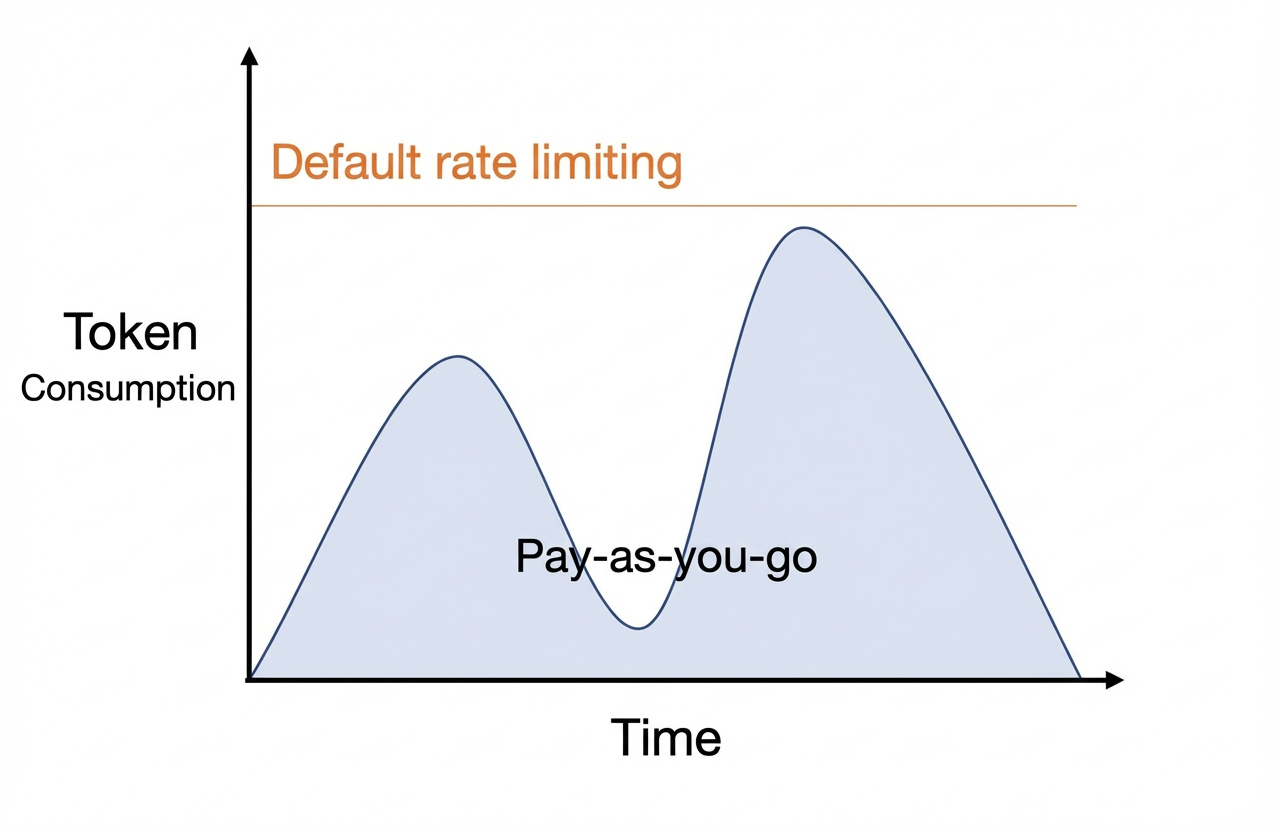
Para ver las estadísticas históricas de uso de tokens y recuento de llamadas de cada llamada, vaya a: Model Monitoring.
DTU es el sucesor de Model Unit (MU): la granularidad de medición cambia del recuento de unidades a TPM de entrada/salida. Para nuevas compras de despliegue dedicado, se recomienda DTU. Consulte Despliegue de cómputo dedicado.
Modos de implementación
Para ver los modelos compatibles y los precios de cada modo de implementación, consulte las páginas correspondientes a cada modo:
NotaAhora se admite la creación y gestión de Provisioned Throughput Units (PTU) en la página de Reserva de rendimiento, que ofrece funciones de gestión de capacidad más completas, como paquetes de capacidad acumulables. Para obtener más información, consulte Reserva de rendimiento.
- Implementación de rendimiento aprovisionado PTU
- Implementación de cómputo dedicado
- Implementación de pago por uso con tokens
- Importación de modelos
Métodos de implementación
Puede implementar modelos en la consola. Consulte los siguientes pasos:
Si recibe un aviso de permisos insuficientes, consulte la sección de solución de problemas de permisos en la guía de implementación de API.
-
Inicie sesión en la consola de Model Studio. En el panel de navegación izquierdo, seleccione Model Inference > Dedicated Deployment.
-
Haga clic en Deploy New Model.
-
Ingrese un Nombre del servicio, complete Seleccionar modelo y Billing Method, mantenga las demás configuraciones predeterminadas y haga clic en Confirm.
Debe completar el ajuste fino del modelo antes de poder implementar la mayoría de los modelos.
-
Regrese a la lista de implementaciones. Cuando el estado de la implementación cambie a En ejecución, el modelo se habrá implementado correctamente.
ImportanteSe generan cargos después de que el modelo se implementa correctamente.
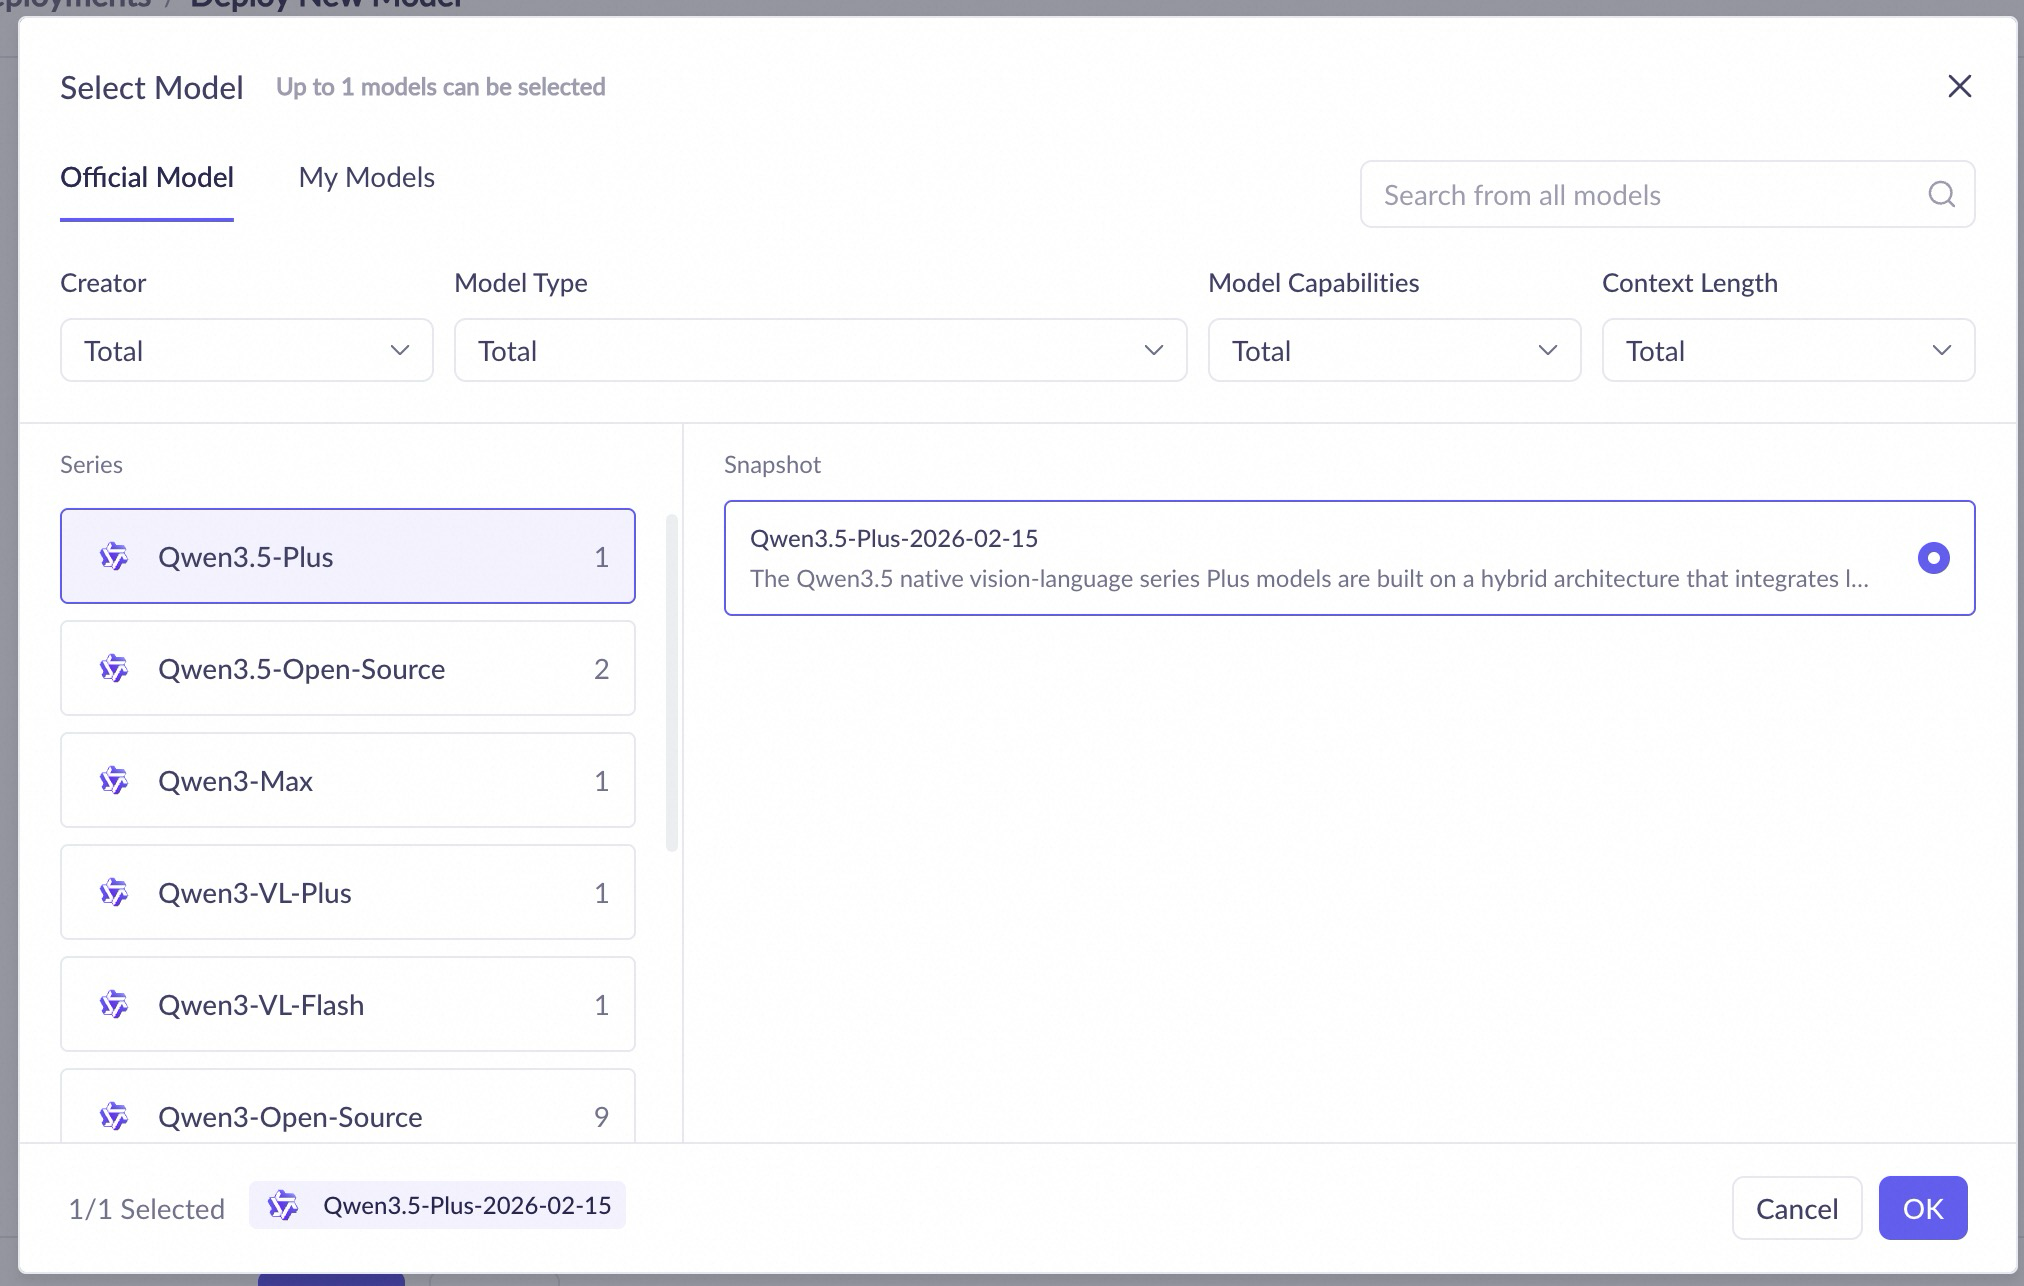
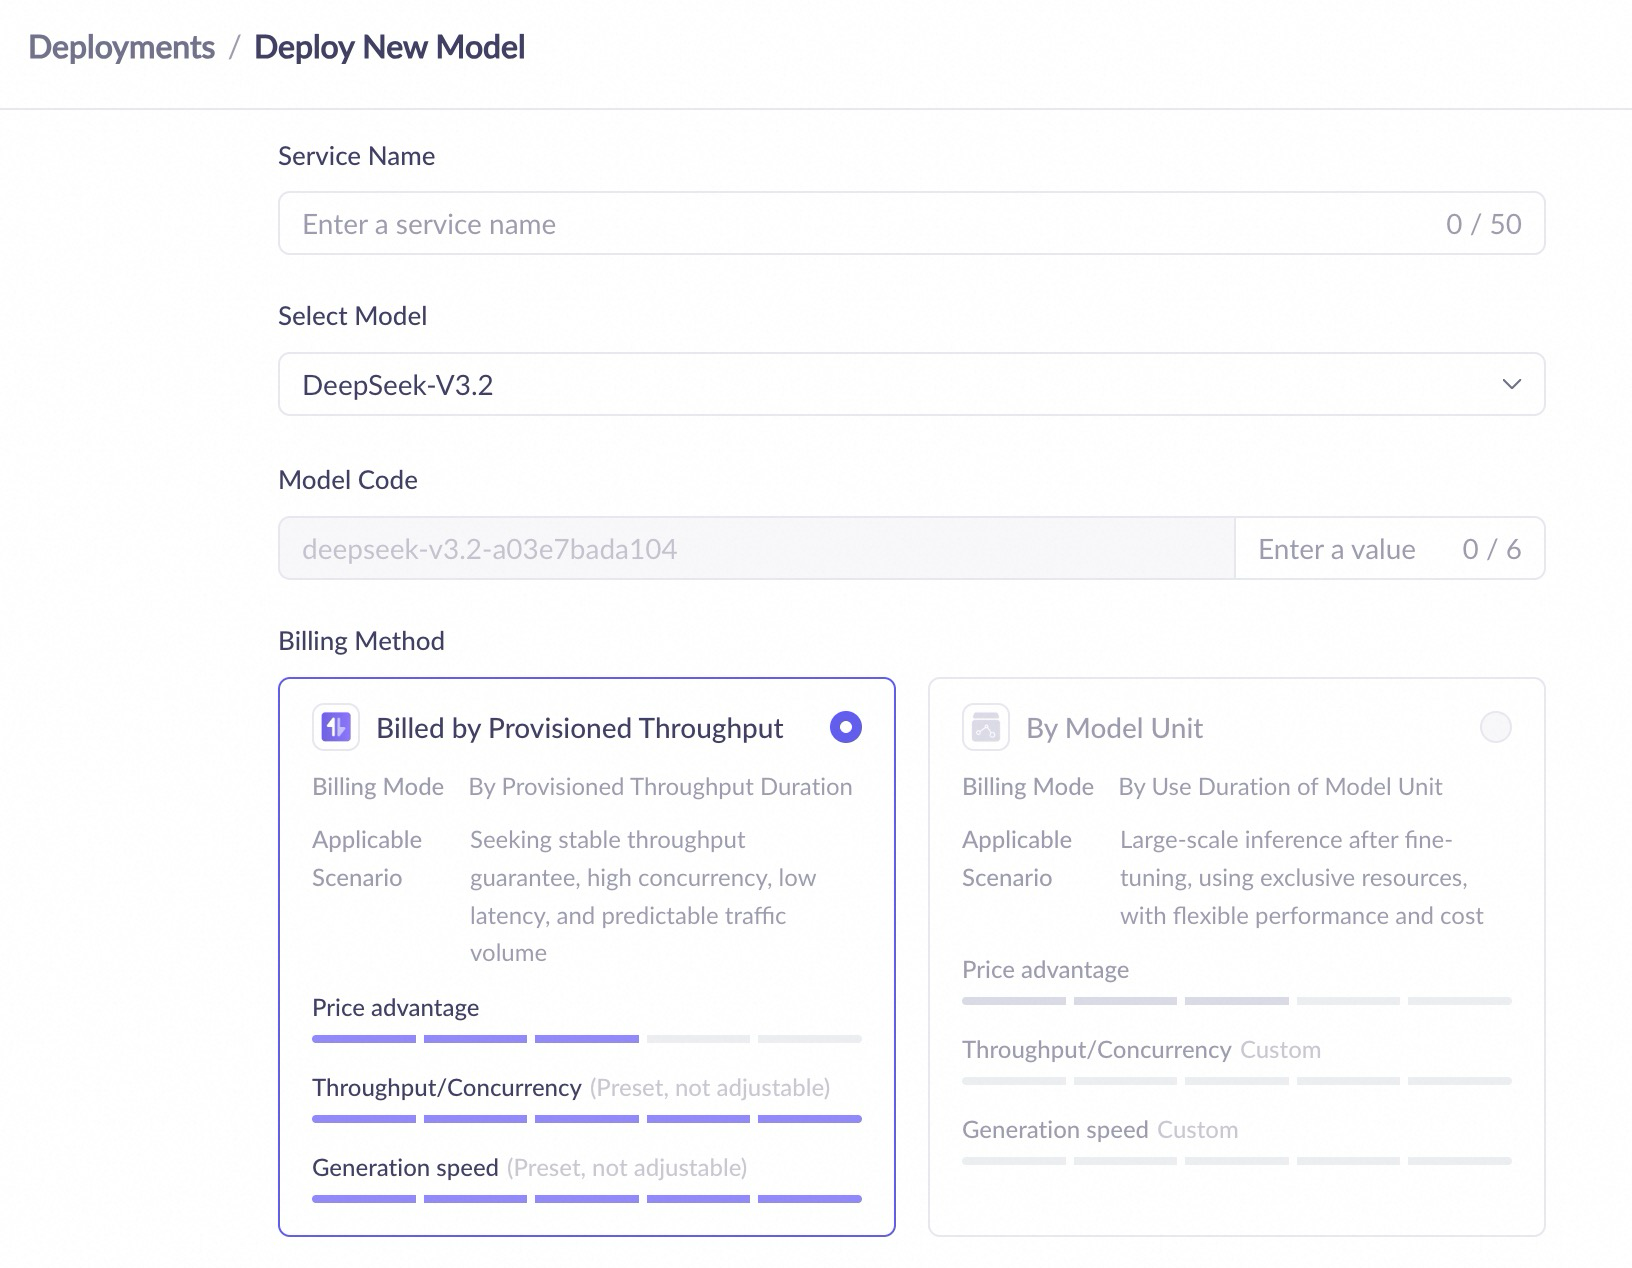
Para obtener detalles sobre los parámetros de configuración del despliegue (nombre del servicio, modelo, tipo de unidad de modelo, número de réplicas, modo de inferencia, contexto máximo, limitación de velocidad, etc.), consulte Despliegue de cómputo dedicado y la Guía de despliegue de API.
Página de lista de implementaciones
Después de una implementación exitosa, puede ver y administrar todos los servicios de implementación en la página de lista de implementaciones. La página de lista contiene la siguiente información:
- Nombre del servicio: El nombre del servicio de implementación. Haga clic para ver los detalles de la implementación.
- Nombre del modelo: El modelo utilizado para la implementación.
- Código del modelo: El identificador único generado después de implementar correctamente el modelo, utilizado para especificar el modelo al llamar a la API.
- Estado del despliegue/Estado del evento: Incluye Despliegue pendiente, Desplegando, En ejecución, Error de despliegue, Poniéndose fuera de línea, Servicio pausado, Detenido, Eliminando, Suscripción suspendida/Suspendido por pago vencido, Reanudando servicio, En ejecución (Cambiando configuración), En ejecución (Error de cambio) y otros estados.
- Método de facturación: El método de facturación del servicio de implementación actual.
- Detalles de la implementación: Información de configuración como el tipo de unidad de modelo y el recuento de réplicas.
- Detalles de limitación: Muestra la configuración de limitación del servicio de implementación actual, como RPM (solicitudes por minuto) y TPM (tokens por minuto).
- Tiempo de servicio: Muestra la hora de creación y la hora de vencimiento del servicio de implementación.
- Operación: Dependiendo del estado del despliegue y del método de facturación, puede realizar operaciones como Actualizar, Monitorear, Escalar, Renovar, Poner fuera de línea, Eliminar y Probar; las instancias de Provisioned Throughput Unit (PTU) también admiten la adición de paquetes de capacidad en la página de Reserva de rendimiento.
Para conocer los métodos de llamada a la API después de una implementación exitosa (DashScope / interfaz compatible con OpenAI / Assistant SDK), consulte la guía de implementación de API.
Para las operaciones de escalado de cada método de facturación (ajuste manual de rendimiento/unidades de modelo, solicitud de ampliación de tokens, políticas de autoescalado), consulte las páginas del modo correspondiente: Despliegue de rendimiento aprovisionado PTU, Despliegue de cómputo dedicado, Despliegue de pago por uso de tokens.
Desconectar un servicio de implementación
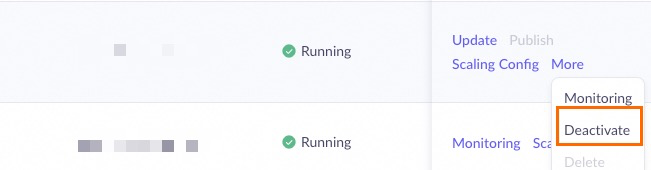
Vaya a la consola de Dedicated Deployment, busque el servicio de implementación que want detener y haga clic en la operación correspondiente según el tipo de facturación:
- Unidad de modelo prepago: Haga clic en Deactivate y confirme.
- Pospago: Haga clic en Delete y confirme.
No se incurrirá en más facturación después de completar la operación.
FAQ
¿Puedo cargar e implementar mis propios modelos?
Puede importar algunos modelos de código abierto en la consola My Models (Beijing); para consultar la lista detallada de modelos compatibles, consulte: Importación de modelos.
Además, Alibaba Cloud Artificial Intelligence Platform PAI ofrece la capacidad de desplegar sus propios modelos. Puede consultar Despliegue de modelos de lenguaje grande PAI-LLM para obtener información sobre el método de despliegue.
¿Cómo cambio a otros métodos de facturación?
Solo puede liberar los recursos originales y luego crear nuevos recursos utilizando el método de facturación deseado.
Se recomienda cambiar siguiendo estos pasos:
- Implemente nuevos recursos utilizando el método de facturación deseado.
- Cambiar la API y probar la disponibilidad del servicio.
- Desconectar y liberar los recursos originales.