Para escenarios de inferencia que no requieren respuestas en tiempo real, la inferencia por lotes procesa de forma asíncrona grandes volúmenes de solicitudes de datos al 50% del costo de la inferencia en tiempo real. Su API compatible con OpenAI es ideal para trabajos por lotes como la evaluación de modelos y el etiquetado de datos.
Funcionamiento
- Enviar una tarea: Cargue un archivo JSONL que contenga múltiples solicitudes para crear una tarea de inferencia por lotes.
- Procesamiento asíncrono: El sistema procesa las tareas en una cola en segundo plano. Puede monitorear el progreso y el estado de la tarea en la consola o mediante la API.
- Descargar resultados: Una vez completada la tarea, el sistema genera un archivo de resultados para las respuestas exitosas y un archivo de errores que detalla cualquier fallo.
Ámbito
Singapore
Modelos compatibles: qwen3.7-plus, qwen-max, qwen-plus, qwen-flash
China (Beijing)
Modelos compatibles:
-
Modelos de generación de texto
- Qwen-Max: qwen3.8-max, qwen3.7-max, qwen-max, qwen-max-latest
- Qwen-Plus: qwen3.7-plus, qwen3.6-plus, qwen3.5-plus, qwen-plus, qwen-plus-latest
- Qwen-Flash: qwen3.8-flash, qwen3.7-flash, qwen3.6-flash, qwen3.5-flash, qwen-flash
- Modelos recomendados: qwen3.8-max
-
Modelos multimodales
- Comprensión de imágenes y videos: qwen3.8-max, qwen3.8-flash, qwen3.7-plus, qwen3.6-plus, qwen3.7-flash, qwen3.6-flash, qwen3.5-plus, qwen3.5-flash, qwen3-vl-plus
- Extracción de texto: qwen-vl-ocr
- Omni-modal: qwen3.5-omni-plus, qwen3.5-omni-flash
-
Modelos de incrustación de texto: text-embedding-v4
Importante
- En el escenario de procesamiento por lotes, el máximo de tokens de contexto por solicitud es de 256 K para
qwen3.8-max,qwen3.8-flash,qwen3.7-max,qwen3.7-plus,qwen3.6-plus,qwen3.7-flash,qwen3.6-flash,qwen3.5-plus,qwen3.5-flash,qwen3.5-omni-flashyqwen3.5-omni-plus.qwen3.5-omni-plusyqwen3.5-omni-flashno admiten salida de voz. - Algunos modelos admiten el modo de pensamiento. Activar este modo genera
tokensde pensamiento y aumenta los costos. - Los modelos de las series
qwen3.8,qwen3.7,qwen3.6yqwen3.5tienen el modo de pensamiento activado de forma predeterminada. Si utiliza un modelo de pensamiento híbrido, debe configurar explícitamente el parámetroenable_thinking. Configure este parámetro entruepara activar el modo o enfalsepara desactivarlo. - En el cuerpo de la solicitud JSONL,
enable_thinkinges un parámetro de nivel superior debodyy debe colocarse al mismo nivel quemodel. No lo coloque dentro deextra_body.
Uso de inferencia por lotes
Paso 1: Preparar el archivo de entrada
Antes de crear una tarea, prepare un archivo JSONL que cumpla con los siguientes requisitos:
-
Formato: JSONL codificado en UTF-8 (un objeto JSON por línea).
-
Límites de escala: Hasta 50,000 solicitudes por archivo y un tamaño máximo de archivo de 500 MB.
Si su conjunto de datos supera estos límites, divídalo en varios archivos y envíelos como tareas separadas.
-
Límite por línea: Cada objeto JSON puede tener hasta 1 MB y no debe exceder la ventana de contexto del modelo.
-
Consistencia: Todas las solicitudes dentro del mismo archivo deben utilizar el mismo modelo.
-
Identificador único: Cada solicitud debe incluir un campo
custom_idque sea único dentro del archivo para la coincidencia de resultados. El custom_id admite un máximo de 256 caracteres. Si se excede este límite, la validación de la tarea falla. Para devolver un identificador más largo, utilice un campo personalizado en el parámetrometadataal crear la tarea. Para más información, consulte Usar metadatos para devolver identificadores personalizados. -
URL de archivos multimedia: Los archivos multimedia a los que se hace referencia en el
bodyde una solicitud multimodal a través de campos comoimage_urlyvideo_urldeben utilizar URL accesibles públicamente. No se admiten rutas de archivos locales (por ejemplo,file:///home/user/test.mp4) ni direcciones de red interna. Una tarea que haga referencia a dicha dirección se puede enviar correctamente, pero nunca se procesará hasta completarse. Cargue primero el archivo en un almacenamiento accesible públicamente y luego haga referencia a su URL.
Cada objeto JSON debe cumplir con el siguiente esquema:
Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
| string | Sí | Un identificador único para la solicitud dentro del archivo. |
| string | Sí | El método HTTP admitido es |
| string | Sí | Solo se admite el endpoint de solicitud |
| object | Sí | El cuerpo de la solicitud tiene el mismo formato que la API |
Archivo de muestra
Puede descargar el archivo de ejemplo test_model.jsonl. El contenido es el siguiente:
{"custom_id":"1","method":"POST","url":"/v1/chat/completions","body":{"model":"qwen-max","messages":[{"role":"system","content":"You are a helpful assistant."},{"role":"user","content":"Hello!"}]}}
{"custom_id":"2","method":"POST","url":"/v1/chat/completions","body":{"model":"qwen-max","messages":[{"role":"system","content":"You are a helpful assistant."},{"role":"user","content":"What is 2+2?"}]}}
Utilice esta herramienta para generar rápidamente archivos JSONL.
Configurar el modo de pensamiento en la inferencia por lotes
Algunos modelos, como qwen3.7-plus, qwen3.7-max y las series qwen3.6 y qwen3.5, tienen el modo de pensamiento activado de forma predeterminada, lo que genera tokens de pensamiento adicionales. Para configurar el modo de pensamiento para la inferencia por lotes, establezca el parámetro enable_thinking al mismo nivel que el parámetro model dentro del body de cada solicitud. El parámetro opcional thinking_budget se puede utilizar para establecer un límite superior en el número de tokens de pensamiento.
ImportanteLos parámetros enable_thinking y thinking_budget deben colocarse directamente en el nivel superior del body, al mismo nivel que model. No los coloque en extra_body. El parámetro extra_body es un mecanismo para pasar parámetros no estándar con el SDK de Python de OpenAI; solo es efectivo para llamadas de inferencia en tiempo real y no se aplica a los archivos de inferencia por lotes.
Ejemplo: Desactivar el modo de pensamiento
{"custom_id":"request-1","method":"POST","url":"/v1/chat/completions","body":{"model":"qwen3.5-plus","enable_thinking":false,"messages":[{"role":"user","content":"Hello"}]}}
Ejemplo: Activar el modo de pensamiento y limitar el presupuesto de tokens de pensamiento
{"custom_id":"request-2","method":"POST","url":"/v1/chat/completions","body":{"model":"qwen3.5-plus","enable_thinking":true,"thinking_budget":50,"messages":[{"role":"user","content":"Please analyze the following question"}]}}
Paso 2: Crear una tarea de inferencia por lotes
-
En la página Batch Inference, haga clic en Create Batch.
-
En el cuadro de diálogo que aparece, ingrese un Nombre de la tarea y una Descripción de la tarea, configure el Tiempo máximo de espera (de 1 a 14 días) y cargue su archivo JSONL.
Puede hacer clic en Download Sample File para obtener la plantilla.
-
Cuando termine, haga clic en Confirm.
Paso 3: Monitorear y administrar tareas
-
Ver:
- En la página de lista de tareas, vea el progreso de la tarea (solicitudes procesadas/total de solicitudes) y el Estado.
- Busque por nombre o ID de tarea, o filtre por espacio de trabajo para localizar rápidamente una tarea específica.
-
Administrar:
-
Cancelar: Puede cancelar tareas que se encuentren en estado Ejecutando en la columna Acciones.
-
Solucionar problemas: Para una tarea fallida, pase el cursor sobre el estado para ver un resumen de errores o descargue el archivo de errores para obtener más detalles.
Por ejemplo, si hay diferentes modelos mezclados en el archivo por lotes
-
Paso 4: Descargar resultados
ImportanteLas tareas se eliminan automáticamente 30 días después de su finalización. Descargue sus resultados a la brevedad.
Cuando la tarea esté completa, haga clic en View Results para descargar el archivo de salida:
- Archivo de resultados: Registra todas las solicitudes exitosas y sus resultados de
response. - Archivo de errores (si corresponde): Registra todas las solicitudes fallidas y sus detalles de
error.
Ambos archivos contienen un campo custom_id, que se utiliza para coincidir con los datos de entrada originales, asociar resultados o localizar errores.
Paso 5: Ver estadísticas de uso (opcional)
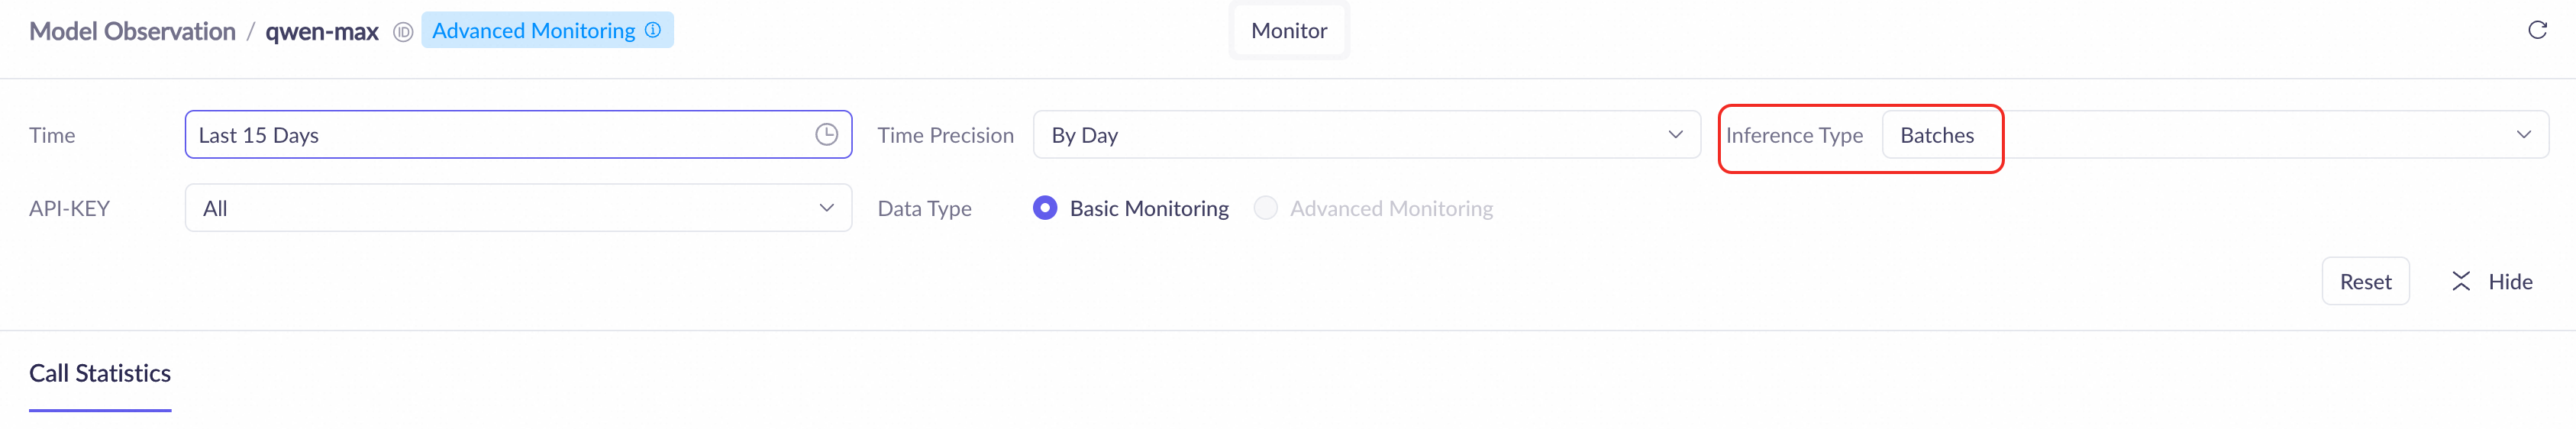
En la página de Monitoreo, puede filtrar y ver estadísticas de uso para la inferencia por lotes.
-
Ver resumen de datos: Seleccione la hora (hasta 30 días), configure Inference Type en Batch Inference, y podrá ver lo siguiente:
- Datos de monitoreo: Estadísticas resumidas para todos los modelos en el período seleccionado, como el número total de llamadas y fallos.
- Lista de modelos: Datos detallados para cada modelo, como total de llamadas, tasa de fallos y duración promedio de llamada.
Para ver datos de inferencia con más de 30 días de antigüedad, vaya a la página de Facturas.
-
Ver detalles del modelo: En la Modelos, haga clic en Monitor en la Actions columna del modelo objetivo para ver Estadísticas de llamadas, como el número de llamadas y el volumen de llamadas.
Importante
- Los datos de llamadas para la inferencia por lotes se registran según la hora de finalización de la tarea. Para las tareas en ejecución, la información de llamadas no se puede consultar hasta que la tarea esté completa.
- Los datos de monitoreo pueden tener un retraso de una a dos horas.
Uso de metadatos para devolver identificadores personalizados
custom_id admite hasta 256 caracteres. Si necesita devolver un identificador más largo en el archivo de resultados, puede usar un campo personalizado en metadata.
Campos de metadatos
metadata es un parámetro opcional para crear una tarea Batch. Admite los siguientes campos:
ds_name: El nombre de la tarea. Este nombre se muestra en la columna Nombre de la tarea de la consola.ds_description: La descripción de la tarea. Esta descripción se muestra en la columna Descripción de la tarea de la consola.- Campos personalizados: Además de los campos oficiales, el objeto
metadatatambién admite cualquier campo personalizado, y sus valores no están limitados a 256 caracteres. Cuando consulta los detalles de la tarea, todos los campos personalizados se devuelven en su totalidad.
Ejemplo de código
El siguiente ejemplo muestra cómo usar un campo personalizado en metadata para devolver un identificador que tenga más de 256 caracteres:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

batch = client.batches.create(
    input_file_id="file-batch-xxxxxxxxxxxxxxxxxxxx",
    endpoint="/v1/chat/completions",
    completion_window="24h",
    metadata={
        "ds_name": "my_batch_task",
        "ds_description": "A description for my batch inference task",
        "my_custom_field": "The value of this field can exceed 256 characters and is used to pass back longer identifier information..."
    }
)
print(batch)
Después de crear una tarea correctamente, puede llamar a la operación GET /v1/batches/{batch_id} para recuperar la información completa de metadata, que incluye todos los campos personalizados y su contenido completo.
Referencia de API
En un entorno de producción, utilice la API compatible con OpenAI para automatizar la creación y gestión de tareas por lotes. El flujo de trabajo principal es el siguiente:
La inferencia por lotes solo admite llamadas a la API compatible con OpenAI. Cuando utilice el SDK de Python de OpenAI, configure base_url en https://dashscope.aliyuncs.com/compatible-mode/v1. El SDK de Python de DashScope (el paquete dashscope) no proporciona ninguna interfaz de inferencia por lotes, por lo que no puede enviar una tarea de inferencia por lotes mediante métodos como dashscope.BatchInference o dashscope.Batches.
Ejemplo:
from openai import OpenAI

client = OpenAI(
    api_key="your-api-key",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
batch = client.batches.create(
    input_file_id=file_id,
    endpoint="/v1/chat/completions",
    completion_window="24h",
)
-
Llame a
POST /v1/filespara cargar un archivo. Registre el ID de archivo que se devuelve. -
Para crear una tarea, pase el ID del archivo, llame a
POST /v1/batchesy registre elbatch_iddevuelto. -
Consultar estado usando
batch_idpara sondearGET /v1/batches/{batch_id}. Cuando elstatuscambie acompleted, registre eloutput_file_idy detenga el sondeo. -
Para descargar el archivo de resultados, use el
output_file_idpara llamar aGET /v1/files/{output_file_id}/content.
Para obtener definiciones completas de la API Batch y ejemplos de código, consulte Compatible con OpenAI - Batch (entrada de archivo).
Ciclo de vida de la tarea
Status | Descripción |
|---|---|
validating | El sistema está validando el formato del archivo (especificación JSONL) y el formato de API de cada solicitud. |
in_progress | El sistema ha validado el archivo y ha comenzado a procesar las solicitudes de inferencia. |
finalizing | Todas las solicitudes han sido procesadas y el sistema está escribiendo los resultados en los archivos de salida. En la consola, esta etapa muestra la misma etiqueta de estado En ejecución que |
completed | Los archivos de resultados y de errores se han generado y están disponibles para su descarga. |
failed | La tarea falló durante la etapa |
expired | El tiempo de ejecución de la tarea excedió el tiempo máximo de espera establecido en la creación y fue terminada por el sistema. Al crear una nueva tarea, considere establecer un tiempo de espera más largo. |
cancelled | La tarea fue cancelada por el usuario. Cualquier solicitud no procesada se termina. En la consola, este estado se muestra como Detenido. |
Facturación
-
Precios: Para todas las solicitudes exitosas, tanto los tokens de entrada como los de salida tienen un precio del 50% del precio de inferencia en tiempo real para el modelo correspondiente. Para más detalles, consulte Modelos y precios.
-
Ámbito de facturación:
- Solo se le facturan las solicitudes ejecutadas correctamente dentro de una tarea.
- Los fallos en el análisis de archivos, los fallos en la ejecución de tareas o los errores de solicitud a nivel de línea no generan cargos.
- Para las tareas canceladas, cualquier solicitud que se haya completado correctamente antes de la cancelación se factura normalmente.
Nota
- La inferencia por lotes es un artículo facturable independiente y admite el Plan de ahorros universal de IA. Sin embargo, no es elegible para otras promociones como planes prepago (Planes de ahorros) y cuotas gratuitas para nuevos usuarios, ni para funciones como caché de contexto.
- Algunos modelos, como qwen3.7-plus, qwen3.7-max y las series qwen3.6 y qwen3.5, tienen el modo de pensamiento activado de forma predeterminada. Esto genera tokens de pensamiento adicionales, que se facturan al precio de tokens de salida, lo que aumenta los costos. Para controlar los costos, configure el parámetro
enable_thinkingsegún la complejidad de la tarea. Para más detalles, consulte Pensamiento profundo.
FAQ
-
¿Necesito comprar o activar algo adicional para usar la inferencia por lotes?
No. La función está disponible después de activar Model Studio. Los cargos se incurren bajo la modalidad de pago por uso y se deducen del saldo de su cuenta.
-
¿Por qué mi tarea falló inmediatamente después de enviarla (el estado cambió a
failed)?Esto suele indicar un error a nivel de archivo y no se ejecutó ninguna solicitud de inferencia. Compruebe lo siguiente en orden:
- Formato de archivo: Verifique que el archivo utilice el formato JSONL estricto, con un objeto JSON completo por línea.
- Escala del archivo: Asegúrese de que el tamaño del archivo y el número de líneas no excedan los límites. Para más detalles, consulte Paso 1: Preparar el archivo de entrada.
- Consistencia del modelo: Verifique que el campo
body.modelsea idéntico para todas las solicitudes en el archivo y que el modelo utilizado sea compatible en la región actual.
-
¿Cuánto tiempo tarda en procesarse una tarea?
El tiempo de procesamiento depende de la carga del sistema cuando se envía la tarea. Durante los períodos de alta demanda, las tareas pueden ponerse en cola. Sin embargo, siempre se devuelve un resultado (éxito o fallo) dentro del tiempo máximo de espera especificado.
Códigos de error
Si una llamada falla y se devuelve un mensaje de error, consulte Códigos de error.