Qwen2.5 Omni: AI ทรงพลังสำหรับข้อมูลหลายรูปแบบ
โดย Farruh

Qwen2.5 Omni ของ Alibaba Cloud: GenAI ผสานกับการรองรับข้อมูลหลายรูปแบบ
ในยุค Generative AI (GenAI) โมเดลภาษาขนาดใหญ่ (Large Language Model หรือ LLM) ไม่ได้จำกัดอยู่แค่ข้อความอีกต่อไป โมเดลที่รองรับข้อมูลหลายรูปแบบอย่าง Qwen2.5 Omni จะอุดช่องโหว่ระหว่างข้อความ รูปภาพ เสียง และวิดีโอ จึงทำให้ AI สามารถคิด มองเห็น รับฟัง และพูดได้เสมือนมนุษย์อย่างเรา
เหตุใดการรองรับข้อมูลหลายรูปแบบจึงสำคัญ
- ความแพร่หลายของข้อมูลหลายรูปแบบ: 90% ของข้อมูลที่ใช้งานบนอินเทอร์เน็ตคือเนื้อหาที่เป็นภาพ/เสียง (เช่น วิดีโอ TikTok, พอดแคสต์)
- การโต้ตอบเสมือนมนุษย์: ผู้ใช้คาดหวังให้ AI ประมวลผลอินพุตผสม (เช่น การสืบค้นรูปภาพ_และ_เสียง)
- ผลกระทบต่ออุตสาหกรรม: ตั้งแต่การวินิจฉัยด้านการดูแลสุขภาพไปจนถึงอีคอมเมิร์ซ AI ที่รองรับข้อมูลหลายรูปแบบกลายเป็นมาตรฐานใหม่
Qwen2.5 Omni: ออกแบบมาเพื่อการรองรับข้อมูลหลายรูปแบบที่ครอบคลุม
- รองรับมากกว่าข้อความ: ขณะที่ LLM อย่าง Qwen2.5-VL มีประสิทธิภาพยอดเยี่ยมในด้านข้อความและรูปภาพ แต่ Qwen2.5 Omni จะเพิ่มการสตรีมเสียง/วิดีโอ ซึ่งเป็นการก้าวไปสู่ AI ที่ตอบโจทย์ประสาทสัมผัสทุกด้าน
- สถาปัตยกรรมรวม: Qwen2.5 Omni ต่างจากเครื่องมือแบบไซโลตรงที่เป็นโมเดลเดี่ยวสำหรับอินพุต/เอาต์พุตในหลากหลายรูปแบบ
ความเข้าใจ Qwen2.5 Omni: ความได้เปรียบทางเทคนิค

ภาพรวมโมดูล Thinker (การประมวลผลข้อความ/เสียง/วิดีโอ) และ Talker (การสร้างเสียงพูด)
นวัตกรรมสำคัญจากรายงานทางเทคนิค
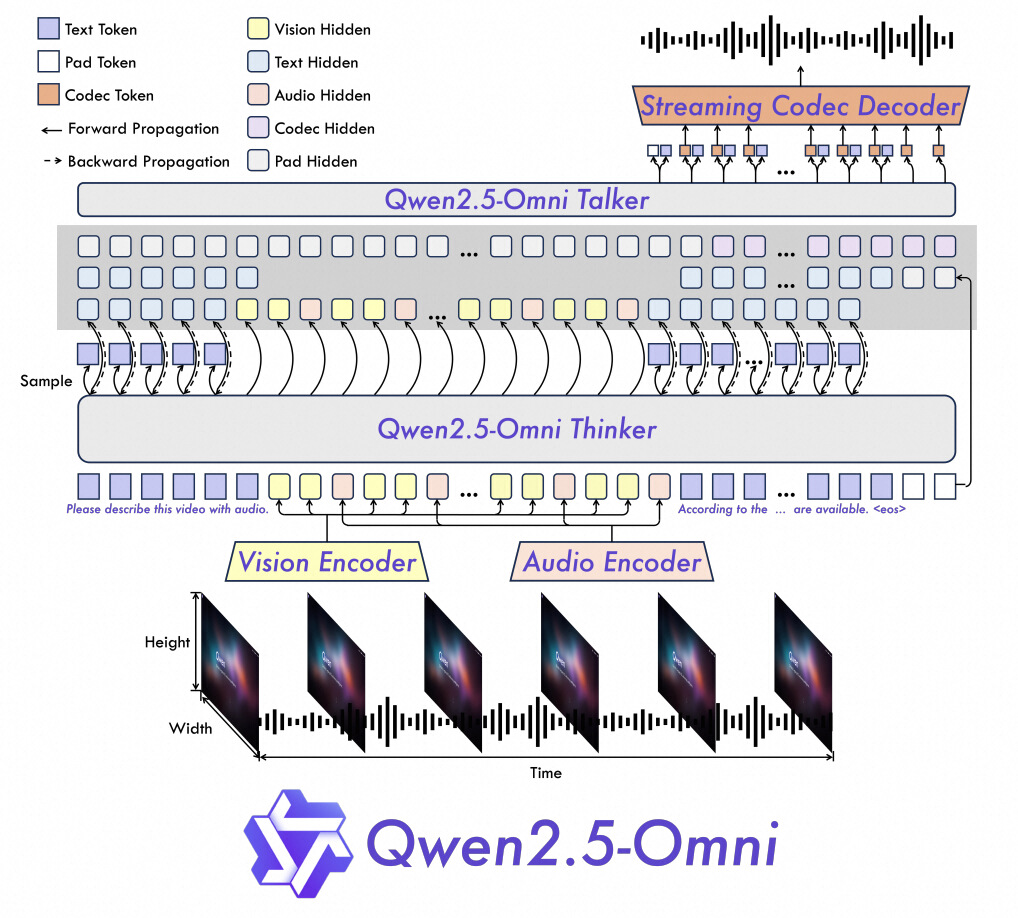
ภาพรวม Qwen2.5-Omni ที่ใช้สถาปัตยกรรม Thinker-Talker
1. การเข้ารหัสทางตำแหน่ง TMRoPE:
- RoPE ที่รองรับข้อมูลหลายรูปแบบที่สอดคล้องตามเวลาจะรับรองว่ามีการประมวลผลเสียงและเฟรมวิดีโอโดยซิงค์กัน (เช่น การลิปซิงค์ในวิดีโอ)
- การแบ่งส่วนแบบแทรกสลับ (Interleaved Chunking) จะแบ่งวิดีโอออกเป็นบล็อกความยาว 2 วินาที โดยรวมข้อมูลภาพ/เสียงเพื่อลดเวลาแฝง
2. สถาปัตยกรรม Thinker-Talker:
- Thinker: LLM สำหรับการสร้างข้อความและการให้เหตุผล
- Talker: โมเดลแทร็กคู่สำหรับการสร้างเสียงพูดแบบเรียลไทม์ ซึ่งจะลดเวลาแฝงของเสียงลง 40% เมื่อเทียบกับ Qwen2-Audio
3. ประสิทธิภาพการสตรีม:
- การเข้ารหัสตามบล็อกจะประมวลผลเสียง/วิดีโอเป็นส่วนๆ จึงช่วยให้ดำเนินการอนุมานแบบเรียลไทม์ได้
- Sliding Window Diffusion Transformer (DiT) จะลดความล่าช้าของเสียงแรกเริ่มโดยการจำกัดช่องรับ
Qwen2.5 Omni มีประสิทธิภาพเหนือกว่าโมเดลที่รองรับข้อมูลหลายรูปแบบโมเดลอื่นๆ อย่างไร

| งาน | Qwen2.5-Omni | Qwen2.5-VL | GPT-4o-Mini | ล้ำสมัย |
|---|---|---|---|---|
| รูปภาพ→ข้อความ | 59.2 (MMMUval) | 58.6 | 60.0 | 53.9 (อื่นๆ) |
| วิดีโอ→ข้อความ | 72.4 (วิดีโอ-MME) | 65.1 | 64.8 | 63.9 (อื่นๆ) |
| การให้เหตุผลที่รองรับข้อมูลหลายรูปแบบ | 81.8 (MMBench) | ไม่มี | 76.0 | 80.5 (อื่นๆ) |
| การสร้างเสียงพูด | 1.42% WER (จีน) | ไม่มี | ไม่มี | 2.33% (อังกฤษ) |
เหตุใด Qwen2.5 Omni จึงมีประสิทธิภาพยอดเยี่ยม
- โมเดลรวม: คุณไม่จำเป็นต้องสลับใช้งานระหว่างโมเดลเสียงและโมเดลวิดีโออย่าง Qwen2-Audio และ Qwen2.5-VL
- เวลาแฝงต่ำ: Qwen2.5 Omni ประมวลผลวิดีโอที่แบ่งเป็นส่วนๆ ความยาว 2 วินาทีแบบเรียลไทม์ จึงเหมาะสำหรับการใช้งานและบริการที่มีเนื้อหาแบบเรียลไทม์
- ความอเนกประสงค์: Qwen2.5 Omni จัดการคำสั่งด้วยเสียงพูดตั้งแต่ต้นจนจบ รวมถึงข้อความด้วย (เช่น “สรุปวิดีโอแล้วอ่านออกเสียง”)
การเริ่มต้นใช้งานฉบับรวบรัดสำหรับ Qwen2.5 บน Alibaba Cloud
ขั้นตอนที่ 1: เลือกโมเดล
1. ไปที่ Alibaba Cloud ModelStudio หรือหน้าข้อมูลเบื้องต้นเกี่ยวกับ Model Studio
2. ค้นหา “Qwen2.5-Omni” แล้วไปที่หน้าดังกล่าว
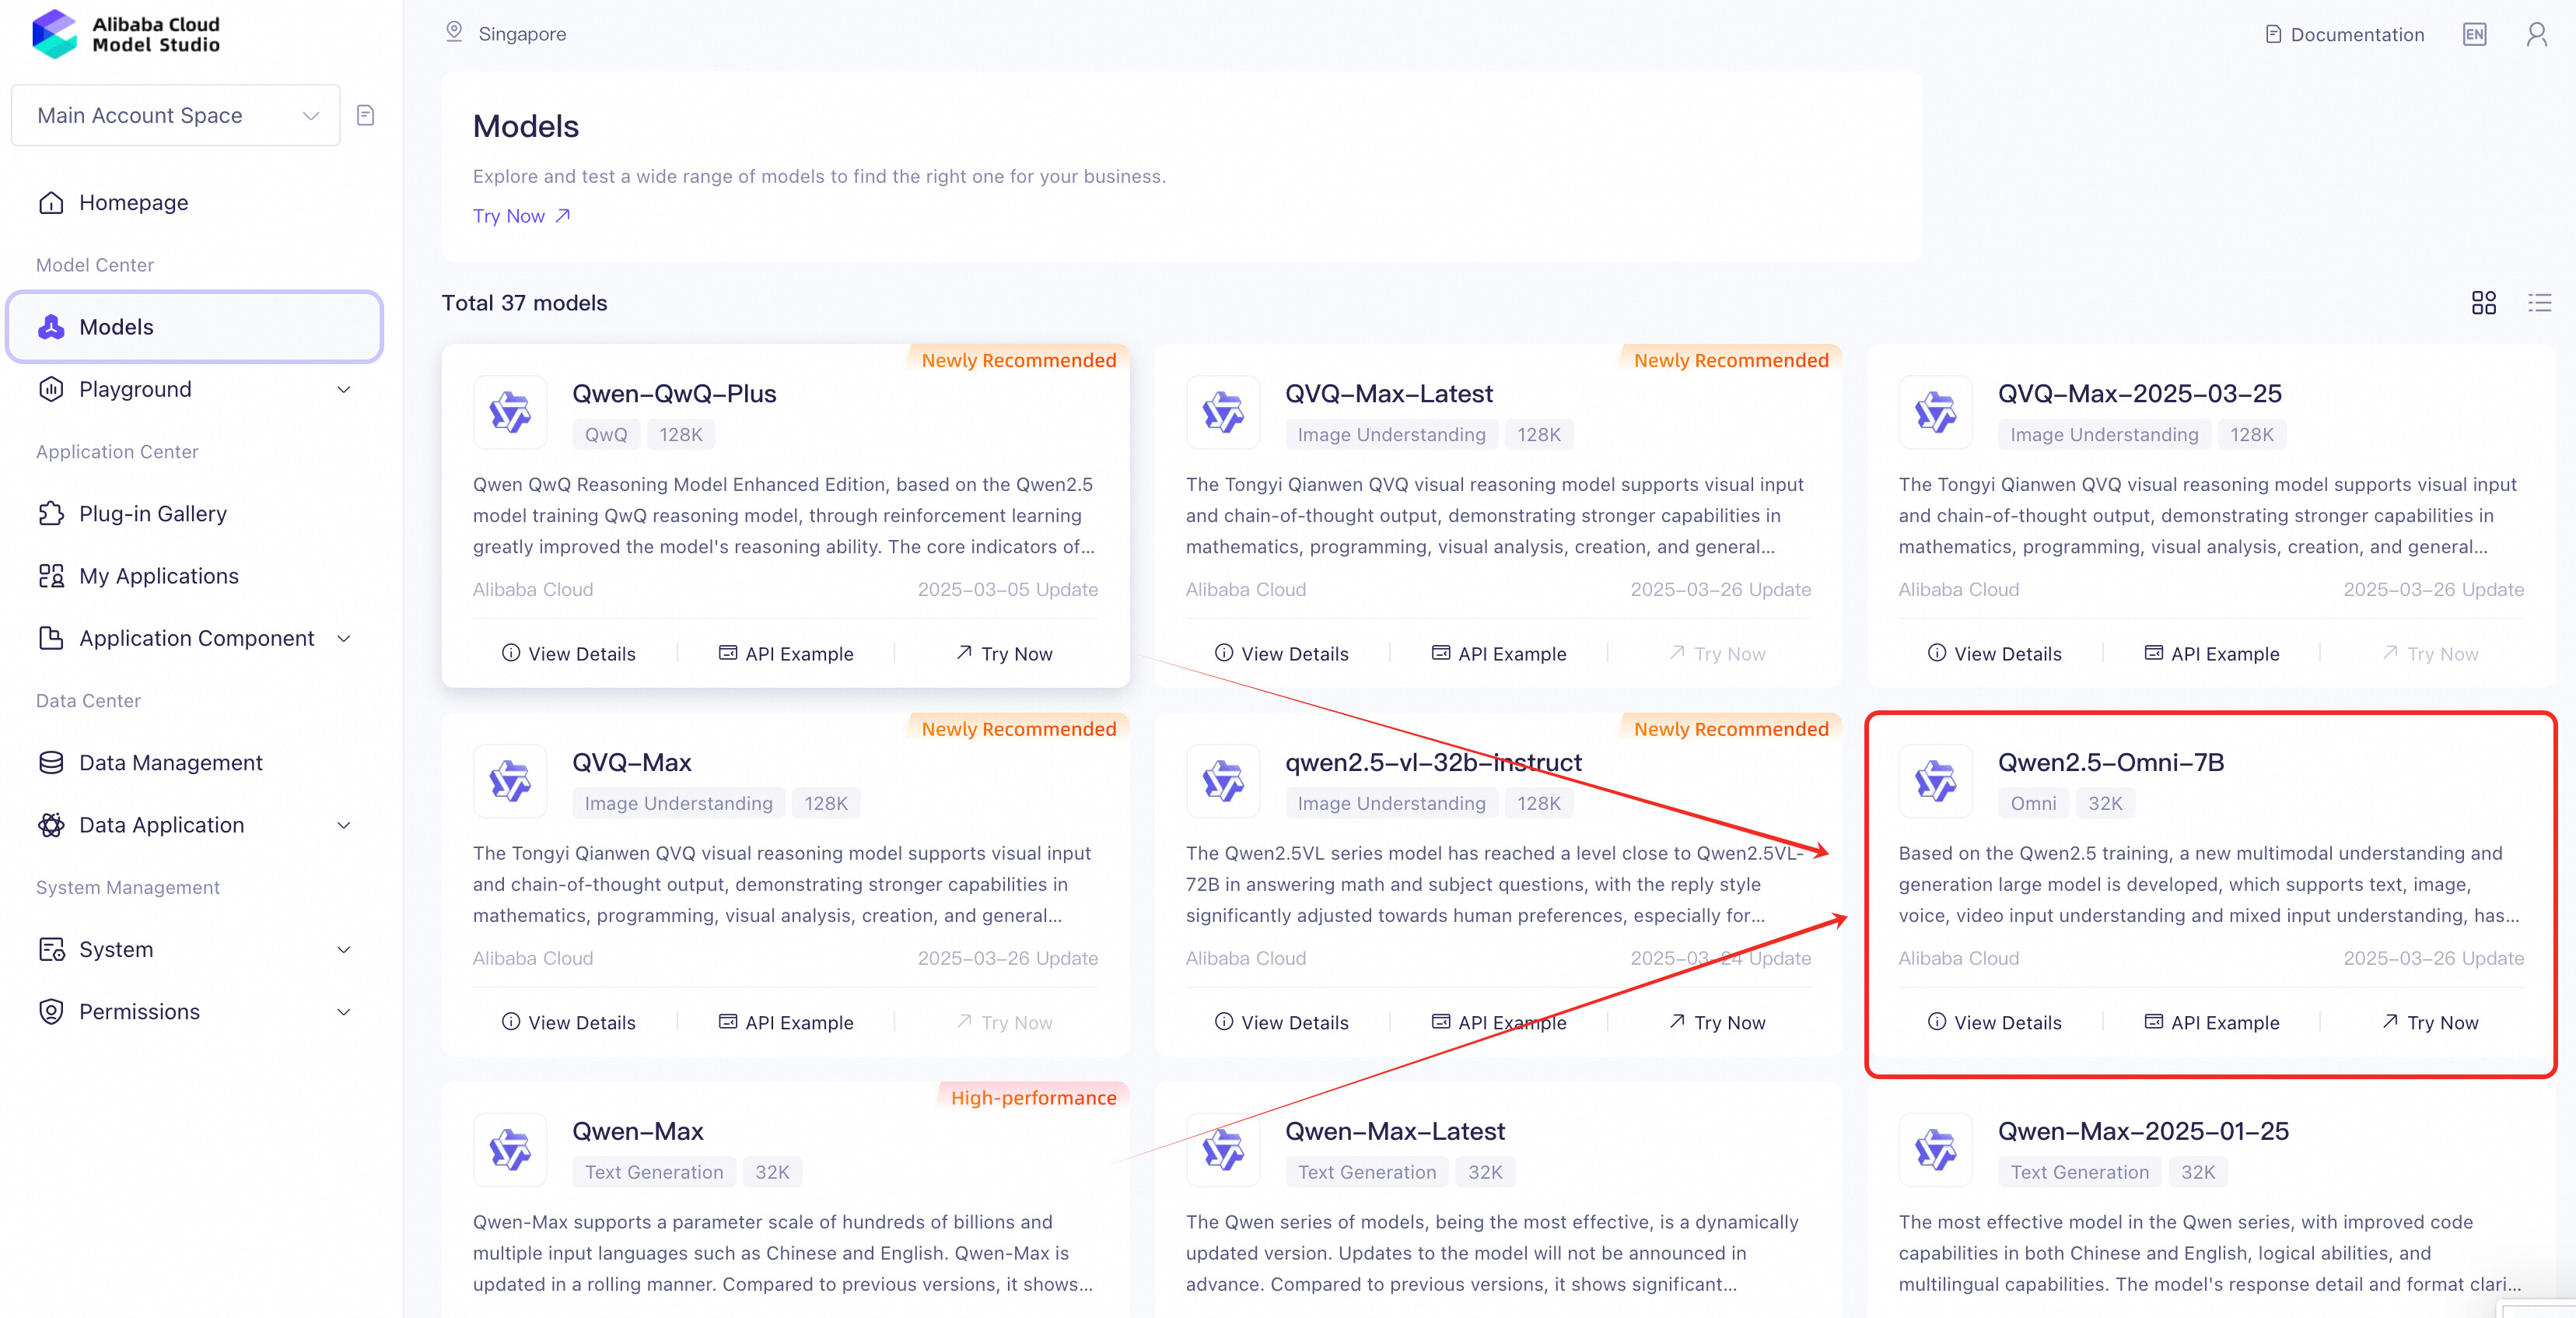
3. อนุญาตให้เข้าถึงโมเดล (ฟรีสำหรับการใช้งานพื้นฐาน)
ขั้นตอนที่ 2: เตรียมสภาพแวดล้อมของคุณ
การตั้งค่าเพื่อการรักษาความปลอดภัย:
1. สร้างสภาพแวดล้อมเสมือน (แนะนำ):
python -m venv qwen-env
source qwen-env/bin/activate  # Linux/MacOS | Windows: qwen-env\Scripts\activate
2. ติดตั้งความสัมพันธ์พึ่งพิง:
pip install openai3. จัดเก็บคีย์ API อย่างปลอดภัย: สร้างไฟล์ .env ในไดเรกทอรีโครงการของคุณ:
DASHSCOPE_API_KEY=your_api_key_hereขั้นตอนที่ 3: เรียกใช้ API ด้วยความสามารถในการใช้ร่วมกับ OpenAI
ใช้ไลบรารี OpenAI เพื่อโต้ตอบกับ Qwen2.5-Omni:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

# Example: Text + Audio Output
completion = client.chat.completions.create(
    model="qwen2.5-omni-7b",
    messages=[{"role": "user", "content": "Who are you?"}],
    modalities=["text", "audio"],  # Specify output formats (text/audio)
    audio={"voice": "Chelsie", "format": "wav"},
    stream=True,  # Enable real-time streaming
    stream_options={"include_usage": True},
)

# Process streaming responses
for chunk in completion:
    if chunk.choices:
        print("Partial response:", chunk.choices[0].delta)
    else:
        print("Usage stats:", chunk.usage)
คุณสมบัติสำคัญของ API
| คุณสมบัติ | รายละเอียด |
|---|---|
| ประเภทอินพุต | ข้อความ รูปภาพ เสียง วิดีโอ (ผ่าน URL/Base64) |
| รูปแบบข้อมูลเอาต์พุต | ระบุพารามิเตอร์ modalities (เช่น ["text", "audio"] สำหรับเอาต์พุตคู่) |
| การรองรับการสตรีม | ผลลัพธ์แบบเรียลไทม์ผ่าน stream=True
|
| การรักษาความปลอดภัย | ตัวแปรสภาพแวดล้อมสำหรับคีย์ API (ไฟล์ .env) |
กรณีการใช้งานขั้นสูง: ก้าวข้ามขอบเขต
1. การวิเคราะห์วิดีโอแบบเรียลไทม์
กรณีการใช้งาน: การใส่คำบรรยายงานกิจกรรมสดด้วยการตรวจจับอารมณ์
- อินพุต: คลิปวิดีโอ 10 วินาที
- เอาต์พุต: สรุปข้อความ + คำบรรยายเสียง (เช่น “คนกำลังส่งเสียงเชียร์热烈!”)
2. อีคอมเมิร์ซข้ามรูปแบบข้อมูล
กรณีการใช้งาน: สร้างคำอธิบายสินค้าจากรูปภาพและรีวิวจากผู้ใช้
# อินพุต: รูปภาพสินค้า + "เขียนรีวิว 5 ดาวในภาษาสเปน"
# เอาต์พุต: ข้อความรีวิว + เวอร์ชันเสียงในภาษาสเปน
เหตุใดจึงควรเรียนรู้เกี่ยวกับ Qwen2.5 Omni
- ทักษะเพื่อให้พร้อมรับอนาคต: โมเดลที่รองรับข้อมูลหลายรูปแบบคือมาตรฐานในรุ่นต่อไปสำหรับการใช้งาน AI
- ความได้เปรียบทางการแข่งขัน: ธุรกิจที่ใช้ Qwen2.5 Omni จะบรรลุผลลัพธ์ต่อไปนี้ได้
- ลดต้นทุน: โมเดลเดียวสำหรับงานด้านข้อความ/เสียง/วิดีโอทั้งหมด
- เร่งให้เกิดนวัตกรรม: นำแอปไปใช้แบบเรียลไทม์ (เช่น ผู้ช่วยเสมือน การเฝ้าระวังอัจฉริยะ)
การแก้ไขปัญหาและแนวทางปฏิบัติที่ดีที่สุด
1. ขีดจำกัดขนาดไฟล์:
- รูปภาพ: ≤10MB ต่อไฟล์
- โทเค็นทั้งหมด: ปฏิบัติตามขีดจำกัดโทเค็นของโมเดลที่ 32,000 รายการ (ข้อความ + การฝังรูปภาพ/เสียง)
2. ปรับให้เหมาะกับการสตรีม:
- ใช้ OSS ของ Alibaba Cloud สำหรับไฟล์ขนาดใหญ่
- เปิดใช้งาน
stream=Trueเพื่อให้ได้เอาต์พุตแบบเรียลไทม์
ข้อสรุป: การรองรับข้อมูลหลายรูปแบบคืออนาคต
ขณะที่ GenAI พัฒนาก้าวหน้า ขีดความสามารถในการรองรับข้อมูลหลายรูปจะแพร่หลายในอุตสาหกรรมต่างๆ ตั้งแต่การดูแลสุขภาพไปจนถึงความบันเทิง การมีความเชี่ยวชาญเกี่ยวกับ Qwen2.5 Omni จะพาคุณก้าวเข้าสู่ยุคแห่งการทำงานร่วมกันระหว่างมนุษย์กับ AI ยุคใหม่
เริ่มทดลองใช้เลยวันนี้แล้วร่วมปฏิวัติวงการไปด้วยกัน!
ข้อมูลอ้างอิง
- ความช่วยเหลือสำหรับ Model Studio: คู่มือการเริ่มต้นใช้งาน
- หน้าผลิตภัณฑ์ Model Studio: สำรวจคุณสมบัติ
- บล็อก Qwen2.5-Omni: ภาพรวมเชิงลึก
- รายงานทางเทคนิค: เอกสาร ArXiv
- GitHub: โค้ดและเอกสาร
- HuggingFace: ดาวน์โหลดโมเดล
- การสร้างภาพด้วย Wan: สร้างวิดีโอที่ยอดเยี่ยม
บทความนี้แปลจากภาษาอังกฤษ ดูบทความต้นฉบับที่นี่
Read previous post:
Read next post:
-

-
Regional Content Hub
144 posts | 4 followers
Follow
Comments
-
-
Regional Content Hub
144 posts | 4 followers
Follow
Related Products
-
 Qwen
Full-range, open-source, multimodal, and multi-functional
Learn More -
 Alibaba Cloud Model Studio
A one-stop generative AI platform to build intelligent applications that understand your business, based on Qwen model series such as Qwen-Max and other popular models
Learn More -
Token Plan
Build more, spend less. One plan, every modality.
Learn More -
 QwenWork
 is dedicated to helping employees strengthen their professional competitiveness in the AI era and to enabling enterprises to improve organizational effectiveness.
Learn More
More Posts by Regional Content Hub
- ให้พื้นที่ทำงานชั่วคราวกับ AI เอเจนต์ของคุณด้วย Alibaba Cloud AgentRun
- Alibaba Cloud AgentRun으로 AI 에이전트에 일회용 워크스페이스 제공
- Alibaba Cloud AgentRun で AI エージェントに使い捨てワークスペースを与える
- Beri Agen AI Anda Ruang Kerja Sekali Pakai dengan Alibaba Cloud AgentRun
- Cung cấp không gian làm việc dùng một lần cho tác nhân AI của bạn với Alibaba Cloud AgentRun
- DeepSeek V4-Flash dalam Skala Besar: Panduan Deployment Berbasis Benchmark
- 大規模な DeepSeek V4-Flash の活用:ベンチマーク主導のデプロイガイド
- 대규모 DeepSeek V4-Flash: 벤치마크 기반 배포 가이드
- Alibaba Cloud ECS 上で Telegram 連携機能付きの OpenClaw をデプロイする
- Alibaba Cloud ECS에 Telegram 통합 기능을 갖춘 OpenClaw 배포