本文档以千问模型的部署为例,使用 API(HTTP)调用方式帮助您完成阿里云百炼模型部署的全流程操作,包括部署、查询、推理、删除及权限排查。
前提条件
- 您已经完整阅读了模型部署,熟悉阿里云百炼平台模型部署支持的模型和基本步骤。
- 您需要已获取与配置 API Key并配置API Key到环境变量。请将示例代码中的
DASHSCOPE_API_HOST替换为获取的 API Host。
1. 部署模型
下面的命令展示如何创建专属服务。其中,按 Token 计费的示例使用已经调优好的自定义模型qwen3-8b-ft-202511132025-0260,创建一个专属服务qwen3-8b-ft-202511132025-0260;按预置吞吐和按模型单元的示例使用预置模型。
获取自定义模型 ID 的方法:前往百炼控制台-模型调优,点击需要部署的任务名称 -> 产出 -> 点击蓝色字体的模型名称,进入我的模型页面,在模型基本信息区域可查看模型 ID。
使用模型 ID作为输入的model_name参数,即可使用 API 部署该模型。
按预置吞吐(PTU)计费
说明执行以下部署命令后,即便您还没有调用模型,模型部署服务仍将在部署成功后开始计费。建议您先确认服务计费规则,再执行部署命令。
按预置吞吐计费模式按预置吞吐的使用时长收费,适用于追求稳定吞吐保障和高并发低延迟、且流量可预估的场景。该模式下,吞吐/并发和生成速度均为平台预置,用户不可调。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_flash",
    "model_name": "qwen-flash-2025-07-28",
    "plan": "ptu",
    "ptu_capacity": {
        "input_tpm": 10000,
        "output_tpm": 1000
    }
}'
按模型单元的使用时长计费
说明
- 执行以下部署命令后,即便您还没有调用模型,模型部署服务仍将在部署成功后开始计费。建议您先确认服务计费规则,再执行部署命令。
- 模型单元-后付费方式的算力资源先买到先得。如购买不成功会全额退款。
选择按模型单元计费计费方式,计费模式为按模型单元的使用时长收费,适用场景为模型调优后的大规模推理业务,资源专属,性能和成本灵活可调;吞吐/并发和生成速度均为客户自定义。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "name": "my_qwen_plus",
    "model_name": "qwen-plus-2025-12-01",
    "plan": "mu",
    "deploy_spec": "MU1",
    "enable_thinking": true,
    "capacity": 4,
    "max_context_length": 10000,
    "rpm_limit": 500,
    "tpm_limit": 1000
}'
模型单元部署模式还支持以下更多设置:
配置内容 | 配置详情 |
服务名称 | 自定义部署服务的名称。 |
选择模型 | 选择要部署的模型,包括平台预置模型和已调优的模型。 |
模型单元类型 | 选择部署规格,不同规格对应不同的算力和性能。 |
部署副本数 | 设置初始部署副本数量,影响服务的并发处理能力。 |
部署模版 | 选择部署模版(如"单机部署"),不同模版对应不同的资源配置方案。仅在模型单元计费模式下可用。 |
配置模型推理模式 | 部分模型在以模型单元方式部署时,可配置推理模式、最长上下文等。
|
最长上下文 | 部分模型的模型单元部署模式支持该设置。最长上下文长度基于模型类型。 |
服务限流 | 部分模型的模型单元部署模式支持该设置,可限制模型调用的 RPM、TPM。 |
如何在 API 设置上述内容,请参考:使用 API 创建部署。
按模型 Token 使用量计费
选择计费方式为按Token计费,计费模式为按Token用量收费,适用于高性价比诉求且对并发和延迟要求不高的场景。该模式价格优势最高,吞吐/并发和生成速度均由平台预置,用户不可调。
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments" \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header 'Content-Type: application/json' \
--data '{
    "model_name": "qwen3-8b-ft-202511132025-0260",
    "plan": "lora",
    "capacity": 1,
    "name": "qwen3-8b-ft"
}'
capacity 参数设置无效,但必须填写。如需扩缩容,请前往百炼专属部署控制台填写表单申请。
dashscope CLI
通过 dashscope 命令行调用。
export DASHSCOPE_API_KEY="your-api-key"
# 将 {WorkspaceId} 替换为业务空间ID,ap-southeast-1 替换为对应地域(美东: us-east-1, 德国: eu-central-1)
export DASHSCOPE_HTTP_BASE_URL="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"
# 列出已部署的专属服务
dashscope deployments list

# 创建专属服务(--plan 必填)
# plan 可选值:ptu(PTU 预留资源)/ mu(模型单元)/ lora(LoRA 部署)
dashscope deployments create -m qwen2.5-7b-instruct -s tst -c 1 --plan ptu
重要SDK Expert 交互式助手可按自然语言完成同样的开发与排障,见
DashScope SDK Expert。完整地域表见 Base URL 总览。
命令执行成功后,返回如下结果:(以 Lora 部署为例)
{
    "request_id": "83b173ab-2b2f-41aa-8c57-b173e8be934e",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:06:46.405",
        "gmt_modified": "2025-11-20T20:06:46.405",
        "status": "PENDING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "workspace_id": "llm-8v*****",
        "charge_type": "post_paid",
        "creator": "16542*****",
        "modifier": "16542*****",
        "plan": "lora"
    }
}
其中deployed_model为专属服务的唯一ID。
2. 查询服务状态
通过以下命令查询指定专属服务的详细信息:
curl "https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260" \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
命令执行成功后,返回如下结果:
{
    "request_id": "ca36952d-9136-426e-ab08-68a97ad72719",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-20T20:42:25",
        "status": "RUNNING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
当服务状态为RUNNING时,服务部署完成。
3. 执行推理请求
说明若首次使用DashScope SDK,请参考安装SDK。
请确保 API Key 所在的业务空间与模型部署所在的业务空间相同。
调用已部署的专属服务时,model 参数取值应为模型部署成功后的模型 code,请前往专属部署控制台获取。
import os
import dashscope

messages = [
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "你是谁?"},
]
dashscope.base_http_api_url = 'https://dashscope-intl.aliyuncs.com/api/v1'
response = dashscope.Generation.call(
    # 若没有配置环境变量,请用百炼API Key将下一行替换为:api_key="sk-xxx",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    model="qwen3-max-xxx-xxx",  # 请替换为模型部署成功后的code
    messages=messages,
    result_format="message",
    enable_thinking=False,
)
print(response)
import os
from openai import OpenAI

client = OpenAI(
    # 若没有配置环境变量,请用百炼API Key将下一行替换为:api_key="sk-xxx",
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
)

completion = client.chat.completions.create(
    model="qwen3-max-xxx-xxx",  # 请替换为模型部署成功后的code
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "你是谁?"},
    ],
    extra_body={"enable_thinking": False},
)
print(completion)
推理参数对齐
百炼推理引擎的参数默认值可能与本地推理框架不同。为对齐 vLLM 默认值,建议调用时参考下表设置参数;使用 SGLang 等其他框架请参考对应文档调整。
参数名称 | 推荐值(对应 vLLM 默认值) |
|---|---|
temperature | 取值范围 [0, 2),设置为 1.0 等同于 vLLM 引擎默认值。 |
top_p | 取值范围 (0, 1.0],设置为 1.0 等同于 vLLM 引擎默认值。 |
top_k | 取值为 None 或大于 100 时不启用 top_k 策略,仅 top_p 生效;设置为 99 不支持全采样,接近 vLLM 默认值 0(全采样)。 |
presence_penalty | 取值范围 [-2.0, 2.0],设置为 0 等同于 vLLM 引擎默认值。 |
repetition_penalty(DashScope 协议) | 提高可降低生成重复度,1.0 表示不惩罚;取值范围大于 0,设置为 1.0 等同于 vLLM 引擎默认值。 |
4. 删除专属服务
警告执行以下删除命令后,模型部署服务将立即开始下线,且不可恢复。您将:
- 无法调用该模型。
- 部署服务停止计费。
不再使用的专属服务,可以通过下面的命令删除:
curl --request DELETE 'https://dashscope-intl.aliyuncs.com/api/v1/deployments/qwen3-8b-ft-202511132025-0260' \
    --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
    --header 'Content-Type: application/json'
命令执行成功后,返回以下结果:
{
    "request_id": "8f726017-6042-420e-a465-0d366a3aba59",
    "output":
    {
        "deployed_model": "qwen3-8b-ft-202511132025-0260",
        "gmt_create": "2025-11-20T20:32:08",
        "gmt_modified": "2025-11-27T16:35:31.591",
        "status": "DELETING",
        "model_name": "qwen3-8b-ft-202511132025-0260",
        "base_model": "qwen3-8b",
        "base_capacity": 2,
        "capacity": 2,
        "ready_capacity": 2,
        "workspace_id": "llm-8v53etv3hwb8orx1",
        "charge_type": "post_paid",
        "creator": "1654290265984853",
        "modifier": "1654290265984853",
        "plan": "mu",
        "model_unit_spec": "MU1"
    }
}
删除成功后,再使用2. 查询服务状态接口将无法查询到部署模型的状态。
权限不足排查
模型部署过程中如遇权限不足报错,根据部署方式分两种排查路径:
控制台部署
-
如果显示"缺少该模块的权限",请确保您的账号在该业务空间的权限管理页面中拥有模型部署-操作权限。
如果无法正常操作,请联系您的组织或 IT 管理员添加相关权限或代为检查权限问题。
-
如果部署时报错"xx业务空间没有部署xx模型的权限",请前往百炼的业务空间管理页面,为对应业务空间添加对应模型的部署权限。
API 调用报错:
Workspace xxx does not have deployment privilege for model xxxx。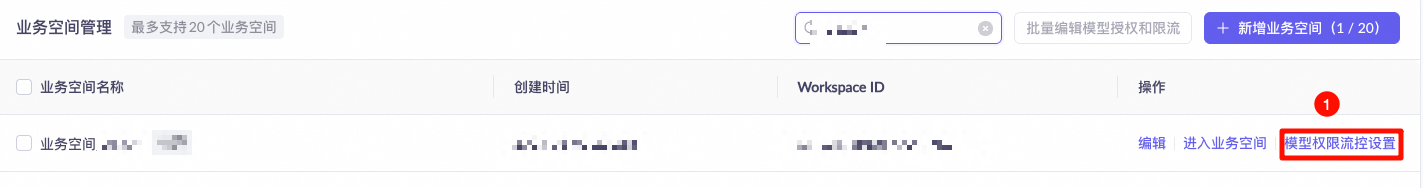
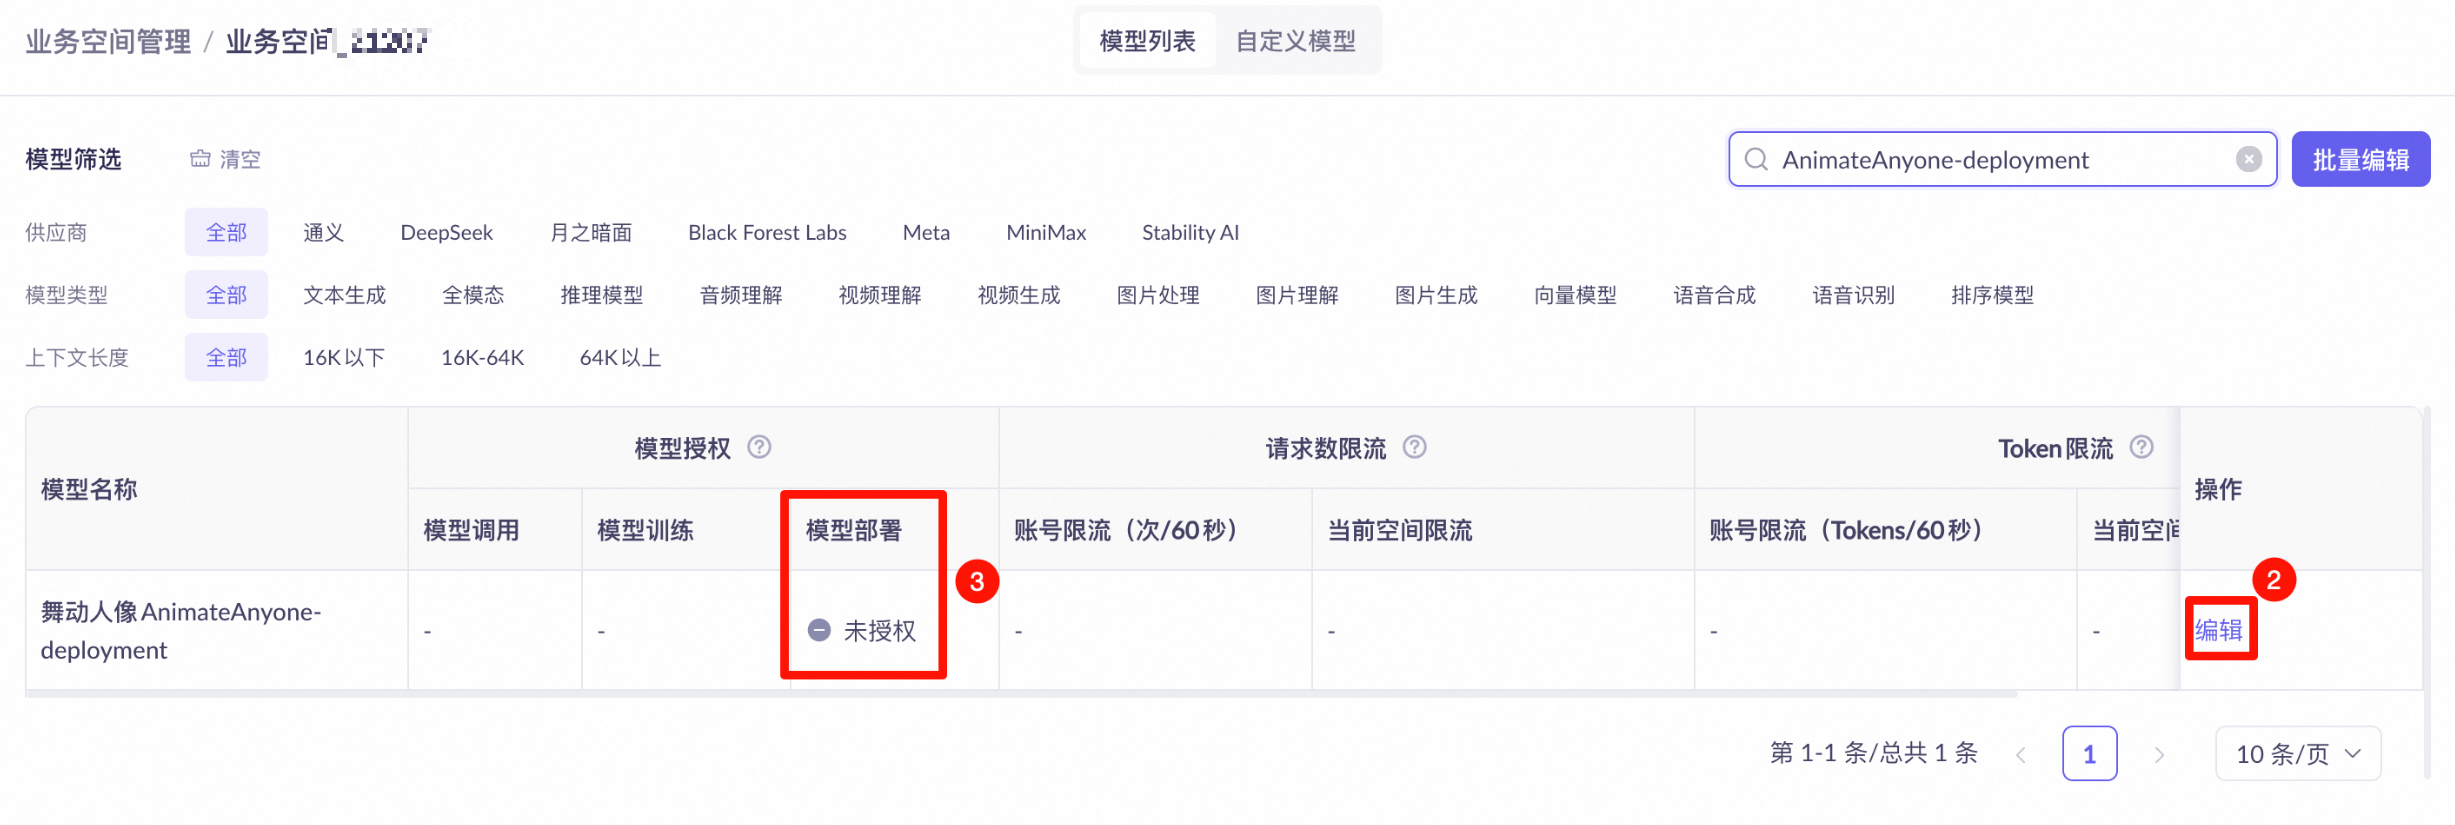
如果提示权限不足,请联系您的组织或 IT 管理员添加相关权限或代为操作。
API 部署
在使用 API 进行模型部署时,需要确保:
-
API Key 的归属业务空间拥有管理该模型的权限。请前往百炼的业务空间管理页面,检查对应业务空间的模型部署权限设置。
API 调用报错:
Workspace xxx does not have deployment privilege for model xxxx。在对应业务空间的操作列,单击模型权限流控设置。
在模型列表中找到目标模型,查看模型部署列的授权状态。若显示未授权,单击操作列的编辑进行授权。
如果提示权限不足,请联系您的组织或 IT 管理员添加相关权限或代为操作。
-
API Key 的归属账号在归属业务空间中拥有操作权限。请前往百炼控制台,点击左下角的业务空间,切换到对应业务空间,再点击
 检查对应业务空间的模型部署权限设置。
API 调用报错:
Workspace access denied。在左侧导航栏点击权限管理,确认用户列表中包含 API Key 的归属账号(类型为主账号)。
如果提示权限不足,请联系您的组织或 IT 管理员添加相关权限或代为操作。
API参考
详细API调用请参考API 详情。