GitHub etkinlik verilerini kullanarak birleşik toplu ve gerçek zamanlı analitik çözümü oluşturun. MaxCompute toplu veri ambarı olarak hizmet verirken Realtime Compute for Apache Flink ve Hologres gerçek zamanlı veri ambarını oluşturur. Hologres ve MaxCompute, hem gerçek zamanlı hem de toplu veri analizi için birleşik bir katman sağlar.
Arka Plan
İşletmeler dijitalleştikçe daha taze verilere duyulan talep artar. Büyük ölçekli veriler için geleneksel toplu işlemenin ötesinde birçok işletme artık gerçek zamanlı veri işleme, depolama ve analitik gerektirir. Birleşik toplu ve gerçek zamanlı analitik bu ihtiyaca yanıt verir.
Birleşik toplu ve gerçek zamanlı analitik, gerçek zamanlı ve toplu verileri tek bir platformda yönetip işleyerek gerçek zamanlı işleme ile toplu analitik arasında kesintisiz bir bağlantı kurar. Başlıca faydaları şunlardır:
Geliştirilmiş veri işleme verimliliği: Gerçek zamanlı ve toplu verileri tek bir platformda entegre etmek veri aktarım ve dönüştürme maliyetlerini azaltır.
Geliştirilmiş analitik doğruluğu: Analiz için gerçek zamanlı ve toplu verileri birleştirmek sonuçların hassasiyetini artırır.
Basitleştirilmiş veri yönetimi: Birleşik yaklaşım veri yönetimini ve işlemeyi kolaylaştırır.
Daha iyi karar desteği: İş kararlarını desteklemek için verilerinizi tam kapasiteyle kullanın.
Alibaba Cloud hem toplu hem de gerçek zamanlı senaryolar için basitleştirilmiş, birleşik bir veri ambarı çözümü sunar. Bu çözüm toplu işleme için MaxCompute'u ve gerçek zamanlı analitik için Hologres'i kullanır. Realtime Compute for Apache Flink'in gerçek zamanlı işleme yetenekleriyle bütünleşen bu hizmetler Alibaba Cloud'un birleşik veri ambarının çekirdek motorunu oluşturur.
Çözüm mimarisi
Aşağıdaki diyagram MaxCompute ve Hologres kullanılarak GitHub genel etkinlikler veri kümesinde birleşik toplu ve gerçek zamanlı analitik için eksiksiz işlem hattını gösterir.
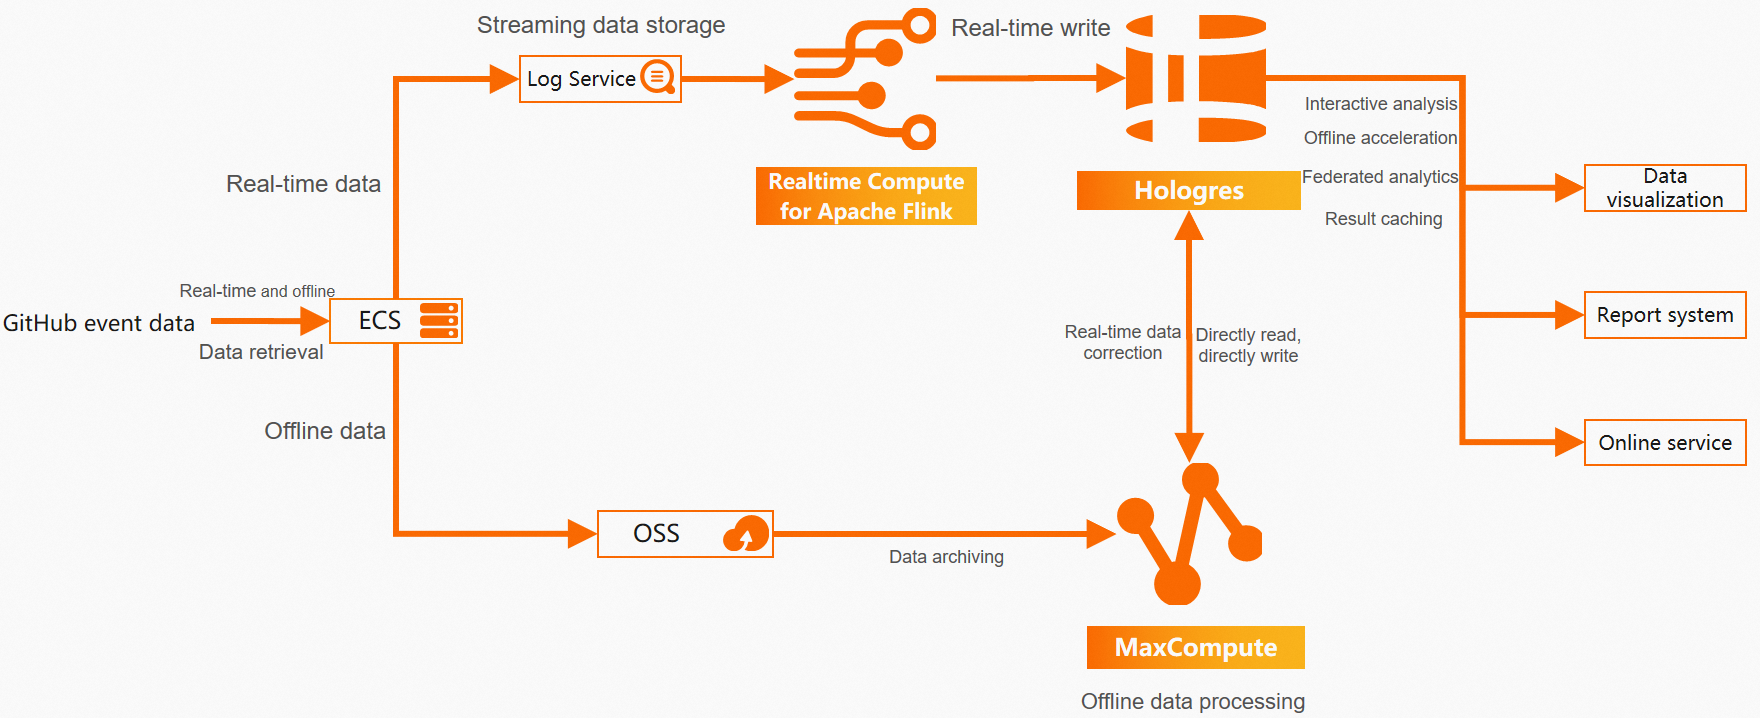
Bu mimaride bir ECS örneği veri kaynağı olarak GitHub'dan gerçek zamanlı ve toplu etkinlik verilerini toplar ve birleştirir. Veriler bir gerçek zamanlı işlem hattına ve bir toplu işlem hattına beslenir ardından birleşik hizmet katmanı olarak Hologres'te konsolide edilir.
Gerçek zamanlı işlem hattı: Realtime Compute for Apache Flink Simple Log Service (SLS) verilerini gerçek zamanlı olarak işler ve Hologres'e yazar. Hologres gerçek zamanlı veri yazma ve güncelleme işlemlerini destekler; veriler sisteme alındıktan hemen sonra sorgulanabilir. Yerel entegrasyon en son etkinliklerin çıkarılması ve trend analizleri gibi kullanım durumları için yüksek aktarım hızına ve düşük gecikme süresine sahip model odaklı gerçek zamanlı veri ambarı geliştirmeyi mümkün kılar.
Toplu işlem hattı: MaxCompute büyük miktardaki toplu verileri işler ve arşivler. Object Storage Service (OSS) ham JSON verileri için kullanışlı güvenli ve düşük maliyetli depolama sağlar. MaxCompute harici tablolar aracılığıyla OSS'deki yarı yapılandırılmış verileri doğrudan okuyup ayrıştırabilir yüksek değerli verileri kendi dahili depolamasına entegre edebilir ve DataWorks ile birlikte çalışarak toplu bir veri ambarı oluşturabilir.
Hologres depolama katmanında MaxCompute ile sorunsuz bir şekilde entegredir; bu sayede MaxCompute'deki büyük hacimli geçmiş veriler üzerindeki sorguları hızlandırabilirsiniz. Bu özellik geçmiş veriler üzerinde düşük sıklıkta ancak yüksek performanslı sorgulamayı destekler. Ayrıca gerçek zamanlı işlem hattındaki veri atlamaları gibi sorunları çözmek ve gerçek zamanlı verileri düzeltmek için toplu işlem hattını kullanabilirsiniz.
Bu çözüm aşağıdaki avantajları sunar:
Kararlı ve verimli toplu işlem hattı: Saatlik veri yazma ve güncellemelerini büyük ölçekli toplu işlemeyi ve karmaşık hesaplamaları destekler hesaplama maliyetlerini azaltır.
Olgun gerçek zamanlı işlem hattı: Gerçek zamanlı veri alma olay hesaplamasını ve analitiği destekleyerek saniyeler içinde yanıt verir.
Birleşik depolama ve hizmet: Hologres merkezi veri depolama ve tutarlı bir harici arayüz (hem OLAP hem de Anahtar-Değer sorguları için tek bir SQL arayüzü) ile birleşik bir hizmet katmanı sağlar.
Birleşik toplu ve gerçek zamanlı analitik: Veri çoğaltmasını ve hareketini azaltır veri düzeltmeye olanak tanır.
Bu tek noktadan geliştirme yaklaşımı saniye düzeyinde veri yanıtı uçtan uca durum görünürlüğü daha az bileşen içeren basitleştirilmiş bir mimari ve azaltılmış bakım ve işletim maliyetleri sağlar.
İş ve veriyi anlama
Geliştiriciler GitHub'daki açık kaynak projeler üzerinde çalışırken çok sayıda etkinlik oluşturur. GitHub her bir etkinlik için etkinlik türü geliştirici ve kod deposu dahil olmak üzere ayrıntıları kaydeder. GitHub bir depoya yıldız verme veya kod commit etme gibi genel etkinlikleri kullanılabilir kılar. Etkinlik türlerinin tam listesi için bkz. Webhook etkinlikleri ve yükleri.
GitHub genel etkinlikleri bir OpenAPI aracılığıyla sunar. API beş dakikalık bir gecikmeyle gerçek zamanlı veriler sağlar. Daha fazla bilgi için bkz. Etkinlikler.
GH Archive projesi GitHub genel etkinliklerinin saatlik arşivlerini toplar ve sunar. Çevrimdışı verileri almak için bu arşivleri kullanın. Daha fazla bilgi için bkz. GH Archive.
GitHub işini anlama
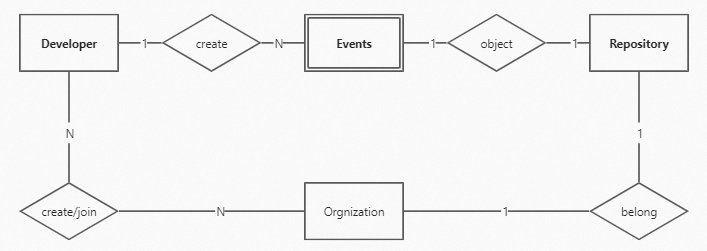
GitHub'ın temel işi kodu ve etkileşimleri yönetmektir. Üç ana varlığı içerir: Geliştirici Depo ve Organizasyon.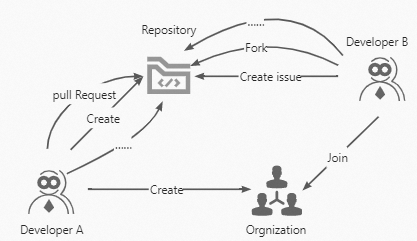
Bu veri analizi için bir Event da bir varlık olarak saklanır ve kaydedilir.
Ham genel etkinlik verilerini anlama
Aşağıdaki örnek ham bir etkinliğin JSON verisini gösterir:
{
    "id": "19541192931",
    "type": "WatchEvent",
    "actor":
    {
        "id": 23286640,
        "login": "herekeo",
        "display_login": "herekeo",
        "gravatar_id": "",
        "url": "https://api.github.com/users/herekeo",
        "avatar_url": "https://avatars.githubusercontent.com/u/23286640?"
    },
    "repo":
    {
        "id": 52760178,
        "name": "crazyguitar/pysheeet",
        "url": "https://api.github.com/repos/crazyguitar/pysheeet"
    },
    "payload":
    {
        "action": "started"
    },
    "public": true,
    "created_at": "2022-01-01T00:03:04Z"
}
Bu analiz 15 tür genel etkinliği kapsar. Hiç gerçekleşmemiş veya artık kaydedilmeyen etkinlikler dahil değildir. Bu etkinlik türleri hakkında ayrıntılı bilgi için bkz. Github genel etkinlik türleri.
Önkoşullar
Bir Elastic Compute Service (ECS) örneği oluşturun ve buna bir Elastic IP Address (EIP) atayın. Örneği GitHub API'sinden gerçek zamanlı etkinlik verilerini çıkarmak için kullanın. Daha fazla bilgi için bkz. Oluşturma kılavuzu ve Elastic IP Address.
Object Storage Service (OSS) hizmetini etkinleştirin ve GH Archive kaynağından gelen JSON veri dosyalarını depolamak için ECS örneğine ossutil aracını yükleyin. Daha fazla bilgi için bkz. OSS'i Etkinleştir ve ossutil'i Yükle.
MaxCompute hizmetini etkinleştirin ve bir proje oluşturun. Daha fazla bilgi için bkz. MaxCompute projesi oluşturma.
DataWorks hizmetini etkinleştirin ve çevrimdışı zamanlama görevleri oluşturmak için bir çalışma alanı oluşturun. Daha fazla bilgi için bkz. Çalışma alanı oluşturma.
Simple Log Service (SLS) hizmetini etkinleştirin; ECS örneğinden günlük olarak veri toplamak için bir proje ve bir Logstore oluşturun. Daha fazla bilgi için bkz. LoongCollector Kullanarak ECS Metin Günlüklerini Toplama ve Analiz Etme.
SLS'den gelen günlük verilerini gerçek zamanlı olarak Hologres'e yazmak için bir Realtime Compute for Apache Flink örneği etkinleştirin. Daha fazla bilgi için bkz. Realtime Compute for Apache Flink'i Etkinleştir.
Hologres hizmetini etkinleştirin. Daha fazla bilgi için bkz. Hologres örneği satın alma.
Çevrimdışı veri ambarı oluşturma (saatlik güncellemeler)
Bir ECS örneği kullanarak ham veri dosyalarını indirme ve OSS'e yükleme
GH Archive kaynağından JSON veri dosyalarını indirmek için bir Elastic Compute Service (ECS) örneği kullanın.
Geçmiş verileri
wgetkomutunu kullanarak indirin. Örneğin 2012'den 2022'ye kadar olan saatlik verileri indirmek içinwget https://data.gharchive.org/{2012..2022}-{01..12}-{01..31}-{0..23}.json.gzkomutunu çalıştırın.-
Her saat oluşturulan yeni verileri indirmek için aşağıda belirtildiği gibi planlanmış bir saatlik görev ayarlayın.
NotECS örneğinde ossutil'in yüklü olduğundan emin olun. Daha fazla bilgi için bkz. ossutil'i Yükle. ossutil kurulum paketini indirin ve ECS örneğine yükleyin. unzip yazılımını yüklemek için
yum install unzipkomutunu çalıştırın. Ardından ossutil paketini açın ve yürütülebilir dosyayı/usr/bin/dizinine taşıyın.ECS örneğinizle aynı bölgede bir Object Storage Service (OSS) paketi oluşturduğunuzdan emin olun. Özel bir paket adı kullanabilirsiniz. Bu örnekte
githubeventspaket adı kullanılmaktadır.Bu örnekte dosyalar ECS örneğindeki
/opt/hourlydata/gh_datadizinine indirilir. Farklı bir dizin kullanabilirsiniz.
-
/opt/hourlydatadizinindedownload_code.shadlı bir dosya oluşturmak için aşağıdaki komutu çalıştırın.cd /opt/hourlydata vim download_code.sh -
Düzenleme moduna girmek için
ituşuna basın ve aşağıdaki betiği ekleyin.d=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%-H') h=$(TZ=UTC date --date='1 hour ago' '+%Y-%m-%d-%H') url=https://data.gharchive.org/${d}.json.gz echo ${url} # Download the data to the ./gh_data/ directory. You can use a different directory. wget ${url} -P ./gh_data/ # Change to the gh_data directory. cd gh_data # Decompress the downloaded data into a JSON file. gzip -d ${d}.json echo ${d}.json # Change to the root directory. cd /root # Use ossutil to upload the data to OSS. # Create the hr=${h} directory in the githubevents OSS bucket. ossutil mkdir oss://githubevents/hr=${h} # Upload the data from the /opt/hourlydata/gh_data directory to OSS. You can use a different directory. ossutil cp -r /opt/hourlydata/gh_data oss://githubevents/hr=${h} -u echo oss uploaded successfully! rm -rf /opt/hourlydata/gh_data/${d}.json echo ecs deleted! Esc tuşuna basın
:wqyazın ve dosyayı kaydedip kapatmak için Enter tuşuna basın.-
download_code.shbetiğini her saatin 10. dakikasında çalıştırmak için aşağıdaki komutu çalıştırın.# 1. Run the following command and press I to enter edit mode. crontab -e # 2. Add the following command. Then, press Esc, enter :wq, and press Enter to exit. 10 * * * * cd /opt/hourlydata && sh download_code.sh > download.logBetik çalıştırıldıktan sonra önceki saate ait JSON dosyası her saatin 10. dakikasında indirilir. Dosya daha sonra ECS örneğinde açılır ve
oss://githubeventsyoluna yüklenir. Yalnızca önceki saatin dosyasını okumak için yükleme sırasında her dosya için bölüm olarak'hr=%Y-%M-%D-%H'adlı bir dizin oluşturulur. Bu sonraki veri yazma işlemlerinin yalnızca en son bölümden dosya okumasını sağlar.
Harici tablo kullanarak OSS verilerini MaxCompute'a aktarma
Aşağıdaki komutları MaxCompute istemcisinde veya DataWorks'teki bir ODPS SQL düğümünde çalıştırın. Daha fazla bilgi için bkz. İstemciyi (odpscmd) kullanarak MaxCompute'a bağlanma veya ODPS SQL görevi geliştirme.
-
OSS'de depolanan JSON dosyalarını okumak için
githubeventsharici tablosunu oluşturun:CREATE EXTERNAL TABLE IF NOT EXISTS githubevents ( col STRING ) PARTITIONED BY ( hr STRING ) STORED AS textfile LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/githubevents/' ;MaxCompute'ta OSS verilerine erişmek için harici tablolar oluşturma hakkında daha fazla bilgi için bkz. OSS'deki yapılandırılmamış verilere erişme.
-
Verileri depolamak için
dwd_github_events_odpsfact tablosunu oluşturun. Aşağıdaki kod Veri Tanımlama Dili (DDL) ifadesini gösterir:CREATE TABLE IF NOT EXISTS dwd_github_events_odps ( id BIGINT COMMENT 'Event ID' ,actor_id BIGINT COMMENT 'ID of the event initiator' ,actor_login STRING COMMENT 'Logon name of the event initiator' ,repo_id BIGINT COMMENT 'Repository ID' ,repo_name STRING COMMENT 'Full name of the repository in the format of owner/repository_name' ,org_id BIGINT COMMENT 'ID of the organization to which the repository belongs' ,org_login STRING COMMENT 'Name of the organization to which the repository belongs' ,`type` STRING COMMENT 'Event type' ,created_at DATETIME COMMENT 'Time when the event occurred' ,action STRING COMMENT 'Event action' ,iss_or_pr_id BIGINT COMMENT 'ID of the issue or pull request' ,number BIGINT COMMENT 'Number of the issue or pull request' ,comment_id BIGINT COMMENT 'Comment ID' ,commit_id STRING COMMENT 'Commit ID' ,member_id BIGINT COMMENT 'Member ID' ,rev_or_push_or_rel_id BIGINT COMMENT 'ID of the review, push, or release' ,ref STRING COMMENT 'Name of the created or deleted resource' ,ref_type STRING COMMENT 'Type of the created or deleted resource' ,state STRING COMMENT 'Status of the issue, pull request, or pull request review' ,author_association STRING COMMENT 'Relationship between the actor and the repository' ,language STRING COMMENT 'Language of the code in the pull request' ,merged BOOLEAN COMMENT 'Indicates whether the pull request was merged' ,merged_at DATETIME COMMENT 'Time when the code was merged' ,additions BIGINT COMMENT 'Number of added lines of code' ,deletions BIGINT COMMENT 'Number of deleted lines of code' ,changed_files BIGINT COMMENT 'Number of files changed in the pull request' ,push_size BIGINT COMMENT 'Number of commits' ,push_distinct_size BIGINT COMMENT 'Number of distinct commits' ,hr STRING COMMENT 'Hour when the event occurred. For example, if the event occurred at 00:23, the value of hr is 00.' ,`month` STRING COMMENT 'Month when the event occurred. For example, if the event occurred in October 2015, the value of month is 2015-10.' ,`year` STRING COMMENT 'Year when the event occurred. For example, if the event occurred in 2015, the value of year is 2015.' ) PARTITIONED BY ( ds STRING COMMENT 'Date when the event occurred, in the yyyy-mm-dd format.' ); -
JSON verilerini ayrıştırın ve fact tablosuna yazın.
Bölümleri eklemek JSON verilerini ayrıştırmak ve verileri
dwd_github_events_odpstablosuna yazmak için aşağıdaki komutu çalıştırın:msck repair table githubevents add partitions; set odps.sql.hive.compatible = true; set odps.sql.split.hive.bridge = true; INSERT into TABLE dwd_github_events_odps PARTITION(ds) SELECT CAST(GET_JSON_OBJECT(col,'$.id') AS BIGINT ) AS id ,CAST(GET_JSON_OBJECT(col,'$.actor.id')AS BIGINT) AS actor_id ,GET_JSON_OBJECT(col,'$.actor.login') AS actor_login ,CAST(GET_JSON_OBJECT(col,'$.repo.id')AS BIGINT) AS repo_id ,GET_JSON_OBJECT(col,'$.repo.name') AS repo_name ,CAST(GET_JSON_OBJECT(col,'$.org.id')AS BIGINT) AS org_id ,GET_JSON_OBJECT(col,'$.org.login') AS org_login ,GET_JSON_OBJECT(col,'$.type') as type ,to_date(GET_JSON_OBJECT(col,'$.created_at'), 'yyyy-mm-ddThh:mi:ssZ') AS created_at ,GET_JSON_OBJECT(col,'$.payload.action') AS action ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.id')AS BIGINT) END AS iss_or_pr_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.number')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.issue.number')AS BIGINT) ELSE CAST(GET_JSON_OBJECT(col,'$.payload.number')AS BIGINT) END AS number ,CAST(GET_JSON_OBJECT(col,'$.payload.comment.id')AS BIGINT) AS comment_id ,GET_JSON_OBJECT(col,'$.payload.comment.commit_id') AS commit_id ,CAST(GET_JSON_OBJECT(col,'$.payload.member.id')AS BIGINT) AS member_id ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.review.id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="PushEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.push_id')AS BIGINT) WHEN GET_JSON_OBJECT(col,'$.type')="ReleaseEvent" THEN CAST(GET_JSON_OBJECT(col,'$.payload.release.id')AS BIGINT) END AS rev_or_push_or_rel_id ,GET_JSON_OBJECT(col,'$.payload.ref') AS ref ,GET_JSON_OBJECT(col,'$.payload.ref_type') AS ref_type ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.state') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.state') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.state') END AS state ,case WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestEvent" THEN GET_JSON_OBJECT(col,'$.payload.pull_request.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssuesEvent" THEN GET_JSON_OBJECT(col,'$.payload.issue.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="IssueCommentEvent" THEN GET_JSON_OBJECT(col,'$.payload.comment.author_association') WHEN GET_JSON_OBJECT(col,'$.type')="PullRequestReviewEvent" THEN GET_JSON_OBJECT(col,'$.payload.review.author_association') END AS author_association ,GET_JSON_OBJECT(col,'$.payload.pull_request.base.repo.language') AS language ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.merged') AS BOOLEAN) AS merged ,to_date(GET_JSON_OBJECT(col,'$.payload.pull_request.merged_at'), 'yyyy-mm-ddThh:mi:ssZ') AS merged_at ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.additions')AS BIGINT) AS additions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.deletions')AS BIGINT) AS deletions ,CAST(GET_JSON_OBJECT(col,'$.payload.pull_request.changed_files')AS BIGINT) AS changed_files ,CAST(GET_JSON_OBJECT(col,'$.payload.size')AS BIGINT) AS push_size ,CAST(GET_JSON_OBJECT(col,'$.payload.distinct_size')AS BIGINT) AS push_distinct_size ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),12,2) as hr ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,7),'/','-') as month ,SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,4) as year ,REPLACE(SUBSTR(GET_JSON_OBJECT(col,'$.created_at'),1,10),'/','-') as ds from githubevents where hr = cast(to_char(dateadd(getdate(),-9,'hh'), 'yyyy-mm-dd-hh') as string); -
Verileri sorgulayın.
dwd_github_events_odpstablosundan veri sorgulamak için aşağıdaki komutu çalıştırın:SET odps.sql.allow.fullscan=true; SELECT * FROM dwd_github_events_odps where ds = '2023-03-31' limit 10;Aşağıdaki örnek sonuç döner:
Sonuç aşağıdaki alanları içerir:
id: Etkinlik Kimliğiactor_id/actor_login: Kullanıcı Kimliği ve kullanıcı adırepo_id/repo_name: Depo Kimliği ve depo adıorg_id/org_login: Organizasyon Kimliği ve organizasyon adı (bazı etkinlikler için boş)type: Etkinlik türü (CreateEvent PushEvent DeleteEvent PullRequestReviewEvent gibi)created_at: Oluşturma zamanıaction: Eylem türü
Gerçek zamanlı veri ambarı oluşturma
ECS kullanarak gerçek zamanlı verileri elde etme
GitHub API'sinden gerçek zamanlı etkinlik verilerini çıkarmak için bir Elastic Compute Service (ECS) örneği kullanın. Aşağıdaki örnek betik GitHub API'sinden gerçek zamanlı verilerin nasıl toplanacağını gösterir.
Betik her çalıştırıldığında 1 dakika boyunca çalışır. Bu süre zarfında API tarafından sağlanan gerçek zamanlı etkinlik verilerini toplar ve her etkinliği JSON formatında saklar.
Bu betik tüm gerçek zamanlı etkinlik verilerinin toplandığını garanti etmez.
GitHub API'sinden sürekli olarak veri toplamak için Accept ve Authorization üstbilgilerini sağlayın. Accept değeri sabittir. Authorization için GitHub'dan aldığınız kişisel erişim belirtecini girin. Kişisel erişim belirteci oluşturma hakkında daha fazla bilgi için bkz. bu dokümantasyon.
-
/opt/realtimedizinindedownload_realtime_data.pyadlı bir dosya oluşturmak için aşağıdaki komutları çalıştırın.cd /opt/realtime vim download_realtime_data.py -
Düzenleme moduna girmek için
ituşuna basın ve dosyaya aşağıdaki örnek içeriği ekleyin.#!python import requests import json import sys import time # Get the API URL def get_next_link(resp): resp_link = resp.headers['link'] link = '' for l in resp_link.split(', '): link = l.split('; ')[0][1:-1] rel = l.split('; ')[1] if rel == 'rel="next"': return link return None # Collect one page of data from the API def download(link, fname): # Define the Accept and Authorization headers for the GitHub API headers = {"Accept": "application/vnd.github+json","Authorization": "<Bearer> <github_api_token>"} resp = requests.get(link, headers=headers) if int(resp.status_code) != 200: return None with open(fname, 'a') as f: for j in resp.json(): f.write(json.dumps(j)) f.write('\n') print('downloaded {} events to {}'.format(len(resp.json()), fname)) return resp # Collect multiple pages of data from the API def download_all_data(fname): link = 'https://api.github.com/events?per_page=100&page=1' while True: resp = download(link, fname) if resp is None: break link = get_next_link(resp) if link is None: break # Define the current time def get_current_ms(): return round(time.time()*1000) # Define the script execution duration as 1 minute def main(fname): current_ms = get_current_ms() while get_current_ms() - current_ms < 60*1000: download_all_data(fname) time.sleep(0.1) # Run the script if __name__ == '__main__': if len(sys.argv) < 2: print('usage: python {} <log_file>'.format(sys.argv[0])) exit(0) main(sys.argv[1]) -
Esc tuşuna basın
:wqyazın ve dosyayı kaydedip kapatmak için Enter tuşuna basın. -
download_realtime_data.pydosyasını çalıştırmak ve her çalıştırmada toplanan verileri ayrı ayrı depolamak için birrun_py.shdosyası oluşturun. İçerik aşağıdaki gibidir.python /opt/realtime/download_realtime_data.py /opt/realtime/gh_realtime_data/$(date '+%Y-%m-%d-%H:%M:%S').json -
Geçmiş verileri silmek için bir
delete_log.shdosyası oluşturun. İçerik aşağıdaki gibidir.d=$(TZ=UTC date --date='2 day ago' '+%Y-%m-%d') rm -f /opt/realtime/gh_realtime_data/*${d}*.json -
GitHub verilerini her dakika toplamak ve geçmiş verileri her gün silmek için aşağıdaki komutları çalıştırın.
#1. Run the following command and press I to enter edit mode.
crontab -e

#2. Add the following commands. Then, press Esc, enter :wq, and press Enter to exit.
* * * * * bash /opt/realtime/run_py.sh
1 1 * * * bash /opt/realtime/delete_log.sh
SLS kullanarak ECS verilerini toplama
Simple Log Service (SLS) ECS örneğinden gelen gerçek zamanlı etkinlik verilerini günlük olarak toplar.
SLS Logtail kullanarak ECS örneklerinden günlük toplamayı destekler. Veriler JSON formatında olduğundan ECS örneğinden artımlı JSON günlüklerini hızlı bir şekilde toplamak için Logtail'in JSON modunu kullanabilirsiniz. Daha fazla bilgi için bkz. JSON modunda günlük toplama. Bu konuda SLS ham verilerin üst düzey anahtar-değer çiftlerini ayrıştıracak şekilde yapılandırılmıştır.
Bu örnekte Logtail yapılandırması için günlük yolu parametresi /opt/realtime/gh_realtime_data/**/*.json olarak ayarlanmıştır.
Yapılandırma tamamlandıktan sonra SLS ECS örneğinden artımlı etkinlik verilerini sürekli olarak toplar. Toplanan günlük verilerini SLS konsolunun Raw Logs sekmesinde görüntüleyebilirsiniz. Her günlük girişi actor created_at id org payload public repo ve type gibi ayrıştırılmış üst düzey alanları içerir.
Flink kullanarak SLS verilerini gerçek zamanlı olarak Hologres'e yazma
Flink SLS tarafından toplanan günlük verilerini gerçek zamanlı olarak Hologres'e yazar. Flink'te bir SLS kaynak tablosu ve bir Hologres sonuç tablosu kullanarak verileri SLS'den Hologres'e akıtabilirsiniz. Daha fazla bilgi için bkz. Simple Log Service'den veri aktarma.
-
Bir Hologres iç tablosu oluşturun.
İç tablo ham JSON verilerinden yalnızca bazı anahtar-değer çiftlerini saklar. Etkinlik
idve tarihdsbirincil anahtar olarak ayarlanır. Etkinlikiddağıtım anahtarı olarak ayarlanır. Tarihdsbölümleme anahtarı olarak ayarlanır. Etkinlik zamanıcreated_atevent_time_column olarak ayarlanır. Diğer alanlar için gerektiğinde indeksler oluşturabilirsiniz. İndeksler hakkında daha fazla bilgi için bkz. CREATE TABLE. Bu örnekte tabloyu oluşturmak için aşağıdaki Veri Tanımlama Dili (DDL) ifadesi kullanılır.DROP TABLE IF EXISTS gh_realtime_data; BEGIN; CREATE TABLE gh_realtime_data ( id bigint, actor_id bigint, actor_login text, repo_id bigint, repo_name text, org_id bigint, org_login text, type text, created_at timestamp with time zone NOT NULL, action text, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id text, member_id bigint, rev_or_push_or_rel_id bigint, ref text, ref_type text, state text, author_association text, language text, merged boolean, merged_at timestamp with time zone, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr text, month text, year text, ds text, PRIMARY KEY (id,ds) ) PARTITION BY LIST (ds); CALL set_table_property('public.gh_realtime_data', 'distribution_key', 'id'); CALL set_table_property('public.gh_realtime_data', 'event_time_column', 'created_at'); CALL set_table_property('public.gh_realtime_data', 'clustering_key', 'created_at'); COMMENT ON COLUMN public.gh_realtime_data.id IS 'Event ID'; COMMENT ON COLUMN public.gh_realtime_data.actor_id IS 'ID of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.actor_login IS 'Logon name of the event initiator'; COMMENT ON COLUMN public.gh_realtime_data.repo_id IS 'repo ID'; COMMENT ON COLUMN public.gh_realtime_data.repo_name IS 'repo name'; COMMENT ON COLUMN public.gh_realtime_data.org_id IS 'ID of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.org_login IS 'Name of the organization to which the repo belongs'; COMMENT ON COLUMN public.gh_realtime_data.type IS 'Event type'; COMMENT ON COLUMN public.gh_realtime_data.created_at IS 'Time when the event occurred'; COMMENT ON COLUMN public.gh_realtime_data.action IS 'Event action'; COMMENT ON COLUMN public.gh_realtime_data.iss_or_pr_id IS 'issue/pull_request ID'; COMMENT ON COLUMN public.gh_realtime_data.number IS 'issue/pull_request number'; COMMENT ON COLUMN public.gh_realtime_data.comment_id IS 'comment ID'; COMMENT ON COLUMN public.gh_realtime_data.commit_id IS 'Commit ID'; COMMENT ON COLUMN public.gh_realtime_data.member_id IS 'Member ID'; COMMENT ON COLUMN public.gh_realtime_data.rev_or_push_or_rel_id IS 'review/push/release ID'; COMMENT ON COLUMN public.gh_realtime_data.ref IS 'Name of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.ref_type IS 'Type of the created or deleted resource'; COMMENT ON COLUMN public.gh_realtime_data.state IS 'Status of the issue/pull_request/pull_request_review'; COMMENT ON COLUMN public.gh_realtime_data.author_association IS 'Relationship between the actor and the repo'; COMMENT ON COLUMN public.gh_realtime_data.language IS 'Programming language'; COMMENT ON COLUMN public.gh_realtime_data.merged IS 'Specifies whether the merge is accepted'; COMMENT ON COLUMN public.gh_realtime_data.merged_at IS 'Time when the code was merged'; COMMENT ON COLUMN public.gh_realtime_data.additions IS 'Number of added lines of code'; COMMENT ON COLUMN public.gh_realtime_data.deletions IS 'Number of deleted lines of code'; COMMENT ON COLUMN public.gh_realtime_data.changed_files IS 'Number of files changed in the pull request'; COMMENT ON COLUMN public.gh_realtime_data.push_size IS 'Number of pushes'; COMMENT ON COLUMN public.gh_realtime_data.push_distinct_size IS 'Number of distinct pushes'; COMMENT ON COLUMN public.gh_realtime_data.hr IS 'The hour when the event occurred. For example, if the time is 00:23, hr=00.'; COMMENT ON COLUMN public.gh_realtime_data.month IS 'The month when the event occurred. For example, if the date is October 2015, month=2015-10.'; COMMENT ON COLUMN public.gh_realtime_data.year IS 'The year when the event occurred. For example, if the year is 2015, year=2015.'; COMMENT ON COLUMN public.gh_realtime_data.ds IS 'The day when the event occurred. ds=yyyy-mm-dd.'; COMMIT; -
Verileri Flink kullanarak gerçek zamanlı olarak yazın.
SLS verilerini ayrıştırmak ve gerçek zamanlı olarak Hologres'e yazmak için Flink'i kullanın. Aşağıdaki Flink ifadeleri verileri filtreler: etkinlik kimliği veya etkinlik zamanı (
created_at) null olan hatalı veriler atılır ve yalnızca son etkinlik verileri saklanır.CREATE TEMPORARY TABLE sls_input ( actor varchar, created_at varchar, id bigint, org varchar, payload varchar, public varchar, repo varchar, type varchar ) WITH ( 'connector' = 'sls', 'endpoint' = '<endpoint>',--The private endpoint of SLS 'accessid' = '<accesskey id>',--The AccessKey ID of your account 'accesskey' = '<accesskey secret>',--The AccessKey secret of your account 'project' = '<project name>',--The name of the SLS project 'logstore' = '<logstore name>'--The name of the SLS Logstore 'starttime' = '2023-04-06 00:00:00',--The start time for SLS data collection ); CREATE TEMPORARY TABLE hologres_sink ( id bigint, actor_id bigint, actor_login string, repo_id bigint, repo_name string, org_id bigint, org_login string, type string, created_at timestamp, action string, iss_or_pr_id bigint, number bigint, comment_id bigint, commit_id string, member_id bigint, rev_or_push_or_rel_id bigint, `ref` string, ref_type string, state string, author_association string, `language` string, merged boolean, merged_at timestamp, additions bigint, deletions bigint, changed_files bigint, push_size bigint, push_distinct_size bigint, hr string, `month` string, `year` string, ds string ) WITH ( 'connector' = 'hologres', 'dbname' = '<hologres dbname>', --The name of the Hologres database 'tablename' = '<hologres tablename>', --The name of the Hologres table that receives data 'username' = '<accesskey id>', --The AccessKey ID of the current Alibaba Cloud account 'password' = '<accesskey secret>', --The AccessKey Secret of the current Alibaba Cloud account 'endpoint' = '<endpoint>', --The VPC endpoint of the current Hologres instance 'jdbcretrycount' = '1', --The number of retries upon connection failure 'partitionrouter' = 'true', --Specifies whether to write data to a partitioned table 'createparttable' = 'true', --Specifies whether to automatically create partitions 'mutatetype' = 'insertorignore' --The data writing mode ); INSERT INTO hologres_sink SELECT id ,CAST(JSON_VALUE(actor, '$.id') AS bigint) AS actor_id ,JSON_VALUE(actor, '$.login') AS actor_login ,CAST(JSON_VALUE(repo, '$.id') AS bigint) AS repo_id ,JSON_VALUE(repo, '$.name') AS repo_name ,CAST(JSON_VALUE(org, '$.id') AS bigint) AS org_id ,JSON_VALUE(org, '$.login') AS org_login ,type ,TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS created_at ,JSON_VALUE(payload, '$.action') AS action ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.id') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.id') AS bigint) END AS iss_or_pr_id ,CASE WHEN type='PullRequestEvent' THEN CAST(JSON_VALUE(payload, '$.pull_request.number') AS bigint) WHEN type='IssuesEvent' THEN CAST(JSON_VALUE(payload, '$.issue.number') AS bigint) ELSE CAST(JSON_VALUE(payload, '$.number') AS bigint) END AS number ,CAST(JSON_VALUE(payload, '$.comment.id') AS bigint) AS comment_id ,JSON_VALUE(payload, '$.comment.commit_id') AS commit_id ,CAST(JSON_VALUE(payload, '$.member.id') AS bigint) AS member_id ,CASE WHEN type='PullRequestReviewEvent' THEN CAST(JSON_VALUE(payload, '$.review.id') AS bigint) WHEN type='PushEvent' THEN CAST(JSON_VALUE(payload, '$.push_id') AS bigint) WHEN type='ReleaseEvent' THEN CAST(JSON_VALUE(payload, '$.release.id') AS bigint) END AS rev_or_push_or_rel_id ,JSON_VALUE(payload, '$.ref') AS `ref` ,JSON_VALUE(payload, '$.ref_type') AS ref_type ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.state') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.state') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.state') END AS state ,CASE WHEN type='PullRequestEvent' THEN JSON_VALUE(payload, '$.pull_request.author_association') WHEN type='IssuesEvent' THEN JSON_VALUE(payload, '$.issue.author_association') WHEN type='IssueCommentEvent' THEN JSON_VALUE(payload, '$.comment.author_association') WHEN type='PullRequestReviewEvent' THEN JSON_VALUE(payload, '$.review.author_association') END AS author_association ,JSON_VALUE(payload, '$.pull_request.base.repo.language') AS `language` ,CAST(JSON_VALUE(payload, '$.pull_request.merged') AS boolean) AS merged ,TO_TIMESTAMP_TZ(replace(JSON_VALUE(payload, '$.pull_request.merged_at'),'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC') AS merged_at ,CAST(JSON_VALUE(payload, '$.pull_request.additions') AS bigint) AS additions ,CAST(JSON_VALUE(payload, '$.pull_request.deletions') AS bigint) AS deletions ,CAST(JSON_VALUE(payload, '$.pull_request.changed_files') AS bigint) AS changed_files ,CAST(JSON_VALUE(payload, '$.size') AS bigint) AS push_size ,CAST(JSON_VALUE(payload, '$.distinct_size') AS bigint) AS push_distinct_size ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),12,2) as hr ,REPLACE(SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,7),'/','-') as `month` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,4) as `year` ,SUBSTRING(TO_TIMESTAMP_TZ(replace(created_at,'T',' '), 'yyyy-MM-dd HH:mm:ss', 'UTC'),1,10) as ds FROM sls_input WHERE id IS NOT NULL AND created_at IS NOT NULL AND to_date(replace(created_at,'T',' ')) >= date_add(CURRENT_DATE, -1);Parametreler hakkında daha fazla bilgi için bkz. Simple Log Service (SLS) ve Hologres.
NotGitHub'dan gelen ham etkinlik verileri UTC saat dilimini kullanır ve bir saat dilimi özniteliğine sahip değildir. Hologres için varsayılan saat dilimi UTC+8'dir. Bu nedenle Flink'ten Hologres'e gerçek zamanlı olarak veri yazarken saat dilimini ayarlamanız gerekir. Flink SQL'de kaynak tablo verilerine UTC saat dilimi özniteliği atayın. Adımlar aşağıdaki gibidir:
Adım 1: İş düzenleme sayfasına gidin
Realtime Compute for Apache Flink console adresinde oturum açın
Hedef workspace adresine gidin
Flink SQL veya JAR işinizi bulun ve Edit seçeneğine tıklayın
Adım 2: Deployment Details sekmesini açın
⚠️ Önemli değişiklik: "Flink Configuration" artık ayrı bir bölüm değildir. "Deployment Details" ile birleştirilmiştir.
İş düzenleme sayfasının üst kısmında Deployment Details sekmesine geçin.
Parameter Configuration bölümüne doğru aşağı kaydırın.
Adım 3: Özel bir yapılandırma ekleyin
Parameter Configuration öğesinin sağındaki Edit düğmesine tıklayın.
Açılan iletişim kutusunda Other Configuration metin kutusunu bulun.
Metin kutusuna Flink sistem saat dilimini
Asia/Shanghaiolarak ayarlamak içintable.local-time-zone:Asia/ShanghaiFlink parametresini bir anahtar-değer çifti olarak ekleyin.
-
Verileri sorgulayın.
Flink aracılığıyla Hologres'e yazılan SLS verilerini sorgulayın ardından ihtiyaç duyduğunuz şekilde veri geliştirme işlemleri gerçekleştirin.
SELECT * FROM public.gh_realtime_data limit 10;Sorgu sonucu aşağıdaki alanları döndürür:
idactor_idactor_loginrepo_idrepo_nameorg_idorg_logintype(etkinlik türü; PullRequestReviewEvent CreateEvent PushEvent PullRequestEvent gibi)created_atactioniss_or_pr_id
Çevrimdışı verileri kullanarak gerçek zamanlı verileri düzeltme
Bu senaryoda gerçek zamanlı veriler eksik olabilir. Gerçek zamanlı verileri düzeltmek için çevrimdışı verileri kullanabilirsiniz. Aşağıdaki adımlar önceki günün gerçek zamanlı verilerinin nasıl düzeltileceğini gösterir. Düzeltme dönemini gerektiği şekilde ayarlayın.
-
MaxCompute çevrimdışı verilerini elde etmek için Hologres'te bir yabancı tablo oluşturun.
IMPORT FOREIGN SCHEMA <maxcompute_project_name> LIMIT to
(
    <foreign_table_name>
)
FROM SERVER odps_server INTO public OPTIONS(if_table_exist 'update',if_unsupported_type 'error');
Parametreler hakkında daha fazla bilgi için bkz. IMPORT FOREIGN SCHEMA.
-
Önceki günün gerçek zamanlı verilerini çevrimdışı verilerle düzeltmek için geçici bir tablo oluşturun.
NotHologres V2.1.17 ve sonraki sürümler Serverless Computing'i destekler. Büyük ölçekli çevrimdışı veri aktarımı büyük ETL işleri ve yabancı tablolarda yüksek hacimli sorgular gibi senaryolar için bu görevleri çalıştırmak üzere Serverless Computing'i kullanabilirsiniz. Bu özellik örnek kaynaklarınız yerine ek sunucusuz kaynaklar kullanır; bu da örnek kararlılığını artırır ve bellek yetersizliği (OOM) hatalarının oluşma olasılığını azaltır. Örneğiniz için ekstra hesaplama kaynakları ayırmanız gerekmez ve yalnızca çalıştırdığınız görevler için ücretlendirilirsiniz. Serverless Computing hakkında daha fazla bilgi için bkz. Serverless Computing. Serverless Computing'in nasıl kullanılacağına ilişkin talimatlar için bkz. Serverless Computing Kullanma.
-- Clean up potential temporary tables
DROP TABLE IF EXISTS gh_realtime_data_tmp;

-- Create a temporary table
SET hg_experimental_enable_create_table_like_properties = ON;
CALL HG_CREATE_TABLE_LIKE ('gh_realtime_data_tmp', 'select * from gh_realtime_data');

-- (Optional) Use Serverless Computing to perform large-scale offline data import and ETL jobs.
SET hg_computing_resource = 'serverless';

-- Insert data into the temporary table and update statistics
INSERT INTO gh_realtime_data_tmp
SELECT
    *
FROM
    <foreign_table_name>
WHERE
    ds = current_date - interval '1 day'
ON CONFLICT (id, ds)
    DO NOTHING;
ANALYZE gh_realtime_data_tmp;

-- Reset the configuration to ensure that non-essential SQL statements do not use Serverless resources.
RESET hg_computing_resource;

-- Replace the atomic table with the existing temporary child table
BEGIN;
DROP TABLE IF EXISTS "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data_tmp RENAME TO "gh_realtime_data_<yesterday_date>";
ALTER TABLE gh_realtime_data ATTACH PARTITION "gh_realtime_data_<yesterday_date>" FOR VALUES IN ('<yesterday_date>');
COMMIT;
Veri analizi
Toplanan veriler üzerinde çok çeşitli analizler yapabilirsiniz. İşletmenizin gerektirdiği zaman aralığına bağlı olarak gerçek zamanlı analizi çevrimdışı analizi ve entegre gerçek zamanlı/çevrimdışı analizi desteklemek için veri ambarınızı katmanlı olarak tasarlayın.
Aşağıdaki örnekler gerçek zamanlı verileri analiz eder. Belirli kod depoları veya geliştiriciler için de veri analizi yapabilirsiniz.
-
Bugünkü genel etkinliklerin toplam sayısını sorgulayın.
SELECT
    count(*)
FROM
    gh_realtime_data
WHERE
    created_at >= date_trunc('day', now());
Aşağıda örnek bir sonuç gösterilmektedir:
count ------ 1006 -
Son bir günde en aktif projeleri (en çok etkinliğe sahip) sorgulayın.
SELECT
    repo_name,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
GROUP BY
    repo_name
ORDER BY
    events DESC
LIMIT 5;
Aşağıda örnek bir sonuç gösterilmektedir:
repo_name events ----------------------------------------+------ leo424y/heysiri.ml 29 arm-on/plan 10 Christoffel-T/fiverr-pat-20230331 9 mate-academy/react_dynamic-list-of-goods 9 openvinotoolkit/openvino 7 -
Son bir günde en aktif geliştiricileri (en çok etkinliğe sahip) sorgulayın.
SELECT
    actor_login,
    COUNT(*) AS events
FROM
    gh_realtime_data
WHERE
    created_at >= now() - interval '1 day'
    AND actor_login NOT LIKE '%[bot]'
GROUP BY
    actor_login
ORDER BY
    events DESC
LIMIT 5;
Aşağıda örnek bir sonuç gösterilmektedir:
actor_login events ------------------+------ direwolf-github 13 arm-on 10 sergii-nosachenko 9 Christoffel-T 9 yangwang201911 7 -
Son bir saatte en popüler programlama dillerinin sıralamasını sorgulayın.
SELECT
    language,
    count(*) total
FROM
    gh_realtime_data
WHERE
    created_at > now() - interval '1 hour'
    AND language IS NOT NULL
GROUP BY
    language
ORDER BY
    total DESC
LIMIT 10;
Aşağıda örnek bir sonuç gösterilmektedir:
language total -----------+---- JavaScript 25 C++ 15 Python 14 TypeScript 13 Java 8 PHP 8 -
Son bir günde alınan yıldız sayısına göre projelerin sıralamasını sorgulayın.
NotBu örnek kullanıcıların bir projeden yıldızı kaldırma durumlarını dikkate almaz.
SELECT
    repo_id,
    repo_name,
    COUNT(actor_login) total
FROM
    gh_realtime_data
WHERE
    type = 'WatchEvent'
    AND created_at > now() - interval '1 day'
GROUP BY
    repo_id,
    repo_name
ORDER BY
    total DESC
LIMIT 10;
Aşağıda örnek bir sonuç gösterilmektedir:
repo_id repo_name total ---------+----------------------------------+----- 618058471 facebookresearch/segment-anything 4 619959033 nomic-ai/gpt4all 1 97249406 denysdovhan/wtfjs 1 9791525 digininja/DVWA 1 168118422 aylei/interview 1 343520006 joehillen/sysz 1 162279822 agalwood/Motrix 1 577723410 huggingface/swift-coreml-diffusers 1 609539715 e2b-dev/e2b 1 254839429 maniackk/KKCallStack 1 -
Bugünkü günlük aktif kullanıcıları ve projeleri sorgulayın.
SELECT
    uniq (actor_id) actor_num,
    uniq (repo_id) repo_num
FROM
    gh_realtime_data
WHERE
    created_at > date_trunc('day', now());
Aşağıda örnek bir sonuç gösterilmektedir:
actor_num	repo_num
---------+--------
743	      816