在應用正式部署上線前,評估應用在自身業務情境上的效果至關重要。LangStudio提供一站式應用評測能力,能從不同維度(評測模板)對應用評分。
簡介
LangStudio提供一站式應用評測能力。您只需要完成評測資料集、應用輸入映射等配置,並按需選擇評測模板,即可提交應用評測任務。整個評測流程包括:使用應用批量處理評測資料集中的每一行,得到輸出。然後結合評測資料集中的輔助欄位,評價每條輸出的優劣。最後匯總得分以展示應用在指定資料集上的精度。

準備工作
已建立應用並完成調試。操作詳情,請參見工作流程應用開發。
將已準備好的評測資料集上傳至OSS,檔案格式為JSONL,樣本內容如下:
{"history":[],"query": "描述華山的險峻威嚴", "reference": "華嶽獨秀,挺拔雲霄; \n峭壁削天,巉岩峻俏。 \n蒼松翠竹,鬥壁爭嬌; \n猿啼鷹飛,霜劍光照。 \n\n危峰如剪,嵯峨劍指; \n徑細坡陡,無路藤繞。 \n風腥霧織,雲出岫交; \n仙境幽深,天梯難繞。 \n\n岩稜交錯,龍脈翻湧; \n險途更引,淩霄曲折。 \n寂寞松梢,鷹擊長空; \n華山之巔,雄姿英發。", "contexts": ["華山是五嶽之一", "華山以其險峻聞名"]} {"history":[],"query": "可以列出5樣稀有金屬嗎?請按全球需求來排名", "reference": "稀有金屬指的是地殼中含量較少、分布不均或開採困難的金屬元素,它們在高科技領域和新興工業中扮演著非常重要的角色。全球需求的排序可能因時間和技術進步而變化,但以下是通常被廣泛需求的一些稀有金屬(不一定按絕對的需求量排名,因為這在不同時間點可能不同):\n\n1. **鈷(Cobalt, Co)** - 鈷是鋰離子電池的關鍵成分之一,尤其是在電動汽車和攜帶型電子產品中。此外,它也被應用於耐熱合金、硬質合金以及催化劑的製造。\n\n2. **釹(Neodymium, Nd)** - 釹是一種稀土金屬,主要用於強磁體的生產,比如高效能的永磁體,這些永磁體廣泛用於電腦硬碟、風力渦輪機和電動汽車的驅動電機中。\n\n3. **鋰(Lithium, Li)** - 鋰主要用於鋰電池的製造,隨著電動車和攜帶型電子裝置的需求增加,鋰的需求量迅速上升。\n\n4. **銀(Silver, Ag)** - 雖然銀不像上述金屬那樣稀有,但其在工業中的需求量巨大,主要用於電子產品、太陽能面板、珠寶和貨幣製造等領域。\n\n5. **釕(Ruthenium, Ru)** - 釕是一種稀有貴金屬,被廣泛使用在硬碟的資料儲存及大容量伺服器中,同時也用在催化劑和電化學電池中。\n\n這些金屬的需求量受到了全球經濟、科技發展和政策支援等多方面因素的影響。而且隨著時間的推移和市場的變化,其他稀有金屬如鉭、銦、錸以及其他的稀土金屬,也可能出現在最受需求的稀有金屬列表中。", "contexts": ["稀有金屬是指地殼中含量較低、開採和提取較為複雜的金屬", "鋰 (Li):被用於電池製造", "鈷 (Co):用於高效能合金和電池製造"]}建立評測所需的LLM串連。操作詳情,請參見串連配置。
註:部分評測模板需要依賴球證模型,因此需要配置LLM串連。
計費說明
應用評測功能會使用OSS儲存評測資料集,並通過PAI-DLC執行離線評測任務,因此會產生資源使用費用。詳情請參見OSS計費概述和分布式訓練(DLC)計費說明。
建立應用評測任務
在應用開發頁面完成調試後,單擊右上方评测,建立應用評測任務。

關鍵參數說明:
參數 | 說明 |
評測資料集 | |
OSS檔案 | 從OSS上選擇一個JSONL格式的評測資料集檔案。該資料集應包含“問題”以及評測所需的其他欄位,其中“問題”欄位作為應用流的輸入,其他必要欄位用於計算指標得分,詳情請參見附錄:預置評測模板說明中關於“輸入欄位”的介紹。 |
應用輸入映射 | |
question/chat_history | 選擇應用啟動並執行輸入欄位。 註:在應用評測前需要先完成應用的推理,然後基於推理結果運行後續的評測任務,因此需要先選擇應用運行需要的輸入欄位。
|
評測配置 | |
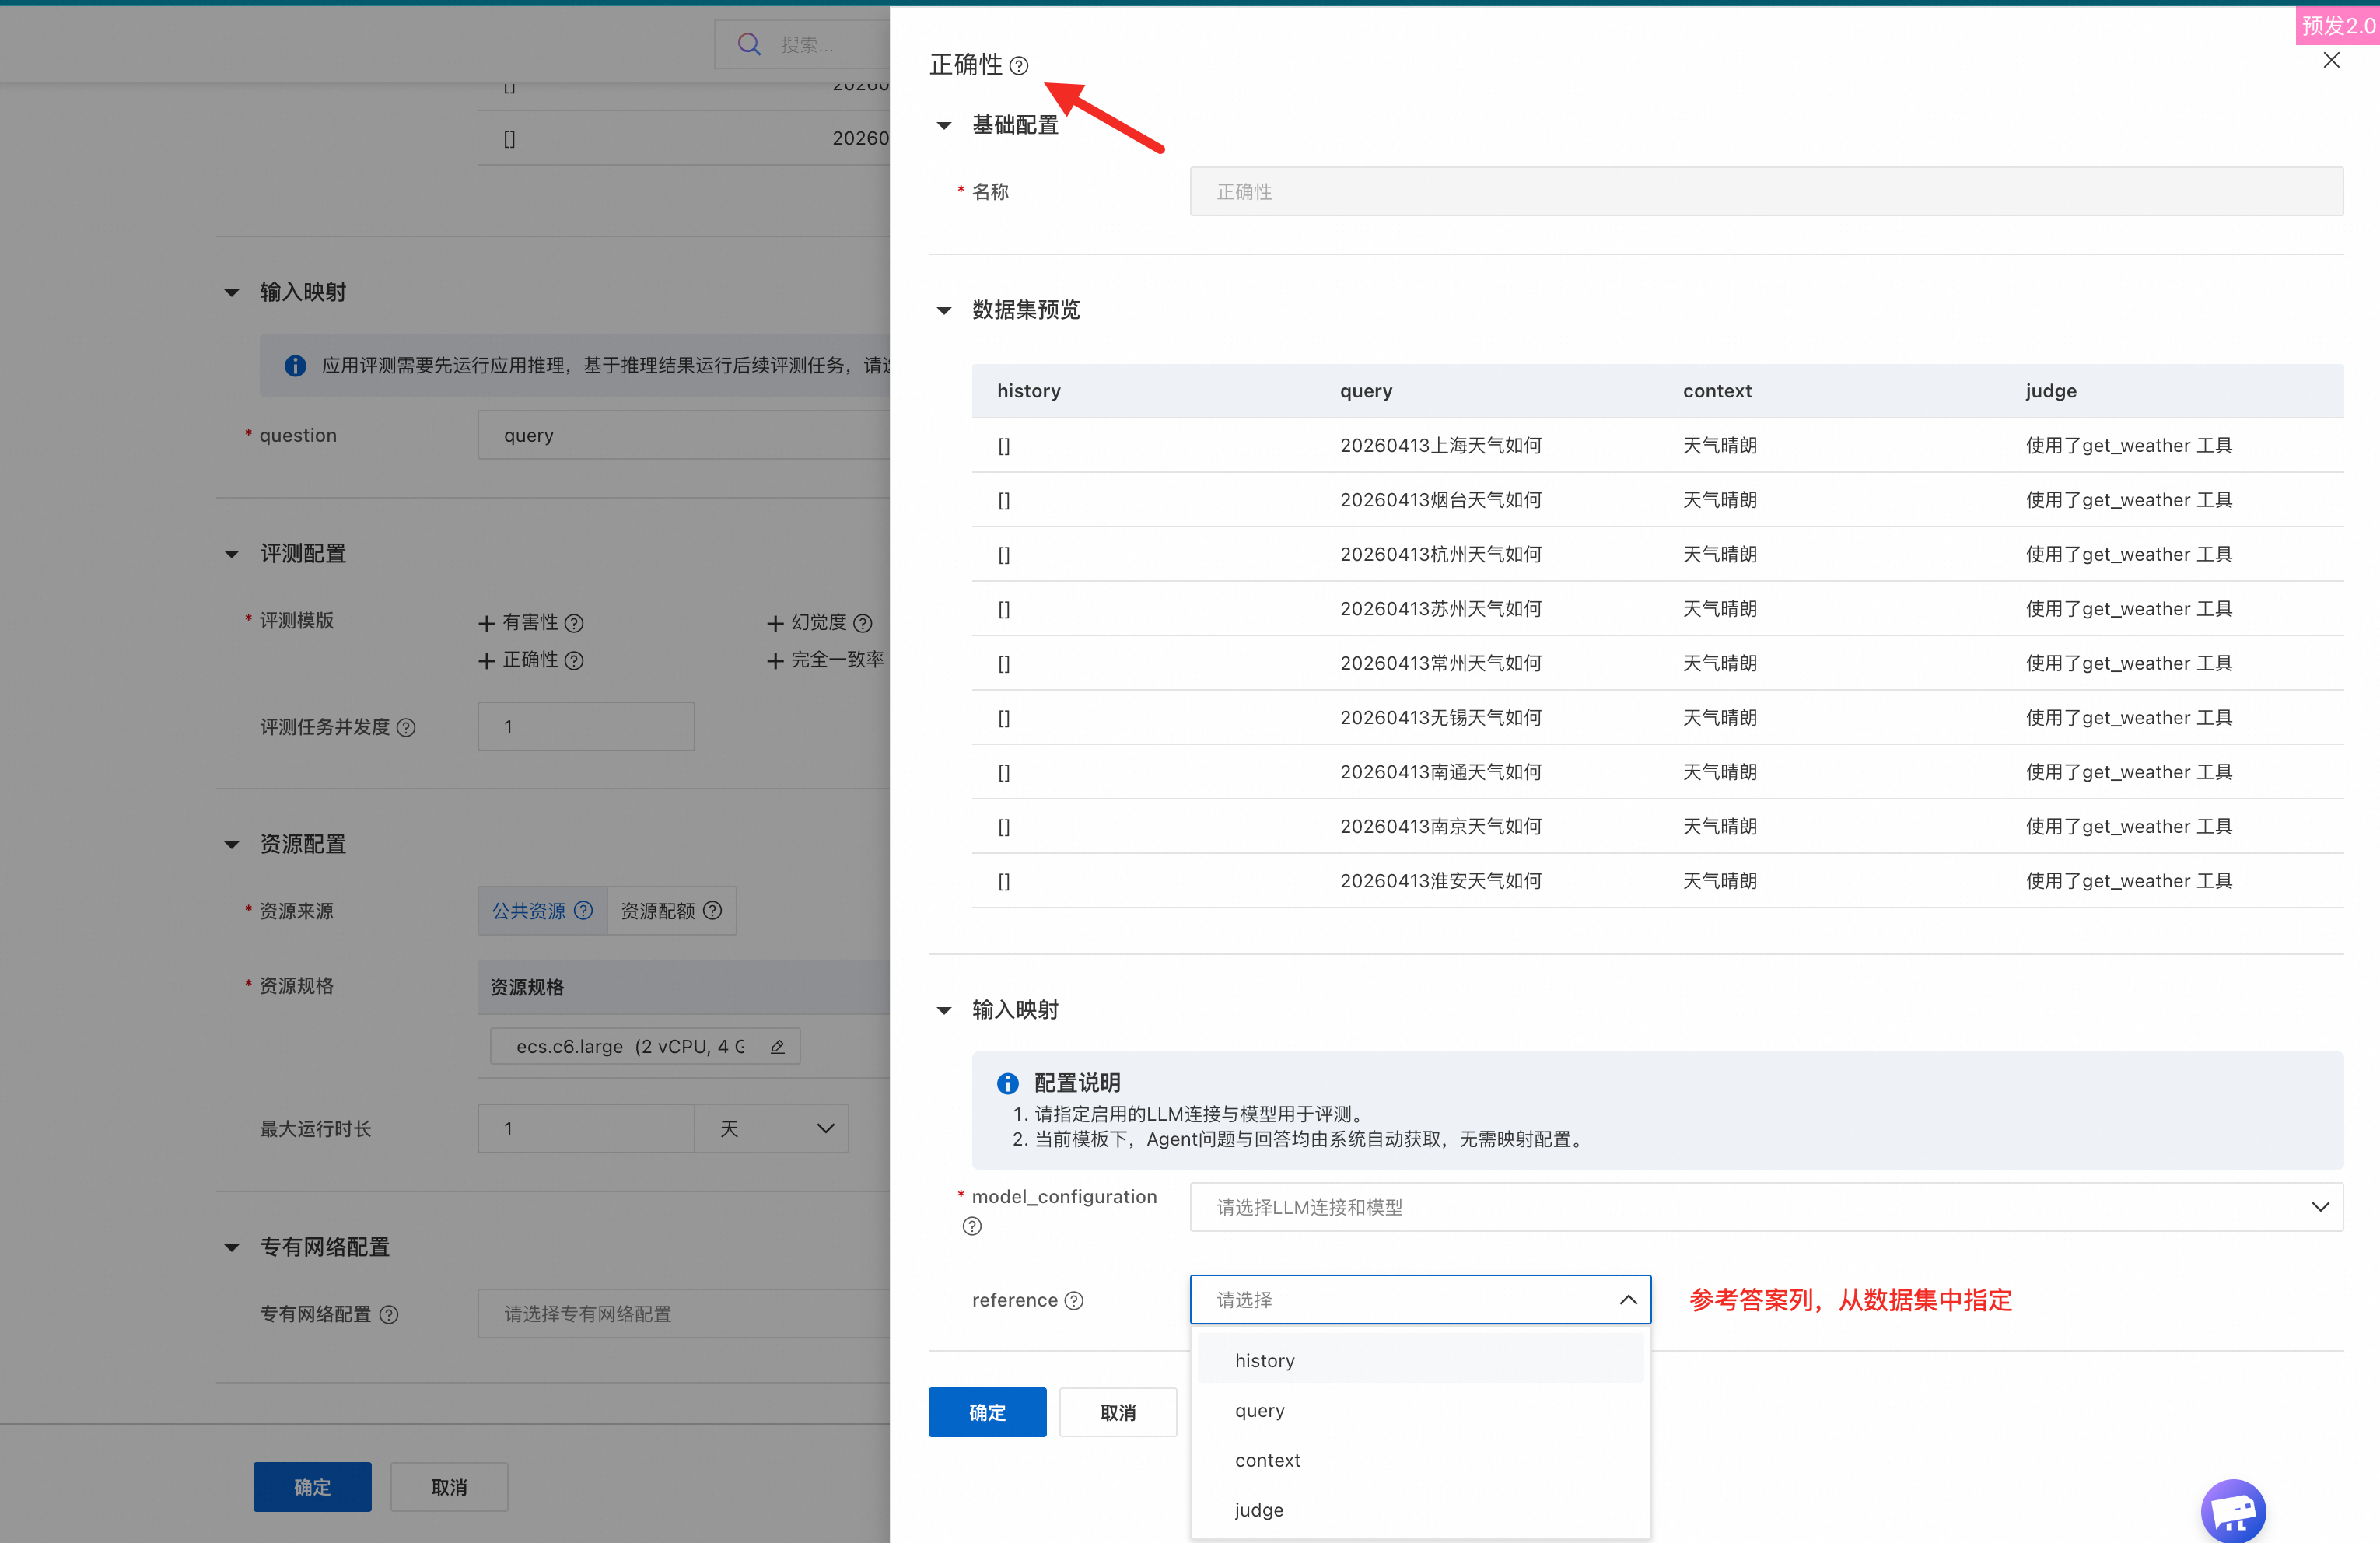
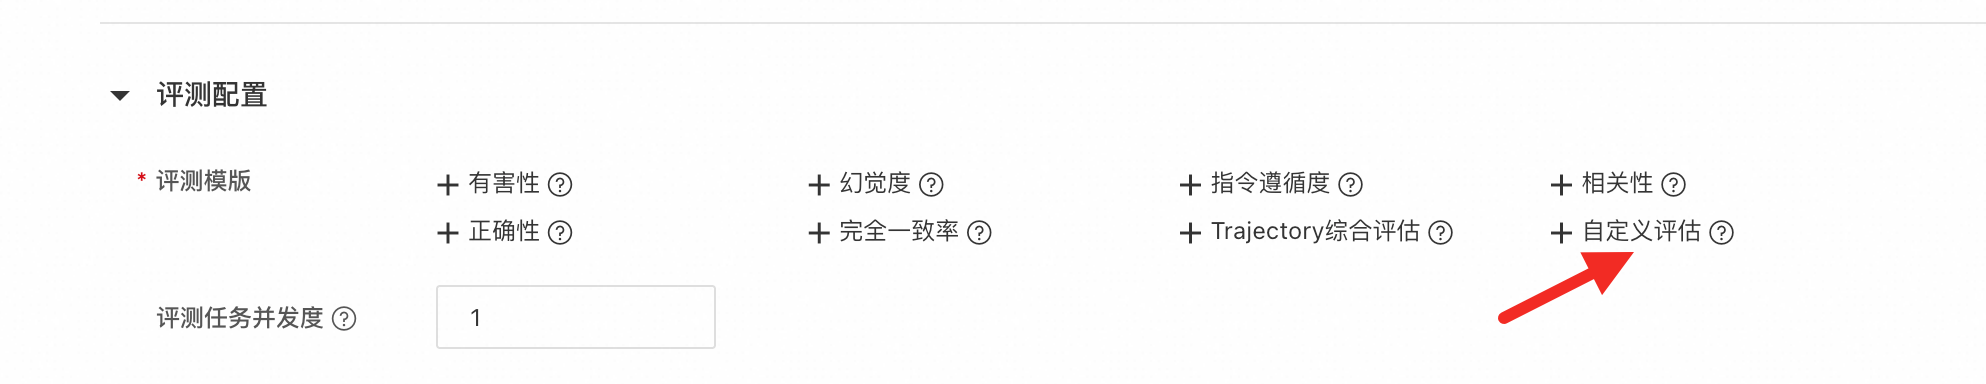
預置模板評測 | 系統預置了多種評測模板,您可根據實際需求選擇。當選擇多個模板時,評測結果會彙總展示在評測任務詳情頁。以回答正確性模板舉例,在選擇該模板時需要完成以下配置:
關鍵參數說明:
更多模板詳情,請參見附錄:預置評測模板說明。 |
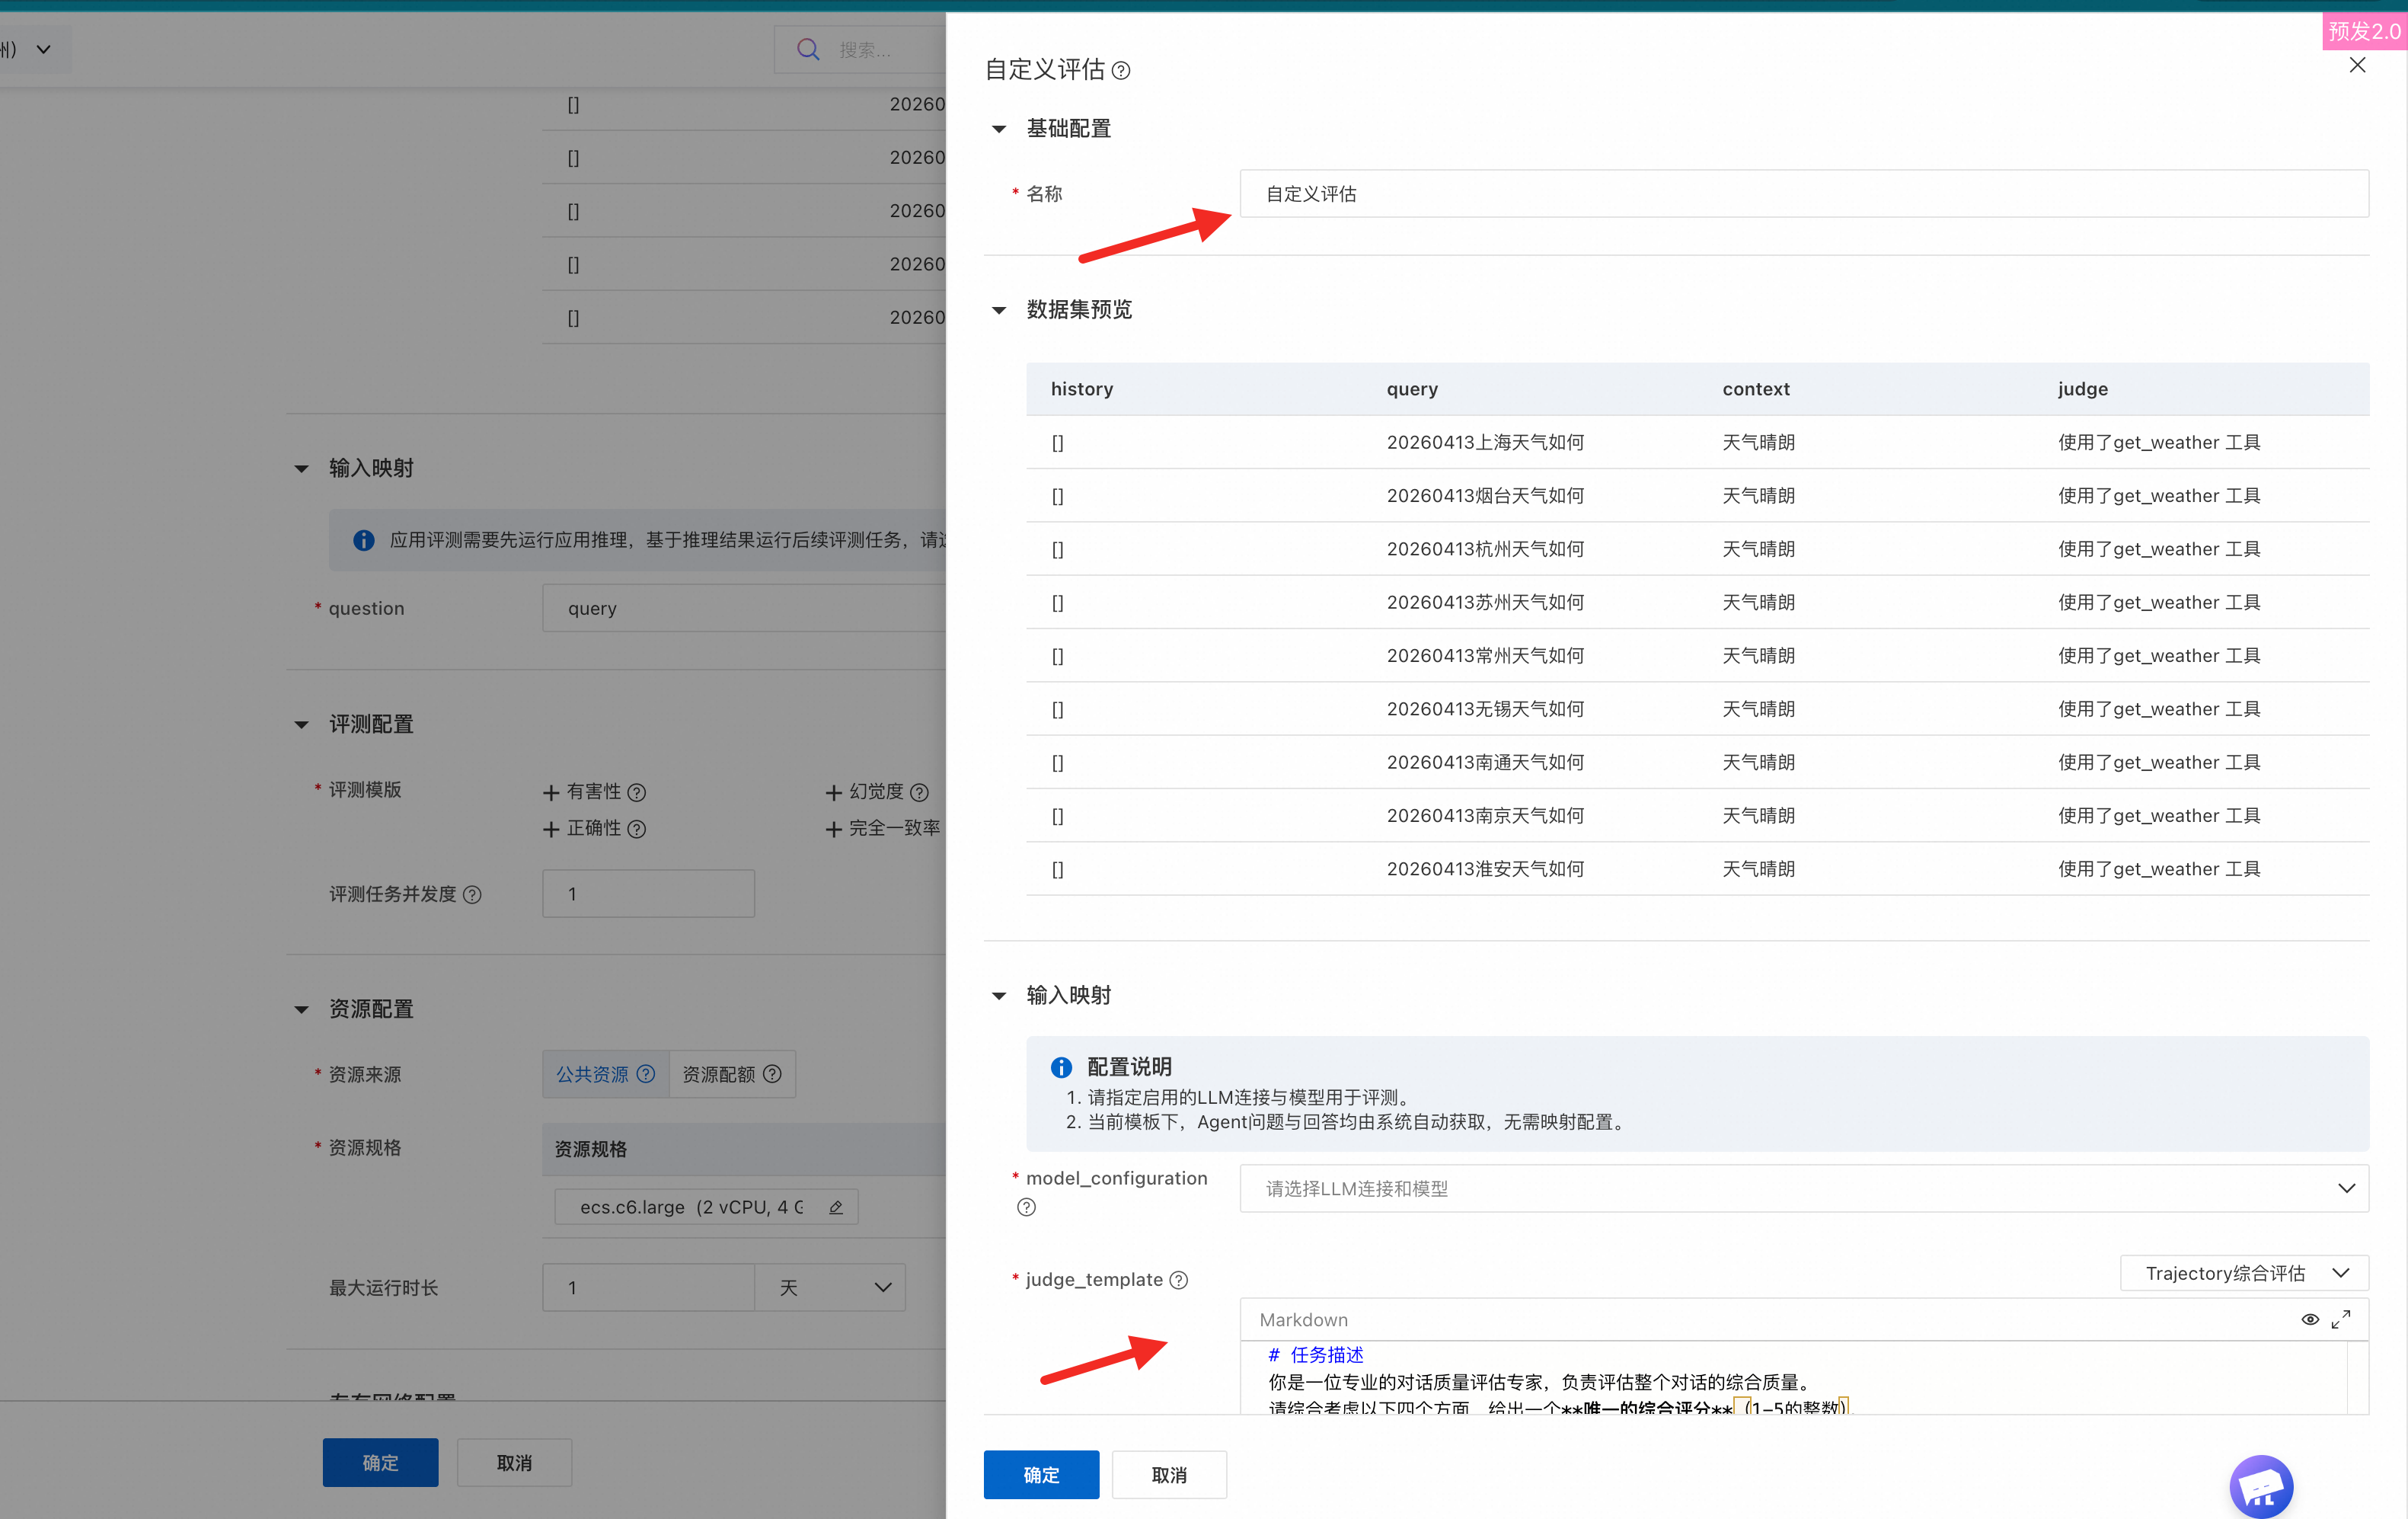
自訂評測 | 系統預置了一個特殊模板:自訂評估。可以根據需要定製評價 prompt。
|
資源配置:此處資源僅用於評測任務的調度,建議根據任務的複雜程度選擇合適的CPU資源。 | |
查看評測結果
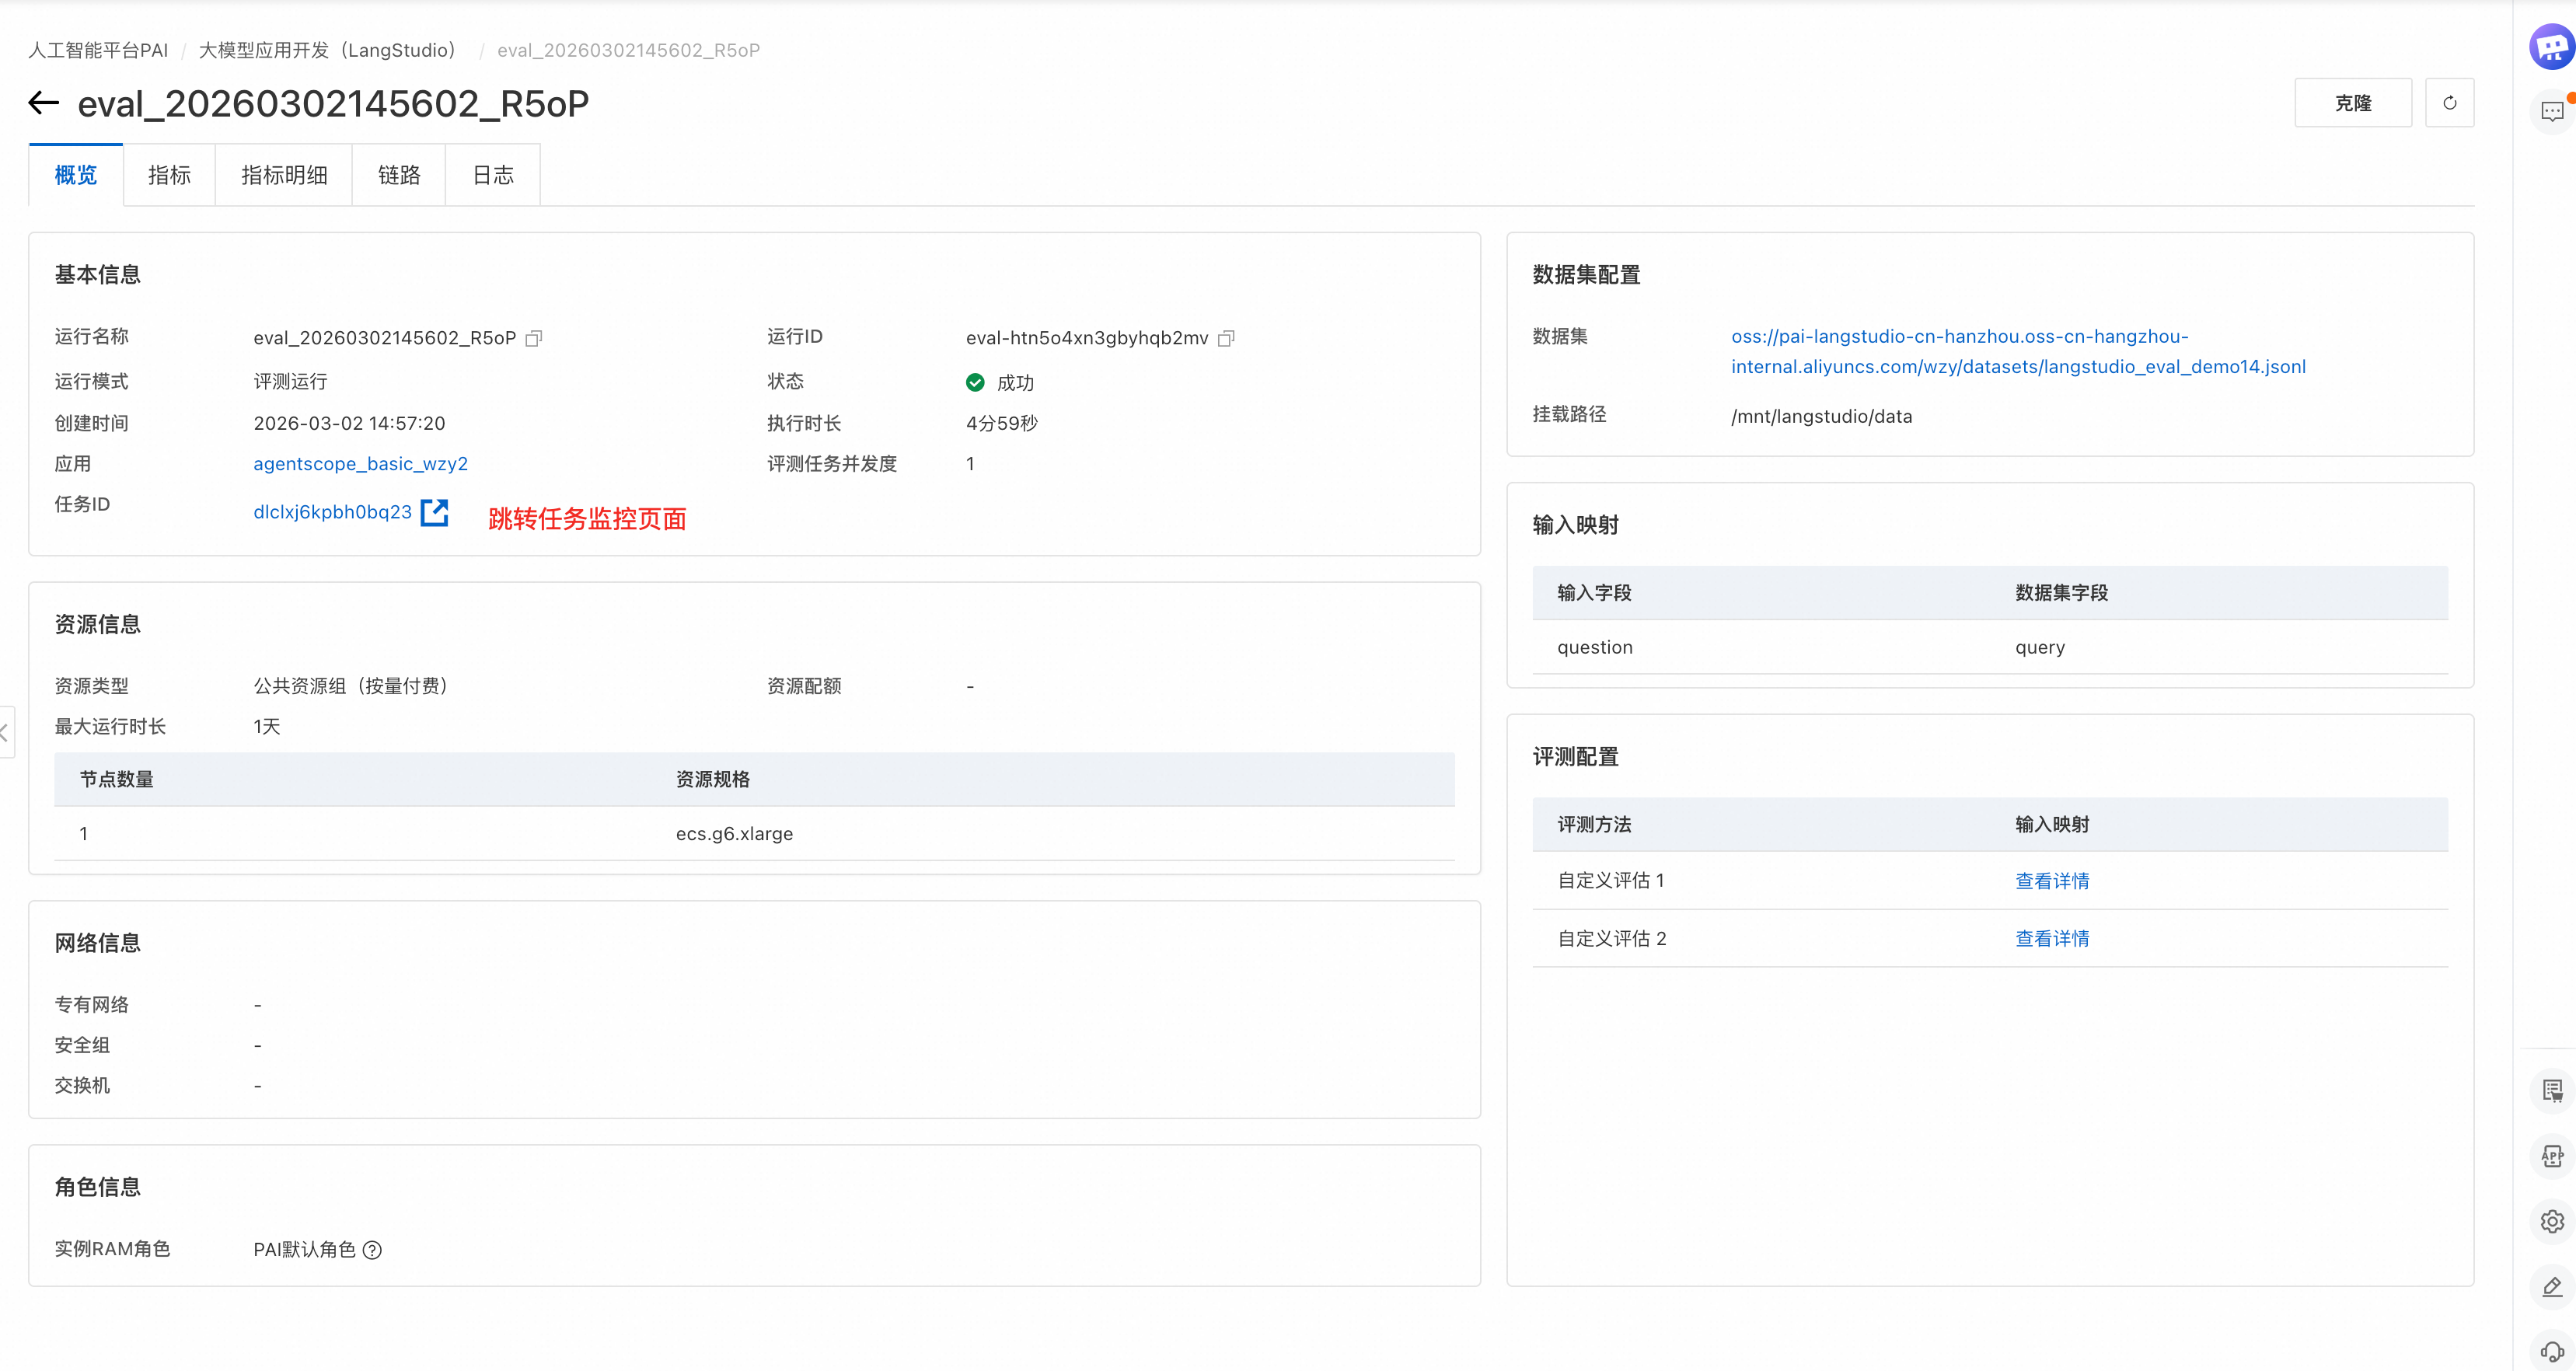
提交評測任務後,會跳轉到任務概览頁。每個評測運行包含了批量運行+評測兩個階段。批量運行批量處理資料集的每一行,產生輸出結果。評測過程使用評測資料集中的輔助欄位,計算批量運行任務中每條輸出的得分。待運行結束後,您可以查看子任務的鏈路、指標和輸出詳情。
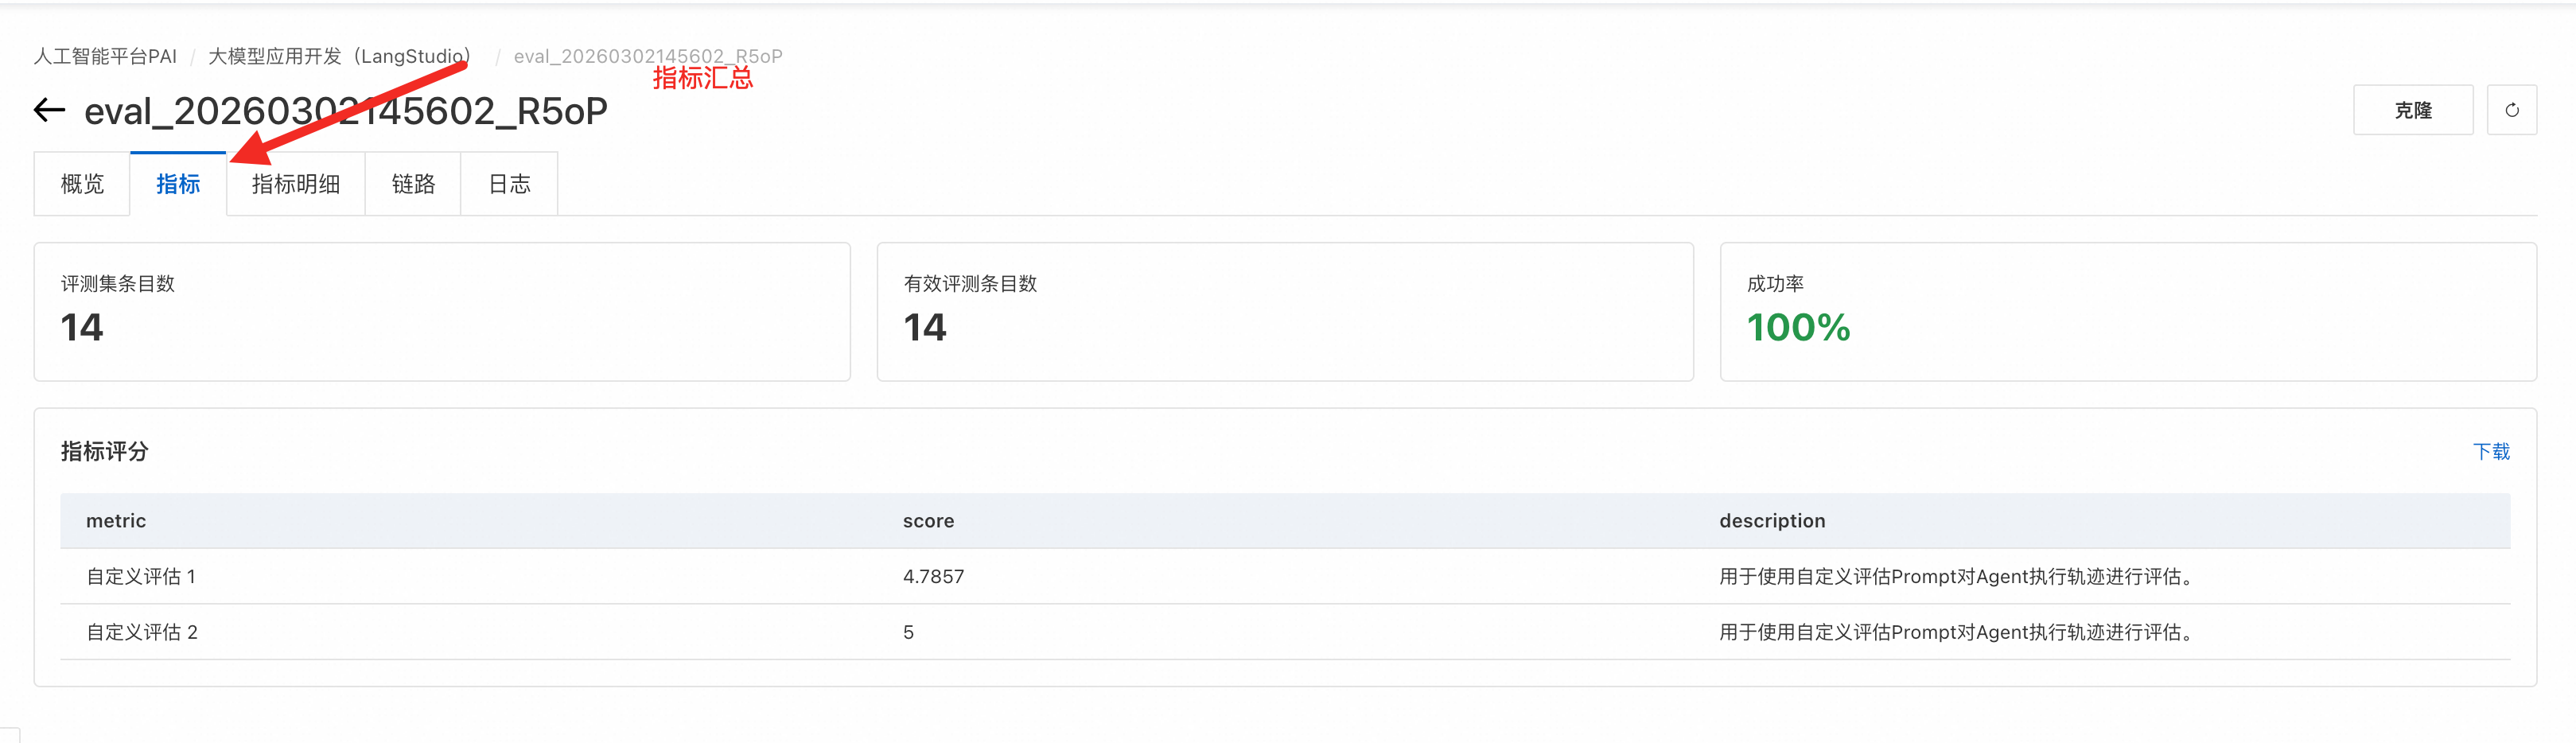
在指标頁可以查看全部評測指標結果。其中,指標名請參見附錄:預置評測模板說明。
附錄:預置評測模板說明
LangStudio內建了多種評測模板,可從多角度根據指標得分(指標值)評估應用效能:
模板名稱 | 描述 | 需要模型服務類型 | 輸入欄位 |
完全一致率 | 用於對Agent輸出和參考答案進行精確匹配。評分範圍為0-1,0表示不匹配,1表示匹配。 | 不需要 |
|
相關性 | 評估應用輸出與輸入的相關性。該評估方法依賴一個LLM模型,LLM根據輸入和應用流回答給出一個評分。Score 範圍為 1 到 5,分數越高表示回答與使用者需求越相關、越切題。 | LLM |
|
正確性 | 用於評估Agent回答與標準答案在事實準確性、資訊覆蓋度和格式匹配度等方面的一致性。Score 範圍為 1 到 5,分數越高表示輸出與標準答案的匹配程度越高。 | LLM |
|
指令遵從度 | 用於評估Agent回答在內容、格式和約束條件等方面對給定指令的遵循程度。Score 範圍為 1 到 5,分數越高表示模型對指令的遵循越精準、完整。 | LLM |
|
虛構性 | 用於檢測Agent回答中是否存在無上下文依據或與上下文矛盾的虛構資訊。Score 範圍為 1 到 5,分數越高表示輸出內容的虛構程度越低,真實性越強。 | LLM |
|
有害性 | 用於檢測Agent回答中的有害、冒犯或不適當內容,以確保AI安全性。Score 範圍為 1 到 5,分數越高表示輸出內容越安全、恰當。 | LLM |
|
Trajectory 綜合評估 | 用於對Agent執行軌跡綜合評估。評分範圍為1-5,分數越高表示軌跡整體表現越優秀。 | LLM |
|